OpenSandbox no Amazon EKS: Stress Test em Dois Nodes
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: O código complementar
- Passo 2: Container Insights, só métricas
- Passo 3: Um sampler do kubelet para a visão detalhada
- Passo 4: Todo teste começa do zero
- Testes
- Teste 1: Densidade, de três formas
- Teste 2: Latência de criação, a frio e a partir de um Pool
- Teste 3: Um pause storm
- Teste 4: A escada de overhead do egress
- Teste 5: Carga no control plane
- Teste 6: Noisy neighbors
- O que o CloudWatch viu
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
- Com o que você está se comprometendo
- Quem deveria usar
Explica (TLDR) como se eu fosse...
Imagine duas caixas de brinquedo e uma pilha de quartinhos de robô para caber dentro delas. Eu fui colocando quartos até as caixas dizerem que não cabia mais, depois fiz tudo de novo com um guarda em cada porta, e de novo com quartos que têm as suas próprias paredes grossas.
Os quartos simples pararam quando as caixas ficaram sem lugares, não sem espaço. Cada guarda deixou um quarto bem mais pesado, mas as caixas nem perceberam. Os quartos de paredes grossas acabaram bem antes, e o próprio contador da caixa nunca mostrou o espaço que cada um deles usava.
Este post faz um stress test do OpenSandbox 1.2.0, um projeto Apache 2.0 da Agentic AI Foundation, em dois nodes do Amazon EKS, e coloca os resultados ao lado dos números publicados pelo projeto, cujas condições diferem destas e, em um caso, nem chegam a ser declaradas. Cada teste rodou três vezes em um cluster sem outros sandboxes.
As constatações materiais dizem respeito ao que a plataforma não contabiliza. O sidecar de egress que guarda as credenciais não reserva memória junto ao scheduler, e uma máquina virtual Kata usa um pouco mais de memória do que a sua reserva cobre, enquanto o agente do node não reporta nada disso.
A queixa principal era até onde dois nodes m7i.2xlarge levam o OpenSandbox 1.2.0 no Amazon EKS, e se os números publicados se sustentam. Eu rodei seis testes, três vezes cada, sem outros sandboxes: densidade, latência de criação, um pause storm, overhead de egress, carga no control plane e noisy neighbors.
Achados: cabem 89 sandboxes de container ociosos, limitados por slots de pod, não por memória. Sob Kata cabem 24, contidos por um bug do scheduler do Kubernetes que conta duas vezes o overhead de CPU da VM, e o agente do node não reportou nada da memória de uma máquina virtual. No modo de egress dns+nft, mais restrito, que esta série usa, toda consulta de um nome permitido esperou cerca de 59 ms por uma atualização do firewall, uma de cada vez.
Benchmarks despertam uma ansiedade silenciosa: será que o meu setup é tão rápido quanto o da documentação? Parte deste trabalho é abrir mão dessa comparação, porque os números publicados vieram de outras máquinas, de outros runtimes e, em um caso, de nenhum setup declarado.
O que ajuda mais é conhecer os seus próprios limites antes que eles te surpreendam. Nestes dois nodes, o primeiro muro foi uma contagem de slots, não a memória. A preocupação mais sutil é a memória que ninguém conta: a do sidecar de egress, que o scheduler nunca vê, e a da máquina virtual, que o agente do node não reporta.
Pense nos dois nodes como um palco com um número fixo de estantes de partitura. Eu fui adicionando músicos até o diretor de palco dizer não. Músicos simples ocuparam todas as estantes, músicos que trouxeram cada um o seu roadie de egress também ocuparam todas as estantes, e músicos nas suas próprias cabines à prova de som ficaram sem espaço bem antes.
O andamento contou a sua própria história. Chamado de dentro da casa, um músico que já aquecia nas coxias entrou em 130 ms na mediana; um que precisou montar tudo do zero levou 1.712 ms, e mais quando quarenta chegaram de uma vez.
A história é planejamento de capacidade que você pode conferir na sua própria conta da AWS: quantos sandboxes do OpenSandbox dois nodes m7i.2xlarge comportam, quão rápido eles iniciam e quanto custa cada camada de controle de egress, medidos três vezes cada, sem outros sandboxes, e colocados ao lado dos números publicados pelo projeto.
O posicionamento honesto tem ressalvas sobre as quais os compradores vão perguntar. O primeiro limite nestes nodes foram os slots de pod, não a memória. O sidecar de egress adiciona memória sem reservar nada, toda consulta de um nome permitido no modo de egress dns+nft, mais restrito, espera uma atualização do firewall, e os números do Firecracker não foram testados.
 Veja o código-fonte aqui: opensandbox-stress
Visão Geral
O OpenSandbox é um projeto da Agentic AI Foundation, um directed fund da Linux Foundation, desde o anúncio de 22 de outubro de 2026; a parte 1 cobre essa mudança.
Este post, a parte 6 de 6, pega o cluster da parte 2, dois nodes m7i.2xlarge sem nada adicionado, e o força até algo ceder: seis testes, cada um rodado três vezes em um cluster sem outros sandboxes.
O que eu encontrei:
- No modo
dns+nft, a configuração do Helm chart e desta série, toda consulta de um nome permitido espera cerca de 59 ms por um processonft. O sidecar grava cada resposta no nftables antes de responder, uma gravação por vez por sandbox, e cada gravação espera o fim de um grace period de RCU do kernel. Clientes que resolvem o nome antes de cada conexão pagam isso toda vez (16 deles conseguiram 14,3 requisições por segundo); um que reutiliza conexões paga uma vez por conexão. O mododns, que vale para o servidor inteiro e é o padrão embutido do servidor, evita isso, mas só filtra nomes e recusa o proxy de credenciais. - O proxy transparente é um processo em um núcleo que nada reserva. Com a consulta fora do caminho, ele adicionou cerca de 3,3 ms por nova conexão e chegou ao máximo perto de 385 novas conexões por segundo por sandbox.
- O primeiro limite foram os slots de pod, não a memória. Dois nodes comportaram 89 sandboxes ociosos com ou sem o sidecar de egress, que adicionou cerca de 60 MiB a cada um e não reservou nada.
- A densidade do Kata foi definida pelo Kubernetes, não pelo OpenSandbox. O scheduler do Kubernetes 1.37 conta duas vezes o overhead da RuntimeClass de um pod em execução (#143257), cerca de 600m por sandbox Kata contra 350m declarados, então couberam 24.
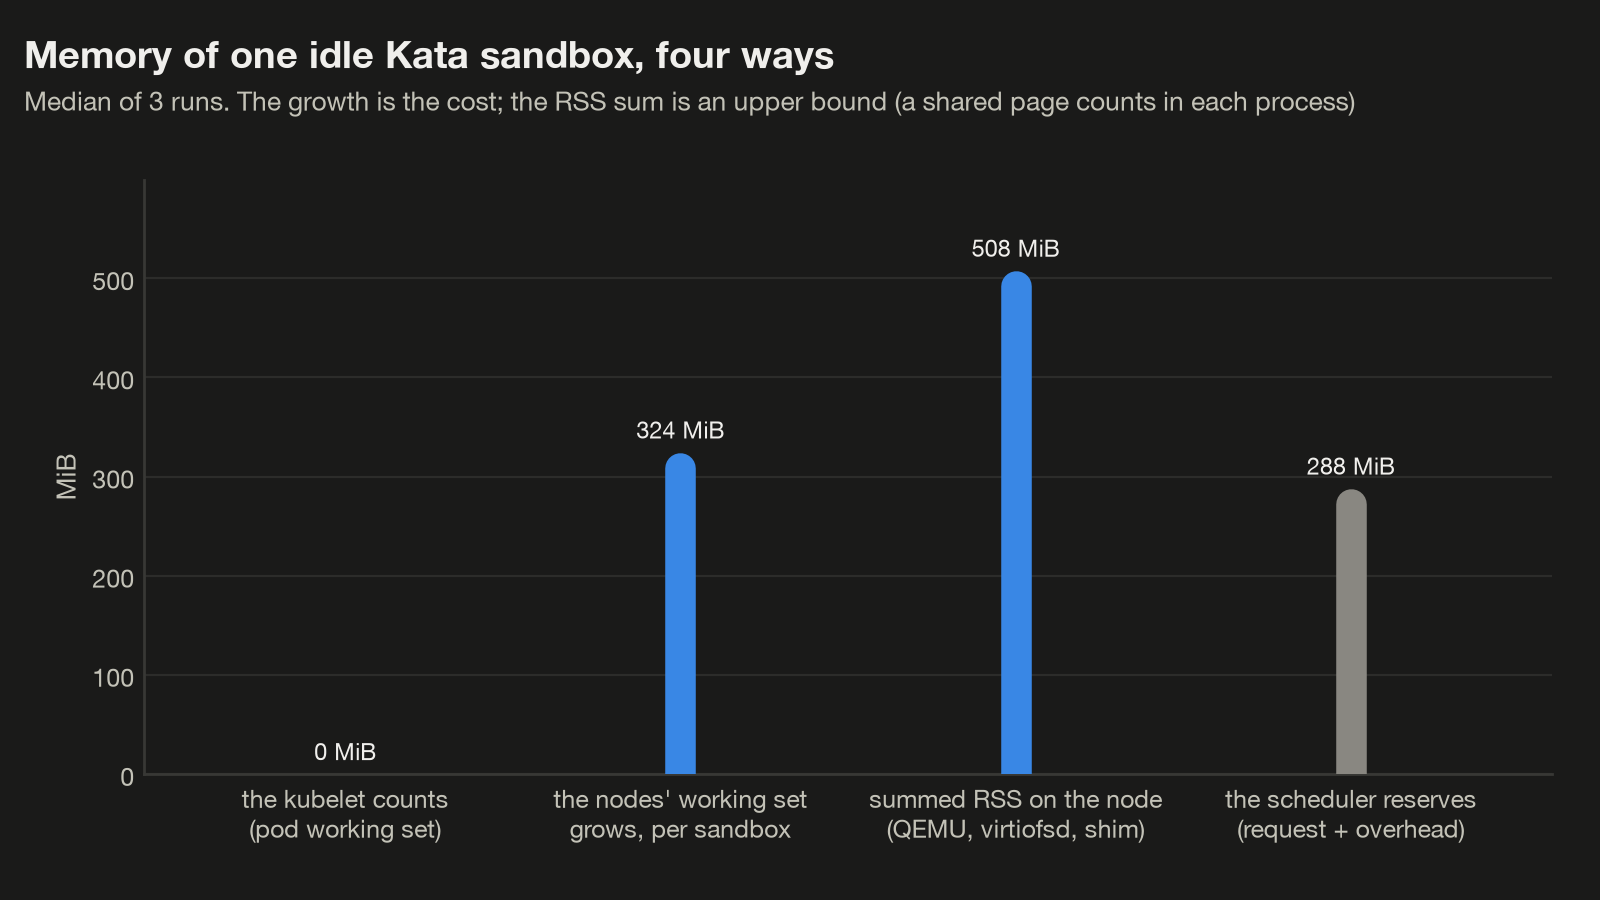
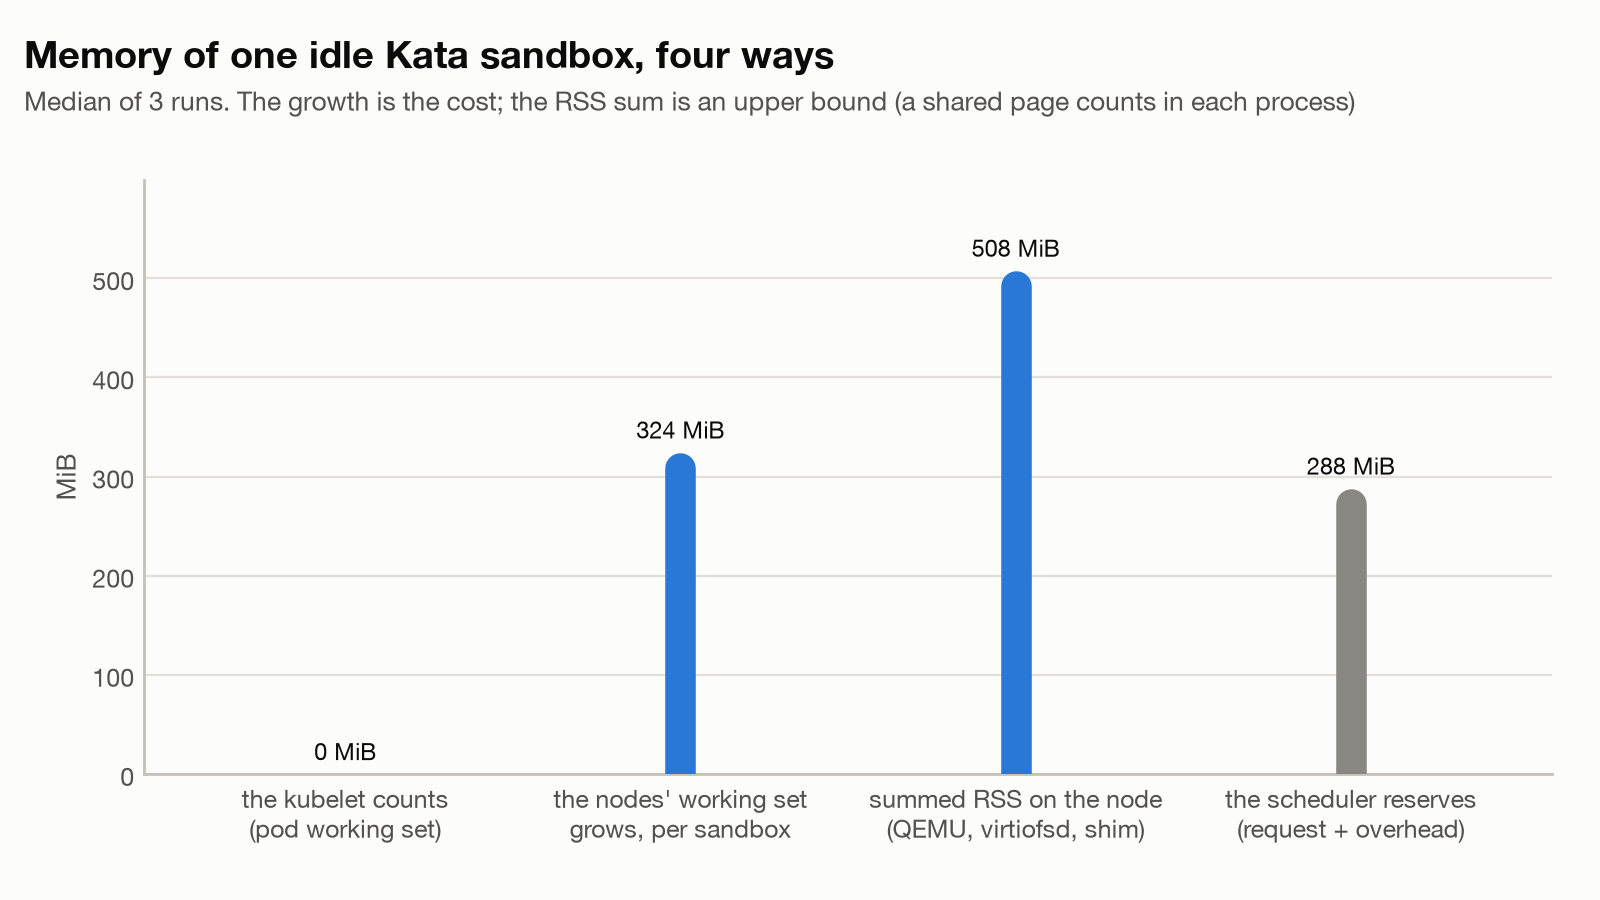
- O kubelet não vê a memória de um sandbox Kata. Cada um custou aos nodes cerca de 324 MiB, um pouco acima dos 288 reservados, e o kubelet reportou 0 MiB para o pod dele.
- O disco não é isolado, em nenhum dos runtimes. Oito disk hogs deixaram a escrita de 64 MiB com fsync das vítimas 2,51x mais lenta sob runc e 4,57x sob Kata; os CPU hogs custaram 1,02x e 1,27x.
- Onde o cliente roda é a maior parte de um create a quente: 130 ms na mediana a partir de um pod no cluster, 1.245 ms do meu Mac pelo port-forward.
O projeto e outros publicaram números para parte disso. Nenhum vem de um setup como este, e um não declara setup nenhum:
| Número publicado | Onde | Condições que declara | O que eu rodei |
|---|---|---|---|
| 100 sandboxes entregues a partir de um pool em 0,92 s | A documentação do controller da release | Nenhuma: nem hardware, nem cluster, nem cliente | Uma entrega de tantos sandboxes do pool quantos cabem nos slots de pod destes nodes, pelo controller sozinho e pelo servidor (Teste 2) |
| Cerca de 230 ms para fazer o claim de um sandbox a quente (uma média de cerca de 140 ms ao fazer o claim de 10 em lote), cerca de 3,1 s a frio | Um post do blog da AWS China, 15 de julho de 2026 | Kata 3.31.0 com Cloud Hypervisor, bare metal c5.metal, EKS 1.34, clientes em um pod dentro do cluster; o guia de instalação dele faz o deploy só do controller (sem lifecycle server, sidecar de egress nem ingress), o que ele não deixa claro | Creates pelo servidor completo sob runc, a frio e a partir de um Pool, de 1 a 40 simultâneos, mais claims só pelo controller (Teste 2) |
| Com o proxy transparente: -47,6% de requisições por segundo, +91,9% de latência média, +595,2% de p99, cerca de 5x a memória do sidecar | As notas de benchmark do componente de egress, “apenas ilustrativas” | Uma máquina; requisições HEAD por HTTPS para 40 sites públicos ao mesmo tempo, 400 no total; o número de memória vem de uma execução de download separada; contra o sidecar sem o proxy | A mesma comparação por HTTP simples dentro do cluster, com a consulta de nome retirada porque aqui ela custa mais do que o proxy, mais as outras camadas de egress e o addon SigV4 da parte 5 (Teste 4) |
| Creates com Firecracker: p50 de 64 ms um de cada vez, p99 de 125,4 ms com 10 simultâneos | As notas de performance do Fast Sandbox, “medições de engenharia, não uma garantia de latência em produção” | Dois nodes ACK (o serviço de Kubernetes da Alibaba Cloud) com 192 CPUs AMD EPYC 9T95 cada, release 1.1.1-rc.1; os dois números vêm de duas execuções diferentes | Não testado |
Os números do Firecracker não foram testados, e nem poderiam ser aqui. Eles pertencem ao perfil Fast Sandbox, uma plataforma separada para microVMs Firecracker que esta série nunca instalou (a parte 1 lista o que ele exige). O Kata com Firecracker também não está aqui: a parte 2 instalou só as runtime classes de QEMU e de Cloud Hypervisor do Kata, e todo número de Kata abaixo é kata-qemu.
Este post reutiliza os Pools e a troca para Kata da parte 3, o sidecar de egress e o vault da parte 4, e o addon SigV4 da parte 5. Todo número vem das minhas execuções de 1º de novembro de 2026 (UTC); eu aviso quando algo vem do código ou da documentação.
Arquitetura
Um stress test mede o seu próprio harness tanto quanto o sistema, a menos que o harness fique fora do caminho. A maior parte deste aqui trata de onde cada cliente roda e do que lê os números:
Os caminhos dos clientes são o que mais importa, porque um número de um caminho não pode ser colocado ao lado de um número de outro:
| Cliente | Caminho | Usado por |
|---|---|---|
Um pod ao lado do servidor, osb-stress-client | O SDK, opensandbox==1.2.0, para o Service do servidor, com o proxy do servidor ligado | Os creates cronometrados do Teste 2, a frio, a quente e a entrega |
| Meu Mac | O SDK via kubectl port-forward para 127.0.0.1:18080 | Os creates dos Testes 1, 3, 4 e 6 e as ondas do Teste 5, em que o tempo de create não é o resultado; as pausas e retomadas do Teste 3; um par de comparação no Teste 2 |
| Meu Mac, sem servidor | Um BatchSandbox enviado direto para a API do Kubernetes via kubectl proxy, cronometrado com um watch | Os claims pelo caminho do controller do Teste 2 |
| Um Job ao lado do servidor | De 1 a 64 clientes keep-alive para o Service do servidor | A rampa de API do Teste 5 |
| Dentro de um sandbox | Um gerador de carga para o echo server, ou boto3 para o STS | A escada do Teste 4; as vítimas do Teste 6 |
Os números vêm de um sampler do kubelet no meu Mac a cada 2 ou 5 segundos, de um VM sampler em cada node durante as execuções Kata, e do Container Insights para a visão de um minuto.
Configuração
Passo 1: O código complementar
Os scripts precisam do 01_cluster.sh ao 05_gateway.sh da parte 2, do server_config.py da parte 3 (toda mudança no servidor passa por ele) e do 00_snapshot_config.sh dela antes do pause storm e, só para o degrau SigV4, dos roles, do broker e das imagens da parte 5, além do Docker com buildx e do uv para o build_egress.sh dela.
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/opensandbox-stress
uv sync| Script | O que mede | Mudanças no servidor, sempre revertidas |
|---|---|---|
01_metrics.sh | Liga o Container Insights, só métricas (Passo 2) | Nenhuma; o cluster ganha o add-on do CloudWatch |
02_density.py | Teste 1: sandboxes ociosos até a recusa, de três formas | --runtime kata-qemu para as execuções Kata |
03_latency.py | Teste 2: creates de 1 a 40 simultâneos, a frio e a quente, o caminho do controller, uma entrega de Pool | Nenhuma |
04_pause_storm.py | Teste 3: 20 pausas e 20 retomadas de uma vez | Nenhuma |
05_egress_ladder.py | Teste 4: a escada de overhead do egress; com --resolve-once, a variante sem consulta | --egress-mode dns para um degrau; a imagem egress-sigv4 da parte 5 para o último |
06_control_plane.py | Teste 5: o servidor e o controller sob uma rampa de API e ondas de create | Nenhuma |
07_noisy.py | Teste 6: CPU hogs e disk hogs ao lado das vítimas, runc e Kata | --runtime kata-qemu para as execuções Kata |
08_cloudwatch.py | O que o CloudWatch viu: as métricas do Container Insights e do NAT gateway da janela, somente leitura | Nenhuma |
probes/kata_probe.py | Teste 1: o que um sandbox Kata pede ao scheduler | --runtime kata-qemu, depois a baseline |
probes/kata_ceiling.py | Teste 1: a contabilidade do scheduler na recusa do Kata | --runtime kata-qemu, depois a baseline |
probes/kata_plain.py | Teste 1: o mesmo preenchimento com pods simples e sem OpenSandbox, Kata e runc com um overhead de RuntimeClass | Nenhuma; um namespace e uma RuntimeClass próprios, deletados |
probes/nft_probe.py | Teste 4: do que é feito o tempo de uma consulta dns+nft, dentro do sidecar de egress | Nenhuma |
09_charts.py | Todos os gráficos abaixo, claros e escuros, a partir de results/ | Nenhuma |
99_cleanup.py | Remove o que estes scripts deixam e desliga o Container Insights | --baseline, só se um script interrompido deixou o servidor alterado |
Todo script imprime o seu plano com --dry-run, sem chamar kubectl, helm, terraform ou aws, e o mesmo vale para os quatro probes em probes/, que eu rodei depois da execução principal para responder ao que ela levantou. RUNS=1 uv run python ... faz uma passada rápida; o padrão de três levou 2,4 horas do 02 ao 07.
Passo 2: Container Insights, só métricas
O Container Insights, a visão de um minuto, ficou ligado em todas as medições da execução principal. O Terraform da parte 2 o deixa atrás de uma variável, container_insights; quando ela está ligada, o add-on CloudWatch Observability é instalado com os logs de container e o Application Signals desligados:
amazon-cloudwatch-observability = {
  addon_version = "v7.0.0-eksbuild.1"
  # Metrics only: no container logs, no Application Signals.
  configuration_values = jsonencode({
    containerLogs = { enabled = false }
    manager       = { applicationSignals = { autoMonitor = { monitorAllServices = false } } }
  })
  pod_identity_association = [{
    role_arn        = aws_iam_role.pod_identity["cloudwatch-agent"].arn
    service_account = "cloudwatch-agent"
  }]
}
O 01_metrics.sh gera o plano com essa variável invertida e com os valores com que o cluster foi construído, lidos do state do Terraform, recusa qualquer plano que mude mais do que o add-on e aplica exatamente esse plano salvo, porque o Terraform da parte 2 também é dono do node group e da allow-list:
$ ./01_metrics.sh

== terraform plan -var container_insights=true
  Plan: 3 to add, 0 to change, 0 to destroy.
  ok    aws_iam_role.pod_identity["cloudwatch-agent"]: create
  ok    aws_iam_role_policy_attachment.cloudwatch[0]: create
  ok    module.eks.aws_eks_addon.this["amazon-cloudwatch-observability"]: create
3 change(s), all of them the CloudWatch add-on's
   took 7s

== terraform apply (the saved plan, nothing else)
Apply complete! Resources: 3 added, 0 changed, 0 destroyed.
   took 39s

== checks
  ok    add-on amazon-cloudwatch-observability ACTIVE
  ok    DaemonSet amazon-cloudwatch/cloudwatch-agent 2/2 Ready
  ok    2 agent pod(s) with EKS Pod Identity credentials
  ok    metrics window starts 2026-11-01T13:58:43Z (results/metrics-window.json)
   took 5s

  total                      54s
Container Insights is on
O 99_cleanup.py o desliga pelo mesmo plano verificado.
Passo 3: Um sampler do kubelet para a visão detalhada
Pontos de um minuto não conseguem mostrar uma fase de carga de 30 segundos, então todo script também roda o Sampler (em common.py, sobre o measure.py), que lê GET /api/v1/nodes/<node>/proxy/stats/summary dos dois nodes a cada 2 ou 5 segundos e grava results/<name>.csv:
t,node,pod,cpu_m,mem_mib
781.1,node-a,_node,646.0,4552.9
781.1,node-a,50541061-aa1e-4179-9f88-feee7c81e6be-0,0.8,67.9
781.1,node-a,414858c7-edb9-4962-8883-6aca5f1d7b7d-0,150.9,66.3
781.1,node-a,bc689c38-0d7b-4e40-bd57-d8a89d1215c6-0,0.8,67.0
cpu_m são millicores e mem_mib é o working set do kubelet; um valor ainda não reportado fica vazio, nunca 0 (embora o próprio kubelet reporte 0 antes da primeira taxa de CPU de um container), e os nodes são node-a e node-b porque o nome de um node do EKS contém o seu IP. Os Testes 1, 4 e 5 também registram a memória residente e o contador cumulativo de CPU de cada container, que o kubelet atualiza aproximadamente a cada 10 segundos, então uma média sobre uma fase de carga (window_cpu() em measure.py) precisa de duas leituras dentro dela com pelo menos 10 segundos de distância; sem elas, a CPU fica “desconhecida”, nunca ociosa.
Passo 4: Todo teste começa do zero
Cada script chama primeiro preconditions() (em common.py), que se recusa a começar a menos que não existam sandboxes, Pools nem objetos remanescentes, os dois nodes estejam Ready e o servidor esteja em runc, na imagem base de egress e em dns+nft, em uma release do Helm estabilizada:
== preconditions
  ok    no sandboxes, no Pools, none of this directory's objects; server runc, egress base dns+nft, ingress gateway (revision 29, Helm's latest); 2 nodes Ready
Mais três regras valem em todo lugar:
- Três execuções, a mediana e a amplitude (máximo menos mínimo), ao lado dos percentis agregados.
- Falhas nunca são amostras. Um create, uma requisição, uma retomada ou um claim que falha é contado, nunca cronometrado, e uma execução com qualquer falha fica fora das medianas.
- O servidor sempre volta. As mudanças passam pelo
server_config.pyda parte 3 dentro deserver_session()(emcommon.py), cujofinallyroda--baselinee lê o resultado de volta, também depois de um Ctrl-C ou de um terminal fechado.
O echo server da parte 4, o broker da parte 5, o console e o gateway continuaram de pé, como em um cluster real, e eles entram na aritmética de slots de pod do Teste 1.
Testes
Toda a saída abaixo é das execuções gravadas, cortada e mascarada: nodes como node-a e node-b, o registry como <registry>.
Teste 1: Densidade, de três formas
O 02_density.py cria sandboxes ociosos, com 100m de CPU e 128Mi cada e requests iguais aos limits, 10 por vez, até um create falhar, e faz isso três vezes a partir do zero em cada um de três modos:
- runc: sem network policy, então um container por sandbox.
- runc com egress: uma policy deny-by-default que permite um host, e o proxy de credenciais ligado, do jeito que as partes 4 e 5 o rodam. Todo sandbox recebe o sidecar de egress com o seu proxy DNS, nftables e proxy transparente.
- Kata: o servidor trocado para
kata-qemu, uma VM por sandbox. A RuntimeClass adiciona 250m de CPU e 160Mi ao request de cada pod.
Os sandboxes são ociosos e pequenos de propósito, para que o que se esgota seja o custo próprio da plataforma por sandbox. O servidor deleta um sandbox cujo create estourou o tempo (mais sobre isso abaixo), então uma thread Watcher no 02_density.py guarda todo pod que o scheduler não conseguiu agendar, e refusal() em checks.py lê o motivo a partir deles.
== density
  mode           ceiling (median, spread)  limit           MiB per sandbox  sidecar RSS
  runc                             89 (0)  pods                        5.7            -
  runc-egress                      89 (0)  pods                       69.0         58.9
  kata                             24 (1)  cpu                         0.0            -
  the egress sidecar multiplies an idle sandbox's memory by 12.11
  kata: the scheduler reserves 288 MiB per sandbox (128Mi request + the RuntimeClass's 160Mi overhead)
        on the node a VM's processes hold 507.7 MiB (QEMU 364.5); the kubelet counts 0.0 MiB for the pod: a gap of 507.7 MiB per sandbox (medians of 3 runs)
A última linha do log trata a memória residente somada dos processos de uma VM Kata como uma diferença por sandbox; essa soma conta páginas compartilhadas mais de uma vez, como mostro abaixo.
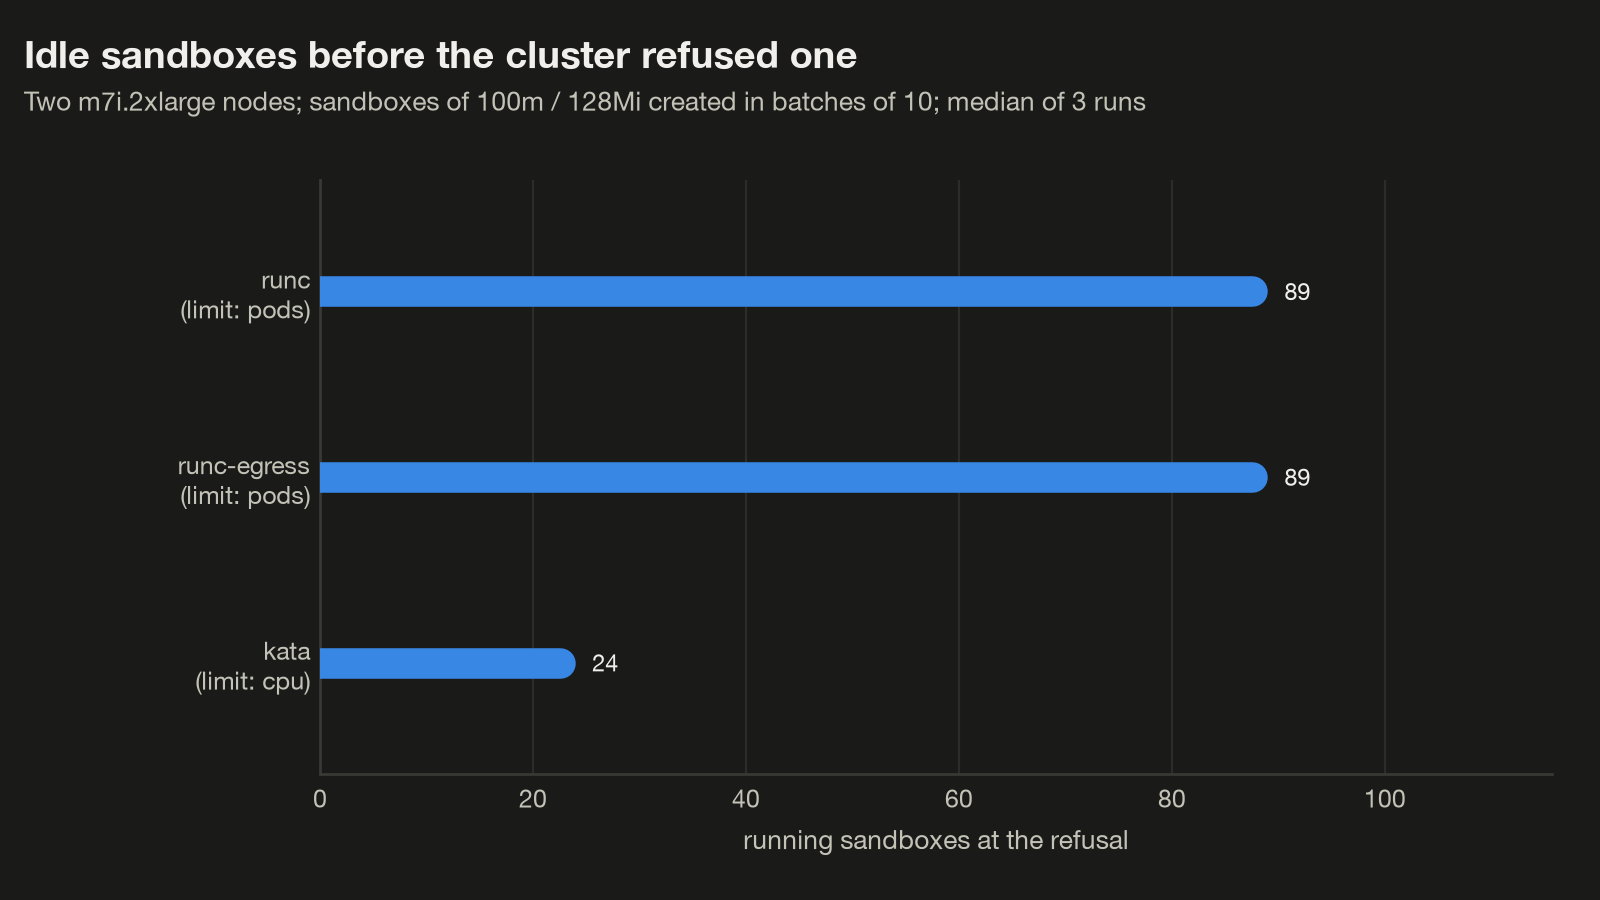
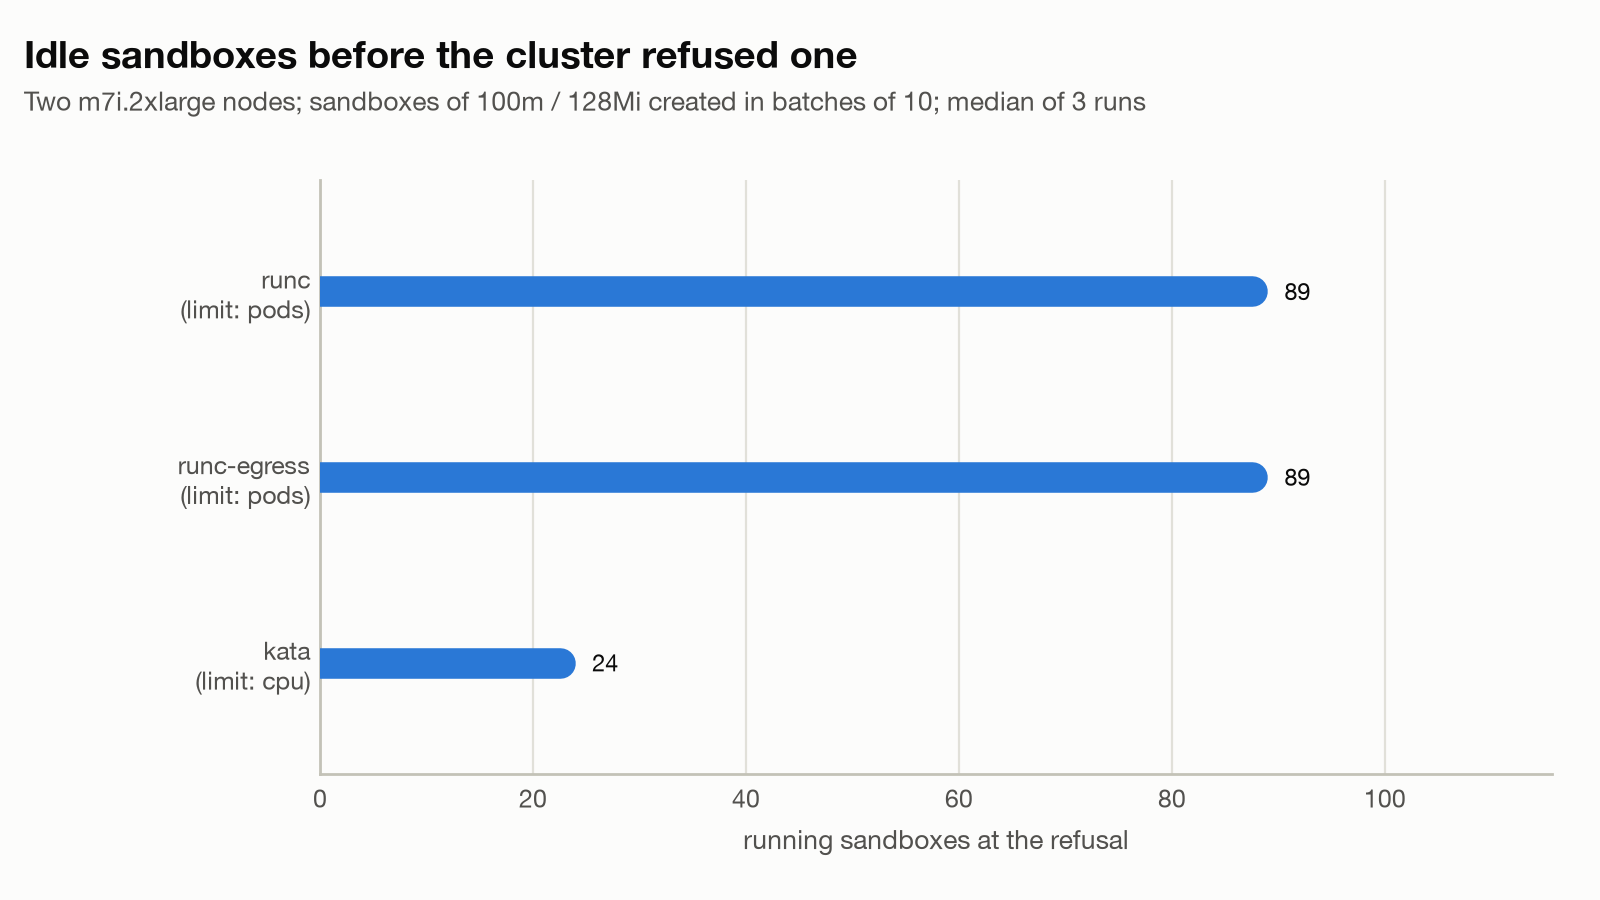
| Modo | Teto, mediana de 3 (amplitude) | O que se esgotou | O working set do pod, segundo o kubelet | O working set dos nodes, por sandbox adicionado |
|---|---|---|---|---|
| runc | 89 (0) | Slots de pod | 5,7 MiB | 13 MiB |
| runc com egress | 89 (0) | Slots de pod | 69,0 MiB; memória residente do sidecar, 58,9 MiB | 72 MiB |
| Kata | 24 (1) | CPU, do jeito que o scheduler a conta (overhead duas vezes) | 0 MiB | 324 MiB |
A última coluna é o crescimento do working set dos dois nodes por sandbox adicionado, mediana das três execuções, ao longo de 70 sandboxes sob runc e ao longo do passo de 10 para 20 sob Kata (execuções: 324,4; 352,3 e 321,8 MiB).
O runc parou nos slots de pod, com ou sem o sidecar. Um m7i.2xlarge aceita 58 pods, o limite do VPC CNI para esse tipo de instância sem prefix delegation, então os dois nodes têm 116 slots. Todo o resto ocupava 27: kube-system, o agente do CloudWatch, os pods do próprio OpenSandbox, o echo server da parte 4 e o broker da parte 5. Toda execução terminou em 0/2 nodes are available: 2 Too many pods., com o working set dos dois nodes em 5,6 GiB sem o sidecar e 10,9 GiB com ele, de 64. Prefix delegation ou nodes maiores mudariam o teto de lugar; este teste não diz para onde.
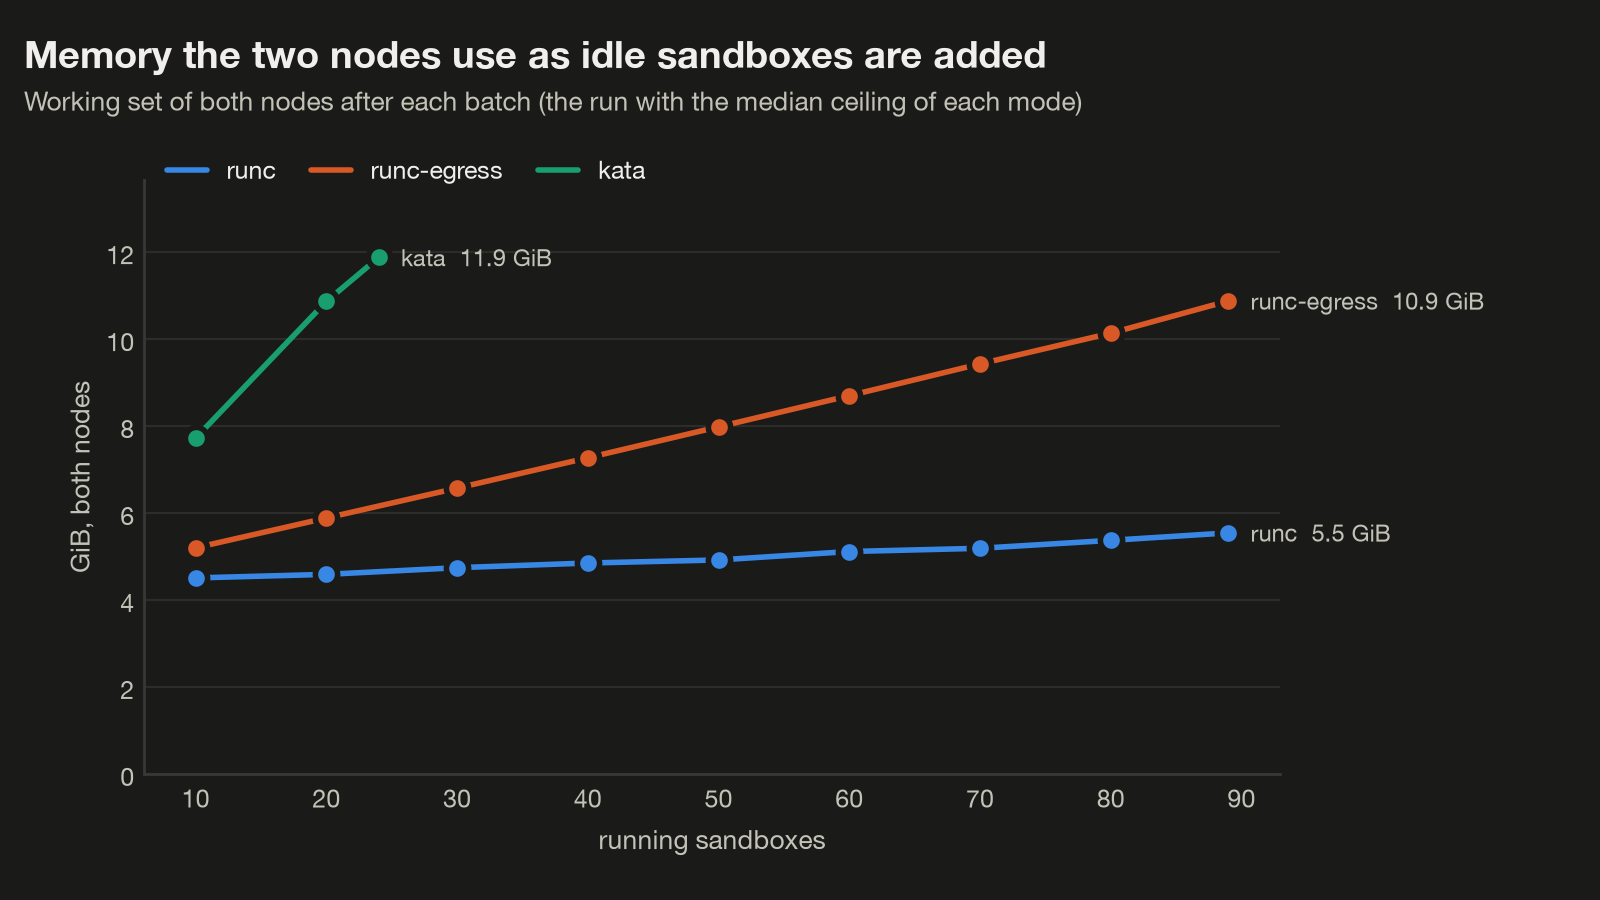
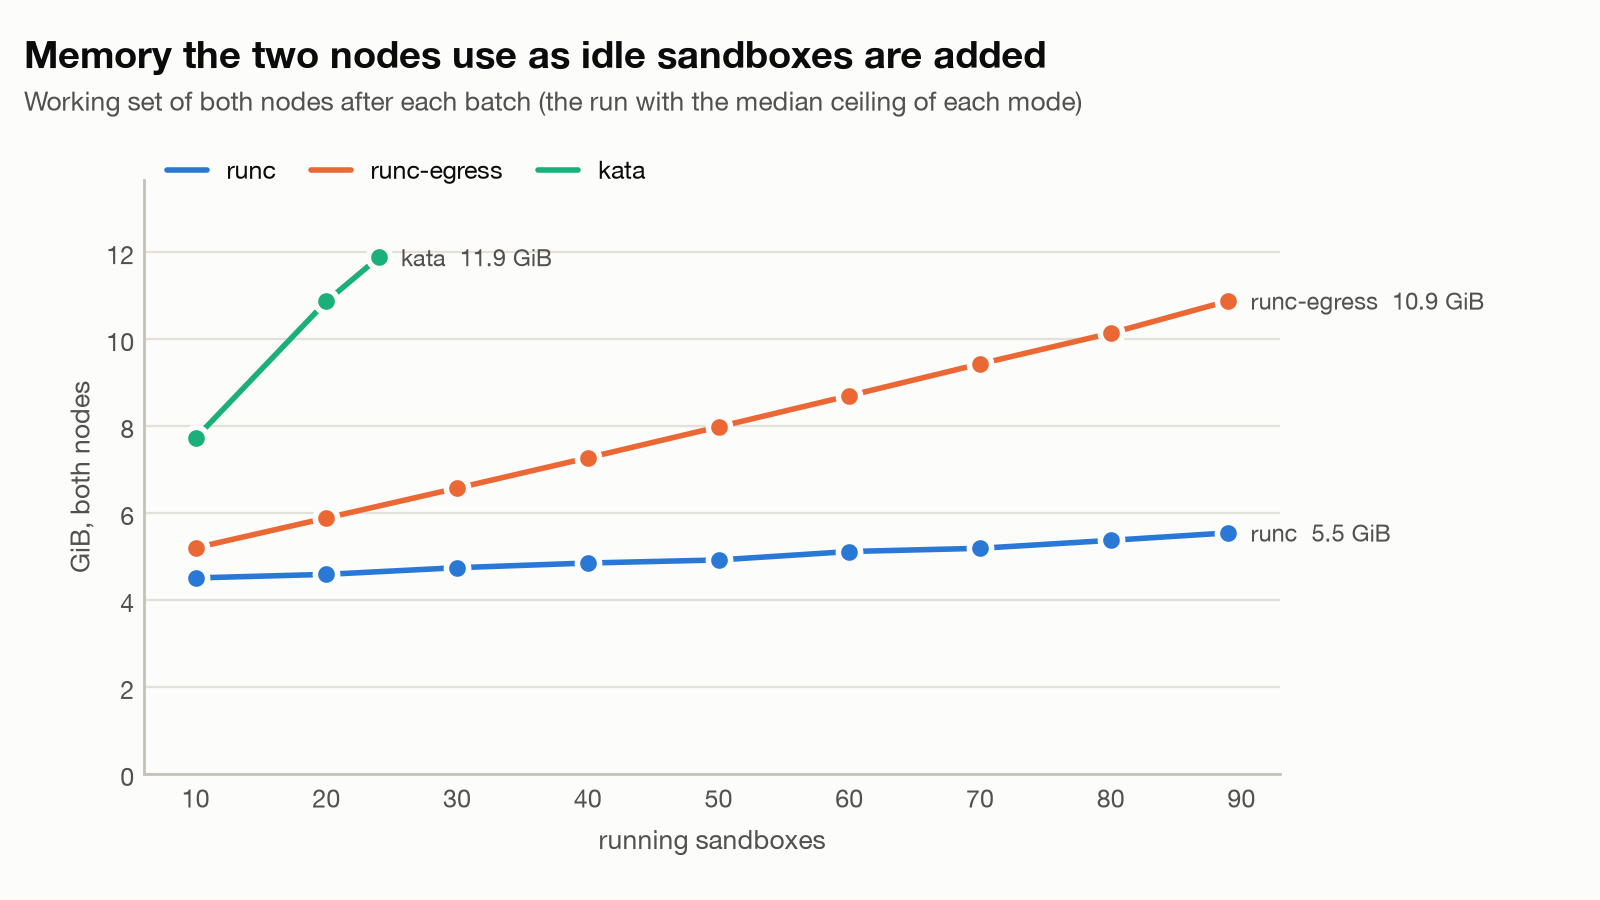
O sidecar de egress é invisível para o scheduler. Ele levou o pod de um sandbox ocioso de 5,7 para 69,0 MiB e custou aos nodes cerca de 60 MiB a mais por sandbox, e ainda assim o teto não se moveu. A 1.2.0 pode dar requests e limits ao sidecar em [egress] (config.py), mas a config da parte 2, assim como o padrão, não define nenhum dos dois. No teto, isso deu 5,3 GiB que nenhuma reserva cobria: inofensivo aqui, mas não em nodes com menos memória por slot de pod.
O Kata parou na CPU, porque o Kubernetes conta o overhead dele duas vezes. Toda execução terminou em 0/2 nodes are available: 2 Insufficient cpu. com 24 sandboxes na mediana, 12 por node (13 no node-b na execução 1), embora cada pod peça só 350m (os seus 100m mais os 250m da RuntimeClass, como o probes/kata_probe.py confirmou). O probes/kata_ceiling.py reproduziu isso com cerca de 3 CPUs livres por node em todas as visões que eu conferi (59,9% e 62,3% em requests); calculando a partir das contagens, o scheduler contou de 567 a 599m por pod Kata. Uma execução de controle sem OpenSandbox, o probes/kata_plain.py, parou nos mesmos 12 por node, com pods kata-qemu simples e com pods runc comuns sob uma RuntimeClass com o mesmo overhead.
A causa está no Kubernetes 1.37, não no OpenSandbox nem no Kata: desde a 1.36 o kubelet grava o request total de um pod, overhead incluído, no status dele, e o scheduler soma o overhead de novo para cada pod que já está no node, cerca de 600m cada, enquanto conta o pod sendo posicionado a 350m. É o kubernetes/kubernetes#143257, aberto desde 21 de outubro de 2026, com uma correção, a #143263, sem merge até 7 de novembro de 2026. Até que uma correção seja lançada, essa contabilidade, não a memória, define a densidade do Kata aqui.
A aritmética, o código-fonte do Kubernetes e as opções
O probes/kata_ceiling.py posicionou 24 sandboxes, 12 por node, sem nenhum pod terminando nem nominated e com todo pod Ready 2 a 3 segundos depois do binding; os specs dos pods, os status dos containers e o kubectl describe node deixavam 3.170 e 2.985m livres. O pod de um sandbox Kata não tem request de init container nem sidecar (probes/kata_probe.py). Os pods runc no probes/kata_plain.py carregavam os mesmos 250m e 160Mi de overhead e foram contados com 567 a 599m cada.
O mecanismo está verificado no código-fonte da v1.37.2, embora eu não tenha conferido qual patch da 1.37 o EKS roda. A gravação do status vem com InPlacePodLevelResourcesVerticalScaling, ligado por padrão desde a 1.36: 350m por pod Kata aqui, pelo código (eu não li esse campo no cluster; o controle com runc e o mesmo overhead reproduziu a contagem). No probe, os outros pods do node-a pediam 540m: 540 + 11 × 600 + 350 = 7.490m admite o 12º sandbox, e um 13º daria 8.090m, acima dos 7.910m alocáveis; os outros pods do node-b, com 725m, também deixam espaço para 12. No Teste 1, com os pods do Container Insights também nos nodes, os outros pods do node-b pediam cerca de 995m, então o modelo estrito admite só 11 ali (7.945m com o 12º); 12 entraram em todas as execuções e 13 na execução 1, todos em lotes de dez criados de uma vez. Um pod cujo status o kubelet ainda não gravou conta uma vez só, o que deixaria espaço para eles (inferido). O kubectl describe node conta cada pod uma vez, daí os 60%. Contada uma vez, a mesma CPU comportaria cerca de 21 e 20 por node, se a memória, os slots de pod ou a inicialização da VM não virassem o limite antes; isso é inferido, não medido.
Código-fonte do Kubernetes, v1.37.2: a contagem por pod do scheduler em types.go, a leitura do status em helpers.go e o overhead somado por cima em L167-L170, a contagem do pod que está chegando em fit.go, e a gravação do status pelo kubelet em kubelet_pods.go.
Três coisas aumentariam esse limite: a correção upstream, quando uma patch release do Kubernetes a incluir e o cluster rodar essa release; o feature gate desligado no kube-scheduler e nos kubelets, o que eu não conferi se o control plane gerenciado do EKS permite; ou uma RuntimeClass sem overhead, que você pode mudar, mas que faz o scheduler não reservar nada para a VM.
O kubelet não vê a memória de um sandbox Kata. Para um sandbox Kata ocioso, quatro números:
| Um sandbox Kata ocioso | MiB, mediana de 3 execuções |
|---|---|
| O que o scheduler reserva: o request de 128Mi mais os 160Mi da RuntimeClass | 288 |
| O que o kubelet reporta para o pod, o working set dele | 0 |
| Quanto o working set dos nodes cresceu por sandbox Kata adicionado | 324 |
| A memória residente dos processos da VM, somada: QEMU 364,5, virtiofsd 99,1, o shim do Kata 44,2 | 507,7 |
A soma é um limite superior: a memória residente conta uma página em todo processo que a mapeia, e o virtiofsd, um backend vhost-user, mapeia a memória do guest, então páginas que o QEMU detém podem contar duas vezes. O crescimento do working set dos nodes é a medida melhor. O gráfico mostra os quatro:
Como a memória das VMs foi lida
Os nodes rodam o Kata com sandbox_cgroup_only = false, sob o qual os processos de uma VM podem ser contabilizados fora do cgroup do pod, então eu medi o resultado: o VmmSampler (em common.py) colocou um pod busybox privilegiado em cada node (manifests/vmm-sampler.yaml) que lia todo processo QEMU, virtiofsd e shim do /proc a cada 5 segundos e associava cada VM ao seu pod (25 de 25, 24 de 24, 24 de 24).
Então um sandbox Kata ocioso custou aos nodes cerca de 324 MiB, 36 MiB a mais do que o reservado, cerca de 437 MiB em um node cheio de 12. Isso responde à pergunta que a parte 3 deixou em aberto: a diferença é menor do que sugeria comparar um processo QEMU (272 MiB na parte 2) com os 160Mi de overhead, porque a memória do guest vive na do QEMU e o request de 128Mi a cobre (inferido). O problema é o reporte: o kubelet contou 0 MiB para cada pod Kata, então qualquer coisa que observe os números de pod do kubelet vê um sandbox Kata como quase de graça. Aqui nada disso virou pressão de memória (11,9 GiB nos dois nodes no teto). Eram sandboxes ociosos, um ou dois minutos depois do boot; eu não medi um guest ocupado.
Uma execução Kata, lote por lote
$ uv run python 02_density.py
...
== kata, run 1 of 3 (sandboxes tagged run=1c618cbe19)
  [14:25:05] +1581.7s  batch  1:  10 running {'node-a': 5, 'node-b': 5}, 0 failed; nodes node-a 3.3 GiB, node-b 3.7 GiB; sandbox 0.0 MiB
  [14:25:21] +1597.3s  batch  2:  20 running {'node-a': 11, 'node-b': 9}, 0 failed; nodes node-a 5.7 GiB, node-b 4.5 GiB; sandbox 0.0 MiB
  [14:26:01] +1637.6s  batch  3:  25 running {'node-a': 12, 'node-b': 13}, 5 failed; nodes node-a 6.0 GiB, node-b 6.1 GiB; sandbox 0.0 MiB
  [14:26:04] +1640.9s  refused: cpu (0/2 nodes are available: 2 Insufficient cpu.)
  [14:26:29] +1665.7s  node side: a VM's processes hold 507.7 MiB (QEMU 364.5), the kubelet sees 0.0 MiB for its pod: 507.7 MiB it does not count (25 of 25 VMs paired by pod)
  [14:26:29] +1665.7s  deleting 25 sandboxes of this run
Um cluster cheio também não diz que está cheio. Todo create que falhou terminou na SandboxTimeoutException do SDK, com o motivo só nos eventos do scheduler. Pelo código, o SDK desiste depois dos seus 30 segundos padrão (connection_sync.py), e o servidor, depois de sandbox_create_timeout_seconds (60 por padrão, config.py), responde 504 KUBERNETES::POD_READY_TIMEOUT (kubernetes_service.py) e deleta o workload (L1260-L1283). Um control plane que enche um cluster precisa observar os eventos de scheduling e repetir ele mesmo os creates recusados.
Teste 2: Latência de criação, a frio e a partir de um Pool
A parte 3 cronometrou os seus creates do meu Mac via kubectl port-forward, o que funciona bem um de cada vez, mas não com 40. O 03_latency.py os cronometra a partir do osb-stress-client, um pod ao lado do servidor com o mesmo SDK, chamando o Service do servidor; o meu Mac o conduz com kubectl exec, fora do intervalo cronometrado.
Um create é cronometrado da chamada do SDK até SandboxSync.create() retornar com um sandbox saudável, com polling a cada 200 ms, o padrão do SDK (sandbox.py); as medições do Fast Sandbox faziam polling a cada 10 ms. Os sandboxes têm 250m e 512Mi, então 40 cabem de uma vez. Todo nível tem pelo menos 30 amostras depois de um aquecimento descartado; abaixo de 100, o p99 por nearest-rank é o máximo, então eu reporto o p95.
Os creates a frio iniciam um pod novo cada, com a imagem já nos dois nodes. Os a quente passam extensions={"poolRef": "osb-stress-pool"} e pegam um pod Ready de um Pool de 40 que não pode crescer, então nenhuma reposição começa durante uma rodada medida; entre as rodadas ele é reabastecido. Ele encheu 21,2 segundos depois do kubectl apply.
$ uv run python 03_latency.py
...
== create latency (ms; in-cluster client; p99 is the maximum below 100 samples, so p95)
  in flight   cold p50     p95    warm p50     p95
          1     1712.1  1995.7       130.4   233.5
          5     1371.2  1930.3       218.0   294.3
         10     1980.8  2879.6       428.3   782.7
         20     3487.3  4124.3       647.7  1195.2
         40     5297.0 26140.7      1283.5  1733.3
  via port-forward (laptop), x1: cold p50 2277.4 ms, warm p50 1245.0 ms (a different path: not comparable with the rows above)
  delivery of 84 (58 pod slots per node x 2 nodes = 116, minus 28 pods already placed (system pods), minus 4 headroom = 84: 84 instead of 100)
controller path allocated in 473.8 ms (median), in-cluster API path 4060.8 ms; published: 100 in 920 ms (no setup stated)| Simultâneos | p50 a frio | p95 a frio | p50 a quente | p95 a quente |
|---|---|---|---|---|
| 1 | 1.712 ms | 1.996 ms | 130 ms | 234 ms |
| 5 | 1.371 ms | 1.930 ms | 218 ms | 294 ms |
| 10 | 1.981 ms | 2.880 ms | 428 ms | 783 ms |
| 20 | 3.487 ms | 4.124 ms | 648 ms | 1.195 ms |
| 40 | 5.297 ms | 26.141 ms | 1.284 ms | 1.733 ms |
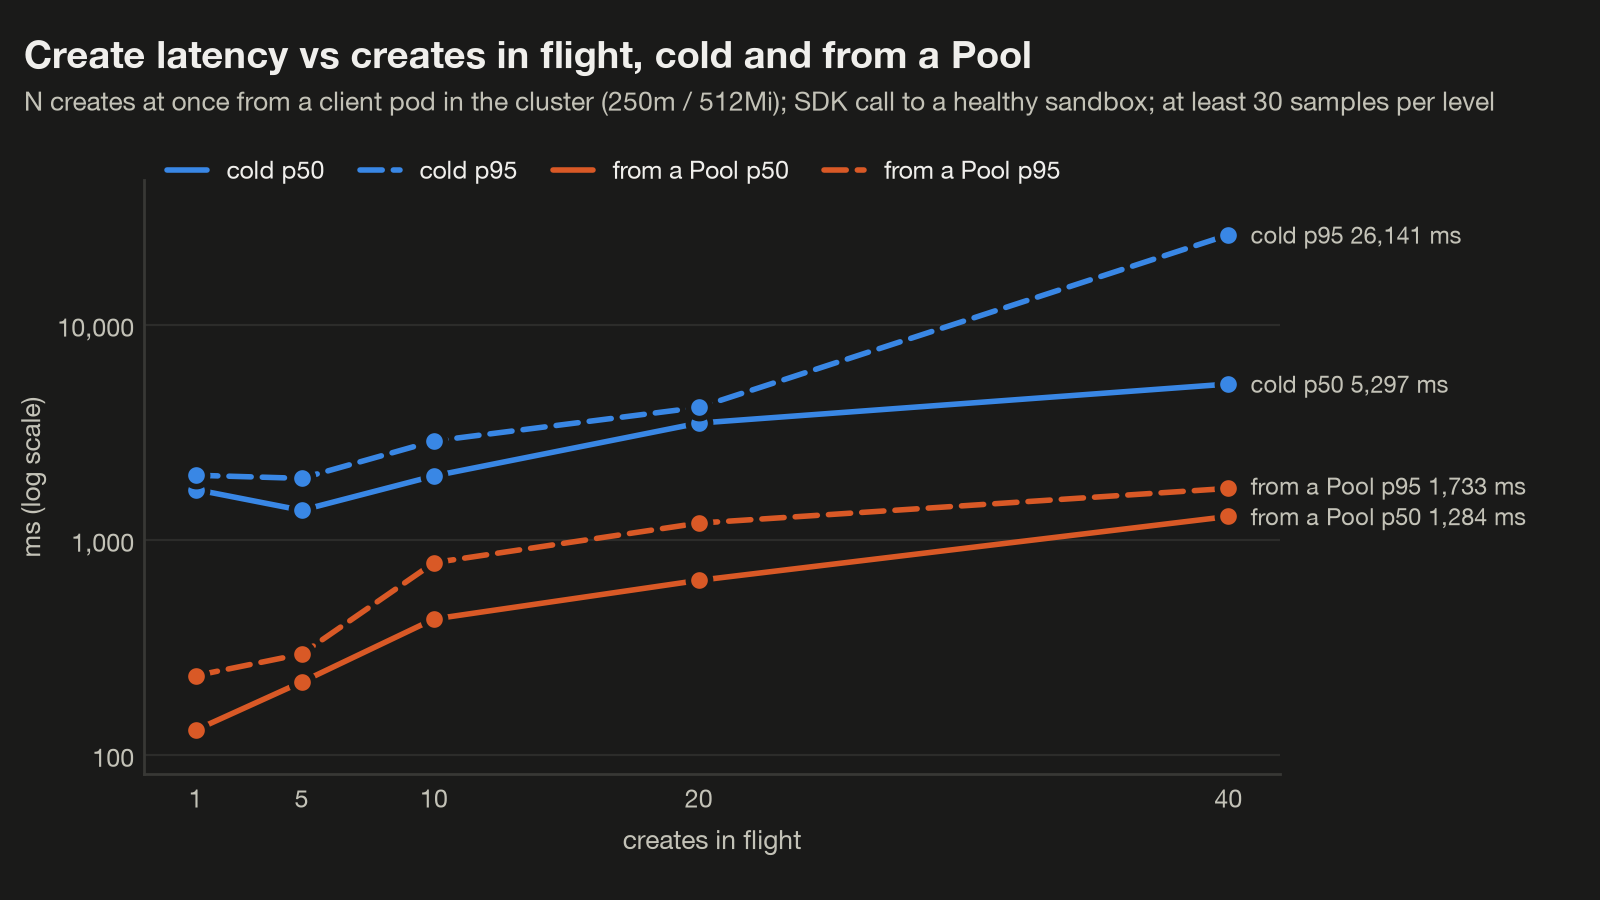
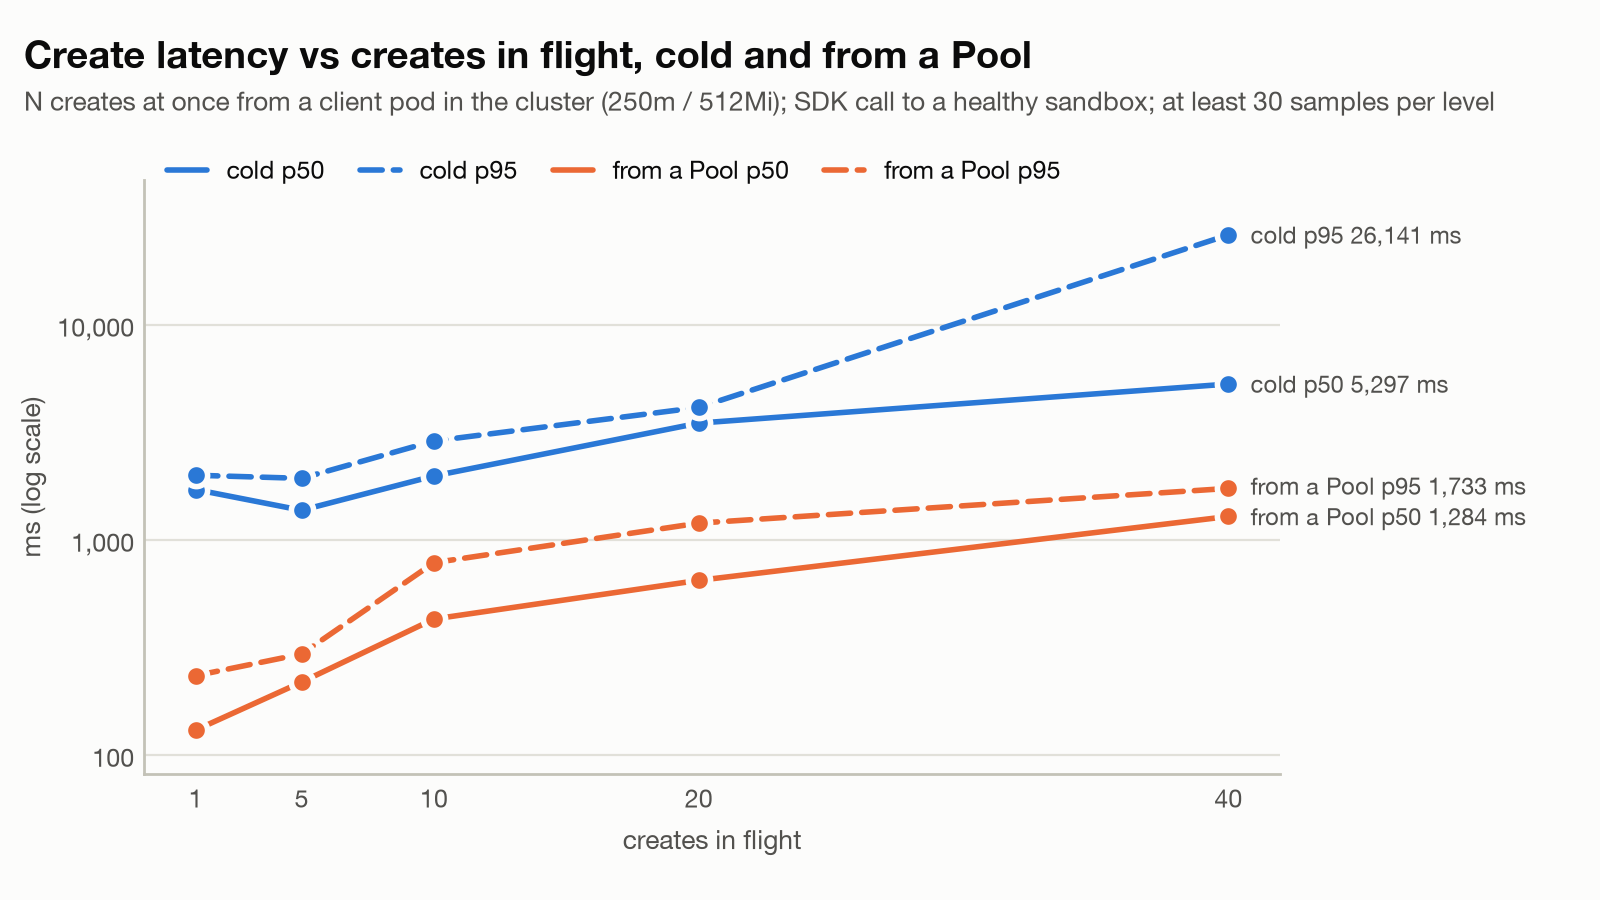
Os creates a frio ficam entre 1.371 e 1.981 ms na mediana até 10 simultâneos e depois sobem; a partir de um Pool eles crescem de forma constante, cerca de 30 ms por create simultâneo a mais. O p95 a frio com 40 é uma cauda: um quinto dos creates com 40 simultâneos levou mais de 10 segundos (24 de 120; 8 acima de 20 s; o mais lento, 31,2 s), e os resultados não dizem pelo que eles esperaram. O cliente, um processo Python, não chegou aos 800m que marcam uma rodada como limitada pelo cliente em nenhuma das 90 rodadas, e nenhum create falhou.
O par do port-forward. Para colocar ao lado da parte 3, creates únicos também rodaram do meu Mac pelo port-forward, com o mesmo formato e o mesmo SDK:
| Um create por vez, p50 | Cliente dentro do cluster | Meu Mac, pelo port-forward | Parte 3 (port-forward, 1 CPU / 2 GiB, mediana de 3) |
|---|---|---|---|
| A frio | 1.712 ms | 2.277 ms | 2,7 s |
| A quente, de um Pool | 130 ms | 1.245 ms | 1,3 s |
O forward adicionou 565 ms a um create a frio e 1.115 ms a um a quente. Então a maior parte do 1,3 segundo da parte 3 para um create a quente foi o caminho a partir do meu Mac, não o Pool (os pods dela eram maiores, então trate a coluna dela como contexto).
O controller sozinho. Com um BatchSandbox que tem um poolRef enviado direto para a API do Kubernetes, e sem lifecycle server, como o guia de instalação do post da AWS China o configura, um único claim foi alocado em 192 ms na mediana a partir do meu Mac, cerca de 99 ms sem o round trip dele: a mesma ordem de grandeza dos 230 ms do post, em hardware e runtime diferentes (Kata com Cloud Hypervisor em c5.metal lá, runc em m7i.2xlarge aqui).
O caminho do controller, claim por claim
O script aplica o BatchSandbox via kubectl proxy e o cronometra com um watch: dez claims únicos e um claim de dez por execução, três execuções. Cada um inclui o round trip do meu Mac até a API do EKS, 93 ms (mediana de dez GET /version).
| Caminho do controller, do meu Mac | Alocado, p50 | Ready, p50 | Post da AWS China |
|---|---|---|---|
| Um sandbox | 192 ms | 192 ms | Cerca de 230 ms |
| Dez em um objeto, até todos os dez | 195 ms | 195 ms | Uma média de cerca de 140 ms, fazendo o claim de 10 em lote |
Dez em um objeto levaram 195 ms no total; os 140 ms do post são uma média sobre um claim em lote, provavelmente por sandbox, não a mesma medida. Os 3,1 segundos a frio dele se comparam, de forma aproximada, com um create a frio sob runc de 1.712 ms pelo servidor completo aqui e com os creates Kata da parte 3, de 4,2 segundos.
Uma entrega de Pool contra 0,92 s. A documentação do controller dá 0,92 segundo para 100 sandboxes do pool como um BatchSandbox, sem setup declarado. Aqui 100 não cabem: 58 slots de pod por node em dois nodes, 116, menos os 28 pods já rodando (os 27 do Teste 1 mais o cliente dentro do cluster), menos 4 de folga, deixam 84. O script encheu um Pool de 84 pods pequenos (100m / 128Mi) em 56,8 segundos e os entregou de uma vez, duas vezes por execução: como um BatchSandbox com 84 réplicas, e como 84 creates a partir do cliente dentro do cluster.
| Entrega de 84 sandboxes a quente | Mediana de 3 execuções (amplitude) |
|---|---|
Controller: um BatchSandbox, todo pod alocado | 474 ms (272) |
| Controller: todo pod pronto | 474 ms (272) |
| Servidor: 84 creates de uma vez a partir do cliente dentro do cluster, todos respondidos; o cliente foi o limite em 3 de 3 execuções | 4.061 ms (2.204) |
| Publicado: 100, setup não declarado | 920 ms |
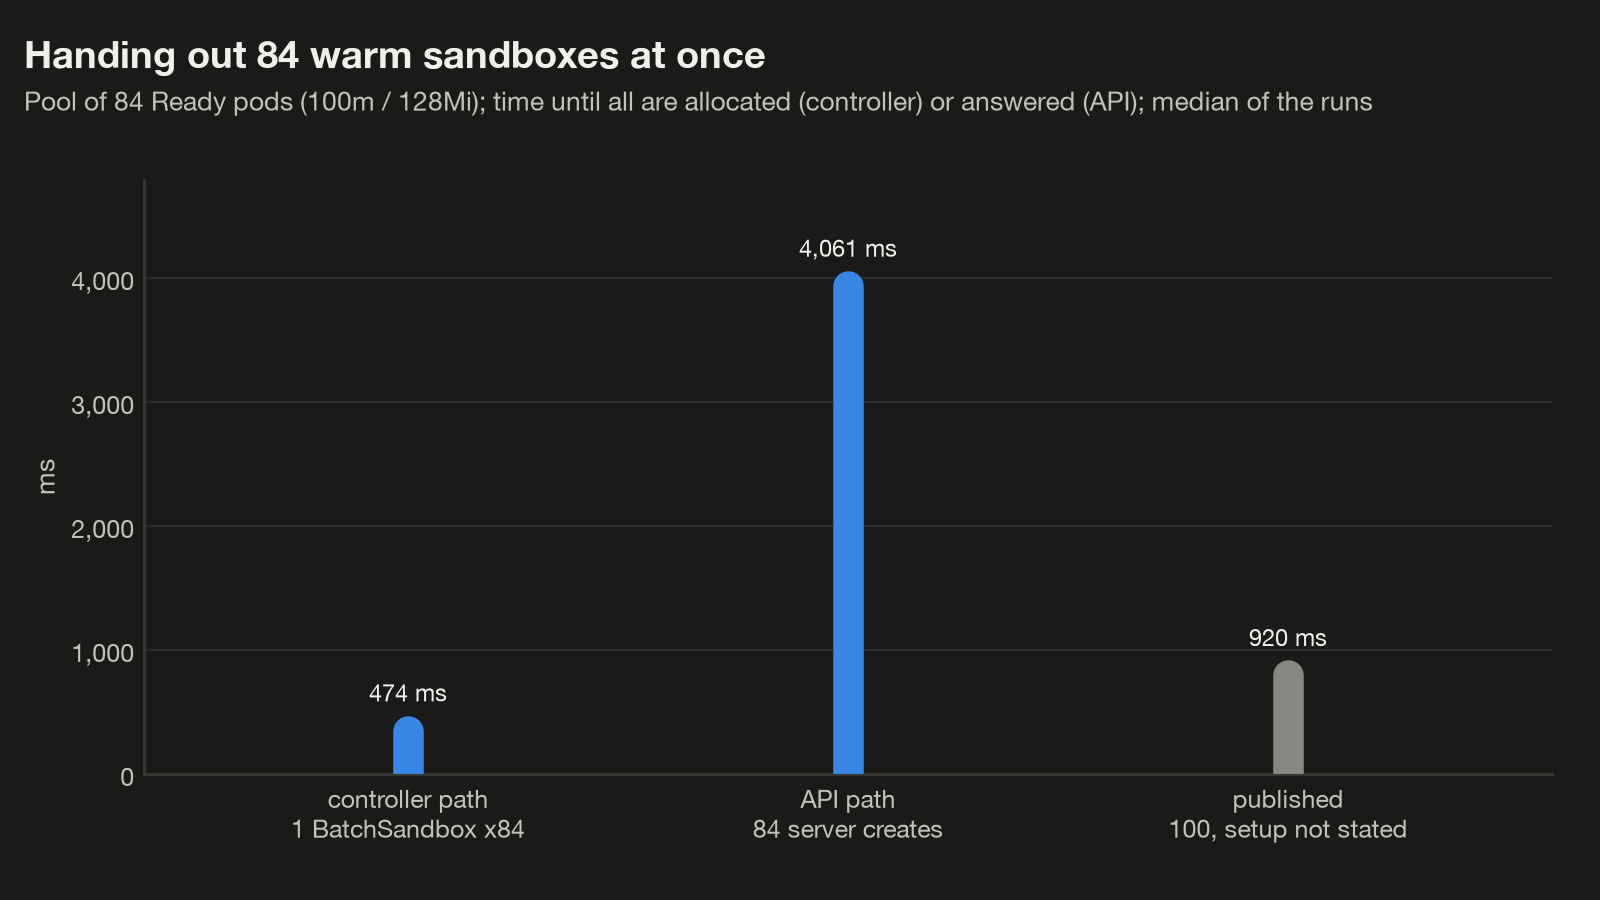
Pelo controller, todos os 84 foram alocados em 474 ms na mediana (de 464 a 736 ms nas execuções), com o round trip do meu Mac incluído: ao lado dos 0,92 segundo publicados para 100, isso nem confirma nem refuta o número. Pelo servidor, o cliente dentro do cluster foi o limite em 3 de 3 execuções, então os seus 4.061 ms são o limite do cliente, não do servidor.
Teste 3: Um pause storm
O 04_pause_storm.py cria 20 sandboxes (250m / 512Mi), faz cada um gravar 100 MiB de dados aleatórios, que não comprimem, e registrar o seu sha256, e então pausa os 20 de uma vez. Um snapshot é durável quando o seu SandboxSnapshot chega a Succeed (o commit Job enviou a imagem para o ECR); isso e o Paused são consultados aproximadamente a cada 3,4 segundos (uma pausa de 2 segundos mais a própria consulta), que é a resolução desses tempos. Depois os 20 são retomados de uma vez, cronometrados até um sandbox saudável e até um primeiro comando que confere o sha256. Três storms, pelo único repositório ECR da parte 3, do meu Mac pelo port-forward, como na parte 3.
$ uv run python 04_pause_storm.py
...
== storm 1 of 3: 20 sandboxes x 100 MiB (run=61aa1c764a)
  [15:26:25] +  19.6s  20 sandboxes created
  [15:26:30] +  25.4s  20 sandboxes hold 100 MiB of random data each
  [15:26:54] +  49.3s  durable: first after 18.1 s, all 20 after 21.4 s; all Paused after 21.4 s
  [15:26:57] +  51.9s  ECR: 20 image(s) for this storm, 2.96 GB compressed
  [15:27:08] +  62.8s  resumed 20: healthy p50 6612.1 ms, p95 9744.6; data intact in 20
...
== pause storm
  every snapshot durable after 21.4 s (median of 3, spread 3.0 s); all Paused after 21.4 s
resume to healthy p50 7300.6 ms (median of the runs' p50)| Por storm de 20 | Mediana de 3 storms (amplitude) |
|---|---|
| Primeiro snapshot durável | 14,5 s |
| Todos os snapshots duráveis | 21,4 s (3,0) |
Todos os sandboxes Paused | 21,4 s (0,5) |
| Um commit Job, p50 | 18,0 s |
| Imagens de snapshot no ECR | 20, 2,96 GB comprimidos |
| Retomada dos 20, até um sandbox saudável, p50 | 7.301 ms (2.140) |
| Retomada dos 20, até o primeiro comando, p95 | 10.301 ms (651) |
| Dados intactos depois da retomada | 60 de 60 |
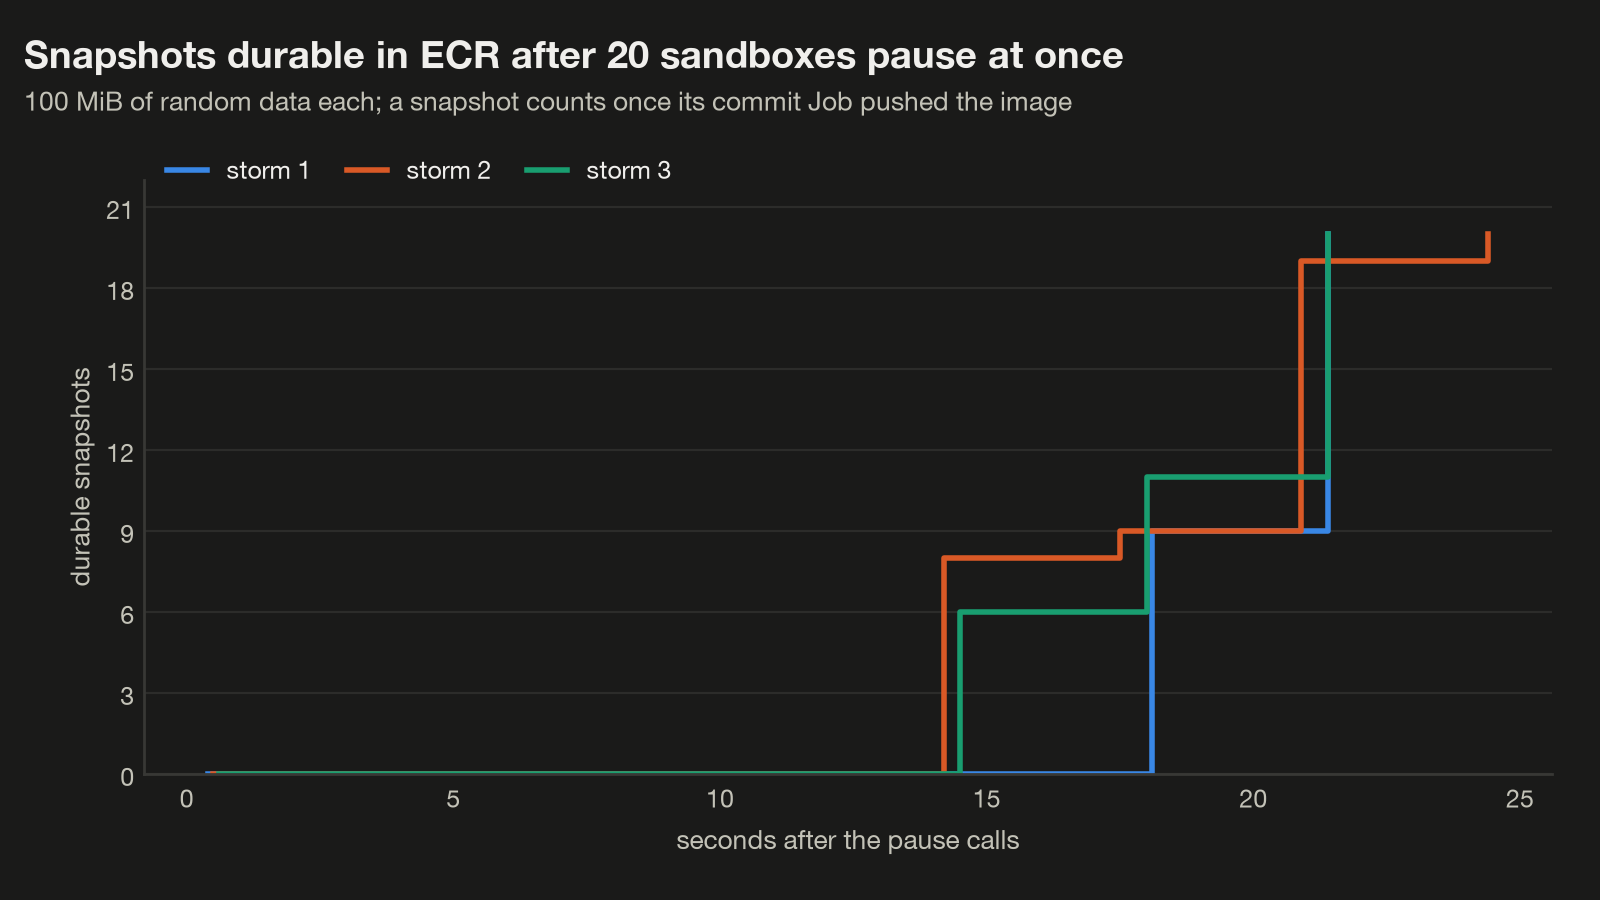
O primeiro snapshot ficou durável 14,5 segundos depois das chamadas de pausa e o último aos 21,4: os 20 commit Jobs rodaram lado a lado, 11 e 9 nos dois nodes, cada um levando 18,0 segundos na mediana, contra 5 da pausa única da parte 3. Todas as 60 retomadas trouxeram os dados de volta, em 7.301 ms até ficarem saudáveis na mediana, contra 5,3 segundos da retomada única da parte 3.
Os pushes para o ECR saem pelo NAT gateway: a VPC da parte 2 tem um gateway endpoint do S3, que os downloads de layers do ECR podem usar, mas nenhum endpoint do ECR. O que o CloudWatch viu está abaixo.
Teste 4: A escada de overhead do egress
O 05_egress_ladder.py envia as mesmas requisições passando por uma camada a mais de controle de egress a cada degrau:
| Degrau | O que está no caminho |
|---|---|
none | Sem network policy, então sem sidecar |
dns | Uma policy deny-by-default que permite o host do echo, com o servidor no modo de egress dns: o proxy DNS do sidecar filtra nomes, nada filtra pacotes |
dns+nft | O mesmo no modo dns+nft, o padrão do Helm chart do servidor (values.yaml) e a configuração da série desde a parte 2; o padrão embutido do servidor é dns (config.py): os endereços resolvidos também vão para o nftables, e uma conexão para qualquer outro endereço é descartada |
mitm | dns+nft mais o proxy de credenciais: o mitmproxy assume toda conexão para as portas 80 e 443 |
vault | mitm mais um binding do Credential Vault para o host do echo que injeta um header apiKey com um valor fictício |
sigv4 | O addon da parte 5 reassinando o GetCallerIdentity do STS com as credenciais de curta duração do broker, com o sandbox guardando só placeholders |
Os degraus 1 a 5 chamam o echo-stress, o programa de echo da parte 4 em três réplicas de 500m (limite de 1 CPU cada), por HTTP simples dentro do cluster, a partir de um sandbox novo de 2 CPU / 2 GiB por execução: 50 requisições de aquecimento, 500 uma de cada vez, depois 16 clientes por 30 segundos. Toda requisição abre uma nova conexão depois de uma consulta de nome, como um curl por requisição, e a consulta é cronometrada separadamente; uma acima de 10 segundos conta como falha.
Uma execução é marcada como limitada pelo alvo quando alguma réplica do echo (um processo Python) teve média de 800m na fase de carga, limitada pelo cliente quando o gerador de carga teve média de 1.600m das suas 2 CPUs, e desconhecida sem duas leituras do contador com 10 segundos de distância (Passo 3).
O degrau SigV4 chama o STS de verdade, já que o addon da parte 5 derruba qualquer host que não seja da AWS, com o boto3 mantendo as suas conexões abertas; o aws-floor faz as mesmas chamadas sem assinatura a partir de um sandbox sem sidecar, e a AWS responde 403.
$ uv run python 05_egress_ladder.py
...
== the ladder (medians over the runs)
  rung        1-at-a-time p50      p99    req/s  load p99  sidecar RSS             vs dns+nft
  none                    5.6      7.9   2590.6       7.9         None 18016.1% req/s, -99.7% p99 ?
  dns                     2.5      4.0   4342.5       5.6          8.6 30267.1% req/s, -99.8% p99 * ?
  dns+nft                62.2    148.0     14.3    2271.9         10.3                      - ?
  mitm                   67.5    149.9     14.3    2230.2         64.3  0.0% req/s, -1.8% p99
  vault                  62.4    150.6     14.2    2179.8         64.5 -0.7% req/s, -4.1% p99 ?
  aws-floor               2.8      5.0    819.8      21.5         None 5632.9% req/s, -99.1% p99
  sigv4                   8.1     11.0    133.1     448.4         60.4 830.8% req/s, -80.3% p99
  * an echo replica (one Python process, limit 1000m) reached 800m: that rung's req/s is the echo server's ceiling, not the path's (per-replica numbers in results/ladder.json)
  c the load generator's CPU reached 1600m: the client, not the path, was the cap
  ? in a run of that rung the CPU over the load phase is unknown (counter readings under 10 s apart): whether the echo server or the client was the cap is not known, not ruled out
  published (dns+nft + transparent MITM vs dns+nft, short HTTPS requests to public sites): -47.6% req/s, +91.9% mean, +595.2% p99, ~5x RSS
the sigv4 rung includes AWS's own latency; aws-floor is the unsigned call without a sidecar| Degrau | Consulta, p50 | Uma de cada vez, p50 / p99 | Requisições por segundo, 16 clientes | p50 / p99, 16 clientes | Pico de RSS do sidecar | Flags |
|---|---|---|---|---|---|---|
none | 5,1 ms | 5,6 / 7,9 ms | 2.591 | 5,6 / 7,9 ms | Sem sidecar | CPU desconhecida em 1 de 3 |
dns | 0,3 ms | 2,5 / 4,0 ms | 4.342 | 3,2 / 5,6 ms | 8,6 MiB | echo server como limite em 1 de 3; CPU desconhecida em 1 de 3 |
dns+nft | 59 ms | 62 / 148 ms | 14,3 | 1.038 / 2.272 ms | 10,3 MiB | CPU desconhecida em 1 de 3 |
mitm | 63 ms | 68 / 150 ms | 14,3 | 1.029 / 2.230 ms | 64,3 MiB | nenhuma |
vault | 56 ms | 62 / 151 ms | 14,2 | 1.039 / 2.180 ms | 64,5 MiB | CPU desconhecida em 1 de 3 |
A consulta é a mediana dos p50 das execuções; as colunas de uma de cada vez são agregadas, e as de 16 clientes, a mediana das execuções. Nenhuma requisição falhou.
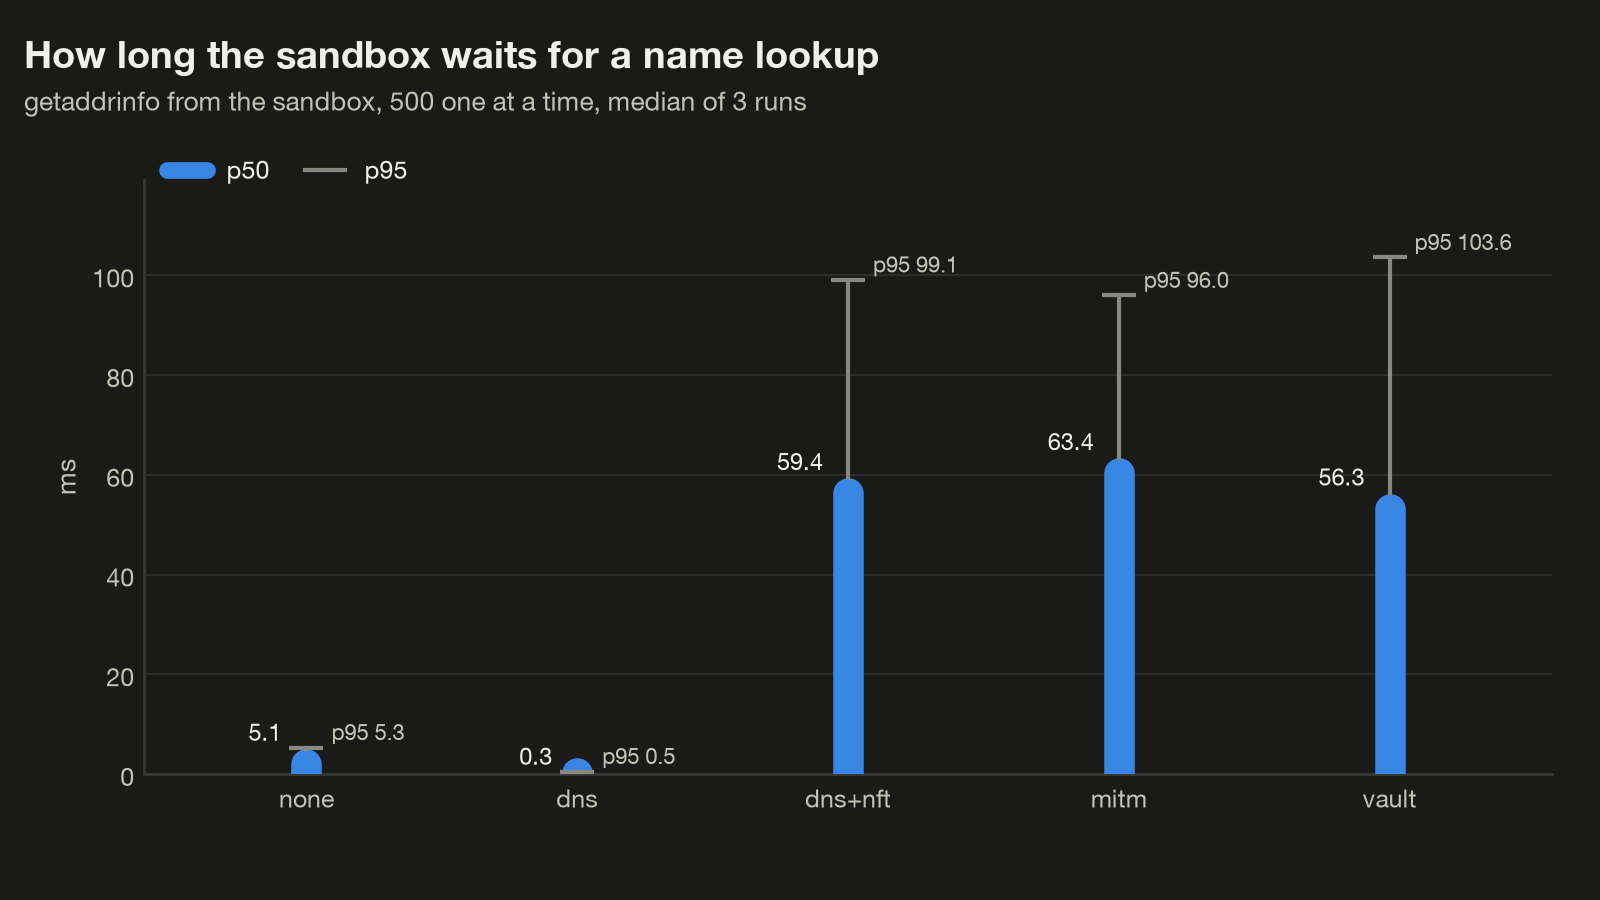
No modo dns+nft uma consulta de nome custa cerca de 60 ms, e esse é o maior degrau da escada. Uma consulta pelo sidecar dns+nft levou 59 ms na mediana, contra 0,3 ms pelo mesmo sidecar no modo dns e 5,1 ms sem sidecar. (O sidecar dns provavelmente supera a ausência de sidecar porque responde ele mesmo às tentativas da search list do resolver; inferido.)
O código explica de onde isso vem: no modo dns+nft o proxy DNS do sidecar grava os endereços de cada resposta permitida no nftables antes de responder, iniciando um novo processo nft -f - e esperando ele terminar, sob um mutex por sidecar, esteja ou não o endereço já no set. Não há cache, e nenhuma configuração resolve isso, a não ser o modo que vale para o servidor inteiro, descrito abaixo.
Então as consultas fazem fila, uma execução de nft por vez. Com 16 clientes abrindo uma nova conexão por requisição, todos os três degraus com dns+nft, incluindo mitm e vault, se estabilizaram em 14,2 a 14,3 requisições por segundo, contra 2.591 sem sidecar. Isso é uma fila única: pela lei de Little, 16 clientes a 14,3 por segundo esperam 1.119 ms cada, em média, e a média medida foi de 1.102 ms (p50 1.038 ms). A CPU do sidecar teve pico de só 57m, contra 2.102m no modo dns.
Um probe no sidecar, o probes/nft_probe.py, e o código-fonte do kernel situam o tempo em um lugar só. O add, delete e re-add do nft levaram de 48,8 a 60,0 ms na mediana, em incrementos de 10 ms, quase tudo no close() do seu socket netlink, que espera um grace period de RCU depois de um commit que mudou algo; um commit que não muda nada levou 1,7 ms.
O código, o probe e o código-fonte do kernel
O caminho no código, na 1.2.0. No modo dns+nft o proxy DNS do sidecar grava os endereços de toda resposta permitida no nftables antes de responder: forwardAndReply chama o callback de IP resolvido e só depois writeReply (proxy.go). O callback inicia um novo processo nft -f - e espera ele terminar (manager.go), com um script que adiciona, deleta e readiciona cada endereço com o seu timeout (dynamic.go); o add, delete e add vieram com a #1786 para que um endereço renovado ganhe uma nova expiração. Tudo isso roda sob um mutex por sidecar (dynamic.go), esteja ou não o endereço já no set: não há cache, nem verificação antes, nem configuração para isso. Até 7 de novembro de 2026, eu não encontrei nenhuma issue ou pull request upstream sobre isso, e a main não tinha mudado esse código desde a 1.2.0.
O probes/nft_probe.py, rodado no sidecar de egress de um sandbox, identificou para onde vai o tempo. Em uma tabela nft descartável, um nft list somente leitura levou 2,9 ms na mediana, um nft -f - sem nada para fazer, 1,5 ms, e um commit que não muda nada, 1,7 ms, mas o próprio add, delete e re-add de um elemento pelo sidecar levou 48,8 ms com execuções a 50 ms de distância e 60,0 ms uma logo após a outra, quase sempre em incrementos de 10 ms. Sob strace, quase todo o tempo de cada renovação ficou em um único close() (60 a 100 ms), que, pelo código do kernel abaixo, é o socket netlink do nft (o strace registrou só os nomes das syscalls), e uma consulta permitida a partir do mesmo sandbox levou 70,0 ms, contra 0,2 ms para um nome negado.
O código-fonte do kernel explica o close. Um commit com mudanças reais passa a sua limpeza para um worker que começa com synchronize_rcu(). Quando o nft termina e fecha o seu socket netlink, o nf_tables espera esse worker antes que o close retorne, então o close espera um grace period de RCU; um commit vazio ou uma leitura não deixa nada para esperar. No kernel do node, com CONFIG_HZ=100, os grace periods terminam em ticks de 10 ms, que é de onde vêm os incrementos; essa última parte é inferida. Três mudanças tirariam a espera do caminho da resposta: uma conexão netlink mantida aberta entre as atualizações, para que nenhuma liberação de socket siga cada commit; várias respostas agrupadas em uma única execução do nft; ou nenhuma gravação quando o endereço já está no set com lease de sobra.
Código-fonte do kernel, mainline v6.18 (o node roda o build 6.18 da Amazon, cujo próprio código-fonte eu não li): a limpeza adiada do commit em nf_tables_api.c e o seu synchronize_rcu(); o notifier de release em af_netlink.c, que faz o flush desse trabalho incondicionalmente desde o 9f6958ba2e90 (2024), depois que o 2c9f0293280e (2023) o adicionou.
Quem paga isso, e quem não paga. O custo é por consulta, não por requisição: toda consulta de um nome permitido cuja resposta traz um endereço espera uma execução do nft, na fila atrás de qualquer outra no mesmo sandbox, enquanto um nome negado, respondido pelo próprio proxy DNS, levou 0,2 ms. Qualquer coisa que resolva o nome antes de cada conexão paga isso toda vez: curl em um loop, um comando que resolve a cada início, requests.get() sem uma Session, um fan-out de novas conexões. Um cliente que mantém ou faz pool de conexões (boto3, requests.Session, HTTP/2, gRPC) paga uma vez por conexão que abre, não por requisição; um com cache de resolver paga a cada cache miss; um que se conecta a um endereço permitido por uma regra de IP ou CIDR nunca paga. O degrau SigV4, com o boto3 mantendo a sua conexão sob dns+nft, levou 6,8; 8,1 e 8,8 ms por chamada na mediana por execução, sem o termo de 60 ms.
A única configuração vale para o servidor inteiro. O modo de egress dns, o padrão embutido do servidor (o Helm chart vem com dns+nft), pula o nftables: as consultas levaram 0,3 ms e 16 clientes chegaram a 4.342 requisições por segundo (echo server como limite em 1 de 3; CPU desconhecida em 1 de 3). O preço é a verificação no nível de pacote e o proxy de credenciais, para todos os sandboxes do servidor. Sem nftables nenhum, uma conexão direta para um endereço IP, ou para um resolvido por fora do proxy DNS do sidecar (via DNS-over-HTTPS, por exemplo), não é descartada; regras de IP, de CIDR e com escopo de porta não são aplicadas (parte 4); e o bloqueio de DNS-over-TLS deixa de existir (o bloqueio de DoH também, onde ele está habilitado; esta série não o habilita). O servidor rejeita credentialProxy.enabled com um 400 no modo dns e o vault do sidecar recusa gravações, então nenhum sandbox pode usar o vault. Verificado (código): nft.go, validators.py, vault.go; o guia do vault diz o mesmo.
O custo do próprio proxy, com a consulta retirada. Sob carga, mitm contra dns+nft compara duas cópias da mesma fila, então os números de 16 clientes da escada não dizem nada sobre o proxy. Duas medições contornam isso. Uma de cada vez, o tempo médio de requisição de uma execução menos a sua consulta média é o connect, o GET e o close; medianas das execuções: 1,14 ms sem sidecar, 1,50 ms em dns+nft, 4,84 ms pelo proxy e 5,06 ms com o vault. Então o proxy transparente adiciona cerca de 3,3 ms a cada nova conexão, e o header do vault, cerca de 0,2 ms a mais.
Sob carga, 05_egress_ladder.py --resolve-once consulta o host do echo uma vez por execução e envia toda requisição para aquele endereço. Ele rodou none, dns+nft, mitm e vault três vezes cada, rotulados como /cached, com um timeout de requisição de 4 segundos contra os 10 da escada principal, o que só decide quão lenta uma conexão pode ser antes de contar como falha.
A tabela final da execução resolve-once
$ uv run python 05_egress_ladder.py --resolve-once
...
== the ladder (medians over the runs)
  rung                1-at-a-time p50      p99    req/s  load p99  sidecar RSS             vs dns+nft
  none/cached                     0.4      2.4   5675.5       3.1         None   1.9% req/s, 0.0% p99 *
  dns+nft/cached                  0.4      2.4   5567.8       3.1          4.0                      - *
  mitm/cached                     3.3      5.5    384.9      68.0         64.9 -93.1% req/s, 2093.5% p99 ?
  vault/cached                    3.5      5.8    359.1      71.0         64.8 -93.6% req/s, 2190.3% p99 ?
  none/cached@8                   0.4      2.4   5793.4       2.9         None   0.9% req/s, 0.0% p99 ?
  dns+nft/cached@8                0.4      2.4   5744.3       2.9          3.8                      - *
  mitm/cached@8                   3.3      5.6    340.2      33.0         64.9 -94.1% req/s, 1037.9% p99
  vault/cached@8                  3.6      6.1    313.9      47.6         64.4 -94.5% req/s, 1541.4% p99
  * an echo replica (one Python process, limit 1000m) reached 800m: that rung's req/s is the echo server's ceiling, not the path's (per-replica numbers in results/ladder.json)
  c the load generator's CPU reached 1600m: the client, not the path, was the cap
  ? in a run of that rung the CPU over the load phase is unknown (counter readings under 10 s apart): whether the echo server or the client was the cap is not known, not ruled out
  published (dns+nft + transparent MITM vs dns+nft, short HTTPS requests to public sites): -47.6% req/s, +91.9% mean, +595.2% p99, ~5x RSS
  --resolve-once: one lookup per run, then every request to the cached address (no lookup in the times); request timeout 4 s (the main ladder: 10 s)
  none/cached        lookup 14.2 ms; one at a time mean 1.0 ms (main ladder, connect+GET+close: 1.14 ms); first failure per run (s after the lookup) [None, None, None] [None, None, None]; kinds -
  dns+nft/cached     lookup 58.5 ms; one at a time mean 1.0 ms (main ladder, connect+GET+close: 1.5 ms); first failure per run (s after the lookup) [None, None, None] [None, None, None]; kinds -
  mitm/cached        lookup 52.8 ms; one at a time mean 3.9 ms (main ladder, connect+GET+close: 4.84 ms); first failure per run (s after the lookup) [None, None, None] [None, None, None]; kinds -
  vault/cached       lookup 60.9 ms; one at a time mean 4.1 ms (main ladder, connect+GET+close: 5.06 ms); first failure per run (s after the lookup) [None, None, None] [None, None, None]; kinds -
  none/cached@8      lookup 14.1 ms; one at a time mean 1.0 ms (main ladder, connect+GET+close: 1.14 ms); first failure per run (s after the lookup) [None] [None]; kinds -
  dns+nft/cached@8   lookup 42.8 ms; one at a time mean 1.0 ms (main ladder, connect+GET+close: 1.5 ms); first failure per run (s after the lookup) [None] [None]; kinds -
  mitm/cached@8      lookup 76.4 ms; one at a time mean 3.9 ms (main ladder, connect+GET+close: 4.84 ms); first failure per run (s after the lookup) [None] [None]; kinds -
  vault/cached@8     lookup 32.3 ms; one at a time mean 4.2 ms (main ladder, connect+GET+close: 5.06 ms); first failure per run (s after the lookup) [None] [None]; kinds -
  * at 16 clients a cached rung was target-bound: its ratio there is a bound; the @8 rows are the pair again with 8 clients (one run each)
Uma passada com 8 clientes concordou (340 contra 5.744 requisições por segundo, uma execução cada). Uma de cada vez, a variante concordou com a separação acima (cerca de 2,9 ms para o proxy pelas suas médias), e as suas consultas únicas levaram de 46,3 a 71,5 ms sob dns+nft, contra 14,0 a 14,5 ms sem sidecar.
| Variante resolve-once, 16 clientes | Requisições por segundo | p50 / p99 | Pico de RSS do sidecar | Flags |
|---|---|---|---|---|
none/cached | 5.676 | 1,2 / 3,1 ms | Sem sidecar | echo server como limite em 3 de 3 |
dns+nft/cached | 5.568 | 1,2 / 3,1 ms | 4,0 MiB | echo server como limite em 3 de 3 |
mitm/cached | 385 | 40 / 68 ms | 64,9 MiB | proxy como limite em 3 de 3 (a CPU do cliente ou de uma réplica do echo desconhecida em 2) |
vault/cached | 359 | 43 / 71 ms | 64,8 MiB | proxy como limite em 3 de 3 (a CPU do cliente desconhecida em 1) |
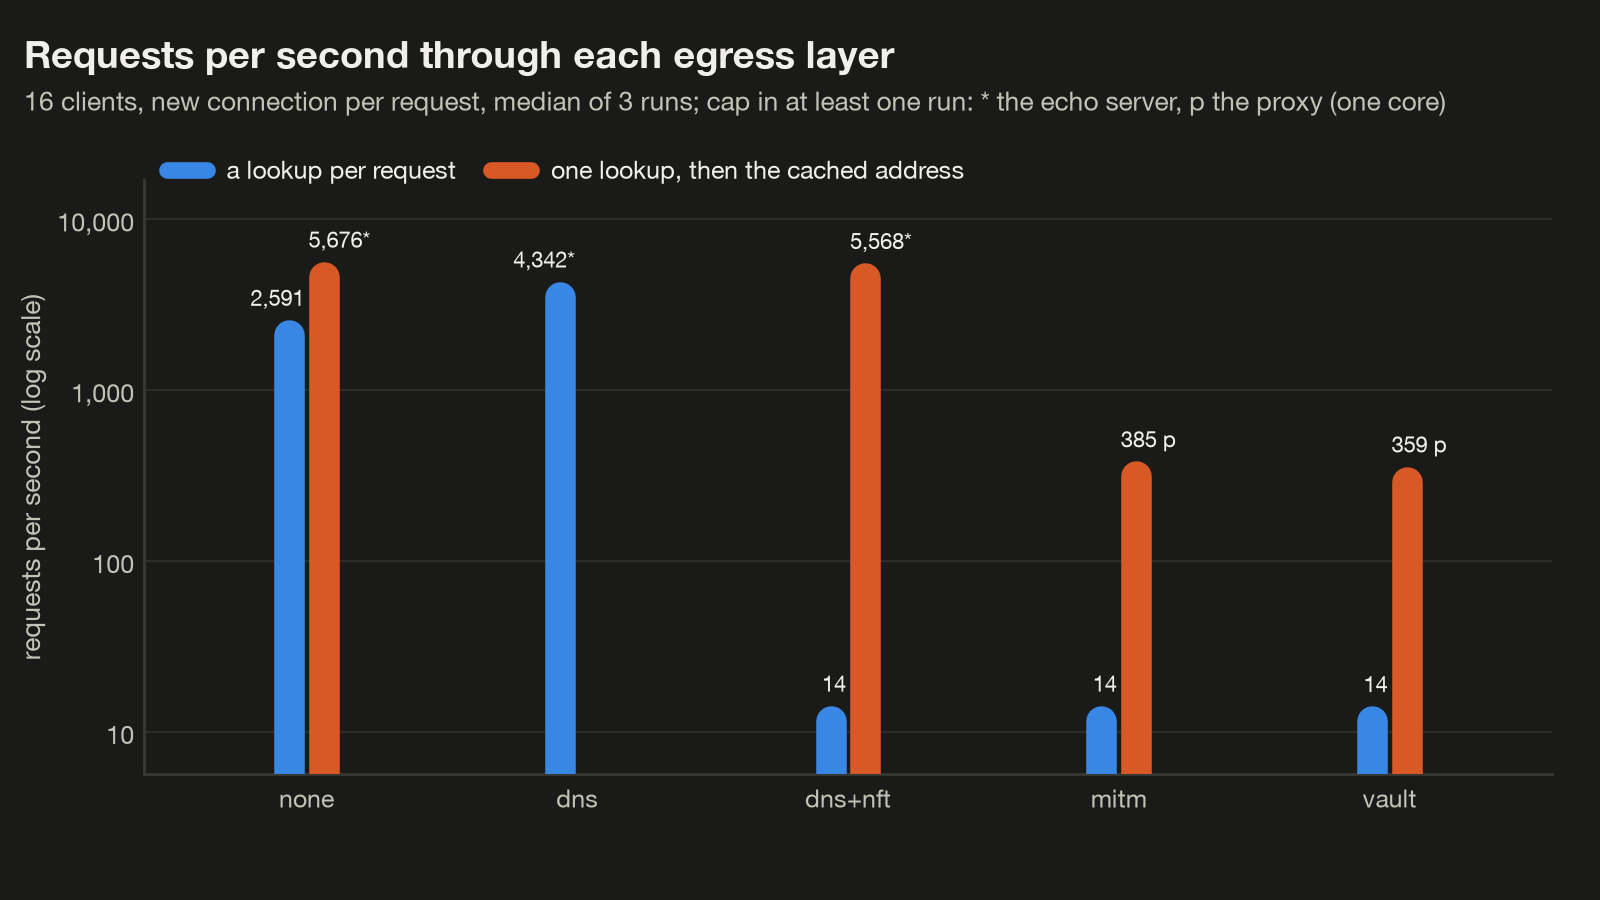
Sem a consulta, o proxy transparente é o limite. O dns+nft/cached chegou a 5.568 requisições por segundo, o teto do echo server, não do caminho (limitado pelo alvo em 3 de 3 execuções), então o próprio nftables custou pouco demais por conexão para aparecer. O mitm/cached conseguiu 385 (p99 68 ms) e o vault/cached, 359: -93% contra o dns+nft/cached, um limite inferior para a queda, já que o echo server limitou essa base. O proxy é um processo mitmdump (launch.go) em um sidecar sem limite de CPU, já que o servidor deixa os recursos de fora quando não estão definidos (egress_helper.py), e o seu Python roda em um núcleo: sob carga o sidecar teve média de 1.024 a 1.051m (uma execução de vault: pico de 1.031m), limitado pelo proxy em todas as execuções, enquanto o gerador de carga usou de 57 a 64m e as réplicas do echo, de 51 a 59m. Nenhuma requisição falhou.
Contra os números publicados. As notas de benchmark comparam dns+nft com e sem o proxy transparente. O cenário curto delas envia requisições HEAD por HTTPS para 40 sites públicos ao mesmo tempo, 400 no total, e os autores consideram a cauda sensível a timing nesse tamanho; o número de memória vem de um cenário de download separado. O meu usa a variante sob carga e a separação sem consulta uma de cada vez:
mitm contra dns+nft | Publicado: HTTPS, 40 sites públicos de uma vez | Meu: HTTP no cluster, resolve-once, 16 clientes (cada um, um limite inferior: o echo server limitou a base) | Meu: uma de cada vez, consulta retirada |
|---|---|---|---|
| Requisições por segundo | -47,6% | -93% ou mais | |
| Latência média | +91,9% | +1.433% ou mais | +3,3 ms por conexão (de 1,50 para 4,84 ms) |
| p50 | +5,2% | +3.267% ou mais | |
| p99 | +595,2% | +2.094% ou mais | |
| Memória do sidecar, pico | Cerca de 5x, cenário de download | +61 MiB (64,9 contra 4,0 MiB) | +54 MiB na escada principal sob carga (64,3 contra 10,3 MiB) |
A comparação de 16 clientes da escada principal (0% de requisições por segundo) é limitada pela consulta dos dois lados, então fica de fora. A deles é HTTPS para sites públicos, onde o handshake TLS e a outra ponta dominam cada requisição; aqui a outra ponta responde em 0,4 ms, então o trabalho do próprio proxy é a maior parte de cada requisição e a queda é muito maior; a deles também pagou a execução do nft por consulta dos dois lados, o que dilui a diferença (inferido).
O degrau SigV4, contra o piso sem assinatura:
GetCallerIdentity do STS, uma de cada vez, boto3 mantendo a sua conexão | p50 | p95 |
|---|---|---|
aws-floor: sem assinatura, sem sidecar, a AWS responde 403 | 2,8 ms | 3,2 ms |
sigv4: chaves placeholder, reassinadas pelo addon sob dns+nft, a AWS responde 200 | 8,1 ms | 9,4 ms |
A diferença, 5,3 ms na mediana, é todo o caminho de egress (o proxy, os headers do vault, a assinatura do addon e a AWS conferindo essa assinatura), não só o addon, sem consulta em uma conexão mantida. Nenhuma chamada assinada falhou.
Teste 5: Carga no control plane
O lifecycle server é uma réplica com os valores da parte 2: requests de 250m de CPU e 512Mi, limits de 1 CPU e 2 GiB, SQLite em um volume EBS. O controller também é uma réplica. O 06_control_plane.py os mede de três formas, três vezes:
- Ocioso: 30 segundos sem nada acontecendo, o piso.
- Uma rampa de API: com 20 sandboxes ociosos no lugar, um Job ao lado do servidor roda 1, 4, 16 e 64 clientes por 30 segundos cada, cada cliente em uma conexão keep-alive alternando uma listagem (
GET /v1/sandboxes?pageSize=20) e um poll de status de um sandbox. Ele chama o Service de dentro do cluster, porque do meu Mac o que seria medido é o port-forward. - Ondas de create e delete: 10, 20 e 40 sandboxes criados de uma vez do meu Mac, depois deletados de uma vez.
$ uv run python 06_control_plane.py
...
== control plane
  idle: server 5.0m / 107.5 MiB, controller 0.8m / 34.4 MiB
    1 API clients: 828.4 req/s (spread 221.5), p99 2.1 ms, server CPU 1017.4m on average over the level (peak 998.9m; limit 1000m)
    4 API clients: 821.3 req/s (spread 0.7), p99 8.9 ms, server CPU 1009.9m on average over the level (peak 999.6m; limit 1000m)
   16 API clients: 829.4 req/s (spread 3.6), p99 80.3 ms, server CPU 1011.1m on average over the level (peak 997.6m; limit 1000m)
   64 API clients: 775.5 req/s (spread 10.0), p99 166.6 ms, server CPU 1011.2m on average over the level (peak 996.7m; limit 1000m)
  wave of 10: create p50 3287.9 ms; controller CPU peak 14.5m; server CPU peak 35.4m
  wave of 20: create p50 5036.3 ms; controller CPU peak 5.0m; server CPU peak 27.4m
wave of 40: create p50 6960.1 ms; controller CPU peak 32.7m; server CPU peak 58.0m| Clientes de API | Requisições por segundo, mediana de 3 | p99 | CPU do servidor, média no nível | Chamadas com falha |
|---|---|---|---|---|
| 1 | 828 | 2,1 ms | 1.017m | 0 |
| 4 | 821 | 8,9 ms | 1.010m | 0 |
| 16 | 829 | 80 ms | 1.011m | 0 |
| 64 | 776 | 167 ms | 1.011m | 0 |
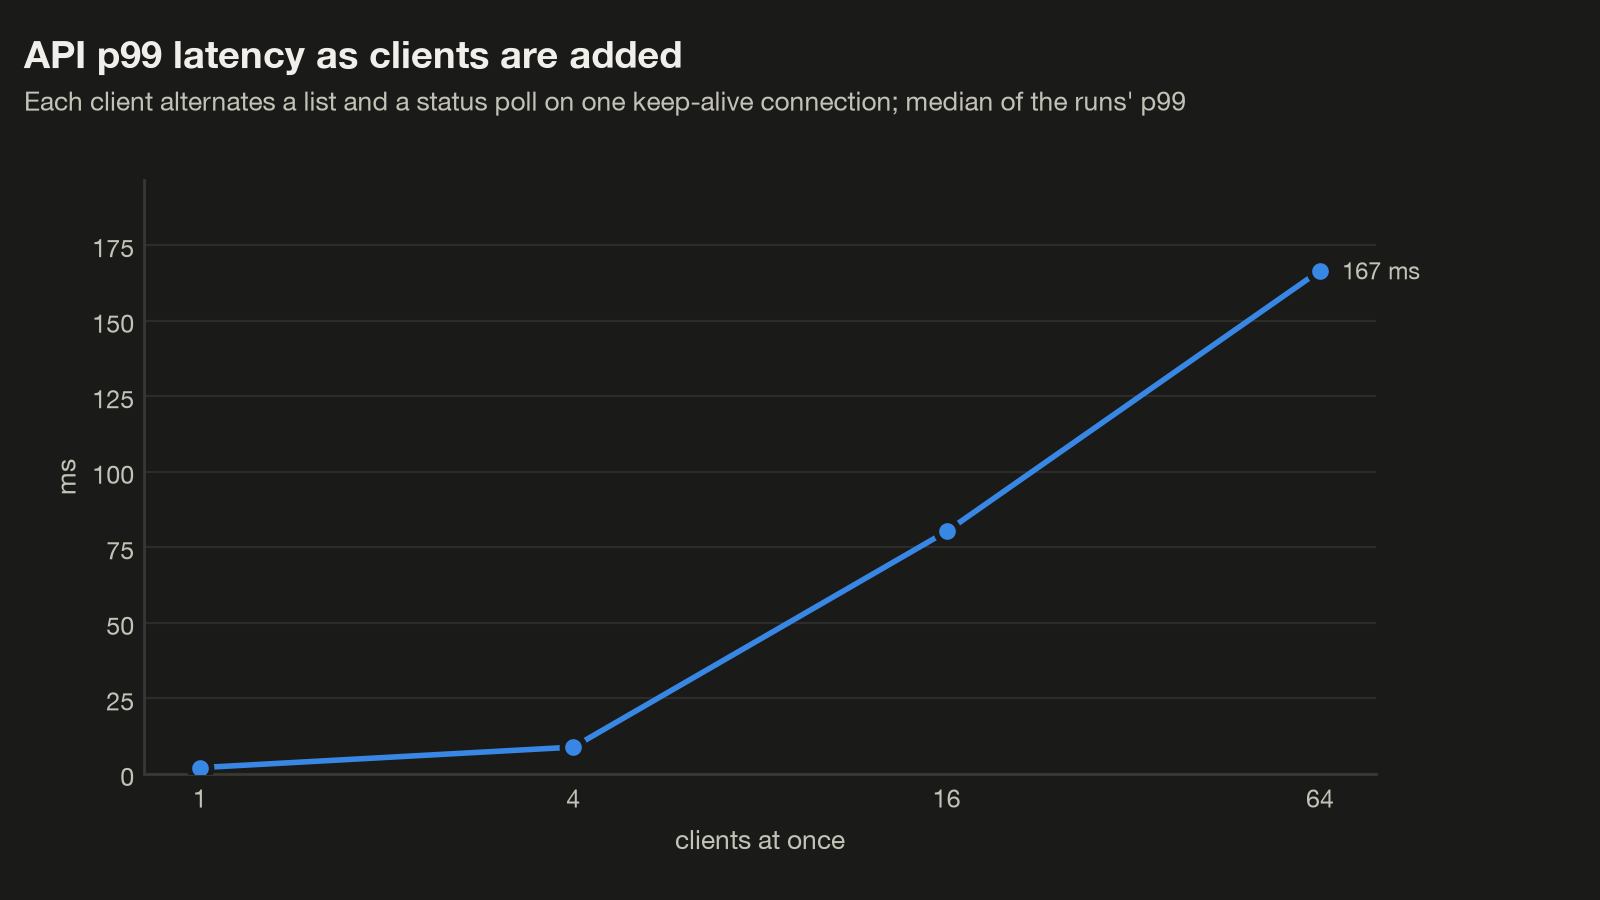
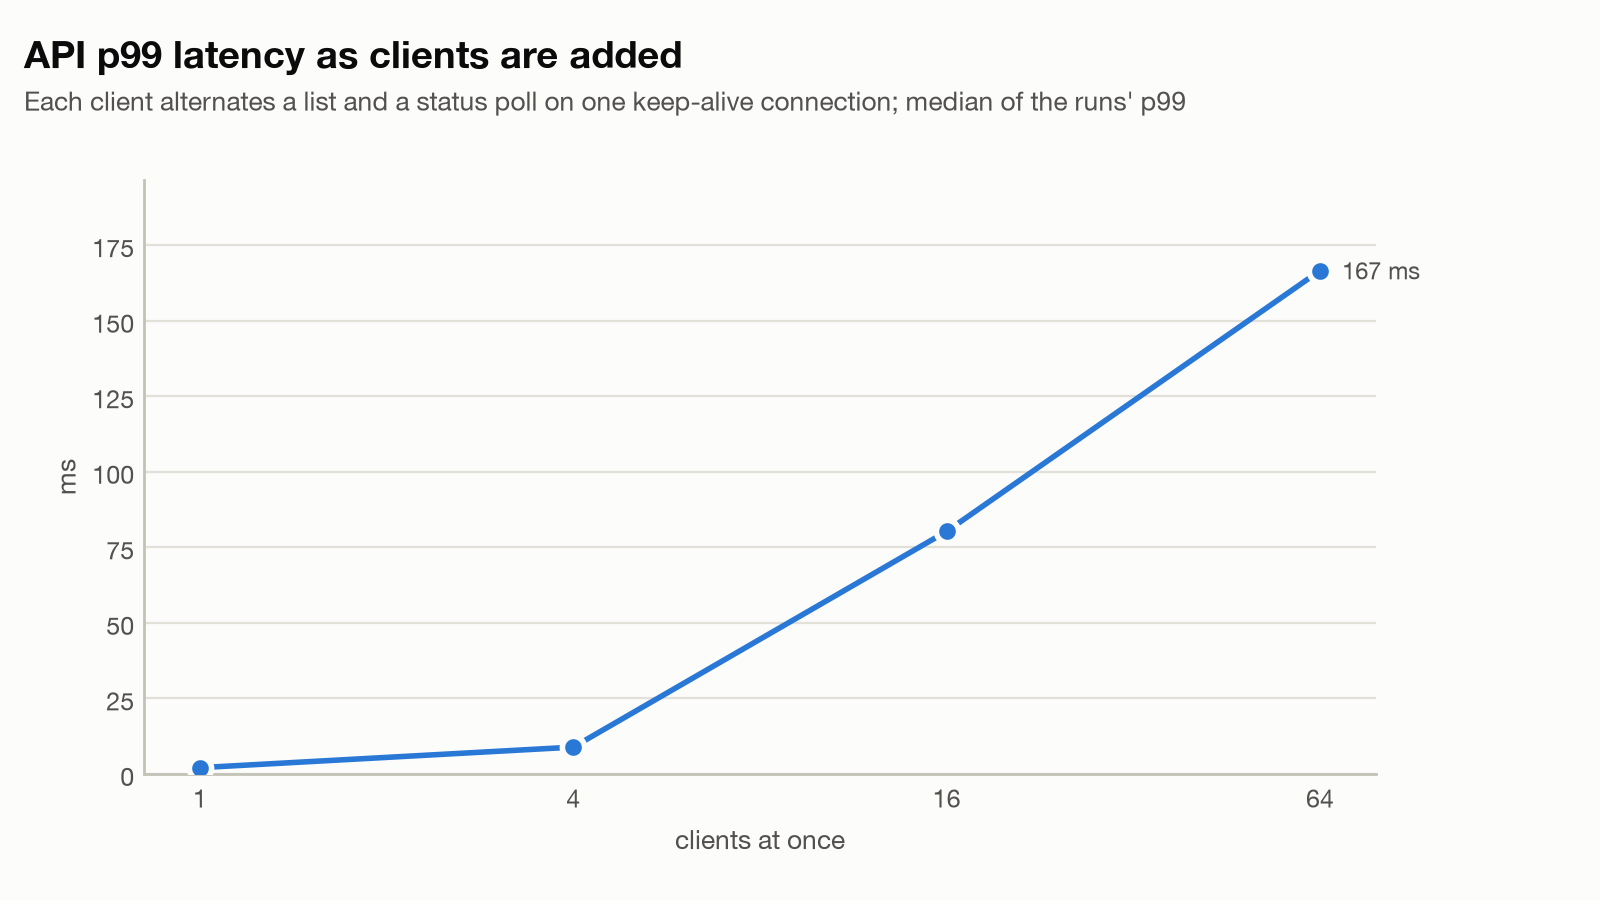
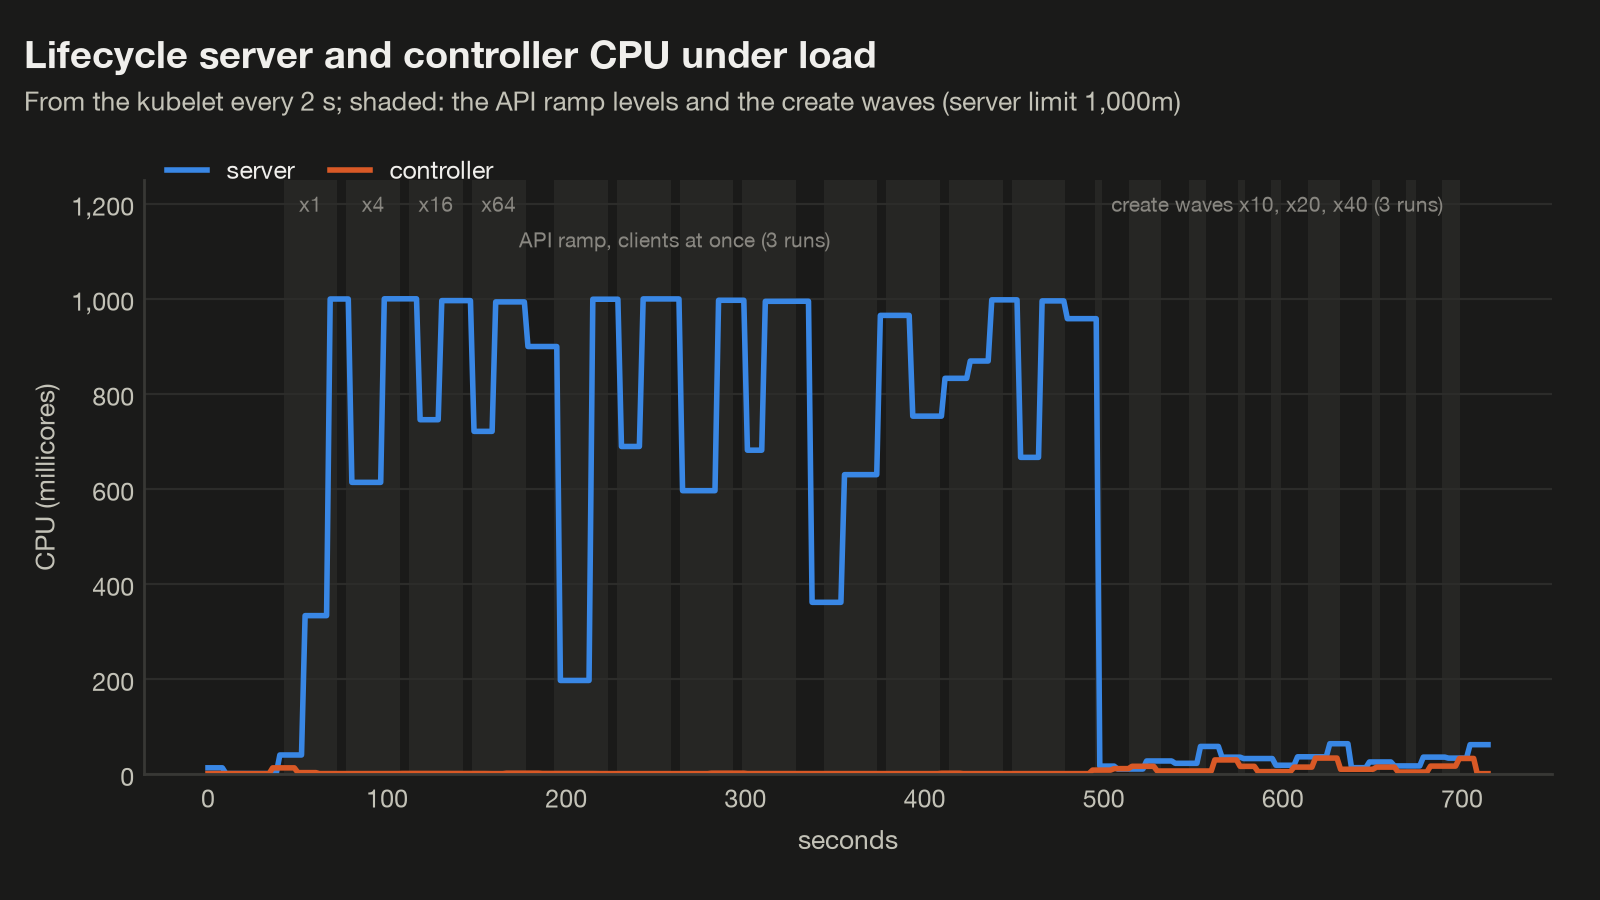
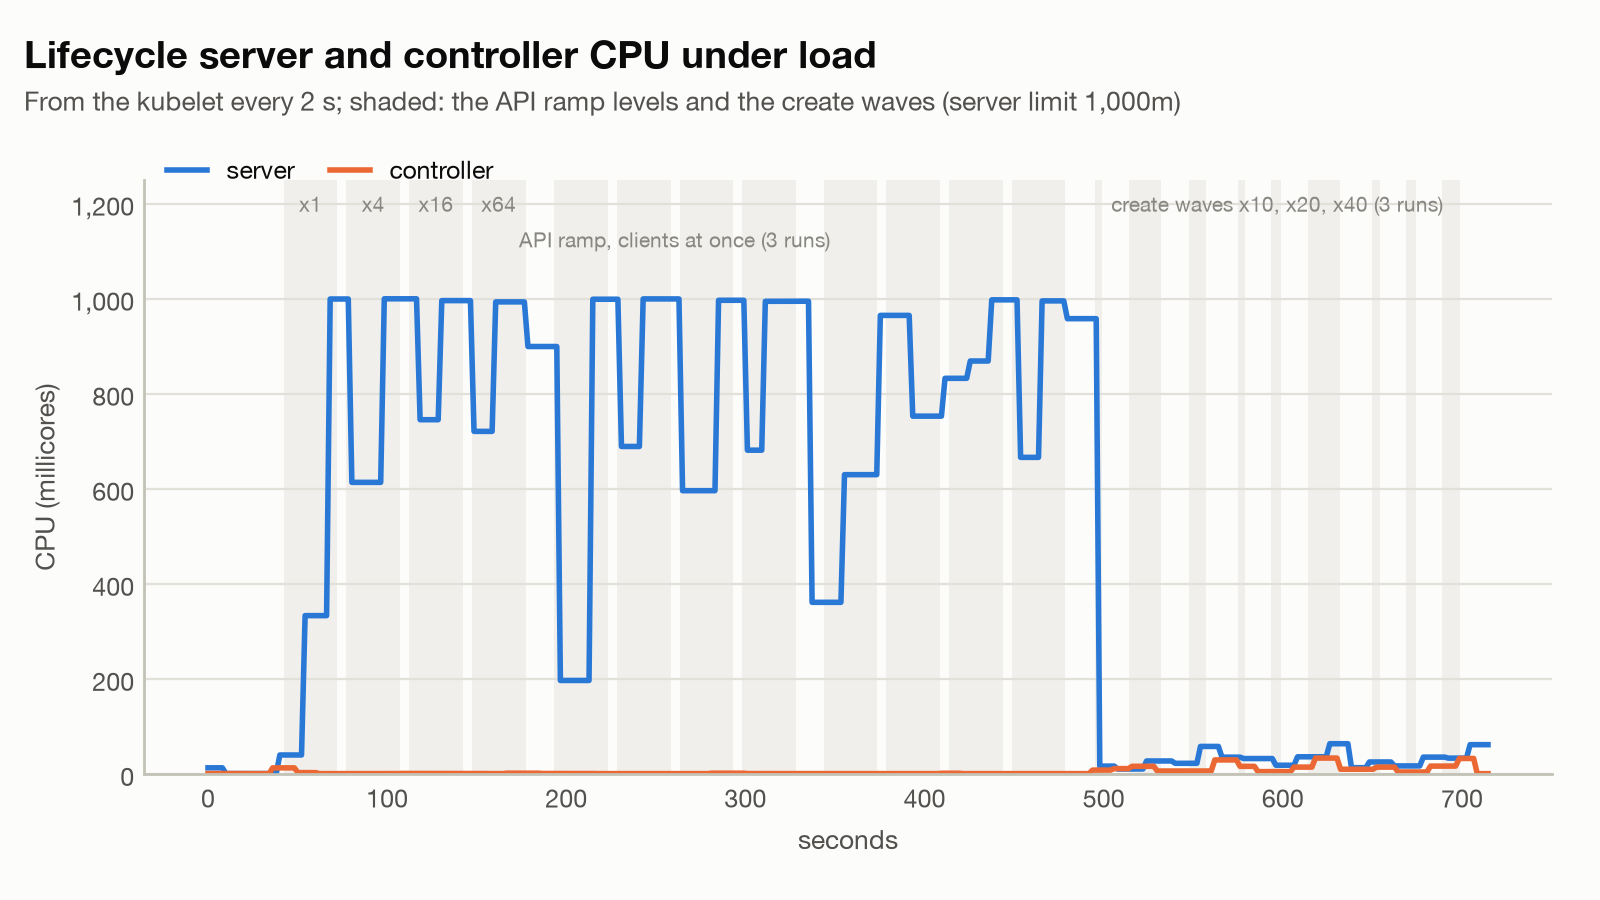
Ocioso, o servidor usou 5m e 107,5 MiB, e o controller, 1m e 34,4 MiB. A única CPU do servidor ficou cheia desde o primeiro cliente: teve média de 1.010 a 1.017m em todos os níveis, um núcleo inteiro (os 1 a 2% acima do limite são o timing do contador; inferido), e respondeu de 821 a 829 requisições por segundo, fossem 1, 4 ou 16 clientes, e 776 com 64; o que cresceu foi a espera, um p99 de 2,1 ms com um cliente para 167 ms com 64. Isso é uma réplica com o limite de 1 CPU da parte 2, e uma réplica também é um processo: a 1.2.0 inicia o uvicorn sem workers (cli.py), então o seu Python roda em cerca de um núcleo, qualquer que seja o limite. Os dois tetos ficam em um núcleo aqui, então esta execução não consegue dizer qual deles foi o limite; um limite maior sozinho provavelmente não ajudaria (inferido), e eu não testei mais réplicas. Nenhuma chamada falhou.
| Onda, criada de uma vez do meu Mac | p50 de create | CPU do controller, mediana dos picos das execuções | CPU do servidor, mediana dos picos das execuções |
|---|---|---|---|
| 10 | 3.288 ms | 14m | 35m |
| 20 | 5.036 ms | 5m | 27m |
| 40 | 6.960 ms | 33m | 58m |
As ondas passam pelo port-forward e estão ali pela CPU; um pico da taxa do kubelet é uma amostra, não uma média. Nenhum dos dois ficou ocupado: nas ondas de 40, a CPU do servidor teve pico de 36 a 64m e a do controller, de 6 a 34m nas três execuções, conforme amostrado.
Teste 6: Noisy neighbors
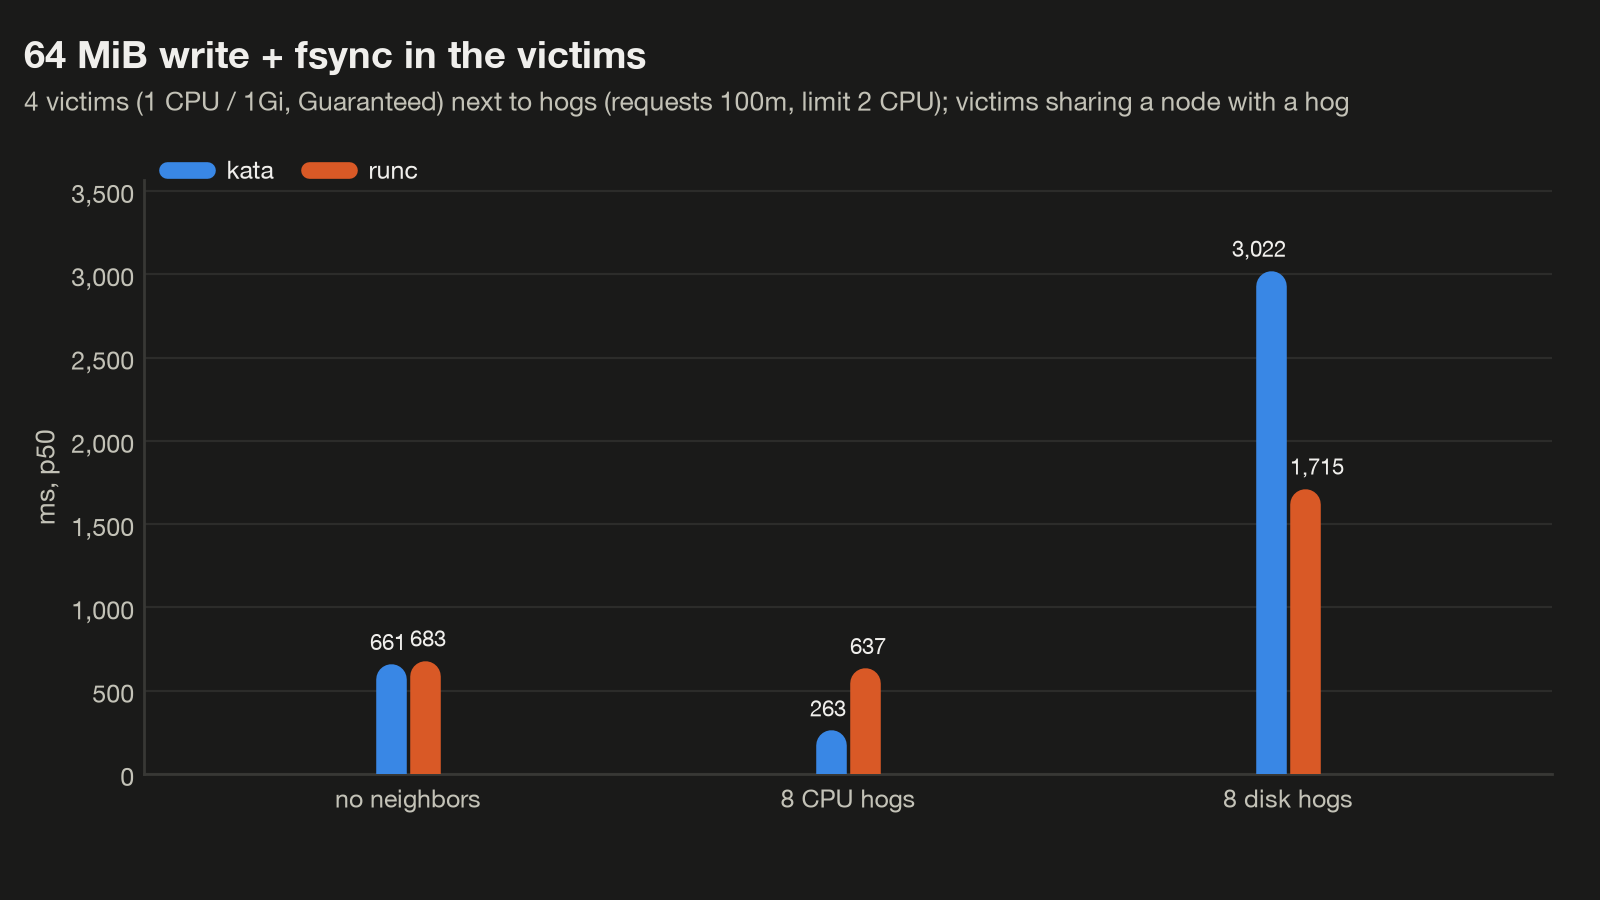
O 07_noisy.py coloca quatro vítimas ao lado de hogs, sob runc e depois sob Kata. Uma vítima tem 1 CPU e 1 GiB, QoS Guaranteed, e roda cinco iterações de um job de CPU fixo (300 rodadas de sha256 sobre um buffer de 1 MiB), uma escrita de 64 MiB com fsync e 100 appends pequenos com um fsync cada, em três cenários:
- Linha de base: nada mais rodando.
- CPU hogs: oito sandboxes, cada um girando dois processos, com requests de 100m e um limit de 2 CPUs. O scheduler os empacota, e juntos eles querem todas as 16 vCPUs.
- Disk hogs: oito sandboxes gravando arquivos de 64 MiB com fsync, sem parar, no volume EBS raiz do node, que guarda a camada gravável de todo container runc e o filesystem raiz compartilhado do Kata.
Cada hog é verificado antes e depois pelo /proc no seu próprio sandbox; um cenário com um hog que não está rodando é inválido, e só contam as vítimas que dividem um node com um hog.
Os números são de uma nova execução depois da execução principal, com 18 de 18 cenários válidos. Na primeira execução, o meu harness invalidou, por conta própria, os casos Kata e um caso runc: a verificação de hog dele lia o número de CPU do kubelet, que é 0 para um pod Kata e para um pod runc novo antes da sua primeira leitura, e um timeout de comando padrão de 120 segundos encerrou os disk hogs do Kata antes da hora. Os dois problemas estão corrigidos no código complementar.
$ uv run python 07_noisy.py
...
== victims, p50 (and slowdown against baseline)
  kata  baseline cpu 200.6 ms (-x)   64 MiB+fsync 661.3 ms (-x)   fsync p99 2.1 ms   [12 exposed victim(s)]
  kata  cpu      cpu 253.8 ms (1.27x)   64 MiB+fsync 262.9 ms (0.4x)   fsync p99 32.2 ms   [12 exposed victim(s)]
  kata  disk     cpu 200.9 ms (1.0x)   64 MiB+fsync 3022.3 ms (4.57x)   fsync p99 192.4 ms   [12 exposed victim(s)]
  runc  baseline cpu 198.5 ms (-x)   64 MiB+fsync 682.7 ms (-x)   fsync p99 2.3 ms   [12 exposed victim(s)]
  runc  cpu      cpu 203.0 ms (1.02x)   64 MiB+fsync 636.8 ms (0.93x)   fsync p99 10.0 ms   [12 exposed victim(s)]
runc disk cpu 198.5 ms (1.0x) 64 MiB+fsync 1714.7 ms (2.51x) fsync p99 186.3 ms [12 exposed victim(s)]| Runtime | Cenário | Job de CPU, p50 | Escrita de 64 MiB e fsync, p50 | Fsync pequeno, p99 | Vítimas expostas |
|---|---|---|---|---|---|
| runc | Linha de base | 198 ms | 683 ms | 2,3 ms | 12 |
| runc | 8 CPU hogs | 203 ms (1,02x) | 637 ms (0,93x) | 10 ms | 12 |
| runc | 8 disk hogs | 198 ms (1,00x) | 1.715 ms (2,51x) | 186 ms | 12 |
| Kata | Linha de base | 201 ms | 661 ms | 2,1 ms | 12 |
| Kata | 8 CPU hogs | 254 ms (1,27x) | 263 ms (0,40x) | 32 ms | 12 |
| Kata | 8 disk hogs | 201 ms (1,00x) | 3.022 ms (4,57x) | 192 ms | 12 |
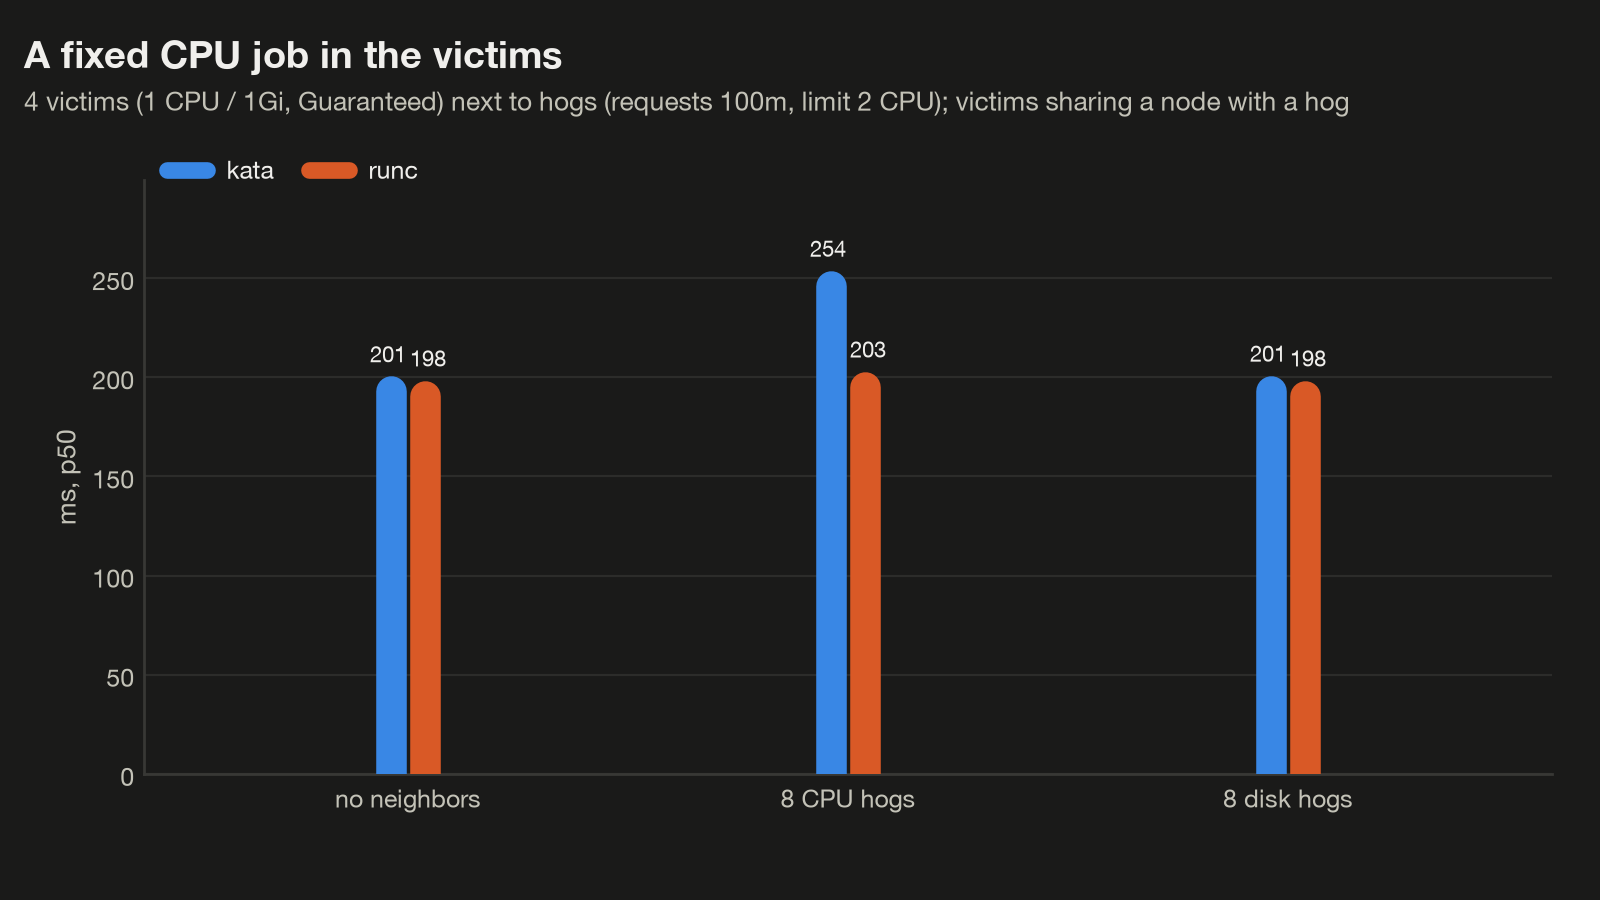
Os requests de CPU protegeram as vítimas sob runc, e menos sob Kata. Sob runc, os oito CPU hogs deixaram o job de CPU das vítimas 1,02x mais lento na mediana: o kernel divide uma CPU disputada pelos requests dos pods, e a CPU inteira de uma vítima pesa mais do que os 100m de um hog. Sob Kata foi 1,27x. Cada hog Kata usou cerca de 1.960m dentro da sua VM (um hog runc: cerca de 1.122m), enquanto o kubelet lia 0m para o pod dele. A documentação do Kata mantém as threads de vCPU no cgroup do pod com sandbox_cgroup_only = false (host-cgroups.md), então esse 0 provavelmente é o jeito como o kubelet lê um pod Kata, e não onde a CPU dele é cobrada (inferido). Eu não investiguei por que os hogs custaram mais às vítimas sob Kata.
O disco não é isolado em nenhum dos runtimes. Oito disk hogs deixaram a escrita de 64 MiB com fsync das vítimas 2,51x mais lenta sob runc e 4,57x sob Kata, e o p99 de um fsync pequeno foi de 2,3 para 186 ms sob runc e de 2,1 para 192 ms sob Kata.
Um resultado que eu não consigo explicar: sob os CPU hogs, a escrita de 64 MiB das vítimas Kata foi mais rápida do que sem vizinhos, 0,40x o tempo da linha de base, nas três execuções. Sob runc, a mediana agregada foi 0,93x, dentro da amplitude das execuções. Foi isso que as execuções registraram; eu não investiguei mais a fundo.
O que o CloudWatch viu
O 08_cloudwatch.py puxa os pontos de um minuto da execução principal, somente leitura, com os nodes como node-a e node-b e sem nenhum ID de instância, de gateway ou de conta: CPU, memória e rede dos nodes, os pods do control plane, os pods em execução do namespace dos sandboxes e os bytes do NAT gateway. A janela termina antes da nova execução do Teste 6.
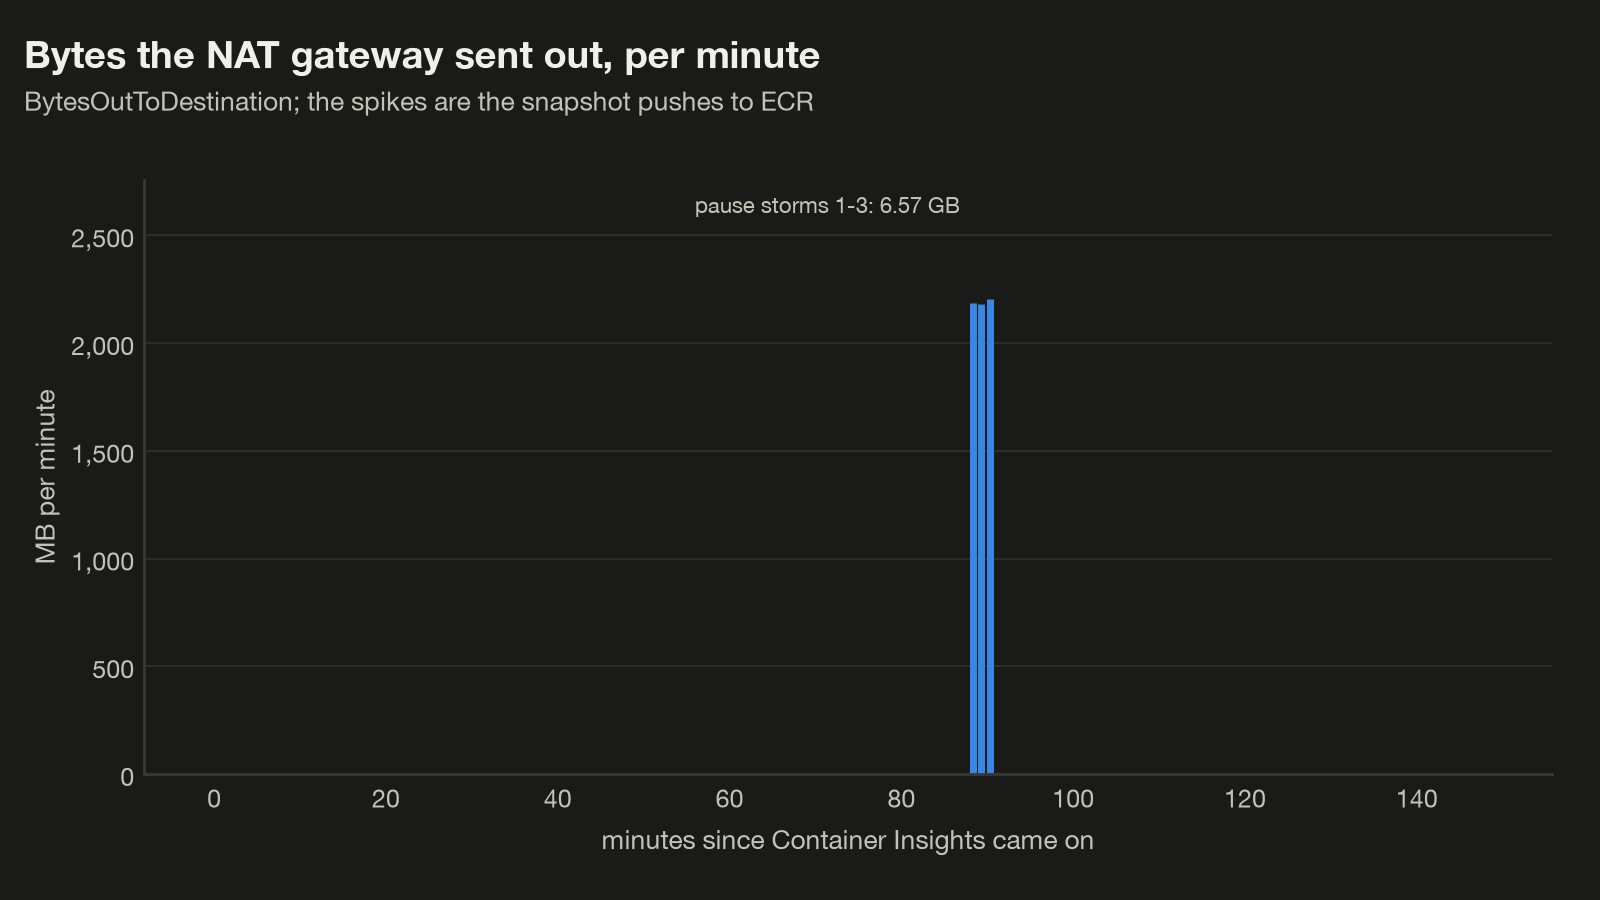
O NAT gateway enviou 6,57 GB para fora durante os três pause storms, cerca de 2,19 GB cada, no minuto seguinte a cada janela de pausa: 4,5% a mais do que os 6,29 GB de dados aleatórios gravados, e menos do que os 8,89 GB de tamanhos de imagem do ECR, que contam layers base que o push pula. As retomadas quase não passaram nada pelo NAT gateway (0,4 MB na janela dos storms fora desses três pontos): ou os pulls delas vieram pelo endpoint do S3, ou o node ainda tinha a imagem, e esta execução não diz qual das duas.
CPU dos nodes ao longo da execução
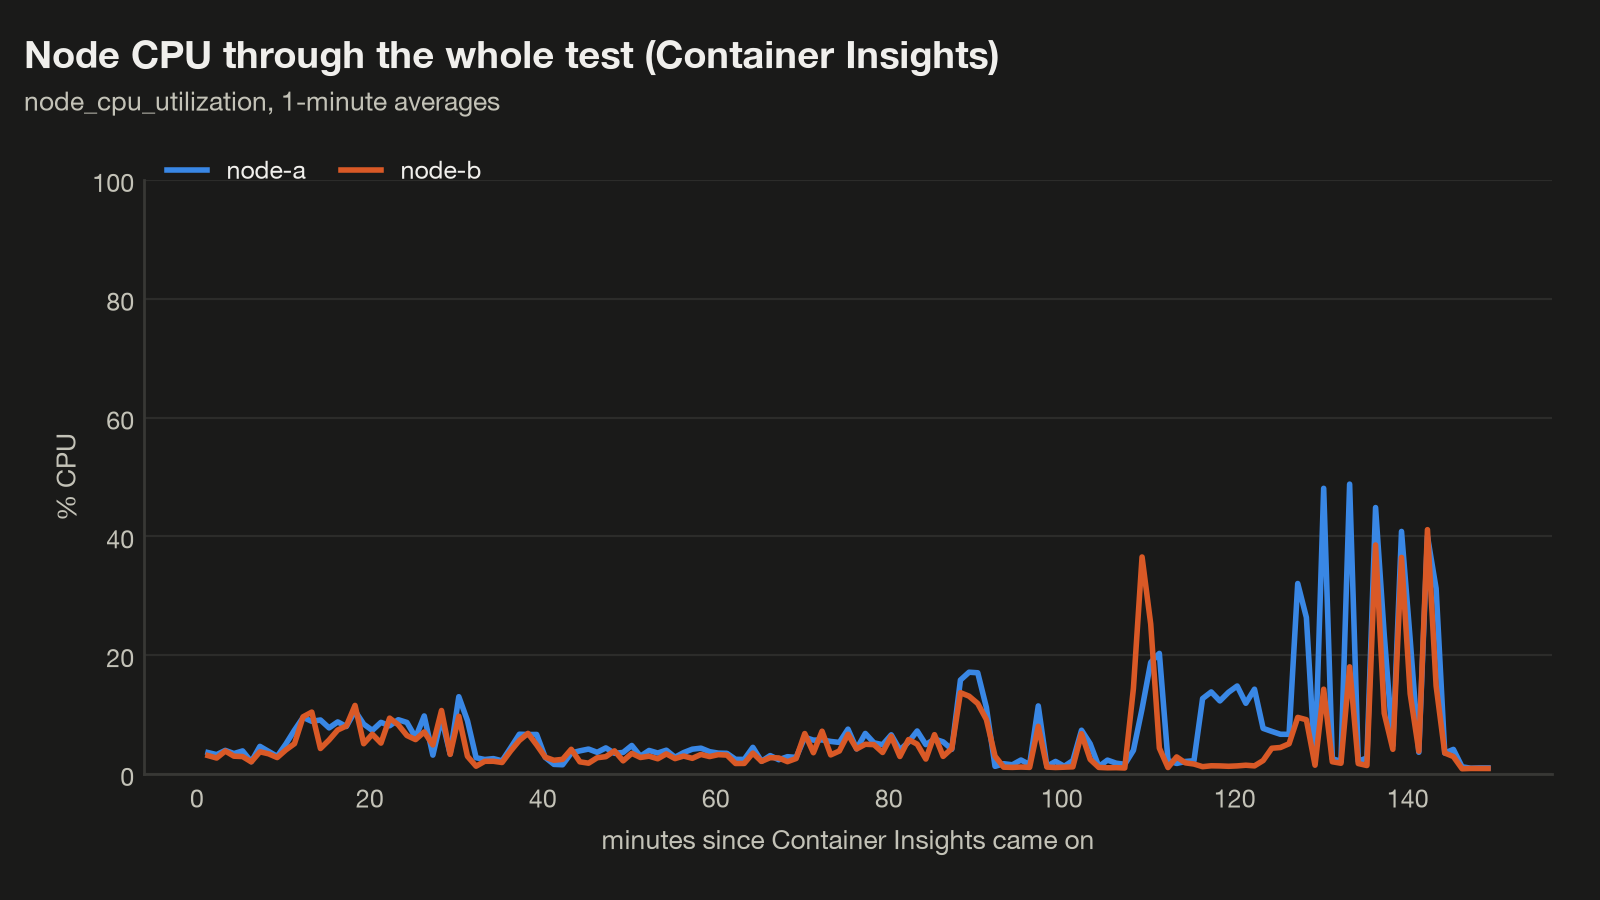
Em 151 minutos, a CPU dos nodes teve média de 7,6% no node-a e 5,4% no node-b, com picos de um minuto de 49% e 41%. Os dois picos caem na primeira execução do Teste 6, quando os CPU hogs rodaram. O namespace dos sandboxes teve pico de 90 pods em execução.
O CloudWatch acrescenta a execução inteira em um eixo só, guardada depois que o cluster some; os números próprios de cada teste vêm do sampler do kubelet.
Resumo dos resultados
| Teste | Script | Execução gravada | Resultado |
|---|---|---|---|
| 1. Densidade | 02_density.py | 32m 09s | runc 89 e runc com egress 89 nos slots de pod, o sidecar com cerca de 60 MiB por sandbox e sem reserva; Kata 24 na CPU (Kubernetes 1.37 contando o overhead duas vezes), cerca de 324 MiB por sandbox nos nodes, contra 288 reservados e 0 reportado pelo kubelet |
| 2. Latência de criação | 03_latency.py | 54m 53s | p50 a frio 1.712 ms com 1 simultâneo, 5.297 ms com 40; a quente 130 e 1.284 ms, dentro do cluster; entrega de 84 em 474 ms pelo controller |
| 3. Pause storm | 04_pause_storm.py | 3m 20s | 20 snapshots de 100 MiB duráveis após 21,4 s; p50 de retomada de 7.301 ms até saudável; dados intactos em 60 de 60 |
| 4. Escada de egress | 05_egress_ladder.py, depois --resolve-once | 24m 10s; 15m 39s | Consulta dns+nft de 59 ms p50, todo degrau dns+nft com 14,2 a 14,3 requisições por segundo com 16 clientes; o proxy +3,3 ms por conexão uma de cada vez, pelo menos 93% menos requisições por segundo no resolve-once (a base era limitada pelo echo); SigV4 5,3 ms acima do piso sem assinatura |
| 5. Control plane | 06_control_plane.py | 12m 10s | Uma réplica do servidor, um processo, limitada pela CPU desde o primeiro cliente: 821 a 829 requisições por segundo até 16 clientes, p99 de 167 ms com 64; nenhuma chamada falhou |
| 6. Noisy neighbors | 07_noisy.py, nova execução | 20m 00s | CPU hogs 1,02x (runc) e 1,27x (Kata) no job de CPU das vítimas; disk hogs 2,51x e 4,57x na escrita e fsync delas |
| CloudWatch | 08_cloudwatch.py | 0m 02s | Picos de um minuto de CPU dos nodes de 49% e 41%; 6,57 GB para fora pelo NAT gateway nos pause storms, 4,5% acima dos dados gravados |
Todo script terminou com código 0, exceto a primeira execução do Teste 6, cujos casos Kata e um caso runc o meu harness invalidou (veja o Teste 6); a nova execução dele e a variante resolve-once, depois da execução principal, terminaram com código 0. Do 02 ao 07, foram 2,4 horas da execução principal.
Preços
O OpenSandbox é gratuito; o cluster cobra por hora, cerca de $1,011 ocioso (a seção Preços da parte 2). A parte 6 acrescenta o Container Insights, a cobrança por GB do NAT gateway e o storage do ECR para os snapshots. Eu precifico as 2,5 horas inteiras em que o Container Insights ficou ligado, do 01_metrics.sh ao 99_cleanup.py; a nova execução do Teste 6 e a variante resolve-once vieram depois, com ele desligado.
O Container Insights com observabilidade aprimorada cobra por observação, $0,21 por milhão para o primeiro bilhão no mês (preços do CloudWatch). Pelas médias por minuto da AWS, este cluster em repouso gera cerca de 6.100 a 7.100 observações por minuto, $0,08 a $0,09 por hora antes do armazenamento de logs, e cada pod de sandbox acrescenta de 159 a 180 por minuto; esta execução nunca teve mais de 89 de uma vez, o que, pelas 2,5 horas inteiras, teria acrescentado $0,50. O 99_cleanup.py deleta o log group de performance, cobrado à parte.
A aritmética das observações
As médias por minuto da AWS são 1.720 por cluster, 68 por node, 2 por namespace ou service, 7 por workload, 138 por pod e 21 por container; elas colocam o exemplo de 10 nodes da própria AWS em $51,75 por mês. Os 2 nodes e os 27 pods que o Teste 1 registrou fora dos sandboxes, com um container cada, somam pelo menos 6.149 por minuto, $0,08 por hora. Namespaces, services, workloads, segundos containers e os três pods a mais que a minha contagem tem acrescentam cerca de 900; com a minha contagem deles, que nenhum log registra, dá cerca de 7.050 por minuto, $0,09 por hora ou $64 por mês antes do armazenamento de logs, e a tabela usa esse número mais alto. Um pod de sandbox é 138 mais 21 por container, 159 sem o sidecar de egress e 180 com ele, então 200 sandboxes de dois containers por 2 horas acrescentariam cerca de 4,32 milhões de observações, $0,91.
O NAT gateway cobra $0,045 por GB que processa, qualquer que seja a direção (preços da VPC), além da sua tarifa por hora. Ele carregou 6,64 GB na janela que o 08_cloudwatch.py leu, cerca de $0,30; 6,57 GB disso para os pushes dos pause storms.
| Item | Preço | Esta execução, 2,5 horas |
|---|---|---|
| O cluster, ocioso (parte 2) | $1,011/h | $2,53 |
| Container Insights, o cluster em repouso | $0,08 a $0,09/h a $0,21 por milhão de observações | Até $0,22 |
| Container Insights, os sandboxes | 159 a 180 observações por minuto por pod de sandbox | Menos de $0,50 |
| Processamento de dados do NAT gateway | $0,045/GB | $0,30 |
| Storage do ECR para os snapshots | $0,10/GB-mês | Menos de um centavo, até o 99_cleanup.py deletá-los |
| Chamadas STS (Teste 4), histórico de eventos do CloudTrail | Sem cobrança | $0 |
| Total | Cerca de $3,55 |
As instâncias são a maior parte da conta. Se ficar ligado, o Container Insights custa cerca de $1,86 a $2,13 por dia neste cluster antes de qualquer sandbox rodar, pela aritmética acima; o 99_cleanup.py o desliga.
Limpeza
Todo script deleta o que criou, também em caso de falha. Depois de uma execução interrompida, ou quando você terminar:
uv run python 99_cleanup.py                  # also turns Container Insights off
uv run python 99_cleanup.py --keep-metrics   # leaves it on
Ele roda todos os passos, independentemente do que os outros fizeram, e sai com 1 se algum falhou. Ele deleta só os objetos deste diretório, entre eles os sandboxes rotulados example=opensandbox-stress e as suas imagens de snapshot, restaura o servidor se um script interrompido o deixou alterado, desliga o Container Insights e deleta o seu log group /aws/containerinsights/osb-eks/performance, e varre results/ e charts/ antes de eles serem publicados. Ele mantém o que as partes 3 a 5 configuraram.
Esta é a última parte da série, então é aqui que o cluster vai embora. Escale os nodes para zero entre as sessões a partir do diretório da parte 2 e, quando você terminar as seis partes, o teardown dele remove tudo, na ordem que a seção Limpeza da parte 2 explica:
../opensandbox-eks/08_scale.sh down
../opensandbox-eks/99_teardown.sh
Veredito
Em dois nodes m7i.2xlarge comuns, o caminho Kubernetes do OpenSandbox 1.2.0 rodou todos os testes até os limites do cluster sem perder dados nem falhar uma requisição abaixo deles (nos limites, os creates estouraram o tempo em vez de serem recusados; Teste 1), e os primeiros limites não foram do OpenSandbox: slots de pod para o runc e, para o Kata, um bug do scheduler do Kubernetes 1.37 que conta duas vezes o overhead de uma RuntimeClass. Planeje em torno da memória que nada contabiliza: a do sidecar de egress, sem reserva, e a de uma VM Kata, invisível para o kubelet. Nenhuma das duas pesou aqui só porque outra coisa se esgotou antes.
A surpresa do egress é a consulta: sob dns+nft, um sandbox que abre conexões por nome espera uma execução do nft por consulta, e o proxy por trás disso é um único núcleo que nada reserva; a única chave, o modo dns do servidor inteiro, também desliga o proxy de credenciais e o vault. Onde o cliente roda é o que mais importa para os creates: um a quente de dentro do cluster levou cerca de um décimo do tempo de um via port-forward. O lifecycle server, uma réplica e um processo, ficou limitado pela CPU desde o primeiro cliente. Os requests de CPU mantiveram os vizinhos separados sob runc, e menos sob Kata, e o disco não foi isolado em nenhum dos dois.
O Firecracker não foi testado: nem o perfil Fast Sandbox, que esta série nunca instalou, nem o Kata com Firecracker, que a parte 2 não instalou.
Com o que você está se comprometendo
| Questão | OpenSandbox 1.2.0 em dois nodes m7i.2xlarge, como testado; o que vem do código ou da documentação está marcado |
|---|---|
| Densidade, runc | 89 sandboxes ociosos, nos 58 pods por node do VPC CNI; memória longe de cheia |
| O sidecar de egress | Cerca de 60 MiB por sandbox ocioso nos nodes, 58,9 MiB disso a memória residente do sidecar; sem requests a menos que você defina [egress] requests (código) |
| Densidade, Kata | 24 sandboxes ociosos, recusados por CPU: o Kubernetes 1.37 conta duas vezes o overhead da RuntimeClass de um pod em execução, cerca de 600m contra 350m declarados (#143257; a correção sem merge até 7 de novembro de 2026; código-fonte do Kubernetes); cerca de 324 MiB por sandbox nos nodes, 288 reservados, 0 reportado pelo kubelet para o pod |
| Um cluster cheio | Os creates estouram o tempo com SandboxTimeoutException; o motivo está só nos eventos do scheduler, e o servidor remove o sandbox (código) |
| Latência de criação, cliente dentro do cluster | A frio 1.712 ms p50 um de cada vez, 5.297 ms com 40; a partir de um Pool 130 e 1.284 ms |
| Latência de criação, via port-forward | A frio 2.277 ms, a quente 1.245 ms, um de cada vez |
| Entrega de Pool | 84 sandboxes alocados em 474 ms pelo controller, com o round trip do meu Mac até a API incluído; pelo servidor, o meu cliente dentro do cluster foi o limite; os 0,92 s publicados para 100 não declaram setup (documentação) |
| Pause storm | 20 snapshots de 100 MiB duráveis no ECR após 21,4 s; cerca de 2,19 GB por storm pelo NAT gateway |
Egress, dns+nft (o padrão do Helm chart e a configuração da série) | Toda consulta de um nome permitido espera cerca de 59 ms por um processo nft, serializado por sandbox (código e execução); um cliente com pool de conexões paga uma vez por conexão; novas conexões por nome chegam ao máximo perto de 14,3 por segundo; nenhuma configuração resolve isso, a não ser o modo dns do servidor inteiro, que abre mão das verificações de pacote e do proxy de credenciais (código) |
| Egress, o proxy | +3,3 ms por nova conexão uma de cada vez; cerca de 385 novas conexões por segundo por sandbox com a consulta retirada, um mitmdump sem limite de CPU em cerca de um núcleo; o proxy adiciona cerca de 54 MiB ao pico do sidecar (64,3 contra 10,3 MiB); uma chamada assinada com SigV4 fica 5,3 ms acima de uma sem assinatura |
| Control plane | Uma réplica do servidor, um processo (código), limitada pela CPU desde o primeiro cliente: 821 a 829 requisições por segundo até 16 clientes, p99 de 2,1 a 167 ms com 64 |
| Noisy neighbors | CPU hogs 1,02x sob runc, 1,27x sob Kata; disk hogs 2,51x e 4,57x, o p99 de um fsync pequeno 186 e 192 ms; o disco não é isolado por nenhum dos dois |
| Observabilidade | Os pontos de um minuto do Container Insights para a execução; os números detalhados precisam do seu próprio sampler do kubelet; a memória das VMs Kata precisa de um no lado do node |
| Custo desta execução | Cerca de $3,55, a maior parte disso as instâncias; Container Insights $0,08 a $0,09/h para o cluster em repouso |
Quem deveria usar
Ele serve para um time que roda sandboxes de agentes nos seus próprios nodes EKS e dimensiona a partir das suas próprias medições. Conte os slots de pod primeiro; defina [egress] requests para que o scheduler veja o sidecar, cujo proxy pode ocupar um núcleo que ninguém reservou; mantenha conexões abertas ou faça cache da resolução de nomes nos sandboxes que chamam para fora com frequência sob dns+nft; observe a memória do Kata pelo node e, até o Kubernetes corrigir o #143257, reserve no orçamento cerca de 600m de CPU do scheduler por sandbox Kata; e crie sandboxes de perto do servidor, com um Pool quando o tempo de create importa.
Ele ainda não serve para um sandbox que abre muitas conexões novas por nome sob dns+nft, para tenants com muita escrita dividindo um node, nem para um plano dimensionado a partir dos números publicados: 0,92 segundo sem setup, números da AWS China de uma instalação só com o controller, e números de Firecracker de um perfil que este caminho não roda. Esse é o fim da série: a parte 1 começa de novo pelo que o OpenSandbox é e como as peças se encaixam.