AWS Lambda MicroVMs: Hands-On com o Ciclo de Vida Completo do Sandbox
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Ferramentas, credenciais e cotas
- Passo 2: O código complementar e a infraestrutura
- Passo 3: Um agente dentro da VM
- Passo 4: Redes de segurança, e como reencontrar as suas MicroVMs
- Testes
- Teste 1: Build de uma imagem
- Teste 2: Rodar uma MicroVM e inspecionar os padrões
- Teste 3: Comandos, arquivos e o endpoint
- Teste 4: Suspender e retomar, três ciclos
- Teste 5: Suspensão automática por ociosidade e auto-resume
- Teste 6: Duração máxima e encerramento
- Teste 7: Listar, filtrar e reconectar a partir de outro processo
- Teste 8: Muitas MicroVMs a partir de um snapshot
- Teste 9: A linha de base de egress e identidade
- Teste 10: Cotas e a conta
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
- O que funciona
- O que não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine um robô de brinquedo que você pode congelar com um botão. Quando você aperta de novo, o robô continua com o mesmo bloquinho que estava segurando, como se o tempo não tivesse passado. Cada robô também mora na sua própria caixinha de vidro, então não consegue derrubar a torre de ninguém.
O problema é que o robô só percebe você quando você bate no vidro. Se você disser para ele tirar uma soneca quando ninguém bate, ele cochila até no meio de uma torre que estava construindo bem quietinho. E nenhum robô pode ficar fora da caixa de brinquedos por mais de oito horas, incluindo o tempo congelado.
As Lambda MicroVMs são um serviço gerenciado da AWS que roda código no qual você não confia em uma máquina virtual dedicada, dentro da sua própria conta e cobrança da AWS, sob os termos padrão da AWS. O acesso a cada máquina exige um token emitido pela sua conta, e esse token é restrito a uma máquina e às portas dela.
Os pontos de due diligence são identidade e egress. O código dentro da máquina consegue ler as credenciais da role que você anexa a ela e, por padrão, consegue alcançar a internet inteira. Nenhum dos dois é restringido pelo próprio serviço, então anexe roles com parcimônia e trate os controles de rede como responsabilidade sua.
A condição é a execução insegura de código escrito por máquina. A intervenção é uma máquina virtual por sessão, restaurada a partir de um snapshot. Nos meus testes, ela estava rodando em menos de dois segundos e foi retomada de uma suspensão em menos de um, com os processos e a memória intactos.
Efeitos colaterais: o timer de ociosidade ignora o trabalho que não chega pela porta da frente, então um agente ocupado pode ser congelado no meio de uma tarefa. Conexões abertas morrem a cada retomada. A máquina também tem uma vida útil de oito horas que conta o tempo congelado, e a minha conta começou com uma dose muito pequena.
Repare na calma que dá quando um sandbox simplesmente congela quando ninguém está usando e acorda, no meio do pensamento, assim que alguém volta. Nada para recarregar, nenhum estado para reconstruir, e a conta de computação pausa enquanto ele dorme.
A tensão está no que você ainda precisa construir por conta própria. Não existe interface de comandos ou de arquivos para um programa chamar, então alguém escreve primeiro um pequeno servidor; não há tags para encontrar as coisas, e uma regra de ociosidade pode congelar um agente enquanto ele trabalha. Espere conversas sobre quem fica responsável por essa cola.
Pense em uma Lambda MicroVM como uma sala de ensaio com um pedal de pausa. Pise nele e a banda inteira congela no meio do compasso; pise de novo e todos voltam no mesmo tempo, menos de um segundo depois, sem precisar contar a entrada.
Só que a sala só escuta a porta. Se a banda toca alto com a porta fechada, a sala assume que não há ninguém ali e pausa mesmo assim. E a sessão é reservada por oito horas cravadas, minutos pausados incluídos, então sets longos precisam de uma sala nova.
O posicionamento é "isolamento Firecracker dentro da sua própria conta AWS." Nenhum fornecedor novo, IAM e CloudTrail como você já conhece, e um sandbox rodando em cerca de dois segundos a partir de um snapshot.
As ressalvas honestas para compradores: é um bloco de construção, não um produto de sandbox. Os times trazem o próprio executor de comandos, os próprios controles de egress e o próprio tratamento de credenciais, e a minha conta começou com uma cota de quatro máquinas de tamanho padrão por vez.
 Veja o código-fonte aqui: lambda-microvm-lifecycle
Visão Geral
As AWS Lambda MicroVMs entraram em disponibilidade geral em 2026-06-22. Elas rodam código de usuários ou gerado por IA em microVMs Firecracker, dentro da sua própria conta AWS. Você faz o build de uma imagem a partir de um Dockerfile, o Lambda a inicializa (uma vez por geração de Graviton), espera a sua aplicação avisar que está pronta e tira um snapshot de tudo (memória, disco, processos em execução). Toda MicroVM que você roda começa a partir desse snapshot, ganha o próprio endpoint HTTPS e pode ser suspensa e retomada com a memória intacta por até 8 horas.
Esse é o produto inteiro, e ele é pequeno de propósito. Não há nenhuma API de exec e nenhuma API de arquivos: o endpoint encaminha HTTP para portas dentro da VM, e o que escuta ali fica por sua conta. Não há fork nem snapshot de uma MicroVM em execução, não há tags em MicroVMs, e não há policy de egress nem tratamento de credenciais além de “internet pública” ou “sua VPC”. É um bloco de construção para um sandbox, não um sandbox pronto.
Esta é a parte 1 de uma série em três partes:
- Parte 1 (este post) acompanha uma MicroVM pela vida inteira, do
create-microvm-imageaté a limpeza, com um script executável por etapa. - Parte 2 preenche a lacuna de egress e credenciais com o iron-proxy.
- Parte 3 explora sandboxes self-service: um workspace no navegador com o Claude Code por cima.
Eu rodei tudo em 2026-11-03 na us-east-1 com boto3 1.43.123 e AWS CLI 2.39.3, sobre a imagem base al2023-1 versão 3. Todos os tempos são das minhas execuções, a partir do meu laptop, fora da AWS.
Duas coisas para saber antes de começar. Você precisa de uma CLI ou de um SDK recente: o lambda-microvms apareceu pela primeira vez na AWS CLI 2.35.10 e no boto3 1.43.35, e a minha (2.34.29) não tinha suporte a ele até eu atualizar. E verifique as suas cotas: o Service Quotas lista um padrão de 2.048 GB de memória de MicroVM e 5 chamadas de RunMicrovm por segundo (o guia do Lambda diz 1.024 GB na us-east-1), mas a minha conta estava limitada a 8 GB e 1 chamada por segundo, e todos os testes aqui cabem nisso. As cotas são por conta: o guia do Lambda diz que contas novas começam com cotas reduzidas que a AWS aumenta automaticamente com o uso, e aumentar a minha manualmente exige um caso de suporte (Passo 1).
Arquitetura
Três coisas nesse diagrama moldam tudo o que vem a seguir:
- O snapshot é o produto. Toda MicroVM começa a partir de um snapshot de memória tirado durante o build, então tudo o que a sua aplicação fez antes de o
/readyretornar (imports, caches aquecidos, IDs gerados) é compartilhado por todas as MicroVMs. É isso que torna a inicialização rápida, e também é uma armadilha (Teste 8). - O endpoint é a única porta de entrada, e o único sinal de atividade. Comandos, arquivos e shells, tudo trafega via HTTP para portas dentro da VM. O timer de ociosidade só conta o tráfego que passa por esse endpoint.
- Os hooks de ciclo de vida são chamadas HTTP simples para a sua aplicação em uma porta que você escolhe. É por eles que você recebe o payload de cada MicroVM e fica sabendo de suspensões, retomadas e encerramentos.
Configuração
Passo 1: Ferramentas, credenciais e cotas
Você precisa de Python 3.11+, uv, Terraform 1.6+ e credenciais da AWS que possam gerenciar Lambda MicroVMs, roles do IAM, S3 e CloudWatch Logs, e ler o Service Quotas e o Cost Explorer (para o Teste 10). Antes de qualquer coisa, verifique o que a sua conta consegue rodar:
aws service-quotas get-service-quota --service-code lambda --quota-code L-CD1C0CC4 \
  --query Quota.Value          # Max allocated ARM_64 MicroVM memory (GB)
aws service-quotas get-aws-default-service-quota --service-code lambda --quota-code L-CD1C0CC4 \
  --query Quota.Value          # the Service Quotas default
A minha retornou 8.0 e 2048.0. O Service Quotas recusa qualquer solicitação igual ou abaixo do padrão, então sair de 8 GB para algo útil exige um caso de suporte. Eu abri um.
Passo 2: O código complementar e a infraestrutura
Os scripts estão em lambda-microvm-lifecycle.
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/lambda-microvm-lifecycle
cp .env.example .env
uv venv && uv pip install -e . && source .venv/bin/activate
terraform -chdir=infra init && terraform -chdir=infra apply
O infra/ cria um bucket S3 para os zips de build, uma role de build (lê o zip, escreve os logs de build) e duas execution roles: uma que só pode escrever logs e outra que também pode listar buckets S3, para o Teste 9. Não há VPC nesta parte.
Passo 3: Um agente dentro da VM
Como não há API de exec, a imagem precisa de algo com que conversar. O images/sandbox/agent.py tem cerca de 230 linhas de Python, só biblioteca padrão além do websockets: POST /exec e um POST /exec/stream via SSE na porta 8080, PUT/GET /files, alguns endpoints de estado para os testes, um eco WebSocket na 8081 e os seis hooks de ciclo de vida na 9001. O Dockerfile não tem nada de especial:
FROM public.ecr.aws/docker/library/python:3.12-slim-bookworm
RUN apt-get update \
 && apt-get install -y --no-install-recommends curl dnsutils iproute2 procps git ca-certificates \
 && rm -rf /var/lib/apt/lists/* \
 && pip install --no-cache-dir websockets==15.0.1 boto3==1.43.123
WORKDIR /app
COPY agent.py .
CMD ["python", "-u", "agent.py"]
Todo mundo que integra MicroVMs escreve alguma versão disso (o worker do Cursor, os exemplos de Claude da AWS, projetos da comunidade como o microvms-agentd). Qualquer pessoa com um token de endpoint para a porta 8080 agora pode rodar qualquer coisa como root nessa MicroVM, que é justamente o objetivo de um sandbox, então trate os tokens como credenciais.
O console só mostra os hooks de uma imagem no formulário Edit dela, junto com os timeouts: 30 s cada aqui, dentro do intervalo permitido de 1 a 60 s para run, resume, suspend e terminate.
Passo 4: Redes de segurança, e como reencontrar as suas MicroVMs
MicroVMs não aceitam tags (o run-microvm não tem parâmetro de tags), então os scripts identificam as suas pelo nome da imagem (my2cents-lc-*) e colocam o nome do teste no payload do hook run. O common.run() também define maximumDurationInSeconds=3600 e uma policy de ociosidade que suspende depois de 10 minutos ociosa e encerra depois de 10 minutos suspensa. Esse segundo timer só vale depois de uma suspensão por ociosidade (Teste 5), então, para os scripts que suspendem uma MicroVM por conta própria, o limite de uma hora é a rede de segurança real. A única execução que não passa pelo common.run(), a do Teste 2, que examina os padrões do Lambda (um limite de 8 horas e nenhuma policy de ociosidade), é encerrada em um bloco finally. Assim, um script que quebrar não consegue deixar nada para trás por mais de uma hora.
Testes
Teste 1: Build de uma imagem
O 01_image.py compacta images/sandbox em um zip, faz o upload e chama create-microvm-image com a base gerenciada al2023-1, um baseline de 2 GB e os seis hooks na porta 9001:
=== Build images/sandbox (python:3.12-slim + agent) =============
create: states [('CREATING', 1.1), ('CREATED', 134.8)]  total 134.8s
134,8 s para a primeira versão (124,5 s em uma execução anterior) e 113,7 s para uma segunda versão que só mudou uma variável de ambiente. O build é mais interessante do que o tempo sugere. O list-microvm-image-builds mostra um build de snapshot por chipset, GRAVITON geração 3 e geração 4, cada um com a sua própria execução dos hooks de build:
{"buildId": "21ec559f-…", "buildState": "SUCCESSFUL", "architecture": "ARM_64", "chipset": "GRAVITON", "chipsetGeneration": "3"}
{"buildId": "b74e6985-…", "buildState": "SUCCESSFUL", "architecture": "ARM_64", "chipset": "GRAVITON", "chipsetGeneration": "4"}
"snapshotBuild": {"memorySnapshotSizeInBytes": 560652288, "codeInstallSizeInBytes": 574095360, "diskSnapshotSizeInBytes": 23519232}
Os logs de build mostram o agente iniciando, o ready de 50 a 90 ms depois (em dois builds) e o validate cerca de 21 s depois disso, separadamente no stream de cada chipset, com um UUID gerado no build diferente em cada um. Então “toda MicroVM compartilha o snapshot” na verdade significa “toda MicroVM da mesma geração de chipset compartilha o snapshot”.
No console, as imagens têm uma página própria, em uma nova seção MicroVMs da navegação do Lambda. Circulei três coisas na minha: os tamanhos de baseline e de pico (mais sobre eles no Teste 2), a mesma divisão de um build por chipset em cada versão e o tamanho do snapshot dividido em memória, instalação de código e disco. Os “MB” do console são mebibytes: a captura de tela, de um build anterior, mostra 546,48 MB de instalação de código, que a API informou como 573.030.400 bytes.
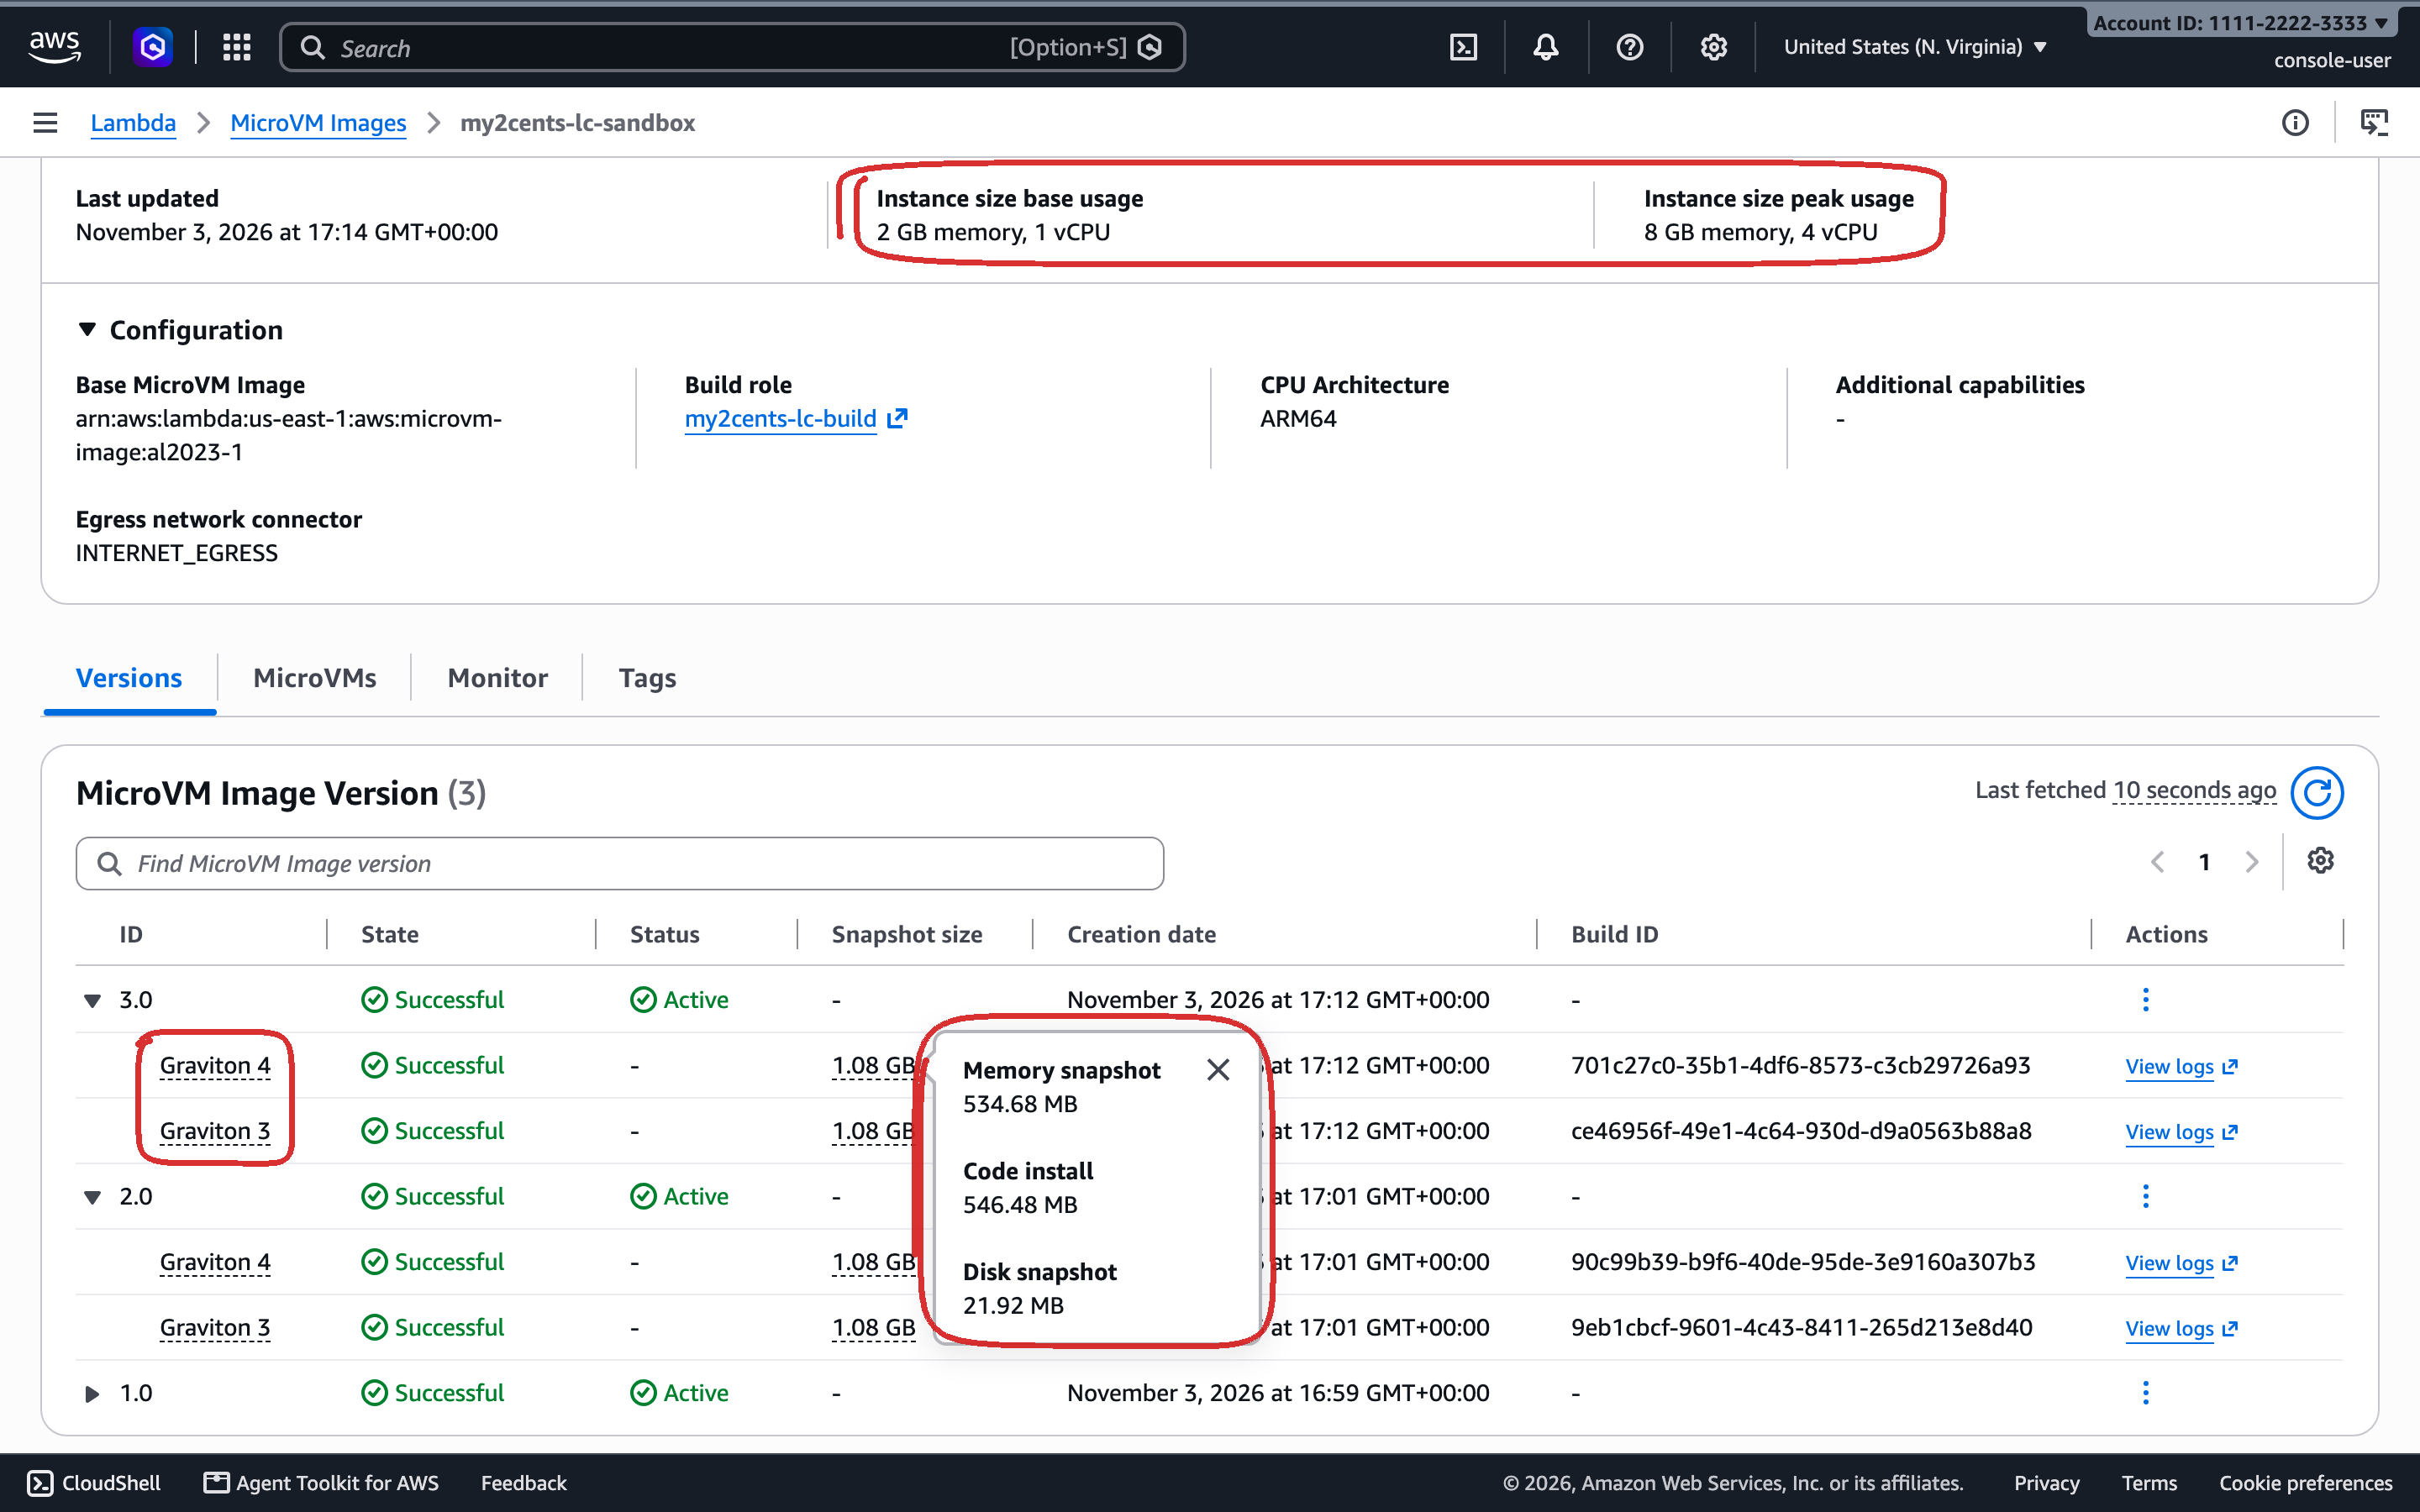
As versões se comportam como você esperaria. Uma execução sem versão pegou a 2.0 (a variável estava definida); uma execução fixada na 1.0 não tinha a variável. Depois de update-microvm-image-version --status INACTIVE na 1.0, uma execução fixada falhou com ResourceNotFoundException: No active version found … and version 1.0, e reativar a versão funcionou. Uma pegadinha: o get-microvm-image precisa do ARN da imagem. O guia de primeiros passos passa só o nome, o que retorna Invalid ARN format, e o guia de lançamento diz que o run-microvm também precisa do ARN.
O x86 ainda não está disponível: cpuConfigurations=[{"architecture": "X86_64"}] falha na validação, embora o Service Quotas já liste uma cota de memória X86_64.
Teste 2: Rodar uma MicroVM e inspecionar os padrões
Só com --image-identifier, o run-microvm preenche uma duração máxima de 8 horas, HTTP_INGRESS, INTERNET_EGRESS, nenhuma policy de ociosidade (então ela nunca suspende sozinha) e nenhuma execution role. Cinco execuções sequenciais do 02_run_defaults.py:
run 1: microvm-7f01aa14-…  RUNNING after 2.10s  first 200 after 2.54s
run 2: microvm-66aed7ac-…  RUNNING after 1.58s  first 200 after 2.02s
run 3: microvm-139f989c-…  RUNNING after 1.80s  first 200 after 2.24s
run 4: microvm-083bee36-…  RUNNING after 2.05s  first 200 after 2.50s
run 5: microvm-3d0831a6-…  RUNNING after 1.83s  first 200 after 2.28s
median: RUNNING 1.83s | first 200 2.28s (min 2.02, max 2.54)
Cerca de 1,8 s até RUNNING e 2,3 s até a primeira resposta pelo endpoint, medidos a partir de logo antes da chamada à API, então os 2,3 s incluem o meu app respondendo pelo endpoint público. Um teste exploratório anterior, com outra imagem, levou de 2,35 a 3,0 s, então a imagem pode fazer diferença.
Por dentro, o guest informa o tamanho de pico, não o baseline:
-- cpu      4 | Model name: Neoverse-V1      (Graviton 3)
-- memory   MemTotal: 8209056 kB
-- disk     /dev/vdc  7.8G  453M  7.0G  7% /
-- user     uid=0(root)
-- pid 1    python -u agent.py
-- kernel   Linux 6.1.166-24.303.amzn2023.aarch64
-- network  eth0 169.254.0.2/30, resolvers 127.0.0.2 and 169.254.53.53
Esse é o modelo de baseline e burst: você paga por 2 GB / 1 vCPU enquanto a MicroVM roda, e por segundo pelo que passar disso, até 4x. E funciona de verdade: alocar e acessar 6 GiB levou de 1,5 a 1,7 s, e quatro workers limitados por CPU rodaram, cada um, no mesmo ritmo de um só em uma execução no Graviton 4, e a cerca de 5% dele em uma execução no Graviton 3 (o chipset varia por MicroVM). O seu container é o PID 1 no próprio namespace, como root, com o conjunto padrão de capabilities do Docker.
Teste 3: Comandos, arquivos e o endpoint
O 03_endpoint.py começa pela autenticação, que funciona como documentado. Sem token, com um token inválido, com um token da porta 8080 usado na 8081 ou com o token da MicroVM A na MicroVM B, o endpoint retorna 403. Com --slow, o script também testa a expiração: um token de um minuto ainda foi aceito aos 95 s e recusado aos 125 s, então os tokens sobrevivem à própria expiração por algo entre 35 e 65 segundos.
Os hooks, porém, são só mais uma porta. Com um token restrito à porta 9001, consegui fazer POST /aws/lambda-microvms/runtime/v1/run do meu laptop, e o agente registrou um segundo evento run. Registrar o endereço de origem não ajudou: as chamadas reais de hook do Lambda, a minha chamada forjada e todos os requests normais chegam de 127.0.0.1.
hook events the agent saw (hook, payload bytes, peer address):
   ready None 127.0.0.1
   run 53 127.0.0.1
run 12 127.0.0.1 <- sent by me, through the endpointallPorts (os exemplos da documentação usam esse tipo) se os seus hooks fazem algo que importa. Coloque os hooks em uma porta própria e restrinja todo token à porta do app, porque o seu app não consegue distinguir as chamadas de hook do Lambda das chamadas encaminhadas.
O endpoint em si é bem capaz. Um request de 100 s foi concluído. As linhas de SSE chegaram com um segundo de intervalo, à medida que eram impressas, sem buffer. O HTTP/2 foi negociado, e um echo de WebSocket na porta 8081 (token e porta passados como subprotocolos) respondeu em 92 a 94 ms a partir do meu laptop. A largura de banda foi melhor do que a documentada: 4 MB/s é o limite declarado para uma MicroVM de 2 GB, e eu medi de 7,9 a 9,9 MiB/s de upload e de 7,9 a 9,2 MiB/s de download em três execuções, sustentados ao longo de 100 MiB.
Duas coisas não bateram com a documentação:
NO_INGRESSnão impede HTTP. Uma MicroVM iniciada só comNO_INGRESScontinuou emitindo tokens e servindo{"ok": true}do meu agente pelo endpoint, três vezes em três. Só os tokens de shell foram recusados (Shell access requires SHELL_INGRESS network connector…). A documentação diz queNO_INGRESSdesativa o ingress. Você ainda precisa de um token, então a exposição é “quem puder chamarCreateMicrovmAuthToken”, mas a opção não faz o que diz.- O shell cai no seu container. Com
SHELL_INGRESS, owss://<endpoint>/shellenvia um framesession_inite recebe as teclas digitadas como frames binários. O que você recebe é um bash, como root, no container Debian do app, com o meu agente como PID 1 e sem o binárioctr, e não o guest AL2023 que a nota sobrectr task execna página de solução de problemas dá a entender.
Teste 4: Suspender e retomar, três ciclos
O 04_suspend_resume.py grava arquivos no disco e em /tmp, inicia um contador em segundo plano, abre uma conexão TLS com example.com e então suspende por 20 s e retoma, três vezes:
=== Cycle 1 =====================================================
[  1.01s] suspend_microvm until SUSPENDED
[  0.76s] resume_microvm until RUNNING
agent pid 1 -> 1 | in-memory counter 6 -> 8 | file counter 4 -> 6
guest clock advanced 22.4s; guest vs laptop now: +0.03s
disk survives | tmp survives | process-alive | uptime 52.22s
held TCP connection: {'ok': False, 'error': 'SSLEOFError: EOF occurred in violation of protocol'}
new outbound request: 200
…
median: suspend 0.76s | resume 0.76s | first request after RUNNING 290 ms
Suspender e retomar levam menos de um segundo cada: mediana de suspensão de 0,76 s nesta execução e de 0,52 s em uma anterior, e de retomada de 0,76 s nas duas. Tudo sobrevive: os arquivos, o processo em segundo plano, o estado em memória do agente. Os processos ficam congelados, não continuam rodando: o contador andou 2 durante uma suspensão de 22 segundos, enquanto o relógio do guest pulou para a hora certa (a 0,03 s do meu laptop) na retomada. Conexões abertas não sobrevivem: a conexão TLS mantida aberta falhou depois de cada retomada, e conexões novas funcionaram imediatamente. Todos os hooks dispararam: suspend e resume três vezes cada.
Dois detalhes mal acabados: retomar uma MicroVM em RUNNING e suspender uma MicroVM duas vezes retornam HTTP 200 em vez do ConflictException documentado, e com autoResumeEnabled=false, um request para uma MicroVM suspensa recebe um 502 em 0,1 s e a deixa suspensa.
Teste 5: Suspensão automática por ociosidade e auto-resume
Com maxIdleDurationSeconds=60, o 05_idle.py acompanha o estado pelo control plane (que não conta como tráfego):
=== A: no traffic at all ========================================
  SUSPENDED after 62s without endpoint traffic
  request to SUSPENDED MicroVM: HTTP 200 after 0.84s (auto-resume), state now RUNNING
=== B: CPU-bound work, no requests ==============================
  busy MicroVM SUSPENDED after 67s
=== C: outbound-only traffic (curl every 5 s), no requests ======
  outbound-only MicroVM SUSPENDED after 62s
=== D: one held-open SSE stream for 150 s, no other requests ====
  150 lines received; states seen while streaming: ['RUNNING']
=== E: autoResumeEnabled=false, then suspendedDurationSeconds=90
  SUSPENDED after 69s
  request while SUSPENDED: HTTP 502 after 0.29s, state SUSPENDED
  TERMINATED 91s after suspending | MicroVM exceeded maximum lifetime.
O auto-resume é rápido: o primeiro request depois de uma suspensão voltou em 0,31 a 0,85 s em duas execuções, com o Lambda segurando o request enquanto a VM era retomada. Mas só o tráfego de entrada pelo endpoint conta como atividade. Uma MicroVM mantendo uma CPU no máximo e outra fazendo um request de saída a cada 5 s foram suspensas depois de 67 e 62 s, mais ou menos o mesmo que a ociosa (62 s). Um único stream mantido aberto deixou uma MicroVM acordada por 150 s. Para um agente que trabalha sozinho (uma sessão do Claude Code só com tráfego de saída, por exemplo), você tem três opções: nenhuma policy de ociosidade, uma janela de ociosidade maior que a tarefa mais longa ou um driver que mantenha um stream aberto. A mensagem de encerramento no caso E também é enganosa: quem expirou foi o suspendedDurationSeconds, não o tempo de vida máximo. E esse timer só vale depois de uma suspensão por ociosidade, como a do caso E. Quando montei a parte 3, uma MicroVM suspensa com suspend-microvm e suspendedDurationSeconds=60 continuava suspensa 10 minutos depois: uma suspensão manual dura até a duração máxima.
Teste 6: Duração máxima e encerramento
O 06_duration.py roda duas MicroVMs com maximumDurationInSeconds=180: uma continua rodando, e a outra é suspensa com suspend-microvm aos 31 s e deixada suspensa (uma suspensão manual, então o suspendedDurationSeconds não a encerra antes da hora):
A running:   TERMINATED 183s after run | MicroVM exceeded maximum lifetime.
B suspended: TERMINATED 183s after run | MicroVM exceeded maximum lifetime.
C: terminate -> TERMINATED in 1.34s
D: terminate (suspended) -> TERMINATED in 1.30s
O tempo suspenso conta para o limite, como a documentação diz (a comunidade não tinha certeza). Então o limite é tempo de relógio desde o run-microvm, faça a MicroVM o que fizer no meio do caminho, e 8 horas é o máximo que você pode definir. Uma sessão que precise de mais tempo tem que levar o seu estado para uma MicroVM nova.
O stdout do agente no CloudWatch mostra quais hooks rodaram:
A cap while running:   run, terminate
B cap while suspended: run, suspend            <- no terminate
C explicit terminate:  run, terminate
D terminate suspended: run, suspend            <- no terminate
O /terminate não roda para uma MicroVM que está suspensa quando é encerrada, seja porque ela atingiu o limite, seja porque você a encerrou. Se você depende do /terminate para fazer flush de dados ou cancelar um registro, faça esse trabalho também no /suspend.
Teste 7: Listar, filtrar e reconectar a partir de outro processo
No 07_list_reconnect.py, o list-microvms retorna cinco campos por MicroVM (microvmId, state, imageArn, imageVersion, startedAt) e filtra só por imagem e versão. Não há nome, nem tags, nem filtro por estado, então “encontrar o sandbox deste usuário” é trabalho do seu banco de dados, não da API. O payload do hook run é onde ficam os dados por MicroVM, e o limite dele é de 4.096 bytes: 4.097 e 16.384 falharam na validação (Member must have length less than or equal to 4096), enquanto o guia diz 16 KB.
Duas coisas funcionam bem. O clientToken é idempotente (o mesmo token duas vezes retornou a mesma MicroVM), que é o que você quer de um orquestrador que faz retries. E um segundo processo que tinha só o ID da MicroVM se conectou a ela, gerou um token e leu um arquivo gravado pelo primeiro em 1,45 s, incluindo a inicialização do interpretador.
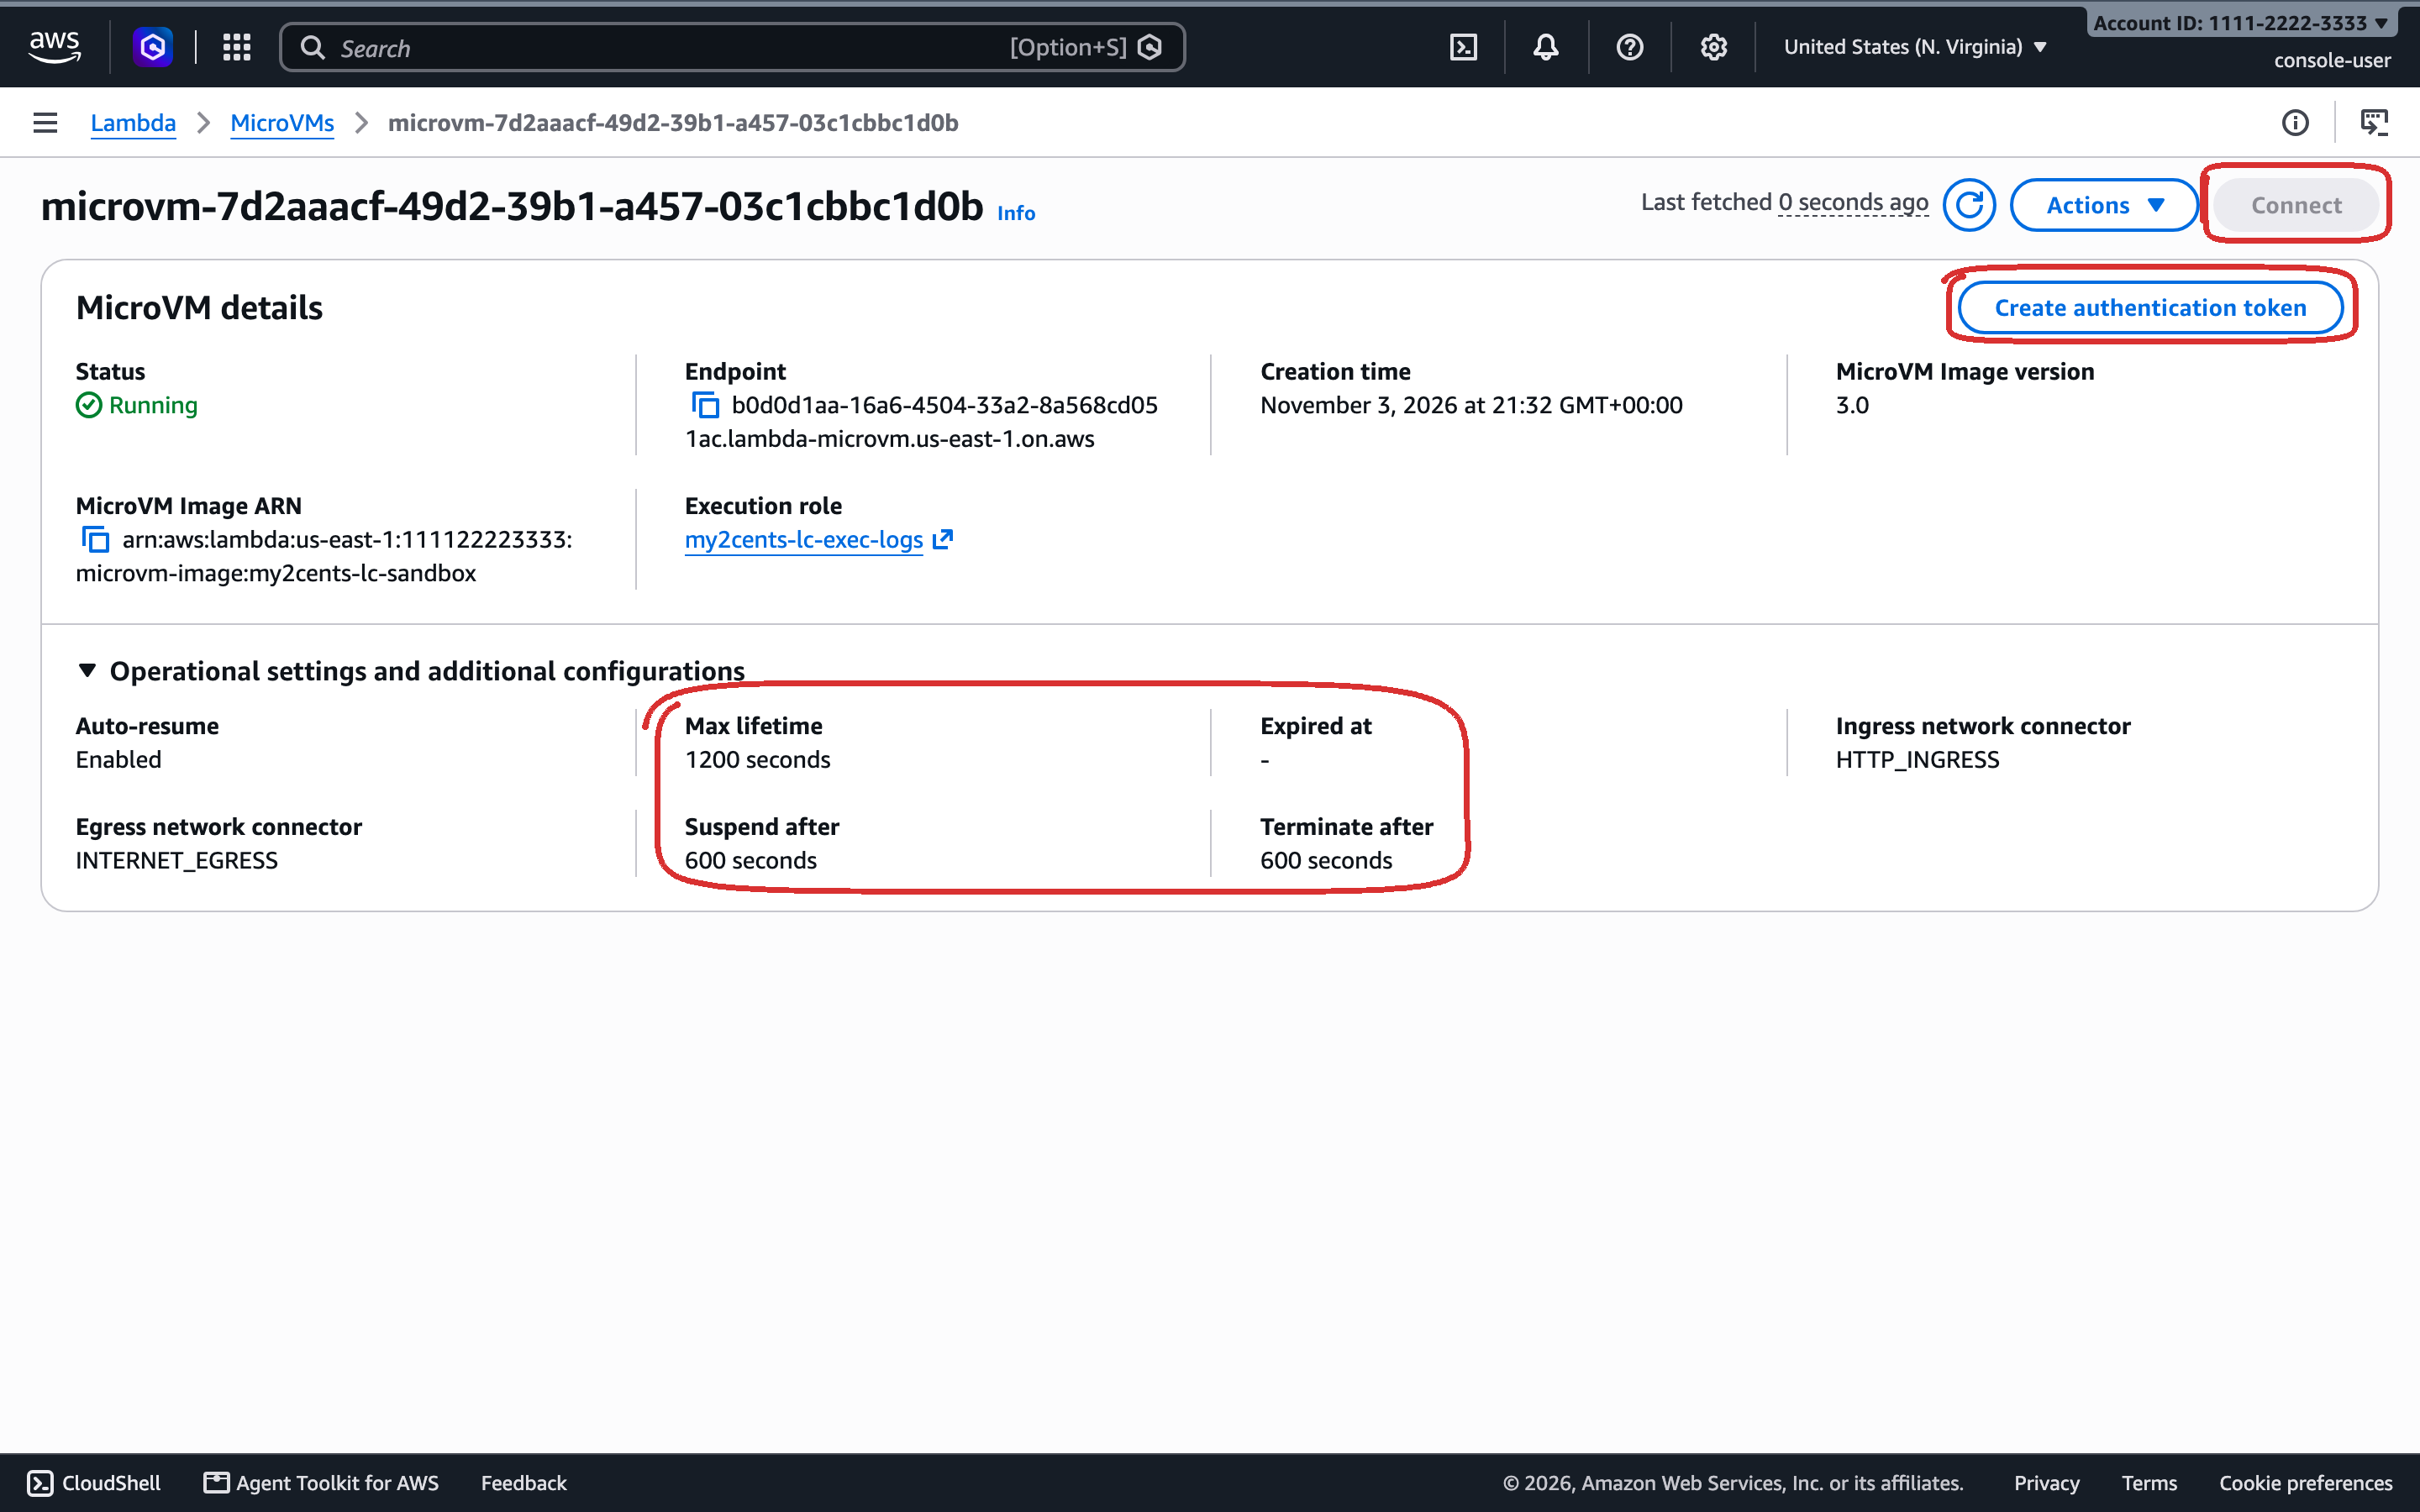
A página MicroVMs do console lista todas as MicroVMs da conta em uma tabela, incluindo as encerradas (129 na minha até o fim do dia). Na página de uma MicroVM, circulei três coisas. Os timers têm nomes diferentes dos da API: “Max lifetime” é maximumDurationInSeconds, “Suspend after” é maxIdleDurationSeconds e “Terminate after” é suspendedDurationSeconds. O botão Create authentication token gera um token de endpoint sem a CLI. E o botão Connect abre um shell; aqui ele está acinzentado, provavelmente porque esta MicroVM não tem o connector SHELL_INGRESS. Iniciei esta MicroVM com um tempo de vida de 20 minutos, só para a captura de tela:
Teste 8: Muitas MicroVMs a partir de um snapshot
Não existe API de fork, então o mais próximo disso é rodar várias MicroVMs a partir de uma imagem e ver o que elas compartilham. O 08_many_from_one.py inicia três em sequência (todas respondendo após 4,52 s com a minha cota de 1 chamada por segundo) e pede a cada agente valores criados em momentos diferentes:
field                          vm0                vm1                vm2
build_uuid (made at import)    97987eff-…         6d9bca20-…         97987eff-…
random.random() now            0.7134323853425568 0.5711589500702194 0.7134323853425568
boot_id                        949631a6-…         efff7f39-…         949631a6-…
counter (thread since build)   3                  3                  3
uuid.uuid4() now               0bbbf8ff-…         7eda5ae6-…         7508876e-…
run_uuid (made in /run)        1122fbbd-…         c9be7242-…         3ecfe54e-…
A vm0 e a vm2 caíram na mesma geração de Graviton, restauraram o mesmo snapshot e são idênticas em tudo que existia antes do snapshot: o UUID gerado no build, o boot_id do kernel e o próximo valor do módulo random do Python, cuja seed foi definida no import, durante o build. A vm1 restaurou o snapshot do outro chipset. O uuid.uuid4() lê a fonte de aleatoriedade do kernel e foi único em todas, assim como tudo que foi criado no /run. A regra da documentação se confirma: gere IDs, tokens e seeds no /run, a partir de uma fonte criptográfica, nunca no momento do import.
O mesmo snapshot faz uma imagem customizada valer menos do que você esperaria, até você usar o hook /validate. Montei a images/datasci (pandas, NumPy, scikit-learn e Matplotlib embutidos, 165 s) e cronometrei o primeiro import em uma MicroVM nova:
| Configuração | Primeiro import pandas, numpy, sklearn, matplotlib |
|---|---|
Imagem simples, pip install em runtime | 24,4 s de instalação, depois 2,4 s |
Stack embutido na imagem, /validate não faz nada | 17,9 s, 16,2 s, 4,1 s |
Stack embutido, /validate faz o import | 1,40 s, 1,46 s, 1,33 s |
O disco do snapshot parece ser buscado sob demanda: um arquivo que ninguém tocou durante o build parece ser lido de um armazenamento remoto na primeira vez que uma MicroVM precisa dele, então uma biblioteca embutida na imagem pode demorar mais para importar do que uma instalada um momento antes. O /validate roda em uma MicroVM nova depois do build, e o Lambda registra quais partes do snapshot esse request toca e faz o prefetch delas no momento da execução. Agora o agente roda um VALIDATE_CMD a partir das variáveis de ambiente da imagem durante o /validate; definir esse comando como os imports levou o primeiro import de 4 a 18 s nesta execução (20 a 44 s em uma anterior) para cerca de 1,4 s. Se o seu sandbox tem um caminho quente (um interpretador, um language server, um modelo), exercite esse caminho no /validate.
Os primeiros imports a frio variaram de 4,1 a 43,6 s em duas gravações, então o lazy fetch também varia muito de uma execução para outra.
Teste 9: A linha de base de egress e identidade
O 09_egress_identity.py roda as mesmas sondagens em uma MicroVM com uma execution role que pode listar buckets do S3 e em outra sem role:
=== execution role (logs + s3:ListAllMyBuckets) =================
egress IP                          184.193.104.115
raw-IP HTTPS (1.1.1.1)             301
DNS straight to 1.1.1.1:53 (UDP)   ;; communications error to 1.1.1.1#53: timed out
DNS over TCP to 1.1.1.1:53         104.20.23.154
IMDSv1 GET (no token)              401
IMDSv2 token PUT                   200
role name from IMDS                execution_role
boto3 credentials                  method=iam-role key=ASIA... token=True
sts get-caller-identity            assumed-role/my2cents-lc-exec-probe/Lambda-microvmsExecutor-microvm-5cf3e44a-…
s3 list-buckets (role allows it)   16 buckets
IMDS as a non-root user            execution_role (as nobody)
RTNETLINK answers: Operation not permitted     <- ip route add blackhole 169.254.169.254
No INTERNET_EGRESS padrão, o TCP de saída vai para qualquer lugar, IPs diretos incluídos, a partir de um endereço da própria AWS que muda por MicroVM (cinco MicroVMs, cinco IPs). DNS para um resolver externo falha por UDP mas funciona por TCP, então o UDP parece bloqueado; não testei outro tráfego UDP. De qualquer forma, isso é uma conveniência, não um controle.
A execution role é a parte que exige planejamento. O IMDS é só v2, e qualquer processo na MicroVM, root ou nobody, consegue ler as credenciais temporárias da role e usá-las; o nome da sessão carrega o ID da MicroVM, então o CloudTrail pelo menos consegue distinguir as MicroVMs. Você também não consegue cercar o IMDS por dentro: adicionar uma rota blackhole falha porque o container não tem CAP_NET_ADMIN (você precisaria de additionalOsCapabilities: ["ALL"], o que também entrega a capability ao seu código não confiável). Sem role, o IMDS responde mas não tem credenciais, e nada na VM consegue chamar a AWS.
Então, com os padrões, um agente em uma MicroVM alcança a internet inteira e usa todas as permissões que você deu à execution role. O próprio exemplo de Claude Managed Agents da documentação lê um secret do Secrets Manager por essa role, na mesma VM onde rodam as chamadas de ferramenta do agente. A parte 2 leva o egress para uma VPC e as credenciais para um proxy fora da VM.
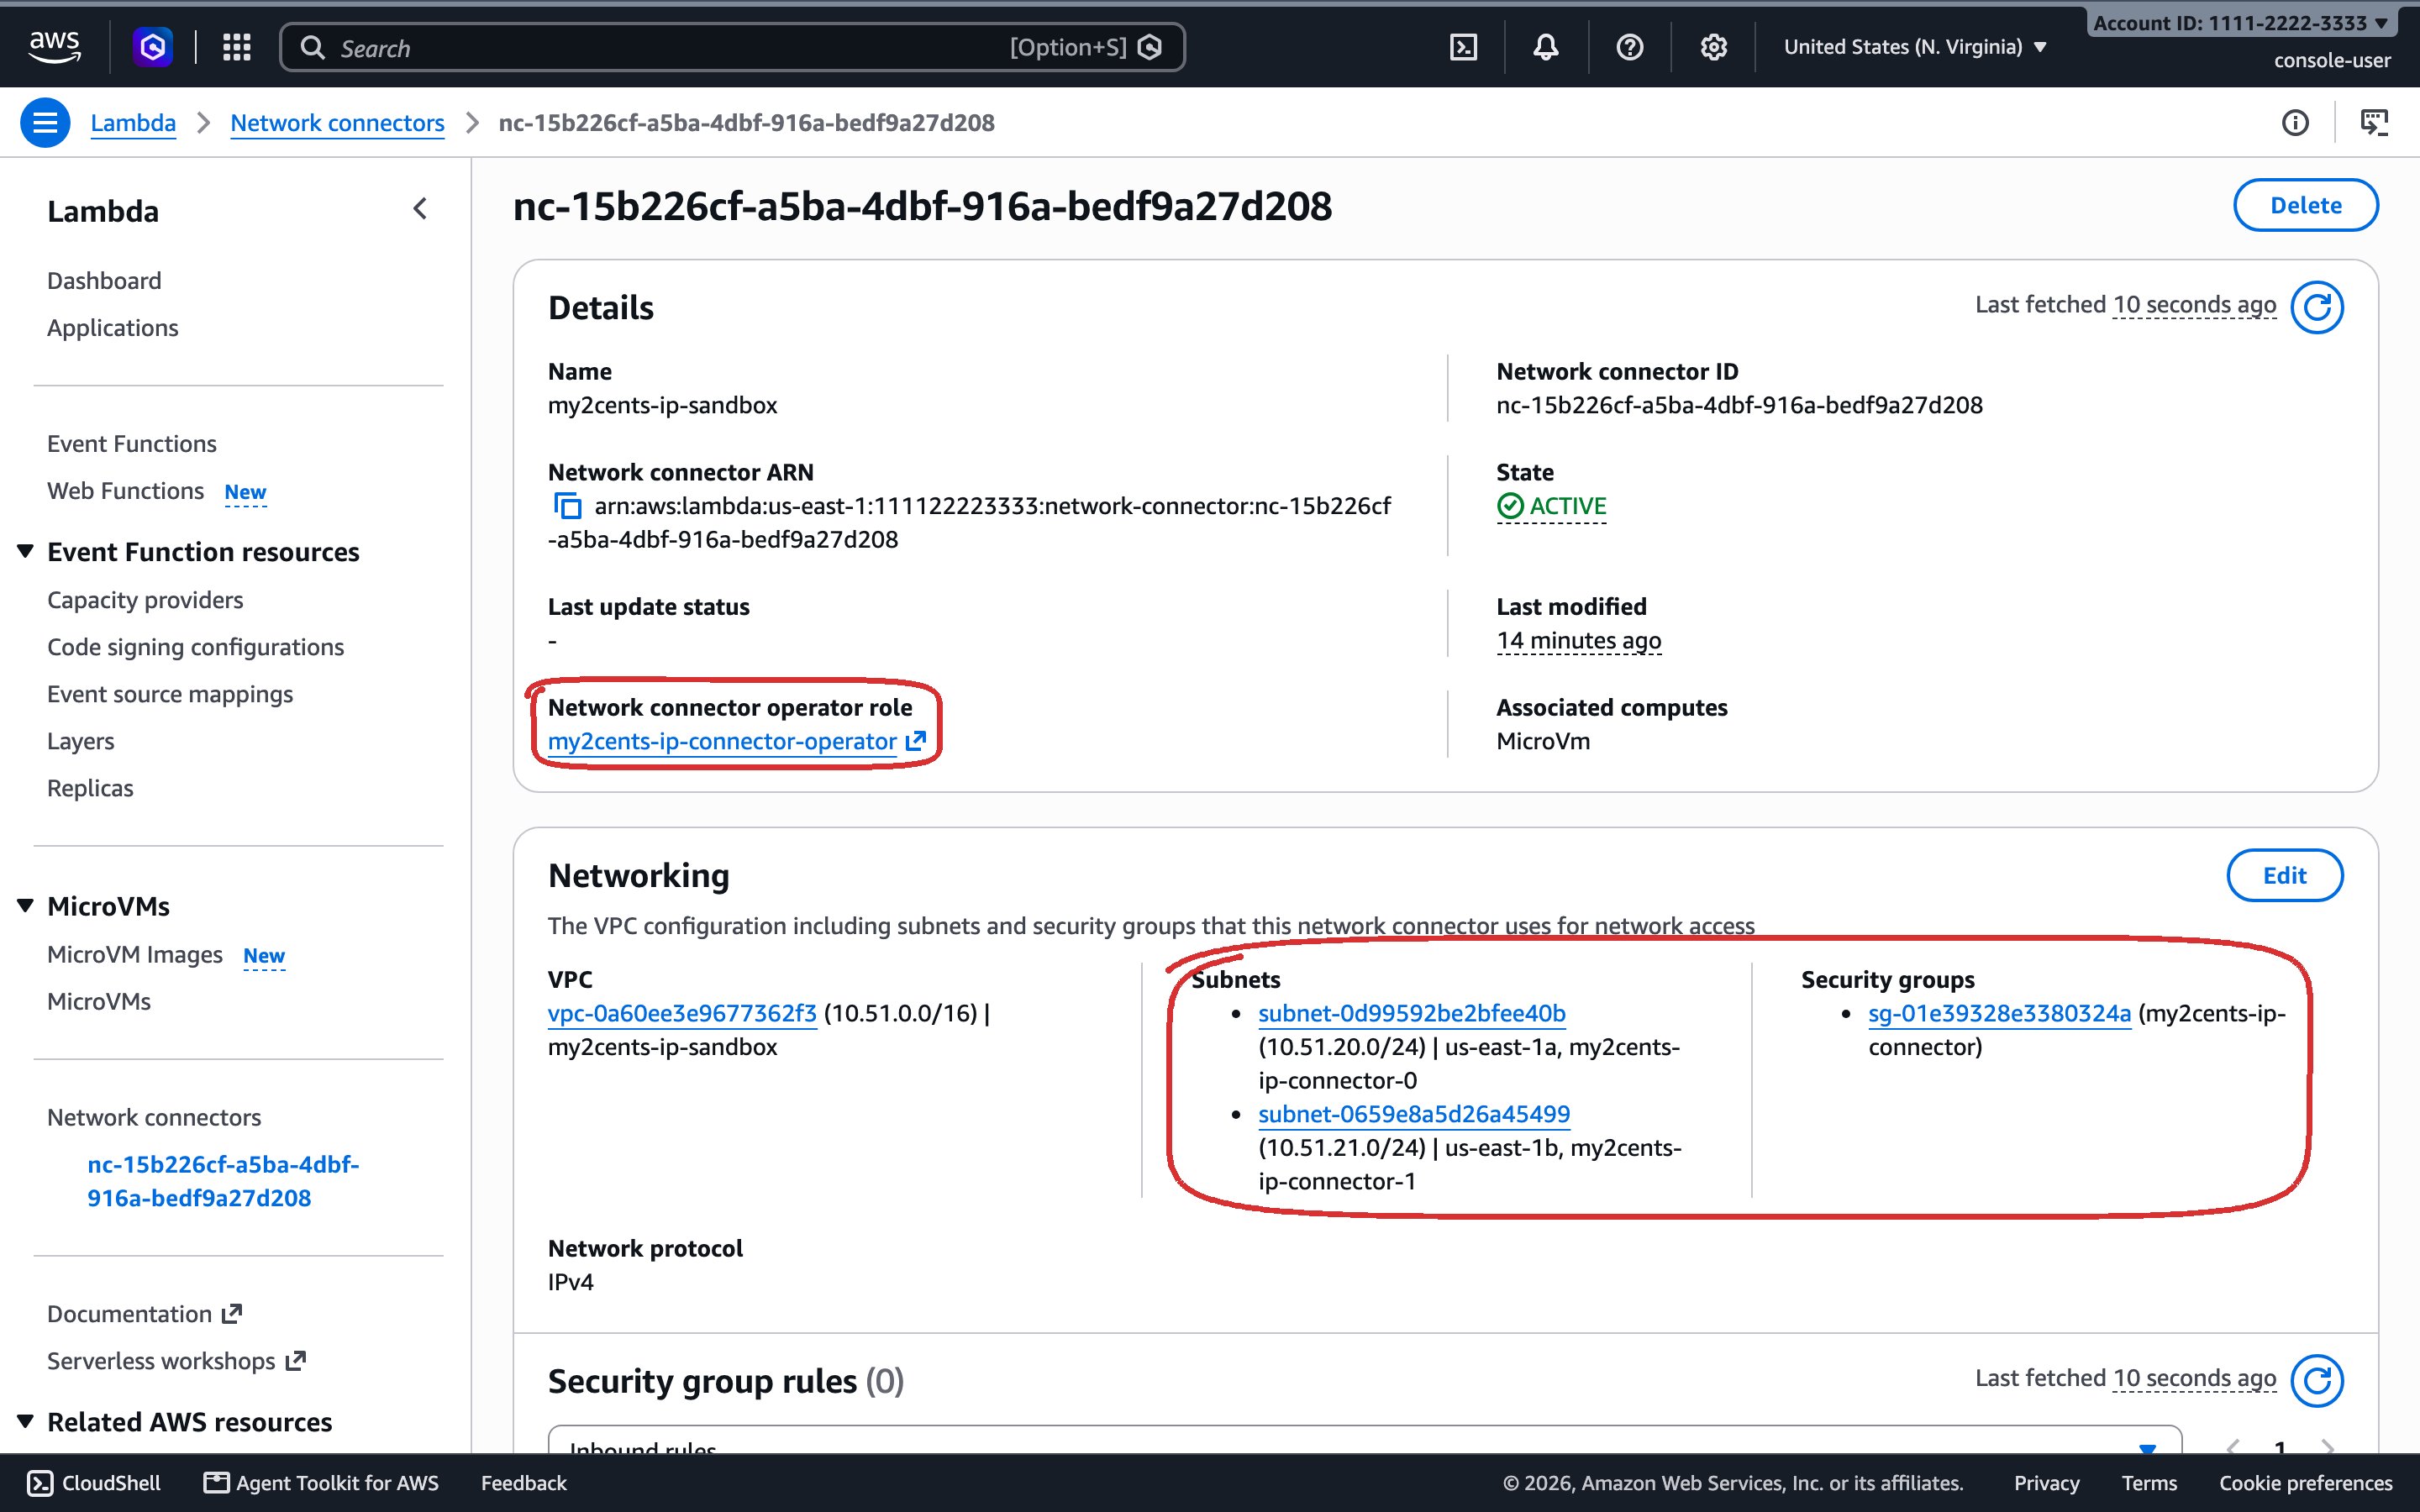
Também não existe uma opção “sem egress”: quando montei a parte 3, uma MicroVM executada com uma lista egressNetworkConnectors vazia subiu com INTERNET_EGRESS anexado mesmo assim. A única alternativa ao INTERNET_EGRESS é um connector de egress de VPC, um recurso próprio que fica em Network connectors no console. Só os connectors que você cria aparecem ali, não os gerenciados pelo Lambda. Este é o da parte 2. Circulados: a role de operador que o Lambda usa para criar interfaces de rede nas suas subnets, e as subnets e o security group que decidem para onde o tráfego IPv4 das MicroVMs pode ir. O connector é só IPv4; a parte 2 trata do endereço IPv6 que o Lambda também dá a cada MicroVM.
Teste 10: Cotas e a conta
O 10_quota_bill.py compara cada cota de MicroVM com o padrão da AWS. Quatro estavam abaixo do padrão na minha conta:
Max allocated ARM_64 MicroVM memory      applied     8.0  default  2048.0  <- below default
Max allocated X86_64 MicroVM memory      applied     8.0  default  2048.0  <- below default
Rate of RunMicrovm API requests          applied     1.0  default     5.0  <- below default
Burst rate of RunMicrovm API requests    applied     1.0  default     5.0  <- below default
A cota de memória é aplicada à risca. Quatro MicroVMs de 2 GB iniciaram; a quinta falhou com ServiceQuotaExceededException: The base maximum allocated memory limit has been reached for this account. MicroVMs suspensas também contam: com as quatro suspensas, uma quinta ainda falhou. A cota de taxa é mais frouxa do que parece: quatro chamadas run-microvm simultâneas, com os retries do cliente desligados, tiveram sucesso, em 0,2 a 0,44 s.
Aumentar a cota de taxa pelo Service Quotas abriu dois casos de suporte automaticamente. O aumento de memória não pôde passar pelo Service Quotas de jeito nenhum, já que ele só aceita valores acima do padrão de 2.048 GB, então abri um caso de suporte pelo console.
Resumo dos resultados
| Operação | Medido (boto3 1.43.123, us-east-1, a partir do meu laptop) |
|---|---|
| Build de imagem (primeira versão / atualização) | 124,5–134,8 s / 113,7–124,6 s; um snapshot por geração de Graviton |
run-microvm até RUNNING | mediana de 1,83–1,84 s (1,58–2,10 s, duas rodadas de 5) |
run-microvm até o primeiro HTTP 200 | mediana de 2,28 s (2,02–2,54 s) |
| Suspensão / retomada (explícitas) | mediana de 0,52–0,76 s / 0,76 s; primeiro request 290 ms após RUNNING |
Suspensão por ociosidade com maxIdleDurationSeconds=60 | 62–69 s; trabalho de CPU e tráfego de saída não contam |
| Auto-resume, primeiro request | 0,31–0,85 s |
Encerramento até TERMINATED | 1,29–1,34 s (em execução ou suspensa) |
| Largura de banda do endpoint, 100 MiB (MicroVM de 2 GB) | 7,9–9,9 MiB/s de upload, 7,9–9,2 MiB/s de download (documentado: 4 MB/s) |
| Limite do payload do hook run | 4.096 bytes (documentado: 16 KB) |
| Duração máxima | conta o tempo suspenso; o limite de 180 s terminou em 183–185 s |
| 3 MicroVMs a partir de uma imagem, em sequência | todas respondendo após 4,48–4,52 s (cota de 1 chamada/s) |
| Primeiro import de um stack de data science embutido na imagem | 4,1–43,6 s sem warm-up no /validate, 1,07–1,46 s com warm-up |
| Cota de memória (8 GB na minha conta) | 4 × 2 GB em execução ou suspensas; a quinta é recusada |
São medições em uma única região, a partir de um laptop em uma conexão residencial. Use-as para ter uma noção de escala, não como benchmark.
Preços
As MicroVMs são cobradas por segundo enquanto rodam, pelo baseline mais o que for usado acima dele (preços, us-east-1, ARM):
| Recurso | Preço |
|---|---|
| vCPU | US$ 0,0000276944 por vCPU-segundo |
| Memória | US$ 0,0000036667 por GB-segundo |
| Armazenamento de snapshot (imagens e MicroVMs suspensas) | US$ 0,08 por GB-mês (imagens: mínimo de uma semana) |
| Leitura / escrita de snapshot | US$ 0,00155 / US$ 0,0038 por GB |
| MicroVM padrão (1 vCPU, 2 GB) em execução | ≈ US$ 0,126 por hora, ≈ US$ 1,01 pelas 8 horas completas |
Uma MicroVM suspensa deixa de pagar por computação e passa a pagar armazenamento de snapshot, mais uma escrita de snapshot a cada suspensão e uma leitura a cada retomada: cerca de US$ 0,011 por ciclo para uma MicroVM de 2 GB, o equivalente a uns cinco minutos de execução. Sessões que ficam ociosas por longos períodos custam bem menos do que o preço em execução sugere; as que suspendem a cada poucos minutos, não.
Limpeza
python 11_cleanup.py                 # terminate this repo's MicroVMs, delete the images
terraform -chdir=infra destroy       # bucket and roles
O 11_cleanup.py encerra todas as MicroVMs iniciadas a partir das imagens deste repositório e apaga as imagens. As imagens continuam cobrando armazenamento de snapshot até você apagá-las, com um mínimo de uma semana, então não pule esta etapa.
Veredito
As Lambda MicroVMs fazem bem a parte difícil. Uma MicroVM restaurada a partir de um snapshot respondeu em cerca de dois segundos, suspendeu e voltou em menos de um segundo cada vez, com a memória e os processos intactos, e o auto-resume segurou um request por menos de um segundo enquanto ela acordava. O endpoint aguentou tudo o que joguei nele, e tudo isso vive na minha própria conta, sob IAM e CloudTrail.
Tudo o que fica acima da VM é você quem constrói, e as arestas são afiadas.
O que funciona
- Snapshots. Cerca de 2 s até
RUNNINGmais uma resposta, suspensão de 0,5 a 0,8 s, retomada de 0,8 s, memória e processos intactos. - O endpoint. Tokens por MicroVM e por porta; HTTP/2, WebSockets, SSE e requests de 100 segundos; mais largura de banda do que a documentada.
/validatecomo dica de prefetch. Um stack de data science embutido na imagem foi de 4 a 44 s no primeiro import, em duas execuções, para menos de 1,5 s quando o hook passou a exercitá-lo.- Sua conta, seus controles. Versões de imagem que você pode fixar e desativar, execuções idempotentes com
clientTokene um nome de sessão que liga cada chamada à AWS a um ID de MicroVM.
O que não funciona
- Você constrói o sandbox. Sem API de exec, de arquivos ou de fork, sem tags e com um payload de run de 4 KB para dados por MicroVM.
- O ciclo de vida tem armadilhas. A ociosidade só conta o tráfego de entrada pelo endpoint, então agentes trabalhando são suspensos. Conexões abertas morrem na retomada. O limite de 8 horas conta o tempo suspenso, e o
suspendedDurationSecondsignora suspensões manuais. O/terminatenunca roda para uma MicroVM suspensa. Todas as MicroVMs do snapshot de um mesmo chipset compartilham o estado aleatório do Python. - Os padrões não são uma fronteira de segurança. O egress é a internet aberta, e a execution role pode ser lida por tudo o que roda na VM.
- Cotas. Minha conta recebeu 8 GB e 1 chamada por segundo, contra os padrões do Service Quotas de 2.048 GB e 5. As cotas são por conta e a AWS diz que aumenta as cotas baixas conforme o uso, mas aumentar a memória por conta própria exige um caso de suporte.
Quem deve usar
Times que já estão na AWS e querem isolamento de VM para código não confiável dentro da própria conta, e que estão prontos para escrever o agente, a gestão das sessões e os controles de egress e de credenciais em volta dele. Se você quer chamar um SDK de sandbox hoje à tarde e seguir em frente, não é disso que se trata. A parte 2 constrói a camada de egress e credenciais que falta, com o iron-proxy.