AWS Nitro Sandboxes no ECS: Hands-On com Tasks Isoladas e Confidenciais
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Ferramentas
- Passo 2: Dependências com Terraform
- Passo 3: O cluster
- Passo 4: Um capacity provider com Nitro Enclaves
- Passo 5: Task definitions com um modo de isolamento
- Passo 6: Rodar as tasks
- Testes
- Teste 1: Cold start, e onde as tasks vão parar
- Teste 2: Uma task isolada e uma compartilhada, lado a lado
- Teste 3: O que “host” significa dentro de um sandbox
- Teste 4: O serviço de metadados
- Teste 5: Overhead de memória por tamanho de sandbox
- Teste 6: Gerando a policy de uma task confidencial
- Teste 7: Confidencial, isolada e adulterada
- Resumo dos resultados
- Operação e Monitoramento
- Preços
- Limpeza
- Veredito
- O que funciona
- O que ainda não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine uma prateleira onde todos os brinquedos dividem uma caixa grande e aberta. Agora cada brinquedo pode ganhar a sua própria caixinha na mesma prateleira, com tampa própria, para que um brinquedo bagunceiro não se espalhe por cima dos outros.
A caixinha ocupa um pouco mais de espaço, e os brinquedos menores são os que mais perdem espaço com ela. Também existe uma caixa especial com um selo que diz exatamente o que tem dentro. Um adulto só abre o pote de biscoitos para uma caixa cujo selo bate, e se alguém trocar o brinquedo, a caixa nem abre.
No Amazon ECS, o isolamento agora é uma propriedade da task definition. Uma task marcada como isolada roda na sua própria máquina virtual em uma instância compartilhada, então um tenant comprometido tem uma fronteira de hardware a atravessar antes de alcançar outro. A própria task definition continua sendo uma entrada confiável, então controle quem pode registrar uma.
O modo confidencial acrescenta evidência. A task apresenta uma medição assinada da sua própria policy, e uma chave do AWS KMS só libera um segredo se houver correspondência. Nos testes, o mesmo container sem essa policy foi recusado, e um comando alterado nunca chegou a iniciar.
A queixa principal são containers em uma instância compartilhando um único kernel. A intervenção é uma máquina virtual dedicada por task, prescrita com um campo na task definition. Na minha execução, a task isolada tinha o seu próprio kernel e via só 1 vCPU e cerca de 2 GiB, ao lado de uma task comum na mesma instância.
Os efeitos colaterais dependem da dose: pelo menos 262 MiB de memória extra por task, o que dá 51% em uma task de 512 MiB e 6% em 8 GiB. Para tasks confidenciais, a evidência é forte: o KMS liberou uma chave só para a task cuja medição de policy correspondia.
Times que compartilham instâncias entre clientes costumam carregar uma preocupação silenciosa com o vizinho que ninguém avaliou. Aqui a resposta é um checkbox e um campo, e o console guia você pelos dois, o que tira um pouco do medo de dizer sim.
O novo peso é a burocracia. Tasks confidenciais precisam de uma policy gerada, e qualquer mudança na imagem, no comando ou no ambiente significa gerá-la de novo e atualizar a key policy. Espere que quem cuida dos releases queira esse ciclo automatizado antes de ficar tranquilo com ele.
Imagine uma sala de ensaio onde todas as bandas dividiam as mesmas paredes e o mesmo amplificador. Agora cada atração pode ter a sua própria cabine com isolamento acústico dentro dessa sala, do tamanho da atração: uma vCPU, dois gigas, nada emprestado da casa.
Só que as cabines ocupam espaço no chão: pelo menos 262 MiB cada, além do que a própria atração usa, o que pesa mais para as atrações pequenas. A cabine confidencial também toca a partir de uma partitura lacrada. Mude um compasso depois da assinatura, e a cabine não abre para o show.
A história para clientes do ECS é simples: isolamento por máquina virtual em cada task, no ECS Managed Instances, sem cobrança adicional. Ativá-lo exige um capacity provider novo, já que a configuração do Nitro só existe na criação, e um campo na task definition. O console mostra os dois antes da documentação.
A prova está no modo confidencial. Uma chave do KMS que só abre para uma task cuja medição de policy corresponde é uma demo que compradores de setores regulados entendem na hora. Seja honesto sobre o custo: pelo menos 262 MiB de memória por task, então serve melhor para tasks médias do que para as minúsculas. E teste os deploys cedo: os rolling updates de services em sandbox criados pelo console falharam até eu desligar a consistência de versão do container.
 Veja o código-fonte aqui: aws-nitro-sandboxes
Visão Geral
Em 2026-11-09 a AWS lançou os Nitro Sandboxes: VMs leves que o hypervisor Nitro recorta de uma instância EC2, cada uma um guest de primeiro nível ao lado da sua instância pai. No Amazon ECS, o recurso se chama tasks isoladas e confidenciais, “um recurso de execução confiável do Amazon ECS Managed Instances”: cada task roda na sua própria VM leve, e várias delas podem compartilhar uma instância.
Este post, parte 3 de 4, cobre o ECS. A parte 1 explica a arquitetura e compara as três portas de entrada, a parte 2 opera a primitiva crua no EC2 com Firecracker, e a parte 4 cobre o EKS.
No ECS, a “mudança de uma linha” do anúncio é um campo na task definition, trustedExecutionConfiguration, e ele só funciona em um capacity provider que foi criado com o Nitro Enclaves ativado. A documentação do ECS descreve os dois na referência da API, mas não mostra nenhum procedimento no console, e deixa em aberto o que eu mais queria saber: uma task comum vai parar na mesma instância que uma isolada, quanto um sandbox custa em memória abaixo de 8 GiB, o que uma configuração de nível de host significa dentro de uma VM, e a atestação do modo confidencial funciona de ponta a ponta? Eu rodei tudo em um cluster com um capacity provider de Managed Instances fixado em m8g.xlarge (Graviton4, 4 vCPU, 16 GiB) na us-east-1 em 2026-11-09, com a AWS CLI 2.39.7, e configurei tudo pelo console. Em 2026-11-10 eu repeti os testes principais em uma segunda execução, gravada, e acrescentei o ECS Exec. Uma terceira execução naquele dia, para a seção de operações do vídeo, manteve um service em sandbox rodando para ver como ele se comporta no dia a dia (Operação e Monitoramento).
Três resultados se destacaram:
- Uma task isolada é uma VM do tamanho da task. Ao lado de uma task comum na mesma instância, ela tinha o seu próprio kernel e via 1 vCPU e 2,2 GiB, enquanto a task comum via o kernel da instância, as 4 vCPUs e os 16 GiB inteiros.
pidMode: hostcomprivileged: truerodou, e o “host” acabou sendo o sandbox. - O modo confidencial condiciona uma chave do KMS à policy da task. O KMS liberou um segredo para uma task confidencial e recusou o mesmo container rodando isolado: dos PCRs que eu imprimi (PCR0, PCR8, PCR17), só o PCR17, a policy, era diferente. Um comando alterado depois de a policy ser gerada nunca iniciou.
- O preço é memória, e as tasks pequenas pagam mais. Cada sandbox custou pelo menos 262 MiB além da memória da própria task: 51% a mais em uma task de 512 MiB, 6% em 8 GiB.
Arquitetura
Duas configurações fazem isso funcionar, em dois níveis. O nitroEnclavesEnabled do capacity provider faz o ECS lançar instâncias com a opção Nitro Enclaves do EC2 ativada, o mesmo switch que eu liguei à mão na parte 2, e o ECS as registra com o atributo ecs.capability.nitro-enclaves. Depois, o isolationMode da task definition decide, task por task, se ela roda no runtime de containers compartilhado da instância ou em um sandbox só dela. Cada sandbox reserva memória, nas palavras da documentação, “para o kernel Linux, a microVM, o containerd e o agente de sandbox do ECS”, e, para uma task confidencial, esse agente avalia a policy de atestação antes de qualquer container iniciar.
Os modos não correspondem um a um aos do EC2. A parte 2 tinha o modo direto (a instância pai consegue ler a memória do guest) e o modo confidencial (ela não consegue). O ECS tem três: SHARED, um container comum; ISOLATED_SANDBOX, em que a instância é confiável e a task não é; e CONFIDENTIAL_SANDBOX, em que a instância não é confiável, o sandbox é a fronteira de confiança e a task precisa levar uma policy de atestação. O Teste 2 mostra qual modo do EC2 fica por baixo do isolado.
Configuração
O Terraform cria as dependências. O cluster, o capacity provider, as task definitions e as tasks são criados no console, com o equivalente na AWS CLI abaixo de cada passo. O README de apoio tem todos os comandos, com os placeholders preenchidos por sed e jq.
Passo 1: Ferramentas
Você precisa da AWS CLI 2.39.7 ou mais recente. O changelog dela é o primeiro a trazer o recurso: “O Amazon ECS Managed Instances agora suporta tasks isoladas e confidenciais, que rodam em AWS Nitro Sandboxes. Configure-as com trustedExecutionConfiguration nas task definitions e nitroEnclavesEnabled nos capacity providers.” Em 9 de novembro o Homebrew ainda servia a 2.39.6, então eu instalei o pacote da própria AWS, como na parte 2.
O Terraform só cuida das dependências, e em 9 de novembro não conseguiria fazer mais: o provider AWS do Terraform não tinha nenhum dos dois campos, e o CloudFormation tinha NitroEnclavesEnabled no capacity provider, mas nenhum TrustedExecutionConfiguration em AWS::ECS::TaskDefinition. A única ferramenta só para Linux é o gerador de policy para tasks confidenciais. Para esta demo eu o rodei no próprio cluster (Teste 6), então não precisei de uma máquina Linux, mas isso é um atalho: em produção, rode-o em CI, no CloudShell, ou em uma estação de trabalho ou container Linux, pelo motivo explicado no Teste 6.
Passo 2: Dependências com Terraform
A configuração do Terraform cria uma VPC (10.62.0.0/16, duas subnets privadas e duas públicas, um NAT gateway), um security group só de egress, my2cents-nitro-ecs-tasks, a infrastructure role do Managed Instances (AmazonECSInfrastructureRolePolicyForManagedInstances), a instance role e o instance profile (AmazonECSInstanceRolePolicyForManagedInstances), uma task execution role, uma task role e o log group /ecs/my2cents-nitro-sandbox. Um nome importa:
# The name must start with ecsInstanceRole: the infrastructure policy scopes iam:PassRole to it
resource "aws_iam_role" "instance" {
  name = "ecsInstanceRole-my2cents"
  assume_role_policy = jsonencode({
    Version   = "2012-10-17"
    Statement = [{ Effect = "Allow", Principal = { Service = "ec2.amazonaws.com" }, Action = "sts:AssumeRole" }]
  })
}
A página do instance profile é direta: “um nome que não corresponde causa um erro de autorização no lançamento da task.” A task role recebe as permissões ssmmessages de que o ECS Exec precisa e nada para o KMS; o Teste 6 concede kms:Decrypt em uma key policy, com condições de atestação, e em nenhum outro lugar.
terraform -chdir=terraform init
terraform -chdir=terraform apply
NET=$(terraform -chdir=terraform output -raw run_task_network_configuration)   # subnets + SG for run-task
Passo 3: O cluster
Em Amazon ECS > Clusters > Create cluster, não há nenhum controle de Nitro ou de sandbox em lugar nenhum, nem mesmo em “Fargate and managed instances” com “Use custom - advanced”. A configuração fica no capacity provider, e a chamada de update da API não tem o membro nitroEnclavesEnabled, então um provider criado sem ele não pode ser corrigido depois pela API. Eu criei o cluster como Fargate only e adicionei o provider no passo seguinte.
aws ecs create-cluster --cluster-name my2cents-nitro-ecsPasso 4: Um capacity provider com Nitro Enclaves
Em Clusters > my2cents-nitro-ecs > Infrastructure > Capacity providers > Create:
- Nome
my2cents-nitro-cp, tipo Amazon ECS Managed Instances. - Infrastructure role
ecsInfrastructureRole-my2centse Instance profileecsInstanceRole-my2cents. Escolha os dois na lista; digitar o nome dá “Value is not a valid profile ARN”. - As duas subnets privadas e o security group
my2cents-nitro-ecs-tasks. - Instance selection: Use custom - advanced, CPU de 4 a 4, Memory de 16384 a 16384, e o atributo Allowed instance types =
m8g.xlarge. O console responde “View matching instance types (1)”. - Storage de 30 GiB.
- Em Advanced configuration, uma seção nova diz “Nitro Enclaves - new: Launch instances with Nitro Enclaves so that tasks can run in an isolated sandbox”, com um checkbox Turn on Nitro Enclaves e a nota “Nitro Enclaves is not supported with local storage.”
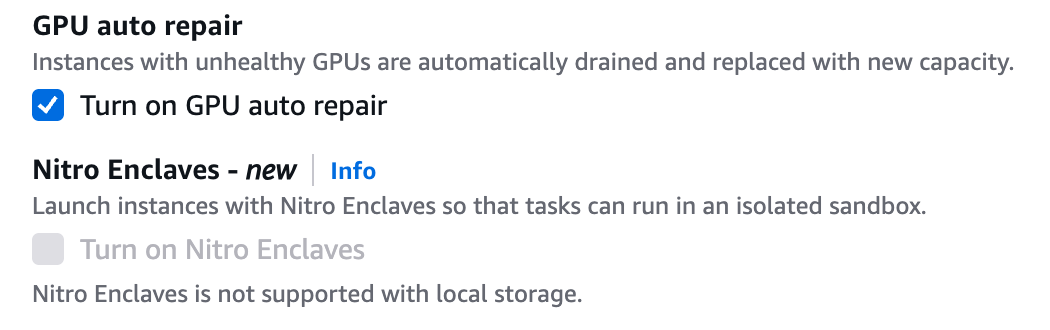
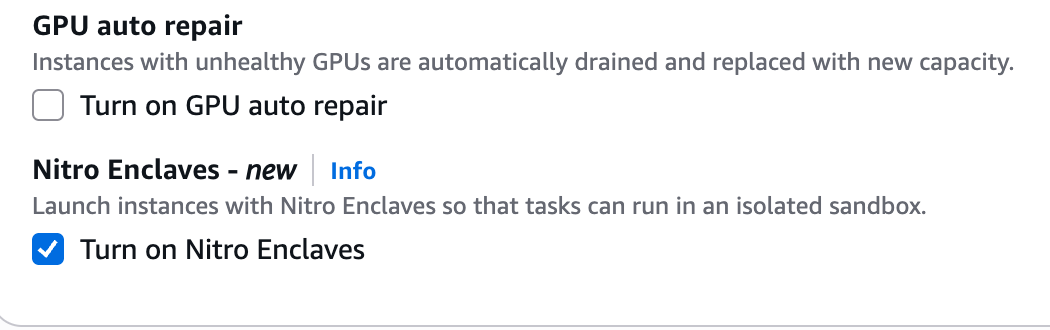
“GPU auto repair” também vem marcado por padrão (eu desmarquei; m8g não tem GPU), e o placeholder do scale-in é de 60 segundos. O equivalente na CLI define as mesmas duas coisas no instance launch template:
{
  "name": "my2cents-nitro-cp",
  "cluster": "my2cents-nitro-ecs",
  "managedInstancesProvider": {
    "infrastructureRoleArn": "<INFRASTRUCTURE_ROLE_ARN>",
    "instanceLaunchTemplate": {
      "ec2InstanceProfileArn": "<INSTANCE_PROFILE_ARN>",
      "networkConfiguration": {
        "subnets": ["<PRIVATE_SUBNET_1>", "<PRIVATE_SUBNET_2>"],
        "securityGroups": ["<SECURITY_GROUP_ID>"]
      },
      "storageConfiguration": { "storageSizeGiB": 30 },
      "localStorageConfiguration": { "useLocalStorage": false },
      "instanceRequirements": {
        "vCpuCount": { "min": 4, "max": 4 },
        "memoryMiB": { "min": 16384, "max": 16384 },
        "allowedInstanceTypes": ["m8g.xlarge"]
      },
      "nitroEnclavesEnabled": true
    }
  }
}
aws ecs create-capacity-provider --cli-input-json file://build/capacity-provider.json
aws ecs describe-capacity-providers --capacity-providers my2cents-nitro-cp \
--query 'capacityProviders[0].{updateStatus: updateStatus, nitro: managedInstancesProvider.instanceLaunchTemplate.nitroEnclavesEnabled, types: managedInstancesProvider.instanceLaunchTemplate.instanceRequirements.allowedInstanceTypes, storage: managedInstancesProvider.instanceLaunchTemplate.storageConfiguration.storageSizeGiB}'{
"updateStatus": "CREATE_COMPLETE",
"nitro": true,
"types": [
"m8g.xlarge"
],
"storage": 30
}Passo 5: Task definitions com um modo de isolamento
Em Task definitions > Create new task definition, com Managed Instances como único launch type, o formulário tem uma seção que a documentação não menciona: “Isolation mode - new: Choose how strongly this task is isolated from other tasks on the same instance.” Marque Use task isolation e ele oferece três modos. A nota abaixo diz “Isolation mode is available when Managed Instances is the only launch type.”
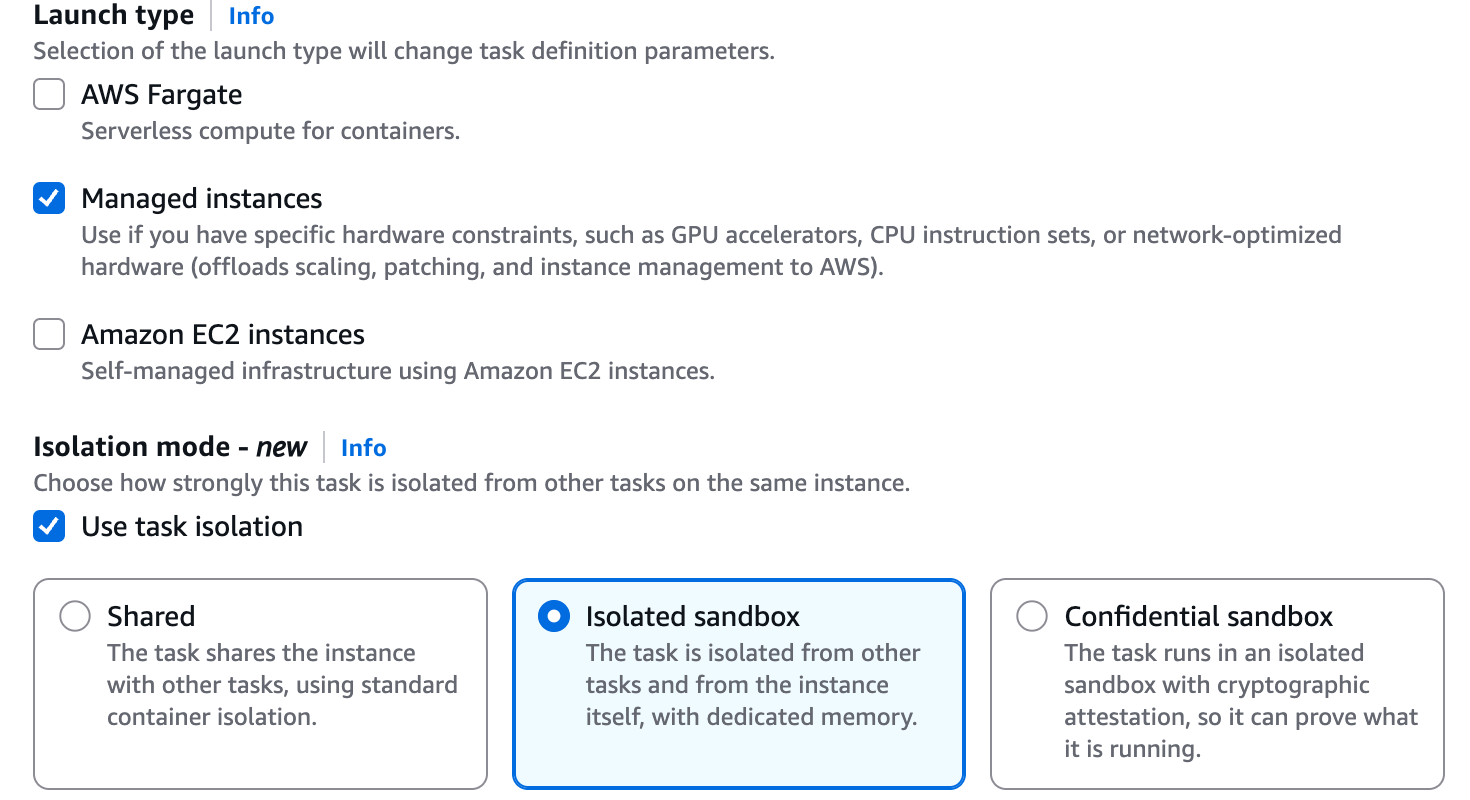
| Modo | Descrição no console |
|---|---|
| Shared | ”The task shares the instance with other tasks, using standard container isolation.” |
| Isolated sandbox | ”The task is isolated from other tasks and from the instance itself, with dedicated memory.” |
| Confidential sandbox | ”The task runs in an isolated sandbox with cryptographic attestation, so it can prove what it is running.” |
A documentação indica Create new task definition with JSON como o caminho no console, e não estava claro se a verificação “no extraneous keys” dele aceitaria o campo novo. Aceita: eu registrei my2cents-isolated:1 e my2cents-shared:1 colando o JSON ali, e na execução gravada criei as duas de novo no console, como a revisão 2 de cada uma. A isolada, com o comando do probe encurtado:
{
  "family": "my2cents-isolated",
  "networkMode": "awsvpc",
  "requiresCompatibilities": ["MANAGED_INSTANCES"],
  "runtimePlatform": { "cpuArchitecture": "ARM64", "operatingSystemFamily": "LINUX" },
  "cpu": "1024",
  "memory": "2048",
  "executionRoleArn": "arn:aws:iam::<ACCOUNT_ID>:role/my2cents-nitro-ecs-execution",
  "taskRoleArn": "arn:aws:iam::<ACCOUNT_ID>:role/my2cents-nitro-ecs-task",
  "containerDefinitions": [
    {
      "name": "probe",
      "image": "public.ecr.aws/amazonlinux/amazonlinux:2023",
      "essential": true,
      "command": ["bash", "-c", "echo \"kernel: $(uname -rv)\"; ... echo PROBE_DONE; sleep 3600"],
      "logConfiguration": {
        "logDriver": "awslogs",
        "options": {
          "awslogs-group": "/ecs/my2cents-nitro-sandbox",
          "awslogs-region": "us-east-1",
          "awslogs-stream-prefix": "my2cents-isolated"
        }
      }
    }
  ],
  "trustedExecutionConfiguration": { "isolationMode": "ISOLATED_SANDBOX" }
}
A definição compartilhada é igual, sem a última chave. As duas rodam um probe como comando e imprimem o resultado no CloudWatch Logs: kernel, boot_id, uptime, CPUs, memória, discos, dispositivos PCI, /dev/nsm, dispositivos de rede, o serviço de metadados, as credenciais da task role, o endpoint de metadados da task, capabilities, PID 1 e egress. Pela CLI, aws ecs register-task-definition --cli-input-json file://build/td-isolated.json, ou o atalho --trusted-execution-configuration isolationMode=ISOLATED_SANDBOX.
Passo 6: Rodar as tasks
Em Run new task > Compute configuration > Capacity provider strategy, FARGATE e FARGATE_SPOT trazem a nota “Sandbox isolation requires a Managed Instances capacity provider.” O provider do Nitro aparece com o rótulo “Nitro Enclaves · Managed instances”.
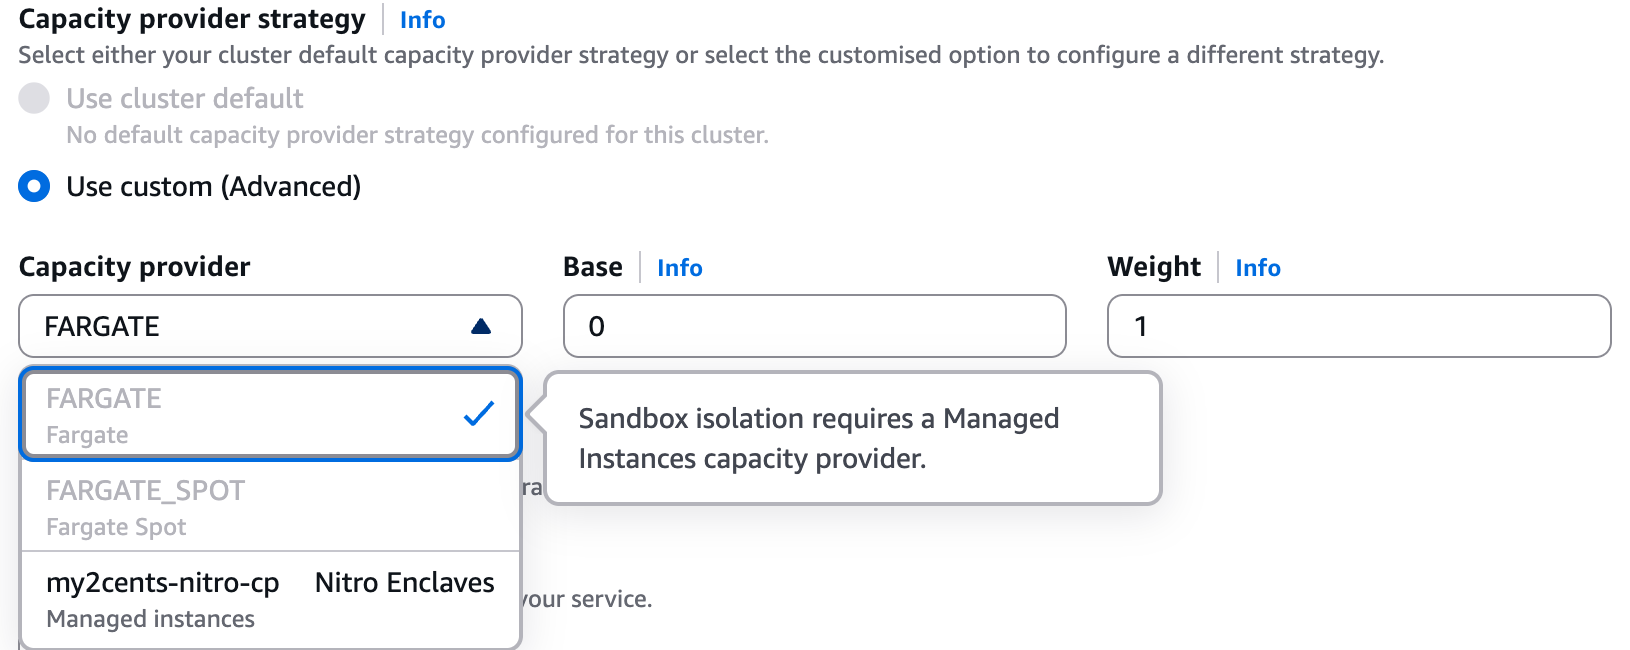
Use as subnets privadas e o security group das tasks. A seção Troubleshooting tem o switch Turn on ECS Exec de sempre. Eu o liguei. Todo probe imprime nos logs, mas na execução gravada eu também abri o ECS Exec na task isolada, e uname -r retornou 6.18.56, o kernel do guest, então o exec funciona em ISOLATED_SANDBOX. Em uma task confidencial, a história é outra (Teste 7).
aws ecs run-task --cluster my2cents-nitro-ecs --task-definition my2cents-isolated \
  --capacity-provider-strategy capacityProvider=my2cents-nitro-cp,weight=1 \
  --network-configuration "$NET" --enable-execute-command --query 'tasks[0].taskArn' --output text
aws logs tail /ecs/my2cents-nitro-sandbox --log-stream-names my2cents-isolated/probe/<task-id> --since 1h
aws ecs execute-command --cluster my2cents-nitro-ecs --task <task-id> --container probe \
  --interactive --command 'uname -r'   # needs the Session Manager plugin locally
Testes
Teste 1: Cold start, e onde as tasks vão parar
A primeira task isolada não tinha instância onde rodar, então o ECS lançou uma. A linha do tempo, a partir do describe-tasks:
| Evento | Horário (UTC) |
|---|---|
| Run task clicado no console | 23:28:55.2 |
createdAt | 23:28:56.0 |
| Registro da container instance criado | 23:28:59.9 |
| PROVISIONING para PENDING | por volta de 23:29:21 |
pullStartedAt a pullStoppedAt | 23:29:22.7 a 23:29:24.4 (1,6 s) |
startedAt | 23:29:30.1 |
São cerca de 34 segundos de createdAt até RUNNING, incluindo o lançamento da m8g.xlarge. A execução gravada, iniciada do mesmo jeito pelo Run task do console, deu o mesmo resultado: createdAt 01:33:59.475, startedAt 01:34:33.797, 34,3 segundos incluindo a instância. Os 5,75 segundos entre o fim do pull e o início do container cobrem o boot do sandbox e o início do container dentro dele; para comparação, um sandbox puro no EC2 fez o boot até o SSH em cerca de 2 segundos na parte 2. Uma task compartilhada na instância já aquecida, com a imagem em cache (um pull de 0,1 segundo), levou 7,1 segundos de createdAt a startedAt. Eu não medi uma task isolada em uma instância já aquecida, então não tenho uma comparação equivalente com a instância aquecida.
A instância que o ECS lançou, i-04786d3b9f7c4f5ef, tinha EnclaveOptions.Enabled: true, IMDSv2 obrigatório com HttpPutResponseHopLimit: 1 e a AMI do ECS Managed Instances baseada em Bottlerocket (ami-0d2bb695ef3bc2351). A container instance dela trazia o atributo ecs.capability.nitro-enclaves e registrou 4.096 unidades de CPU e 13.347 MiB de memória de um total de 16.384.
Tasks compartilhadas e isoladas dividem a instância. A documentação dá a entender isso, mas nunca diz. As duas tasks reportaram o mesmo containerInstanceArn, nas duas execuções. Só que não dá para forçar isso: uma placement constraint no ID da instância é recusada.
not applicable for MANAGED_INSTANCES. Subject of expression must be one of [attribute:ecs.subnet-id, attribute:ecs.vpc-id, attribute:ecs.availability-zone, attribute:ecs.cpu-architecture, attribute:ecs.instance-type]A colocação na mesma instância vem só do bin-packing. A outra pergunta que a documentação deixava em aberto era como uma task compartilhada reporta o seu modo: ela não reporta. O trustedExecutionSummary da task isolada era {"isolationMode": "ISOLATED_SANDBOX"}; a task compartilhada não tinha trustedExecutionSummary nenhum, nem um dizendo SHARED (com --output text, a CLI imprime None). Um script que audita o isolamento deve tratar um campo ausente como compartilhado.
Teste 2: Uma task isolada e uma compartilhada, lado a lado
A página de responsabilidade compartilhada do Managed Instances, escrita antes do lançamento, ainda diz: “não há isolamento de tasks no Amazon ECS Managed Instances. Os containers podem potencialmente acessar credenciais, variáveis de ambiente e arquivos temporários de outras tasks na mesma instância, incluindo dados deixados por tasks que rodaram antes.” Para uma task compartilhada, isso continua valendo. Aqui está o mesmo probe nos dois modos, as duas tasks com 1 vCPU e 2 GiB, na mesma instância:
ISOLATED_SANDBOX | Compartilhada | |
|---|---|---|
| Kernel | 6.18.56 #1 SMP Tue Oct 27 17:44:05 UTC 2026 | 6.18.56 #2 SMP Fri Oct 30 22:32:43 UTC 2026 (o da instância) |
boot_id | o próprio | o da instância |
| Uptime no probe | 6,11 s | 47,40 s (o da instância) |
nproc | 1 | 4 |
| MemTotal | 2.319.336 kB | 16.048.204 kB |
| Discos | dm-0 vda vdb vdc | dm-0 loop0-7 nvme0n1 nvme1n1 |
/ | overlay, 20G (fixo) | overlay, 30G (o volume de dados EBS de 30 GiB da instância) |
| PCI | bridges da Amazon, 1af4:1061 (NSM), três 1af4:1042 (bloco), 1af4:1041 (rede), 1af4:1053 (vsock) | bridges da Amazon, 1d0f:e4c1, 1d0f:8061 (NVMe), 1d0f:ec20 (ENA), 1af4:1053 |
/dev/nsm | presente (crw-rw-rw-) | ausente |
| Dispositivos de rede | lo dummy0 eth1 | lo eth0 eth1 |
CapEff | 00000000a80425fb (padrão do Docker) | igual |
| Egress pelo NAT gateway | HTTP 200 | HTTP 200 |
A task isolada é uma máquina separada, do tamanho da task. O kernel dela é um build diferente do da instância, ela tem o seu próprio boot_id e um uptime de seis segundos, e vê uma CPU e um pouco mais do que os 2 GiB que pediu. A task compartilhada vê a instância: o kernel, as quatro CPUs, os 16 GiB e os discos NVMe dela, digam o que disserem os seus limites de cgroup. A raiz da task isolada fica em discos virtio e é fixa em 20G, como a documentação diz: tasks em sandbox recebem 20 GiB de armazenamento efêmero, diga o que disser o ephemeralStorage. A execução gravada deu os mesmos kernels, contagens de CPU, valores de MemTotal, discos e resultado do NSM.
Duas linhas não mudam. Os dois containers recebem as capabilities padrão do Docker, e os dois alcançam a internet: um sandbox muda o que os privilégios de um container conseguem alcançar, não os privilégios em si, e a rede dele continua sendo o que o security group permitir.
O dispositivo NSM está lá no modo isolado. Na parte 2, um sandbox no modo direto do EC2 não tinha NSM (1af4:1061) e um no modo confidencial tinha; a documentação do Firecracker e o guia do EC2 dizem o mesmo (“Não há NSM nem atestação” no modo direto). Então o modo isolado do ECS parece rodar, por baixo, sobre o modo de memória confidencial do EC2. Essa é a minha inferência a partir da lista de dispositivos, não algo que a documentação do ECS afirme, mas ela bate com a própria descrição do console (“isolated … from the instance itself, with dedicated memory”) e com o modelo de segurança do ECS, que diz que a instância pai não consegue ler nem escrever a memória do guest. O que separa o isolado do confidencial no ECS é a policy de atestação (Testes 6 e 7) e, segundo a documentação, a camada gravável: “Para tasks isoladas, o overlay não é criptografado, para permitir uma inicialização mais rápida da task, e a instância pai pode ler e escrever a camada efêmera.”
Teste 3: O que “host” significa dentro de um sandbox
Eu registrei três variantes da task definition isolada:
jq '.family = "my2cents-neg-host" | .networkMode = "host"' build/td-isolated.json > build/neg-host.json
jq '.family = "my2cents-neg-fargate" | .requiresCompatibilities = ["FARGATE"]' build/td-isolated.json > build/neg-fargate.json
jq '.family = "my2cents-neg-priv" | .pidMode = "host" | .containerDefinitions[0].privileged = true' \
build/td-isolated.json > build/neg-priv.json| Variante | Resultado |
|---|---|
networkMode: host | Rejeitada no registro: “Tasks using the ISOLATED_SANDBOX isolation mode require networkMode ‘awsvpc’.” |
requiresCompatibilities: [FARGATE] | Rejeitada: “trustedExecutionConfiguration with isolationMode ISOLATED_SANDBOX requires the requiresCompatibilities field to contain only MANAGED_INSTANCES” |
pidMode: host mais privileged: true | Aceita, e roda. O PID 1 é systemd, 172 processos ficam visíveis (174 na primeira execução), CapEff é 000001ffffffffff (todas as capabilities), e o kernel é o do guest, 6.18.56 #1 SMP Tue Oct 27 |
A última linha não estava documentada para tasks em sandbox. O ECS não recusa um container privilegiado com o PID namespace do host; ele o confina. O “host” é a VM do sandbox: o systemd no PID 1 é o próprio init do guest, os processos são os do guest, e as capabilities completas valem para o kernel do guest. A documentação coloca assim: “As capabilities privilegiadas do Linux se aplicam só à stack do sistema operacional Linux dentro do Nitro Sandbox, não ao host.” Eu não rodei a mesma variante como task compartilhada, em que o host PID mode compartilharia o próprio namespace de processos da instância.
O outro lado da moeda está no modelo de segurança: “se um ator consegue rodar uma task ISOLATED_SANDBOX no seu cluster, esse ator consegue rodar qualquer imagem de container com quaisquer capabilities dentro do sandbox.” A fronteira é a VM, e a task definition é uma entrada confiável. O ECS diz que o recurso “não foi projetado para rodar task definitions não confiáveis”, então restrinja RegisterTaskDefinition, RunTask e CreateService com IAM.
Teste 4: O serviço de metadados
Na parte 2, um sandbox no EC2 puro alcançou o serviço de metadados da instância pai pelo NAT e leu o nome da role dela. No ECS, nenhuma das tasks o alcançou:
ISOLATED_SANDBOX | Compartilhada | |
|---|---|---|
IMDS em 169.254.169.254 | Roteado via eth1; o PUT do token e um GET deram timeout depois de 5 s | Bloqueado: Immediate connect fail ... Invalid argument (rota inalcançável) |
Credenciais da task role (169.254.170.2) | Funcionam (RoleArn ... my2cents-nitro-ecs-task) | Funcionam |
| Endpoint de metadados da task v4 | Funciona (AZ us-east-1a) | Funciona |
Para credenciais, esse é o resultado certo: a instance role não é alcançável de nenhuma das tasks, e a task role funciona sem mudanças. A surpresa é a coluna isolada. A visão geral do ECS diz que um sandbox recebe um substituto só IMDSv2 que “serve apenas metadados de posicionamento (Região, Zona de Disponibilidade e ID da Zona de Disponibilidade) e metadados de endpoints de serviço (domínio do serviço e partição)”, retornando 404 para todo o resto, e que workloads que consultam metadados de Região e posicionamento “funcionam sem mudanças”. Na minha execução, absolutamente nada respondeu em 169.254.169.254. Um código que lê a sua Região ou Zona de Disponibilidade do IMDS esperaria até estourar o timeout; leia o endpoint de metadados da task, que funcionou nos dois modos.
Para contraste, nas AWS Lambda MicroVMs o IMDS é o jeito como o workload recebe credenciais, e qualquer processo na MicroVM consegue ler as da execution role.
Teste 5: Overhead de memória por tamanho de sandbox
A documentação dá um único número para a memória extra que um sandbox reserva: “uma task com 2 vCPU e 8 GiB de memória tem um consumo total de memória de cerca de 8,7 GiB.” Eu queria os tamanhos pequenos. Rodei uma task por vez (1 vCPU, sleep 600) em uma instância nova com 13.347 MiB registrados, e li o consumo como a memória registrada menos a restante na container instance:
aws ecs describe-container-instances --cluster my2cents-nitro-ecs --container-instances $CI \
  --query 'containerInstances[0].[registeredResources[?name==`MEMORY`].integerValue | [0], remainingResources[?name==`MEMORY`].integerValue | [0]]' \
--output text| Memória da task | Consumo na instância | Overhead | Overhead % |
|---|---|---|---|
| Compartilhada 2048 MiB | 2048 | 0 | 0% |
| Isolada 512 MiB | 774 | 262 | 51% |
| Isolada 1024 MiB | 1286 | 262 | 26% |
| Isolada 2048 MiB | 2416 | 368 | 18% |
| Isolada 4096 MiB | 4511 | 415 | 10% |
| Isolada 8192 MiB | 8701 | 509 | 6% |
A linha de 8 GiB deu 8.701 MiB, cerca de 8,5 GiB, o que significa 509 MiB de overhead. Isso fica abaixo do exemplo da documentação, cujo “cerca de 8,7 GiB” implica uns 717 MiB, mas a task deles tinha 2 vCPUs e a minha 1, então o overhead pode crescer com as vCPUs; eu não testei isso. A informação nova é a parte de baixo da curva: há um piso de cerca de 262 MiB, então os menores sandboxes pagam proporcionalmente mais. O overhead é por sandbox, e tasks compartilhadas não pagam nada: com uma task compartilhada e uma isolada de 2 GiB rodando juntas, a instância mostrou 4.464 MiB usados, 2.048 mais 2.416. A execução gravada reproduziu isso exatamente: 13.347 MiB registrados, 8.883 restantes, então de novo 368 MiB de overhead.
Se isso custa uma task a você depende de qual recurso se esgota primeiro. Pela aritmética da tabela (eu não rodei esses testes de empacotamento), uma m8g.xlarge com 4.096 unidades de CPU e 13.347 MiB comporta quatro tasks de 1 vCPU / 2 GiB em qualquer um dos modos, porque a CPU acaba primeiro (4 × 2.416 = 9.664 MiB). Com 1 vCPU / 4 GiB, a memória é o limite: cabem três tasks compartilhadas (12.288 MiB), mas só duas isoladas (uma terceira precisaria de 13.533).
Parar uma task levou de 55 a 65 segundos de stoppingAt a stoppedAt: o stop timeout padrão de 30 segundos para o sleep, mais a limpeza.
Teste 6: Gerando a policy de uma task confidencial
Uma task confidencial precisa de uma attestationPolicy ao lado de "isolationMode": "CONFIDENTIAL_SANDBOX". Você a gera a partir da task definition com o ecs-nitro-sandbox-genpolicy, o agente de sandbox do ECS a aplica, e a medição dela vai parar no PCR17 do documento de atestação da task. Uma key policy do KMS pode então exigir esse PCR17.
O workload. A documentação não tem nenhum exemplo de código de aplicação que faça atestação de dentro de uma task do ECS, então eu escrevi um. O container (amazonlinux:2023) instala openssl, awscli-2 e python3, grava a partir de uma variável de ambiente o cliente NSM da parte 2, feito só com a stdlib (nsm.py), cria um par de chaves RSA, obtém um documento de atestação de /dev/nsm, imprime os PCRs, pede ao KMS para descriptografar um segredo para esse documento com a task role e abre a resposta dentro do sandbox. Desenrolado, o comando é:
openssl genrsa -out key.pem 2048 && openssl rsa -in key.pem -pubout -outform DER -out pub.der
python3 nsm.py attest pub.der att.doc && python3 nsm.py pcrs att.doc | grep -E "module_id|PCR0:|PCR8:|PCR17:"
echo "$SECRET_CT" | base64 -d > ct.bin
aws kms decrypt --region us-east-1 --ciphertext-blob fileb://ct.bin \
  --recipient "KeyEncryptionAlgorithm=RSAES_OAEP_SHA_256,AttestationDocument=$(base64 -w0 att.doc)" \
  --query CiphertextForRecipient --output text | base64 -d > cfr.der
openssl cms -decrypt -inform DER -in cfr.der -inkey key.pem
O segredo veio de uma chave nova do KMS cuja policy, no início, tinha só o statement padrão do root da conta, então o acesso passava apenas pelas policies do IAM. Eu o criptografei na minha máquina e coloquei o texto cifrado na task definition como SECRET_CT:
KEY_ID=$(aws kms create-key --description "Nitro Sandboxes on ECS demo" \
  --policy file://build/kms-ecs-initial.json --query KeyMetadata.KeyId --output text)
printf '%s' 'ecs: only a measured task can read this' > build/secret.txt
SECRET_CT=$(aws kms encrypt --key-id "$KEY_ID" --plaintext fileb://build/secret.txt --query CiphertextBlob --output text)
Gerando a policy, no cluster. A AWS distribui o ecs-nitro-sandbox-genpolicy só para Linux (x86_64 e aarch64, glibc 2.34 ou mais recente). Em vez de arrumar uma máquina Linux, eu o rodei em uma task compartilhada: Linux arm64, no mesmo cluster. A task recebe a task definition confidencial codificada em base64 em uma variável de ambiente, baixa o release assinado do runtime, verifica-o com a chave pública publicada na documentação do ECS e roda a ferramenta duas vezes.
dnf install -y -q tar gzip openssl findutils; cd /tmp
U=https://d1uvmbvklg8rt.cloudfront.net/latest/aarch64
curl -fsSLO $U/nitro-sandboxes-runtime.tar.gz && curl -fsSLO $U/SHA256SUM && curl -fsSLO $U/SHA256SUM.sig
printf '%s' "$PUBKEY" > nitro-sandboxes-runtime-v1.pub   # the release key from the ECS docs, passed in the task's environment
openssl dgst -sha384 -verify nitro-sandboxes-runtime-v1.pub -signature SHA256SUM.sig SHA256SUM
sha256sum -c SHA256SUM --ignore-missing && tar -xzf nitro-sandboxes-runtime.tar.gz
echo "$TD_B64" | base64 -d > td.json
./ecs-nitro-sandbox-genpolicy --image-architecture arm64 --task-definition td.json > policy.b64
./ecs-nitro-sandbox-genpolicy --image-architecture arm64 --task-definition td.json --output pcrs
Verified OK
nitro-sandboxes-runtime.tar.gz: OK
ecs-nitro-sandbox-genpolicy 0.1.4274.0
--- KMS Key Policy Condition ---
"Condition": {
"StringEqualsIgnoreCase": {
"kms:RecipientAttestation:PCR17": "e549c3c2d082f8e53a7514aebd748741fe23097505862b47c9095fa8e6834909a2cc0f4fbd8846aa1db484576ed3c58b",
"kms:RecipientAttestation:PCR8:ServiceName": "ecs.amazonaws.com"
}
}Duas coisas me fizeram tropeçar. A imagem amazonlinux:2023 não tem find, que eu usei para localizar o binário no arquivo compactado, daí o findutils; no fim ele era desnecessário, porque o arquivo se expande sem subdiretórios, como a documentação diz. E a ferramenta rejeita comandos de várias linhas:
error: process argument "..." contains an illegal control character '\n'Eu juntei o script do workload em uma linha só com ; .
O que a policy diz. A saída é um JSON comprimido com gzip, com version, admission_policy e runtime_policy, codificado em base64: 8.852 caracteres na primeira execução (19.372 bytes descomprimidos) e 8.849 na execução gravada, cujo segredo criptografado de novo colocou um texto cifrado diferente no ambiente. As duas policies são Cedar.
- A admissão nega por padrão e controla
CreateContainer,PrepareImageeMountHostImage. O único permit para o containerattestexige o digest da imagem, o comando exato, cada valor de ambiente declarado e a lista completa de nomes de variáveis, o usuário, as capabilities, os mounts e mais.MountHostImageé proibido de vez. - O runtime permite logs, stats, métricas, eventos de OOM e o substituto de metadados, e proíbe
DebugExec,WriteStdin,SetupVolume,StreamEfsCertseGetBootTimings.
As policies Cedar geradas, resumidas
// ---- admission_policy ----
// Generated by ecs-nitro-sandbox-genpolicy (CONFIDENTIAL_PARTITION).
// Admission gates CreateContainer, PrepareImage, and MountHostImage (deny-by-default).

// CreateContainer: attest
permit(
    principal,
    action == Agent::Action::"CreateContainer",
    resource == Workload::Container::"attest"
)
when {
    context.image_ref == "public.ecr.aws/amazonlinux/amazonlinux@sha256:5e98730d73190367a4d29c086f2ed2911cc5867eff5aa8b2a19cbb884e9d601f" &&
    context.read_only_rootfs == false &&
    context.working_dir == "/" &&
    context.process_args == "[…the whole command, byte for byte…]" &&
    context.run_as_user == 0 &&
    context.run_as_group == 0 &&
    // … effective, bounding and permitted capabilities pinned to the Docker default set
    context.env.contains({"name": "SECRET_CT",
 "value": "…the ciphertext…"}) &&
    // … every other environment value, and the full list of variable names
    context.host_network == false &&
    context.host_pid == false &&
    context.host_ipc == false &&
    // … mounts, masked paths, seccomp, devices, hooks, SELinux labels
    context.ecs_exec_enabled == false
};

// PrepareImage: public.ecr.aws/amazonlinux/amazonlinux@sha256:5e98730d…
permit(
    principal,
    action == Agent::Action::"PrepareImage",
    resource
)
when {
    context.image_ref == "public.ecr.aws/amazonlinux/amazonlinux@sha256:5e98730d73190367a4d29c086f2ed2911cc5867eff5aa8b2a19cbb884e9d601f"
};

// Admission: MountHostImage is forbidden. Mounting a host-prepared
// image would bypass the guest-pull path the PrepareImage digest
// pin relies on, letting the parent instance substitute image
// content the pin never sees.
forbid(principal, action == Agent::Action::"MountHostImage", resource);

// ---- runtime_policy ----
// Generated by ecs-nitro-sandbox-genpolicy (CONFIDENTIAL_PARTITION).
// Runtime: deny-by-default; the image pin lives in admission.

permit(principal, action == Agent::Action::"InitGuestMetadata", resource);
permit(principal, action == Agent::Action::"UpdateGuestMetadata", resource);
permit(principal, action == Agent::Action::"WatchOomEvents", resource);
permit(principal, action == Agent::Action::"RemoveContainer", resource);
permit(principal, action == Agent::Action::"ReadLogs", resource);
permit(principal, action == Agent::Action::"ReadTerminationLog", resource);
permit(principal, action == Agent::Action::"StreamAgentLogs", resource);
permit(principal, action == Agent::Action::"Stats", resource);
permit(principal, action == Agent::Action::"GetSandboxMetrics", resource);

permit(principal, action == Agent::Action::"SetupSandbox", resource)
when {
    context.ephemeral_layer == Workload::EphemeralLayer::"integrity-memory"
    && context.sysctls.isEmpty()
    && context.fsgroup == -1
    && context.deny_all_egress == false
    && context.volume_paths.isEmpty()
};
// … two CreateTask permits: no logger, or the awslogs wrapper with a fixed flag set

// Runtime: exec has no permit: the task launched without
// enableExecuteCommand and declares no health check.

// Runtime: DebugExec is forbidden: host-operator diagnostic REPL that
// reads guest files (ls, cat); only the command name is in the Cedar
// context, not the path, so no permit can scope what it reads, and any
// read of the guest filesystem defeats confidentiality.
forbid(principal, action == Agent::Action::"DebugExec", resource);
forbid(principal, action == Agent::Action::"WriteStdin", resource);
forbid(principal, action == Agent::Action::"SetupVolume", resource);
forbid(principal, action == Agent::Action::"StreamEfsCerts", resource);
forbid(principal, action == Agent::Action::"GetBootTimings", resource);
Para o ECS Exec, a policy é explícita: a admissão exige ecs_exec_enabled == false, e a policy de runtime não tem permit para exec. DebugExec é outra coisa: segundo o próprio comentário da policy, uma ação de diagnóstico do operador do host que lê arquivos do guest, e a policy a proíbe de vez. Para manter o exec em uma task confidencial, a documentação da policy diz para gerá-la com --allow-exec-command, e que “você não pode adicionar a permissão depois sem gerar a policy de novo e atualizar a medição do PCR17 dela”. O modo isolado não tem uma policy sua (o guest roda uma embutida e permissiva, que aparece como o PCR17 da task isolada no Teste 7), e a documentação diz que ali “o exec da task é permitido”. A execução gravada testou os dois: o exec funcionou em uma task isolada (Passo 6), e uma task confidencial com o ECS Exec ativado não conseguiu iniciar (Teste 7). Mais um comentário na policy de runtime diz que SetupVolume cobre “EFS, FSx, EBS task-attach”, “all of which generation rejects as not attestable”, embora a documentação liste o EFS como suportado e o modelo de segurança avise os workloads confidenciais para não gravar segredos em texto puro em um volume EFS; eu não testei volumes.
Fixando o PCR17. A key policy dá à task role kms:Decrypt só quando o PCR17 do documento é o previsto e a imagem do guest foi assinada pelo ECS. A documentação diz para usar PCR8:ServiceName em vez do valor bruto do PCR8.
{
  "Sid": "DecryptOnlyFromAttestedConfidentialTask",
  "Effect": "Allow",
  "Principal": { "AWS": "arn:aws:iam::<ACCOUNT_ID>:role/my2cents-nitro-ecs-task" },
  "Action": "kms:Decrypt",
  "Resource": "*",
  "Condition": {
    "StringEqualsIgnoreCase": {
      "kms:RecipientAttestation:PCR17": "e549c3c2d082f8e53a7514aebd748741fe23097505862b47c9095fa8e6834909a2cc0f4fbd8846aa1db484576ed3c58b",
      "kms:RecipientAttestation:PCR8:ServiceName": "ecs.amazonaws.com"
    }
  }
}
Depois eu inseri a policy em trustedExecutionConfiguration.attestationPolicy e registrei my2cents-confidential:1 pelo editor de JSON do console.
Teste 7: Confidencial, isolada e adulterada
Eu rodei três tasks, e todas foram parar na mesma m8g.xlarge (i-0c0df4bdfa8711cca): a task confidencial; o mesmo container como ISOLATED_SANDBOX, sem policy própria; e a task definition confidencial com echo tampered; colocado na frente do comando depois de a policy ser gerada, ainda levando a policy original.
| Confidencial, com a sua policy | Mesmo container, isolado | Confidencial, comando alterado | |
|---|---|---|---|
trustedExecutionSummary | {"isolationMode": "CONFIDENTIAL_SANDBOX", "attestationPolicyStatus": "CONFIGURED"} | {"isolationMode": "ISOLATED_SANDBOX"} | CONFIDENTIAL_SANDBOX, CONFIGURED |
/dev/nsm | presente | presente | n/a |
| Documento de atestação | 4.810 bytes | 4.808 bytes | n/a |
| PCR0 (imagem do guest) | 2e3aa034…aad4b | igual | n/a |
| PCR8 (certificado de assinatura do ECS) | 336ea928…7b3fcb | igual | n/a |
| PCR17 (policy) | e549c3c2…6ed3c58b, o valor previsto | 8d833c2f…aa08dc | n/a |
| Decrypt no KMS | SECRET: ecs: only a measured task can read this | AccessDeniedException ... not authorized to perform: kms:Decrypt | n/a |
| Resultado da task | RUNNING | RUNNING | STOPPED, TaskFailedToStart |
A task adulterada nem chegou a pedir nada ao KMS:
CannotStartContainerError: ResourceInitializationError: ... create_container: rpc status: Status { code: PERMISSION_DENIED, message: "policy denied Agent::Action::\"CreateContainer\" ...Três coisas nessa tabela importam.
- O PCR17 é previsível. O valor que a ferramenta imprimiu antes de a task existir é o valor que a task em execução reportou, então a key policy pode ser escrita antes do primeiro deploy. No EC2, na parte 2, eu li o PCR0 de dentro de um guest em execução; o guia do EC2 agora documenta como calculá-lo antecipadamente, gerando a imagem com
eif_build. - Tasks isoladas também conseguem fazer atestação. Elas têm um NSM, a mesma imagem de guest (PCR0) e o mesmo assinante (PCR8). Dos PCRs que eu imprimi (PCR0, PCR8, PCR17), só o PCR17 era diferente, e foi com base nele que o KMS recusou. O PCR17 da task isolada,
8d833c2f…, saiu idêntico para um pod isolado no EKS na parte 4, então parece ser a medição da policy embutida permissiva. Eu não testei uma key policy mais fraca, mas, com PCR0 e PCR8 idênticos, uma que verificasse só esses dois não teria nada para diferenciar as duas tasks. A garantia confidencial vem de fixar o PCR17, o que só tem sentido no modo confidencial, em que a mesma policy também trava a admissão e nega o exec. - A adulteração é barrada na porta. O agente se recusou a criar um container cujo comando não correspondia à policy, então a task não conseguiu iniciar. Uma policy gerada de novo levaria um PCR17 diferente, que a key policy não aceitaria.
A execução gravada repetiu os três resultados. O PCR17 da task confidencial foi um valor novo (o e549c3c2… mostrado acima; o da primeira execução foi 9591b312…), porque o segredo criptografado de novo tinha mudado o texto cifrado no ambiente dela, e ela descriptografou SECRET: ecs: only a measured task can read this de novo. O PCR17 da task isolada foi 8d833c2f… de novo, e o KMS a recusou com AccessDeniedException. A task adulterada parou com a mesma negação de CreateContainer.
Ativar o ECS Exec é uma decisão tomada na geração. Na execução gravada, eu também iniciei a task confidencial com --enable-execute-command, contra uma policy gerada sem --allow-exec-command. Ela nunca rodou: parou com TaskFailedToStart, e o motivo dizia policy denied Agent::Action::"WriteFile" on path "/var/lib/…", com o path cortado na saída. A policy gerada explica isso em um comentário próprio: “WriteFile has no permit: the task launched without enableExecuteCommand, so the host has no bind mounts to replicate into the guest.” Ativar o ECS Exec adiciona esses bind mounts, e a policy não tem regra que deixe o agente gravá-los. Não dá para ligar o ECS Exec em uma task confidencial em tempo de execução; a policy tem de ser gerada com --allow-exec-command, o que significa um PCR17 novo. A documentação da policy concorda: sem esse permit, “a task é negada na inicialização”. No EKS, na parte 4, por outro lado, o pod confidencial iniciou e só a chamada kubectl exec foi recusada.
O custo é o retrabalho. A policy fixa os valores de ambiente, incluindo o texto cifrado, então criptografar o segredo de novo, editar o cliente NSM ou passar para um novo digest de imagem significa, em cada caso, uma policy nova, um PCR17 novo e uma atualização da key policy. A recomendação da documentação para rolling deployments é listar os dois valores de PCR17 em uma única condição StringEqualsIgnoreCase enquanto tasks antigas e novas coexistem.
Como no EC2, o module_id do documento de atestação começa com o ID da instância pai: i-0c0df4bdfa8711cca-enc01a1c2be42785a8f.
Resumo dos resultados
| Pergunta | Resposta da minha execução |
|---|---|
| Switch no console | Capacity provider > Advanced configuration > Turn on Nitro Enclaves, depois de desmarcar “Use local storage” |
| Opt-in da task | O Isolation mode do formulário, ou trustedExecutionConfiguration no editor de JSON |
| Cold start com instância nova | Cerca de 34 s de createdAt até RUNNING, nas duas execuções; 5,75 s do fim do pull até o início do container |
| Compartilhada e isolada em uma instância | Sim, mesmo containerInstanceArn; fixar em um ID de instância é recusado |
trustedExecutionSummary em uma task compartilhada | Omitido |
| O que uma task isolada vê | Kernel próprio, 1 vCPU, 2,2 GiB, discos virtio, uma raiz de 20G e um dispositivo NSM |
| Configurações de nível de host | Rede host e Fargate rejeitados; pidMode: host mais privileged confinados à VM do sandbox |
| Serviço de metadados | Inalcançável das duas tasks; o substituto documentado não respondeu |
| Overhead de memória | Um piso de cerca de 262 MiB; 51% com 512 MiB, 18% com 2 GiB, 6% com 8 GiB |
| Modo confidencial | O PCR17 bateu com a previsão; o KMS liberou o segredo só para essa task; um comando alterado foi negado na inicialização |
| ECS Exec | Funciona em uma task isolada (uname -r retornou o 6.18.56 do guest); uma task confidencial com o ECS Exec ativado, e uma policy gerada sem --allow-exec-command, não conseguiu iniciar |
| Geração da policy | Rodou em uma task compartilhada no cluster como atalho de demonstração; em produção, gere-a em CI ou em uma estação de trabalho Linux, não na instância |
| Service de longa duração | Criação, scale-out, stop e substituição, e ECS Exec funcionam; rolling updates de services criados pelo console falharam 5 de 5 com o versionConsistency padrão; com ele disabled, 5 de 5 terminaram |
| Monitoramento | Container Insights e as métricas do service cobrem tasks em sandbox; o overhead de 262 MiB e o modo de isolamento não aparecem em nenhuma métrica ou evento |
Operação e Monitoramento
Assista a esta parte: a seção de operações do vídeo, a partir de 5:45, mostra tudo isso no console e na CLI.
Em 2026-11-10 eu fiz uma terceira passada, para a seção de operações do vídeo, em um cluster e um capacity provider novos, montados no console: um service de longa duração com tasks httpd ISOLATED_SANDBOX (0,5 vCPU, 1 GiB) que eu escalei, parei, atualizei, monitorei, auditei e desmontei.
O isolamento só aparece na task e na definição dela. O painel Configuration da página da task diz “Trusted execution: Isolated sandbox”, a task definition tem uma aba nova “Trusted execution”, e o describe-tasks retorna trustedExecutionSummary. O service não tem nenhum campo assim. Também é fácil perder as instâncias de vista: as Managed Instances não apareceram em listagens do aws ec2 describe-instances filtradas por VPC, instance profile, tag do cluster ou tipo de instância, só quando eu as consultei pelo ID da instância. ecs list-container-instances e describe-container-instances as encontram.
| Ação | O que aconteceu |
|---|---|
| Criar o service no console | O console o cria por meio de uma stack do CloudFormation; steady state de 3 a 3,5 minutos depois do Create, incluindo a instância |
| As duas primeiras tasks do service | Na exploração, duas tasks criadas com 20 s de diferença dividiram uma instância. Na execução gravada, duas criadas com 9 s de diferença, em uma subnet cada, ganharam cada uma a sua m8g.xlarge, e o Infrastructure Optimization drenou uma e a encerrou cerca de 7 minutos depois |
| Scale out em uma instância já aquecida | 2 → 3 (e 3 → 5 na exploração) empacotadas na mesma instância, estáveis em menos de 30 s |
| Parar uma task | O service iniciou uma substituta em 12 a 42 s |
| ECS Exec | O kernel do guest 6.18.56, uma CPU e cerca de 1,1 GiB de MemTotal para uma task de 1 GiB |
| Rolling update | Falhou 4 vezes de 4 em 2026-11-10, com --force-new-deployment e com uma revisão nova. A primeira task nova iniciou; as seguintes pararam com TaskFailedToStart e failed to pre-ingest image ... into guest VM ... not found, citando a imagem sem a tag 2.4, e o circuit breaker fez rollback depois de 5 a 9 minutos. Em 2026-11-11, em services criados com a CLI, todos os oito rolling updates que eu tentei terminaram em cerca de três minutos, com todas as configurações, inclusive a padrão. Em um service criado pelo console, o padrão falhou de novo do mesmo jeito. Uma revisão da task definition com "versionConsistency": "disabled" no container (o formulário do console não tem campo para isso; use Create new revision with JSON) resolveu: 5 de 5 rolling updates terminaram, em services criados pelo console e pela CLI, todos em uma instância. A consistência de versão fixa cada task no digest da imagem resolvido no deploy; com ela desligada, as tasks fazem pull da tag simples. Não sei por que só os services criados pelo console tiveram a falha |
| Excluir | O service precisa de Force delete enquanto tiver tasks; apagar o capacity provider enquanto elas drenam dá DELETE_FAILED, e tentar de novo funciona |
Nada limita um provider a uma instância; então, para ficar em uma só, inicie o service com uma task e faça o scale out quando a instância dela estiver de pé, e dimensione as tasks para que as cópias extras de um deploy ainda caibam.
| Sinal de monitoramento | O que mostrou |
|---|---|
CPUUtilization do service (AWS/ECS) | Funciona: com uma das três tasks queimando CPU, média de 33,3% e máximo de 100% |
| Container Insights, observabilidade aprimorada | Existem métricas de task para tasks em sandbox, e nada nelas indica o modo de isolamento. Um busy loop em uma task de 0,5 vCPU registrou um CpuUtilized de cerca de 512, a reserva dela, embora o guest veja uma CPU. MemoryUtilized é o uso do próprio guest, de 12 a 35 MB para o httpd |
| Memória que a instância cedeu | 1.286 MiB por task de 1 GiB: os 262 MiB de overhead do Teste 5, que nenhuma métrica de task mostra |
CPUUtilization do EC2 para a instância | Inclui a carga do sandbox: 13 a 14% com uma task de 0,5 vCPU queimando CPU, contra 0,7% ociosa |
| EventBridge, via captura de eventos | Nenhum dos 309 eventos capturados trazia trustedExecutionSummary, e eventos de container instance não têm atributos, então uma regra não consegue filtrar pelo modo de isolamento |
| O Event history do cluster | Lista cada TaskFailedToStart com o motivo completo; logs e Live Tail funcionam como em qualquer service |
Desligar a captura de eventos remove só a regra do EventBridge dela. Apague você mesmo o log group e a resource policy EventBridgeCloudWatchLogs; o log group do Container Insights também sobrevive ao cluster.
O CloudTrail registra a configuração de isolamento e a atestação. RegisterTaskDefinition grava trustedExecutionConfiguration no request, incluindo a policy de atestação inteira de uma definição confidencial, e CreateCapacityProvider grava nitroEnclavesEnabled: true; CreateService não tem campo de isolamento. Para uma task confidencial como a do Teste 6, o registro do Decrypt do KMS tem o ID da task como user name e um bloco recipient com o module ID (o ID da instância pai mais -enc…), o digest da imagem, PCR1 a PCR4, PCR8, attestationDocumentEnclavePCR8ServiceName: ecs.amazonaws.com e o PCR17. O PCR17 vem em base64; decodificado, ele bateu com a previsão do gerador. O registro levou até 9 minutos para chegar ao Event history.
Preços
O ECS é explícito: “Não há cobrança adicional para tasks isoladas e confidenciais. Você paga pelas instâncias do Amazon EC2 subjacentes e pela taxa de gerenciamento padrão do Amazon ECS.” Na us-east-1, isso dá US$ 0,17952 por hora on demand para a m8g.xlarge, mais uma taxa de gerenciamento do Managed Instances de US$ 0,02154 por hora, US$ 0,20106 no total, tenha a instância zero sandboxes ou quatro. O custo aparece como capacidade:
- Overhead de memória. Pelo menos 262 MiB por sandbox, o que é metade a mais em uma task de 512 MiB. Com 1 vCPU / 4 GiB, é a diferença entre três tasks por instância e duas (Teste 5).
- Sem limite de instâncias. Um capacity provider de Managed Instances não tem tamanho máximo. Quando uma quinta task de 1 vCPU chegou enquanto as 4.096 unidades de CPU da primeira instância estavam ocupadas, o ECS lançou uma segunda
m8g.xlarge(i-0cc8ffc57d7b4226b). As duas instâncias passaram por scale in quando ficaram ociosas, mas a conta segue o número de tasks, não o seu plano de ficar em uma máquina só. Na execução de operações, as duas primeiras tasks de um service novo chegaram a ganhar uma instância cada, até o ECS consolidá-las cerca de 7 minutos depois. - Por task. Pela aritmética do Teste 5, quatro tasks isoladas de 1 vCPU / 2 GiB lotam uma
m8g.xlarge, cerca de US$ 0,050 por hora cada, com a taxa. Uma Lambda MicroVM do mesmo tamanho custa US$ 0,1261 por hora enquanto roda, mas só cobra computação enquanto roda e pode ser suspensa com a memória intacta; uma instância é cobrada por toda hora em que está de pé, ocupada ou não.
A minha exploração foi de cerca de 23:20 a 00:10 UTC, com o ECS lançando instâncias e fazendo scale in conforme as tasks iam e vinham, e a execução gravada, de cerca de 01:30 a 01:55 UTC em 2026-11-10. Além das instâncias, o NAT gateway custa cerca de US$ 0,045 por hora (mais US$ 0,045 por GB processado) até o terraform destroy, e a chave do KMS, US$ 1 por mês até você agendar a exclusão dela.
Limpeza
Pare todas as tasks, apague o capacity provider, espere as instâncias dele serem encerradas, apague o cluster, destrua as dependências e agende a exclusão da chave:
CLUSTER=my2cents-nitro-ecs; CP=my2cents-nitro-cp
TASKS=$(aws ecs list-tasks --cluster $CLUSTER --query 'taskArns[]' --output text)
for t in $TASKS; do aws ecs stop-task --cluster $CLUSTER --task $t --query task.lastStatus --output text; done
[ -n "$TASKS" ] && aws ecs wait tasks-stopped --cluster $CLUSTER --tasks $TASKS

aws ecs delete-capacity-provider --cluster $CLUSTER --capacity-provider $CP
aws ecs describe-capacity-providers --capacity-providers $CP \
  --query 'capacityProviders[0].[status, updateStatus, updateStatusReason]' --output text
# if this shows DELETE_FAILED (tasks still stopping, for example), wait and run the delete again

# wait until this prints nothing, then delete the cluster
aws ecs list-container-instances --cluster $CLUSTER --query 'containerInstanceArns[]' --output text
aws ecs delete-cluster --cluster $CLUSTER

terraform -chdir=terraform destroy
aws kms schedule-key-deletion --key-id <key-id> --pending-window-in-days 7   # key ID, not alias
Parar levou cerca de um minuto por task no Teste 5, porque o sleep como PID 1 ignora o SIGTERM e espera o stop timeout de 30 segundos acabar; um workload que trata o SIGTERM para mais rápido. Se a exclusão do provider reportar DELETE_FAILED, espere as tasks terminarem de parar e rode de novo. Espere pelo list-container-instances, não pelo ec2 describe-instances: na execução de operações, as Managed Instances não apareceram em listagens do describe-instances filtradas por VPC. Como na parte 2, o schedule-key-deletion quer o ID da chave, não o alias. Task definitions não custam nada, mas o README de apoio tem um loop que faz o deregister e apaga as famílias my2cents-.
Veredito
O que funciona
O opt-in é tão pequeno quanto o prometido depois que o capacity provider existe: um checkbox no provider, um campo ou um radio button na task definition, e nenhuma mudança no container. O console já tinha tudo isso em 9 de novembro, antes da documentação. Uma task isolada é visivelmente uma máquina própria, com o seu próprio kernel, uma VM do tamanho da task e discos próprios, enquanto uma task compartilhada na mesma instância vê tudo. Configurações de nível de host que seriam perigosas em uma task compartilhada são rejeitadas ou confinadas ao sandbox, e, na minha execução, nenhum dos modos conseguiu alcançar o serviço de metadados da instância. A task role, o endpoint de metadados da task e o ECS Exec funcionam sem mudanças em uma task isolada. Rodando como um service de longa duração, as tasks em sandbox fizeram scale out, foram substituídas quando paradas e apareceram no Container Insights, nas métricas do service e nos logs como qualquer outra, e o CloudTrail registrou tanto a configuração de isolamento quanto o decrypt atestado.
O modo confidencial é o caminho de atestação mais completo desta série até agora. O gerador de policy previu o PCR17 exatamente, então a key policy pode ser escrita antes de a task rodar; o KMS liberou o segredo só para a task que levava essa policy, recusando o mesmo container no modo isolado; e um comando alterado foi barrado antes de iniciar. Para esta demo, todo o toolchain rodou no cluster, então um Mac bastou, mas em produção o gerador deve ficar em CI ou em uma estação de trabalho, fora da instância que o modo confidencial trata como não confiável.
O que ainda não funciona
A documentação está atrás do produto. Ela não mostra nenhum procedimento no console, as páginas novas de configuração não têm link a partir da própria página de visão geral do recurso e só aparecem no sumário do developer guide, e a página de responsabilidade compartilhada do Managed Instances ainda diz que não há isolamento de tasks. A configuração do Nitro só pode ser definida quando um capacity provider é criado, e o padrão “Use local storage” do console a desabilita. O substituto de metadados documentado não respondeu na minha execução.
Os rolling deployments foram a maior surpresa: em services criados pelo console, todo rolling update com as configurações padrão falhou com um erro de pre-ingest da imagem e fez rollback, cinco vezes de cinco, enquanto scale-outs e substituições funcionaram. Desligar a consistência de versão no container resolveu, cinco vezes de cinco, e services criados com a CLI não falharam nem com o padrão. Até a AWS explicar isso, defina versionConsistency como disabled em services com sandbox e teste o seu caminho de deploy antes de depender dele. O ECS também pode dar uma instância para cada uma das primeiras tasks de um service novo antes de consolidá-las, e nem o overhead de memória nem o modo de isolamento aparecem em qualquer métrica ou evento do EventBridge.
O piso de overhead de cerca de 262 MiB deixa os sandboxes pequenos caros em memória. Não há limite de instâncias nem como fixar uma task em uma instância. O modo confidencial acrescenta um ciclo de policy: o gerador é só para Linux, deve rodar fora da instância, rejeita comandos de várias linhas e fixa valores de ambiente, então toda mudança se propaga para o PCR17 e para a key policy. O ECS Exec tem de ser permitido quando a policy é gerada: uma task confidencial iniciada com exec ativado, contra uma policy que não o permitia, não conseguiu iniciar. Os limites documentados continuam valendo: só awsvpc, sem Service Connect, sem volumes EBS por task, sem GPUs, e armazenamento efêmero fixo em 20 GiB. E, no lançamento, não havia caminho de infraestrutura como código para o campo da task definition.
Quem deve usar
Times que já estão no ECS Managed Instances e fazem bin-packing de tasks de tenants diferentes, ou rodam imagens de container que não escreveram. O ECS o posiciona como “o isolamento equivalente ao do AWS Fargate, no nível de VM e por task”, com a diferença de que “as tasks rodam no Amazon ECS Managed Instances na sua própria conta”, então você mantém a escolha de instância e o bin-packing. Ele se encaixa melhor a partir de 2 GiB, onde o overhead fica abaixo de 20%. O modo confidencial é para workloads que precisam provar o que rodam antes de receber uma chave, e a medição esperada vem de uma ferramenta documentada que lê a task definition, então a key policy pode estar pronta antes de a primeira task rodar.
Evite-o para tasks com GPU, meshes de Service Connect ou frotas de tasks minúsculas. Se você roda o seu próprio orquestrador, a primitiva crua no EC2 (parte 2) dá mais controle e mais trabalho. Se você prefere não operar instâncias, as AWS Lambda MicroVMs cobram por segundo enquanto rodam e são suspensas com a memória intacta, mas não documentam atestação. Times que usam Kubernetes devem ler a parte 4.