AWS Nitro Sandboxes no EC2: Hands-On com Firecracker e Atestação
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Uma role de instância para o Session Manager
- Passo 2: Lance a instância pai pelo console
- Passo 3: Reserve um pool de memória (não é opcional)
- Passo 4: Firecracker, um guest e uma rede
- Testes
- Teste 1: Os orçamentos da instância pai antes de qualquer sandbox
- Teste 2: Faça o boot de um sandbox e meça o tempo
- Teste 3: Direto versus confidencial, visto da instância pai
- Teste 4: Atestação, com um guest AL2023 e o AWS KMS
- Teste 5: O que o KMS recusa
- Teste 6: Quantos sandboxes cabem
- Teste 7: Um sandbox, um container e o serviço de metadados
- Resumo dos resultados
- Operação e Monitoramento
- Preços
- Limpeza
- Veredito
- O que funciona
- O que ainda não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine que a sua caixa de brinquedos pode ganhar uma caixa menor e trancada dentro dela. Você coloca um brinquedo novo na caixinha e, depois que a tampa fecha, nem você, o dono da caixa grande, consegue espiar lá dentro.
Dá para escolher a tampa. Uma tampa é de vidro, então a caixa grande ainda consegue ver lá dentro. A outra é sólida, e a caixinha pode mostrar um adesivo que prova qual brinquedo está lá dentro. Um adulto só entrega o biscoito secreto quando o adesivo está certo.
No EC2 puro, o cliente opera a instância pai e o software do sandbox, então é o cliente que carrega o risco de configuração. A AWS fornece a fronteira de isolamento e um documento de atestação assinado; tudo ao redor disso, incluindo o egress de rede e o acesso a metadados, cabe ao operador controlar.
O controle que vale documentar é a liberação de chaves. No modo confidencial, uma key policy do AWS KMS pode exigir uma medição específica da imagem antes de descriptografar, então nem a própria instância do operador consegue obter o segredo. No modo direto essa garantia não existe, e a instância pai consegue ler a memória do guest.
A queixa principal é código não confiável compartilhando um kernel com todo o resto no host. A intervenção é um guest isolado por hardware que faz boot em cerca de dois segundos na mesma instância, sem virtualização aninhada.
Dois achados importam clinicamente. No modo confidencial, a instância pai não conseguiu encontrar um segredo plantado na memória do guest, e o KMS liberou uma chave apenas para uma imagem medida. Efeitos colaterais: você precisa reservar memória de antemão, e um guest consegue alcançar o serviço de metadados da instância pai a menos que você o bloqueie.
Existe um alívio real em poder dizer "nem eu consigo ver lá dentro" sobre um workload que você mesmo roda. Isso muda a conversa com os times de segurança: sai o confie em mim, entra o aqui está a medição.
O peso passa para quem opera a instância pai. Essa pessoa é dona do pool de memória, do encanamento de rede, do build da imagem e da cola da atestação, e nada disso está embrulhado em uma API amigável ainda. Conte com essa pessoa pedindo tempo, e um runbook, antes que alguém chame isso de pronto para produção.
Pense na instância pai como um estúdio e em cada sandbox como uma cabine de voz construída dentro dele. O modo direto tem uma janela, então o técnico ouve tudo. O modo confidencial tem isolamento acústico, e a cabine pode entregar um setlist assinado que prova o que está sendo tocado.
As cabines sobem rápido, cerca de dois segundos cada, mas você precisa reservar o espaço antes de a sessão começar, e a casa só tem um certo número de portas. Planeje a sala antes de chamar a banda.
A história é simples: isolamento por hardware para um workload do tamanho de um container, na instância pela qual você já paga, sem custo adicional. No EC2, é a primitiva em estado bruto, voltada para times que rodam o próprio orquestrador.
A prova é o modo confidencial. Uma chave do KMS que só abre para um sandbox medido é uma demo certeira para compradores de setores regulados. Mas posicione com honestidade: hoje esse caminho exige um time de plataforma capacitado, não um checkbox.
 Veja o código-fonte aqui: aws-nitro-sandboxes
Visão Geral
Em 2026-11-09 a AWS lançou os Nitro Sandboxes: VMs leves que o hypervisor Nitro recorta de uma instância EC2 que você já roda. Cada sandbox é um guest de primeiro nível, virtualizado por hardware, ao lado da sua instância pai, e não uma VM aninhada dentro dela. O recurso está disponível na maioria dos tipos de instância Nitro, em todas as Regiões comerciais, sem custo adicional.
Há três portas de entrada. O Amazon EKS e o Amazon ECS encapsulam o recurso em um pod ou em uma task, e a parte 3 e a parte 4 cobrem esses caminhos. Este post, parte 2 de 4, usa a primitiva em estado bruto no EC2: você ativa uma configuração na instância e depois controla o sandbox você mesmo com o Firecracker 1.18, lançado no mesmo dia. A parte 1 explica a arquitetura e compara os três.
No EC2, você é o operador da instância pai. A AWS fornece a fronteira e a atestação; você fornece o pool de memória, a rede, a imagem do guest e o que quer que verifique as medições. Eu queria saber quanto disso a documentação realmente cobre, então rodei tudo de ponta a ponta em uma m8g.xlarge (Graviton4, 4 vCPU, 16 GiB) na us-east-1, duas vezes: uma rodada de exploração em 2026-11-09 e a rodada que gravei para o vídeo em 2026-11-10, ambas com a AWS CLI 2.39.7. As saídas abaixo são da rodada gravada, salvo indicação em contrário. A AWS revisou o guia do EC2 depois das minhas rodadas, adicionando páginas sobre rodar sandboxes com Firecracker e sobre atestação. Onde ele agora cobre algo que eu precisei descobrir por conta própria, eu indico abaixo.
Três resultados se destacaram:
- O modo confidencial faz o que promete. Eu plantei um segredo na memória de um guest e procurei por ele a partir da instância pai. No modo direto, a instância pai o encontrou 1.994 vezes; no modo confidencial, zero vezes.
- A atestação funciona no EC2 puro, com alguma montagem. Uma chave do AWS KMS que exige uma medição específica da imagem liberou um segredo apenas para o sandbox. Um argumento de kernel alterado, o modo debug ou um documento adulterado foram todos recusados.
- Um limite documentado não se sustentou. Com CPU overcommit, o guia do EC2 limita o total de vCPUs dos sandboxes a cinco vezes o da instância, mas eu rodei 80 vCPUs de sandbox em uma instância de 4 vCPUs. O limite que valeu foi a outra regra do guia: no máximo 20 sandboxes, cinco por vCPU.
Arquitetura
O recurso reaproveita o encanamento do Nitro Enclaves: a mesma configuração de instância, o mesmo driver /dev/nitro_enclaves, o mesmo formato de documento de atestação e as mesmas chaves de condição do KMS. O que é novo é o guest. Um enclave conversa com a sua instância pai por um único canal vsock e não tem rede nem disco. Um sandbox ganha dispositivos virtio de rede e de bloco, faz boot de um kernel comum bootável via EFI (com drivers virtio-pci, mais um pequeno conjunto de patches para o modo confidencial) e roda o que quer que você coloque no seu sistema de arquivos raiz.
Configuração
Tudo abaixo roda como root na instância pai, em um shell do Session Manager (aws ssm start-session --target <instance-id>, depois sudo -i). Você precisa da AWS CLI 2.39.7 ou posterior na sua máquina; é a primeira versão com os campos do ECS que esta série usa mais adiante. O Homebrew se atualizou na noite de 9 de novembro; antes disso, eu tinha instalado o pacote da própria AWS. Para o Session Manager, você precisa do session-manager-plugin.
Passo 1: Uma role de instância para o Session Manager
Sem par de chaves, sem regras de entrada: o Session Manager é a única porta de entrada.
aws iam create-role --role-name nitro-sandbox-ec2 \
  --assume-role-policy-document '{"Version":"2012-10-17","Statement":[{"Effect":"Allow","Principal":{"Service":"ec2.amazonaws.com"},"Action":"sts:AssumeRole"}]}'
aws iam attach-role-policy --role-name nitro-sandbox-ec2 \
  --policy-arn arn:aws:iam::aws:policy/AmazonSSMManagedInstanceCore
aws iam create-instance-profile --instance-profile-name nitro-sandbox-ec2
aws iam add-role-to-instance-profile --instance-profile-name nitro-sandbox-ec2 --role-name nitro-sandbox-ec2
Passo 2: Lance a instância pai pelo console
Em EC2 > Launch instance, o padrão do Quick Start em 9 de novembro já era “Amazon Linux 2023 kernel-6.18 AMI”. Mude a arquitetura para 64-bit (Arm), escolha m8g.xlarge, selecione “Proceed without a key pair”, desmarque a regra de SSH do assistente, dê a ela 20 GiB de armazenamento e, em Advanced details, defina o perfil de instância e Nitro Enclave: Enable. Essa única configuração é o interruptor do recurso inteiro.
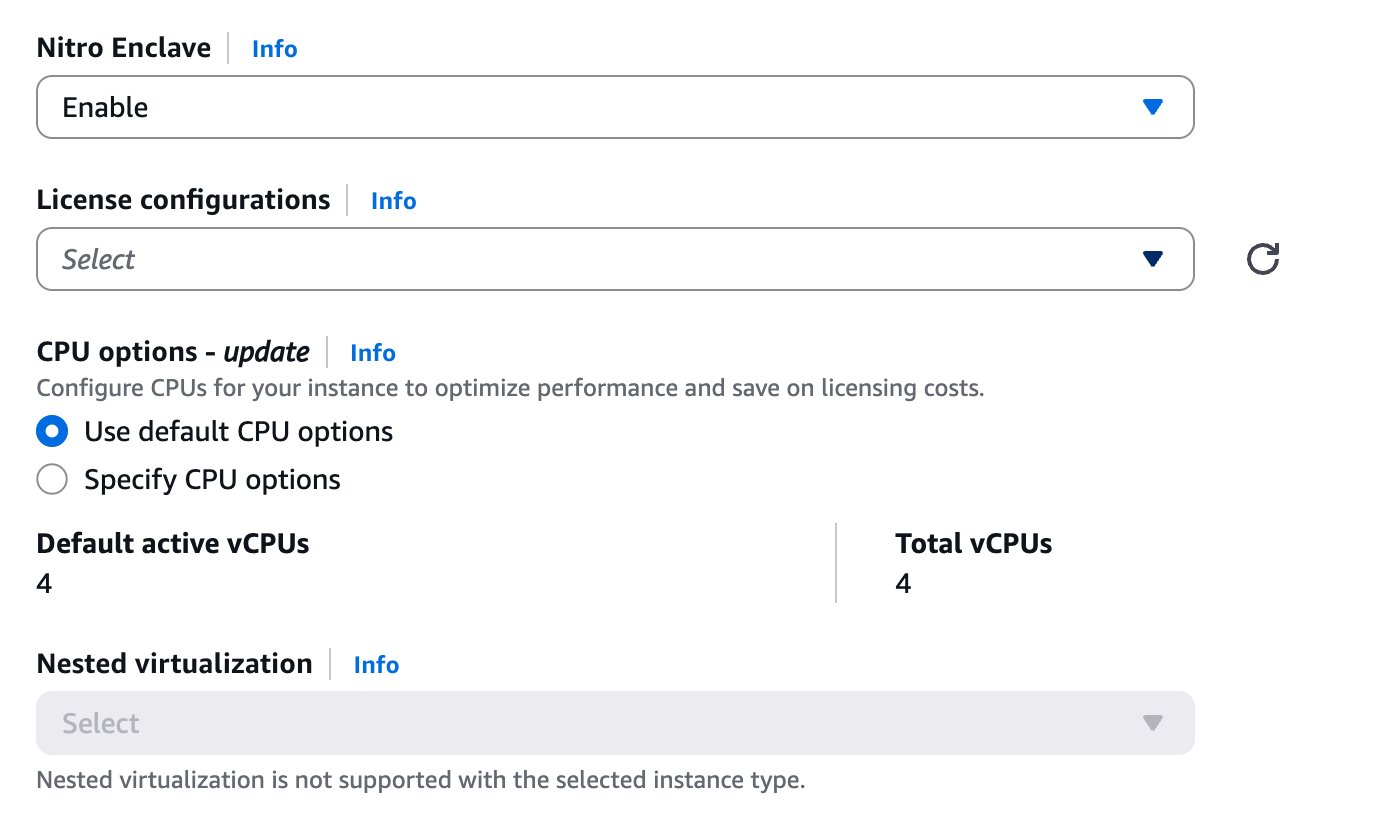
A captura de tela mostra algo que o guia do EC2 agora também afirma: a virtualização aninhada só está disponível em instâncias Intel, então nesta ela simplesmente não está disponível, e os sandboxes funcionam mesmo assim, porque não a usam. (O guia acrescenta que você não pode usar sandboxes em uma instância com virtualização aninhada ativada.) O equivalente na CLI:
aws ec2 run-instances \
  --image-id resolve:ssm:/aws/service/ami-amazon-linux-latest/al2023-ami-kernel-6.18-arm64 \
  --instance-type m8g.xlarge \
  --iam-instance-profile Name=nitro-sandbox-ec2 \
  --enclave-options Enabled=true \
  --block-device-mappings 'DeviceName=/dev/xvda,Ebs={VolumeSize=20,VolumeType=gp3}'
A instância pai precisa do pacote kernel6.18 do AL2023 na versão 6.18.51-120.162 ou posterior. A AMI do Quick Start mudou em 9 de novembro: a minha primeira rodada pegou a al2023-ami-2023.12.20261102.0 com o kernel 6.18.56-125.164, e a rodada gravada, a al2023-ami-2023.12.20261109.0 com o 6.18.56-126.188. As duas funcionaram, sem nada para instalar. aws ec2 describe-instance-attribute --attribute enclaveOptions retorna {"Enabled": true}, e o Session Manager ficou online cerca de 30 segundos depois do lançamento.
Passo 3: Reserve um pool de memória (não é opcional)
O meu primeiro sandbox, com 2 vCPUs e 1 GiB, morreu 50 ms depois de iniciar:
CMA allocation failed: size=1073741824 bytes gpa=0x40000000 parent_numa=0 prot=0x3: Cannot create mmap region: Out of memory (os error 12)A memória do sandbox precisa ser fisicamente contígua. O guia do Firecracker diz que, sem uma reserva, o driver “aloca memória contígua a partir da memória geral da instância pai a cada lançamento”. Nesta AMI, esse pool geral é a área de memória contígua padrão do kernel, e o /proc/meminfo mostrava CmaTotal: 65536 kB: 64 MiB. O guia do EC2 revisado é mais direto: “Sem um pool, você não consegue lançar Nitro Sandboxes.” Ele também diz que uma instância pai sem pool tem 0 slots. Não foi isso que eu vi no meu primeiro boot (kernel 6.18.56-125.164): com mem_pool/total em 0, pcie_slots mostrava 4, e o lançamento chegou até a alocação CMA. Duas rodadas posteriores no kernel 6.18.56-126.188, para a seção de operações do vídeo, também mostraram 4. De qualquer forma, reservar um pool no boot resolveu:
grubby --update-kernel=ALL --args="nitro_enclaves.mempool=12G"
systemctl reboot
Depois do reboot, CmaTotal estava em 12 GiB e /sys/class/misc/nitro_enclaves/mem_pool/free reportava 12.284 MiB. A reserva não tira essa memória da instância pai de antemão: free -m ainda mostrava cerca de 15 GiB livres, e a memória de um sandbox só sai da instância pai quando o sandbox inicia. O próprio script de build da AWS para imagens de node do EKS com suporte a sandboxes faz a mesma coisa, com nitro_enclaves.mempool=95%-1G, e observa que os sandboxes não iniciam sem isso. O exemplo do guia do EC2 é nitro_enclaves.mempool=8G@0 (8 GiB no nó NUMA 0), e ele verifica a reserva com dmesg | grep "nitro_enclaves: CMA pool".
Passo 4: Firecracker, um guest e uma rede
O Firecracker 1.18.0 é a primeira versão com suporte a sandboxes, e o tarball aarch64 dele funciona no Graviton. Para um guest rápido, o CI do Firecracker publica um kernel e um sistema de arquivos raiz Ubuntu; no aarch64, o vmlinux dele já é uma imagem bootável via EFI.
dnf install -y nftables squashfs-tools
mkdir -p /opt/sandbox && cd /opt/sandbox

# Firecracker
curl -fsSL https://github.com/firecracker-microvm/firecracker/releases/download/v1.18.0/firecracker-v1.18.0-aarch64.tgz | tar -xz
mv release-v1.18.0-aarch64/firecracker-v1.18.0-aarch64 /usr/local/bin/firecracker

# Guest kernel and rootfs from Firecracker's CI (20261105 build)
S3=https://s3.amazonaws.com/spec.ccfc.min/firecracker-ci/20261105-6ea6634994fa-0/aarch64
curl -fsSLO $S3/vmlinux-6.18.56
curl -fsSL -o ubuntu-24.04.squashfs $S3/ubuntu-24.04.squashfs
unsquashfs ubuntu-24.04.squashfs
ssh-keygen -q -f id_rsa -N "" && cp id_rsa.pub squashfs-root/root/.ssh/authorized_keys
truncate -s 1G ubuntu-24.04.ext4 && mkfs.ext4 -q -d squashfs-root -F ubuntu-24.04.ext4
A rede é um dispositivo TAP que a instância pai faz NAT para fora pela própria interface. O guia de configuração de rede do Firecracker assume que o uplink é eth0; nesta AMI ele é ens34, então descubra o nome do jeito que o guia de primeiros passos do Firecracker (e agora o guia do EC2) faz:
HOST_IFACE=$(ip -j route list default | jq -r '.[0].dev')   # ens34 here
ip tuntap add tap0 mode tap
ip addr add 172.16.0.1/30 dev tap0 && ip link set tap0 up
echo 1 > /proc/sys/net/ipv4/ip_forward
nft add table firecracker
nft 'add chain firecracker postrouting { type nat hook postrouting priority srcnat; policy accept; }'
nft 'add chain firecracker filter { type filter hook forward priority filter; policy accept; }'
nft add rule firecracker postrouting ip saddr 172.16.0.0/24 oifname $HOST_IFACE masquerade
nft add rule firecracker filter iifname '"tap*"' oifname $HOST_IFACE accept
Você não precisa da Nitro Enclaves CLI nem do serviço de alocação dela. O Firecracker conversa diretamente com o driver.
Testes
Teste 1: Os orçamentos da instância pai antes de qualquer sandbox
O driver expõe os seus orçamentos em /sys/class/misc/nitro_enclaves/:
| Arquivo | Valor na m8g.xlarge | O que significa |
|---|---|---|
cpu_pool/total | 3 | Núcleos disponíveis para sandboxes com núcleos dedicados; o núcleo da CPU 0 fica com a instância pai |
pcie_slots | 4 | Sandboxes que a instância pai comporta agora |
pcie_slots_total | 20 | O máximo que ela pode comportar: 5 × as suas vCPUs |
mem_pool/free | 12.284 MiB | Depois da reserva do Passo 3 |
O Graviton tem uma thread por núcleo, então cada vCPU é um núcleo inteiro. Em instâncias Intel e AMD com duas threads por núcleo, sandboxes com núcleos dedicados precisam pegar as duas threads de um núcleo, e vcpu_count tem de ser par.
Teste 2: Faça o boot de um sandbox e meça o tempo
O único acréscimo a uma configuração comum do Firecracker é a chave enclave. {} significa modo confidencial, o padrão; {"direct_mode": true} significa modo direto.
{
  "boot-source": { "kernel_image_path": "/opt/sandbox/vmlinux-6.18.56" },
  "machine-config": { "vcpu_count": 2, "mem_size_mib": 1024 },
  "drives": [
    { "drive_id": "rootfs", "path_on_host": "/opt/sandbox/ubuntu-24.04.ext4",
      "is_root_device": true, "is_read_only": false }
  ],
  "network-interfaces": [
    { "iface_id": "eth0", "guest_mac": "06:00:AC:10:00:02", "host_dev_name": "tap0" }
  ],
  "enclave": { "direct_mode": true }
}
firecracker --api-sock /tmp/fc.sock --config-file direct.json &
ssh -i /opt/sandbox/id_rsa root@172.16.0.2Eu medi o tempo desde o início do Firecracker até o primeiro login SSH bem-sucedido, testando a cada 0,2 segundo:
| Sandbox | Tempo até o SSH |
|---|---|
| Modo direto, kernel do CI, 2 vCPU, 1 GiB | 1,70 s (1,71 s na rodada gravada) |
| Modo direto com o console de debug | 2,33 s |
| Modo confidencial, kernel do CI, 2 vCPU, 1 GiB | 1,87 s |
| Modo confidencial, kernel do AL2023 e um initramfs de 17 MB | 3,08 a 3,24 s |
Por dentro, é uma máquina separada. O kernel era 6.18.56+ #1 SMP Thu Nov 5, contra o 6.18.56-126.188.amzn2023 #2 SMP Tue Nov 3 da instância pai; ele tinha o próprio boot_id, um uptime de cerca de dois segundos, um disco (vda), e o dmesg mostrava o boot via UEFI (efi: EFI v2.7 by EDK II). Na instância pai, cpu_pool/in_use foi para 2 e pcie_slots_in_use para 1.
Uma verificação dos blueprints de sandbox do EKS da AWS não vale aqui: /sys/class/dmi/id/product_name, que mostra <family>.enclave em sandboxes x86, não existe em um guest arm64. Use no lugar dela a string de build do kernel, o /proc/uptime e os nomes dos discos.
Teste 3: Direto versus confidencial, visto da instância pai
A principal diferença entre os modos é se a instância pai consegue alcançar a memória do guest, então eu testei isso diretamente. Dentro do guest, escrevi um marcador único em /dev/shm 2.000 vezes. Na instância pai, procurei por ele em todos os mapeamentos de /dev/nitro_enclaves no processo do Firecracker.
# inside the guest
MARK="my2cents-secret-$(date +%s%N)"
for i in $(seq 1 2000); do echo $MARK; done > /dev/shm/secret

# on the parent, with MARK set to the same value
FCPID=$(pgrep -x firecracker)
for MAP in $(grep nitro_enclaves /proc/$FCPID/maps | awk '{print $1}'); do
  S=$((0x${MAP%-*})); E=$((0x${MAP#*-}))
  N=$(dd if=/proc/$FCPID/mem bs=1M iflag=skip_bytes,count_bytes skip=$S count=$((E-S)) 2>/dev/null | grep -a -c "$MARK")
  echo "$(( (E-S)/1048576 )) MiB: $N copies"
done
O gcore não serve para isso: ele pula esses mapeamentos, e o core file saiu com 5 MB. Ler /proc/<pid>/mem diretamente funciona. Mesmo guest, mesmo marcador, os dois modos:
| Modo direto | Modo confidencial | |
|---|---|---|
Mapeamentos de /dev/nitro_enclaves no Firecracker | 1024 MiB (RAM do guest), 2 MiB (página de controle) | 16 MiB e 16 MiB (buffers de dispositivo), 1024 MiB, 2 MiB |
| Todos legíveis a partir da instância pai | sim | sim |
| Cópias do segredo do guest encontradas | 1.994 | 0 |
Dispositivo NSM (1af4:1061) no guest | ausente | presente |
Buffers de memória de dispositivo no dmesg do guest | nenhum | virtio_blk virtio1: Enabled 16777216-byte Virtio DMB (e o mesmo para virtio_net) |
A leitura funciona nos dois modos; no modo confidencial, ela só não retorna os dados do guest. O modo direto é a escolha certa quando você confia na instância pai e quer I/O mais simples. O modelo de confiança dele, nas palavras do guia do EC2, é “equivalente ao de uma máquina virtual aninhada”. O modo confidencial é o padrão por um motivo.
Teste 4: Atestação, com um guest AL2023 e o AWS KMS
Um sandbox confidencial tem um Nitro Secure Module (NSM). Ele assina um documento de atestação com medições da imagem de boot (PCR0 a PCR2), da instância pai (PCR3 e PCR4) e, como novidade dos sandboxes, dos dispositivos no boot (PCR5) e do arquivo de imagem inteiro (PCR6). Uma key policy do KMS pode exigir essas medições antes de descriptografar qualquer coisa. Quando eu rodei isso, a documentação descrevia a atestação, mas deixava duas peças por minha conta. A nova página de atestação do guia do EC2 agora cobre as duas.
Primeiro, o guest precisa do driver do NSM. O kernel do CI do Firecracker é compilado sem ele (# CONFIG_NSM is not set). O kernel do AL2023 o tem como módulo, e o /boot/vmlinuz dele já é uma aplicação EFI, então eu fiz o boot do próprio kernel da instância pai como guest, com um initramfs que carrega os drivers. Esse também é o caminho que o guia do EC2 agora segue:
dracut --force --no-hostonly \
  --add-drivers "virtio_pci virtio_blk virtio_net ext4" \
  --force-drivers "nsm virtio_net" \
  /opt/sandbox/initrd-al-guest.img $(uname -r)
cp /boot/vmlinuz-$(uname -r) /opt/sandbox/vmlinuz-al
{
"boot-source": {
"kernel_image_path": "/opt/sandbox/vmlinuz-al",
"initrd_path": "/opt/sandbox/initrd-al-guest.img",
"boot_args": "panic=1 initcall_blacklist=i8042_init net.ifnames=0"
},
"machine-config": { "vcpu_count": 2, "mem_size_mib": 1024 },
"drives": [ { "drive_id": "rootfs", "path_on_host": "/opt/sandbox/ubuntu-24.04.ext4", "is_root_device": true, "is_read_only": false } ],
"network-interfaces": [ { "iface_id": "eth0", "guest_mac": "06:00:AC:10:00:02", "host_dev_name": "tap0" } ],
"enclave": {}
}O /dev/nsm apareceu. Não há CLI para ele, então escrevi um pequeno cliente em Python só com a biblioteca padrão (nsm.py no repositório de apoio). Ele envia ao NSM um pedido de atestação com uma chave pública e decodifica os PCRs do documento assinado. O guia do EC2 agora pede que você compile um pequeno programa em Rust, nsm-attest, para a mesma tarefa.
Segundo, você precisa conhecer o PCR0 de antemão. O Firecracker monta a imagem de boot em memória e não informa as medições dela. Quando eu rodei isso, nenhuma documentação indicava uma ferramenta para você mesmo montar a imagem. A página de atestação agora indica: monte-a com eif_build --pcie-virtio, que imprime PCR0, PCR1, PCR2 e PCR6, e aponte kernel_image_path para o resultado. (Não use o nitro-cli: o guia diz que o PCR0 dele é diferente para os mesmos arquivos, porque o PCR0 de um sandbox também cobre configurações de lançamento como o CPU overcommit.) Eu, em vez disso, peguei um atalho. As medições se mostraram determinísticas: dois boots do mesmo kernel, initramfs e linha de comando deram os mesmos PCR0, PCR1 e PCR2. Então eu as li uma vez de dentro, o que serve para uma demo. Em produção, monte a imagem com eif_build e pegue os valores da saída dele.
module_id: i-027e…-enc01a1c30b3f0c118b digest: SHA384
PCR0: 45f505c94768f619b4d8b421087fb5d74797a3ea9ed50473ec50db443ee1794d30fe38a419b3b1ea814babbe7f1ce278
PCR1: 2f191a99923d20ff7b0de72d7b9b239dcd465ec460ba9b751eecb532c11469ff22f198fce030f5d7541ee9c81b512de0
PCR2: 21b9efbc184807662e966d34f390821309eeac6802309798826296bf3e8bec7c10edb30948c90ba67310f7b964fc500a
PCR3: 2cb637df…
PCR4: acb56851…
PCR3 e PCR4 identificam a instância pai, como fazem no Nitro Enclaves. Eu os conferi: cada um é um SHA-384 sobre 48 bytes zero seguidos do ARN da IAM role da instância pai (PCR3) ou do ID da instância (PCR4), a fórmula que a página de atestação agora apresenta. Eu os encurtei aqui porque o ARN da role contém o ID da conta, que é fácil de recuperar a partir do hash. O PCR2 bate byte a byte com o exemplo do guia: com um único initramfs, ele é a medição de uma entrada vazia. O documento também trazia PCR5 e PCR6, que nenhuma documentação definia quando eu rodei isso.
A medição também acompanha o sistema operacional. A atualização da AMI entre as minhas duas rodadas trouxe um kernel novo, e o PCR0 mudou junto: ab0079bb… na primeira rodada, 45f505c9… na gravada. Uma key policy fixada no PCR0 precisa ser atualizada sempre que você muda o kernel do guest.
A key policy dá à role da instância pai kms:Decrypt apenas para um destinatário com esse PCR0:
{
  "Sid": "DecryptOnlyFromThisSandboxImage",
  "Effect": "Allow",
  "Principal": { "AWS": "arn:aws:iam::<ACCOUNT_ID>:role/nitro-sandbox-ec2" },
  "Action": "kms:Decrypt",
  "Resource": "*",
  "Condition": {
    "StringEqualsIgnoreCase": {
      "kms:RecipientAttestation:ImageSha384": "45f505c94768f619b4d8b421087fb5d74797a3ea9ed50473ec50db443ee1794d30fe38a419b3b1ea814babbe7f1ce278"
    }
  }
}
O guest cria um par de chaves e pede ao NSM um documento que carrega a chave pública. A instância pai repassa esse documento ao KMS. O KMS criptografa a resposta com a chave pública do guest, então a instância pai repassa algo que ela não consegue abrir:
# inside the guest, in RAM
cd /dev/shm
openssl genrsa -out key.pem 2048
openssl rsa -in key.pem -pubout -outform DER -out pub.der
python3 nsm.py attest pub.der att.doc

# on the parent, with the parent's role
aws kms decrypt --ciphertext-blob fileb://secret.enc \
  --recipient "KeyEncryptionAlgorithm=RSAES_OAEP_SHA_256,AttestationDocument=$(base64 -w0 att.doc)" \
  --query CiphertextForRecipient --output text | base64 -d > cfr.der

# inside the guest
openssl cms -decrypt -inform DER -in /dev/shm/cfr.der -inkey /dev/shm/key.pem
Mantenha a chave privada na RAM; é por isso que os comandos usam /dev/shm. Na minha rodada de exploração, eu a gravei em /root, e esse é um erro que vale detalhar: /root fica no disco raiz do guest, que é um arquivo ext4 no disco da instância pai, legível pela instância pai. O modo confidencial protege a memória do guest, não os discos virtio dele, então qualquer coisa que um workload confidencial grave em um disco que ele mesmo não criptografa fica visível para a instância pai. O guia do EC2 agora diz isso com todas as letras, e acrescenta que a criptografia do EBS também não protege os dados contra a instância pai.
O PCR0 tem um ponto cego parecido. O guia observa que os dispositivos de bloco não são medidos, e a minha demo rodou nsm.py e openssl a partir do disco raiz Ubuntu, que a instância pai consegue alterar. O padrão do guia coloca o código que faz a atestação no initramfs medido.
Um detalhe da CLI me custou uma nova tentativa: AttestationDocument=fileb://att.doc dentro da sintaxe abreviada do --recipient falha com Invalid base64. Passe o base64 inline. O guia do EC2 usa AttestationDocument@=fileb://attestation.bin; o @= carrega o arquivo, e na minha rodada de operações isso funcionou (AWS CLI 2.38.0 na instância).
| Passo | Resultado |
|---|---|
A instância pai chama kms:Decrypt sem atestação | AccessDeniedException ... not authorized to perform: kms:Decrypt |
| A instância pai repassa o documento do sandbox | Plaintext: null, mais um CiphertextForRecipient |
| A instância pai tenta abri-lo com a própria chave | Error decrypting CMS structure ... bad decrypt |
| O sandbox o abre | the launch codes are 0000 |
Teste 5: O que o KMS recusa
| Tentativa | Resultado |
|---|---|
Mesmo kernel e initramfs, um argumento de boot a mais (quiet) | Novo PCR0 (e973f238…), AccessDeniedException |
Mesma imagem com "debug_mode": true | O PCR0 é todo zeros, AccessDeniedException |
| Um documento válido com um byte alterado | ValidationException: AWS KMS cannot parse the attestation document. |
| Um documento válido de 90 segundos atrás, de um boot anterior | Aceito, mas selado para uma chave pública cuja metade privada morreu com aquele sandbox |
A última linha é o design funcionando como previsto. O KMS não rejeitou o documento reenviado, e nem precisava: a única parte que consegue abrir a resposta é o guest que criou o par de chaves. O modo debug é a armadilha. Ele oferece um console serial e, no modo confidencial, também zera as medições da imagem, então um sandbox em debug nunca passa por uma key policy fixada no PCR0. Ele não zera PCR3 e PCR4: o meu documento em debug ainda trazia os dois, e o guia do EC2 agora confirma que os PCRs da instância pai mantêm os valores no modo debug. Uma policy que verifica só PCR3 ou PCR4 liberaria, portanto, a chave para um sandbox em debug, e é por isso que o guia diz para sempre incluir PCR0, PCR1 ou ImageSha384.
Teste 6: Quantos sandboxes cabem
Cada sandbox de teste aqui usou o kernel do CI, um sistema de arquivos raiz compartilhado e somente leitura, nenhuma rede e 256 MiB.
| Configuração | Resultado |
|---|---|
| Núcleos dedicados, 1 vCPU cada | 3 iniciam; o 4º falha com NE_ERR_NO_CPUS_AVAIL_IN_POOL (errno=272) |
cpu_overcommit, 1 vCPU cada, orçamento de slots mantido em 4 | 4 iniciam; o 5º falha com No space left on device (os error 28) |
Aumentar o orçamento: echo 20 > /sys/class/misc/nitro_enclaves/pcie_slots | A instância pai cede 256 MiB (dois degraus de 128 MiB, de 8 slots cada) até reiniciar |
cpu_overcommit, 1 vCPU cada, orçamento 20 | 20 iniciam, em 31,7 s incluindo uma pausa de 1,5 segundo depois de cada um; o 21º falha com NE_ERR_ENCLAVE_LIMIT (errno=553): the per-instance enclave quota has been reached |
cpu_overcommit, 4 vCPUs cada, orçamento 20 | 20 iniciam: 80 vCPUs de sandbox em uma instância de 4 vCPUs, cada um registrando smp: Brought up 1 node, 4 CPUs |
A contabilidade de memória bateu com a documentação do Firecracker até o MiB: cada sandbox de 256 MiB tirou 274 MiB do pool, ou seja, 256 mais uma página de controle de 2 MiB e um buffer de memória de dispositivo de 16 MiB para o disco dele.
A última linha contradiz o guia do EC2, que diz “Com CPU overcommit, todos os Nitro Sandboxes juntos podem ter até 5 vezes o número de vCPUs da instância pai”. O próprio exemplo dele para uma instância pai de 4 vCPUs permite no máximo cinco sandboxes de 4 vCPUs cada; eu rodei 20. Nesta instância, nas duas rodadas, o limite que valeu foi a outra regra do guia, o número de sandboxes (“até 5 Nitro Sandboxes para cada vCPU”, então 20 aqui), e não o total de vCPUs deles. Os guests estavam ociosos, então isso não diz nada sobre o desempenho de 80 vCPUs dividindo o tempo de quatro núcleos. Trate isso como comportamento observado, não como promessa.
Teste 7: Um sandbox, um container e o serviço de metadados
O objetivo de tudo isso é o que muda em relação ao jeito usual de rodar código não confiável em uma instância: um container. Eu rodei a mesma verificação na instância pai, em um container docker run na instância pai (o AL2023 precisa de dnf install docker antes) e em um sandbox (cujo guest precisa de uma rota padrão via 172.16.0.1 para sair).
| Instância pai | Container na instância pai | Nitro Sandbox | |
|---|---|---|---|
| Kernel | 6.18.56-126.188.amzn2023 | o mesmo | 6.18.56+ (próprio) |
boot_id | 8afba422… | o mesmo | a035669d… |
| Nome da role no IMDS | nitro-sandbox-ec2 | nitro-sandbox-ec2 | nitro-sandbox-ec2 |
O container é a instância pai com uma visão diferente do sistema de arquivos: um bug de kernel alcançado de dentro dele é um bug no kernel da instância pai. O sandbox tem o próprio kernel, e um bug ali fica no sandbox.
A última linha é a pegadinha. Pelo NAT da instância pai, o sandbox alcançou o serviço de metadados da instância e conseguiu ler o nome da role da instância pai, o que significa que ele também conseguiria buscar as credenciais da instância pai. No ECS e no EKS, a AWS substitui o IMDS dentro do sandbox (a parte 3 e a parte 4 testam quão bem). No EC2, isso é trabalho seu. Uma regra na instância pai fecha a brecha:
nft insert rule firecracker filter iifname '"tap*"' ip daddr 169.254.169.254 counter dropDepois disso, o pedido de metadados do sandbox ficou sem resposta, e o nome da role voltou vazio.
O guia do EC2 revisado agora documenta essa exposição. Ele diz que o IMDSv2 e o hop limit de 2 nas AMIs do Amazon Linux 2023 não a impedem, e o exemplo de NAT dele usa reject em vez de drop, para que um pedido de metadados falhe na hora em vez de esperar um timeout. Se o guest usa o servidor DNS da Amazon, mantenha 169.254.169.253 acessível.
Resumo dos resultados
| Pergunta | Resposta da minha rodada |
|---|---|
| Opção no console | Advanced details > Nitro Enclave: Enable |
| Software extra na instância pai | Firecracker 1.18; sem a Nitro Enclaves CLI |
| Pool de memória | nitro_enclaves.mempool= no boot, ou um sandbox de 1 GiB falha (a área contígua padrão tem 64 MiB); o guia do EC2 agora diz que é obrigatório |
| Do boot ao SSH | 1,7 s direto, 1,9 s confidencial, ~3,1 s com o kernel do AL2023 |
| A instância pai lê a memória do guest | Direto: sim (1.994 ocorrências). Confidencial: não (0 ocorrências) |
| Atestação no EC2 puro | Funciona, com o kernel do AL2023 como guest e o PCR0 lido uma vez de dentro (o guia agora o calcula com eif_build) |
| Limites que pesaram | 3 núcleos dedicados, 4 slots até aumentar, 20 sandboxes (5 por vCPU); não o teto de 5× vCPU |
| Overhead por sandbox | 2 MiB, mais 16 MiB por dispositivo no modo confidencial |
| O guest alcança o IMDS da instância pai | Sim, até você bloquear 169.254.169.254 na instância pai |
| Operação | Nenhuma API, página do console ou métrica da AWS lista os sandboxes; o CPUUtilization da instância conta o trabalho deles (próxima seção) |
Operação e Monitoramento
Assista a esta parte: a seção de operações do vídeo, a partir de 5:49, percorre tudo isso no console e na CLI.
Em 2026-11-10, eu rodei tudo pela terceira vez, para a seção de operações do vídeo: lançar pelo console, iniciar, listar, parar e reiniciar sandboxes, acompanhá-los no CloudWatch, auditar a liberação da chave no CloudTrail, e parar e iniciar a instância pai. Mesmo tipo de instância, kernel 6.18.56-126.188, o nitro_enclaves.mempool=8G@0 do guia e o agente do CloudWatch instalado pelo Systems Manager.
A AWS não enxerga os sandboxes. A aba Details da instância tem um campo relacionado, “Enclaves Support: Enabled”, e describe-instances --filters Name=enclave-options.enabled,Values=true lista instâncias pai, não sandboxes. Todo o resto acontece na instância pai: pcie_slots_in_use os conta, pgrep -a firecracker os lista, e cada socket de API do Firecracker responde a GET / com "state":"Running". nitro-cli describe-enclaves retorna [].
| Ação | O que aconteceu |
|---|---|
| Iniciar | Um processo do Firecracker por sandbox, cada um com o próprio socket de API, arquivo de log e arquivo de métricas |
| Parada limpa | poweroff dentro do guest: o Firecracker saiu 0,6 s depois com Enclave exited (event_set=HANG_UP) e liberou o slot |
| Matar | kill, kill -9 ou Fleet Manager > Processes > Terminate process no console do Systems Manager: slot liberado na hora, outros sandboxes não afetados |
| Pausar | Rejeitado: Operation not supported on Enclave VMs. O pedido rejeitado ainda assim congelou a rede do guest e as métricas do Firecracker até um pedido de retomada, também rejeitado |
| Reboot dentro do guest | O guest ficou em silêncio, mas o Firecracker continuou rodando e segurou o slot: 20 s na rodada gravada, mais de 4 minutos na de exploração, até eu matá-lo. O guia diz que um sandbox “para quando é desligado ou reiniciado” |
| Reiniciar | Falha com Failed to open the API socket até você apagar o socket de API antigo; o guia menciona só o socket vsock. O logger do Firecracker também reescreve o arquivo de log desde o início sem truncá-lo, então apague o log também |
| Parar e iniciar a instância pai | Todos os sandboxes somem, junto com o dispositivo TAP, a tabela nft e o ip_forward. O pool de memória sobrevive, porque está na linha de comando do kernel. Nada reinicia os sandboxes |
| Desligar ou ligar o Nitro Enclave | modify-instance-attribute --enclave-options funciona em uma instância parada e falha em uma em execução, então a instância não precisa ser substituída |
Monitoramento, enquanto um sandbox rodava busy loops em duas vCPUs por dez minutos:
| Sinal | O que mostrou |
|---|---|
CPUUtilization do EC2 | Cerca de 51%, duas de quatro vCPUs. A métrica conta o trabalho dos sandboxes, tanto com núcleos dedicados quanto com cpu_overcommit |
top na instância pai | 95% ocioso, steal 0 |
Agente do CloudWatch, procstat no firecracker | procstat_lookup_pid_count subia a cada sandbox, o mais próximo de uma contagem de sandboxes no CloudWatch. cpu_usage ficou em 0,5% ou menos, e memory_rss ficou em cerca de 1,11 GB por guest de 1 GiB |
| Agente do CloudWatch, arquivos de log do Firecracker | Um log stream por sandbox: o boot, a pausa e a retomada rejeitadas, a saída limpa e o reinício |
| Fleet Manager > Processes | Lista os processos do Firecracker por PID, sem as linhas de comando. Enquanto a página ficou aberta, ela manteve cerca de 30% da CPU da instância pai ocupada |
O CloudTrail registra a liberação da chave. A chamada Decrypt atestada aparece em Event history com o ID da instância como nome de usuário. O bloco additionalEventData.recipient dela traz o ID do módulo de atestação (<instance-id>-enc…), o PCR0 como attestationDocumentEnclaveImageDigest e PCR1 a PCR4 e PCR8, todos em base64, sem PCR5 nem PCR6. A chamada sem atestação não tem bloco recipient, e uma chamada negada cujo PCR0 não batia também não tinha, então o CloudTrail não registra qual imagem o KMS recusou.
Preços
Os Nitro Sandboxes não têm custo adicional. Você paga pela instância, que custava US$ 0,17952 por hora on-demand para a m8g.xlarge na us-east-1, e os sandboxes a compartilham. O custo aparece como capacidade em vez de dólares:
- A memória é doada inteira. Um sandbox de 1 GiB tira 1 GiB mais overhead da instância pai durante toda a vida dele, usado ou não. Não há overcommit nem ballooning.
- Pequenos custos fixos se somam. 2 MiB por sandbox, 16 MiB por dispositivo no modo confidencial e 128 MiB de memória da instância pai a cada 8 slots que você adiciona além dos 4 primeiros.
- Núcleos, se você os dedicar. Sandboxes com núcleos dedicados tiram núcleos inteiros da instância pai;
cpu_overcommit, em vez disso, os compartilha.
Cada uma das minhas duas rodadas manteve a instância no ar por cerca de 20 minutos. A chave do KMS custa US$ 1 por mês enquanto existir.
Limpeza
aws ec2 terminate-instances --instance-ids <instance-id>
aws ec2 wait instance-terminated --instance-ids <instance-id>
aws ec2 delete-security-group --group-id <launch-wizard-sg-id>
aws kms schedule-key-deletion --key-id <key-id> --pending-window-in-days 7   # key ID, not alias
aws iam remove-role-from-instance-profile --instance-profile-name nitro-sandbox-ec2 --role-name nitro-sandbox-ec2
aws iam delete-instance-profile --instance-profile-name nitro-sandbox-ec2
aws iam detach-role-policy --role-name nitro-sandbox-ec2 --policy-arn arn:aws:iam::aws:policy/AmazonSSMManagedInstanceCore
aws iam delete-role --role-name nitro-sandbox-ec2
schedule-key-deletion não aceita um alias; ele quer o ID da chave.
Veredito
O que funciona
A fronteira é real, e você mesmo pode verificá-la. No modo confidencial, a instância pai não conseguiu encontrar um segredo que encontrava trivialmente no modo direto, e o KMS liberou uma chave apenas para uma imagem medida, recusando a mudança de um argumento, o modo debug e um documento adulterado. Os boots levam cerca de dois segundos, em uma instância Graviton comum, sem .metal e sem virtualização aninhada. A API do Firecracker não muda, fora uma chave enclave, então a maior parte do ferramental existente do Firecracker continua servindo; snapshots, pausa e o dispositivo de balloon são as exceções.
O que ainda não funciona
O caminho do EC2 é uma primitiva. Quando eu o rodei, a documentação me deixou quatro coisas para descobrir: um comando do AL2023 para o pool de memória, o nome real do uplink, um kernel de guest com o driver do NSM e um jeito de saber o PCR0 antes de escrever uma key policy. O guia do EC2 revisado agora cobre as quatro, e a exposição de metadados também. Ele não explica o teto de vCPUs: o documentado não foi o limite que eu atingi. E um sandbox ainda consegue alcançar o serviço de metadados da instância pai a menos que você o bloqueie, algo que um time novo nisso poderia facilmente deixar passar.
A operação também fica com você. Nenhuma API, página do console ou métrica da AWS lista os sandboxes, e, embora a métrica de CPU da instância conte o trabalho deles, as ferramentas da própria instância pai não contam. Um reboot dentro do guest deixou o sandbox rodando e segurando o slot, ao contrário do que diz o guia, e uma pausa rejeitada congelou a rede do guest até um pedido de retomada.
Quem deve usar
Times que já rodam o próprio VMM ou orquestrador e querem uma fronteira de hardware em instâncias que já têm, especialmente se precisam de atestação: a capacidade de provar ao KMS, ou a um cliente, exatamente o que está rodando. Se você prefere não ser o operador da instância pai, os caminhos gerenciados encaixam melhor: o ECS (parte 3) e o EKS (parte 4) escondem tudo isso atrás de um campo por task ou pod, depois de uma configuração de capacidade feita uma única vez. As AWS Lambda MicroVMs escondem também a instância, e trocam a atestação por suspensão e retomada. O próprio guia do EC2 aponta as pessoas para lá se elas não querem nada dessa maquinaria, “sem instâncias nem rede para gerenciar”.