OpenShell no Amazon EKS: Stress Test
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Container Insights, só métricas
- Passo 2: Um sampler
- Passo 3: Todo teste a partir do zero
- Testes
- Teste 1: Densidade até algo recusar
- Teste 2: Latência de create sob concorrência
- Teste 3: Propagação de policy
- Teste 4: Quanto custa cada camada de policy
- Teste 5: O gateway sob carga de API
- Teste 6: Noisy neighbours
- O Que o CloudWatch Viu
- Resumo dos Resultados
- Preços
- Limpeza
- Veredito
Explica (TLDR) como se eu fosse...
Eu tentei espremer o máximo possível de quartinhos de robô em duas casas grandes. As casas ainda tinham muito espaço e energia sobrando, mas os números de porta e as vagas de estacionamento acabaram antes, então couberam 46 quartos de um jeito e 61 de outro. Na próxima vez, eu contaria os números de porta primeiro.
Os quartos funcionaram direitinho mesmo quando eu construí 40 de uma vez. Mas quando um robô batia no chão compartilhado, todo mundo do lado ficava mais lento, e toda vez que eu mudava as regras da casa, a ligação de todos os robôs que estavam no telefone caía.
Este post registra testes de carga do OpenShell 0.1.6 em dois nodes do Amazon EKS. A capacidade foi restringida pelos limites do Kubernetes de Pods e volumes anexados por node, não pelo poder de computação; nenhuma criação de sandbox falhou ou travou sob concorrência de até 40, a partir do momento em que o pool de supervisores compartilhado passou a aceitar sandboxes.
Riscos operacionais a documentar: toda mudança de policy interrompe todas as conexões abertas nos sandboxes afetados; os sandboxes não têm limites de recursos por padrão, então um tenant pode degradar outro; e uma execução de teste observou uma deleção que deixou para trás storage que continua sendo cobrado.
Eu carreguei dois nodes até o OpenShell recusar novos sandboxes: 46 com o design padrão, 61 com o supervisor compartilhado. Os sinais vitais ficaram calmos o tempo todo, com memória e CPU quase ociosas; o limite foi o número de Pods e de attachments de volume que cada node permite.
Efeitos colaterais sob estresse: mudanças de policy cortam todas as conexões abertas, vizinhos pesados em disco deixam as escritas no disco compartilhado cerca de trinta e seis vezes mais lentas, e limites de CPU só ajudam com CPU. Prescreva limites por sandbox e agrupe as mudanças de policy em lotes.
Testes de carga são onde um sistema mostra o seu temperamento. Este manteve a compostura: criar quarenta sandboxes de uma vez deixou as coisas mais lentas, mas não quebrou nada, e o control plane respondeu a cerca de duas mil requisições por segundo sem um único erro.
A tensão aparece entre vizinhos. Sem limites, um sandbox ocupado tira de todo mundo ao redor, e uma única edição de policy interrompe todas as conversas em andamento naquele sandbox. Combinar limites e janelas de mudança mantém um cluster compartilhado um lugar tranquilo.
Pense em dois palcos que poderiam receber muitos músicos, até a casa de shows ficar sem camarins e sem vagas de estacionamento. Esse é o teto real aqui: 46 atrações do jeito padrão, 61 com uma equipe técnica compartilhada.
A banda segurou o andamento mesmo quando quarenta atrações chegaram de uma vez. O problema é acústico: um baterista barulhento vaza em todos os microfones vizinhos, e cada vez que o setlist muda, toda música em andamento para no meio do compasso. A solução é velha técnica de palco: dê a cada baterista uma cabine, e mude o setlist entre as músicas.
A história de capacidade é concreta: dois nodes modestos hospedaram 46 sandboxes de agentes isolados na configuração padrão e 61 com o supervisor compartilhado, com a maior parte da CPU e da memória ainda livre. Com tudo configurado corretamente, a criação nunca falhou sob carga, e o control plane lidou com cerca de 2.000 requisições por segundo.
O posicionamento para compradores: planeje a capacidade em Pods e volumes, não em cores; defina limites por sandbox; e trate mudanças de policy como eventos que resetam conexões. Com isso, a plataforma escala de forma previsível.
 Veja o código-fonte aqui: openshell-stress
Visão Geral
O OpenShell, projeto CNCF Sandbox desde 2026-09-26, foi o assunto de cinco posts nesta série: a arquitetura, uma instalação no Amazon EKS, o ciclo de vida de um sandbox, policy e egress e credenciais da AWS. Esta última parte, a 6 de 6, pergunta quanto o mesmo cluster de dois nodes aguenta.
Eu não encontrei números independentes do OpenShell em nodes comuns de Kubernetes para usar como comparação. Os números que a NVIDIA cita são afirmações de hardware para as suas próprias plataformas, que esta série não testa. Então este post mede em vez de conferir: seis testes em dois nodes m7i.2xlarge, sem nada adicionado ao cluster além do Container Insights, cada teste começando com zero sandboxes e deletando o que criou.
A versão curta: nesses nodes, o OpenShell fica sem Kubernetes antes de ficar sem máquina. 46 sandboxes com um Pod de supervisor cada, 61 com o pool de supervisores compartilhado, e os dois parados por limites por node (Pods, depois attachments de volumes EBS) enquanto CPU e memória ficavam quase ociosas. Os creates ficam mais lentos com a concorrência, mas não falham quando a configuração está certa, o gateway processa cerca de 2.000 chamadas de API por segundo, as camadas de policy adicionam uns dois milissegundos por nova conexão, e o que dói é uma edição de policy (ela corta todas as conexões abertas) e um vizinho martelando o disco do node.
Arquitetura
Duas formas de observar, de propósito. O sampler.py lê a summary API do kubelet de cada node a cada 2 segundos e grava em CSV a CPU, a memória, a contagem de Pods, os volumes EBS anexados e o consumo do próprio gateway, ao lado dos resultados dos próprios testes. O Container Insights (só métricas) roda em paralelo, para ver como os mesmos testes aparecem no CloudWatch, que é onde a maioria dos times os acompanharia.
Configuração
O cluster é o da parte 2, sem alterações: dois nodes m7i.2xlarge (8 vCPUs, 32 GiB) em duas zonas de disponibilidade, EKS 1.37, o VPC CNI com enforcement de network policy, OpenShell 0.1.6 com uma réplica do gateway em SQLite. Os sandboxes rodam em runc. O echo server da parte 4 é o destino dentro do cluster para os testes de rede.
Passo 1: Container Insights, só métricas
O 00_container_insights.sh on liga uma variável no Terraform da parte 2 que adiciona o add-on Amazon CloudWatch Observability com a IAM role do seu agente. O plan adicionou três recursos e não alterou mais nada; o add-on roda um Pod cloudwatch-agent por node, que conta para o limite de Pods que acaba sendo decisivo no Teste 1. Ele coleta só métricas, sem envio de logs de container (o Container Insights armazena as próprias métricas como eventos de log de performance no CloudWatch Logs).
Passo 2: Um sampler
O sampler.py lê a summary API do kubelet de cada node (/api/v1/nodes/<node>/proxy/stats/summary) a cada 2 segundos e grava uma linha de CSV por node: CPU, memória, contagem de Pods, Pods não agendados, volumes EBS anexados, NetworkPolicies, e a CPU, a memória e o volume SQLite do próprio Pod do gateway. A maioria dos testes o inicia em background; o charts.py desenha os gráficos deste post a partir dos arquivos de resultado dos testes.
Passo 3: Todo teste a partir do zero
Cada teste verifica que não existe nenhum outro sandbox, cria só sandboxes com nome p6-* e deleta tudo o que criou, incluindo qualquer coisa que o gateway esqueça (mais sobre isso abaixo). Os testes que mudam a configuração do gateway (o pool de supervisores compartilhado, a entrega por push) aplicam um overlay do Helm e, no final, fazem rollback do release para a revisão anterior exata, inclusive com Ctrl-C, e verificam que o gateway.toml renderizado é o mesmo de antes.
uv sync
./00_container_insights.sh on
uv run python 01_density.py --variant dedicated
uv run python 02_create_latency.py --topology dedicated
# ... see the README for the full run order
Testes
Teste 1: Densidade até algo recusar
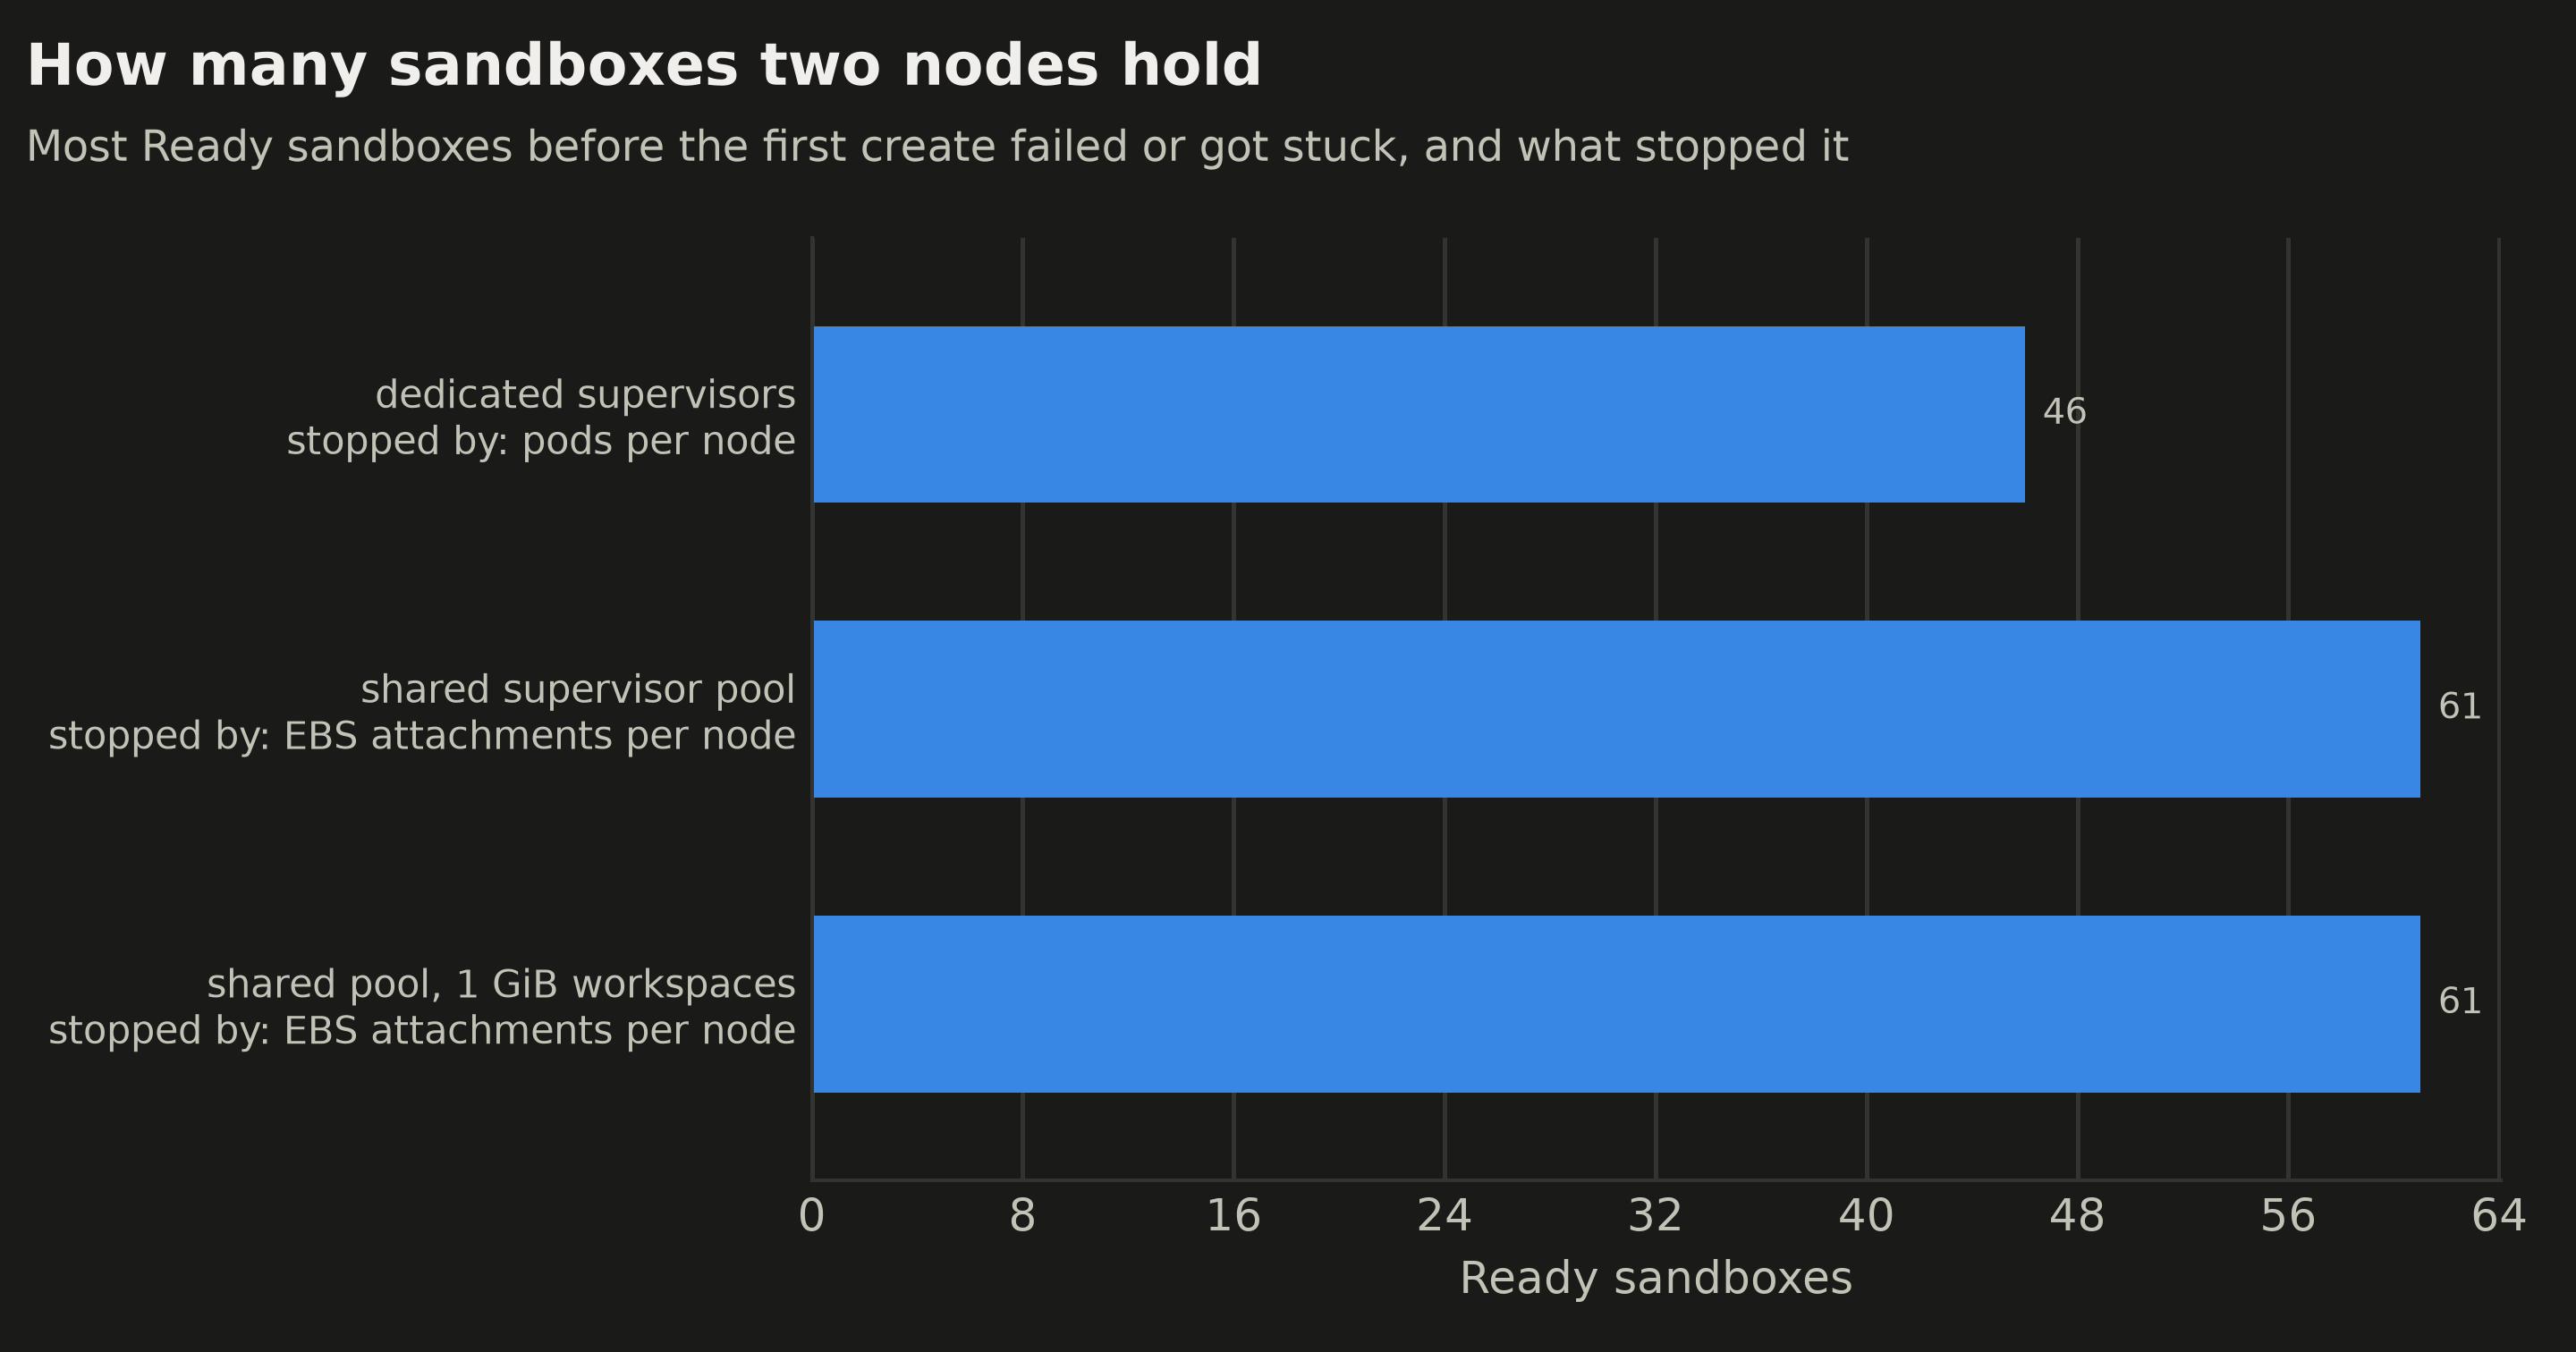
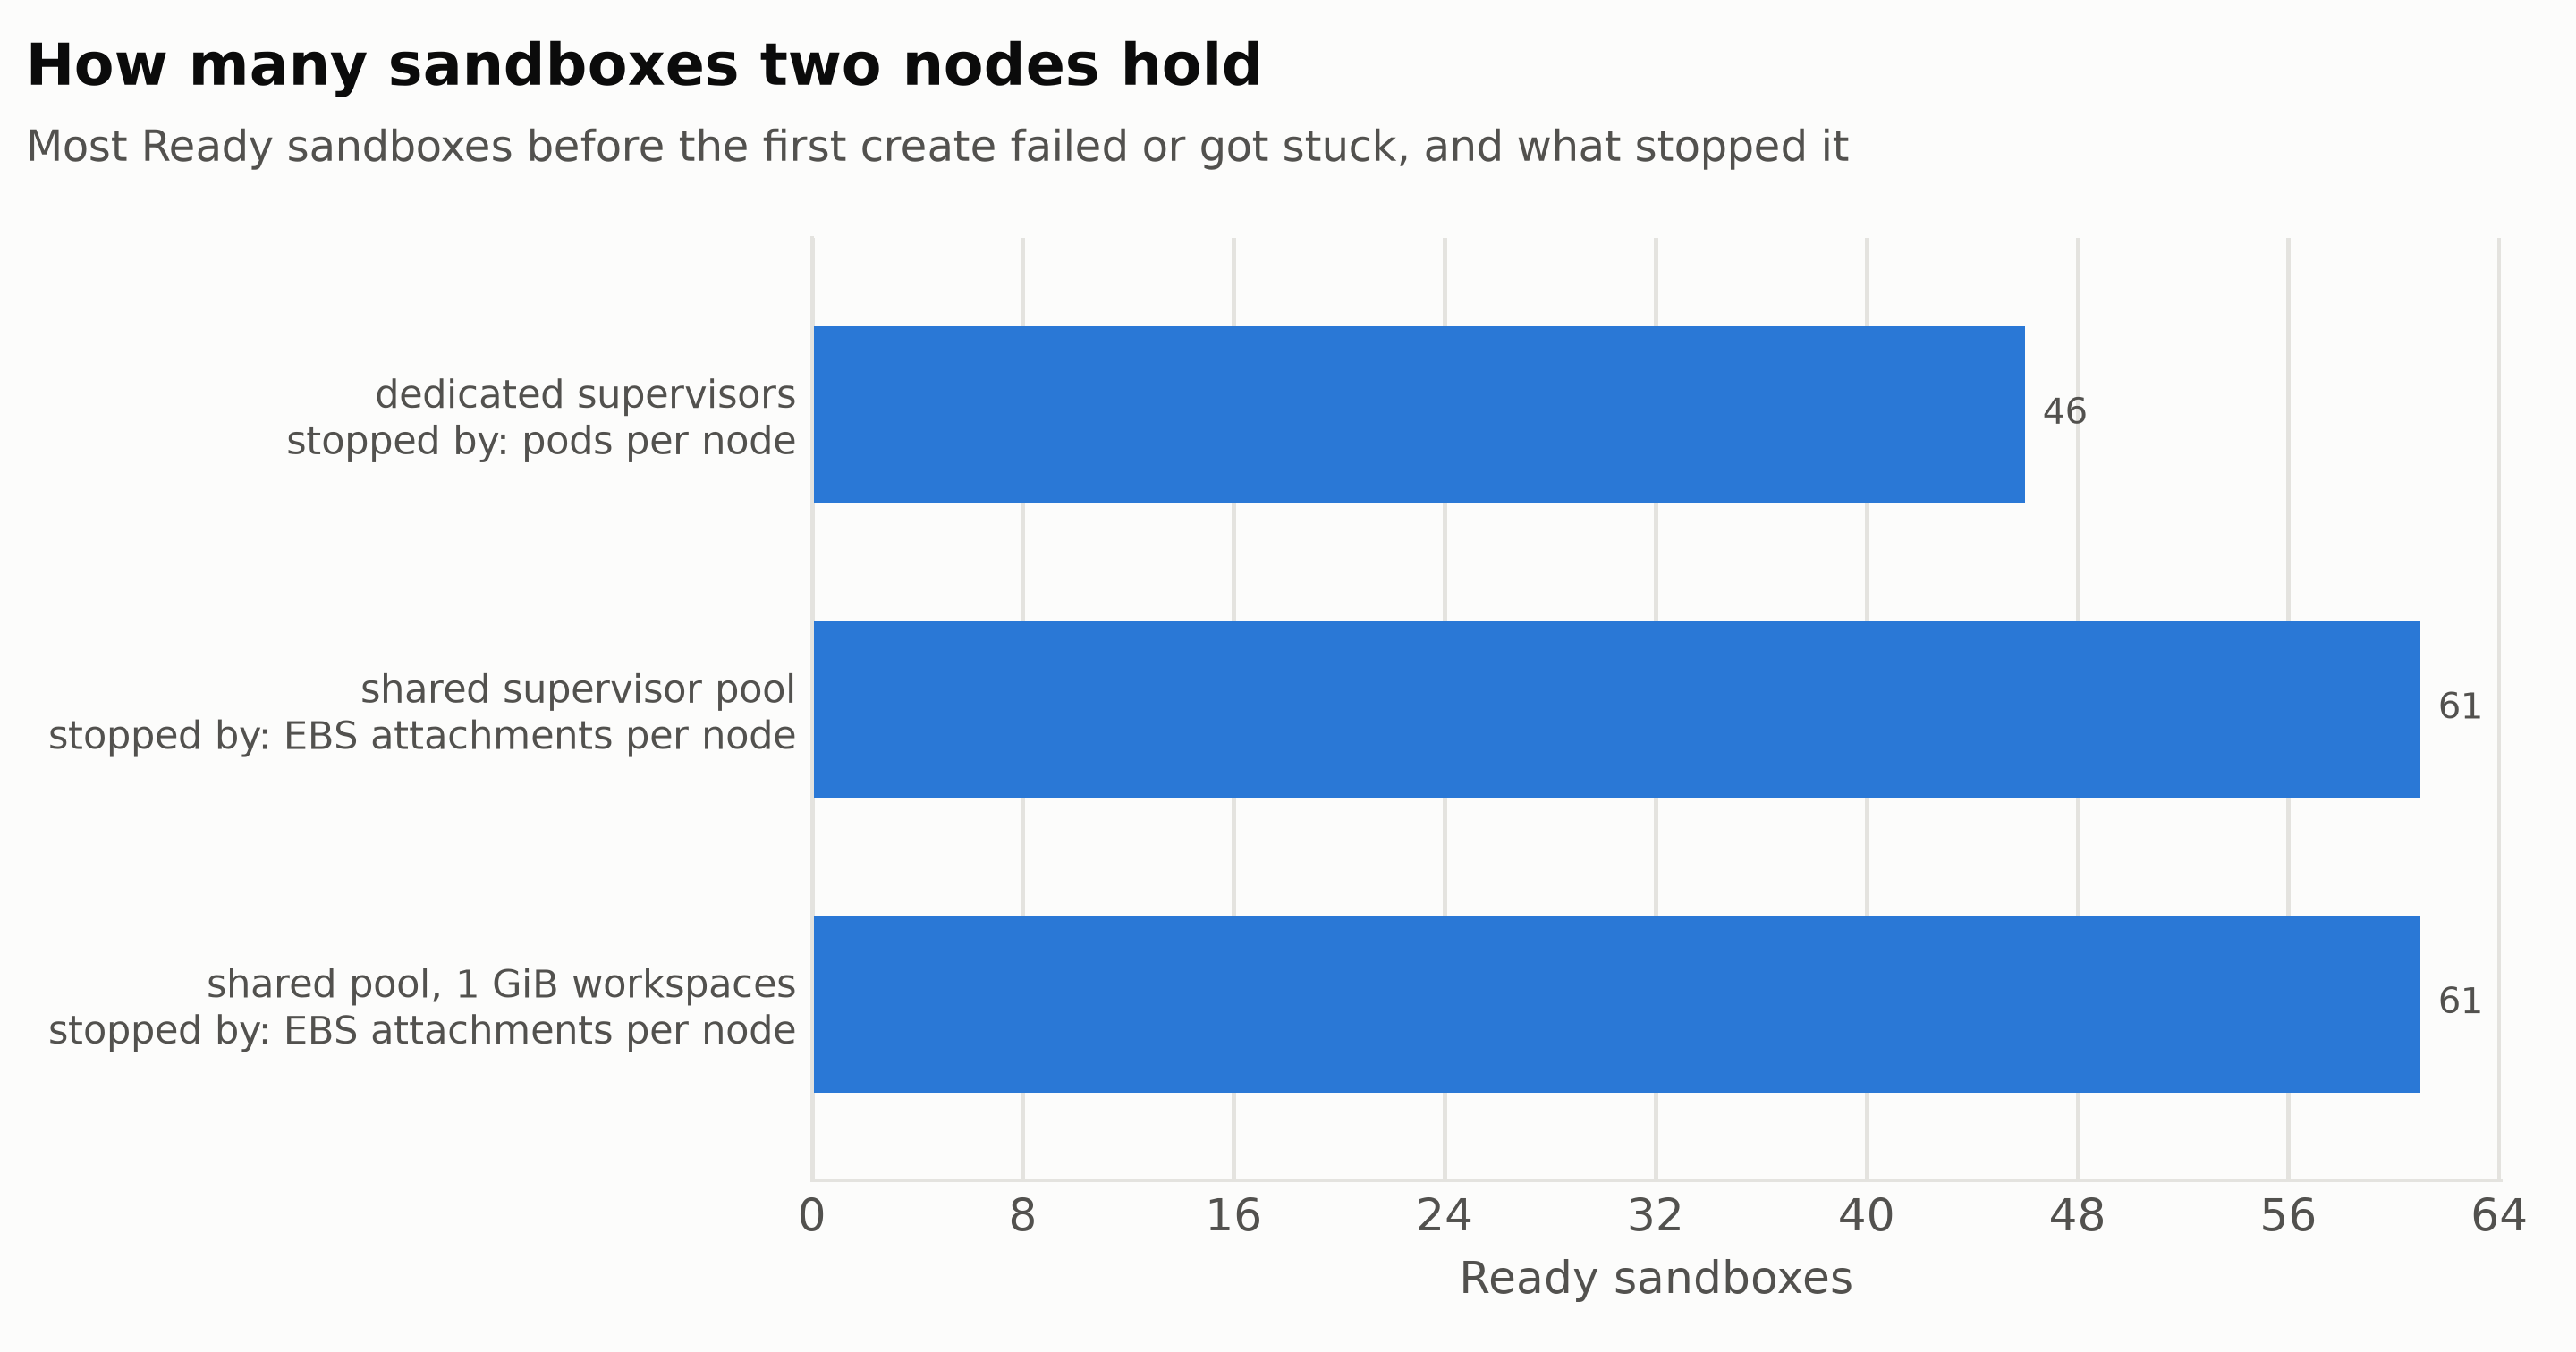
O 01_density.py cria sandboxes em lotes de 10, espera cada um ficar Ready e para no primeiro sandbox que não fica Ready em 240 segundos. Depois ele lê os Pods, os volumes e os eventos dos sandboxes travados para identificar a causa. Três variantes: o padrão (um Pod de supervisor por sandbox), o pool de supervisores compartilhado experimental (supervisor_topology = "gateway": um Deployment de supervisor, um Pod por membro, atendendo todos os sandboxes) e o pool com volumes de workspace de 1 GiB em vez de 2 GiB.
| Variante | Ready | O que o parou | create→Ready por lote (p50) |
|---|---|---|---|
| Supervisores dedicados | 46 | Pods por node: 58 em cada node, “Too many pods” | 14,0 a 17,7 s |
| Pool de supervisores compartilhado | 61 | Attachments de EBS: 31 por node (CSINode) | 9,8 a 15,0 s |
| Pool compartilhado, workspaces de 1 GiB | 61 | Attachments de EBS | 8,7 a 16,3 s |
Com um Pod de supervisor por sandbox, cada sandbox custa dois Pods, e uma m7i.2xlarge no VPC CNI permite 58 Pods. Os nodes já rodavam 22 no total (Pods de sistema, o gateway, o agente do CloudWatch), então quando os dois nodes chegaram a 58 Pods, quatro sandboxes do quinto lote não conseguiram ter todos os seus Pods agendados (“0/2 nodes are available: 2 Too many pods”); dois dos Pods de supervisor deles ocuparam os últimos slots livres, e é por isso que a contagem é 46 e não 47. O pool compartilhado corta os Pods pela metade, e o próximo limite é o volume EBS de que o workspace de cada sandbox precisa: 31 attachments por node (o limite de attachments EBS da instância depois do volume raiz, conforme o objeto CSINode do node reporta), um deles já usado pelo próprio volume do gateway. Volumes menores não ajudam, já que o limite conta volumes, não gigabytes.
CPU e memória não chegaram perto de um limite. Com 46 sandboxes, cada node usava menos de 2,8 GiB dos seus 32 GiB e menos de 0,9 dos seus 8 cores; os Pods dos sandboxes juntos ocupavam cerca de 780 MiB por node, aproximadamente 33 MiB por par ocioso de sandbox e supervisor. Dois nodes m7i.2xlarge são dimensionados para muito mais do que 46 sandboxes ociosos; o que acaba são os slots de Pod e os attachments de volume. O prefix delegation do VPC CNI aumenta o limite de Pods; o limite de volumes continua enquanto cada sandbox receber o seu próprio volume de workspace, que é o padrão (a configuração do driver pode montar um volume diferente em /sandbox, o que eu não testei).
O pool compartilhado exigiu cuidado. As primeiras execuções falharam em todos os creates com “the shared supervisor has no capacity for another sandbox instance”, porque o teste começava assim que o rollout do Deployment do pool terminava. O gateway só aloca sandboxes depois que os membros do pool se conectaram. Agora o harness cria um sandbox canary a cada 10 segundos até que um seja aceito; incluindo o create e o delete do próprio canary, esse passo levou de 49 a 110 segundos.
Teste 2: Latência de create sob concorrência
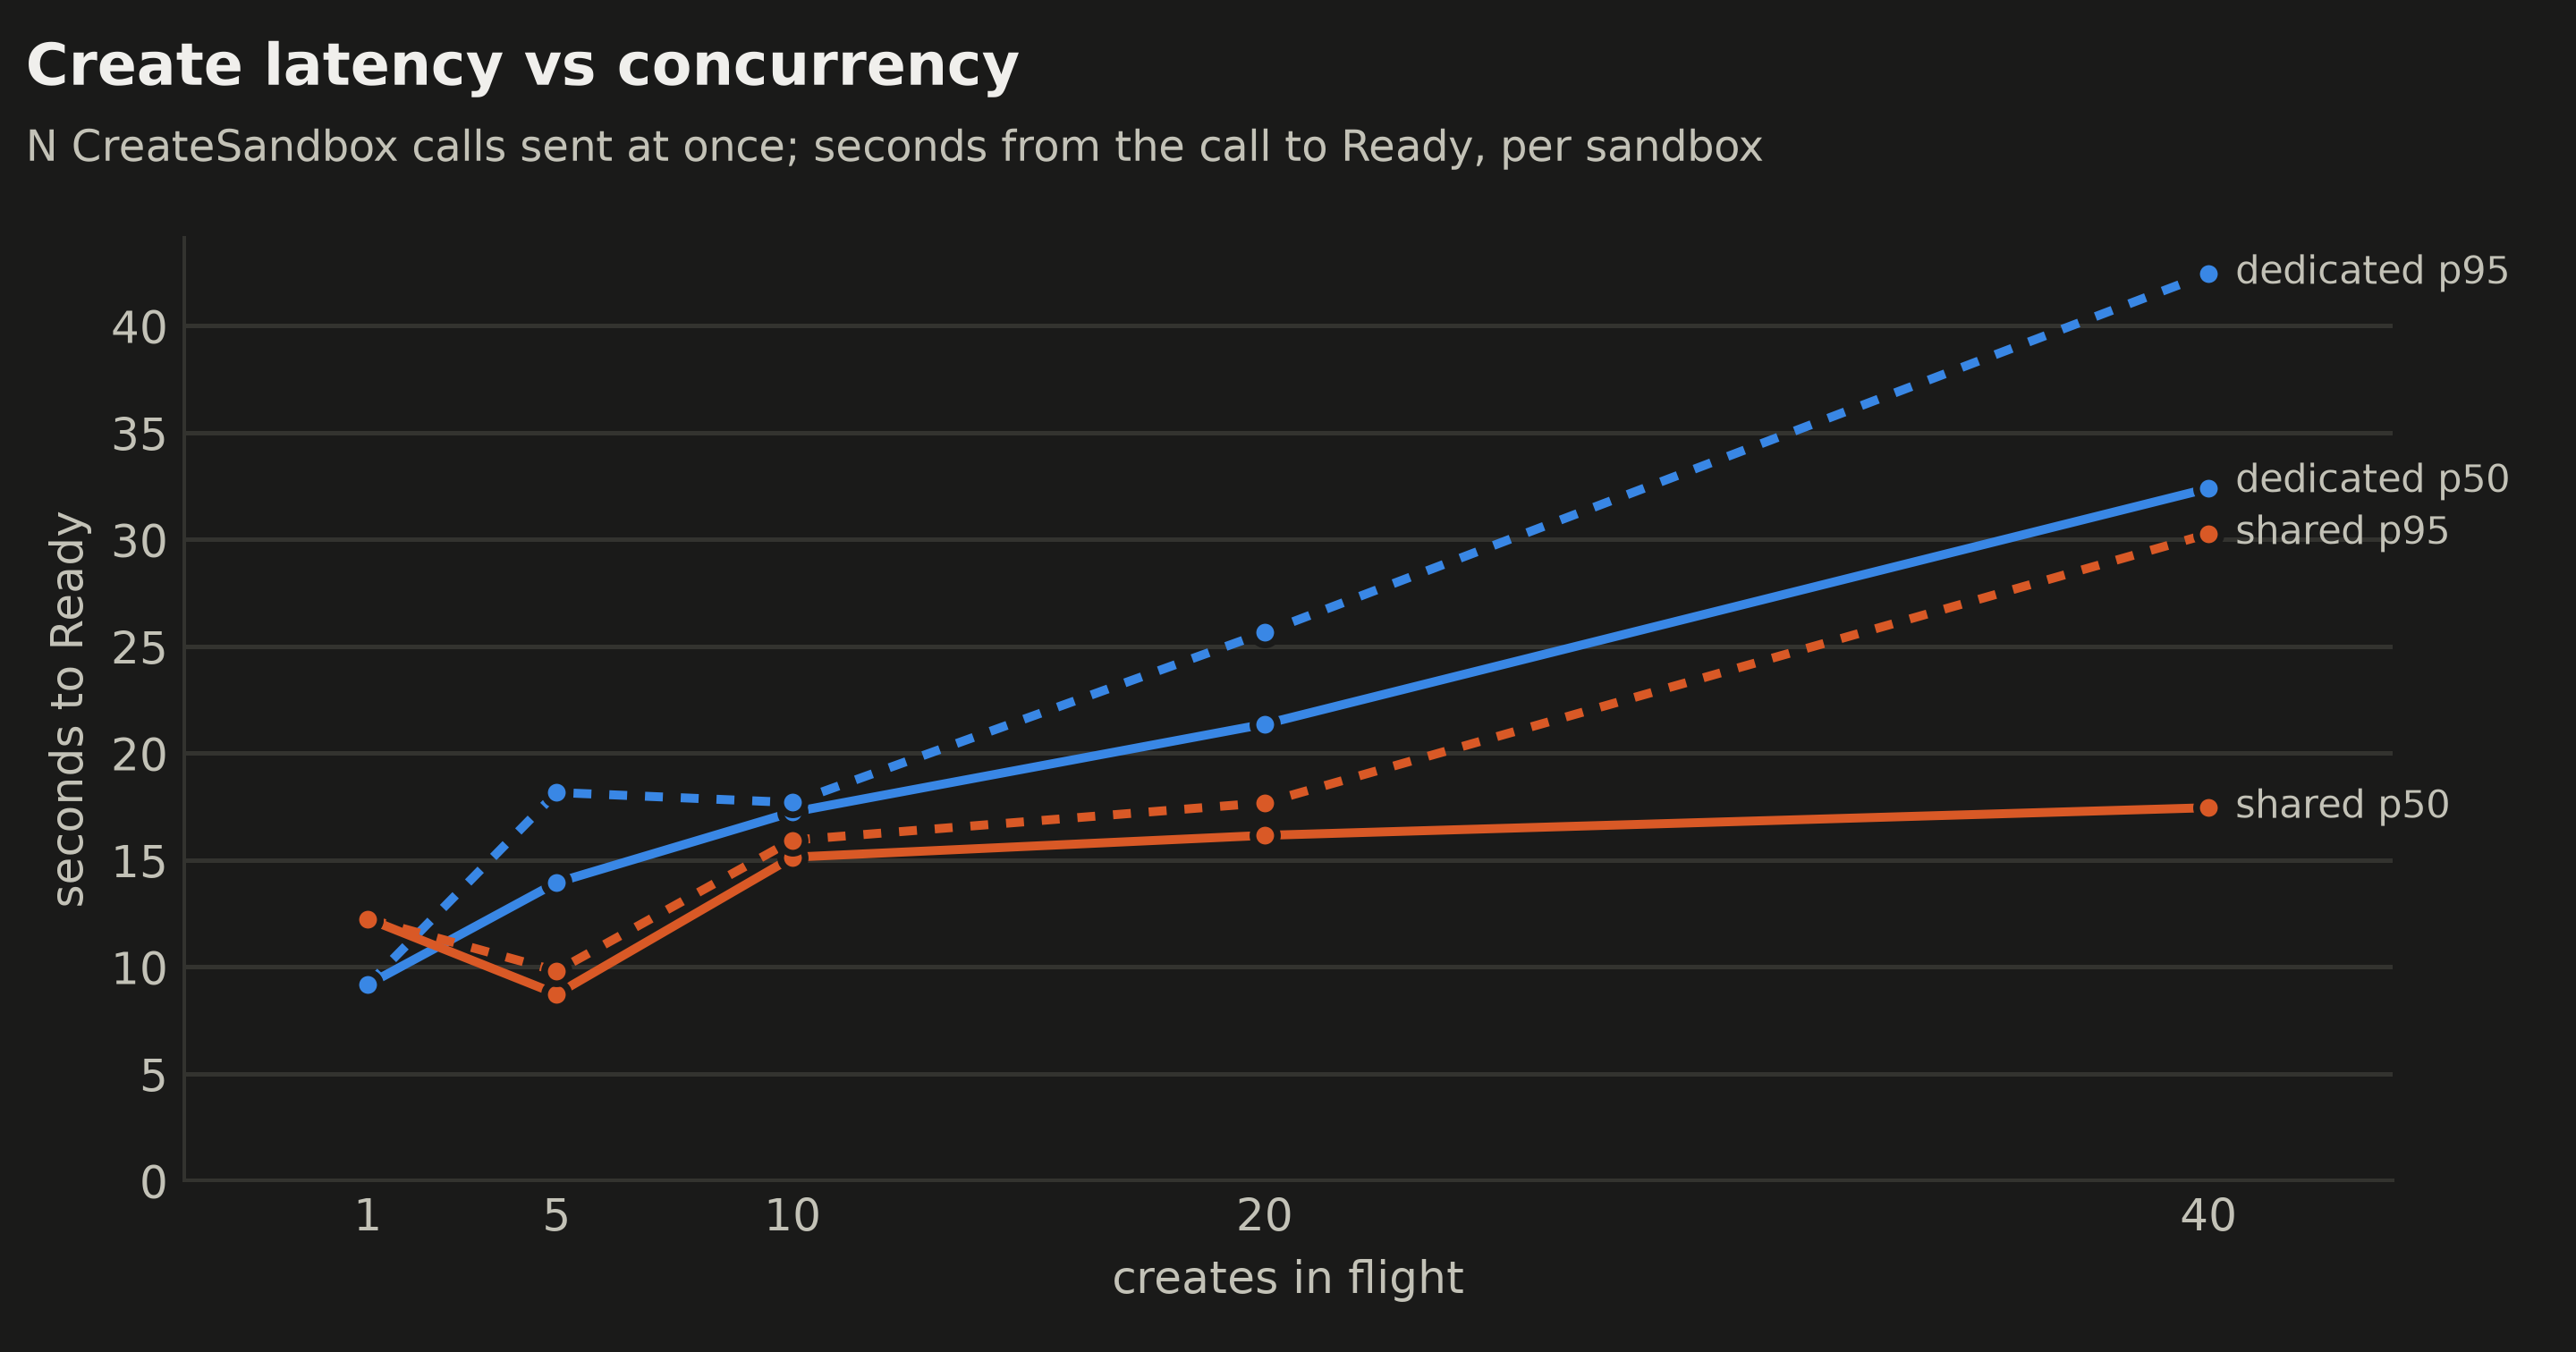
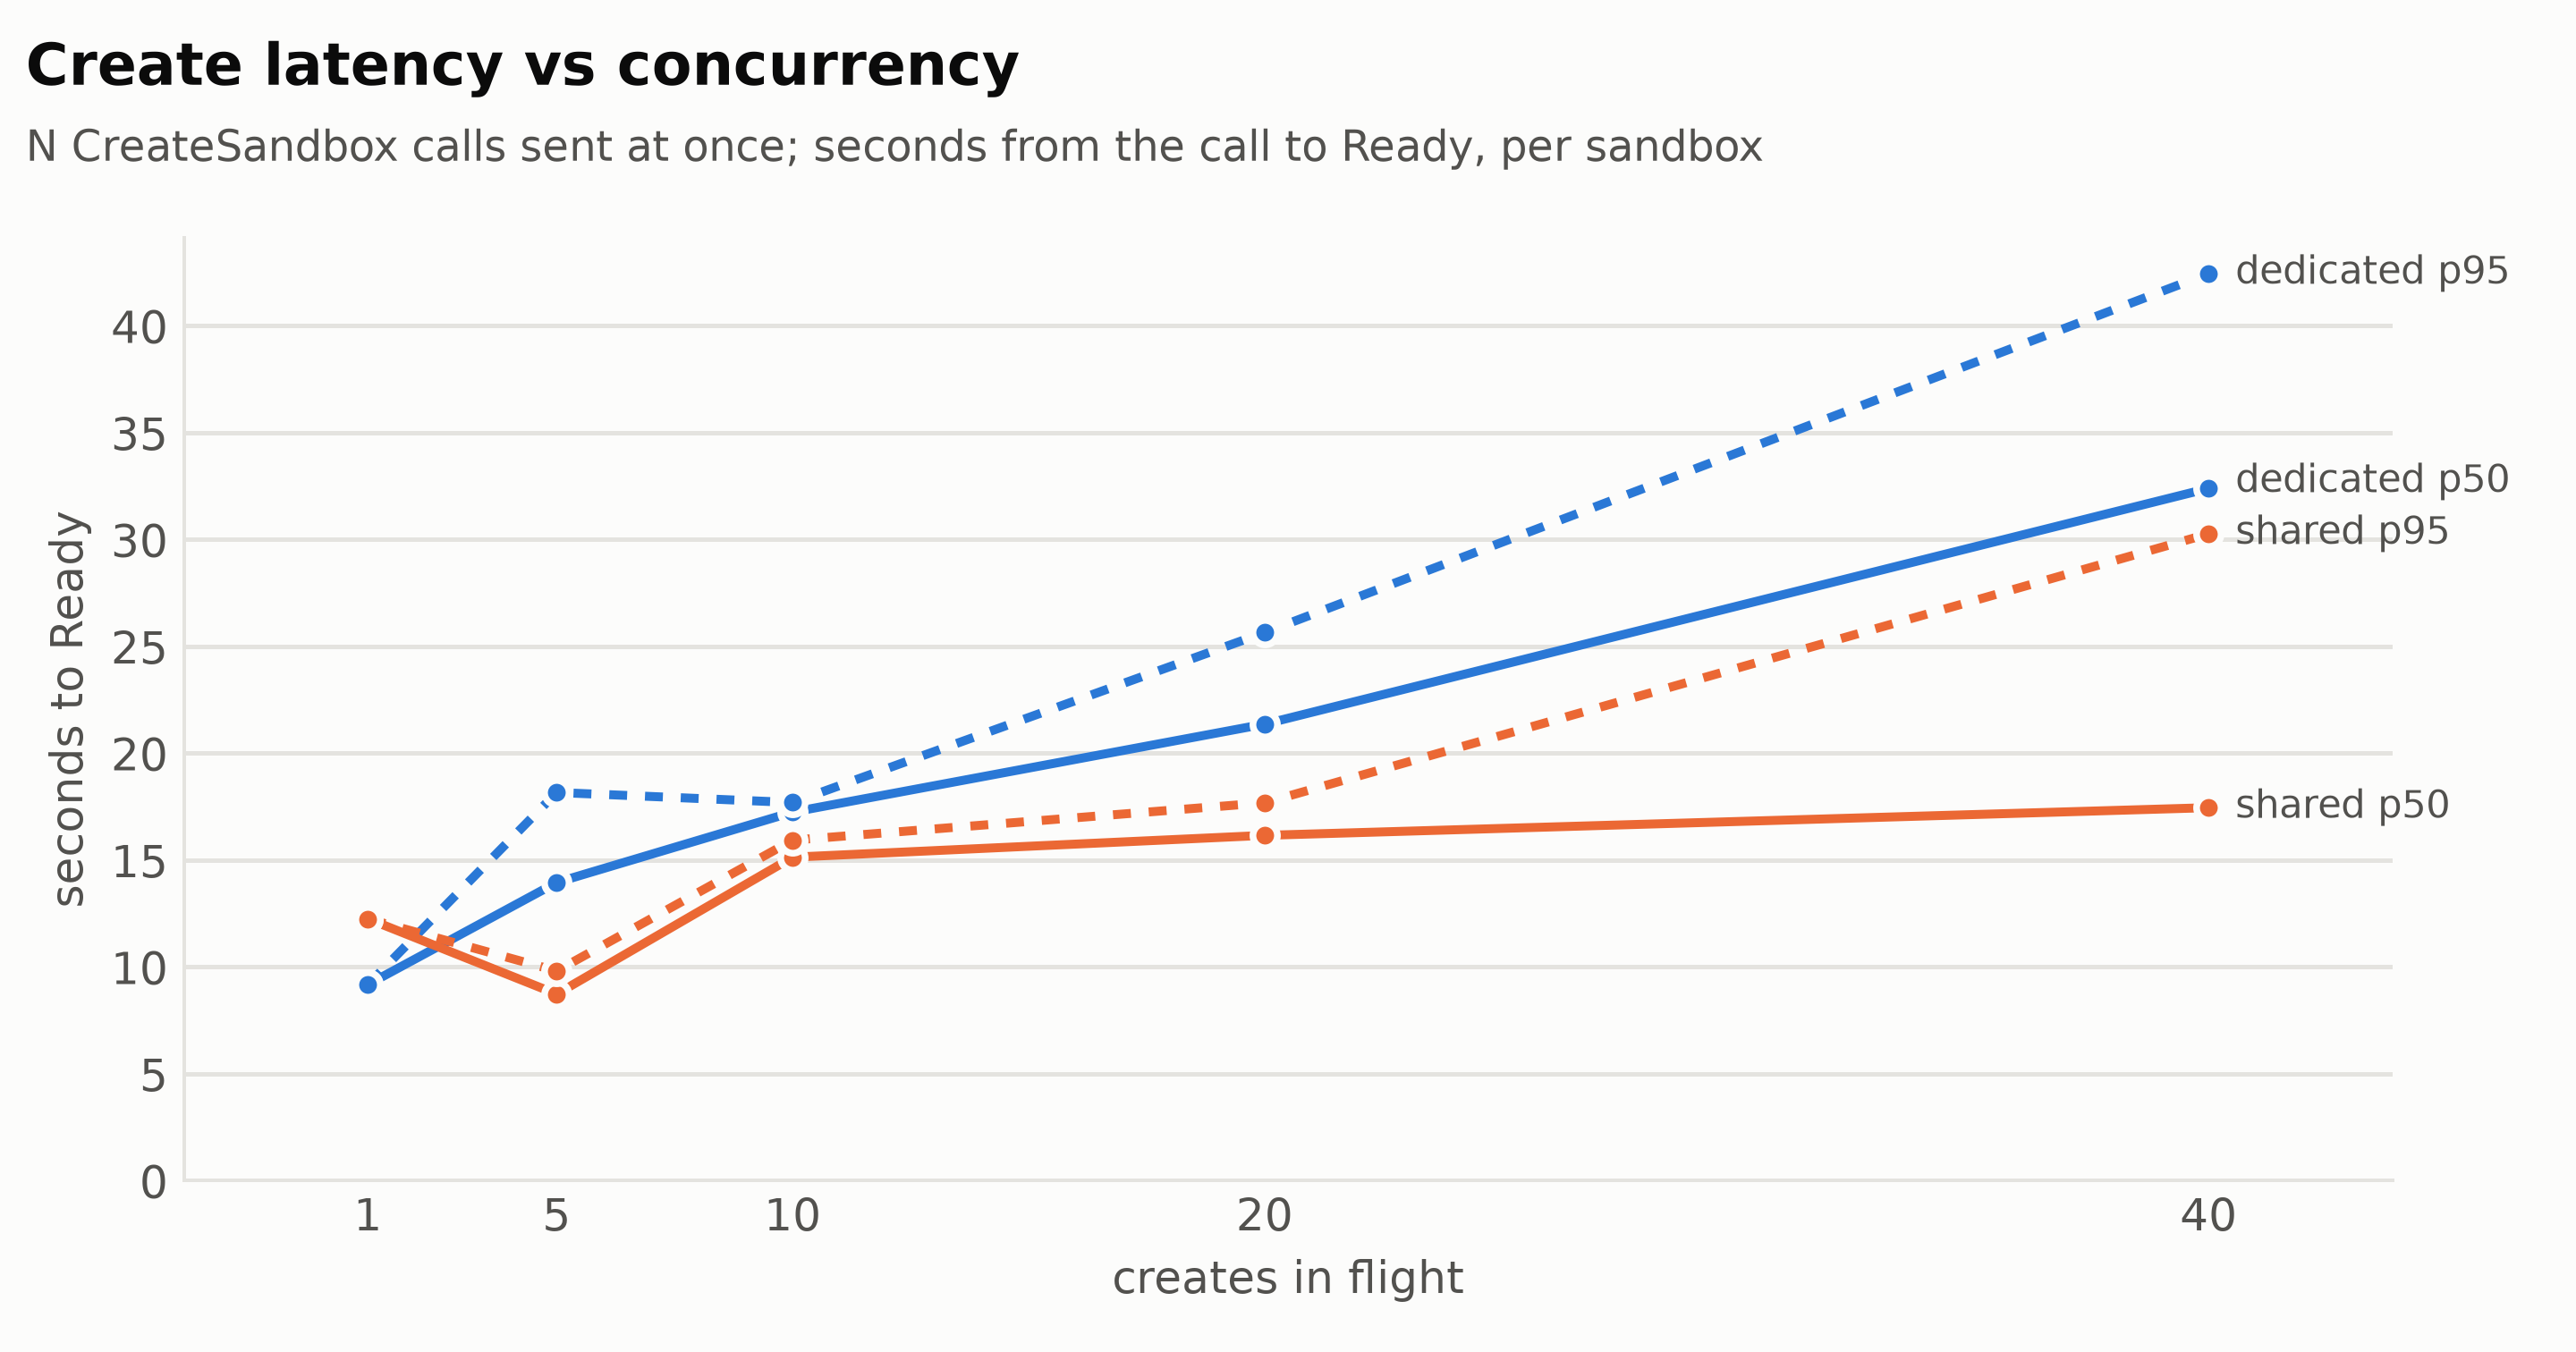
O 02_create_latency.py envia 1, 5, 10, 20 e 40 chamadas CreateSandbox de uma vez e cronometra cada sandbox da chamada até Ready.
| Creates de uma vez | Dedicados p50 / p95 | Pool compartilhado p50 / p95 | Chamada CreateSandbox p50, dedicados / compartilhado |
|---|---|---|---|
| 1 | 9,2 / 9,2 s | 12,3 / 12,3 s | 0,47 / 0,30 s |
| 5 | 14,0 / 18,2 s | 8,7 / 9,8 s | 1,91 / 0,43 s |
| 10 | 17,2 / 17,7 s | 15,1 / 15,9 s | 3,52 / 0,49 s |
| 20 | 21,4 / 25,7 s | 16,2 / 17,7 s | 4,31 / 0,70 s |
| 40 | 32,4 / 42,4 s | 17,5 / 30,3 s | 7,27 / 0,96 s |
Todos os sandboxes chegaram a Ready, nenhum travou e nenhum dos creates falhou (os números do pool compartilhado são de execuções depois que o pool passou a aceitar sandboxes). O lock de mutação do gateway não foi o gargalo (espera média abaixo de 2 ms em todos os níveis). O que cresce é a própria chamada CreateSandbox com supervisores dedicados, de meio segundo para mais de 7 segundos com 40 em andamento, provavelmente porque cada create também precisa configurar um Pod de supervisor com os seus Secrets e Services. Com o pool compartilhado não há Pod de supervisor para criar, e a mediana para 40 de uma vez (17,5 s) ficou próxima da mediana para 10 (15,1 s), embora o p95 tenha dobrado.
Deletar é a direção lenta nos dois casos: cerca de 31 segundos por sandbox, como na parte 2, e 98 segundos (dedicados) ou 94 segundos (compartilhado) para 40 de uma vez, 16 em paralelo. Em uma das execuções de smoke test do harness, um delete enviado cerca de um segundo depois de um sandbox ficar Ready retornou em 26 ms e o gateway esqueceu o sandbox, enquanto os seus objetos do Kubernetes e o seu volume EBS ficaram para trás; agora os scripts verificam isso e fazem a limpeza pelo Kubernetes. Não vi isso de novo nas execuções registradas.
Teste 3: Propagação de policy
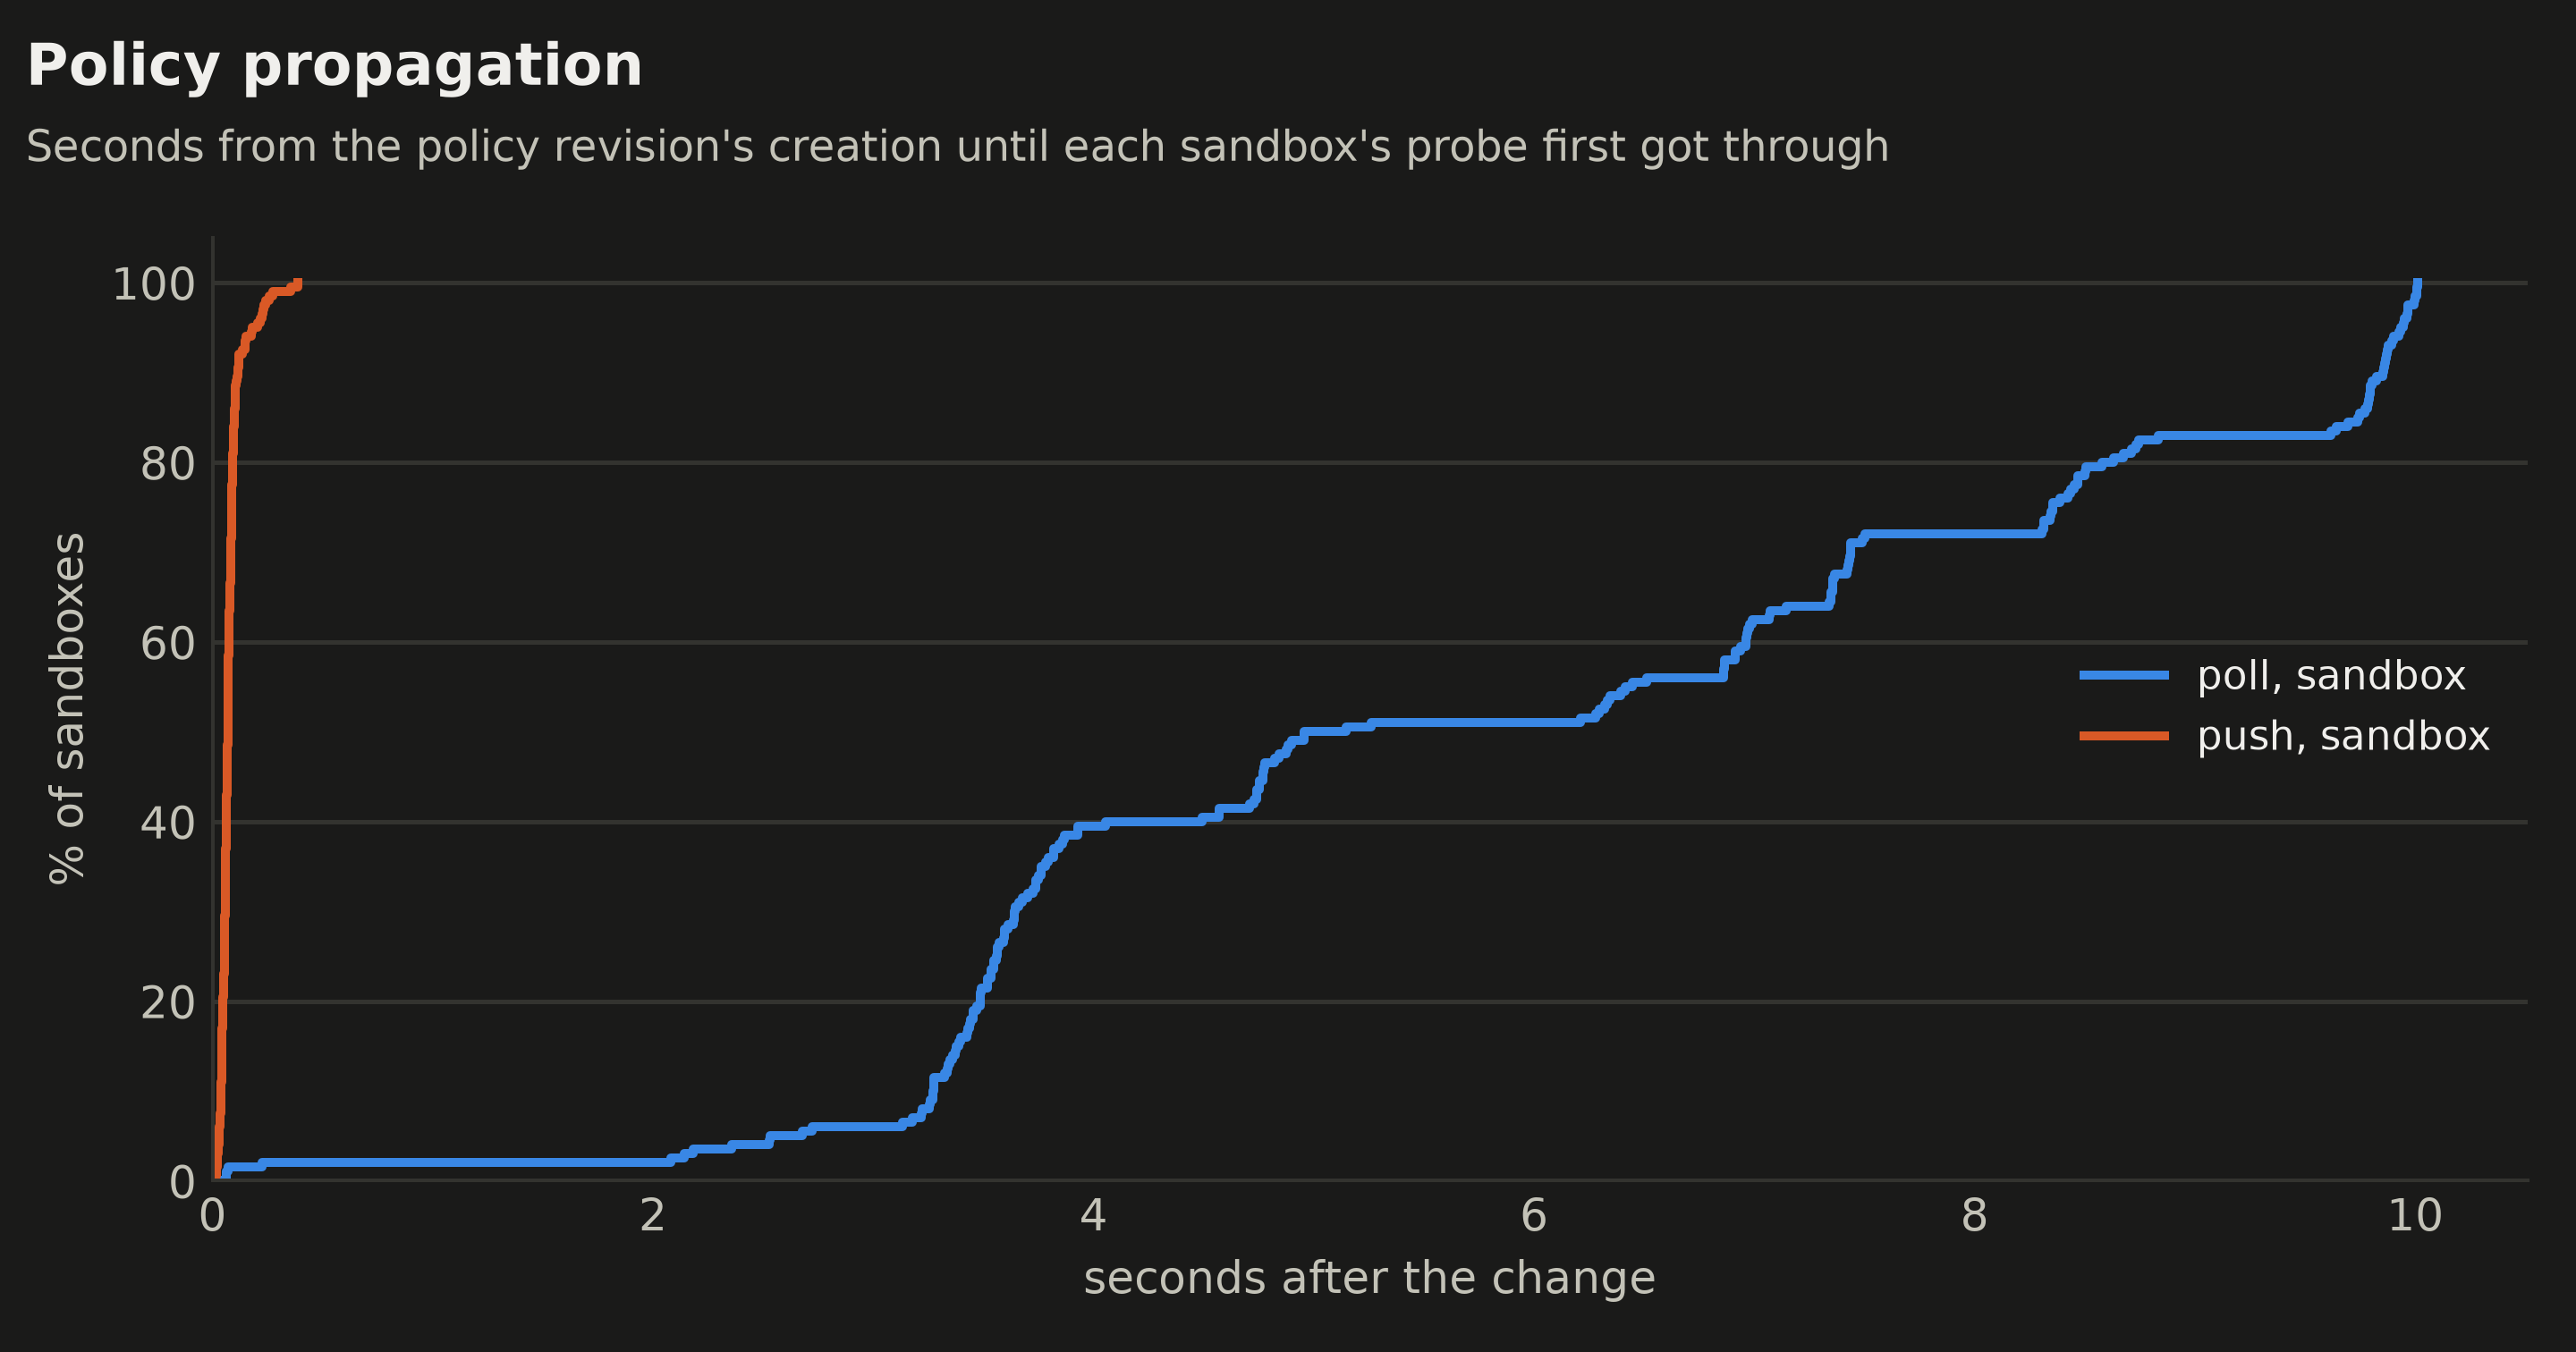
O 03_policy_propagation.py inicia 20 sandboxes, cada um com um probe que tenta o echo server a cada 50 ms e um download em streaming de 90 segundos. Uma mudança de policy libera o echo server; uma segunda mudança, não relacionada, cria uma nova revisão da policy. Dez repetições, com a entrega padrão por poll e com push.
| Entrega | Liberado após (p50 / p95 / máx., 200 pares sandbox-mudança) | Streams abertos cortados pela mudança não relacionada |
|---|---|---|
| Poll (padrão) | 4,96 / 9,93 / 10,01 s | 200 de 200 |
| Push | 0,07 / 0,18 / 0,39 s | 200 de 200 |
Com polling, uma mudança chegava em qualquer ponto do intervalo de 10 segundos, na maioria das vezes depois dos 3 primeiros segundos; o push foi praticamente imediato. A parte 4 mediu de 7,9 a 12,5 segundos com polling e 1,3 segundo com push, mas cronometrava desde a chamada da CLI através de round trips repetidos de sandbox exec; os probes aqui rodam dentro do sandbox a cada 50 ms, então cronometram só a entrega. O que não muda é o custo: toda nova revisão de policy cortou todos os streams abertos no sandbox que ela alcançou, incluindo uma mudança que não tinha nada a ver com eles. A parte 4 mostrou isso para um sandbox. Aqui cada uma das 20 edições por sandbox cortou o download do seu sandbox; uma mudança de policy no gateway inteiro, que eu não executei, alcançaria todos os sandboxes de uma vez.
Uma coisa deu errado na limpeza da execução com poll: um delete recebeu “storage is (re)initializing” (HTTP 429) da API do Kubernetes, e aquele sandbox só foi removido em uma passada de limpeza posterior. O CloudWatch mostra 8 respostas 5xx do API server durante o mesmo teste.
Teste 4: Quanto custa cada camada de policy
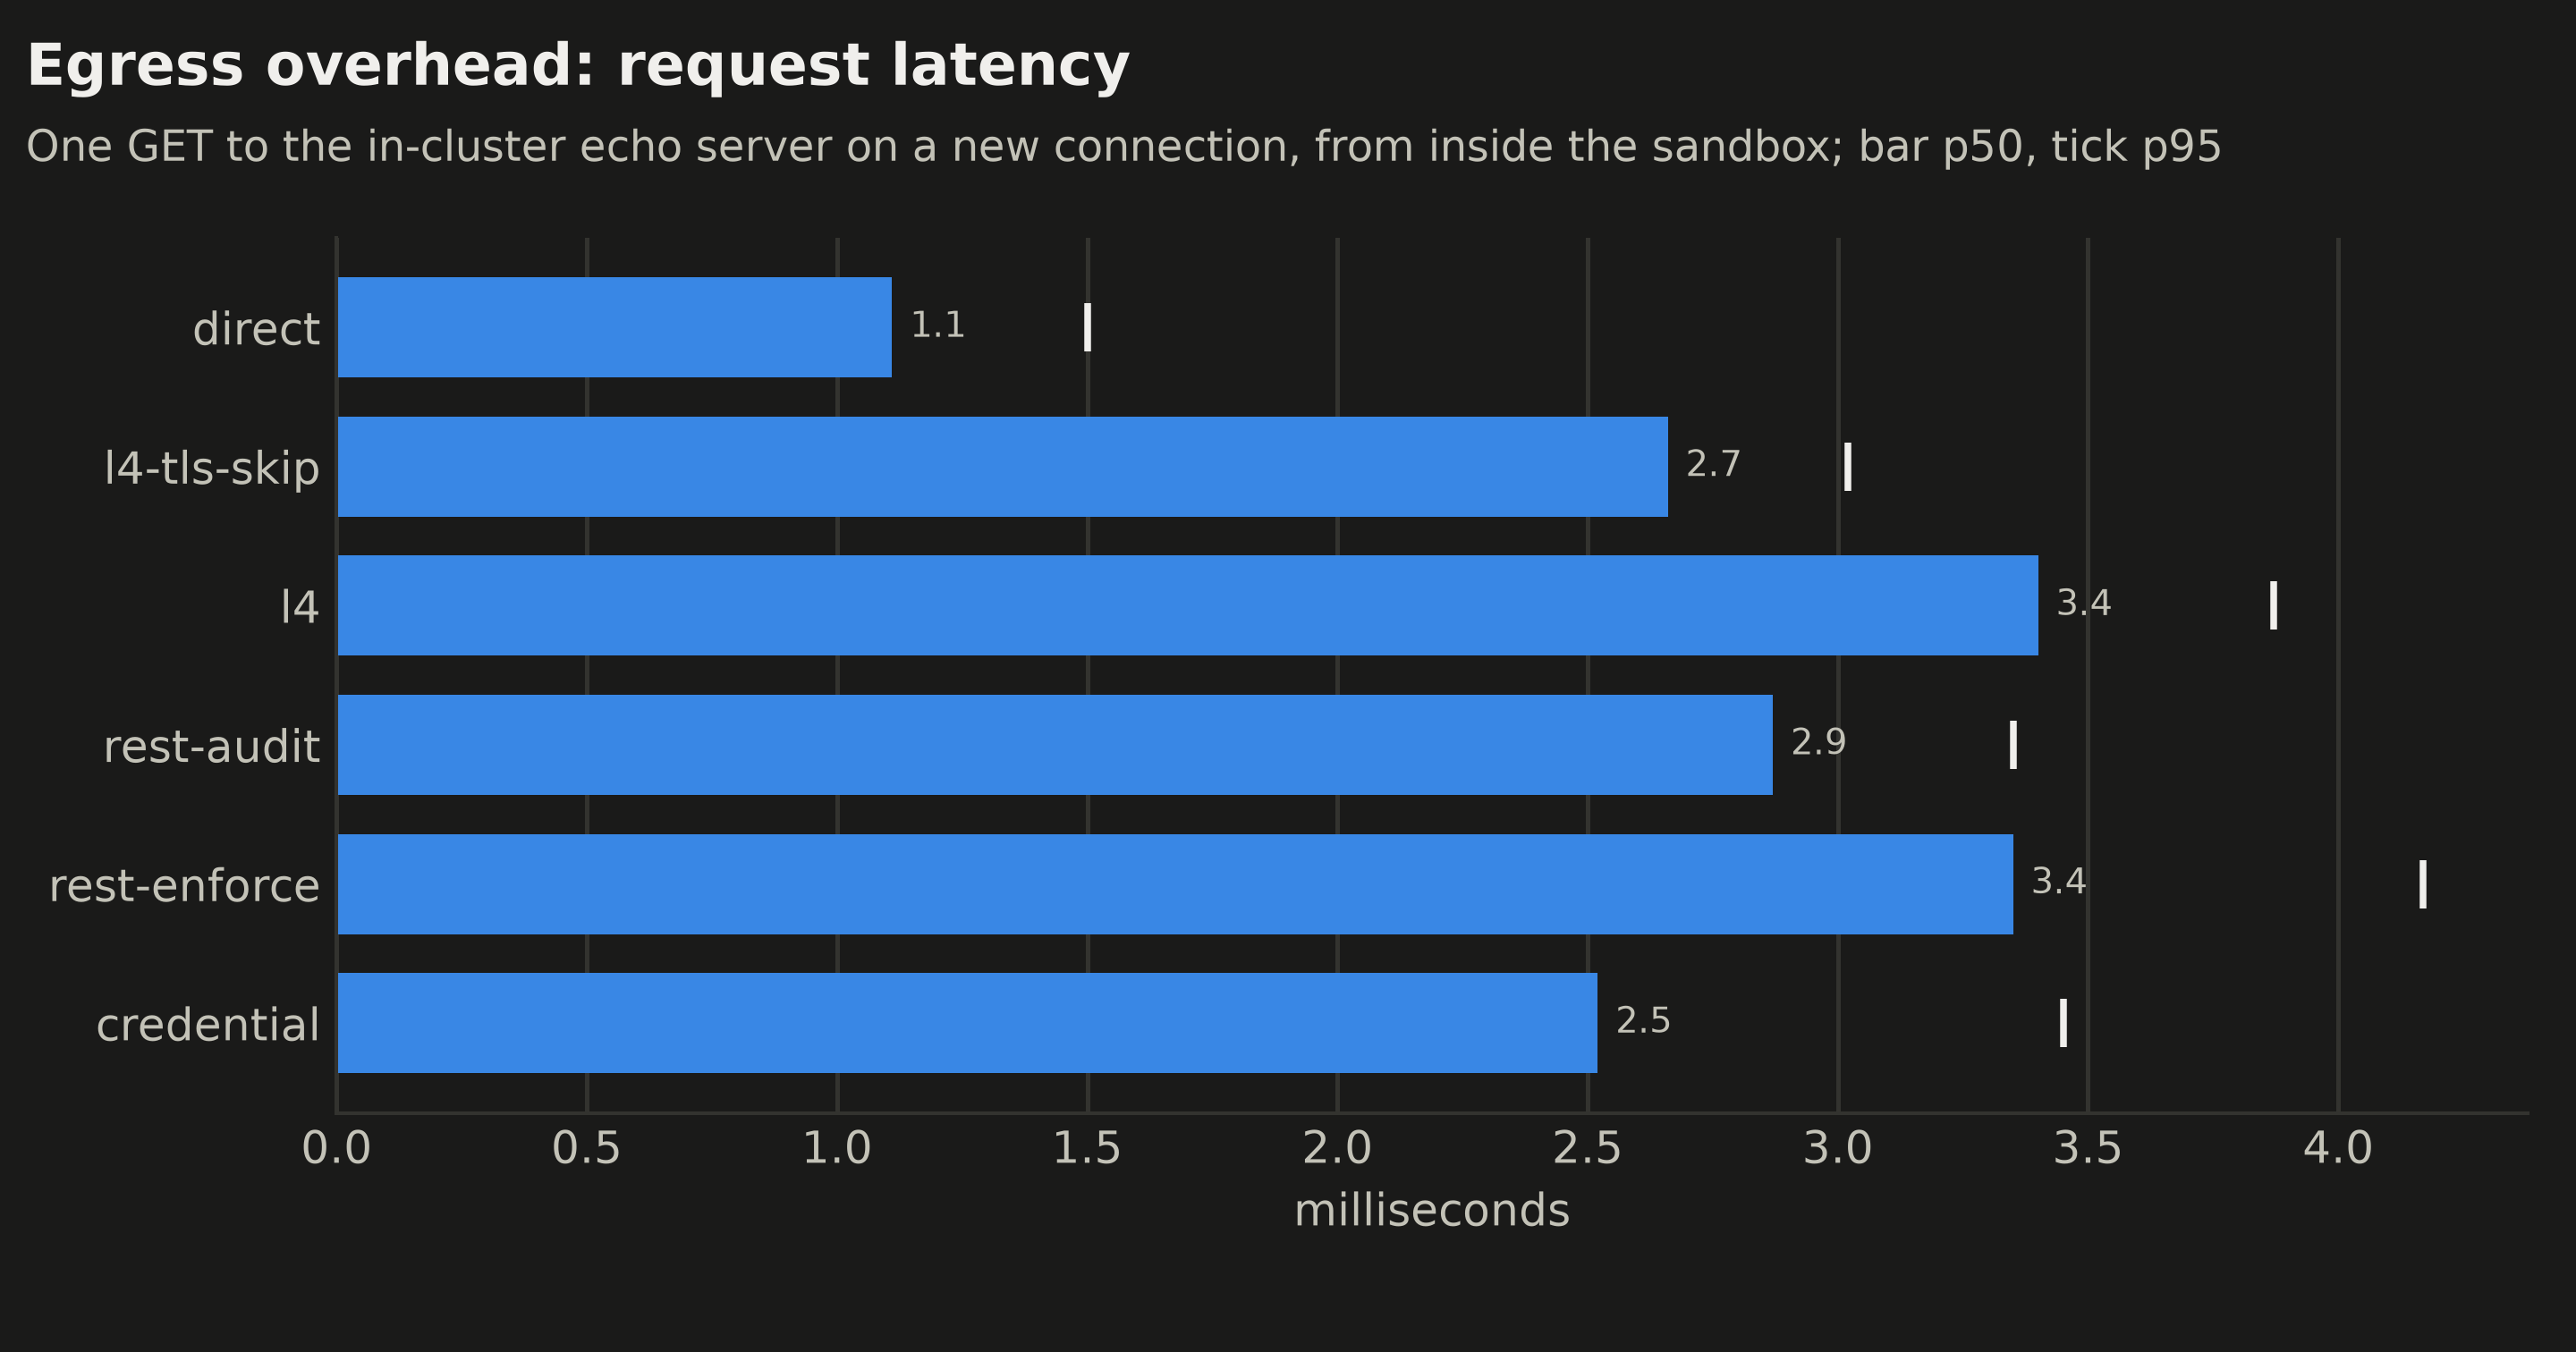
O 04_egress_ladder.py roda o mesmo benchmark a partir de um sandbox com cada vez mais trabalho de policy: L4 com tls: skip (o supervisor repassa os bytes sem olhar para eles), L4 (sem regras de requisição, mas o supervisor verifica o host e o path de cada requisição HTTP), uma regra REST em modo audit, uma regra REST em modo enforce e uma credencial substituída. A linha de base é um Pod simples no mesmo node. O echo server, o workload e o seu supervisor ficaram todos em um node; a variante com o supervisor no outro node nunca rodou, porque o scheduler colocou o supervisor ao lado do workload em 10 de 10 tentativas.
| Degrau | Nova conexão p50 / p95 | Upload |
|---|---|---|
| Direto (um Pod simples) | 1,11 / 1,50 ms | n/d |
L4, tls: skip | 2,66 / 3,02 ms | 172 MiB/s |
| L4 | 3,40 / 3,87 ms | 178 MiB/s |
| REST, audit | 2,87 / 3,35 ms | 164 MiB/s |
| REST, enforce | 3,35 / 4,17 ms | 169 MiB/s |
| Credencial substituída | 2,52 / 3,45 ms | 101 MiB/s |
Passar pelo OpenShell adiciona cerca de 1,4 a 2,3 ms a uma nova conexão para um serviço dentro do cluster: o runtime intercepta o connect, o Sandbox Protocol o leva até o supervisor, e o supervisor abre a conexão. Cada degrau rodou uma vez, e as diferenças entre eles são pequenas o bastante para que eu não tire delas uma ordem. Os uploads rodaram entre 160 e 180 MiB/s, exceto com uma credencial substituída, a 101 MiB/s. Não tenho números de throughput para a linha de base direta: todos os seus uploads e cerca de metade da sua execução de requisições por segundo falharam com um OSError no meu harness, então esses números ficaram de fora, e as execuções de throughput de L4 e de REST-enforce tiveram 8 timeouts cada, então eu também não compararia requisições por segundo entre os degraus.
Contra um endpoint da AWS sobre HTTPS, com keep-alive, o p50 foi de 3,06 ms direto para 3,27 ms com tls: skip, 3,35 ms com TLS terminado e 3,57 ms com uma regra REST em modo enforce: a terminação e a inspeção de TLS custam uma fração de milissegundo por requisição depois que a conexão está aberta. Novas conexões HTTPS custam mais, 7,2 ms direto contra 9,6 a 10,2 ms pelo OpenShell.
Deixei de fora um degrau com assinatura SigV4, então esta escada não mede quanto a assinatura custa; a parte 5 cobre o que ela faz.
Teste 5: O gateway sob carga de API
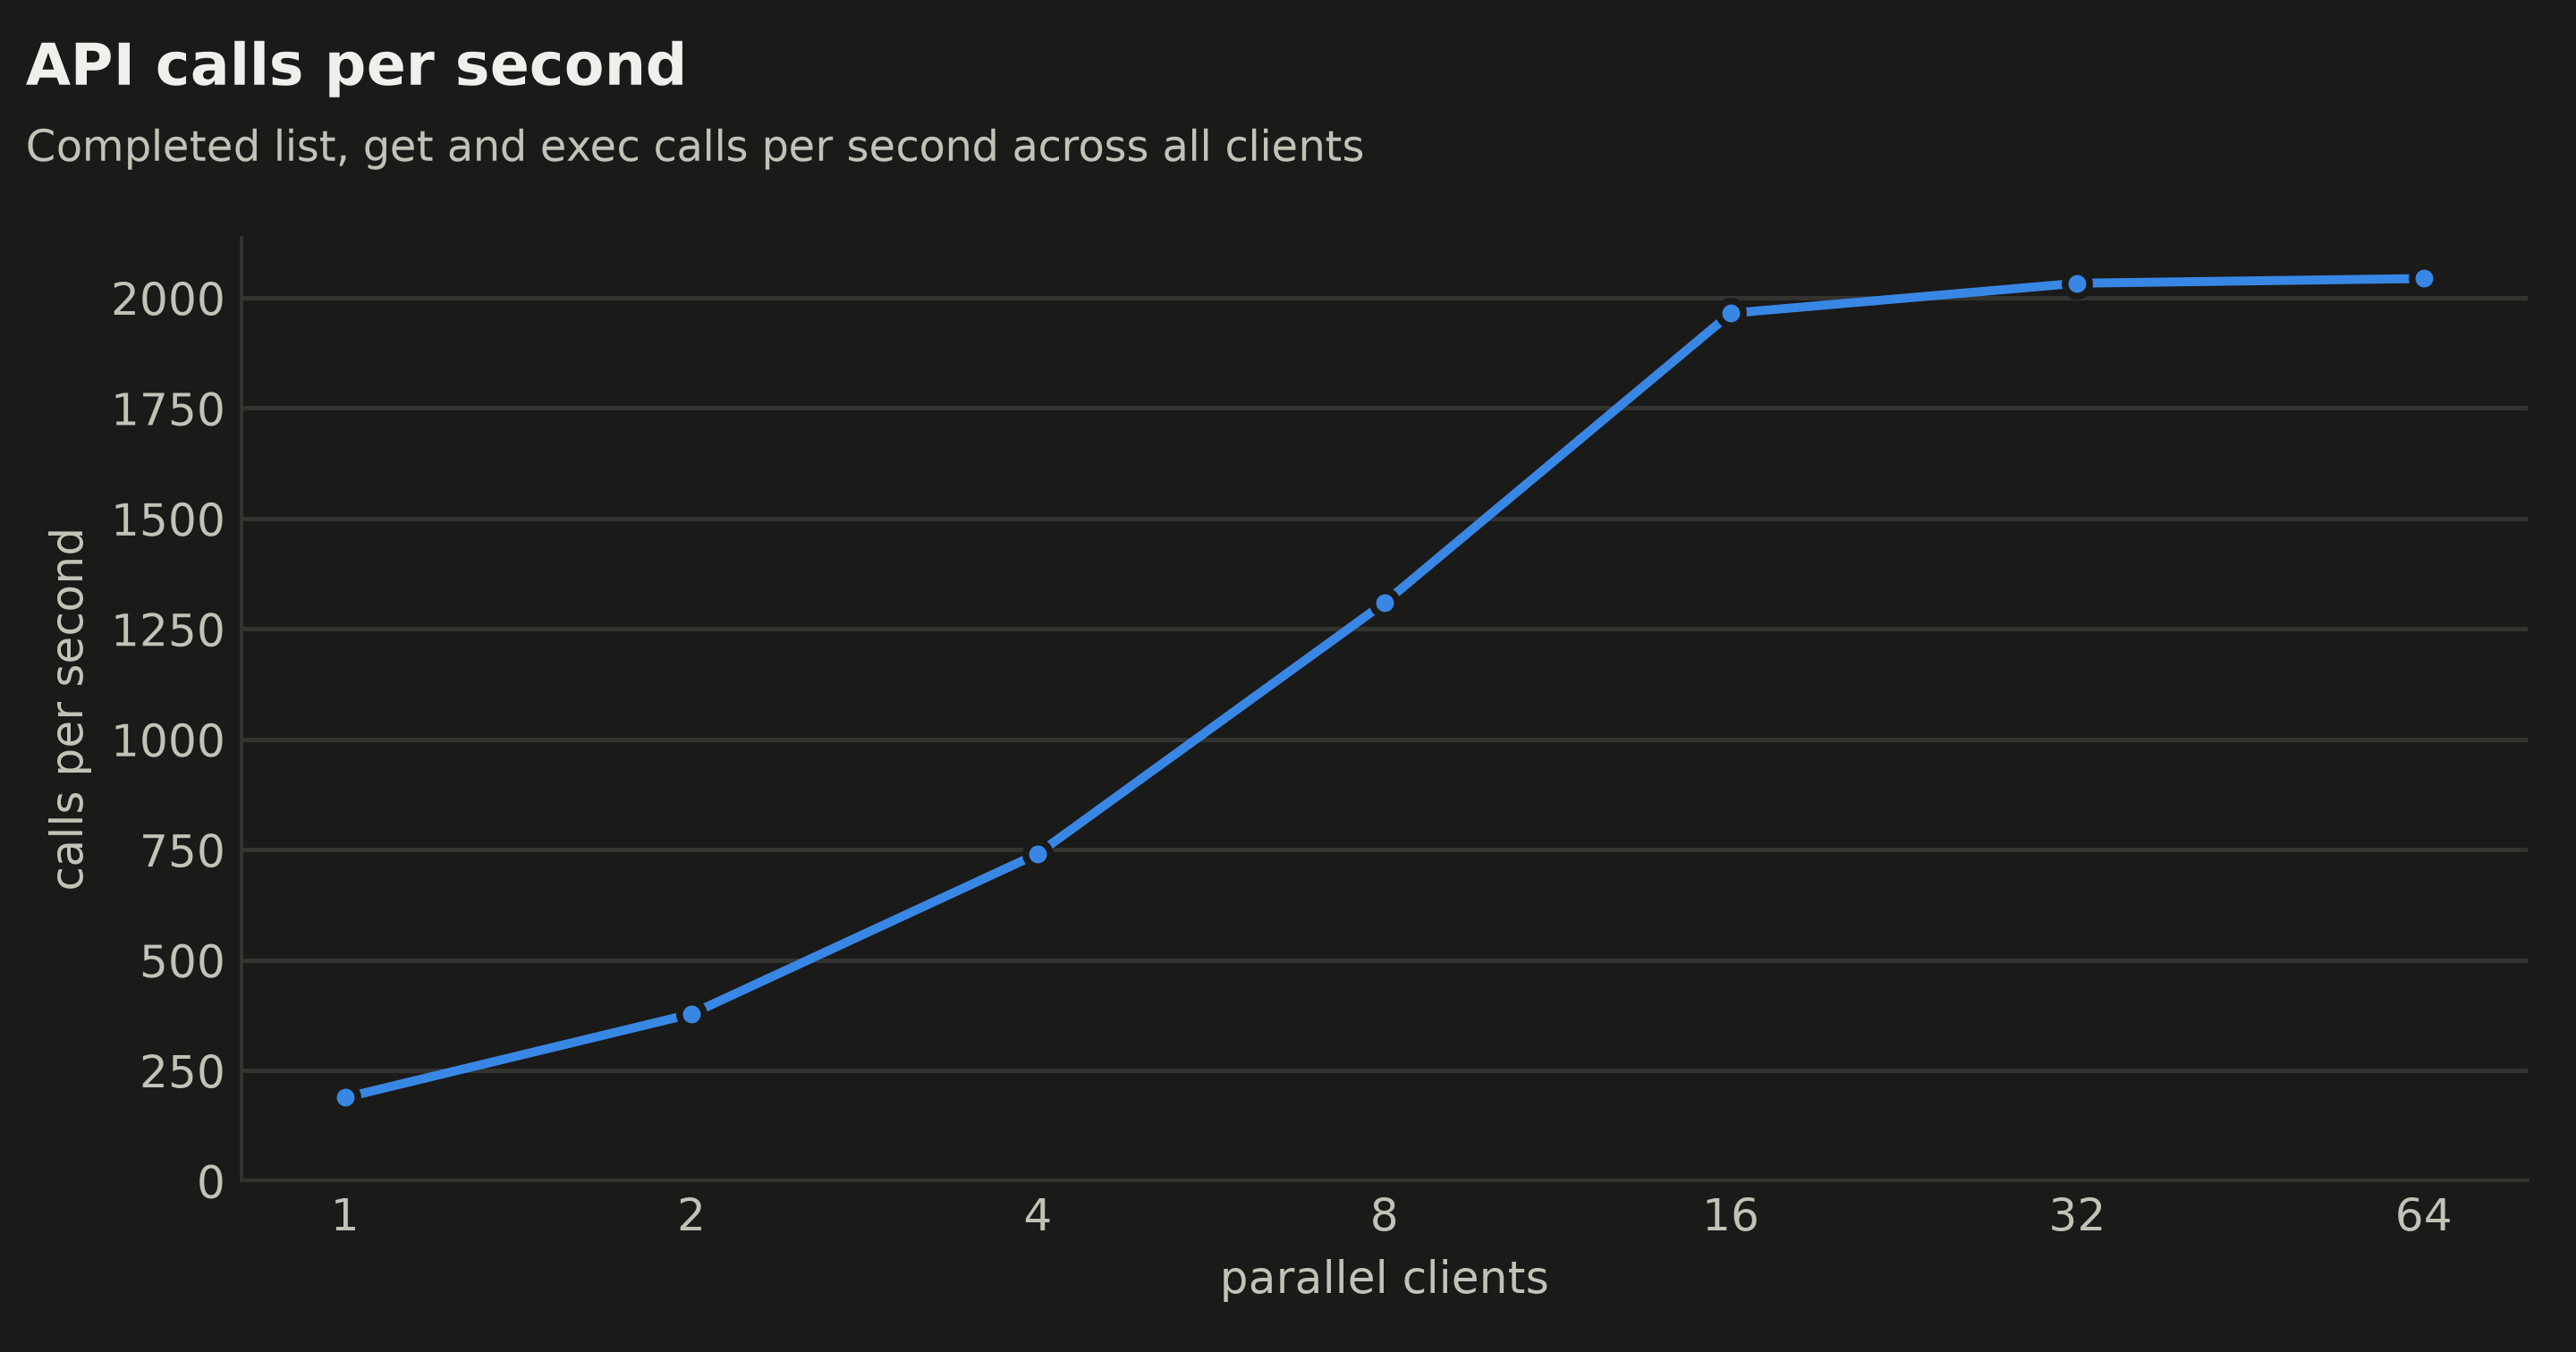
O 05_control_plane.py roda de 1 a 64 clientes de API em paralelo, cada um alternando list, get e exec contra cinco sandboxes, a partir de um Pod dentro do cluster: em uma execução de smoke test, cada chamada a partir do laptop pagava cerca de 90 ms pelo port-forward. O gateway é uma réplica sem limites de recursos.
| Clientes | Chamadas/s | list p50 | exec p50 / p95 | CPU do gateway | Memória do gateway |
|---|---|---|---|---|---|
| 1 | 189 | 1,9 ms | 13,1 / 17,7 ms | 0,23 cores | 83 MiB |
| 8 | 1.309 | 2,0 ms | 14,6 / 22,9 ms | 1,80 cores | 102 MiB |
| 16 | 1.965 | 2,2 ms | 17,9 / 42,5 ms | 2,65 cores | 107 MiB |
| 64 | 2.044 | 2,3 ms | 20,1 / 384,9 ms | 2,73 cores | 126 MiB |
Nenhum erro em nenhum nível. O throughput se estabiliza em cerca de 2.040 chamadas por segundo, com o gateway em cerca de 2,7 cores. Não posso dizer que esse é o limite do gateway: o node dele estava então em cerca de 6 dos seus 8 cores, e o meu cliente de carga é um único processo Python. list e get ficam em cerca de 2 ms; exec, que abre uma sessão pelo supervisor do sandbox, vai de 13 para 20 ms na mediana e para 385 ms no p95 com 64 clientes. Uma chamada Health, o piso do transporte, levou 0,89 ms.
Teste 6: Noisy neighbours
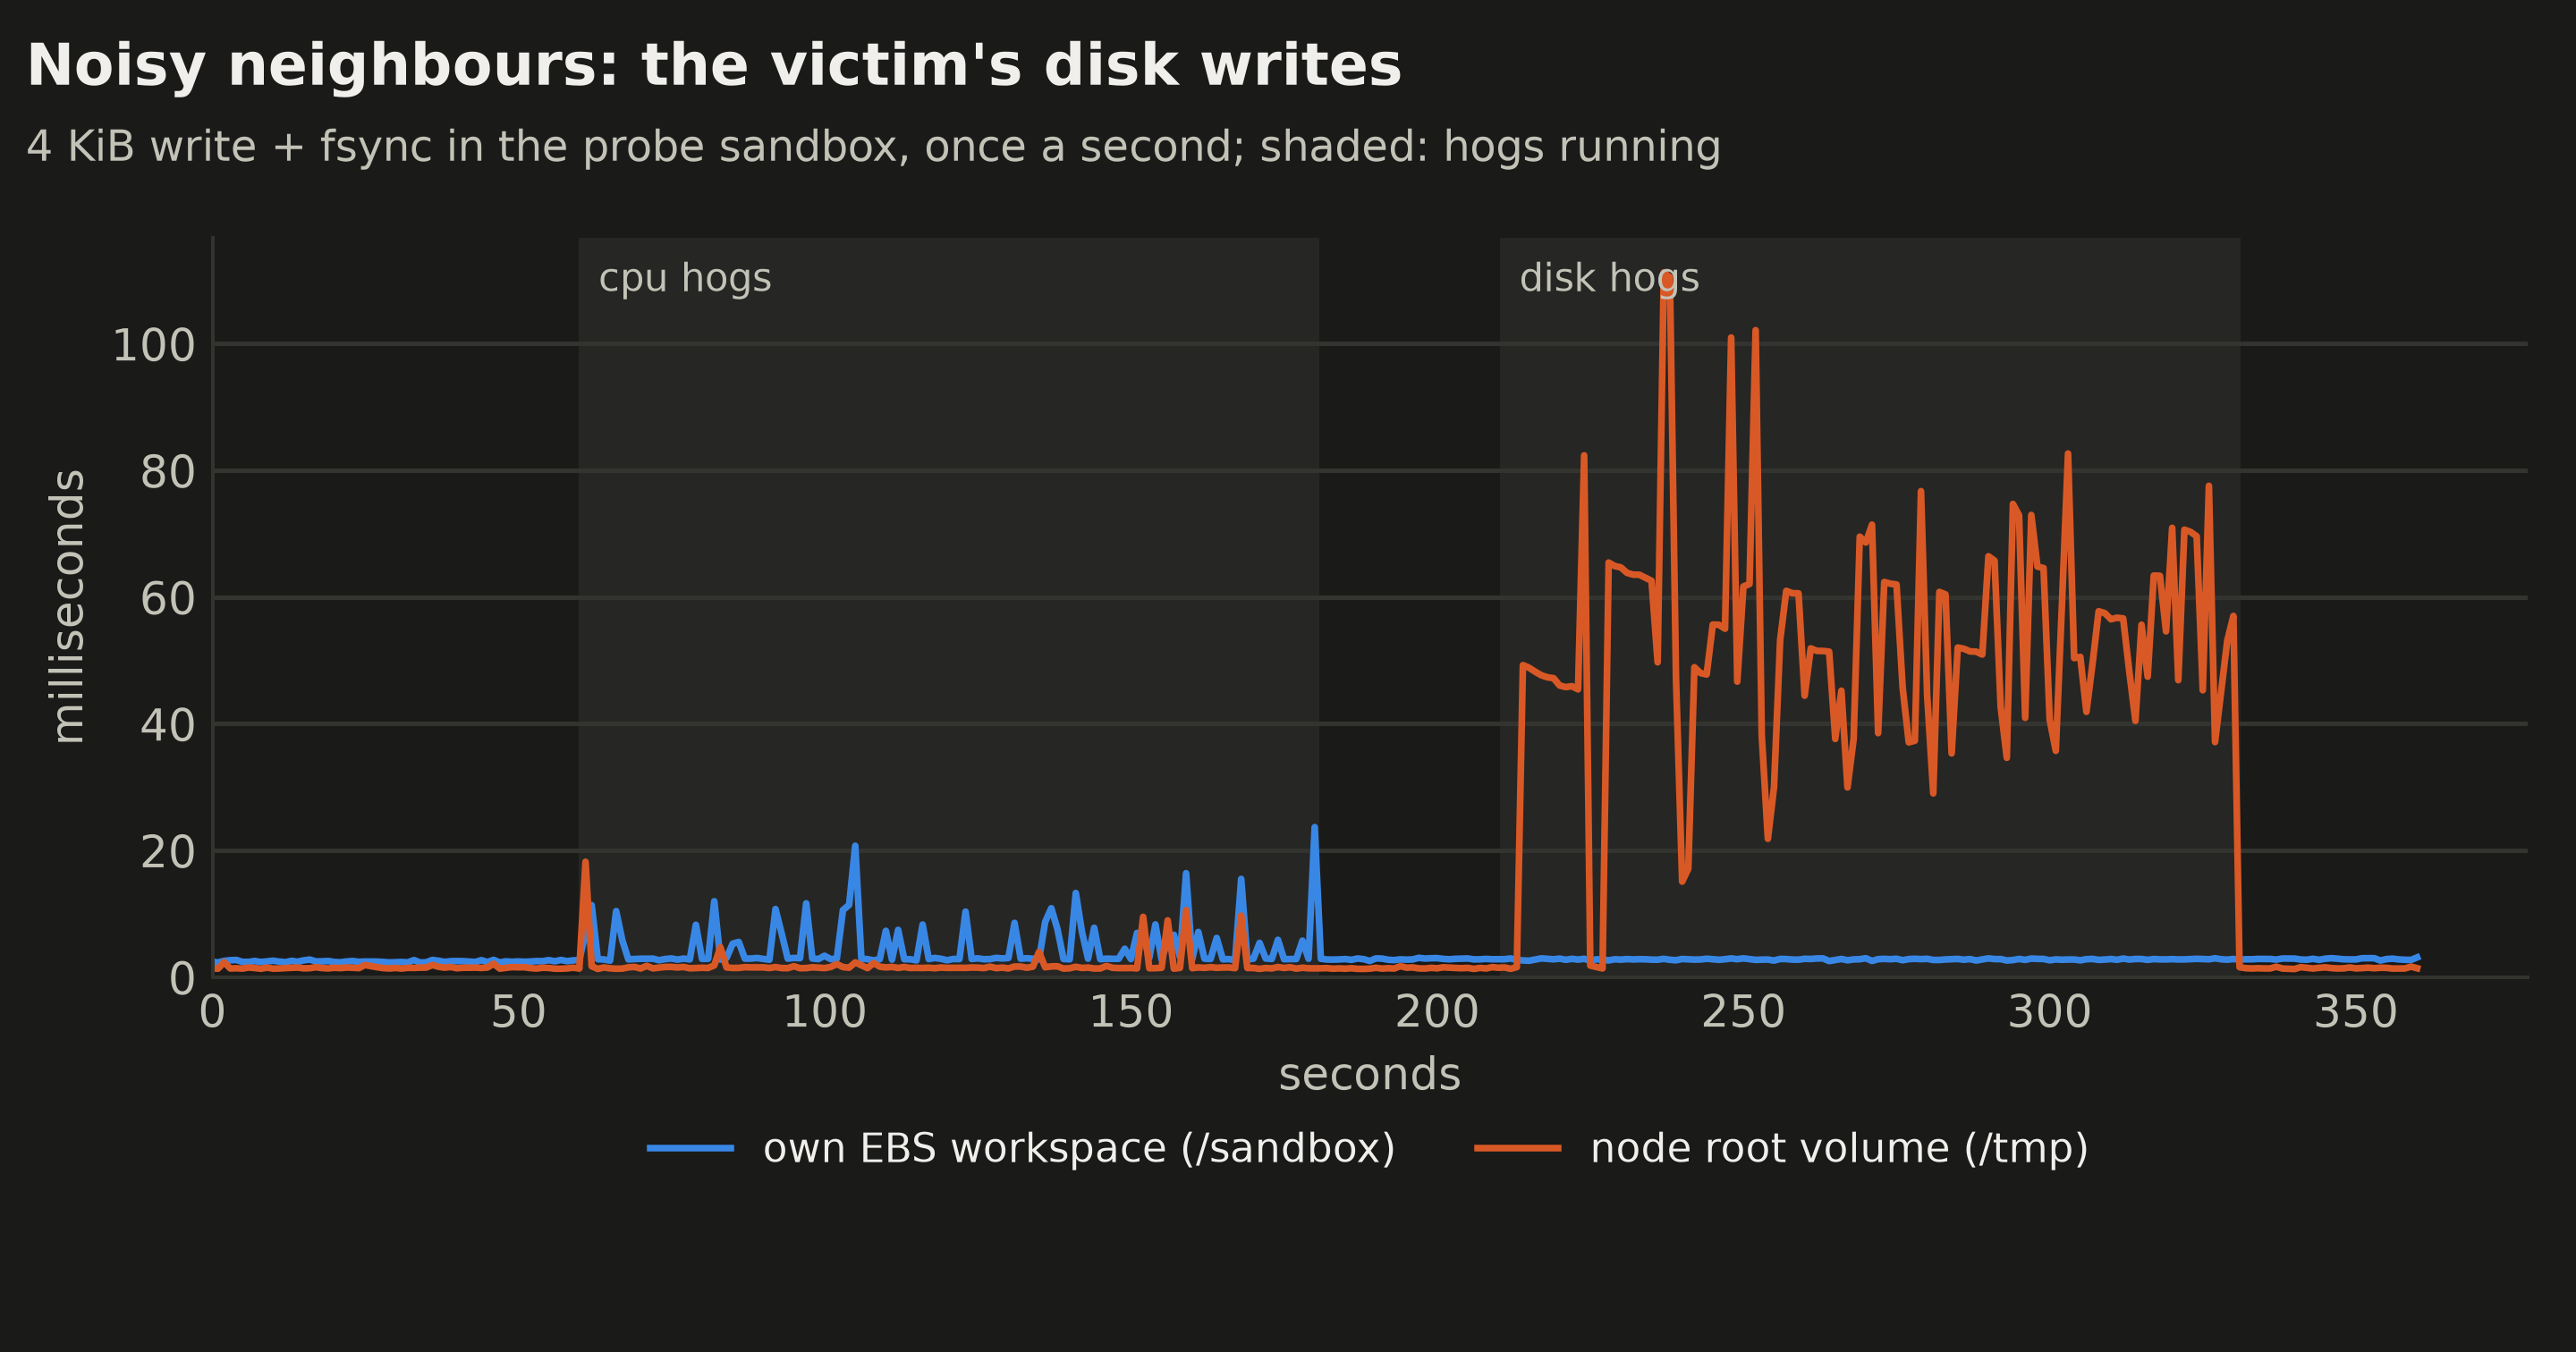
O 06_noisy_neighbors.py coloca um sandbox probe em um node ao lado de três sandboxes hog: primeiro CPU hogs (8 threads cada), depois disk hogs escrevendo no volume raiz do node e nos seus próprios workspaces. O probe mede uma porção fixa de trabalho de CPU, um fsync no seu próprio workspace EBS e no volume raiz do node, e uma requisição para o echo server, uma vez por segundo. O node do probe não é o mesmo do echo server, então a sua requisição de echo atravessa nodes, ao contrário da do Teste 4, e parte de uma linha de base mais alta. A segunda execução limita cada hog a 1 CPU.
| Probe, p50 | Linha de base | CPU hogs | CPU hogs, 1 CPU cada | Disk hogs | Disk hogs, 1 CPU cada |
|---|---|---|---|---|---|
| Trabalho de CPU | 10,6 ms | 20,6 ms | 15,0 ms | 10,7 ms | 10,7 ms |
| Requisição para o echo server | 6,1 ms | 15,5 ms | 7,4 ms | 6,2 ms | 7,2 ms |
fsync, workspace EBS próprio | 2,5 ms | 2,9 ms | 2,9 ms | 2,8 ms | 2,8 ms |
fsync, volume raiz do node (/tmp) | 1,4 ms | 1,5 ms | 1,5 ms | 51,5 ms | 53,6 ms |
Os sandboxes não têm limites de recursos a menos que você os defina (--cpu, --memory), e as camadas de isolamento do OpenShell não adicionam nenhum. Três CPU hogs sem limite dobraram o tempo de CPU do probe e mais que dobraram a latência das suas requisições; um limite de 1 CPU por hog eliminou a maior parte disso. Os disk hogs não afetaram o próprio volume EBS do probe, mas deixaram o fsync no volume raiz do node cerca de 36 vezes mais lento, e os limites de CPU não fizeram nada a respeito. Tudo o que um sandbox escreve fora de /sandbox, incluindo o seu /tmp, compartilha o disco raiz do node com todos os outros sandboxes daquele node.
O Que o CloudWatch Viu
O Container Insights viu os mesmos testes, com um ponto de dados por minuto. O node_number_of_running_pods teve pico de 58 em um node durante a execução de densidade com supervisores dedicados, o limite de Pods que o Teste 1 atingiu, e o cluster_number_of_running_pods, de 116. O node_cpu_utilization ficou abaixo de 10% nos testes de densidade, create e propagação, chegou a cerca de 42% durante a escada de egress e a 72% sob carga de API, e a 100% no node dos hogs com os noisy neighbours; o node_memory_utilization nunca passou de 9%. O API server reportou 8 respostas com status 5xx durante o teste de propagação de policy.
Duas coisas que ele não mostra. Nada no Container Insights sabe o que é um sandbox, então um sandbox travado em Provisioning é só um Pod Pending, e o teto de densidade parece uma falha de scheduling comum. E com um ponto de dados por minuto, uma tempestade de creates que leva 40 segundos é um único ponto. Para o próprio OpenShell, o gateway expõe métricas Prometheus na porta 9090 (sessões de supervisor, entrega de configuração, chamadas gRPC), que um scraper Prometheus ou o suporte a Prometheus do agente do CloudWatch poderia coletar; eu as li diretamente no Teste 5.
Resumo dos Resultados
| Resultado | |
|---|---|
| Densidade, um Pod de supervisor por sandbox | 46 sandboxes; parados pelo limite de Pods por node (58) |
| Densidade, pool de supervisores compartilhado | 61; parados pelo limite de attachments de EBS por node (31) |
| Densidade, pool compartilhado com workspaces de 1 GiB | 61; mesmo limite |
| Uso dos nodes com 46 sandboxes | menos de 2,8 GiB de 32 GiB de memória e 0,9 de 8 cores por node |
| Pool compartilhado após uma troca | creates recusados até os membros do pool se conectarem (o passo do canary levou de 49 a 110 s) |
| Create→Ready, 1 / 40 de uma vez, dedicados | 9,2 s / 32,4 s p50 (42,4 s p95) |
| Create→Ready, 1 / 40 de uma vez, pool compartilhado | 12,3 s / 17,5 s p50 (30,3 s p95) |
| Creates travados ou com falha | 0 (pool compartilhado: depois que passou a aceitar sandboxes) |
| Delete | cerca de 31 s por sandbox |
| Propagação de policy, poll / push | p50 4,96 s, máx. 10,0 s / p50 0,07 s, máx. 0,39 s |
| Streams abertos cortados por uma mudança de policy não relacionada | 200 de 200 |
| Nova conexão para um serviço dentro do cluster | 1,1 ms direto, 2,5 a 3,4 ms pelo OpenShell |
| Requisição HTTPS com keep-alive, direto vs REST enforce | 3,06 ms vs 3,57 ms |
| Throughput da API do gateway | cerca de 2.040 chamadas/s com cerca de 2,7 cores, sem erros |
| Noisy neighbours de CPU | trabalho de CPU do probe 10,6 → 20,6 ms; 15,0 ms com limites de 1 CPU |
| Noisy neighbours de disco | fsync no volume raiz do node 1,4 → 51,5 ms; workspace EBS próprio não afetado |
Preços
Os testes rodaram no cluster da parte 2, sem nada adicionado além do Container Insights, de cerca de 06:10 a 08:10, incluindo as re-execuções dos testes do pool compartilhado. Com a tarifa ociosa da parte 2, de cerca de $0,98 por hora (dois nodes m7i.2xlarge, o control plane do EKS, o NAT gateway e os volumes raiz), isso dá aproximadamente $2 de tempo de cluster.
O resto é pouco:
| Item | Preço | Para estes testes |
|---|---|---|
| Volumes de workspace, até 61 × 2 GiB gp3 | $0,08/GB-mês | menos de $0,02 por hora no pico |
| Container Insights | cobrado por observação de métrica (preços do CloudWatch) | desligue depois |
Sandboxes nesses nodes são baratos: 46 ociosos usaram alguns por cento de dois nodes que custam $0,81 por hora juntos. O custo da densidade aqui é o custo dos slots de Pod e dos attachments de volume, então, para um tipo de instância, verifique esses limites antes de olhar vCPUs e memória.
Limpeza
./99_cleanup.sh               # anything a killed script left: p6 sandboxes, Pods, Helm overlays
./00_container_insights.sh off
cd ../openshell-eks
./99_teardown.sh              # the whole cluster, at the end of the series
Cada teste deleta o que criou e desfaz qualquer mudança no gateway; o 99_cleanup.sh é para quando um script foi interrompido à força. Ele também remove os recursos Sandbox que o gateway não lista mais, os órfãos descritos no Teste 2.
Veredito
Dois nodes m7i.2xlarge rodaram 46 sandboxes do OpenShell na configuração padrão e 61 com o pool de supervisores compartilhado, e nos dois casos o cluster esgotou os slots de Pod e os attachments de EBS por node (limites da instância que o Kubernetes aplica) muito antes de esgotar CPU ou memória. Essa é a lição prática para dimensionamento: conte Pods (dois por sandbox por padrão) e attachments de EBS (um por sandbox), não gigabytes e cores. O prefix delegation no VPC CNI eleva o primeiro, e o pool compartilhado o reduz pela metade; o segundo continua enquanto cada sandbox receber o seu próprio volume, que é o padrão.
Sob carga, o OpenShell se comportou bem. Os creates ficaram mais lentos com a concorrência, mas nunca falharam nem travaram quando a configuração estava certa, o gateway atendeu cerca de 2.000 chamadas de API por segundo a partir de uma réplica, sem erros, e as camadas de policy custaram uns dois milissegundos por nova conexão. O pool compartilhado é a forma mais rápida de criar muitos sandboxes, mas é experimental, e depois de cada troca para ele o gateway recusou sandboxes até que os membros do pool se conectassem.
Os comportamentos a levar em conta no design:
- Mudanças de policy são disruptivas em escala. Toda revisão corta todas as conexões abertas em todos os sandboxes que alcança, e com polling ela leva até 10 segundos (cerca de 5 na mediana). Agrupe as edições de policy e use a entrega por push se os agentes ficarem esperando por elas.
- Não há limites de recursos por padrão. Um sandbox pesado em CPU deixa os vizinhos mais lentos, e um pesado em disco deixa mais lento tudo o que escreve no volume raiz do node, o que limites de CPU não resolvem. Defina
--cpue--memory, mantenha dados temporários em/sandboxe considere node pools separados para agentes pesados. - Os deletes são lentos, e um pode deixar órfãos. Cerca de 31 segundos cada, e em uma execução de smoke test um delete logo depois de
Readydeixou para trás os objetos e o volume de um sandbox. Procure recursosSandboxe volumes remanescentes depois de deletes em massa. - Monitore com as métricas do próprio OpenShell. O Container Insights enxerga Pods e nodes, não sandboxes.
Este é o fim da série. Ao longo de seis partes, o OpenShell 0.1.6 no EKS se mostrou um design cuidadoso com arestas afiadas: o agente não guarda as próprias credenciais (com uma exceção conhecida na 0.1.6, coberta na parte 5), o isolamento falha fechado e o modelo de egress é preciso, enquanto os padrões (modo audit, telemetria ligada, sem limites, sem isolamento por VM nesses nodes) e um punhado de bugs precisam de atenção antes que qualquer coisa importante rode nele. Se você está decidindo, a parte 1 é por onde começar.