OpenSandbox no Amazon EKS: Hands-On com uma Instalação Self-Hosted
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- O que o EKS precisa e os defaults não entregam
- Configuração
- Passo 1: Ferramentas e o código de apoio
- Passo 2: O cluster
- Passo 3: As imagens
- Passo 4: Os charts e os values deles
- Testes
- Teste 1: O cluster atende ao nível exigido?
- Teste 2: Kata na virtualização aninhada (o gate)
- Teste 3: Nove imagens para o ECR
- Teste 4: Base, controller e server, e a API key vazia
- Teste 5: O ingress gateway atrás de um NLB
- Teste 6: O console de desenvolvedor
- Teste 7: Um primeiro sandbox no EKS
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
- Com o que você se compromete
- Quem deveria rodar isto
Explica (TLDR) como se eu fosse...
Imagine construir um parquinho para robôs ajudantes dentro de um parque enorme e alugado. O livro de regras foi escrito para outro parque, então eu conferi pessoalmente cada portão e cada balanço e consertei os que não serviam, como a placa que mandava todo mundo buscar brinquedos numa loja muito longe.
No fim, um robô ganhou o seu próprio quartinho, e eu consegui falar com ele por um portão que só abre para a minha casa. Um robô pode até ganhar um quarto só dele, com paredes de verdade. Manter o parque aberto custa dinheiro a cada hora, então eu fecho quando ninguém está brincando.
Este post documenta uma instalação self-hosted do OpenSandbox 1.2.0, um projeto Apache 2.0 da Agentic AI Foundation, no Amazon EKS 1.37. Essa versão está fora da faixa de suporte declarada pelo projeto, que termina no Kubernetes 1.34, então o operador assume o risco de compatibilidade.
Os pontos de diligência são controle e exposição. As imagens ficam no registry da própria organização, a API e o console só são acessíveis por um túnel autenticado, e o servidor se recusa a iniciar sem uma key. Restam duas lacunas: o tráfego dos sandboxes atravessa a internet em texto claro, limitado apenas pelo endereço de origem, e os charts concedem permissões amplas no cluster inteiro.
A questão apresentada era se o OpenSandbox roda no Amazon EKS 1.37 quando o projeto só testa até o Kubernetes 1.34. A investigação foi uma instalação completa, de uma conta vazia até um primeiro sandbox, registrada execução por execução, com cada falha anotada ao lado da correção que a resolveu.
Achados: nenhuma das falhas que consegui diagnosticar teve origem na 1.37, embora um drain lento de node continue sem explicação. A maioria veio dos defaults, de imagens num registry distante a um servidor que encerra sem uma key. Sandboxes runc padrão iniciaram em cerca de dois segundos e meio, e máquinas virtuais Kata rodaram em instâncias comuns.
Existe um cansaço particular em instalar algo cujas instruções foram escritas para outro lugar. Cada default que não se encaixa é pequeno, mas eles se acumulam, e ajuda nomeá-los um de cada vez em vez de carregar uma sensação vaga de que a coisa toda é frágil.
É disso que trata a maior parte deste post: cada descompasso, o que quebrou e o que consertou. Nenhum dos que consegui diagnosticar veio de rodar um Kubernetes mais novo do que o projeto testa, e todo script de instalação pode rodar duas vezes sem causar dano. O que continua pesando é custo e exposição: cerca de um dólar por hora em ociosidade, e um gateway protegido apenas por um endereço.
Montar o OpenSandbox no EKS pareceu afinar um equipamento emprestado antes de um show. Os charts chegaram ajustados para outra sala: cabos para um fornecedor do outro lado do mundo, um servidor que não ligava sem a sua key, e amplificadores no volume muito acima do que um palco pequeno precisa.
Com cada botão no lugar, a passagem de som manteve o andamento firme. Cada script de instalação tocou o mesmo take duas vezes sem errar uma nota, um sandbox runc entrou cerca de dois segundos e meio depois da contagem, e as máquinas virtuais Kata acharam a sua deixa em instâncias comuns, e não em hardware dedicado.
A história é uma plataforma self-hosted de sandboxes para agentes na sua própria conta AWS, no Amazon EKS 1.37, com cada passo em script e cada número medido. O OpenSandbox 1.2.0, agora um projeto da Agentic AI Foundation, vai de uma conta vazia a um primeiro sandbox em cerca de meia hora de tempo de script.
O posicionamento honesto: isto é para times de plataforma que aceitam de bom grado ser donos de um cluster. Muitos defaults precisaram mudar, o gateway precisa de hardening antes de uso real, e o cluster custa cerca de um dólar por hora ocioso. A recompensa são sandboxes, máquinas virtuais Kata incluídas, sob o seu próprio controle.
 Veja o código-fonte aqui: opensandbox-eks
Visão Geral
O OpenSandbox é um projeto da Agentic AI Foundation, um directed fund da Linux Foundation, desde o anúncio de 22 de outubro de 2026; a parte 1 cobre essa mudança e como as peças se encaixam.
Este post, parte 2 de 6, instala o OpenSandbox 1.2.0 no Amazon EKS e registra tudo o que não funcionou de primeira. Primeiro, a questão da versão: o BOM da release 1.2.0 lista suporte a Kubernetes da v1.21 à v1.34, e o CI do projeto roda só em clusters kind. Eu rodei no EKS 1.37, três versões minor além dessa faixa. A 1.37 é a versão mais nova no suporte padrão do EKS, e o suporte padrão da 1.34 termina em 2 de dezembro de 2026, então eu não começaria um cluster novo na 1.34.
O código de apoio vai de uma conta AWS vazia até um primeiro sandbox: uma VPC e um cluster EKS 1.37 em Terraform, com dois nodes m7i.2xlarge com a virtualização aninhada do EC2 ligada; Kata Containers pelo kata-deploy 3.32.0, a última release 3.x; as oito imagens principais da 1.2.0 e a imagem Python de sandbox copiadas para o ECR; os charts base, controller e server, renderizados a partir da tag do git release-1.2.0 com um arquivo de values por componente; o ingress gateway atrás de um Network Load Balancer que aceita um único endereço IP; o console de desenvolvedor, com build a partir do código-fonte; e um primeiro sandbox, alcançado pelo servidor e pelo gateway. A API do servidor e o console nunca ganham um endpoint público, só kubectl port-forward. Aqui os sandboxes rodam sob runc; a parte 3 muda o servidor para Kata.
O material sobre EKS que encontrei cobre menos: um post do blog da AWS China de 15 de julho de 2026 roda só o controller do OpenSandbox no EKS 1.34 com nodes bare-metal c5.metal, e os guias de EKS de um fork da comunidade são de março e abril de 2026, antes da 1.1.0, a primeira release sob a linha de versão única do projeto.
A parte 3 cobre o ciclo de vida do sandbox, pools e isolamento, a parte 4 o sidecar de egress e o Credential Vault, a parte 5 credenciais AWS assinadas no egress, e a parte 6 faz um teste de estresse nos mesmos dois nodes, tudo no cluster construído aqui. Cada número abaixo vem das minhas execuções em 31 de outubro e 1º de novembro de 2026 (UTC), a partir de um Mac com Apple Silicon; eu aviso quando uma execução não está nas gravações.
Arquitetura
Três namespaces guardam tudo. O opensandbox-system tem o que os charts do OpenSandbox instalam (controller, servidor, gateway) mais o console. O opensandbox é onde os sandboxes rodam, e nenhum chart o cria. O kube-system tem as peças da AWS e o kata-deploy. (O chart base também cria um namespace opensandbox-dataplane vazio.) Tudo isso compartilha os mesmos dois nodes.
opensandbox-system contém o servidor (SQLite num volume gp3 criptografado de 1 GiB), o web e o BFF do console, o controller, que transforma objetos BatchSandbox em pods, e o gateway. O opensandbox contém os pods de sandbox: o init container execd-installer, o sandbox e um sidecar de egress só quando há uma network policy. O kube-system contém o AWS Load Balancer Controller, o agente EKS Pod Identity, o kata-deploy (RuntimeClasses kata-qemu e kata-clh) e os add-ons. Tudo roda em dois nodes m7i.2xlarge, um por zona, com virtualização aninhada (/dev/kvm) e IMDSv2 com hop limit de 1; eles fazem pull das imagens do ECR.O que o EKS precisa e os defaults não entregam
Cada linha é algo que aconteceu numa execução (gravada, a menos que a linha diga o contrário), ou um default que eu mudei antes da primeira execução porque esperava que quebrasse (de antemão; cada um foi conferido no cluster depois). A coluna Escopo diz se é específico do EKS ou da AWS; a maioria das linhas afetaria qualquer cluster. Os testes abaixo trazem as evidências; esta é a lista de trabalho.
O cluster (Terraform e AWS)
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
| Nada falhou, mas a documentação do provider AWS do Terraform (6.71.0) diz que a virtualização aninhada é só para Intel de 8ª geração | O EC2 adicionou M7i, C7i e R7i em 18 de junho de 2026; a documentação está atrasada | cpu_options.nested_virtualization = "enabled"; o EC2 aceitou em m7i.2xlarge | AWS |
| A AMI AL2023 recomendada mudou de v20261026 para v20261031 no dia do build | O módulo EKS escolhe a AMI e os builds de add-on mais novos a cada plan, então o próximo apply substituiria os nodes | Fixar a release da AMI e as versões dos cinco add-ons | EKS |
Um volume de teste na StorageClass padrão saiu Encrypted: False | A class padrão do add-on não define parâmetros, e a criptografia por padrão do EBS está desligada | Uma StorageClass gp3-encrypted para o servidor | EKS |
| Numa execução de dev, health checks pelo service proxy do API server ficaram travados por cerca de 2 minutos cada | O security group dos nodes só admite o control plane nas portas 443, 4443, 6443, 8443, 9443, 10250 e 10251 | Fazer a verificação de dentro do pod com kubectl exec | EKS |
| De antemão: o tráfego de pods entre nodes abaixo da porta 1025 falharia | O módulo só abre a 53 e de 1025 a 65535 entre nodes | Uma regra node a node para todas as portas | EKS |
| De antemão: o LB Controller não consegue ler a sua região e VPC, e cada upgrade substituiria o certificado do webhook dele | Hop limit 1 do IMDS; keepTLSSecret tem default false | region, vpcId e keepTLSSecret=true nos values dele | EKS |
| De antemão: repositórios criados no push não podem receber tags nem scan só pelo creation template | As tags precisam de uma role própria; o scan on push é uma regra do registry inteiro | Um custom_role_arn para opensandbox-eks/*, e uma regra de registry que o script não aplica por cima de uma configuração existente | AWS |
Kata Containers
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
De antemão: o chart instala todos os shims, o snapshotter nydus e o kubectl:latest para o hook de uninstall | Defaults do chart | Só os shims de QEMU e Cloud Hypervisor, sem snapshotter, kubectl fixado em v1.37.1 (uma tag que o projeto refaz toda semana) | Geral |
O kata-deploy editou o /etc/containerd/config.toml e reiniciou o containerd nos dois nodes com no máximo um segundo de diferença | A config do AL2023 não tem linha imports; o DaemonSet instala em todos os nodes ao mesmo tempo | Nada necessário. Num cluster maior, faça canary em um node com o nodeSelector do chart | EKS (AL2023) |
Imagens e charts do OpenSandbox
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
Sete referências de imagem nos charts renderizados apontam para sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com | Defaults do chart; o BOM da release cita docker.io/opensandbox/*:release-1.2.0 | Copiar as imagens para o ECR e apontar todas as referências para lá, incluindo duas dentro do TOML do servidor | Geral |
O Docker Hub respondeu 429 Too Many Requests na quarta imagem da primeira cópia | O Docker documenta 100 pulls anônimos a cada 6 horas por endereço IPv4 ou /64 IPv6; os headers que recebi diziam 100;w=3600, uma hora | Backoff com teto, uma nova execução que copia só o que falta, Python do ECR Public | Geral |
O servidor entrou em crash loop com Startup blocked: server.api_key is empty in non-interactive mode, enquanto o Helm dizia STATUS: deployed | O chart renderiza api_key = "" | A key vinda de um Secret, como OPENSANDBOX_SERVER_API_KEY | Geral |
| O servidor pedia 1 CPU e 4 GiB (limits de 2 e 8 GiB) | Defaults do chart | 250m e 512Mi, do próprio smoke test de Helm da release | Geral |
O chart base falhou: Namespace "opensandbox-system" ... exists and cannot be imported into the current release | Ele renderiza um namespace que já existia sem os labels do Helm | fastSandbox.namespaces.createSystem: false; o meu manifest é o dono dele | Geral |
O git clone --branch release-1.2.0 imprimiu um aviso inofensivo mas confuso, ... is not a commit! | Os charts não são publicados, e a tag é anotada | Fazer fetch da tag num repositório novo e checkout do commit dela | Geral |
De antemão: nenhum chart cria o namespace de sandboxes opensandbox | O servidor simplesmente o usa | Um manifest com Pod Security privileged (o sidecar de egress adiciona NET_ADMIN) | Geral |
| De antemão: o banco de dados SQLite ficaria dentro do container | O chart do servidor não tem volume | Um PVC de 1 GiB na gp3-encrypted, em /data | Geral |
| De antemão: todo pod de sandbox toleraria qualquer taint | O template padrão de BatchSandbox tem tolerations: [{operator: Exists}] | Um template meu, sem isso | Geral |
Não aconteceu: o crash loop por -containerd-socket-path que o time da AWS China encontrou no EKS 1.34 | A 1.2.0 define a flag, e o chart não passa nenhuma | Nada | Geral |
O ingress gateway
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
| De antemão: o gateway não vem instalado, embora a documentação o chame de obrigatório | O chart umbrella o desabilita | O chart dele como uma release própria | Geral |
| De antemão: a imagem dele vem do registry na China, cada réplica pede 1 CPU e 4 GiB, e ele roda como root | Defaults do chart | Imagem do ECR; 100m e 128Mi; não root, com filesystem raiz somente leitura e sem capabilities | Geral |
| De antemão: o Service do chart não pode ser configurado como internet-facing, com targets por IP nem com limite por source range | O chart não tem value para annotations do Service | Um segundo Service para os mesmos pods, com as annotations do NLB e um loadBalancerClass: service.k8s.aws/nlb explícito, para não depender do webhook de Service do LB Controller, ligado por padrão | EKS |
| De antemão: o upgrade de WebSocket do PTY precisa chegar ao gateway como HTTP/1.1 | O gateway só fala HTTP/1.1 em texto claro | Um listener TCP no NLB; o upgrade retornou HTTP 101 | AWS |
| De antemão: o servidor não consegue anunciar o gateway antes de o NLB existir | server.gateway.host é o nome DNS do NLB | Duas passadas: esperar o NLB, gravar um arquivo de values, fazer upgrade do servidor | Geral |
Uma execução interrompida (não gravada) deixou o NLB no ar e o servidor ainda no modo direct | O upgrade do servidor vem depois da espera pelo NLB | Não testado: uma nova execução deveria convergir, já que espera o NLB existente e grava o arquivo de values que falta. Em vez disso, eu apaguei o NLB e comecei de novo | Geral |
O console
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
| De antemão: não há imagens do console para fazer pull | A release entrega só o código-fonte e manifests de exemplo | Fazer o build das imagens web e BFF a partir da tag para linux/amd64, o push para o ECR e o deploy por digest | Geral |
| O BFF de exemplo chama o servidor na porta 8090; o Service do chart do servidor escuta na 80 | Os manifests de exemplo e a documentação divergem do chart | LIFECYCLE_API_BASE=http://opensandbox-server.opensandbox-system.svc/v1 | Geral |
| De antemão: o exemplo guarda a key do tenant num ConfigMap | Manifest de exemplo | Um Secret, montado com modo 0400 | Geral |
| De antemão: o cookie de sessão Secure do exemplo, sobre um port-forward http | O Safari descarta cookies Secure sobre http | BFF_COOKIE_SECURE=false (ainda HttpOnly e SameSite=Lax), CORS para localhost:5173 | Geral |
| Numa execução de dev, uma nova execução refez o build das duas imagens com digests novos e substituiu os dois pods | Timestamps de build e provenance acabam dentro da imagem | Builds reproduzíveis (SOURCE_DATE_EPOCH, timestamps reescritos, sem provenance). O digest do BFF ainda muda num build sem o cache, porque os requirements dele usam >= | Geral |
O primeiro sandbox e o dia dois
| O que aconteceu | Por quê | Correção que funcionou | Escopo |
|---|---|---|---|
A primeira execução de create a frio falhou: crictl não encontrado no node | A AMI AL2023 do EKS tem ctr, não crictl | ctr -n k8s.io images rm --sync por um debug pod privilegiado | EKS (AL2023) |
| Escalar para zero nodes levou 17 minutos, com um node sendo cobrado até o fim | Um node saiu em até 3 minutos; o drain do segundo travou até o limite de eviction de 15 minutos do EKS (não descobri qual pod o segurou) | Uma espera de 30 minutos no script, e planejar para isso | EKS |
| Não ocorreu: um scale-up poderia colocar os dois nodes em us-east-1b e deixar o servidor Pending | O volume EBS dele fica em us-east-1a | Nenhuma ainda; três scale-ups puseram um node em cada zona | EKS |
Nada nesta lista que eu tenha conseguido diagnosticar remonta ao Kubernetes 1.37 em si; a causa do drain travado é desconhecida. Nenhum create de sandbox chegou perto do timeout de 60 segundos do servidor.
Configuração
Passo 1: Ferramentas e o código de apoio
Você precisa de uma conta AWS que possa criar recursos de VPC, EKS, IAM, EC2 e ECR, além de:
- Terraform 1.9 ou mais novo (eu usei o 1.14.8), o AWS CLI (2.34.29),
kubectla no máximo uma versão minor de distância da 1.37 (1.37.2) e Helm 4 (4.3.1) - Docker com
buildx, para a cópia das imagens e o build do console jq,git,curl,openssleenvsubst(do gettext; no Mac ele vem com ogettextdo Homebrew)uvpara os scripts Python
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/opensandbox-eks| Arquivo | O que faz |
|---|---|
terraform/ | VPC, EKS 1.37, o node group, as roles de Pod Identity, a policy IAM do LB Controller, o creation template do ECR e a regra de scan |
01_cluster.sh | terraform apply, grava o env.sh, configura o contexto do kubectl, instala o AWS Load Balancer Controller e depois verifica o cluster |
02_kata.sh | Instala o kata-deploy, inicia o mesmo pod sob kata-qemu, kata-clh e runc, e verifica que os pods Kata rodam na própria VM |
03_images.sh, images.txt | Copia as nove imagens para o ECR e confere cada digest com a origem |
04_install.sh | Namespaces, storage, o Secret da API key e o template de BatchSandbox, depois os charts base, controller e server |
05_gateway.sh | O ingress gateway atrás de um NLB que aceita só o seu IP, e as configurações de gateway do servidor |
06_console.sh | Faz o build das duas imagens do console a partir da tag e o push para o ECR (build), depois o deploy delas por digest (deploy) |
07_first_sandbox.py | Creates a frio e a quente, depois um comando e um round trip de arquivo pelo proxy do servidor e pelo gateway |
08_scale.sh | down e up escalam o node group para zero e de volta, com verificações; nodes-only traz os nodes de volta sem elas |
98_delete_sandboxes.py | Apaga todo sandbox que o servidor lista, passando da primeira página |
99_teardown.sh | Remove tudo, incluindo o que não é do Terraform, e procura sobras |
common.py, pyproject.toml | Os helpers de conexão dos scripts Python; opensandbox==1.2.0 e opensandbox-cli==1.2.0 |
values/, manifests/ | Um arquivo de values por chart, e os objetos Kubernetes que os charts não criam |
O 01_cluster.sh grava o env.sh (no gitignore) a partir dos outputs do Terraform, e todo script seguinte faz source dele. Toda chamada de kubectl e helm nos scripts nomeia o contexto osb-eks, então um contexto atual diferente não consegue mandá-las para o cluster errado. A API key do servidor e os dois segredos do console ficam no .env (no gitignore, modo 600); os scripts geram o que estiver faltando e nunca o imprimem.
Passo 2: O cluster
O terraform/ usa os módulos da comunidade EKS (21.29.0) e VPC (6.7.3), com todo provider fixado em versão exata. Ele cria 64 recursos:
- Rede: uma VPC (10.60.0.0/16) em us-east-1a e us-east-1b, subnets privadas para nodes e pods, subnets públicas para o NAT gateway e o NLB, um NAT gateway, e um S3 gateway endpoint gratuito para que os downloads de layers do ECR evitem o processamento do NAT.
- EKS 1.37: só access entries, um endpoint público da API aberto para um /32 (o seu IP, do
checkip.amazonaws.com) mais acesso privado para os nodes. Sem chave KMS gerenciada pelo cliente (o EKS já faz envelope encryption dos dados da API, e uma chave do cliente sobreviveria a um teardown por 7 a 30 dias), sem logs do control plane, sem IRSA. - Add-ons, fixados: VPC CNI, CoreDNS, kube-proxy, o agente EKS Pod Identity e o driver EBS CSI, mais duas roles de Pod Identity (driver EBS CSI, LB Controller), cada uma confiável só para a sua própria service account, namespace e cluster.
- ECR: um creation template para
opensandbox-eks/*(tags, AES256, imagens sem tag expiram após 7 dias) e uma regra de scan on push.
O node group é a parte que importa para esta série (cortado e reformatado):
eks_managed_node_groups = {
  nodes = {
    name                           = local.nodegroup_name   # "osb-nodes"
    ami_type                       = "AL2023_x86_64_STANDARD"
    ami_release_version            = var.ami_release_version   # "1.37.1-20261031"
    use_latest_ami_release_version = false
    instance_types                 = [var.instance_type]   # m7i.2xlarge

    min_size     = 0
    max_size     = 2
    desired_size = 2

    # Exposes VT-x to the node, so the kvm module loads and /dev/kvm exists.
    cpu_options = {
      nested_virtualization = "enabled"
    }

    # IMDSv2 only, with a hop limit of 1: the token response can't make the extra hop
    # into a pod's network namespace, so pods can't get the node role's credentials.
    metadata_options = {
      http_endpoint               = "enabled"
      http_tokens                 = "required"
      http_put_response_hop_limit = 1
    }

    # The AMI's 20 GiB root volume fills up with images, Kata assets and sandbox layers.
    block_device_mappings = {
      root = {
        device_name = "/dev/xvda"
        ebs = { volume_size = 100, volume_type = "gp3", encrypted = true, delete_on_termination = true }
      }
    }
  }
}
A virtualização aninhada não custa nada a mais no EC2. É ela que deixa o Kata rodar num m7i.2xlarge de $0,4032/h em vez de num node bare-metal (o m7i.metal-24xl custa $4,8384/h).
./01_cluster.shTrês coisas para saber antes de rodar:
- O scan do ECR é configurado para o registry inteiro. O Terraform é dono da configuração de scan do registry. Se o seu já tem regras, o script para:
ALLOW_ECR_SCAN_OVERWRITE=1as substitui,MANAGE_ECR_SCAN_ON_PUSH=falseas deixa como estão. O teardown volta o registry para o scan básico, sem regras. - As tags chegam a todo recurso que o Terraform cria,
project=opensandbox-eks, mas não às network interfaces que os serviços da AWS criam por conta própria. - Duas permissões IAM são mais amplas que o least privilege. A policy do LB Controller é a
iam_policy.jsonupstream da v3.6.2, literalmente, e alguns dos seus statements (ec2:CreateSecurityGroup,AuthorizeSecurityGroupIngress,RevokeSecurityGroupIngress) cobrem todo security group da conta. AAmazonEC2ContainerRegistryReadOnlyda role do node lê todo repositório da conta; o hop limit mantém os sandboxes longe dela.
Passo 3: As imagens
O images.txt lista as nove imagens de que a série precisa: as oito imagens principais do OpenSandbox do BOM da release (ele também lista seis imagens Fast Sandbox fsb-* que esta série não usa) e a imagem Python que os sandboxes usam.
docker.io/opensandbox/server:release-1.2.0
docker.io/opensandbox/execd:release-1.2.0
docker.io/opensandbox/ingress:release-1.2.0
docker.io/opensandbox/egress:release-1.2.0
docker.io/opensandbox/image-committer:release-1.2.0
docker.io/opensandbox/controller:release-1.2.0
docker.io/opensandbox/task-executor:release-1.2.0
docker.io/opensandbox/nodeagent:release-1.2.0
public.ecr.aws/docker/library/python:3.12-slim
O 03_images.sh copia cada uma de registry para registry com docker buildx imagetools create --tag <ecr> <source>, que mantém o índice multi-arch e o digest dele, e pula qualquer imagem cujo digest já bate. Ele faz login no ECR por uma config Docker descartável, então os seus próprios logins do Docker e o seu keychain nunca são lidos.
./03_images.shPasso 4: Os charts e os values deles
O OpenSandbox não publica os seus Helm charts, então o 04_install.sh faz fetch da tag release-1.2.0 (commit 62a64f0b48cd) em .src/OpenSandbox e instala três charts a partir dela: opensandbox-base (as CRDs e o RBAC delas), opensandbox-controller e opensandbox-server, todos em opensandbox-system. Os arquivos de values contêm ${ECR_REGISTRY} e ${ECR_PREFIX}; o script os preenche a partir do env.sh num diretório temporário, então nenhum ID de conta fica guardado no repositório.
Os values do servidor carregam a maior parte das correções (cortado e reformatado):
server:
  image:
    repository: ${ECR_REGISTRY}/${ECR_PREFIX}/server
    tag: release-1.2.0

  resources:
    requests: { cpu: 250m, memory: 512Mi }
    limits:   { cpu: "1", memory: 2Gi }

  env:
    - name: OPENSANDBOX_SERVER_API_KEY
      valueFrom:
        secretKeyRef: { name: opensandbox-server-auth, key: api-key }

  volumes:
    - name: data
      persistentVolumeClaim: { claimName: opensandbox-server-data }
    - name: batchsandbox-template
      configMap: { name: opensandbox-batchsandbox-template }
  volumeMounts:
    - { name: data, mountPath: /data }
    - { name: batchsandbox-template, mountPath: /etc/opensandbox-custom, readOnly: true }

# The server's config.toml. The chart renders it into a ConfigMap and appends [ingress].
configToml: |
  [server]
  host = "0.0.0.0"
  port = 80

  [runtime]
  type = "kubernetes"
  execd_image = "${ECR_REGISTRY}/${ECR_PREFIX}/execd:release-1.2.0"

  [kubernetes]
  namespace = "opensandbox"
  workload_provider = "batchsandbox"
  batchsandbox_template_file = "/etc/opensandbox-custom/batchsandbox-template.yaml"

  [egress]
  image = "${ECR_REGISTRY}/${ECR_PREFIX}/egress:release-1.2.0"
  mode = "dns+nft"

  [store]
  type = "sqlite"
  path = "/data/opensandbox.db"
A key vem do ambiente, então o TOML não tem linha api_key. O mode = "dns+nft" aplica regras de pacote além das regras de nome, o que o Credential Vault da parte 4 exige. Sem uma seção [secure_runtime], os sandboxes rodam sob runc.
Os values do chart base desligam o namespace que ele renderizaria de outra forma (comentário meu):
fastSandbox:
  namespaces:
    createSystem: false   # manifests/namespace-opensandbox.yaml owns opensandbox-system
Os values do controller apontam as duas imagens dele para o ECR e mantêm todos os outros defaults. O controller.snapshot.containerdSocketPath está vazio no chart 1.2.0, então nenhuma flag de socket é passada (comentários cortados):
controller:
  image:
    repository: ${ECR_REGISTRY}/${ECR_PREFIX}/controller
    tag: release-1.2.0
  snapshot:
    imageCommitterImage: ${ECR_REGISTRY}/${ECR_PREFIX}/image-committer:release-1.2.0
Antes dos charts, o script aplica os objetos que eles não criam: os dois namespaces (o de sandboxes com Pod Security privileged), a StorageClass gp3-encrypted e o PVC de 1 GiB do servidor, o Secret da API key e o template de BatchSandbox. O template é o exemplo da release sem a toleration para qualquer taint (comentários cortados):
data:
  batchsandbox-template.yaml: |
    metadata:
    spec:
      replicas: 1
      template:
        spec:
          restartPolicy: Never
Sem a toleration, os pods de sandbox recebem as tolerations padrão de 300 segundos do Kubernetes para not-ready e unreachable, então são despejados de um node com falha em vez de ficarem presos a ele.
./04_install.shDuas coisas que os charts instalam, que eu deixei como estavam e que importam antes de você rodar isto em qualquer ambiente de verdade:
- O RBAC vale para o cluster inteiro. A ClusterRole do servidor pode criar, atualizar e apagar pods, ConfigMaps e Services, e criar, ler e apagar Secrets em todo namespace. A do controller pode criar e apagar pods e ler Secrets em todo lugar. O chart base adiciona duas ClusterRoles de fast-sandbox (pods, nodes, ConfigMaps e Secrets no cluster inteiro, mais Roles e RoleBindings) para um componente que esta instalação não usa. O gateway (Teste 5) e o console (Teste 6) também leem pods e mais coisas no cluster inteiro.
- O servidor roda sem security context. Ele é o workload mais privilegiado aqui, e mesmo assim o container dele não tem
securityContext, enquanto o controller roda como não root, com todas as capabilities removidas e seccompRuntimeDefault. O chart expõeserver.podSecurityContexteserver.containerSecurityContext; eu não testei um servidor com hardening.
Testes
Teste 1: O cluster atende ao nível exigido?
Sandboxes runc pedem pouco do cluster. A série precisa de mais: /dev/kvm em todo node para o Kata, IMDS fechado para os pods, o agente Pod Identity para a parte 5, e o LB Controller para o gateway. O 01_cluster.sh verifica tudo isso depois do terraform apply; a verificação de /dev/kvm roda um debug pod em cada node com o filesystem do node em /host (simplificado):
kubectl debug -n default "node/$node" --quiet --profile=general --image="$DEBUG_IMAGE" -- \
  sh -c 'ls -l /host/dev/kvm 2>&1; echo "vmx: $(grep "^flags" /proc/cpuinfo | grep -cw vmx)"'
A primeira execução levou 13 minutos e 50 segundos: terraform apply 13m 07s (só o control plane do EKS 9m 50s, o NAT gateway 2m 6s em paralelo, o node group 1m 48s), o LB Controller 25 segundos e as verificações 16 segundos. Uma segunda execução não encontrou mudanças e terminou em 36 segundos. As verificações dessa nova execução:
== terraform apply
EKS API endpoint open to 203.0.113.10/32 only (full output: logs/terraform-apply.log)
ECR scanning: already managed by this Terraform
No changes. Your infrastructure matches the configuration.
Apply complete! Resources: 0 added, 0 changed, 0 destroyed.
   took 9s
...
== AWS Load Balancer Controller
chart 3.6.2 upgraded to revision 3: manifests identical to revision 2
   took 9s

== checks
  ok    Kubernetes v1.37.1-eks-577a51e
NODE                           TYPE          KUBELET               KERNEL                            RUNTIME
ip-10-60-10-104.ec2.internal   m7i.2xlarge   v1.37.1-eks-6e7947a   6.18.56-125.164.amzn2023.x86_64   containerd://2.3.7+unknown
ip-10-60-61-61.ec2.internal    m7i.2xlarge   v1.37.1-eks-6e7947a   6.18.56-125.164.amzn2023.x86_64   containerd://2.3.7+unknown
  ok    2 nodes Ready, both m7i.2xlarge
  ok    ip-10-60-10-104.ec2.internal: crw-rw-rw-. 1 root 36 10, 232 Oct 31 21:00 /host/dev/kvm (vmx on 8 vCPUs)
  ok    ip-10-60-61-61.ec2.internal: crw-rw-rw-. 1 root 36 10, 232 Oct 31 21:00 /host/dev/kvm (vmx on 8 vCPUs)
  ok    i-0de57b72d1ca37655 (m7i.2xlarge): HttpTokens required, HttpPutResponseHopLimit 1, NestedVirtualization enabled
  ok    i-0b539e448c1d539c2 (m7i.2xlarge): HttpTokens required, HttpPutResponseHopLimit 1, NestedVirtualization enabled
  ok    eks-pod-identity-agent DaemonSet 2/2 ready
  ok    aws-load-balancer-controller 2/2 ready, credentials from EKS Pod Identity
  ok    default StorageClass ebs-csi-default-sc (ebs.csi.aws.com, type not set: the driver default)
   took 16s
O terraform apply da primeira execução, cortado para os recursos lentos
== terraform apply
EKS API endpoint open to 203.0.113.10/32 only (full output: logs/terraform-apply.log)
Plan: 64 to add, 0 to change, 0 to destroy.
module.vpc.aws_nat_gateway.this[0]: Creation complete after 2m6s
module.eks.aws_eks_cluster.this[0]: Creation complete after 9m50s
module.eks.aws_eks_addon.before_compute["kube-proxy"]: Creation complete after 9s
module.eks.aws_eks_addon.before_compute["vpc-cni"]: Creation complete after 15s
module.eks.aws_eks_addon.before_compute["eks-pod-identity-agent"]: Creation complete after 25s
module.eks.time_sleep.this[0]: Creation complete after 30s
module.eks.module.eks_managed_node_group["nodes"].aws_launch_template.this[0]: Creation complete after 6s
module.eks.module.eks_managed_node_group["nodes"].aws_eks_node_group.this[0]: Creation complete after 1m48s
module.eks.aws_eks_addon.this["coredns"]: Creation complete after 26s
module.eks.aws_eks_addon.this["aws-ebs-csi-driver"]: Creation complete after 36s
Apply complete! Resources: 64 added, 0 changed, 0 destroyed.
   took 13m 07s
...
== Timings
  terraform apply                  13m 07s
  env.sh                                0s
  kubeconfig                            2s
  AWS Load Balancer Controller         25s
  checks                               16s
  total                            13m 50s
Tudo passou. O /dev/kvm é um character device nos dois nodes, e todas as 8 vCPUs têm a flag vmx (o gid 36 é kvm no node; a imagem de debug só não tem nome para ele). A primeira execução imprimiu “vmx on 16 vCPUs”: o kernel imprime uma linha vmx flags separada por CPU (desde o Linux 5.6), então contar vmx em todo o /proc/cpuinfo dobra o número. A verificação corrigida conta só as linhas flags.
O hop limit funciona: numa verificação ad hoc fora do script, um request de token IMDSv2 a partir de um pod comum deu timeout após 5 segundos (curl com exit 28). Pods em hostNetwork ainda alcançam o IMDS, já que compartilham o network namespace do node. A última linha é a StorageClass padrão sem criptografia da tabela acima.
Teste 2: Kata na virtualização aninhada (o gate)
Testei isso primeiro, porque decide as partes 3 e 6. O servidor rejeita gVisor junto com uma egress policy (HTTP 400), então para sandboxes de container com egress a escolha é runc ou Kata, o único dos dois com isolamento por VM, e o Kata precisa de KVM. Sem KVM na virtualização aninhada, a série precisaria de um node bare-metal.
Usei o kata-deploy 3.32.0, a última release 3.x (22 de junho de 2026). O Kata Containers 4.x já saiu (4.3.1 em 21 de outubro de 2026), e a 4.0 tornou o runtime em Rust o padrão; eu fiquei na linha 3.x, para a qual o guia de secure container do OpenSandbox foi escrito (ele fixa a 3.27.0). A linha 3.x está deprecated, não abandonada: as notas da 4.0 prometem correções críticas e de CVE para o runtime em Go durante o período de deprecation. A instalação, com as variáveis do script preenchidas:
helm upgrade --install kata-deploy oci://ghcr.io/kata-containers/kata-deploy-charts/kata-deploy \
  --version 3.32.0 --namespace kube-system \
  --set shims.disableAll=true \
  --set shims.qemu.enabled=true \
  --set shims.clh.enabled=true \
  --set 'snapshotter.setup={}' \
  --set kubectlImage.tag=v1.37.1
O kata-deploy é um DaemonSet privilegiado. Em cada node, ele copia os binários do Kata, o kernel guest e a imagem guest para /opt/kata, grava um drop-in do containerd com um runtime por shim e o importa a partir do /etc/containerd/config.toml, reinicia o containerd e aplica no node o label katacontainers.io/kata-runtime=true, que as RuntimeClasses usam como seletor.
Em nodes novos, a fase do kata-deploy levou 1 minuto e 4 segundos (a execução inteira, incluindo os pods de teste, 1m 34s). Essa execução usou uma versão anterior do script, que rotulava a linha de instalação de outra forma e não mostrava a tabela de RuntimeClasses; o código de medição de tempo é o mesmo:
== kata-deploy 3.32.0
chart 3.32.0 installed (revision 1); waiting for the DaemonSet on every node
       +6s  kata-deploy 0/2 ready   nodes Ready 2/2
      +56s  kata-deploy 2/2 ready   nodes Ready 2/2
  ip-10-60-10-104.ec2.internal   pull 33.66s (1.6 GB)   install 16s   containerd restart 20:49:09, back in 0.4s
  ip-10-60-61-61.ec2.internal    pull 33.884s (1.6 GB)   install 16s   containerd restart 20:49:10, back in 0.5s
   took 1m 04s
A maior parte disso é a imagem de 1,6 GB do kata-deploy (1.599.460.395 bytes, como o kubelet reportou), baixada nos dois nodes em paralelo em cerca de 34 segundos. Dos 16 segundos de instalação, 12 são o kata-deploy verificando que o label do node se mantém (seis verificações, com dois segundos de intervalo, segundo o log dele). Repare nos timestamps: a primeira instalação reinicia o containerd em todo node ao mesmo tempo, com um segundo de diferença aqui.
Depois, o gate: o mesmo pod spec (amazonlinux:2023, imprimindo uname -r e quantas CPUs têm a flag hypervisor) sob kata-qemu, kata-clh e runc. A execução com o script publicado já tinha a imagem do kata-deploy nos nodes, depois de um uninstall e reinstall (seção do gate, cortada):
== Kata gate (test pods)
  RUNTIME    NODE                          KERNEL (uname -r)                HYPERVISOR FLAG  CREATED TO RUNNING
  kata-qemu  ip-10-60-10-104.ec2.internal  6.18.35                          on 1 CPU         3s (sandbox ready at 2s)
  kata-clh   ip-10-60-61-61.ec2.internal   6.18.35                          on 1 CPU         2s (sandbox ready at 2s)
  runc       ip-10-60-61-61.ec2.internal   6.18.56-125.164.amzn2023.x86_64  on 8 CPUs        1s (sandbox ready at 0s)

  The VM behind each Kata pod, read on its node by a privileged debug pod (kubectl debug --profile=sysadmin):
  kata-test      qemu-system-x86_64  RSS  272 MiB   -machine q35,accel=kvm,nvdimm=on   KVM fds: 1 VM, 1 vCPU
  kata-clh-test  cloud-hypervisor    RSS  153 MiB   KVM fds: 1 VM, 1 vCPU
  On the nodes: Kata 3.32.0, QEMU 11.0.1, Cloud Hypervisor 51.1, guest kernel 6.18.35-197

  PASS  kata-qemu
          ok   kata-test Running on ip-10-60-10-104.ec2.internal after 3s (limit 5m 00s)
          ok   guest kernel 6.18.35 is not the node's kernel (6.18.56-125.164.amzn2023.x86_64)
          ok   qemu-system-x86_64 runs the guest under KVM
  PASS  kata-clh
          ok   kata-clh-test Running on ip-10-60-61-61.ec2.internal after 2s (limit 5m 00s)
          ok   guest kernel 6.18.35 is not the node's kernel (6.18.56-125.164.amzn2023.x86_64)
          ok   cloud-hypervisor runs the guest under KVM
  ok    Kata gate passed on kata-qemu; kata-clh passed too
O resto daquela execução: instalação, RuntimeClasses e saúde do cluster
$ ./02_kata.sh

== kata-deploy 3.32.0
chart 3.32.0 installed (revision 1); waiting for the DaemonSet on every node
       +6s  kata-deploy 0/2 ready   nodes Ready 2/2
      +28s  kata-deploy 2/2 ready   nodes Ready 2/2
  ip-10-60-10-104.ec2.internal   image already on the node   ready after 20s  containerd restart 21:49:59, back in 0.4s
  ip-10-60-61-61.ec2.internal    image already on the node   ready after 20s  containerd restart 21:49:59, back in 0.4s
   took 35s

== RuntimeClasses
  NAME        HANDLER     CPU OVERHEAD  MEMORY OVERHEAD  NODE SELECTOR                         KATA
  kata-clh    kata-clh    250m          130Mi            katacontainers.io/kata-runtime=true   3.32.0
  kata-qemu   kata-qemu   250m          160Mi            katacontainers.io/kata-runtime=true   3.32.0
  ok    RuntimeClass kata-qemu
  ok    RuntimeClass kata-clh
  ok    2 of 2 nodes labelled katacontainers.io/kata-runtime=true
   took 2s
...
== cluster health
  ok    ip-10-60-10-104.ec2.internal stayed Ready throughout (Ready since 2026-10-31T20:21:43Z)
  ok    ip-10-60-61-61.ec2.internal stayed Ready throughout (Ready since 2026-10-31T20:21:42Z)
  ok    aws-load-balancer-controller 2/2 ready
  ok    eks-pod-identity-agent 2/2 ready
  ok    kata-deploy 2/2 ready
  ok    every namespace (6 DaemonSets, 3 Deployments, 16 Pods): nothing that was ready before this run is not ready now
  ok    no container restarted in any namespace during this run
   took 6s

== Timings
  kata-deploy 3.32.0                   35s
  RuntimeClasses                        2s
  Kata gate (test pods)                28s
  cluster health                        6s
  total                             1m 15s
Kata gate passed on kata-qemu; kata-clh works too, and both run pods in their own VMs on these nodes
O gate passou na primeira tentativa. Uma flag hypervisor sozinha não prova nada no EC2, porque o node é ele próprio uma VM e o runc vê a flag nas 8 vCPUs. O que prova:
- Um kernel diferente. Cada pod Kata sobe o seu próprio kernel guest, 6.18.35, enquanto o runc reporta o 6.18.56 do node: mesma série, build diferente.
- vCPUs próprias. O guest Kata tem uma vCPU (o padrão do Kata) contra as oito do node.
- Um VMM de verdade sob KVM. O processo por trás de cada pod Kata é o
qemu-system-x86_64com-machine q35,accel=kvm, ou ocloud-hypervisor, cada um com uma VM KVM e um descritor de vCPU. O QEMU usa KVM dentro da instância EC2, não emulação por software.
Um pod Kata foi de criado a Running em 1 a 3 segundos nas três execuções gravadas (2 s na execução de instalação a frio, 3 s e 1 s nas seguintes), contra 0 a 1 segundo para o runc. Os timestamps da API têm resolução de 1 segundo, então não tire conclusões demais deles; a estimativa do próprio projeto para o QEMU é de cerca de 500 ms, que eu não medi. Para a parte 6: a memória residente do QEMU foi de 272 MiB e a do Cloud Hypervisor de 153 MiB nas duas execuções gravadas com o script publicado, contra overheads de RuntimeClass de 160Mi e 130Mi por pod (uma amostra ociosa cada).
A nova execução convergiu em 51 segundos com manifests idênticos e pods do DaemonSet inalterados. O helm uninstall kata-deploy -n kube-system --wait levou de 12 a 14 segundos e deixou só uma linha imports = [] vazia e inofensiva no config.toml. O servidor continua usando runc até a parte 3 definir [secure_runtime] type = "kata" e k8s_runtime_class = "kata-qemu".
Teste 3: Nove imagens para o ECR
A primeira cópia não foi limpa, o que a torna a execução mais útil de mostrar. Ela usou uma versão anterior do script, que ainda puxava o Python do Docker Hub:
A primeira cópia: oito de nove imagens, depois o rate limit do Docker Hub
$ ./03_images.sh

== ECR login
  ok    logged in to 123456789012.dkr.ecr.us-east-1.amazonaws.com (token valid for 12 hours, kept in a throwaway Docker config)
   took 1s

== copy 9 images to ECR
  copy  opensandbox-eks/server:release-1.2.0           from docker.io/opensandbox/server:release-1.2.0  27s
  copy  opensandbox-eks/execd:release-1.2.0            from docker.io/opensandbox/execd:release-1.2.0  22s
  copy  opensandbox-eks/ingress:release-1.2.0          from docker.io/opensandbox/ingress:release-1.2.0  21s
        rate limited (HTTP 429); waiting 15s before attempt 2 of 5
        rate limited (HTTP 429); waiting 30s before attempt 3 of 5
        rate limited (HTTP 429); waiting 60s before attempt 4 of 5
        rate limited (HTTP 429); waiting 120s before attempt 5 of 5
  skip  opensandbox-eks/egress:release-1.2.0           cannot read source docker.io/opensandbox/egress:release-1.2.0: unexpected status from HEAD request to https://registry-1.docker.io/v2/opensandbox/egress/manifests/release-1.2.0: 429 Too Many Requests
        rate limited (HTTP 429); waiting 15s before attempt 2 of 5
        rate limited (HTTP 429); waiting 30s before attempt 3 of 5
        rate limited (HTTP 429); waiting 60s before attempt 4 of 5
        rate limited (HTTP 429); waiting 120s before attempt 5 of 5
  copy  opensandbox-eks/image-committer:release-1.2.0  from docker.io/opensandbox/image-committer:release-1.2.0  4m 24s
  copy  opensandbox-eks/controller:release-1.2.0       from docker.io/opensandbox/controller:release-1.2.0  42s
  copy  opensandbox-eks/task-executor:release-1.2.0    from docker.io/opensandbox/task-executor:release-1.2.0  27s
  copy  opensandbox-eks/nodeagent:release-1.2.0        from docker.io/opensandbox/nodeagent:release-1.2.0  26s
  copy  opensandbox-eks/python:3.12-slim               from docker.io/library/python:3.12-slim  54s
   copied 8, already in ECR 0
   took 11m 54s
...
== Timings
  ECR login                             1s
  copy 9 images to ECR             11m 54s
  verify ECR against source            17s
  total                            12m 12s
Rate limited 9 time(s) (HTTP 429); waited 7m 30s in all
1 of 9 images are not in ECR as they should be:
  opensandbox-eks/egress:release-1.2.0
Run ./03_images.sh to copy them (details: logs/03-images.log)
O script saiu com código 1 e nomeou a imagem que faltava. Rodar de novo copiou só a egress (30 segundos), 1 minuto e 20 segundos no total. O Docker documenta 100 pulls a cada 6 horas para usuários anônimos, por endereço IPv4 ou /64 IPv6; os headers que recebi diziam ratelimit-limit: 100;w=3600, uma janela de uma hora, para um /64 IPv6. Todo GET de manifest conta, incluindo leituras de digest e cada arquitetura de uma cópia (checagens HEAD não contam, segundo a documentação do Docker), e o meu debug de uma versão inicial do script tinha gastado parte da cota. O script publicado calcula o hash do índice bruto de cada origem (um request por imagem), limita o backoff a 15 minutos por execução, e para de consultar um registry que ainda responde 429 depois das quatro novas tentativas de uma imagem. Sem throttling, as nove cópias levaram cerca de 4 minutos e 48 segundos, de 21 a 54 segundos cada, do Mac para o ECR.
O Python agora vem do ECR Public, com o mesmo digest de índice do Docker Hub (sha256:aa943ce411423c7582288f18707ff66eddcbaeb510502d747a72aeb34f30d159). A 3.12-slim é uma tag móvel, então uma nova execução mais tarde copia uma imagem mais nova; tenha isso em mente ao comparar números entre as partes. O mirror do próprio projeto no Alibaba Cloud serve o mesmo digest de execd, mas o docker buildx imagetools recebe insufficient_scope dele.
Uma imagem faltando é a falha que dói depois: ImagePullBackOff e um create de sandbox que dá timeout sem nenhuma pista do motivo. Por isso o script termina conferindo cada digest no ECR. Apaguei uma tag e rodei só a verificação (cortado):
$ aws ecr batch-delete-image --repository-name opensandbox-eks/nodeagent --image-ids imageTag=release-1.2.0
$ ./03_images.sh --verify-only
...
  FAIL  opensandbox-eks/nodeagent:release-1.2.0        missing from ECR (source sha256:e1d0adbd58b9)
  ok    opensandbox-eks/python:3.12-slim               sha256:aa943ce41142
...
1 of 9 images are missing from ECR or could not be checked:
  opensandbox-eks/nodeagent:release-1.2.0
Run ./03_images.sh again to copy them (details: logs/03-images.log)
Ele saiu com código 1 após 14 segundos. Uma execução normal então restaurou a imagem em 4 segundos (os manifests de plataforma ainda estavam no repositório, então só o índice recebeu push) e terminou em 23 segundos com todas as nove ok. Uma execução sem nada para copiar leva 21 segundos. Os nove repositórios somam 1,51 GiB, um limite superior porque layers compartilhadas são cobradas uma vez só. Se você checar o scan por repositório, o describe-repositories mostra scanOnPush: False em todos, porque a regra fica no nível do registry; o scan amd64 da imagem do servidor chegou a terminar, com 4 achados de severidade alta, 9 média e 3 baixa.
Teste 4: Base, controller e server, e a API key vazia
Primeiro, os charts como vêm. Eu os renderizei e instalei o chart do servidor com os defaults dele, exceto a imagem, que apontei para o ECR para que a falha fosse a configuração e não um pull de imagem (saída cortada):
$ for c in controller server ingress-gateway node-agent; do helm template demo .src/OpenSandbox/manifests/charts/$c; done | grep -oE "[a-z0-9.-]+aliyuncs\.com/[^\" ]+" | sort -u
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/controller:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/egress:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/execd:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/image-committer:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/ingress:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/nodeagent:release-1.2.0
sandbox-registry.cn-zhangjiakou.cr.aliyuncs.com/opensandbox/server:release-1.2.0

$ helm install opensandbox-server .src/OpenSandbox/manifests/charts/server -n opensandbox-system --create-namespace --hide-notes --set server.image.repository=$ECR_REGISTRY/opensandbox-eks/server
NAME: opensandbox-server
STATUS: deployed
REVISION: 1

$ kubectl -n opensandbox-system get deploy opensandbox-server -o jsonpath="{.spec.template.spec.containers[0].resources}{\"\n\"}"
{"limits":{"cpu":"2","memory":"8Gi"},"requests":{"cpu":"1","memory":"4Gi"}}

$ kubectl -n opensandbox-system get pods
NAME                                  READY   STATUS    RESTARTS      AGE
opensandbox-server-6c4c5557df-5l2fv   0/1     Running   2 (14s ago)   24s

$ kubectl -n opensandbox-system logs deploy/opensandbox-server --previous | tail -n 4
INFO:     2026-10-31 23:02:24+0000 [-] uvicorn.error: Started server process [1]
INFO:     2026-10-31 23:02:24+0000 [-] uvicorn.error: Waiting for application startup.
ERROR:    2026-10-31 23:02:24+0000 [-] opensandbox_server.main: API key startup confirmation failed: Startup blocked: server.api_key is empty in non-interactive mode. Set OPENSANDBOX_INSECURE_SERVER=YES to acknowledge the risk. Strongly recommend setting server.api_key. See: https://github.com/opensandbox-group/OpenSandbox/issues/750

$ helm install opensandbox-base .src/OpenSandbox/manifests/charts/base -n opensandbox-system
Error: INSTALLATION FAILED: unable to continue with install: Namespace "opensandbox-system" in namespace "" exists and cannot be imported into the current release: invalid ownership metadata; label validation error: missing key "app.kubernetes.io/managed-by": must be set to "Helm"; ...
Quatro linhas da tabela numa única tela. A recusa do servidor é o default certo: sem uma key, ele só sobe se uma pessoa digitar YES num terminal ou se você definir OPENSANDBOX_INSECURE_SERVER=YES, e uma API de lifecycle sem autenticação pode criar pods no seu cluster. O conflito de namespace tem uma nuance: no Helm 4.3.1, --create-namespace num namespace que ainda não existe funciona. Aqui falha porque o Secret, o PVC e o template precisam existir antes do chart do servidor, então o namespace já está lá.
Depois, a instalação com os arquivos de values, do zero:
$ ./04_install.sh

== OpenSandbox release-1.2.0 source
  fetched https://github.com/opensandbox-group/OpenSandbox.git at release-1.2.0 (62a64f0b48cd) into .src/OpenSandbox
  charts base, controller and server: version 1.2.0
   took 4s

== namespaces, storage, API key
  namespace/opensandbox-system created
  namespace/opensandbox created
  storageclass.storage.k8s.io/gp3-encrypted created
  persistentvolumeclaim/opensandbox-server-data created
  configmap/opensandbox-batchsandbox-template created
  API key: none in .env, generated a random one and saved it there as OSB_API_KEY (mode 600)
  secret/opensandbox-server-auth created
   took 8s
...
== checks
  ok    opensandbox-controller-manager-bfb67cd44-hw2qk Running and ready, 0 restarts, on ip-10-60-10-104.ec2.internal (us-east-1a)
  ok    opensandbox-server-64bd45d9-dnwll Running and ready, 0 restarts, on ip-10-60-10-104.ec2.internal (us-east-1a)
  ok    server /health: {"status":"healthy"}
  ok    server /version: 1.2.0
  ok    all 5 images come from ECR (opensandbox-eks/): controller:release-1.2.0 egress:release-1.2.0 execd:release-1.2.0 image-committer:release-1.2.0 server:release-1.2.0
  ok    PVC opensandbox-server-data Bound to EBS vol-05ae2ed39c1246004: 1 GiB gp3, encrypted, us-east-1a
  ok    /data/opensandbox.db on the PVC: 28672 bytes, modified 2026-10-31 23:33:20
  ok    CRDs: 3 sandbox.opensandbox.io (BatchSandbox, Pool, SandboxSnapshot), 4 sandbox.fast.io
  ok    sandbox namespace opensandbox (Pod Security: privileged)
  opensandbox-controller-manager: requests 10m CPU / 64Mi, limits 500m / 128Mi
  opensandbox-server: requests 250m CPU / 512Mi, limits 1 / 2Gi
  config.toml: runtime kubernetes, sandboxes in namespace opensandbox, template /etc/opensandbox-custom/batchsandbox-template.yaml
               store sqlite at /data/opensandbox.db, egress dns+nft, ingress direct
   took 13s

== Timings
  OpenSandbox release-1.2.0 source        4s
  namespaces, storage, API key          8s
  base chart                           10s
  controller                           21s
  server                               24s
  checks                               13s
  total                             1m 20s
Um minuto e 20 segundos, de primeira, sem restarts. A key chega ao Secret pela entrada padrão com um server-side apply, então nunca aparece nos argumentos de um processo nem numa annotation last-applied-configuration, e o script nunca a imprime. Os 24 segundos do servidor incluem provisionar e anexar o volume EBS dele (cerca de 3 segundos cada). Os pulls do ECR foram rápidos: 2,57 segundos para os 103 MB do controller, e 1,86 segundo para os 70 MB do servidor na execução com os defaults. As verificações de /health e /version rodam dentro do pod com kubectl exec; qualquer coisa que dependa do API server fazendo proxy para um pod, ou de um webhook servido em outra porta, esbarra na linha do security group da tabela.
Depois, as verificações que um leitor faria à mão: a API por um port-forward, com e sem a key, e um restart do servidor para provar que o banco de dados está no volume (cortado; OSB_API_KEY é lido do .env antes; esta execução gravada usou a porta local 8080, e os scripts usam 18080 por padrão):
$ kubectl -n opensandbox-system port-forward svc/opensandbox-server 8080:80 >/dev/null & sleep 3
$ curl -s http://127.0.0.1:8080/version; echo
{"version":"1.2.0"}
$ curl -s -o /dev/null -w "%{http_code}\n" -H "OPEN-SANDBOX-API-KEY: $OSB_API_KEY" http://127.0.0.1:8080/v1/sandboxes
200
$ curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8080/v1/sandboxes
401
$ curl -s -H "OPEN-SANDBOX-API-KEY: $OSB_API_KEY" http://127.0.0.1:8080/v1/sandboxes; echo
{"items":[],"pagination":{"page":1,"pageSize":20,"totalItems":0,"totalPages":0,"hasNextPage":false}}

$ kubectl -n opensandbox-system exec deploy/opensandbox-server -- stat -c "%n  %s bytes  created %w" /data/opensandbox.db
/data/opensandbox.db  28672 bytes  created 2026-10-31 23:33:20.534560790 +0000
$ kubectl -n opensandbox-system delete pod -l app.kubernetes.io/name=opensandbox-server
pod "opensandbox-server-64bd45d9-rpjw5" deleted from opensandbox-system namespace
$ kubectl -n opensandbox-system wait pod -l app.kubernetes.io/name=opensandbox-server --for=condition=Ready --timeout=120s
pod/opensandbox-server-64bd45d9-wmr2p condition met
$ kubectl -n opensandbox-system exec deploy/opensandbox-server -- stat -c "%n  %s bytes  created %w" /data/opensandbox.db
/data/opensandbox.db  28672 bytes  created 2026-10-31 23:33:20.534560790 +0000
O servidor cria o banco de dados na inicialização, então o arquivo existir não prova nada; o horário de criação inalterado prova: mesmo arquivo, mesmo volume EBS. O novo pod ficou Ready 11,5 segundos depois do delete. O volume fica em us-east-1a, então o servidor só pode rodar no node dessa zona, o que combina com a réplica única e a estratégia Recreate do chart.
Rodar o ./04_install.sh de novo levou 58 segundos e não mudou nada: cada release ganhou uma nova revisão com manifests idênticos, e os dois pods ficaram inalterados, com zero restarts. O chart base é o passo lento (18 segundos para manifests idênticos), muito provavelmente o Helm reaplicando as sete CRDs. Numa execução de dev não gravada, eu quebrei a tag da imagem do servidor de propósito: a instalação falhou depois de 101 segundos e imprimiu os eventos ImagePullBackOff do pod, e com a tag corrigida, a execução seguinte substituiu o pod e saiu com 0.
Teste 5: O ingress gateway atrás de um NLB
Os pods de sandbox só têm endereços privados da VPC, então comandos, arquivos e o PTY precisam de uma entrada a partir de fora do cluster. A resposta do OpenSandbox é o ingress gateway, um reverse proxy que roteia cada request para um sandbox. O 05_gateway.sh instala o chart dele, coloca um NLB na frente e diz ao servidor para entregar endpoints do gateway. A API do servidor em si nunca passa pelo NLB.
Os values do gateway (cortados e reformatados):
gateway:
  image:
    repository: ${ECR_REGISTRY}/${ECR_PREFIX}/ingress
    tag: release-1.2.0
  replicaCount: 2              # spread across the two zones: a healthy NLB target in each
  gatewayRouteMode: header     # route on OpenSandbox-Ingress-To: <sandbox-id>-<port>
  resources:
    requests: { cpu: 100m, memory: 128Mi }
    limits:   { cpu: "1", memory: 512Mi }
  podSecurityContext:
    runAsNonRoot: true
    runAsUser: 65532
    runAsGroup: 65532
    seccompProfile: { type: RuntimeDefault }
  containerSecurityContext:
    allowPrivilegeEscalation: false
    readOnlyRootFilesystem: true
    capabilities: { drop: [ALL] }
O NLB vem de um segundo Service que seleciona os pods do gateway (cortado; comentários meus):
apiVersion: v1
kind: Service
metadata:
  name: opensandbox-gateway-nlb
  namespace: opensandbox-system
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-scheme: internet-facing
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: ip   # straight to the pod IPs
    service.beta.kubernetes.io/aws-load-balancer-healthcheck-protocol: http
    service.beta.kubernetes.io/aws-load-balancer-healthcheck-path: /status.ok
    service.beta.kubernetes.io/aws-load-balancer-attributes: load_balancing.cross_zone.enabled=true
spec:
  type: LoadBalancer
  loadBalancerClass: service.k8s.aws/nlb    # the LB Controller; immutable once created
  allocateLoadBalancerNodePorts: false
  loadBalancerSourceRanges:
    - "${MY_IP}/32"                          # filled in on every run
  selector:
    app.kubernetes.io/name: opensandbox-ingress-gateway
    app.kubernetes.io/instance: opensandbox-ingress-gateway
  ports:
    - name: http
      port: 80
      targetPort: http   # the gateway's 28888
      protocol: TCP
O ${MY_IP} é o meu endereço público, do checkip.amazonaws.com, consultado a cada execução; MY_IP= o sobrescreve. O listener é TCP puro, então o NLB repassa intacto o HTTP/1.1 em texto claro do gateway, incluindo upgrades de WebSocket. O servidor precisa do nome DNS do NLB como host do gateway, que só existe depois que o NLB existe, então o script espera por ele, grava um arquivo de values no gitignore e roda o 04_install.sh, que adiciona o arquivo à release do servidor nesta e em todas as execuções seguintes (o nome do NLB é o placeholder):
# Written by 05_gateway.sh, read by 04_install.sh. Gitignored: it holds this cluster's NLB
# DNS name. Run ./05_gateway.sh again instead of editing it.
server:
  gateway:
    enabled: true
    host: osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com
    gatewayRouteMode: header
O chart renderiza isso como [ingress] mode = "gateway" no TOML do servidor.
./05_gateway.shA primeira execução começou sem gateway e sem NLB. O script mede cada marco do NLB a partir do kubectl apply:
== network load balancer
  service/opensandbox-gateway-nlb created
  DNS name in the Service status                     after 10s
    osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com
  security group: tcp/80 from 203.0.113.10/32 only   after 12s
  NLB active                                         after 2m 24s
  gateway pods healthy in the target group           after 2m 26s
  gateway answers from here                          after 2m 28s
   took 2m 29s
A primeira execução inteira: gateway, NLB, upgrade do servidor e verificações
$ ./05_gateway.sh

== your public IP
  the NLB will accept 203.0.113.10/32 only (from checkip.amazonaws.com)
   took 0s

== ingress gateway
  opensandbox-ingress-gateway: installed, revision 1
  pods started: opensandbox-ingress-gateway-6ff9ff8ddb-5t2mb opensandbox-ingress-gateway-6ff9ff8ddb-sd6p8
   took 18s
...
== server
  values/server-gateway.yaml written: gateway.enabled true, host osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com, route mode header
  upgrading the server with ./04_install.sh (full output in logs/04_install.log)
  04_install.sh: with values/server-gateway.yaml (the ingress gateway, from ./05_gateway.sh)
  04_install.sh: opensandbox-server: revision 9, manifests changed since revision 8
  04_install.sh: pod opensandbox-server-775f8ddf57-kt4qd replaced opensandbox-server-64bd45d9-4v665
   took 1m 11s

== checks
  ok    release opensandbox-ingress-gateway deployed (revision 1)
  ok    opensandbox-ingress-gateway-6ff9ff8ddb-5t2mb ready, 0 restarts, 10.60.8.79 on ip-10-60-10-104.ec2.internal (us-east-1a)
  ok    opensandbox-ingress-gateway-6ff9ff8ddb-sd6p8 ready, 0 restarts, 10.60.40.29 on ip-10-60-61-61.ec2.internal (us-east-1b)
  ok    image from ECR: opensandbox-eks/ingress:release-1.2.0
  ok    service/opensandbox-gateway-nlb loadBalancerSourceRanges ["203.0.113.10/32"]
  ok    NLB internet-facing, active, listener TCP:80, zones us-east-1a,us-east-1b
  ok    NLB security group: tcp/80 from 203.0.113.10/32 (no other rules)
  ok    NLB targets: 10.60.40.29:28888 healthy, 10.60.8.79:28888 healthy
  ok    http://osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com/status.ok from here: 200 in 224 ms
  ok    OpenSandbox-Ingress-To: no-such-sandbox-44772 -> 404 OpenSandbox Ingress: sandbox not found: no-such-sandbox
  ok    server config.toml [ingress]: mode=gateway gateway.address=osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com gateway.route.mode=header
  ok    server pod ready
   took 11s

== Timings
  your public IP                        0s
  ingress gateway                      18s
    NLB: DNS name                      10s
    NLB: security group                12s
    NLB: active                     2m 24s
    NLB: targets healthy            2m 26s
    NLB: answers from here          2m 28s
  network load balancer             2m 29s
  server                            1m 11s
  checks                               11s
  total                             4m 09s
O NLB levou dois minutos e meio dos quatro; uma primeira execução anterior, com uma versão antiga do script, ficou ativa após 2m 31s e respondeu após 2m 51s. A fase do servidor (1m 11s) é o 04_install.sh substituindo o pod do servidor com a nova config. Um request para um sandbox que não existe recebe o 404 do gateway, não um timeout.
Depois, um sandbox através dele. Um script Python curto cria um sandbox por um port-forward para o servidor (porta local 18080) e depois o alcança só pelo endpoint que o servidor retorna (cortado):
$ python gateway_check.py
created sandbox 7c4d8746-f764-4630-9599-bbec2d9fd6ba from opensandbox-eks/python:3.12-slim (ECR) in 1.9 s
(the SDK's readiness check already went through the endpoint below)

execd endpoint (port 44772) from the server: osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com
  headers: {'OpenSandbox-Ingress-To': '7c4d8746-f764-4630-9599-bbec2d9fd6ba-44772'}
  same host: yes
  resolves to 2 public NLB addresses, not the pod's 10.60.x.x

$ GET http://osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com/ping  with and without the routing header
  with OpenSandbox-Ingress-To: 200 (execd)
  without:                     400 OpenSandbox Ingress: invalid ingress route

commands.run through the gateway:
$ hostname; hostname -i; python3 --version
7c4d8746-f764-4630-9599-bbec2d9fd6ba-0
10.60.50.158
Python 3.12.16
exit code: 0

PTY over a WebSocket through the gateway:
  WebSocket upgrade: HTTP 101
  | bash-5.2# bash-5.2# tty; echo "6 x 7 = $((6*7))"; exit 3
  | /dev/pts/0
  | 6 x 7 = 42
  | exit
  shell exit code: 3

killed 7c4d8746-f764-4630-9599-bbec2d9fd6ba
sandboxes listed 3 s later: 0
O servidor respondeu com o nome do NLB mais um header de roteamento, e tudo depois disso (o readiness check do SDK, um comando e um shell interativo) passou pelo NLB até um pod com endereço privado. O upgrade de WebSocket do PTY retornou HTTP 101 e o exit code do shell voltou (o prompt duplicado é um redesenho depois do resize do terminal). Sem o header, o gateway responde 400.
OpenSandbox-Ingress-To, legível por qualquer coisa no caminho. O source range /32 é o único controle, e ele deixa entrar todo mundo atrás do mesmo endereço público, como o NAT de um escritório ou a saída de uma VPN. O OpenSandbox tem rotas assinadas para o gateway (secureAccess nos charts do servidor e do gateway), que eu não configurei. Isso é aceitável para este lab, cujos sandboxes não guardam credenciais reais, e para pouca coisa além disso.
Quando o meu endereço muda, uma nova execução move o /32. Para testar isso, passei outro endereço de documentação (cortado):
$ MY_IP=203.0.113.7 ./05_gateway.sh
  the NLB will accept 203.0.113.7/32 only (from MY_IP)
  WARN  this machine's public address is 203.0.113.10, not 203.0.113.7: it will be shut out of the gateway
...
  loadBalancerSourceRanges: ["203.0.113.10/32"] -> ["203.0.113.7/32"]
  security group: tcp/80 from 203.0.113.7/32 only    after 4s
...
  the server release already announces the gateway: ./04_install.sh not needed
...
  ok    this machine (203.0.113.10) gets no answer within 5 s: only 203.0.113.7/32 gets through
  total                                32s
This machine is shut out: run ./05_gateway.sh without MY_IP to let it back in.
O LB Controller reescreveu o security group do NLB 4 segundos depois que o Service mudou, e o servidor não foi tocado. Uma execução simples me deixou entrar de novo: security group após 4 segundos, o gateway respondendo após 7, 30 segundos no total. Mais uma execução sem nada para mudar levou 29 segundos e reportou cada passo como already ou unchanged. Se o seu endereço muda, o endpoint da API do EKS também recusa você, então rode o ./01_cluster.sh primeiro.
Teste 6: O console de desenvolvedor
O OpenSandbox 1.2.0 entrega o seu web console como código-fonte e manifests de exemplo, não como imagens. O ./06_console.sh build faz o build das duas metades, um web app servido pelo nginx e um BFF (backend for frontend) em Python, a partir do código da release-1.2.0 para linux/amd64, com imagens base do ECR Public, e faz o push delas para o ECR: 1 minuto e 9 segundos sem cache de build (web 37 s, BFF 32 s). O deploy aplica os manifests de exemplo editados com as imagens fixadas por digest, então um node nunca consegue rodar uma imagem antiga em cache sob a mesma tag.
A documentação do console sugere montar o mesmo arquivo de tenants no servidor e no BFF, o que colocaria o servidor em modo multi-tenant. Não é preciso. O BFF faz o login dos desenvolvedores contra o seu próprio tenants.toml e depois repassa a key do tenant para o servidor como um OPEN-SANDBOX-API-KEY simples. Um tenant cuja key é a própria API key do servidor basta, então a release do servidor não mudou. O arquivo de tenants, como o Secret o guarda (montado no BFF com modo 0400):
[[tenants]]
name = "default"
namespace = "opensandbox"
api_keys = ["${OSB_API_KEY}"]
As outras edições no Deployment de exemplo do BFF (um trecho, achatado; comentários meus):
image: ${ECR_REGISTRY}/${ECR_PREFIX}/console-bff@${BFF_DIGEST}
env:
  - name: LIFECYCLE_API_BASE
    value: "http://opensandbox-server.opensandbox-system.svc/v1"   # the example has :8090
  - name: BFF_COOKIE_SECURE
    value: "false"     # an http port-forward; the cookie stays HttpOnly and SameSite=Lax
  - name: BFF_CORS_ORIGINS
    value: "http://127.0.0.1:5173,http://localhost:5173"
O deploy funcionou de primeira, em 25 segundos (cortado):
$ ./06_console.sh deploy
...
== checks
  ok    BFF /health: {"status":"ok"}
  ok    web /health (nginx to the BFF Service): {"status":"ok"}
  ok    tenant login through the BFF: login 200 default; sandboxes 200 0 (through to the lifecycle server)
   took 5s
...
  total                                25s
The console is running. Open it with:
  kubectl --context osb-eks -n opensandbox-system port-forward svc/opensandbox-console-web 5173:80
then http://127.0.0.1:5173/login: sign in with OSB_API_KEY, or BFF_ADMIN_TOKEN as admin (both in .env)
Uma nova execução levou 13 segundos e deixou todo objeto unchanged. Pelo port-forward, entrei com a API key enquanto um sandbox estava rodando:
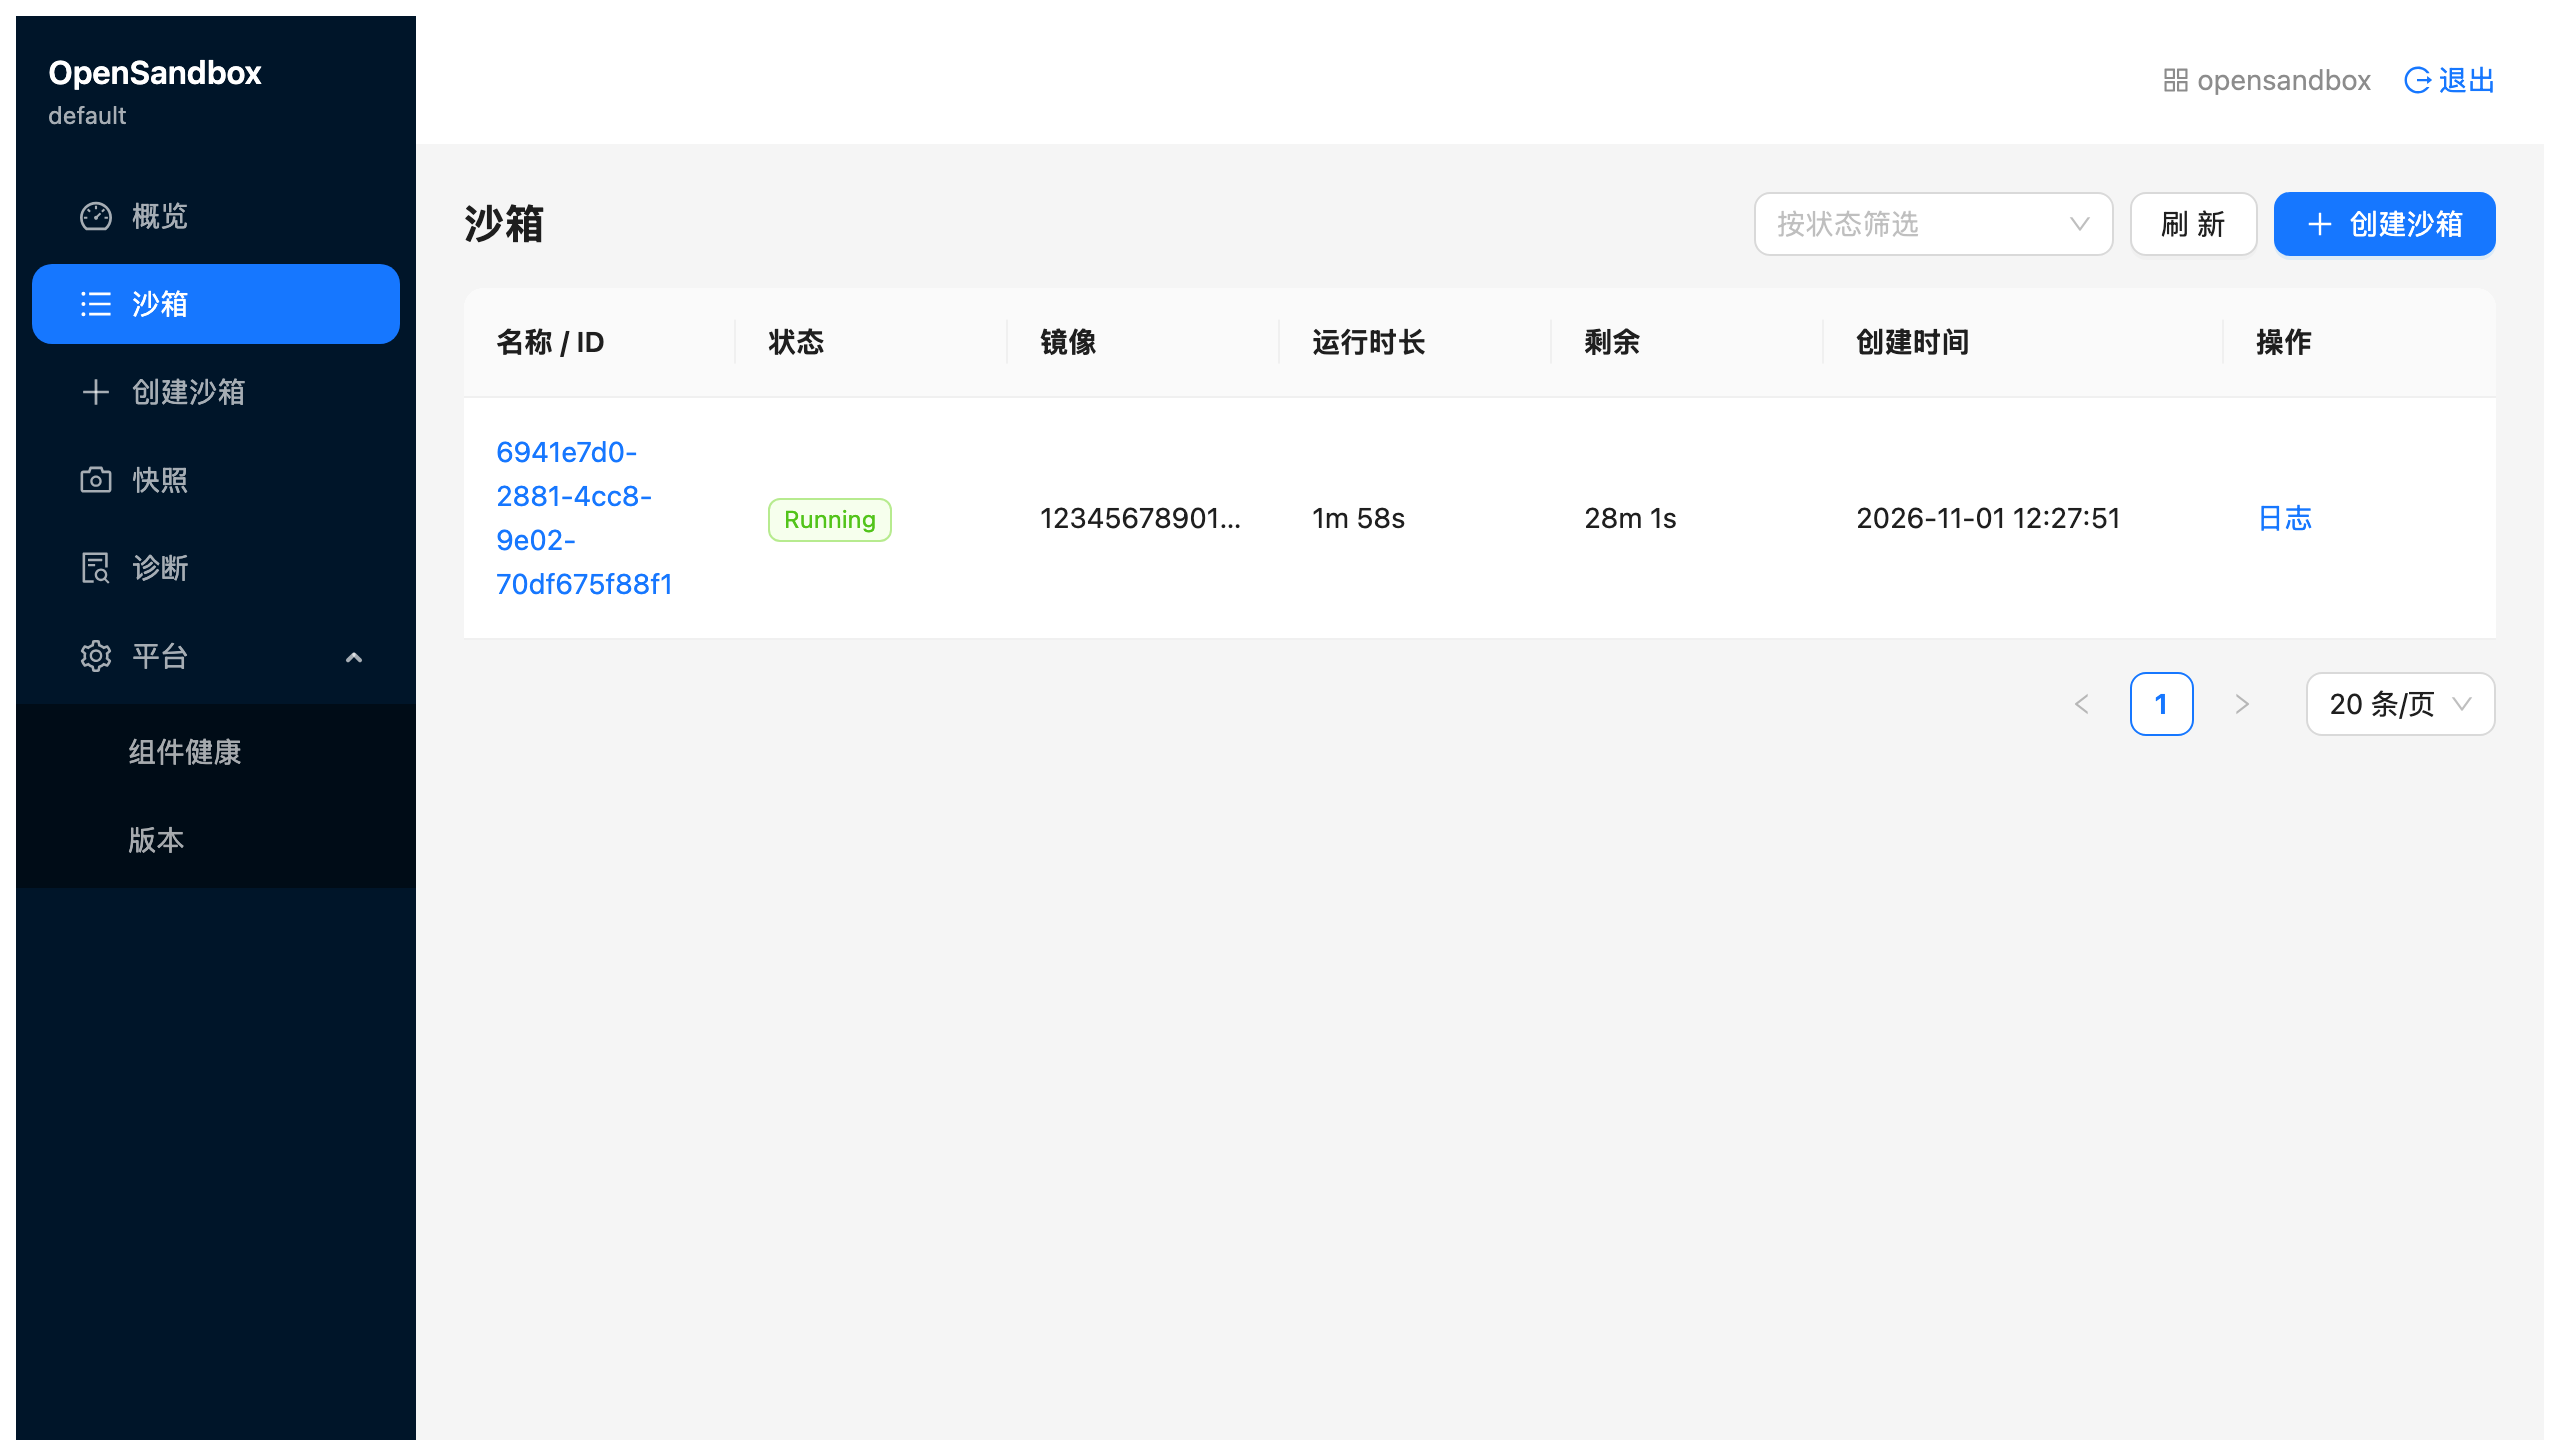
O console 1.2.0 é só em chinês: a barra lateral diz Visão geral, Sandboxes, Criar sandbox, Snapshots, Diagnósticos e Plataforma, e não existe locale em inglês. Ele também exibe as horas no horário padrão da China: o web app 1.2.0 tem Asia/Shanghai fixo no código, então o 12:27:51 da captura de tela é 04:27:51 UTC. O login cai numa visão geral com as contagens de sandboxes. Algumas coisas para saber antes de depender dele:
- O BFF roda como root. A imagem upstream não tem
USER; montar o arquivo de tenants com modo 0400 só funciona por causa disso. - O BFF lê no cluster inteiro. A ServiceAccount dele pode ler pods, events e Deployments em todo namespace, para as páginas de plataforma.
- O cookie de sessão não é Secure, porque o console é acessado por um port-forward http (o Safari o descartaria caso contrário). Atrás de HTTPS, defina
BFF_COOKIE_SECURE=true. Não há ingress. - Os digests não são fixos. Um build sem o cache dá ao BFF um novo digest, porque os requirements Python dele usam pins
>=.
Teste 7: Um primeiro sandbox no EKS
O 07_first_sandbox.py usa o SDK Python por um port-forward para o servidor na porta local 18080, porque outro serviço local agora ocupa a 8080 no meu Mac e responde 404, o que parece um servidor quebrado. O helper dele confere o corpo do /health, não só que algo respondeu. O script remove a referência da imagem Python dos dois nodes, mede um create, depois cinco a quente, e então roda um comando e um round trip de arquivo num sandbox pelo proxy do servidor e pelo gateway (cortado). Na saída dele, “cold” significa que o registro da imagem foi apagado do containerd enquanto as layers descompactadas ficaram no node, então não é um cold pull:
$ uv run python 07_first_sandbox.py
image   123456789012.dkr.ecr.us-east-1.amazonaws.com/opensandbox-eks/python:3.12-slim
server  127.0.0.1:18080 (port-forward), sandboxes tagged run=76f813213a95

== 1. cold create: the image is on no node
  ip-10-60-10-104.ec2.internal: image removed (5 s), debug pod deleted
  ip-10-60-61-61.ec2.internal: image removed (5 s), debug pod deleted
  cold                      2.5 s   node ip-10-60-61-61.ec2.internal   kubelet pulled the image in 90ms (43 MB)
...
== 3. command and file round trip, through the server proxy and through the gateway
  sandbox e41a7281-dc2c-436f-8123-e8eb1267f031
  server proxy: endpoint 127.0.0.1:18080/v1/sandboxes/e41a7281-dc2c-436f-8123-e8eb1267f031/proxy/44772
  server proxy: command -> hello from e41a7281-dc2c-436f-8123-e8eb1267f031-0 | Python 3.12.16
  server proxy: file round trip ok
  gateway: endpoint osb-gateway-0123456789abcdef.elb.us-east-1.amazonaws.com
  gateway: command -> hello from e41a7281-dc2c-436f-8123-e8eb1267f031-0 | Python 3.12.16
  gateway: file round trip ok
...
== Timing table
  case                     create   node                              note
  cold                       2.5s   ip-10-60-61-61.ec2.internal       kubelet pulled the image in 90ms (43 MB)
  cold, 2nd node             2.3s   ip-10-60-10-104.ec2.internal      kubelet pulled the image in 100ms (43 MB)
  warm 1                     2.2s   ip-10-60-10-104.ec2.internal      image already on the node
  warm 2                     2.7s   ip-10-60-10-104.ec2.internal      image already on the node
  warm 3                     2.6s   ip-10-60-10-104.ec2.internal      image already on the node
  warm 4                     2.3s   ip-10-60-10-104.ec2.internal      image already on the node
  warm 5                     2.5s   ip-10-60-10-104.ec2.internal      image already on the node

  warm median of 5: 2.5 s   (min 2.2, max 2.7)
  no create took longer than the server's 60 s sandbox_create_timeout_seconds
  total 46 s

all steps passed
As linhas “cold” não são um cold pull, e eu não tiraria delas um número de cold start. O script remove a imagem com ctr images rm, que apaga o nome da imagem, mas nesses nodes AL2023 as layers descompactadas ficam. Durante a instalação limpa no Teste 4, depois que as referências da imagem do servidor tinham sido removidas dos dois nodes com o mesmo ctr -n k8s.io images rm --sync, o pull do servidor levou 94 ms e, segundo o log do containerd, leu 0 bytes. Então os 90 a 100 ms do kubelet são o containerd encontrando as layers já lá, e 43 MB é o tamanho da imagem, não o que foi baixado (isso daria cerca de 480 MB/s, contra os 40 MB/s do pull genuíno do controller no Teste 4). O que a tabela mede de fato é o startup de um sandbox runc com a imagem no node: 2,2 a 2,7 segundos para o scheduling, o init container do execd e o readiness check, com mediana de 2,5 segundos. Um pull realmente a frio somaria o download por cima; na taxa do Teste 4, cerca de mais um segundo para esta imagem, o que eu não medi. O scheduler colocou o primeiro create “warm” no outro node, então o script o contou como um segundo create a frio. Em todas as minhas execuções, o create mais lento foi de 5,2 segundos, longe do limite de 60 segundos do servidor.
Os dois caminhos chegaram ao mesmo sandbox. Pelo proxy do servidor, o SDK chama /v1/sandboxes/<id>/proxy/44772 no port-forward e o servidor repassa para o execd; pelo gateway, ele obtém o nome do NLB a partir do servidor e vai direto para lá. O osb sandbox list mostrou o sandbox Running, e o script apagou só os sandboxes que ele tinha criado, usando um valor run que ele anexa como metadata (que vira um label do pod).
Para as sobras de uma execução que quebrou, o 98_delete_sandboxes.py apaga tudo que o servidor lista, página por página. Com três sandboxes e um tamanho de página de 2, ele imprimiu deleted 3, e o osb sandbox list então respondeu No sandboxes found.
Resumo dos resultados
| Passo | Execução gravada | Outras execuções | Notas |
|---|---|---|---|
01_cluster.sh (64 recursos) | 13m 50s; apply 13m 07s | 36 s, sem mudanças | Control plane do EKS 9m 50s |
02_kata.sh | 1m 34s a frio; fase do kata-deploy 1m 04s (pull de 1,6 GB, cerca de 34 s por node) | 1m 15s com cache; 51 s na nova execução | Pod Kata Running em 1 a 3 s, runc em 0 a 1 s |
03_images.sh, nove imagens | 12m 12s, exit 1 (7m 30s de backoff por 429) | 1m 20s para a imagem que faltava; 21 s sem nada para copiar | Cerca de 4m 48s de cópia sem throttling |
| Imagem faltando encontrada e restaurada | 14 s, exit 1, nomeia a imagem | 23 s para restaurar | |
04_install.sh do zero | 1m 20s | 58 s na nova execução, sem mudanças | Pod do servidor substituído e Ready em 11,5 s |
05_gateway.sh, NLB novo | 4m 09s: NLB ativo em 2m 24s, respondendo em 2m 28s | 32 s com IP novo; 30 s de volta; 29 s sem mudança | Primeira execução anterior: ativo em 2m 31s, respondendo em 2m 51s |
06_console.sh | build 1m 09s sem cache; deploy 25 s | 13 s na nova execução, sem mudanças | |
07_first_sandbox.py | 46 s | Create de sandbox runc em 2,2 a 2,7 s, mediana 2,5 s, com as layers da imagem no node | |
98_delete_sandboxes.py | 3 sandboxes em 2 páginas, deleted 3 | ||
08_scale.sh down | 17m 08s (update 33 s; primeiro node fora em cerca de 3 min, o segundo no fim) | Um node é cobrado até sumir | |
08_scale.sh up | 2m 31s | Kata reinstalado; volume do servidor de volta em us-east-1a |
Somando as primeiras execuções gravadas, uma conta vazia chega a um primeiro sandbox em cerca de 28 minutos de tempo de script se o Docker Hub não fizer throttling da cópia (cerca de 5 minutos para as imagens). A minha execução, com a cópia limitada e a nova execução dela, levou cerca de 37.
Preços
O OpenSandbox é gratuito. O cluster cobra por hora, rodando sandbox ou não. Discriminado item a item, com base no que os scripts criaram, nos preços on-demand de us-east-1:
| Recurso | Preço | Por hora |
|---|---|---|
| Control plane do EKS (suporte padrão) | $0,10/h | $0,1000 |
2 × m7i.2xlarge (virtualização aninhada sem custo extra) | $0,4032/h cada | $0,8064 |
| NAT gateway | $0,045/h, mais $0,045 por GB processado | $0,0450 |
| Network Load Balancer | $0,0225/h, mais $0,006 por NLCU-hora usada | $0,0225 |
| Endereços IPv4 públicos: o do NAT gateway e os dois do NLB | $0,005/h cada | $0,0150 |
| EBS gp3: 2 × 100 GiB de volumes raiz dos nodes e o volume de 1 GiB do servidor | $0,08/GB-mês | $0,0220 |
Storage do ECR: 1,51 GiB das nove cópias, mais cerca de 0,10 GiB das duas imagens do console (21 MB e 87 MB, da minha própria consulta describe-images) | $0,10/GB-mês | $0,0002 |
| S3 gateway endpoint, IAM, EKS Pod Identity, scan básico do ECR | grátis | $0 |
| Total, ocioso | $1,011/h, cerca de $24,27 por dia |
As duas instâncias são cerca de 80% da conta. A cobrança por GB do NAT gateway fica pequena, porque as layers do ECR passam pelo S3 endpoint gratuito e as cópias do Docker Hub rodaram a partir do meu Mac. A exceção é a imagem de 1,6 GB do kata-deploy, que cada node novo baixa do quay.io pelo NAT gateway: cerca de $0,07 por node.
Com zero nodes, as instâncias e os volumes raiz delas somem. O control plane, o NAT gateway, o NLB, os três endereços deles, o volume do servidor e o ECR ficam: cerca de $0,18 por hora, $4,39 por dia. Chegar lá leva cerca de 17 minutos: um node sai em cerca de 3, e o outro é cobrado até o fim (cerca de $0,14 no total). O NLB não é do Terraform e não faz parte do node group, então continua cobrando até o Service dele ser apagado. Só o teardown chega a $0.
Limpeza
Entre sessões, escale o node group para zero, e de volta quando precisar:
./08_scale.sh down
./08_scale.sh up
O down define o tamanho desejado como 0 e espera os nodes saírem. Na minha execução gravada, o update do node group levou 33 segundos. O primeiro node sumiu em cerca de 3 minutos; o segundo levou mais 14, até o limite de eviction de 15 minutos do EKS encerrar o drain dele (não descobri qual pod o segurou). O up levou 2m 31s e verifica o que uma substituição de nodes poderia quebrar (cortado):
== kata-deploy on the new nodes
  ok    kata-deploy labelled 2 nodes
  ok    RuntimeClass kata-qemu exists
  ok    ip-10-60-15-81.ec2.internal: containerd imports the kata-deploy drop-in; the kata shim is installed
  ok    ip-10-60-36-30.ec2.internal: containerd imports the kata-deploy drop-in; the kata shim is installed
   took 1m 12s

== a pod under kata-qemu
  ok    kata-qemu pod ran in its own VM on ip-10-60-15-81.ec2.internal: guest kernel 6.18.35, node kernel 6.18.56-125.164.amzn2023.x86_64
   took 12s
...
== server volume and gateway load balancer
  ok    the server's EBS volume is attached (in-use us-east-1a); the server pod runs in us-east-1a
  ok    NLB: 2 gateway targets healthy (all states: healthy draining healthy draining)
   took 8s
...
  total                                         2m 31s
Os novos nodes são instâncias novas, e o kata-deploy reinstalou o Kata neles sozinho em 1m 12s. Os pods do OpenSandbox esperaram como Pending enquanto os nodes estavam fora e voltaram nos novos. O volume do servidor foi reanexado porque um node novo caiu em us-east-1a. Nada garante isso: se os dois caírem em us-east-1b, o servidor fica Pending. Não aconteceu em três scale-ups, e eu não forcei. Nenhum sandbox estava rodando durante o teste, então o que acontece com sandboxes em execução durante um scale-down não foi testado aqui.
Para remover tudo:
./99_teardown.shRodei uma vez, com gravação, no fim da série, depois de as partes 3 a 6 usarem o cluster: 13 minutos e 14 segundos no total, dos quais o terraform destroy levou 11 minutos e 8 segundos (64 de 64 recursos). Toda verificação de sobras voltou limpa, a regra de scan do ECR voltou ao padrão, e a execução terminou com teardown complete; uma verificação separada da conta não encontrou nada do cluster (28 de 28 verificações). Três linhas nessa gravação dizem teardown stopped at line .... São um bug cosmético no error trap do script, que disparou dentro das verificações de “já sumiu?”, onde “not found” é a resposta esperada; a execução seguiu até o fim, e o script de apoio foi corrigido (a saída gravada é anterior à correção). O --yes pula a pergunta que vem a seguir. Ela pede que você digite o nome do cluster e confere se a sua conta AWS bate com o env.sh. Se o node group está em zero, o script primeiro traz dois nodes de volta com ./08_scale.sh nodes-only, porque os controllers que apagam o load balancer e o volume precisam de nodes para rodar. Depois, em ordem: todo sandbox; o Service do NLB do gateway, esperando o NLB sumir; o console e as releases do Helm, com o LB Controller por último; o PVC, esperando o volume EBS dele sumir; os namespaces, as sete CRDs que o Helm mantém e a StorageClass; todo repositório opensandbox-eks/* do ECR; terraform destroy; e uma verificação de sobras que falha com qualquer coisa que encontrar. A ordem é o que importa, porque várias coisas não são do Terraform:
- O NLB pertence ao LB Controller, então o Service dele sai enquanto o controller ainda roda; senão o load balancer, o target group dele e dois security groups ficam órfãos e bloqueiam o delete da VPC. Quando resetei o gateway para o Teste 5, o delete do Service levou 28 segundos e o lado da AWS tinha sumido em 33.
- O volume EBS do servidor pertence ao driver EBS CSI; apagar o PVC o apaga.
- Os repositórios do ECR foram criados no push.
values/server-gateway.yamlainda nomeia o NLB antigo. Num cluster reconstruído, rode o05_gateway.shlogo depois do04_install.sh.- A configuração de scan do registry volta para básica, sem regras.
A verificação de sobras procura network interfaces pelo ID da VPC, porque as que os serviços da AWS criam não têm tag de projeto, e volumes EBS só pela tag deste cluster, então os volumes de outro cluster na mesma conta ficam intactos.
Veredito
O OpenSandbox 1.2.0 instala no EKS 1.37, de uma conta vazia até um sandbox alcançado pelo servidor e por um load balancer, em cerca de 28 minutos de tempo de script. Nada que eu tenha conseguido diagnosticar remontou ao fato de rodar três versões minor do Kubernetes além da faixa testada; a única causa que eu não encontrei, um drain de node que travou durante um scale-down, continua em aberto. (Mais tarde, a parte 6 encontrou uma que remonta: veja a parte 6.) A maioria das correções foi sobre defaults, e a maioria delas afetaria qualquer cluster fora do ambiente do próprio projeto: imagens de um registry na China, um servidor que sai sem uma key, requests dimensionados para um node bem maior, nenhum storage para o banco de dados, um template que tolera qualquer taint, um namespace que dois charts disputam, um gateway que vem desligado e não pode ser exposto pelo próprio Service, e um console sem imagens e com um exemplo apontado para a porta errada. Cada correção é pequena, e depois que elas vivem em arquivos de values e manifests, a instalação converge: todo script de instalação rodou uma segunda vez sem mudanças.
A surpresa agradável foi o Kata. A virtualização aninhada transformou duas instâncias m7i.2xlarge comuns em hosts Kata sem mudanças no node além do chart do kata-deploy, e ele se reinstalou sozinho nos nodes substitutos. Isso torna possível o isolamento por VM junto com o sidecar de egress sem bare metal. Sandboxes runc iniciaram em cerca de 2,5 segundos com a imagem já no node (não medi um pull realmente a frio), e o console funcionou sem mexer na autenticação do servidor. O ponto fraco é a exposição: como configurado aqui, o gateway é uma porta em texto claro guardada só por um endereço de origem.
O que eu teria em mente antes de construir em cima disso:
- Você é a matriz de testes, e os arquivos de values são o seu contrato. Nenhum CI upstream cobre o EKS ou o Kubernetes 1.37, os charts não são publicados, e uma nova linha do OpenSandbox sai a cada poucas semanas, com só a mais recente suportada. Fixe tudo (a AMI, os add-ons, a tag do git, as tags das imagens, conferidas por digest) e rode as verificações de novo depois de cada upgrade.
- O gateway precisa de mais que um /32 antes de uso real. O tráfego dos sandboxes é texto claro e o ID do sandbox é a única credencial; olhe primeiro para rotas assinadas e TLS.
- As permissões são amplas. Pods e Secrets no cluster inteiro para o servidor e o controller, ClusterRoles de fast-sandbox sem uso, um servidor sem security context, um BFF do console rodando como root, e uma policy do LB Controller que pode editar qualquer security group da conta. Mantenha este cluster só para sandboxes.
Com o que você se compromete
| Aspecto | OpenSandbox 1.2.0 no EKS 1.37, como construído aqui |
|---|---|
| Suporte a Kubernetes | O projeto testa até a v1.34; na 1.37, nada que eu diagnostiquei aqui precisou de uma correção específica da 1.37 (um drain travado sem explicação); a parte 6 encontrou depois uma que precisa |
| Quem roda o quê | Você: o cluster, os charts renderizados a partir de uma tag do git, as cópias no ECR, as imagens do console, o kata-deploy, o NLB |
| Exposição | Servidor e console só por kubectl port-forward; sandboxes pelo NLB do gateway, em texto claro, a partir de um /32 |
| Isolamento | runc por padrão; VMs Kata (QEMU ou Cloud Hypervisor) prontas nos dois nodes |
| Estado | SQLite num volume EBS criptografado de 1 GiB, o que prende o servidor a uma zona |
| Console | Funciona com a key única do servidor; UI só em chinês; o BFF dele roda como root |
| Custo ocioso | Cerca de $1,01/h, $24,27 por dia; cerca de $0,18/h com zero nodes |
| Tempo (minhas execuções) | Cerca de 28 minutos de tempo de script de uma conta vazia até um primeiro sandbox (37 com o throttling do Docker Hub); 17 minutos para escalar para zero, 2,5 para voltar |
Quem deveria rodar isto
Esta instalação faz sentido para um time de plataforma na AWS que quer sandboxes de agentes na própria conta, com egress policy e isolamento por VM sob o próprio controle, e que se sente confortável sendo dono de Terraform, values de Helm e uma linha de releases que muda a cada poucas semanas. Também é um lab razoável para avaliar o caminho Kubernetes do OpenSandbox antes de se comprometer com ele: tudo está em scripts e pode rodar de novo, e um único script desmonta tudo.
Não serve para times que querem uma instalação de um comando só, uma versão de Kubernetes testada pelo fornecedor, ou um servidor, gateway e console com hardening de fábrica. A parte 3 leva este cluster pelo ciclo de vida do sandbox, pelos pools e pela mudança para Kata.