LangSmith Sandboxes: Hands-On com o Ciclo de Vida Completo do Sandbox
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Setup
- Passo 1: Conta, API key e plano
- Passo 2: Instale o SDK e o código de apoio
- Passo 3: Um helper REST, nomes, labels e timers de segurança
- Testes
- Teste 1: Crie um sandbox e inspecione os padrões
- Teste 2: Comandos, arquivos, URLs e egress
- Teste 3: Configurações de tempo de vida e redimensionamento
- Teste 4: Stop e start, com e sem memória
- Teste 5: Idle stop e auto-wake
- Teste 6: Listar, filtrar e reconectar a partir de outro processo
- Teste 7: Snapshots e “fork”
- Teste 8: Um snapshot customizado vs instalar em runtime
- Teste 9: A quota e a conta
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
- Quem deveria usar
Explica (TLDR) como se eu fosse...
Imagine uma caixa de brinquedos que pega no sono quando ninguém brinca com ela por alguns minutos. O legal é que ela acorda sozinha no momento em que você enfia a mão para pegar um brinquedo, e todos os seus blocos continuam exatamente onde você deixou.
Normalmente a caixa esquece qualquer brincadeira que ainda estava rolando quando ela dormiu, então o robô começa aquela brincadeira de novo. Se você pedir com jeitinho quando ganhar a caixa, ela também pode lembrar da brincadeira, e o robô continua exatamente de onde parou.
O LangSmith Sandboxes é um ambiente de execução hospedado dentro da plataforma LangSmith: o código que um agent gera roda em uma máquina virtual isolada na infraestrutura da LangChain, cobrado por segundo em LangSmith units na mesma conta do tracing.
Os pontos de diligência são retenção e egress. Um sandbox parado mantém o disco por quatorze dias por padrão, e os snapshots não têm expiração documentada. Organizações que não são Enterprise recebem uma allow list de saída fixa que o sandbox não consegue ampliar sem uma exceção do suporte. Configure timers de exclusão e defina quem é responsável pela limpeza.
A condição tratada aqui é a execução insegura de código escrito por máquina. A intervenção é uma máquina virtual descartável por tarefa. Nos meus testes, ela foi criada em cerca de meio segundo e acordou de um stop em um a quatro segundos sem uma chamada explícita de start.
A evidência é boa para arquivos, que sobreviveram a todos os stops. Efeitos colaterais: processos são perdidos num stop padrão, timeouts de comando falham silenciosamente com exit code menos um, e o acesso de rede de saída fica limitado a uma allow list, a menos que você esteja no Enterprise ou consiga uma exceção do suporte.
Repare no alívio quando um sandbox que foi dormir simplesmente acorda na próxima vez que alguém mexe nele. Ninguém precisa lembrar de iniciá-lo, e toda uma categoria de mensagens do tipo "por que ele está parado" desaparece.
O atrito muda de lugar. Um comando que estoura o timeout retorna em silêncio em vez de reclamar, então uma instalação que falhou pode parecer uma que terminou. E parte da plataforma só existe por trás da API crua, o que pode deixar as pessoas inseguras sobre se estão usando a ferramenta do jeito pretendido.
Pense num sandbox do LangSmith como uma sala de ensaio com sensor de presença. As luzes apagam depois de dez minutos de silêncio e voltam a acender no momento em que alguém abre a porta, com cada instrumento ainda no seu suporte.
Por padrão, a sala esquece a música que vocês estavam tocando, então a banda conta de novo. Reserve a sala com a opção de memória e o groove retoma no meio do compasso depois que as luzes voltam. As regras da casa sobre quem pode visitar são rígidas: só uma lista fixa de convidados com endereços externos consegue entrar.
O posicionamento é "o sandbox que vem com a sua conta LangSmith". O time to value é de minutos: a mesma API key do tracing, um sandbox em cerca de meio segundo e 8 LSU de uso incluído.
A narrativa é um ciclo de vida que se gerencia sozinho: sandboxes ociosos param, e qualquer request os acorda de novo. As ressalvas que os compradores vão levantar são uma conta de plataforma que precisa ser contratada, um limite de 10 sandboxes no plano gratuito, egress restrito fora do Enterprise e um Python SDK que cobre só parte da API.
 Veja o código-fonte aqui: langsmith-sandbox-lifecycle
Visão Geral
Os LangSmith Sandboxes são os ambientes hospedados da LangChain para rodar código gerado por agents. Eles foram lançados em private preview em março de 2026 e ficaram generally available em 2026-05-13. Não existe cadastro separado: sandboxes são uma feature da sua organização LangSmith, você usa a mesma API key do tracing, e o uso é cobrado em LangSmith units (LSU) junto com todo o resto. Cada sandbox é uma microVM; o documento de arquitetura self-hosted é a única página que diz isso com todas as letras (“A sandbox is a Firecracker microVM, not a Kubernetes pod”).
O modelo de ciclo de vida é a parte interessante. Um sandbox para sozinho depois de 10 minutos ocioso, e qualquer coisa que toque um sandbox parado o acorda: um comando, uma leitura de arquivo, um link de download ou um request para a service URL dele. Não existe um start() que você precise lembrar de chamar. O que um stop preserva depende de uma flag: por padrão, só o disco sobrevive e o próximo wake é um cold boot, mas um sandbox criado com preserve_memory_on_stop retoma com os processos ainda rodando. Não existe chamada fork(); um fork é um snapshot mais N creates.
Este post, parte 1 de 2, acompanha um sandbox pela vida inteira, de create_sandbox() até a limpeza, com um script executável por etapa. Eu rodei tudo com langsmith[sandbox] 0.14.14 (publicado no PyPI em 2026-10-27) a partir do Python 3.12, contra a região GCP US do LangSmith, em um workspace não Enterprise. Todos os tempos são das minhas execuções. Não encontrei ninguém que tenha publicado medições deste produto. Duas coisas para saber antes de começar: o Python SDK cobre só parte da plataforma (labels, filtros, redimensionamento e tudo relacionado a memória são exclusivos da REST), e o tráfego de saída é limitado a uma allow list fixa, a menos que você esteja no Enterprise. A Parte 2 trata de credenciais: dar API keys a um agent dentro do sandbox sem colocar as chaves lá dentro.
Arquitetura
A API de sandbox em api.smith.langchain.com/api/v2/sandboxes cuida do ciclo de vida (create, stop, start, snapshot, list, delete). Comandos e operações de arquivo vão direto para o dataplane do sandbox, por um WebSocket no caso do run(). Qualquer porta pode ser exposta como https://<sandbox-id>--<port>.smithbox.dev, protegida por um token, e qualquer arquivo pode ser compartilhado por um link de download com token que não exige credenciais.
Quanto custa e quanto dura cada estado, segundo a página de preços, a documentação do SDK e o Teste 9:
| Estado | Cobrado por | Conta para o limite de sandboxes? | Expira? |
|---|---|---|---|
| Ready | vCPU + memória + storage, por segundo | Sim | Para depois de 10 minutos ocioso por padrão; sem limite de tempo de execução total |
| Stopped | Só storage (inferido da documentação da API de custos, não declarado) | Não (medido no Teste 9) | Excluído 14 dias após o stop por padrão (máximo de 30 dias) |
| Snapshot | Storage, como recurso próprio | Não | Sem expiração documentada; mantido até você excluí-lo |
| Deleted | Nada (snapshots tirados dele continuam sendo cobrados) | Não | Some para sempre |
Setup
Passo 1: Conta, API key e plano
Você precisa de uma conta LangSmith; crie uma API key em Settings > API Keys. O plano gratuito Developer inclui 8 LSU de uso de sandbox e é limitado a 10 sandboxes, o que é mais do que suficiente para este walkthrough. O endpoint de quota diz o que o seu workspace realmente recebe. O meu, antes do primeiro teste:
=== Quota before we start (GET /usage) ==========================
sandboxes 0/10 | cpu 0/200000 m | memory 0/400 GiB | snapshots 0
Verifique o egress antes de planejar qualquer coisa que converse com o mundo externo. Em organizações não Enterprise, os sandboxes recebem uma allow list gerenciada que o próprio access_control do sandbox não consegue ampliar (visão geral, documentação do auth proxy). Ela não é publicada, mas dá para ler: GET /boxes/{name} a retorna em proxy_config.access_control.allow_list. A minha tinha 60 padrões de host cobrindo LangSmith, npm, yarn e bun, PyPI e astral.sh, GitHub, GitLab e Bitbucket, os mirrors do Ubuntu e do Debian, Docker Hub e os outros grandes container registries, Google Cloud Storage e Azure Blob, e as APIs da Anthropic, OpenAI, Gemini, Perplexity, DeepSeek, Groq, OpenRouter e Hugging Face. Nenhum host da AWS, o que travou a metade AWS do meu post sobre credenciais até o suporte da LangChain conceder uma exceção. Egress irrestrito exige Enterprise ou esse ticket de suporte, e a exceção remove a lista em vez de ampliá-la: o access_control desaparece do GET /boxes/{name}, todo host passa a ser acessível, e o próprio access_control do sandbox passa a ser aplicado (parte 2, Teste 7). A flag da organização sandbox_restricted_egress continuou retornando true depois disso, então verifique de dentro de um sandbox.
Passo 2: Instale o SDK e o código de apoio
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/langsmith-sandbox-lifecycle
cp .env.example .env            # paste LANGSMITH_API_KEY=lsv2_pt_...
uv venv && uv pip install -e .  # installs langsmith[sandbox]==0.14.14 + httpx + python-dotenv
source .venv/bin/activate
Eu fixei langsmith[sandbox]==0.14.14. A API de sandbox muda rápido: os templates foram substituídos por snapshots em abril de 2026, e código escrito contra a API antiga agora falha com AttributeError: ... no attribute 'get_template' (thread no fórum). Atualize a versão fixada de forma deliberada.
Passo 3: Um helper REST, nomes, labels e timers de segurança
O Python SDK não tem labels, nem filtros de listagem, nem redimensionamento, nem nenhuma das opções de memória, então o common.py traz um pequeno helper para a API REST ao lado do SandboxClient:
# common.py
API = os.environ.get("LANGSMITH_ENDPOINT", "https://api.smith.langchain.com").rstrip("/") + "/api/v2/sandboxes"
_http = httpx.Client(headers={"x-api-key": os.environ["LANGSMITH_API_KEY"]}, timeout=120)


def rest(method: str, path: str, **kw):
    """Call the REST API directly, for what the Python SDK doesn't expose (labels, memory, filters, usage)."""
    r = _http.request(method, f"{API}{path}", **kw)
    if r.is_error:
        raise RuntimeError(f"HTTP {r.status_code} {method} {path}: {r.text.strip()[:300]}")
    return r.json() if r.content else None
Todo sandbox recebe o nome my2cents-lc-<test>-<n>, e os criados via REST também carregam o label demo=my2cents-lifecycle. O create via REST define dois timers de segurança, para que qualquer coisa que um script que travou deixe para trás pare depois de 5 minutos ocioso e seja excluída 10 minutos depois disso:
def create(test: str, **body) -> Sandbox:
    """Create a labelled sandbox over REST (the SDK has no labels) and wrap it in the SDK's Sandbox."""
    payload = {
        "name": name(test),
        "labels": {**DEMO_LABELS, "test": test},
        "idle_ttl_seconds": SAFETY_IDLE_TTL,
        "delete_after_stop_seconds": SAFETY_DELETE_AFTER_STOP,
        "wait_for_ready": True,
        "timeout": 120,
        **body,
    }
    return Sandbox.from_dict(rest("POST", "/boxes", json=payload), client=client, auto_delete=False)
O segundo timer importa mais do que parece. Sem ele, um sandbox parado fica por aí durante 14 dias.
Testes
Teste 1: Crie um sandbox e inspecione os padrões
python 01_create.py # optional arg: number of timed creates (default 5)sb = client.create_sandbox(name=name("01"), idle_ttl_seconds=SAFETY_IDLE_TTL,
delete_after_stop_seconds=SAFETY_DELETE_AFTER_STOP)
raw = rest("GET", f"/boxes/{sb.name}")=== Create with defaults (SDK create_sandbox) ===================
[ 0.53s] client.create_sandbox()
name : my2cents-lc-01-40088314 (id 01a18570-3f5e-7ae0-920b-07c44116813f)
status : ready
vcpus : 1 (cpu_millicores 500, REST only)
mem / disk : 2 GiB / 16 GiB
snapshot : 8e277348-2a29-409e-84ff-63b433972773
run_config : user=root work_dir=/root
lifecycle : idle_ttl 300s | delete_after_stop 600s | preserve_memory_on_stop False | persistent True
egress : 60 allow-listed host patterns
[ 1.19s] first run()
6.1.166 # uname -r
root
1 # nproc
Mem: 1979 172 1832 0 97 1807
/dev/vda 16G 3.3G 13G 22% /
PRETTY_NAME="Ubuntu 26.04.1 LTS"
docker # systemd-detect-virt
[ 0.000000] Hypervisor detected: KVM
python3=yes pip3=yes uv=yes node=yes npm=yes git=yes gh=yes curl=yes docker=yes langsmith=yes
Python 3.14.4
=== Sandbox without options (server defaults) ===================
idle_ttl 600s | delete_after_stop 1209600s
=== 5 sequential creates (create, first run, delete) ============
#1: create 0.50s | create + first run 0.93s
#2: create 0.51s | create + first run 0.91s
#3: create 0.50s | create + first run 0.89s
#4: create 0.51s | create + first run 0.93s
#5: create 0.52s | create + first run 0.91s
create median 0.51s | min 0.50s | max 0.52s
create + first run median 0.91s | min 0.89s | max 0.93s
=== Same thing over REST with labels ============================
REST create median 0.57s(A linha idle_ttl 300s | delete_after_stop 600s mostra os meus timers de segurança; os padrões do servidor estão no segundo bloco. Comentários adicionados, linhas do create via REST cortadas.)
- Os creates são rápidos e notavelmente consistentes. Cinco creates sequenciais tiveram mediana de 0,51 s (0,50 a 0,52 s; 0,59 s em uma execução posterior), e 0,91 s incluindo o primeiro comando, medidos a partir do meu laptop, com uma dispersão bem pequena.
- O tamanho padrão é 0,5 vCPU, 2 GiB e 16 GiB. O campo
vcpusdo SDK diz 1, mas a resposta REST dizcpu_millicores500, e a quota contou 500 millicores por sandbox no Teste 9. Lá dentro,nprocé 1 efreereporta 1.979 MiB: o guest enxerga os próprios tamanhos, não os do host. - É uma VM. Kernel próprio (6.1.166), um disco virtual em
/dev/vdaeHypervisor detected: KVMnodmesg. Osystemd-detect-virtimprimirdockerengana. - O sistema operacional é Ubuntu 26.04.1, não 24.04. A documentação de snapshots ainda diz 24.04. O código roda como
rootem/root, com Python 3.14.4, uv, Node, git, gh, Docker e a CLIlangsmithpré-instalados. A imagem é enxuta em pacotes Python, porém:pip3 listimprimiu 15 linhas (Teste 8). - Padrões do servidor: 10 minutos ocioso antes de um stop, e 14 dias (1.209.600 s) do stop até a exclusão.
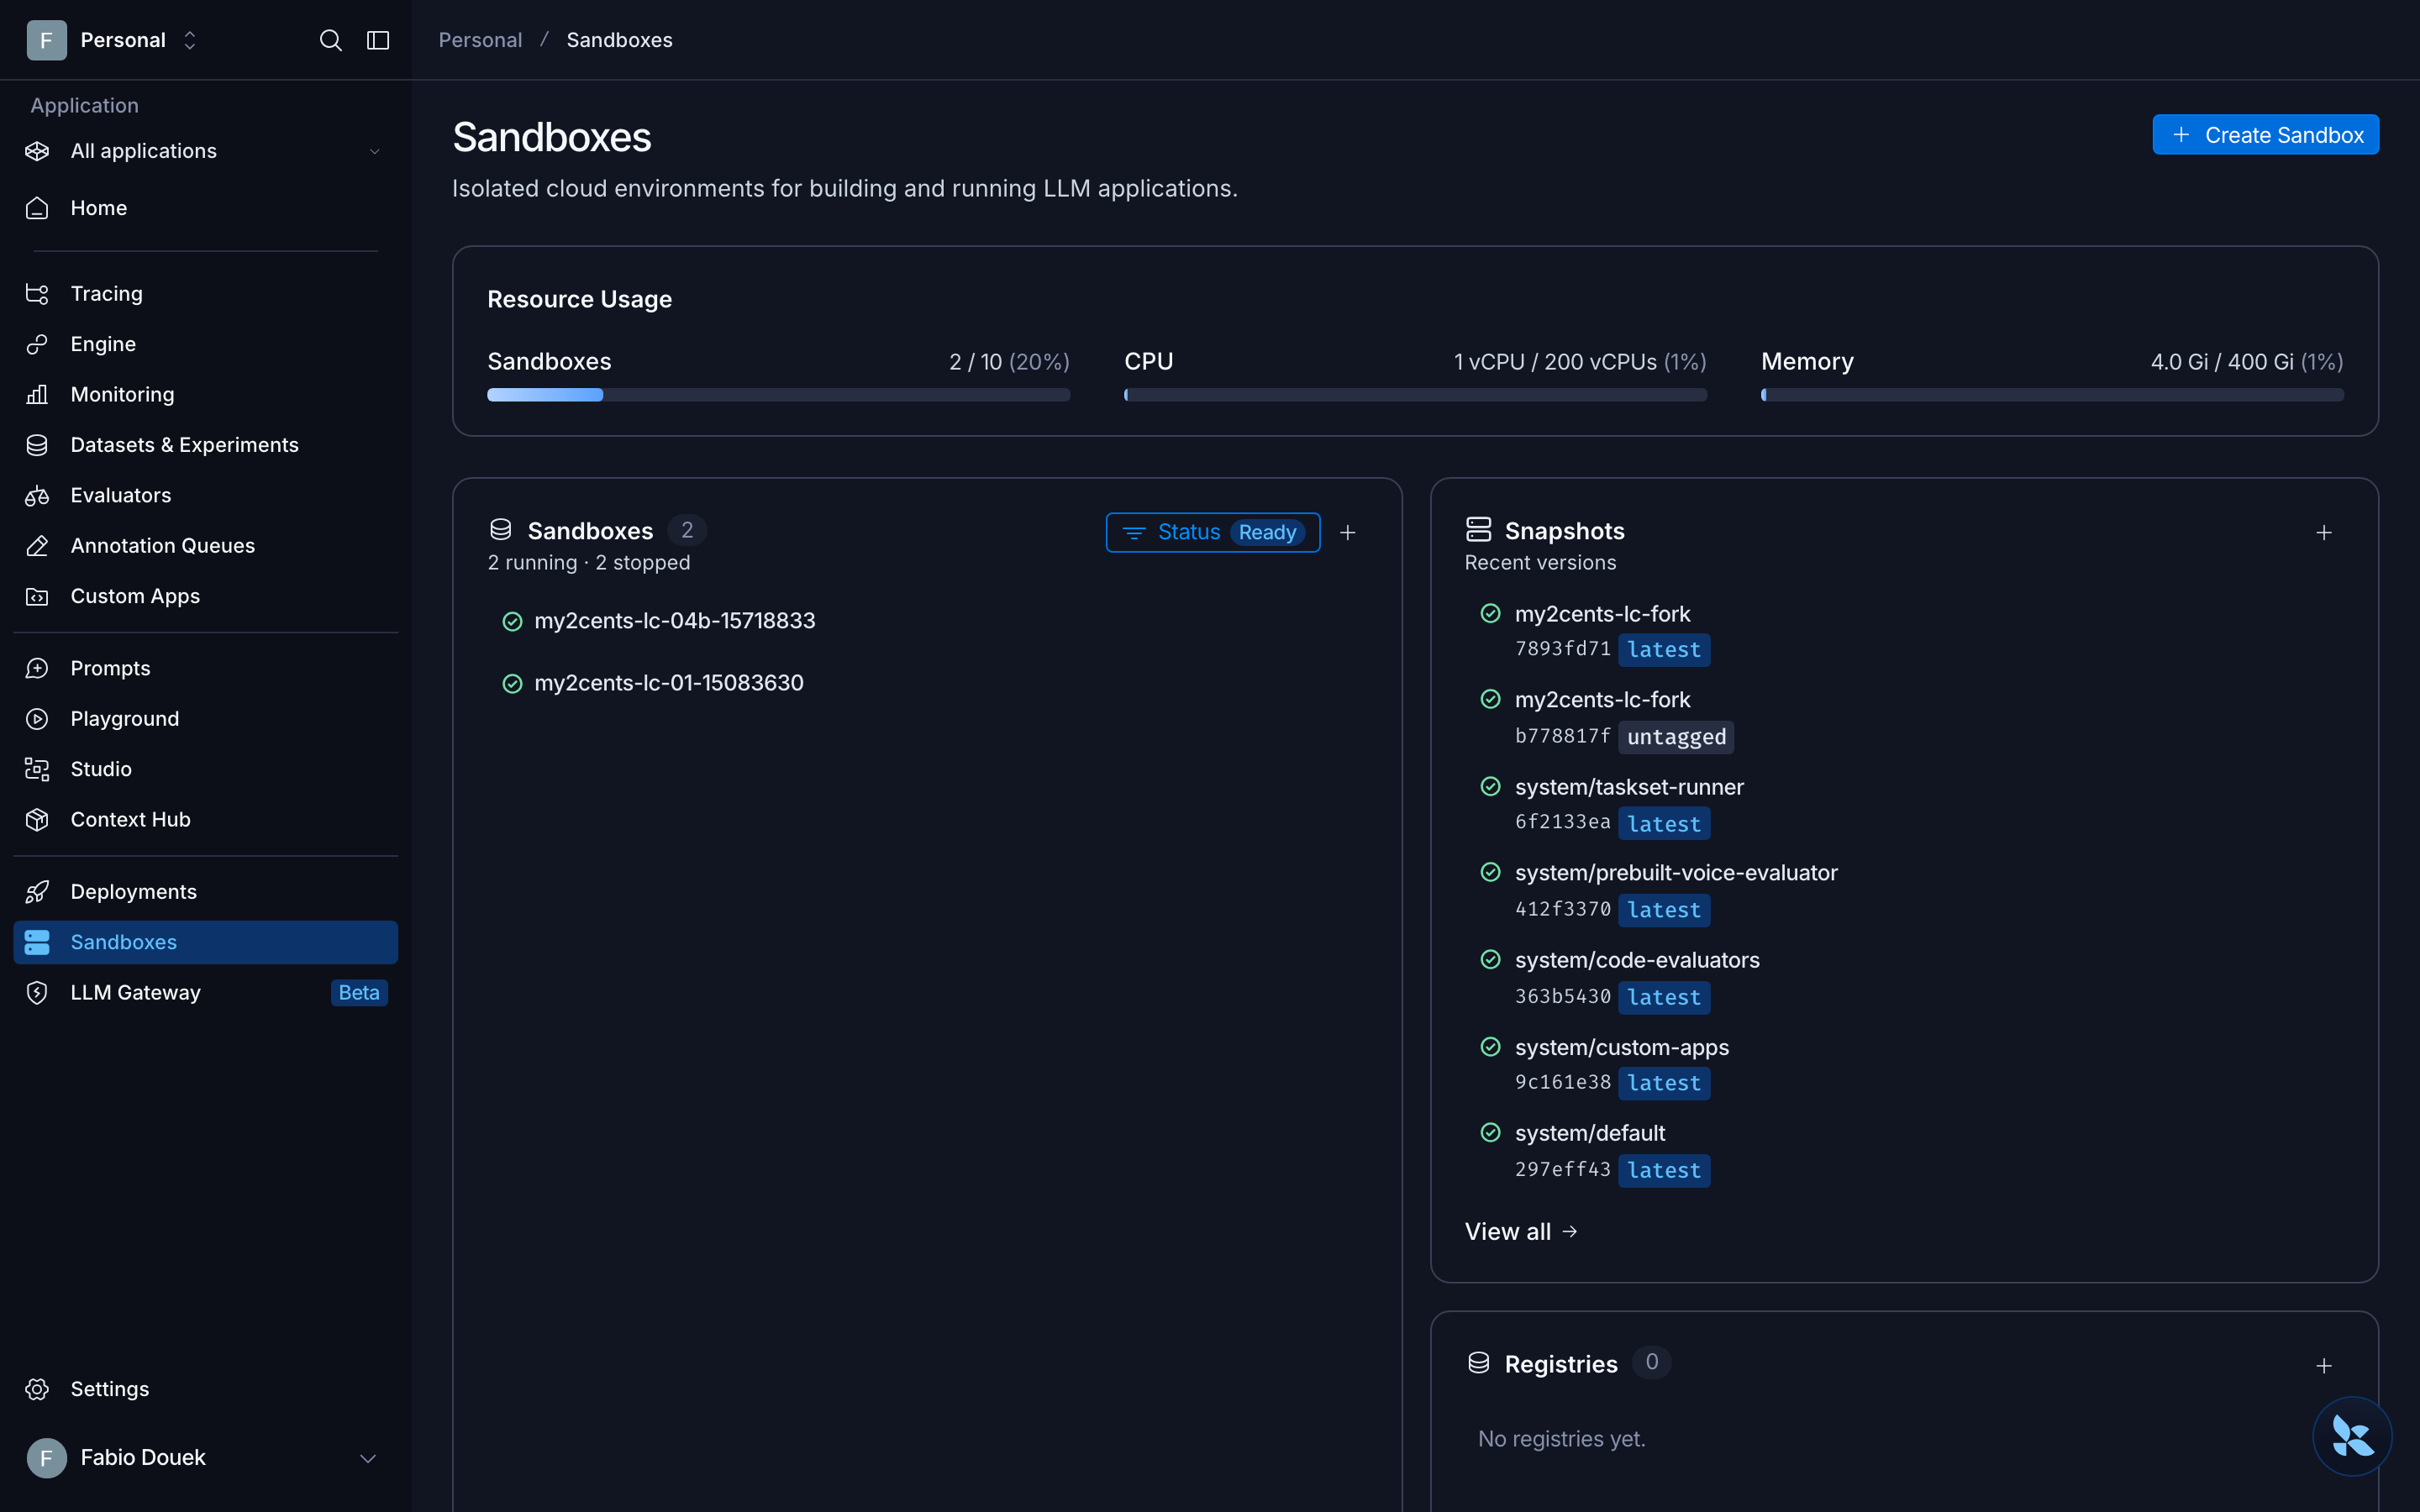
A página Sandboxes é basicamente uma visão de quota. Sandboxes parados não contam contra ela: dois sandboxes rodando e dois parados aparecem como 2 de 10.
Teste 2: Comandos, arquivos, URLs e egress
python 02_commands_files.pyr = sb.run("echo out; echo err 1>&2; exit 3")
sb.run("for i in 1 2 3; do echo tick $i; sleep 1; done", on_stdout=lambda s: print(" stream>", s, end=""))
r = sb.run("sleep 10; echo done", timeout=2)
r = sb.run("sleep 75; echo done")sandbox: my2cents-lc-02-40212032
=== Commands ====================================================
exit=3 stdout='out\n' stderr='err\n' (no exception on non-zero exit)
stream> tick 1
stream> tick 2
stream> tick 3
no exception: exit=-1 stdout='' stderr=''
[ 2.36s] run('sleep 10', timeout=2)
no exception: exit=-1 stdout='' stderr=''
[ 60.37s] run('sleep 75') with the default timeout
send_input with default close_input: SandboxOperationError: stdin is closed for this command. Non-PTY commands close stdin by default so a command that reads it sees EOF instead of hanging; pass close_input=False to run() to stream input into it.
cat with close_input=False echoed: 'hello over stdin\n'- stdout e stderr voltam separados, junto com o exit code, e um exit diferente de zero não levanta exceção.
- Timeouts não levantam exceção. A docstring do SDK diz que um comando que excede o
timeoutlevantaCommandTimeoutError. Na 0.14.14, isso não acontece:run(..., timeout=2)voltou depois de 2,36 s com exit code -1 e saída vazia, sem exceção. O script envolve as duas chamadas emexcept CommandTimeoutError, e nenhum dos branches foi acionado. - O timeout padrão é de 60 segundos.
run("sleep 75")semtimeout=voltou depois de 60,37 s, de novo como um exit -1 silencioso. Umpip installlongo sem timeout explícito é cortado em um minuto e parece uma falha comum. Verifiqueexit_code == -1e passetimeout=(outimeout=0para nenhum) em qualquer coisa lenta. - O stdin vem fechado por padrão. O exemplo de
send_input()da documentação falha a menos que você passeclose_input=Falsepara orun(). A mensagem de erro diz exatamente isso, o que é mais do que a maioria dos SDKs faz.
A API de arquivos (write, read, ls, glob, grep, stat) funcionou toda, e dois tipos de URL tornam o sandbox acessível de fora:
dl = sb.generate_download_url("/root/notes/hello.txt", expires_in_seconds=300)
server = sb.run("python3 -m http.server 8000 --directory /root/notes", wait=False, timeout=0)
svc = sb.service(8000)
=== Download URL (no LangSmith credentials needed) ==============
url host: a-6giegpp4x7nz4wlus3xm3sdzne.smithbox.dev expires_at=2026-10-29T02:23:01Z
GET without auth: HTTP 200 'hello from my laptop'
no expires_in_seconds -> expires_at=None
=== Service URL =================================================
service_url host: 01a18572-22a5-7432-ac5f-528d30c9195c--8000.smithbox.dev
svc.get('/hello.txt'): 200 'hello from my laptop'
same URL without the token: HTTP 401
browser_url carries the token in the query: True- Links de download são bearer URLs e, por padrão, nunca expiram. Qualquer pessoa com o link pega o arquivo, sem precisar de credenciais do LangSmith. Passe
expires_in_seconds, a menos que você realmente queira um link permanente. - Service URLs exigem um token, 401 sem ele. O
svc.get()do SDK envia o token para você, e obrowser_urlo coloca na query string para que um navegador possa definir um cookie.
Depois, egress, com curl de dentro de um sandbox padrão:
=== Egress ======================================================
60 allow-listed patterns, e.g. ['smith.langchain.com:443', '*.smith.langchain.com:443', 'api.smith.langchain.com:443'] ... ['openrouter.ai:443', 'huggingface.co:443', '*.huggingface.co:443']
  https://pypi.org/simple/                           200
  https://registry.npmjs.org/                        200
  https://github.com                                 200
  https://api.anthropic.com                          404
  https://api.openai.com                             421
  https://huggingface.co                             200
  https://registry-1.docker.io/v2/                   401
  https://example.com                                000 blocked
  https://httpbin.org/get                            000 blocked
  https://sts.amazonaws.com                          000 blocked
  https://bedrock-runtime.us-east-1.amazonaws.com    000 blocked
curl: (35) TLS connect error: error:0A000126:SSL routines::unexpected eof while reading

=== Installing packages =========================================
[  1.15s] pip3 install -q requests
  exit=1 'hint: See PEP 668 for the detailed specification.'
[  1.07s] uv pip install --system -q requests
  exit=2 'hint: Virtual environments were not considered due to the `--system` flag'
[  4.85s] python3 -m venv /root/v && /root/v/bin/pip install -q requests && echo venv-ok
  exit=0 'venv-ok'
As respostas 404, 421 e 401 significam que o host estava acessível; 000 significa que o proxy derrubou o handshake TLS. Qualquer coisa fora da lista falha como erro de TLS, não como um claro “bloqueado por política”, o que vale saber quando você está debugando um agent que não consegue alcançar uma API.
Isso vale para o egress restrito. Depois da exceção da minha organização (2026-11-03), o mesmo script imprime no managed allow list: this organization has unrestricted egress, e todos os hosts acima respondem, incluindo example.com, o httpbin e os dois endpoints da AWS.
Instalar pacotes funciona, mas não do jeito óbvio. O Ubuntu marca o Python do sistema como externally managed (PEP 668), então pip3 install e uv pip install --system se recusam. Um venv funciona, em menos de 5 s aqui. Se os prompts do seu agent dizem pip install, dê um venv a ele primeiro, ou embuta os pacotes em um snapshot (Teste 8).
Teste 3: Configurações de tempo de vida e redimensionamento
python 03_lifetimes.pyHá dois timers por sandbox, idle_ttl_seconds e delete_after_stop_seconds, e ambos podem ser alterados em um sandbox rodando. Redimensionar é exclusivo da REST: a documentação diz que update_sandbox consegue redimensionar, mas o método Python não tem vcpus nem mem_bytes.
up = client.update_sandbox(sb.name, idle_ttl_seconds=0, delete_after_stop_seconds=600)
body = rest("PATCH", f"/boxes/{sb.name}", json={"vcpus": 2, "mem_bytes": 4 * GiB})
=== TTL validation ==============================================
idle_ttl_seconds=90: ValueError (client side, nothing created): idle_ttl_seconds must be a multiple of 60 seconds, got 90
REST idle_ttl_seconds=90: HTTP 422 POST /boxes: {"detail":[{"loc":["body","idle_ttl_seconds"],"msg":"idle_ttl_seconds must be a multiple of 60 (only minute-resolution supported). Got: 90","type":"value_error"}]}
sandbox: my2cents-lc-03-40412317
=== Update TTLs on a running sandbox ============================
before: idle 120s, delete_after_stop 3600s
after update_sandbox(idle_ttl_seconds=0, ...): idle 0s, delete_after_stop 600s
delete_after_stop_seconds=2592000 (30.00 d): accepted
delete_after_stop_seconds=2592060 (30.00 d): HTTP 422 PATCH /boxes/my2cents-lc-03-40412317: {"detail":[{"loc":["body","delete_after_stop_seconds"],"msg":"delete_after_stop_seconds must be \u003c= 2592000 (30 days). Got: 2592060","type":"value_error"}]}
=== Resize: PATCH vcpus/mem_bytes (REST only) ===================
before : 1 | Mem: 1979 203 1761 0 151 1776 |
PATCH response: vcpus 2 cpu_millicores 2000 mem 4 GiB status ready
running: 1 | Mem: 1979 208 1740 0 167 1771 |
[ 2.13s] stop() + start()
restart: 4 | Mem: 3992 259 3787 0 124 3732 |
cpu.max: none
1 vCPU + 16 GiB: accepted as vcpus 1 cpu_millicores 1000 mem 16 GiB
=== delete_after_stop_seconds=60 really deletes =================
[ 0.5s] stopped
[ 0.7s] stopped
[ 104.3s] gone (ResourceNotFoundError)(A linha de idle_ttl_seconds=30 foi cortada.)
- Os timers têm resolução de minuto. O SDK rejeita 90 segundos no lado do cliente antes de qualquer coisa ser criada; a API retorna um 422.
0desativa qualquer um dos timers. delete_after_stop_secondstem teto de 30 dias e realmente exclui. Com 60 segundos, o sandbox parado sumiu depois de 104 s nesta execução e de 78,5 s em outra. Ele nunca mostrou statusdeletingnos meus polls de 5 segundos.- O redimensionamento vale a partir do próximo start. A resposta do PATCH disse 2 vCPU e 4 GiB na hora, mas o sandbox em execução ainda tinha 1 CPU e 1.979 MiB. Depois de um stop e start (2,13 s), ele tinha 3.992 MiB e
nprocdizia 4 para um sandbox de 2 vCPU. A documentação diz que a CPU pode fazer burst para 2x quando o host tem capacidade, que é a minha melhor explicação para a duplicação. - A regra de memória não é aplicada. A documentação diz que a memória precisa ficar dentro de ±50% de 4 GiB por vCPU. Um PATCH para 1 vCPU e 16 GiB, quatro vezes a proporção, foi aceito.
Teste 4: Stop e start, com e sem memória
python 04_stop_start.pyO script grava um arquivo em /root e em /tmp, inicia um loop de shell que grava um contador a cada segundo, e então faz stop e start do sandbox três vezes. A segunda metade repete isso em um sandbox criado com preserve_memory_on_stop, que é uma flag definida no create e exclusiva da REST:
sb.stop()
wait_status(sb.name, "stopped", poll=0.2)
sb.start()
# ...
sbm = create("04b", preserve_memory_on_stop=True)
=== Default stop: my2cents-lc-04a-46122842 ======================
/dev/vda 16G 3.3G 13G 22% /
/tmp is on the root disk
[ 0.53s] cycle 1 stop() until status=stopped
[ 1.59s] cycle 1 start()
counter at stop: 4
disk survives
tmp survives
counter 4 -> 4
process-gone
uptime 3.85s
...
Default stop: stop median 0.53s | start median 1.62s
=== Touching a stopped sandbox ==================================
exit=0 'hi'
[ 1.82s] run('echo hi') on a stopped sandbox
status after: ready
=== stop() twice ================================================
second stop(): SandboxClientError: sandbox "my2cents-lc-04a-46122842" is stopped, not ready
second start(): no error
preserve_memory_on_stop: True
=== preserve_memory_on_stop: my2cents-lc-04b-46160949 ===========
[ 3.29s] cycle 1 stop() until status=stopped
[ 0.91s] cycle 1 start()
counter at stop: 4
disk survives
tmp survives
counter 5 -> 7
process-alive
uptime 18.74s
[ 1.58s] cycle 2 stop() until status=stopped
[ 0.74s] cycle 2 start()
counter at stop: 8
counter 9 -> 11
process-alive
uptime 23.17s
...
preserve_memory_on_stop: stop median 2.33s | start median 0.91s(Os ciclos 2 e 3 do stop padrão, e o ciclo 3 e linhas repetidas da variante com memória, foram cortados.)
- Um stop padrão é um cold boot. Os arquivos em
/roote/tmpsobreviveram a todos os ciclos (/tmpfica no disco raiz aqui, não em um tmpfs), mas o processo do contador tinha sumido e o uptime era de 3,9 a 7,1 s depois de cada start. O stop levou uma mediana de 0,53 s e o start 1,62 s. - Um sandbox parado acorda no próximo comando.
run("echo hi")contra um sandbox parado retornouhiem 1,82 s e o deixouready. Nenhumstart()necessário. preserve_memory_on_stopfunciona no meu plano não Enterprise. O contador continuou contando a cada stop, o processo seguiu vivo e o uptime continuou crescendo (18,7, 23,2, 28,5 s): a VM retomou em vez de reiniciar. O stop é mais lento porque grava a RAM (mediana de 2,33 s), e o start é mais rápido (mediana de 0,91 s). É uma pausa real com memória, mas opt-in, e você precisa decidir no momento do create.stop()não é idempotente;start()é. Um segundostop()levantaSandboxClientError.
Uma execução anterior (a primeira tentativa do Teste 9) tomou um httpx.ReadTimeout no stop() enquanto o workspace estava ocupado com outros testes. O SandboxClient usa por padrão um timeout HTTP de 10 segundos, que volta a aparecer no Teste 8.
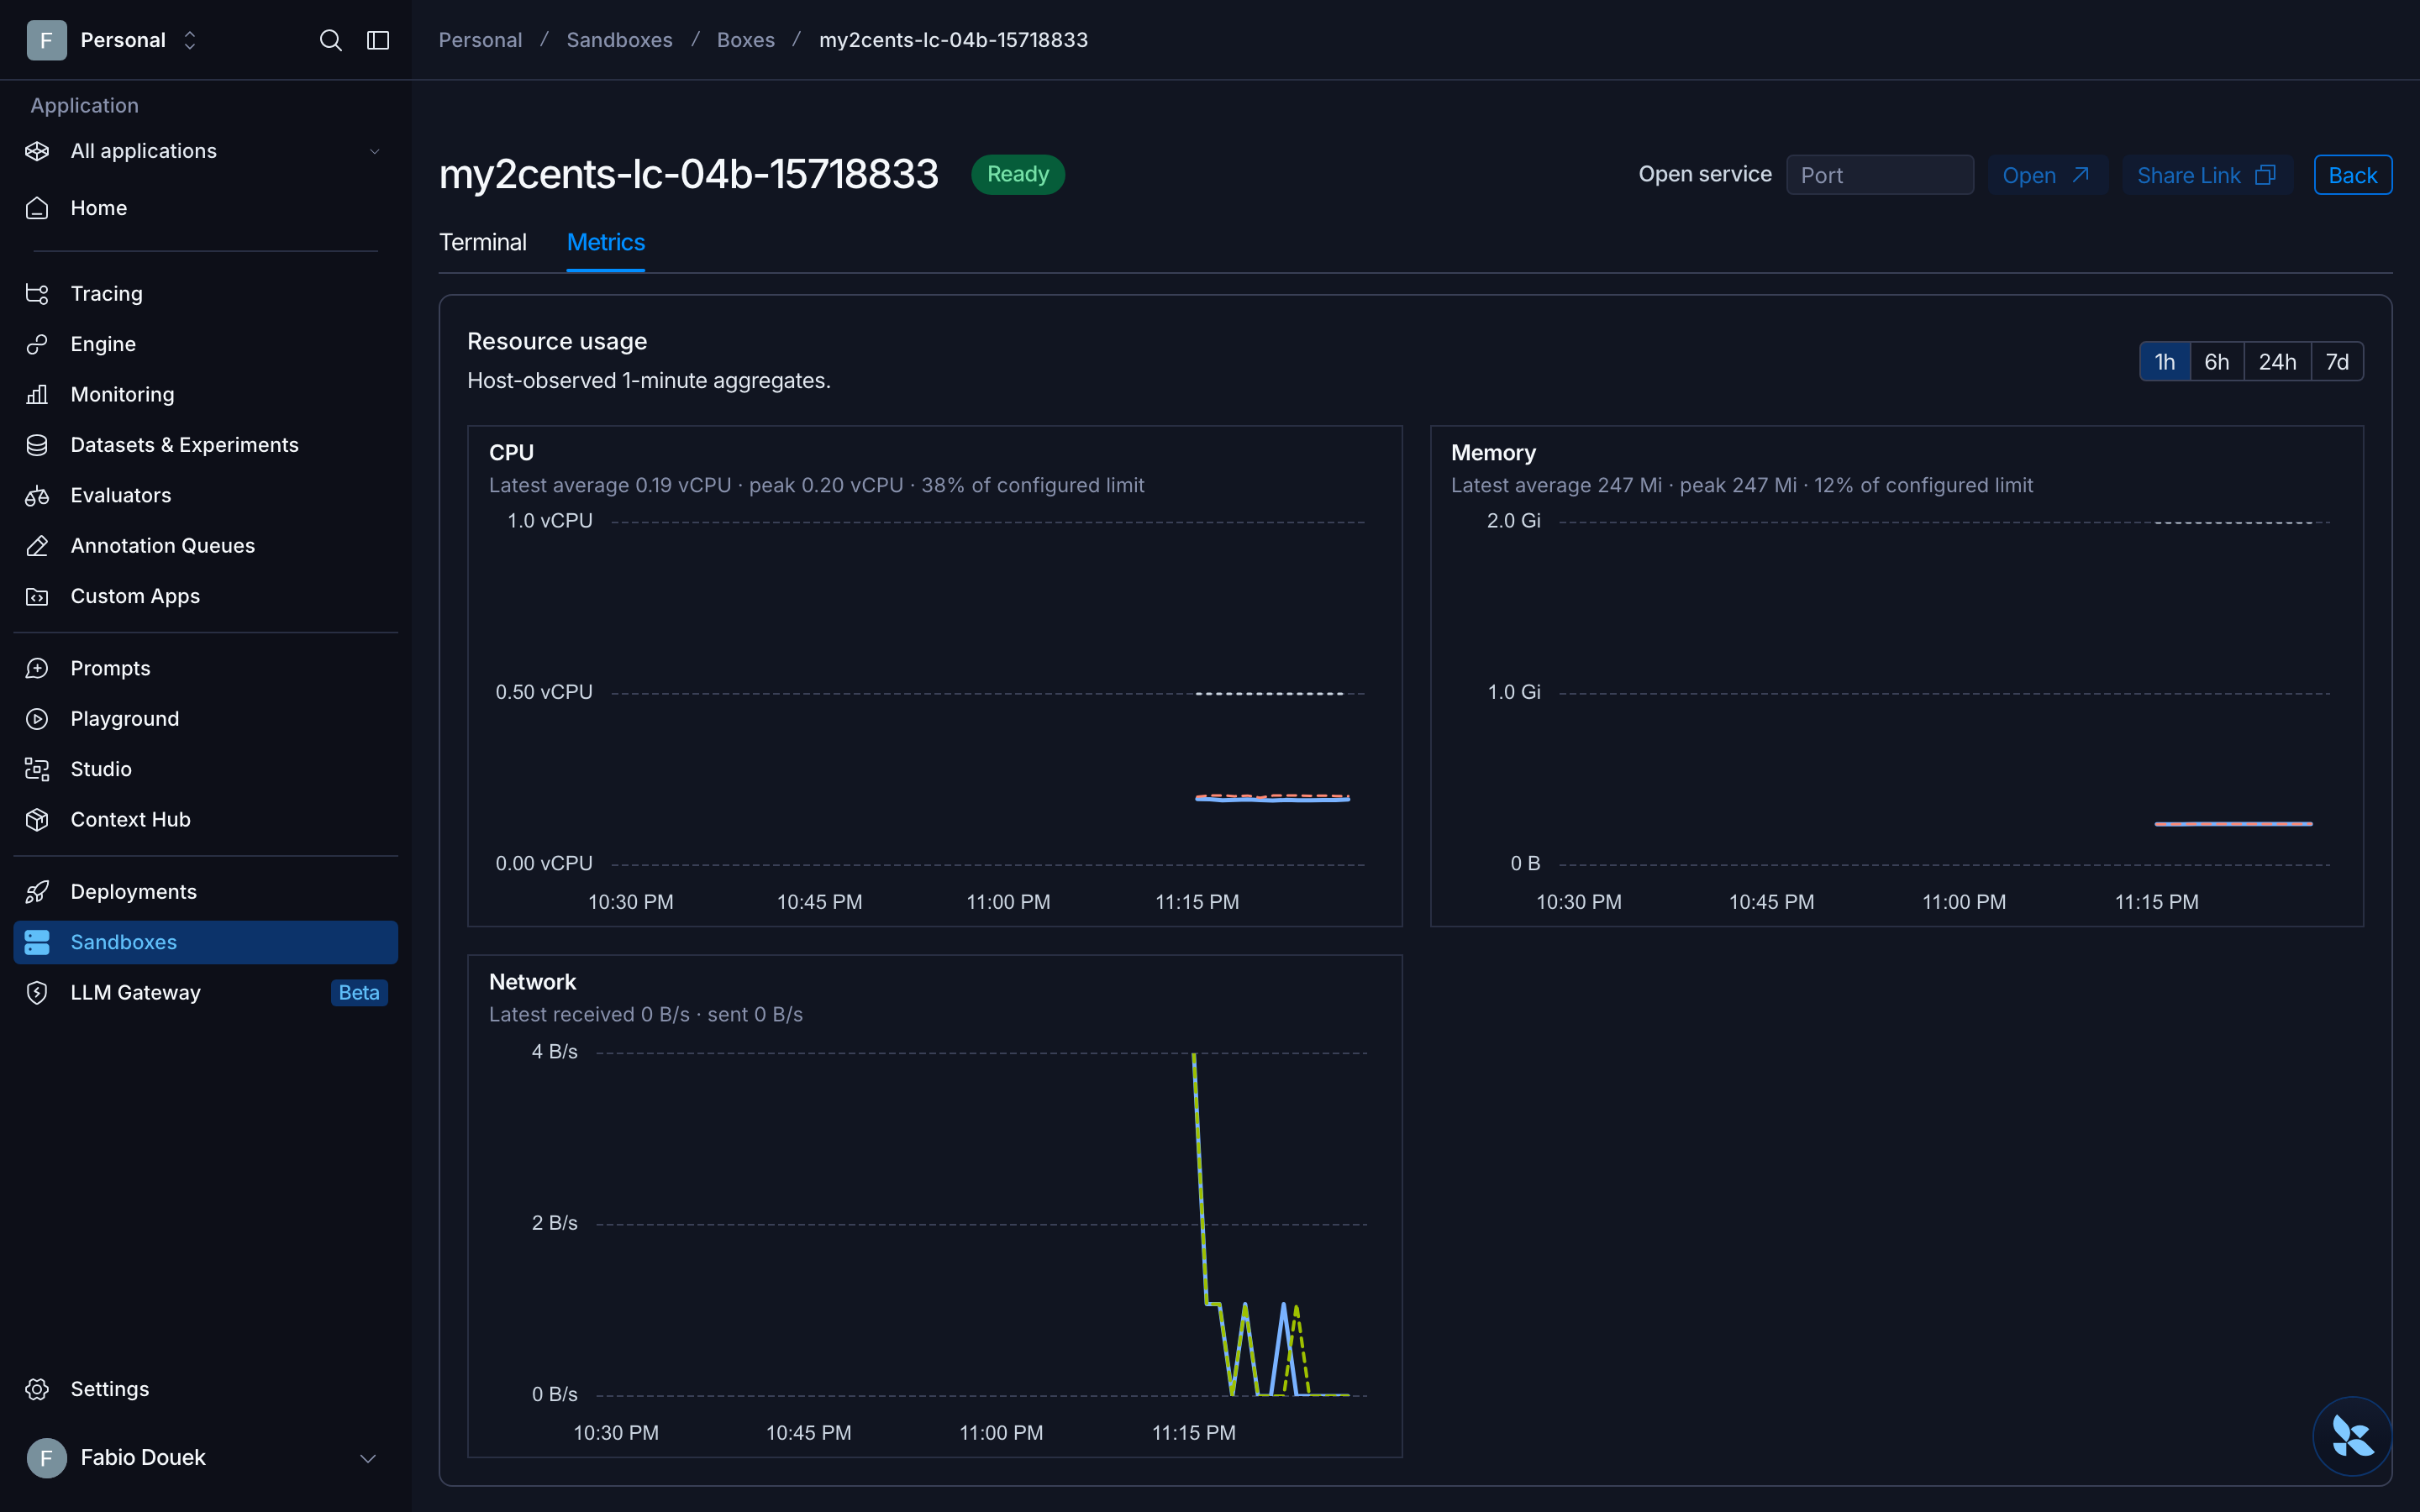
A página de detalhes tem duas abas: um Terminal no navegador (um shell root) e Metrics. A aba Metrics não mostra a configuração preserve_memory_on_stop, então a API é o único lugar para verificá-la.
Teste 5: Idle stop e auto-wake
python 05_idle_wake.py # about 20 minutes, mostly waiting for idle stopsO script cria um sandbox com idle_ttl_seconds=60, espera ele parar, acorda-o de um jeito diferente a cada vez e deixa ele parar de novo:
sb = create("05", idle_ttl_seconds=60)
sb.write("/root/wake.txt", "wake me\n")
url = sb.generate_download_url("/root/wake.txt")  # minted while running, fetched after the stop
idle_stop(sb, "after write()")
=== Idle stop with idle_ttl_seconds=60: my2cents-lc-05-44183274 =
[ 60.4s] after write(): idle -> stopped
=== Wake triggers ===============================================
read -> b'wake me\n'
[ 1.33s] wake via read()
status: ready
[ 60.4s] after read(): idle -> stopped
run -> 'wake me\n'
[ 4.03s] wake via run()
[ 62.6s] after run(): idle -> stopped
HTTP 200 'wake me\n'
[ 1.54s] wake via download URL (no credentials)
status: ready
[ 60.4s] after download: idle -> stopped
=== Service URL on a stopped (cold-boot) sandbox ================
HTTP 502 '{"detail":{"error":"BadGateway","message":"Could not connect to service on port 8000"}}'
[ 1.46s] GET service URL
status: ready
=== Does a running process count as activity? ===================
[ 60.4s] after the service request: idle -> stopped
[ 60.4s] detached 'nohup sleep 900 &' running: idle -> stopped
attached 'sleep 900' via run(wait=False), handle held open; watching for 4 minutes
[ 0.0s] ready
=== Service URL wake with preserve_memory_on_stop: my2cents-lc-05m-44804885
running: HTTP 200
[ 62.5s] after last request: idle -> stopped
HTTP 200 'served from memory'
[ 1.52s] wake via service URL
status: ready
=== Does service-URL traffic every 20 s keep it awake? ==========
[ 0.0s] ready
=== Traffic stops ===============================================
[ 47.8s] after last service request: idle -> stopped- O timer de inatividade é preciso. Com um TTL de 60 segundos, o sandbox parou 60,4 a 62,6 s depois da última chamada (polls de 2 segundos).
- Todo gatilho o acorda: uma leitura de arquivo (1,33 s), um comando (4,03 s aqui, 1,59 s em uma execução anterior), um link de download acessado por alguém sem credenciais (1,54 s) e um request para a service URL (1,46 s). Qualquer atividade o retoma, embora um sandbox padrão acorde com um cold boot, não com um resume de memória.
- Uma service URL acorda a VM, não o seu servidor. Em um sandbox padrão, o processo do servidor morreu com o stop, então o request que o acordou recebeu um 502. Em um sandbox com
preserve_memory_on_stop, o mesmo request voltou 200served from memoryem 1,52 s, porque o processo do servidor retomou junto com a VM. Se você está servindo qualquer coisa, esse é o motivo para ligar a flag. - Processos detached não contam como atividade. Com
nohup sleep 900 &rodando, o sandbox ainda assim parou em 60,4 s. Um comando iniciado comrun(..., wait=False)cujo handle continua aberto conta: o sandbox ficoureadydurante os 4 minutos inteiros de observação. O tráfego na service URL também conta: requests a cada 20 s o mantiveram de pé por 4 minutos. (Os 47,8 s no final são menores que o TTL porque o último request saiu cerca de 12 s antes de a observação terminar.)
Uma pegadinha me custou mais tempo do que qualquer outra coisa em toda esta avaliação. run("cd /root && nohup python3 -m http.server 8000 >/dev/null 2>&1 &") nunca retorna, e ignora timeout=10. Ele ficou travado por mais de 40 segundos em uma sondagem e por mais de 18 minutos na minha primeira execução deste teste, o que também manteve o sandbox acordado o tempo todo. Redirecionar o stdin de /dev/null e usar setsid não ajudou. Outros comandos em background (nohup sleep, um servidor Node, nc -l, o loop de contador em shell) retornaram em cerca de meio segundo. O workaround está no script: inicie servidores com run(..., wait=False) e descarte o handle, assim o servidor continua rodando e o sandbox ainda pode ficar ocioso.
server = sbm.run("python3 -m http.server 8000 --directory /root", wait=False, timeout=3600)
del server
Teste 6: Listar, filtrar e reconectar a partir de outro processo
python 06_list_connect.pyO list_sandboxes() do SDK não aceita filtros e retorna tudo o que existe no workspace. Filtragem, paginação e labels estão no endpoint REST:
items = rest("GET", "/boxes", params={"label": "user=alice"})["items"]
rest("PATCH", f"/boxes/{bob.name}", json={"labels": {**DEMO_LABELS, "test": "06", "user": "robert"}})
# ...in a second Python process, with only the sandbox name and a command id:
sb = client.get_sandbox(name)
h = sb.reconnect(cmd_id)
=== Listing =====================================================
SDK list_sandboxes() (no filters): 4 sandboxes in the workspace
GET /boxes {'label': 'demo=my2cents-lifecycle'}: ['-', 'alice', 'bob', 'carol']
GET /boxes {'label': 'user=alice'}: ['alice']
GET /boxes {'label': 'user'}: ['alice', 'bob', 'carol']
GET /boxes {'created_by': 'me', 'name_contains': 'lc-06'}: ['alice', 'bob', 'carol']
page_size=2: 2 items + next_cursor=True, page 2: 1 items, next_cursor=None
=== Does list() lag get() after a stop? =========================
[ 0.43s] get=stopped list=stopped status=stopped filter=1
=== Labels on update? ===========================================
PATCH labels -> {'demo': 'my2cents-lifecycle', 'test': '06', 'user': 'bob'}
=== Second process: wake a stopped sandbox and reattach to a command
parent: started command 01a1857b..., saw 'line 1', then disconnected
child: get_sandbox -> status ready [0.36s]
child: run() on it -> 'written by the parent' [0.38s]
child: reconnect(01a1857b...) replayed 14 chunks, first ['line 1\nline 2'] last ['line 15'] exit=0 [14.15s]
parent: stopped my2cents-lc-06-40818248; child again, with the old command id
child: get_sandbox -> status stopped [0.41s]
child: run() on it -> 'written by the parent' [2.00s]
child: status now ready
child: reconnect(01a1857b...) -> SandboxOperationError: Command not found: 01a1857b72b87649a58239d9e037f70d [CommandNotFound](Linhas de status e de tempo do processo filho cortadas. O - no primeiro filtro é um sandbox de outro teste que carrega o label demo, mas não tem user.)
- Filtre por label na REST.
label=key=valueelabel=keyfuncionam, assim comocreated_by=me,name_containse paginação por cursor. - Labels só podem ser definidos no create, e a API não avisa. Um
PATCHcom novos labels retornou 200 e não mudou nada:bobcontinuoubob. Defina os labels no create, ou você vai achar que reetiquetou sandboxes que não reetiquetou. - Sem atraso na listagem. Tanto
getquantolistdisseramstoppedno primeiro poll, e o filtrostatus=stoppedo encontrou. - Reconectar funciona entre processos. Um segundo processo, só com o nome do sandbox e um command id, pegou o sandbox em 0,36 s, incluindo os imports, e reproduziu a saída do comando desde o início enquanto o acompanhava até o fim. Depois de um stop, o mesmo processo filho acordou o sandbox com um
run()em 2,00 s, mas o command id antigo tinha sumido: comandos não sobrevivem a um stop a frio.
Teste 7: Snapshots e “fork”
python 07_snapshot_fork.pyNão existe fork() na API. O padrão é capture_snapshot() em um sandbox rodando, depois N creates a partir dele:
stream = src.run("for i in $(seq 1 20); do echo $i; sleep 1; done", wait=False)
snap = src.capture_snapshot(SNAP, timeout=300)
f = create(f"07f{i}", snapshot_id=snap.id)
# memory snapshot, REST only
mem = rest("POST", f"/boxes/{src.name}/snapshot", json={"name": f"{PREFIX}-warm", "include_memory": True})
mem = client.wait_for_snapshot(mem["id"], timeout=300)
m = create("07m", snapshot_id=mem.id, restore_memory=True)
=== Source: my2cents-lc-07-40987117 =============================
[ 0.99s] capture_snapshot() while a command streams
snapshot e0fa32c2-eaf0-4099-9c01-e7593dc172b7 status=ready fs_capacity 16 GiB fs_used 0.00 GiB source=01a1857d-f64e-720d-a3fd-879147912a1b tags=['latest']
stream on the source after capture: last line ['20'] exit=0
source status: ready
=== 3 sandboxes from the snapshot, one after another ============
[ 1.42s] fork 0
[ 1.34s] fork 1
[ 0.65s] fork 2
sequential median 1.34s
fork 0: 'base fork-0 cowsay 6.1\nno-stream-process'
fork 1: 'base fork-1 cowsay 6.1\nno-stream-process'
fork 2: 'base fork-2 cowsay 6.1\nno-stream-process'
source : 'base'
=== Delete the snapshot while forks use it ======================
delete_snapshot: SandboxClientError: snapshot is in use by one or more sandboxes or functions; release or delete them before deleting it
=== 3 sandboxes from the snapshot, concurrently =================
each: 0.62s, 0.58s, 0.57s | wall 0.62s
=== Memory snapshot (REST only) =================================
[ 3.13s] POST /boxes/{name}/snapshot include_memory=true
memory snapshot 7ff94545-3361-48c0-a307-cb9c30a2acf5: memory_snapshot_size_bytes=2147483648
[ 0.84s] create from memory snapshot (restore_memory=true)
restored counter 5 -> 7 two seconds later, uptime 46.37s (process resumed)- A captura é rápida e não perturba a origem. 0,99 s aqui (1,86 s em outra execução), enquanto um comando fazia streaming na origem; o stream terminou normalmente e a origem continuou
ready. (fs_usednão é reportado; o script imprime 0 para um valor ausente.) - Forks são cópias do filesystem. Três sandboxes criados a partir do snapshot tinham, cada um, o arquivo e o venv com
cowsay, gravaram na própria cópia e deixaram a origem em paz. O processo de streaming não foi junto. Creates sequenciais levaram de 0,65 a 1,42 s (0,57 a 2,15 s na execução gravada para o vídeo); três em paralelo levaram 0,62 s de tempo de relógio. - Snapshots de memória existem, via REST. Com
include_memory: true, a captura levou 3,13 s e armazenou os 2 GiB inteiros de RAM. Um sandbox criado a partir dele comrestore_memory: trueficou pronto em 0,84 s com o processo do contador ainda contando e com o uptime da origem (46 s): uma restauração real da memória da VM, e o mais perto que o LangSmith chega de fazer fork de estado vivo. - Você não consegue excluir um snapshot que sandboxes estão usando, e o erro é um
SandboxClientErrorgenérico, não oResourceInUseErrorque o SDK define.
A armadilha está nos nomes. Capturar de novo com o mesmo nome de snapshot não substitui o snapshot antigo. O novo recebe a tag latest, e o antigo fica, sem tag, cobrando storage até você excluí-lo. Minhas execuções repetidas dos Testes 7 e 8 tinham deixado 15 snapshots para trás quando rodei a limpeza no meio da sessão.
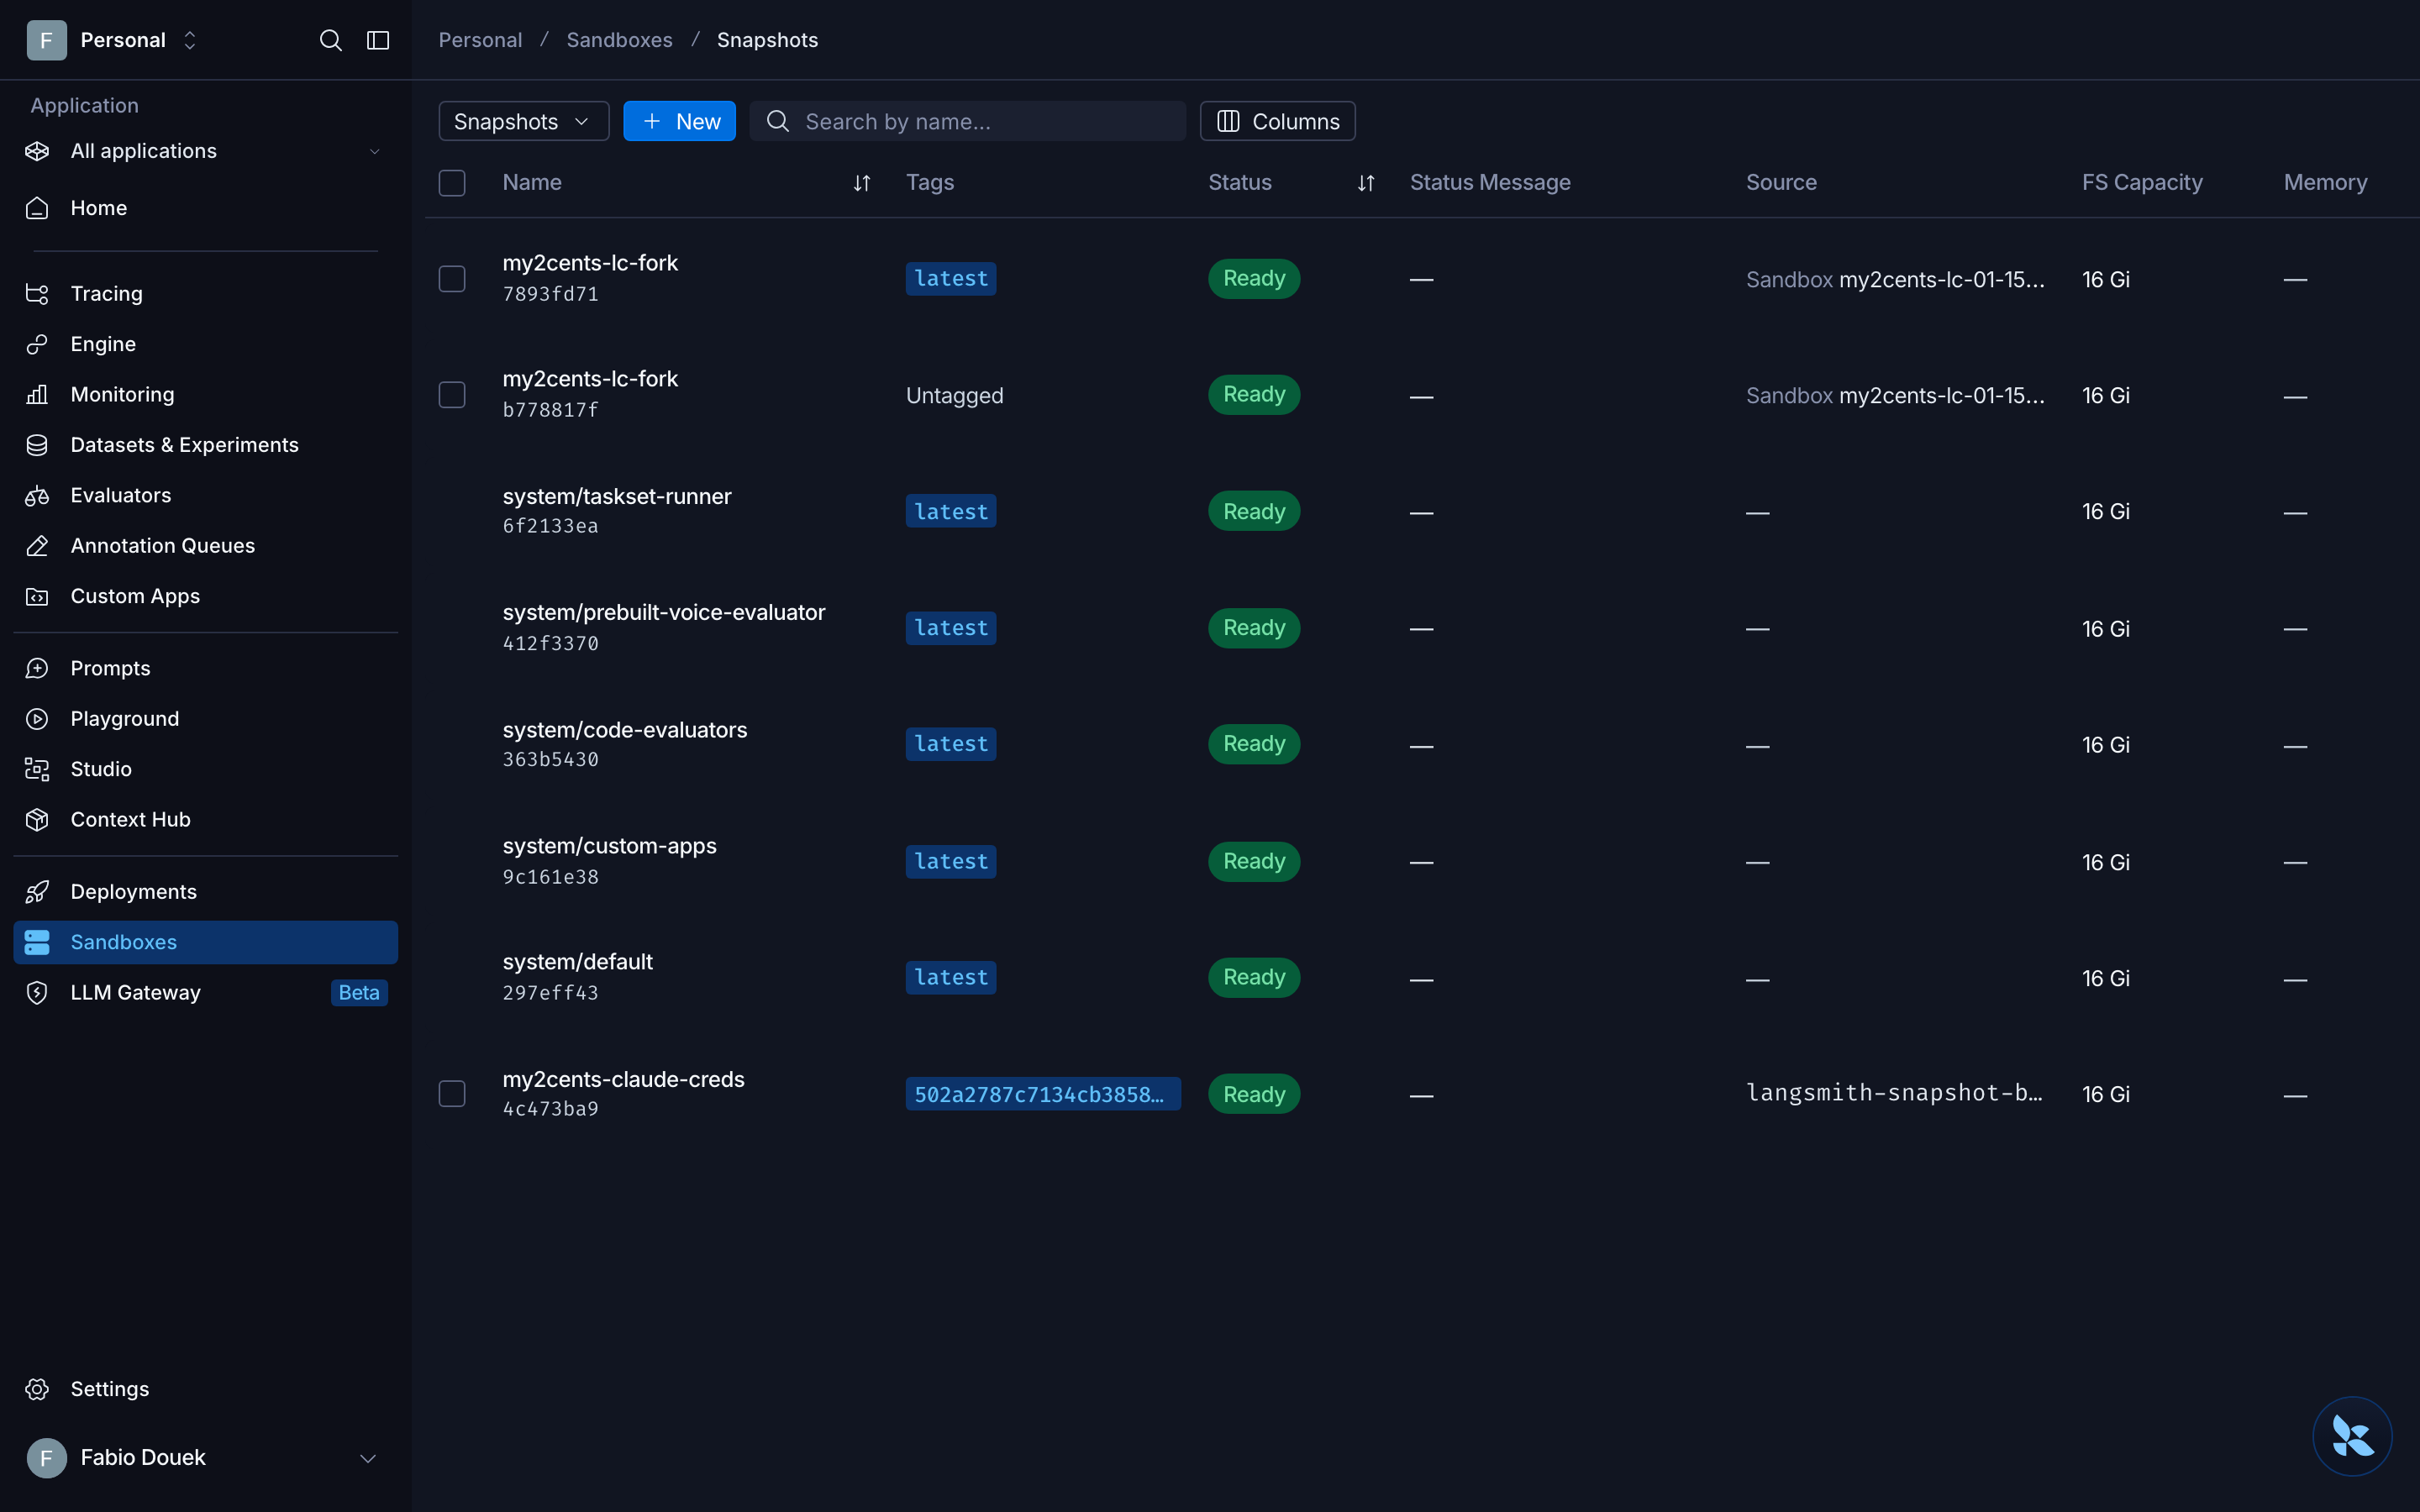
O console deixa a armadilha visível: duas linhas com o mesmo nome, e só a coluna de tag as diferencia.
Teste 8: Um snapshot customizado vs instalar em runtime
python 08_custom_snapshot.pyO teste usa pandas, numpy e matplotlib, que a imagem padrão não tem. O Caminho A os instala em um venv em runtime. O Caminho B faz o build de um snapshot a partir de um Dockerfile de duas linhas:
FROM python:3.12-slim
RUN pip install --no-cache-dir pandas numpy matplotlib
# The default 10 s HTTP timeout is too short for the export call at the end of a Dockerfile build: the
# server creates the snapshot anyway, but the SDK raises ReadTimeout and you lose the handle.
client = SandboxClient(timeout=120)
snap = client.create_snapshot_from_dockerfile(
f"{PREFIX}-datasci", "Dockerfile", context="datasci", fs_capacity_bytes=16 * GiB, vcpus=2, mem_bytes=8 * GiB,
on_build_log=log_lines.append, timeout=900)=== Default snapshot: is pandas already there? ==================
ModuleNotFoundError: No module named 'pandas'
15
=== Path A: default snapshot + install at runtime ===============
[ 21.97s] venv + pip install pandas numpy matplotlib
exit=0
import: first 0.38s, second 0.32s | create-to-import total 23.66s
=== Build a snapshot from a Dockerfile (temporary BuildKit builder sandbox)
[ 66.49s] create_snapshot_from_dockerfile(vcpus=2)
snapshot 58ffaa67-4cc2-4541-a3de-97c045913597 status=ready tags=['f425a454dcc344a6b9032baf42081601']
by bare name: ResourceNotFoundError: Snapshot 'my2cents-lc-datasci' not found
=== Build a snapshot from a public image (platform pull) ========
snapshot cec5ea04-d587-49e3-9c72-7133af0dc135 status=ready tags=['3.12-slim']
[ 33.09s] create_snapshot(docker_image='python:3.12-slim')
=== Path B: sandbox from the custom snapshot ====================
[ 2.76s] create from snapshot
import: first 3.97s, second 0.48s | create-to-import total 9.62s
'Python 3.12.16\nroot\n/'O snapshot customizado vence: 9,62 s do create até o primeiro import vs 23,66 s instalando em runtime (4,48 a 9,62 s vs 21,7 a 28,7 s nas minhas execuções, incluindo 4,85 s vs 22,98 s na última). O relógio do Caminho A começa depois que o sandbox dele já existe, então deixa de fora um create de cerca de meio segundo; o do Caminho B inclui o create. O primeiro import no snapshot é a parte lenta, 3,97 s aqui contra 0,48 s no segundo, o que parece o disco sendo carregado de forma lazy.
Chegar lá exigiu algumas tentativas e erros:
create_snapshot_from_dockerfile() usa por padrão context="." e empacota tudo o que está lá dentro em um tar para o sandbox de build, pulando apenas o .git e ignorando o .dockerignore. Rode isso a partir da raiz de um projeto e o seu .env e o seu .venv vão junto. Aponte context= para uma pasta que contenha só o Dockerfile, como o script de apoio faz com datasci/.
- O snapshot não recebe a tag
latest. Um build de Dockerfile recebe a tag aleatória da imagem de build, entãocreate_sandbox(snapshot="my2cents-lc-datasci")retornouHTTP 404 ... snapshot "my2cents-lc-datasci:latest" not found, eget_snapshot()pelo nome também falhou. Um nome sem tag significaname:latest, e o fallback da docstring só cobre o snapshot sem tag mais recente, então um snapshot com tag de build não pode ser encontrado pelo nome de jeito nenhum. Use o id do snapshot. (Um snapshot de uma imagem pública recebe a tag da imagem,3.12-slimaqui.) - O timeout HTTP de 10 segundos do SDK perde snapshots. Em uma execução, a chamada final de export estourou o timeout depois que o BuildKit já tinha terminado. O snapshot foi criado no servidor e o sandbox de build foi excluído, mas o meu código recebeu um
httpx.ReadTimeoute nenhum handle.SandboxClient(timeout=120)resolve. - 16 GiB é o tamanho mínimo para um build de Dockerfile. Com
fs_capacity_bytesem 8 GiB, o SDK levantoufs_capacity_bytes (8589934592) cannot be smaller than snapshot (17179869184), porque o builder faz boot a partir da imagem padrão de 16 GiB. A partir de uma imagem pública, 4 GiB funcionou. - O tempo de build depende do que você faz upload. 66,49 s com um contexto contendo só o Dockerfile; 77,64 s e 81,05 s em execuções anteriores que fizeram upload do projeto inteiro. O pull do Docker Hub passou pela allow list de egress sem problemas. Um snapshot direto de
python:3.12-slimlevou de 22,18 a 33,09 s em cinco execuções.
Teste 9: A quota e a conta
python 09_quota_bill.py=== Does a stopped sandbox count against the cap? ===============
before used 2/10 | running 2 stopped 0 | cpu 2500 m | memory 10 GiB | snapshots 15
4 running used 6/10 | running 6 stopped 0 | cpu 4500 m | memory 18 GiB | snapshots 15
2 running, 2 stopped used 4/10 | running 4 stopped 2 | cpu 3500 m | memory 14 GiB | snapshots 15
after delete used 2/10 | running 2 stopped 0 | cpu 2500 m | memory 10 GiB | snapshots 15
=== The bill: GET /usage/costs, last 24 hours ===================
totals: {'lcu': '0', 'lsu': '0', 'compute_standard_units': '0', 'storage_standard_units': '0', 'vcpu_hours': '0', 'memory_gib_hours': '0', 'storage_gib_hours': '0'}Outra execução de teste estava compartilhando o workspace, então leia as diferenças, não os números absolutos:
- Sandboxes parados não contam contra o limite. Quatro sandboxes novos somaram 4 a
sandboxes_used; parar dois deles baixou o número em 2, enquantostoppedfoi para 2. As reservas de CPU e memória também caíram no stop. Cada sandbox padrão reservou 500 millicores e 2 GiB, batendo com o Teste 1. Então, em um plano de 10 sandboxes, você pode manter bem mais de 10 sandboxes por aí, desde que no máximo 10 estejam acordados. O changelog diz que acordar um sandbox parado verifica a quota e retorna 429 quando você está acima dela; mantive no máximo um punhado vivo e não testei isso. - A API de custos tem um atraso de cerca de um dia.
GET /usage/costsretornou zero itens e totais zerados para as últimas 24 horas e para os últimos 30 dias, embora houvesse sandboxes rodando desde a noite anterior. Quando rodei o script de novo algumas horas depois, ele retornou uma linha: um sandbox do dia anterior, a 0,000061 no campolcuda API (0,0007 vCPU-hora; a página de preços cobra em LSU). Dezenas de sandboxes posteriores ainda estavam faltando. Mais sobre isso em Preços.
Resumo dos resultados
| Operação | Medido (SDK 0.14.14, GCP US, a partir do meu laptop) |
|---|---|
create_sandbox() (snapshot padrão, sequencial) |
mediana 0,51–0,59 s (0,50–0,62 s, duas execuções com n=5) |
Create + primeiro run() |
mediana 0,91 s |
stop() / start(), padrão (cold boot) |
mediana 0,53 s / 1,62 s |
stop() / start(), preserve_memory_on_stop |
mediana 2,33 s / 0,91 s |
Idle stop com idle_ttl_seconds=60 |
60,4–62,6 s |
Auto-wake via read() / run() / link de download / service URL |
1,33 s / 1,59–4,03 s / 1,54 s / 1,46 s |
| Wake via service URL, sandbox com memória preservada | 1,52 s, servidor ainda rodando |
get_sandbox() / wake via run() a partir de um segundo processo |
0,36–0,41 s com imports / 2,00 s |
capture_snapshot() (filesystem) |
0,99–1,86 s |
| 3 sandboxes a partir de um snapshot, sequencial / concorrente | mediana 1,34 s / 0,62 s de tempo de relógio |
Snapshot de memória / create com restore_memory |
3,13 s (2 GiB) / 0,84 s |
| Build de snapshot via Dockerfile (pandas, numpy, matplotlib) | 66,49 s |
Tempo até o primeiro import pandas: instalação em runtime vs snapshot |
21,7–28,7 s vs 4,48–9,62 s |
| Timeout padrão de comando | 60 s, retorna exit -1 sem levantar exceção |
São medições de uma única região, a partir de um laptop em uma conexão doméstica, em um workspace que outro teste também estava usando. Use-as como noção de escala, não como benchmark.
Preços
O LangSmith cobra os sandboxes por segundo em LSU, onde 1 LSU equivale a $1 (preços):
| Recurso | Tarifa |
|---|---|
| vCPU | 0,0576 LSU / vCPU-hora |
| Memória | 0,01845 LSU / GiB-hora |
| Storage | 0,000123 LSU / GiB-hora |
| Sandbox padrão (0,5 vCPU, 2 GiB) | ≈ $0,066 / hora enquanto ready, mais storage |
| 16 GiB de storage | ≈ $0,002 / hora |
| Plano | Preço | Sandboxes |
|---|---|---|
| Developer | Gratuito | Inclui 8 LSU; limitado a 10 sandboxes |
| Plus | $39 / assento / mês | Inclui 8 LSU de uso de sandbox por mês |
| Enterprise | Sob consulta | Sob consulta; egress irrestrito |
No tamanho padrão, 8 LSU equivalem a cerca de 120 horas de um sandbox ready. Três coisas que não consegui confirmar:
- Se o padrão é cobrado como 0,5 ou 1 vCPU. A API REST retorna tanto
cpu_millicores: 500quantovcpus: 1, e o SDK só expõe o 1. Tudo o que aplica ou contabiliza CPU usa o 500: a aba Metrics desenha o limite configurado em 0,50 vCPU, e o card Resource Usage contou dois sandboxes rodando como 1 vCPU. Só a coluna de CPU da tabela Boxes mostra “1 vCPU”. Assumi 0,5 acima, mas nenhuma página de preços diz qual dos dois é cobrado, e a API de custos não tinha dados dos meus sandboxes quando verifiquei. - Quanto custa um sandbox parado. Nenhuma página diz. A referência da API de custos mede compute por sandbox e storage por sandbox e por snapshot, então um sandbox parado deveria acumular só storage, e a quota para de contar a CPU e a memória dele (Teste 9). O storage é descrito como alocado por bytes atribuídos, então pode estar mais perto dos 3,3 GB em uso do que dos 16 GiB de capacidade.
- Quanto este walkthrough custou. A API de custos teve um atraso de cerca de um dia: primeiro retornou zeros e, horas depois, mostrou apenas o único sandbox do dia anterior, a 0,000061 LCU. Então não tenho um número completo da minha conta, e não vou estimar um a partir das tarifas. A página de uso na UI do LangSmith é o outro lugar para olhar.
O que a tabela de preços não mostra é que o LangSmith é uma compra de plataforma. Não existe conta só de sandbox: você precisa de uma organização LangSmith, os assentos Plus têm preço para a plataforma inteira, e egress irrestrito é uma feature Enterprise.
Limpeza
Duas coisas ficam para trás aqui: sandboxes parados (14 dias por padrão) e snapshots (nenhuma configuração de expiração que eu tenha encontrado, inclusive para os sem tag gerados por recapturas). O último script do repositório de apoio encontra tudo por label e por prefixo de nome, exclui os sandboxes em lote, espera as exclusões terminarem (um snapshot não pode ser excluído enquanto um sandbox ainda o usa) e então exclui os snapshots:
names = ours()
if names:
    res = rest("POST", "/boxes/batch-delete", json={"names": names})
# ...wait until ours() is empty...
for s in snaps:
    if s.name.startswith(PREFIX):
        client.delete_snapshot(s.id)
=== Sandboxes labelled {'demo': 'my2cents-lifecycle'} or named my2cents-lc-*
remaining: []
=== Snapshots named my2cents-lc-* ===============================
left: []
quota now: sandboxes 1/10 (running 1, stopped 0) | snapshots 1Essa é a execução final; o sandbox e o snapshot restantes pertencem à parte 2. A execução do meio da sessão excluiu 3 sandboxes e 15 snapshots, quase todos sobras sem tag de rodar os Testes 7 e 8 de novo. Ele busca por prefixo de nome além de label porque sandboxes criados com o SDK não podem ter labels.
Para produção, eu definiria três coisas em todo sandbox: um delete_after_stop_seconds curto, para que sandboxes parados não fiquem parados por duas semanas, labels de usuário e job no create (você não consegue adicioná-los depois), e nomes de snapshot únicos ou uma limpeza explícita dos antigos.
Veredito
Os LangSmith Sandboxes têm um ciclo de vida que em grande parte se gerencia sozinho. Os sandboxes param quando ociosos, acordam em qualquer request sem um start() e podem manter a memória entre stops se você pedir no create. Os creates foram rápidos e consistentes, e a VM reporta o seu tamanho real. As arestas estão no client e na documentação, não na plataforma.
O que eu teria em mente antes de construir em cima dele:
- Conte com a API REST. Labels, filtros de listagem, redimensionamento,
preserve_memory_on_stop, snapshots de memória e uso não estão no Python SDK. O helper de 20 linhas no repositório de apoio cobre tudo isso, mas é o tipo de coisa que você mesmo vai manter. - Verifique todo exit code em busca de -1. Timeouts de comando retornam em silêncio em vez de levantar exceção, e o padrão é de 60 segundos. Configure o timeout HTTP do SDK acima de 10 s para builds de snapshot, e não inicie servidores com
nohup ... &. - Decida sobre memória no create. Um stop padrão é um reboot, então um servidor por trás de uma service URL volta como 502. Se os processos precisam sobreviver a idle stops, crie o sandbox com
preserve_memory_on_stop; não dá para ligar isso depois. - Limpe os snapshots de forma deliberada. Eles não têm expiração documentada, e cada recaptura com o mesmo nome deixa o antigo sendo cobrado.
- Verifique o egress antes de projetar. Em planos não Enterprise, a allow list cobre registries de pacotes, hosts Git e as principais APIs de modelos, e bloqueia todo o resto, incluindo toda a AWS. Uma exceção do suporte remove a lista por completo, e depois disso o
access_controlde cada sandbox é o seu único controle de egress.
Quem deveria usar
Os LangSmith Sandboxes se encaixam em times que já estão no LangSmith e querem a execução de código dos seus agents na mesma conta, chave e fatura do tracing, especialmente com Deep Agents, cuja documentação os posiciona como o backend padrão sem setup. O ciclo de vida com auto-wake combina com workspaces de agents que ficam em silêncio entre turnos, e o stop com preservação de memória dá uma pausa e retomada reais quando você precisa.
Se você não está no LangSmith, o argumento é mais fraco: uma conta de plataforma que precisa ser contratada, uma rede restrita fora do Enterprise e um SDK que cobre só parte da API. E se fazer fork de estado vivo é central para o seu produto, o snapshot de memória exclusivo da REST é o único caminho, e dá mais trabalho do que uma única chamada de fork.