Lambda MicroVM: Exploração Hands-On de Sandboxes Self-Service
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Parte 2, com o control plane ligado
- Passo 2: Uma imagem de sandbox para pessoas, não para scripts
- Passo 3: Deploy
- Testes
- Teste 1: Do login a um terminal
- Teste 2: Claude Code no navegador
- Teste 3: O feed do proxy e o uso de credenciais
- Teste 4: Tokens e custo
- Teste 5: Vitals e o custo de observar
- Teste 6: Suspender, retomar e a mesma tela do Claude
- Teste 7: Feche a aba, volte mais tarde
- Teste 8: Vários sandboxes, uma cota
- Teste 9: O painel de DNS
- Teste 10: Alterando a allowlist e as credenciais ao vivo
- Teste 11: Revogando uma credencial sem reiniciar
- Teste 12: Acesso à AWS: quatro roles e uma session policy opcional
- Teste 13: A proteção do Secrets Manager
- Teste 14: Os guardrails da role builder
- Preços
- Limpeza
- Veredito
- O que funciona
- O que não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine uma oficina de brinquedos que você abre pelo tablet. Você aperta um botão, uma oficininha aparece, e um robô ajudante lá dentro começa a construir o que você pedir, enquanto uma janela do lado mostra cada viagem que o robô faz até a loja.
Quando você larga o tablet, a oficina congela, e quando você volta o robô está segurando exatamente o mesmo bloquinho. Um adulto na porta da loja pode mudar quais lojas são permitidas enquanto os robôs trabalham, mas é uma porta só para todas as oficinas, então a regra muda para todas elas.
Esta é uma interface hospedada pela qual usuários autenticados rodam um agente de programação com IA em máquinas isoladas na conta AWS da organização. As credenciais reais deles ficam em um proxy operado pela organização, que registra em log todo request de saída e assina as chamadas à AWS com uma role escolhida por um administrador, e os administradores podem alterar ou retirar o acesso em cerca de 30 segundos.
O proxy é compartilhado, então o registro não consegue atribuir um request a uma única máquina, e toda mudança de policy vale para todas elas. A role da AWS mais ampla pode alterar a maior parte do que roda na região principal da conta, e o acesso de leitura ainda pode revelar configurações sensíveis. Trate isto como uma ferramenta para um único time, e conceda essas roles de forma deliberada.
A intervenção é um terminal no navegador para uma máquina descartável onde um agente de IA trabalha, com sinais vitais ao lado: chamadas de rede, uso de credenciais, consumo de tokens e CPU. Uma sessão suspensa voltou em cerca de um segundo, com o agente exatamente onde estava.
A prescrição do proxy, ou seja, quais sites, chaves e permissões da AWS os agentes recebem, pode ser ajustada enquanto eles rodam, mas uma única prescrição cobre todos os pacientes. Efeitos colaterais a monitorar: uma aba de terminal aberta mantém a máquina acordada e gerando cobrança.
Repare em como uma sessão com um agente fica mais tranquila quando você pode fechar o laptop sem perder nada. O trabalho fica congelado, não perdido, e ao voltar ele continua no meio da frase, então se afastar deixa de ser uma decisão.
Os painéis também mudam a relação: ver cada request e cada troca de credencial substitui uma confiança vaga por algo que você pode olhar. A questão em aberto é o compartilhamento. Todos no proxy veem o tráfego de todos, e a mudança de um admin alcança todos os sandboxes, o que pede uma conversa sobre quem fica com essa role.
Pense nisso como uma sala de ensaio que você reserva pelo navegador. A banda começa a tocar em segundos, a mesa de um técnico de som mostra cada canal que sai, e um pedal de pausa congela a sala inteira no meio do compasso.
Volte mais tarde, solte o pedal, e a banda está na mesma batida em cerca de um segundo. O técnico pode remanejar os canais entre as músicas sem parar o som, mas é uma mesa só para todas as salas do prédio, e uma linha aberta para uma sala a mantém acesa e gerando cobrança.
A proposta é "Claude Code em uma aba do navegador, na sua própria conta AWS, sem nada para instalar e nada a perder." Faça login, clique uma vez, e um agente já está trabalhando em uma máquina isolada, com cada request e cada token na tela e uma policy que você pode mudar enquanto ele roda.
As provas são concretas: segundos até um sandbox rodando, cerca de um segundo para retomar um, e mudanças no proxy valendo em cerca de 30 segundos. As ressalvas são honestas: um único proxy compartilhado, uma cota de MicroVMs que varia por conta, e uma implementação de referência, não um produto.
 Veja o código-fonte aqui: lambda-microvm-workspace
Visão Geral
A parte 1 mediu o que uma Lambda MicroVM consegue fazer, e a parte 2 cercou a rede dela e moveu as credenciais para um proxy. Este post, o último de três, faz a pergunta do usuário final: o que é preciso para colocar isso na frente de um desenvolvedor como algo que ele realmente usaria? Uma aba do navegador, um sandbox por tarefa, o Claude Code em um terminal e visibilidade suficiente para confiar no que o agente está fazendo.
Trate isto como uma exploração, não como um produto: uma implementação de referência de um playground self-service, não algo para rodar em produção. Eu queria ver como ficam sandboxes self-service construídos a partir dessas peças: o que as Lambda MicroVMs facilitam, onde elas oferecem resistência e quais ideias se sustentam quando uma pessoa real, e não um script de teste, está clicando por aí. Por isso o workspace é deliberadamente amplo e um pouco cru. Ele experimenta coisas (um feed ao vivo do proxy, uma página de policy que altera o proxy enquanto os sandboxes rodam, chamadas à AWS a partir de um terminal que não guarda nenhuma chave da AWS) para descobrir quanto elas custam e o que revelam, e vários dos achados mais úteis abaixo vieram de funcionalidades que não deram certo na primeira tentativa.
Então eu construí um, o My2cents.ai Lambda MicroVM Playground, e fiz o deploy na AWS. Você faz login com o Cognito, cria um sandbox de 1, 2, 4 ou 8 GB e recebe um terminal dentro dele com o Claude Code pronto para rodar. O terminal vive no tmux dentro da MicroVM, então fechar a aba, perder a rede ou suspender o sandbox não faz a sessão se perder. Em volta do terminal, cinco painéis mostram o que o sandbox faz: cada request que passa pelo iron-proxy da parte 2 e qual credencial foi injetada, com que frequência cada credencial é usada, o uso de tokens e o custo do Claude Code, os sinais vitais e os timers da MicroVM, e as consultas DNS na VPC do sandbox da parte 2 que o resolver dela não responde a partir do cache. Os admins ganham uma página Proxy policy que altera a allowlist, as credenciais e a role da AWS do proxy enquanto os sandboxes rodam, e uma aba Config que mostra a configuração do proxy como está armazenada, lado a lado com o que o iron-proxy aplicou.
Todo sandbox roda sobre o design da parte 2 do jeito que ele é: a VPC do sandbox da parte 2, o connector dela e o seu único iron-proxy, em modo transparente, sem nenhuma configuração de proxy no sandbox. A página de policy precisa do control plane opcional da parte 2, que você liga na parte 2 antes de fazer o deploy do workspace. Eu escrevi uma spec e coloquei quatro subagents do Claude Code para construir em paralelo a imagem do sandbox, o backend, o frontend e a infraestrutura, e depois eu mesmo integrei e testei o resultado após o deploy. Os resultados abaixo vêm de duas rodadas: a primeira versão do workspace, em 2026-11-03, e o design com proxy compartilhado sobre as duas VPCs da parte 2, em 2026-11-04, ambas em us-east-1.
Arquitetura
Quatro escolhas moldaram o resto:
- O navegador nunca fala diretamente com uma MicroVM. Qualquer endpoint ou token de shell de uma MicroVM é root naquele sandbox, então entregar tokens a navegadores seria distribuir root. A própria API emite tokens de shell de curta duração e faz a ponte do terminal.
- O tmux, não o WebSocket, é a sessão. A parte 1 mostrou que os processos sobrevivem a uma suspensão e as conexões não. Então o shell se anexa a uma sessão tmux chamada
main, e cada reconexão apenas se anexa a ela de novo. - Um proxy para todos os sandboxes. Todos os sandboxes compartilham o iron-proxy da parte 2, a policy dele e o log de auditoria dele. A parte 2 mostrou que o proxy não consegue distingui-los, então os painéis Proxy, Credentials e DNS não conseguem associar uma linha a um único sandbox, e uma mudança de policy vale para todos os sandboxes ao mesmo tempo. Identidade por sandbox no proxy fica como trabalho futuro.
- A policy vive no S3 e é aplicada por reload. Com o control plane da parte 2 ligado, o iron-proxy roda com um sidecar de controle que observa a configuração dele no S3, assume a role da AWS que a policy indica e faz o reload do iron-proxy via loopback na verificação seguinte, em cerca de 30 s. Nada é reiniciado, e nenhum sandbox é tocado.
Configuração
Passo 1: Parte 2, com o control plane ligado
O workspace se apoia nas duas VPCs, no NAT gateway, no cluster ECS, na CA e no iron-proxy da parte 2, lê esses recursos do state do Terraform da parte 2 e adiciona uma segunda subnet pública à VPC do proxy da parte 2 para o seu ALB. Ele precisa da flag opcional control_plane da parte 2, que você liga na parte 2 antes de fazer o deploy do workspace, no terraform.tfvars, para que os applies seguintes a mantenham:
echo 'control_plane = true' >> infra/terraform.tfvars   # in part 2's directory
terraform -chdir=infra apply
Ela muda três coisas no infra/ da parte 2:
- A configuração vai para o S3. Um bucket,
my2cents-ip-control-<random>, guarda a configuração do iron-proxy (iron-proxy.yaml) e o escopo AWS (aws-scope.json: a role e a session policy opcional). O sidecar grava ostatus.jsonao lado deles, e o workspace guarda emcredentials.jsonos metadados das credenciais que os admins adicionam; os valores delas vão para o Secrets Manager, sobmy2cents-ip/user/. - Um sidecar de controle entra na task do iron-proxy, dentro dos mesmos 0,5 vCPU e 1 GB. Ele faz polling do S3 a cada 30 s (o
control_poll_sda parte 2). Quando o escopo muda, ele assume a role que o escopo indica, com a session policy opcional; em qualquer mudança, ele chama o reload do iron-proxy via loopback com um token de gerenciamento e grava ostatus.json, incluindo o que o STS informou sobre o token de sessão. Assim, uma mudança entra em vigor na verificação seguinte: em até cerca de 30 s, mais uma fração de segundo, já que o reload acontece 0,08 a 0,24 s depois que o sidecar busca o novo objeto. O sidecar também recusa qualquer configuração que liste o Secrets Manager emallowed_servicesou na allowlist; essa verificação foi testada offline, contra 16 configurações na imagem do sidecar, e não em uma execução ao vivo. - As chamadas à AWS são assinadas com uma role selecionável em vez da task role, em uma sessão chamada
proxy-<role>-v<scope version>.
Ligar a flag substitui a task do iron-proxy: o apply levou 20 s e o rollout, cerca de 3 minutos. O README da parte 2 tem os detalhes.
As quatro roles, chamadas my2cents-ip-<role>, confiam apenas na task role do iron-proxy:
| Role | Permissões |
|---|---|
view-only (padrão) | AWS ViewOnlyAccess: listar e descrever, sem leitura de dados |
read-only | AWS ReadOnlyAccess: leituras, incluindo dados de objetos e itens |
data-reader | o bucket de demonstração da parte 2 e as tabelas DynamoDB my2cents-demo-*, somente leitura; nada mais |
builder | AWS PowerUserAccess com guardrails: somente us-east-1, sem mudanças nesta stack nem na da parte 2, sem assumir roles; pode criar recursos que geram cobrança |
Toda role também permite secretsmanager:GetSecretValue nos segredos do próprio proxy (os três da parte 2 e as credenciais que os admins adicionam sob my2cents-ip/user/), porque o iron-proxy busca os segredos que injeta com essa mesma sessão. E toda role nega qualquer outra ação e qualquer outro segredo do Secrets Manager, além de ssm:GetParameter*, que retorna valores SecureString descriptografados.
Passo 2: Uma imagem de sandbox para pessoas, não para scripts
images/sandbox/ repete a imagem da parte 2 (Claude Code, gh, git, a AWS CLI e a CA do proxy) e adiciona o tmux, o tini como PID 1 (o agente da parte 2 como PID 1 deixava processos zumbis para trás) e um Claude Code que inicia direto no prompt. Essa última parte exigiu experimentação: iniciar o claude no tmux só com a chave placeholder e remover uma configuração de cada vez. No Claude Code 2.1.317, quatro chaves no ~/.claude.json e duas no settings.json decidem isso:
| Chave | Sem ela |
|---|---|
hasCompletedOnboarding: true | o seletor de tema e o onboarding |
customApiKeyResponses.approved: [last 20 characters of the key] | ”Do you want to use this API key?”, com No como padrão |
projects["/root/work"].hasTrustDialogAccepted: true | o prompt de confiança da pasta |
hasSeenAutoDefaultNudge: true | um prompt “auto mode?” quando o proxy está inacessível, em que o Enter muda o seu padrão |
permissions.defaultMode: "bypassPermissions" (settings) | o modo manual, que pede confirmação antes de cada edição e de cada comando |
skipDangerousModePermissionPrompt: true (settings) | uma tela de aviso antes de o bypass mode iniciar |
O bypass mode é uma escolha deliberada: a MicroVM é o sandbox, as únicas credenciais dela são placeholders e cada request que ela faz aparece no feed do proxy. Um prompt de permissão em um terminal que ninguém está olhando só trava o agente. O Claude Code também recusa o bypass mode como root, a menos que IS_SANDBOX=1 esteja definido.
O hook /validate da imagem faz o warm-up do Claude Code, do node, do git e da AWS CLI (a parte 1 mostrou que o que o /validate toca é pré-carregado). Uma pegadinha: o Lambda derruba cada request /validate em algum ponto antes dos 12 segundos, então o primeiro build falhou até o warm-up passar a rodar em segundo plano, respondendo 503 até terminar.
Passo 3: Deploy
bash scripts/deploy.sh                                   # image, Terraform, backend, frontend
bash scripts/create_user.sh --admin you@example.com      # prompts for a password; --admin may edit policies
O scripts/deploy.sh verifica se a parte 2 é a stack de duas VPCs (e avisa se o control plane dela estiver desligado: o workspace continua funcionando, mas a página Proxy policy fica somente leitura e a revogação reinicia o proxy), faz o build das quatro imagens de sandbox, uma por tamanho, uma depois da outra (cerca de 3 minutos cada) quando elas não existem ou foram construídas para outra CA, faz o build da API para ARM64 e o push para o ECR, aplica o infra/, faz o build do frontend e o sincroniza com o S3, e espera o serviço. O primeiro deploy levou cerca de 13 minutos quando havia uma única imagem; eu não cronometrei um com quatro. Os quatro builds de imagem levaram de 181 a 196 s cada, cerca de 12,6 minutos em sequência, e o deploy.sh os roda em paralelo com a API, o Terraform e o frontend e depois espera por eles, então conte com pelo menos uns 13 minutos; o Terraform cria 38 recursos, 39 com a IAM policy do control plane. Ele se autentica no ECR com um pequeno credential helper em vez de docker login, que precisa do keychain do macOS e falha em um shell não interativo. A task role da API tem escopo restrito às quatro imagens de sandbox, mais lambda:PassNetworkConnector no connector da parte 2 e servicequotas:GetServiceQuota para ler a cota de MicroVMs. Gravações de policy exigem o grupo admins do Cognito: uma mudança alcança todos os sandboxes, e uma role como builder alcança a maior parte da conta, então escolhê-la não deveria ficar a critério de qualquer usuário.
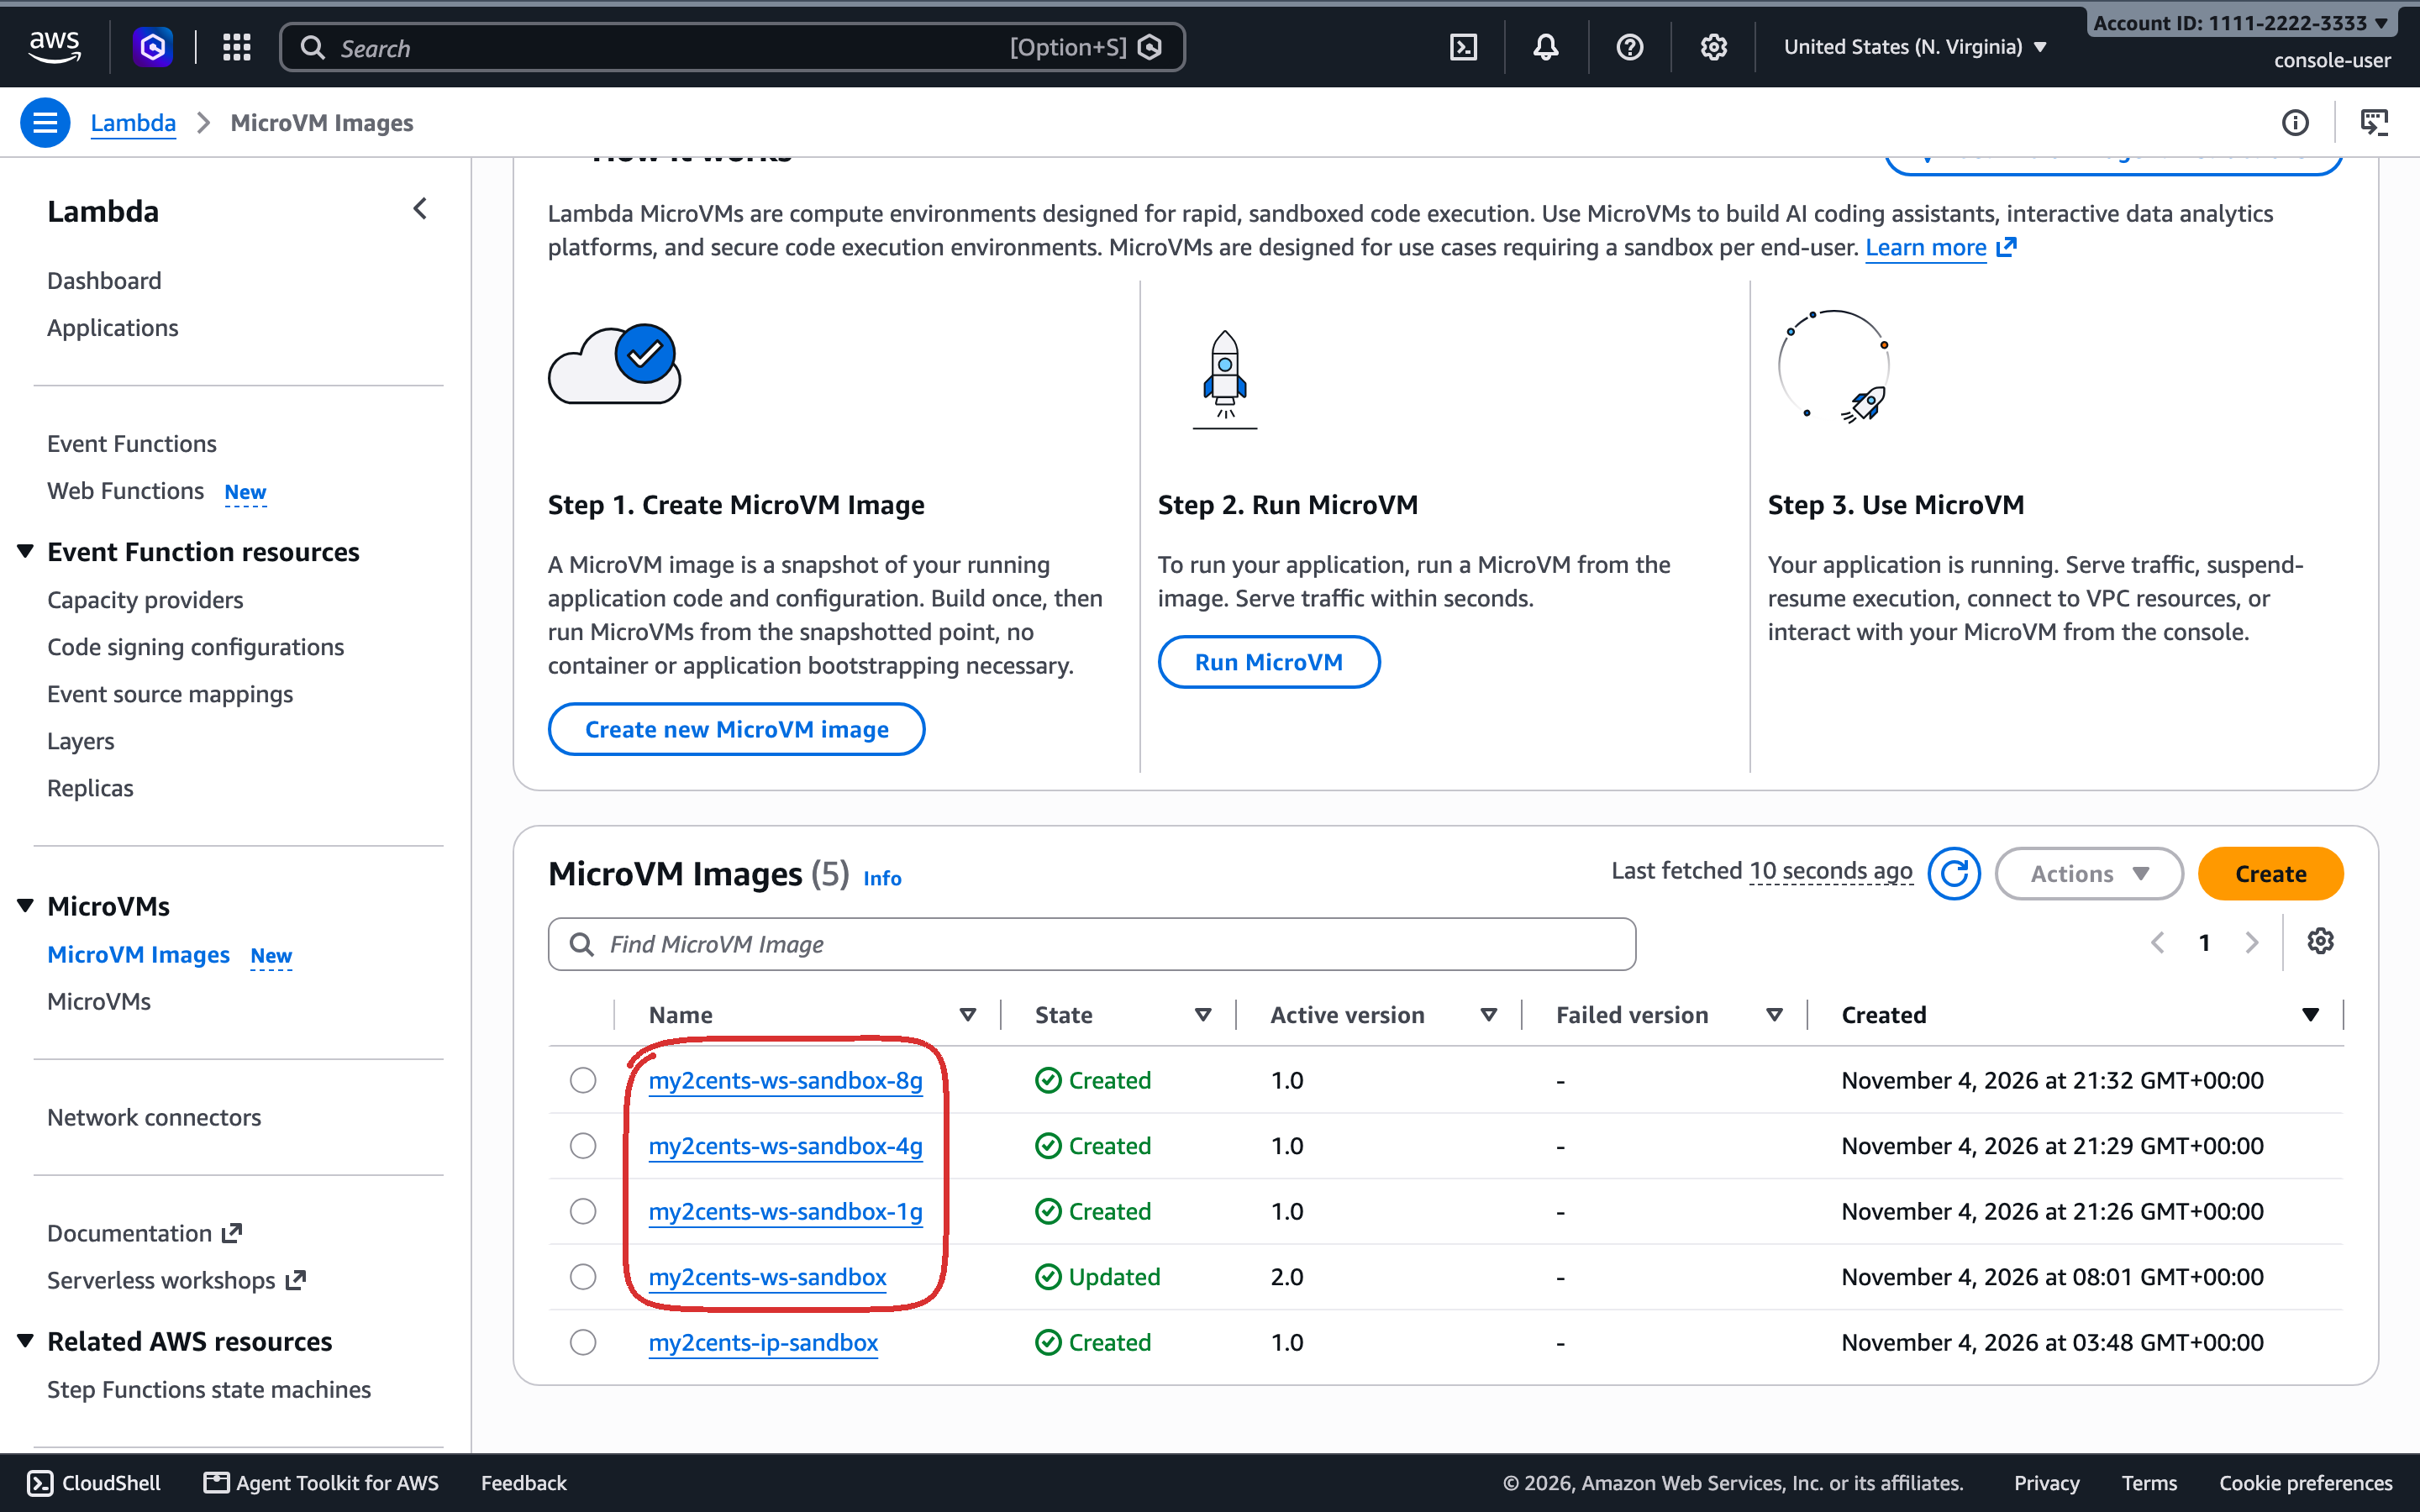
Cada tamanho é uma imagem de MicroVM própria, porque a memória de uma MicroVM vem da imagem: a versão de cada imagem define minimumMemoryInMiB (1024, 2048, 4096 ou 8192).
Testes
Teste 1: Do login a um terminal
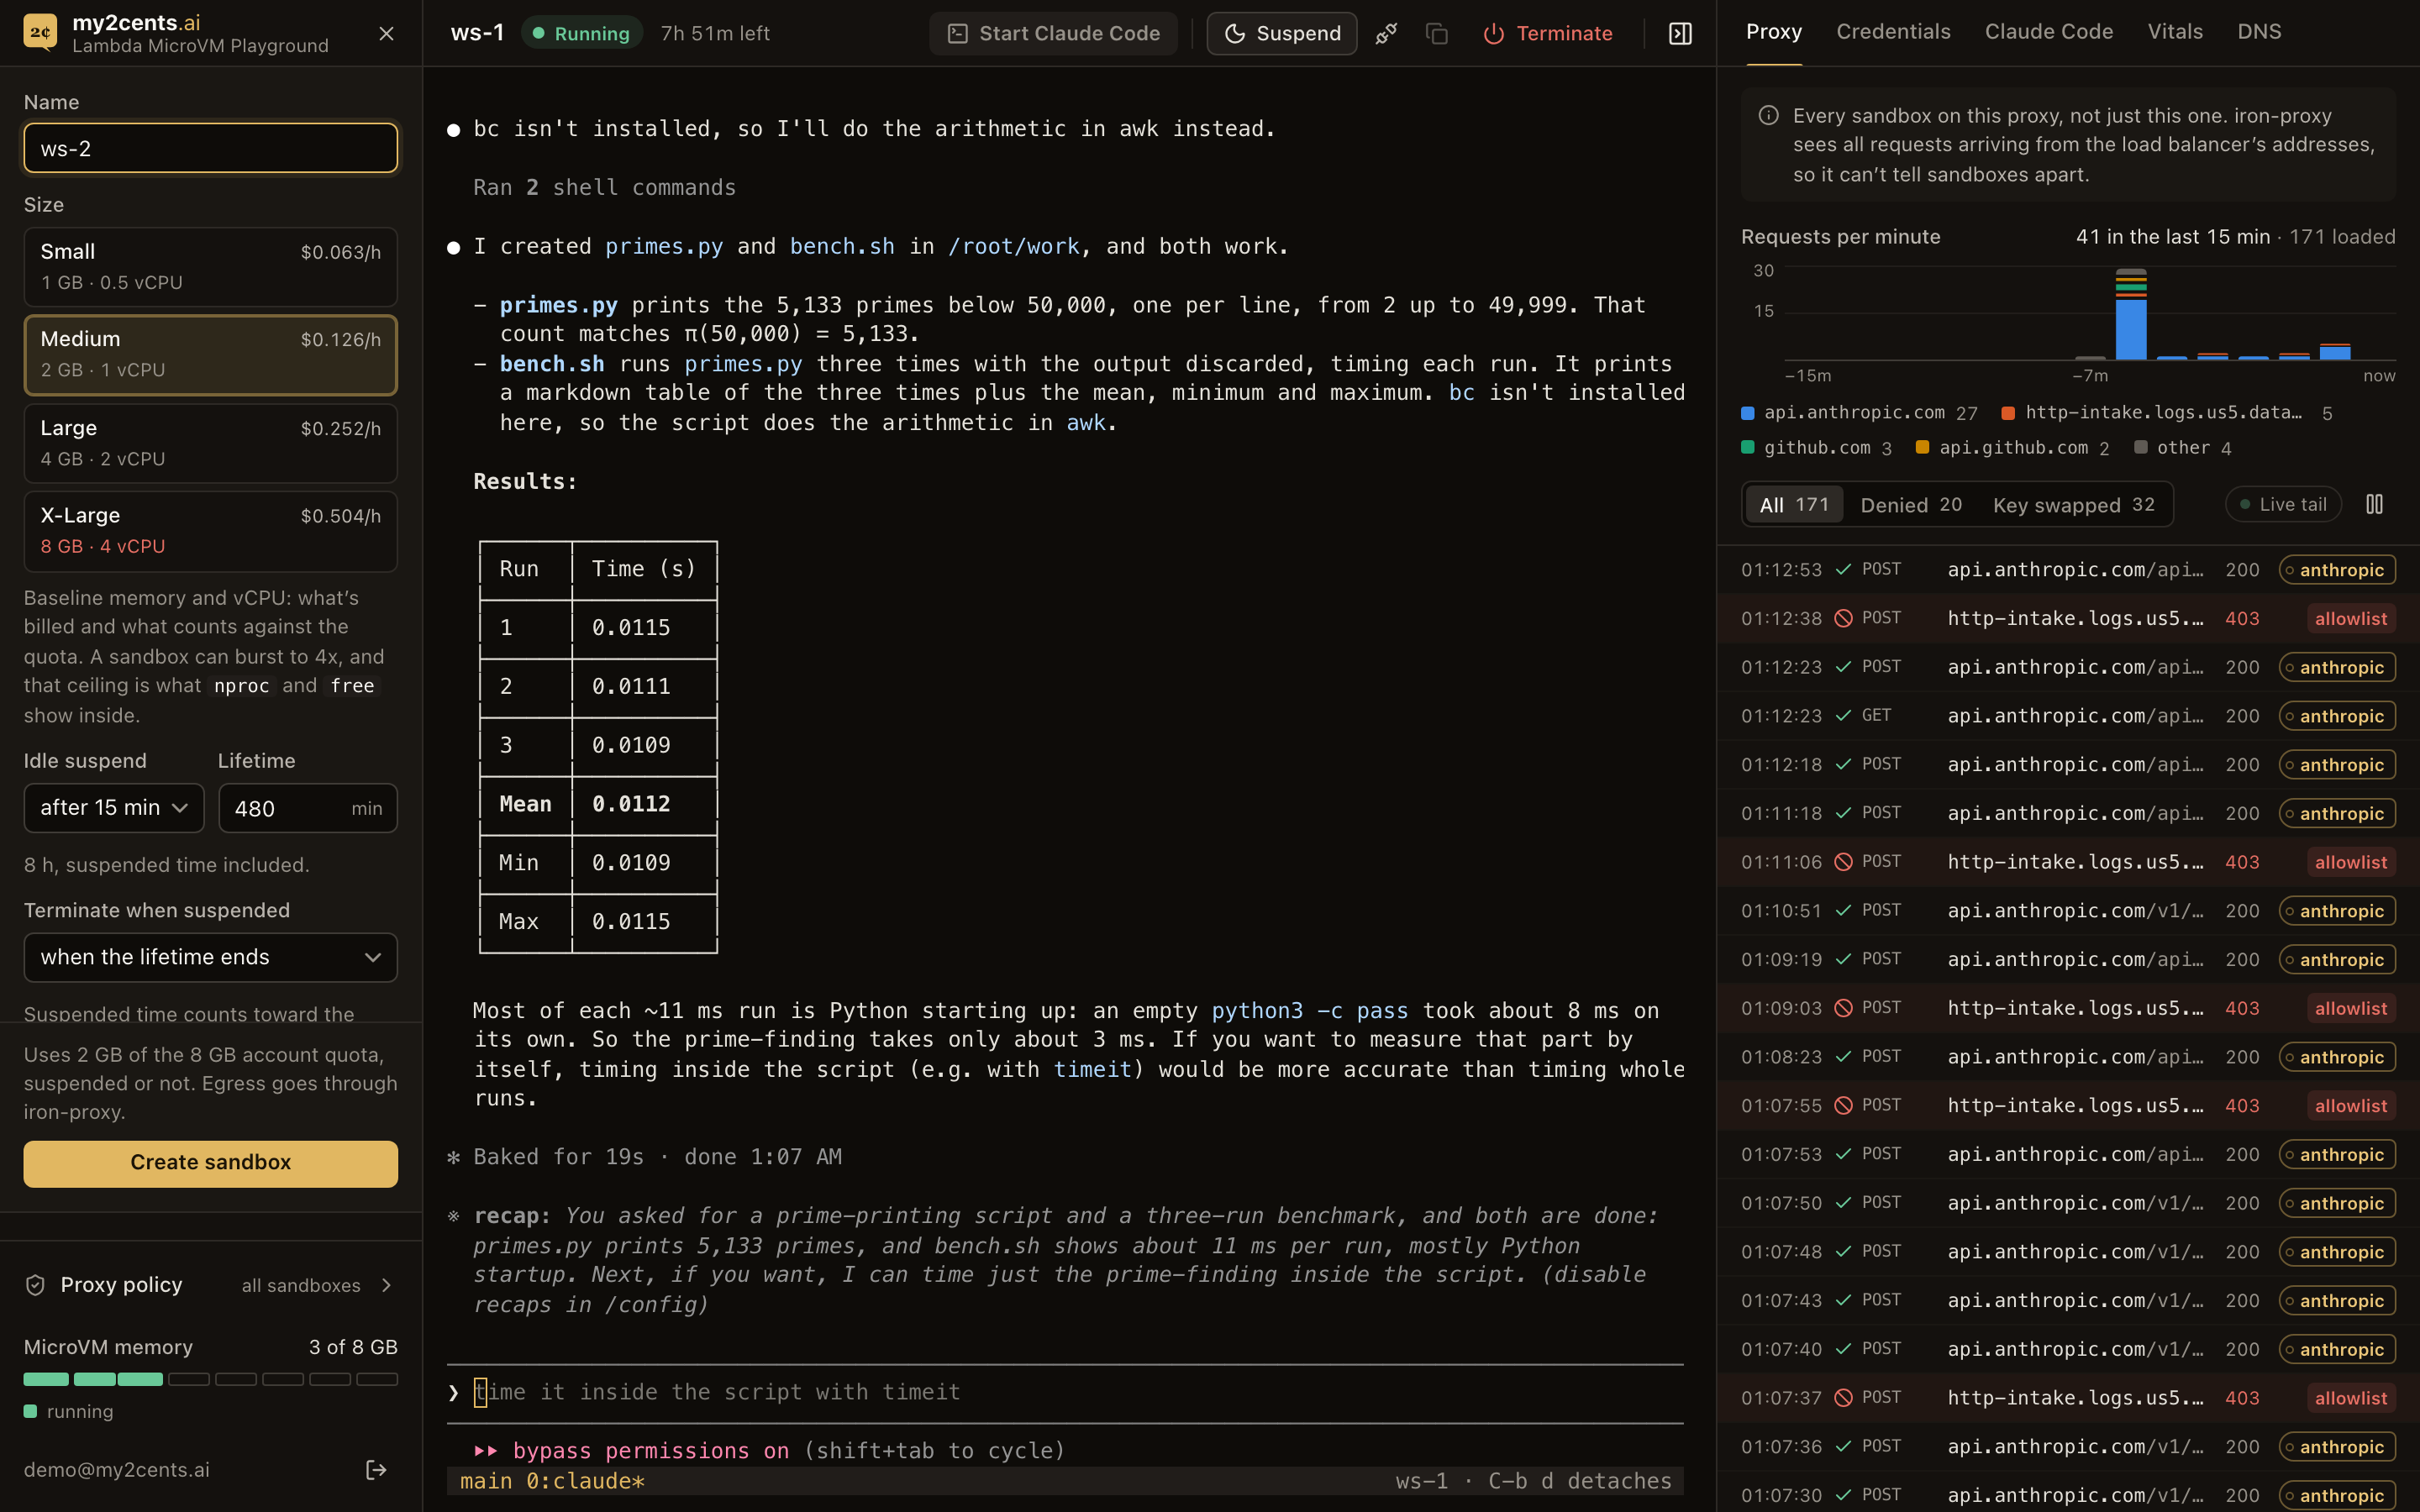
O login é o managed login do Cognito; o app recebe um ID token com PKCE e o envia à API em toda chamada, e como primeira mensagem em cada WebSocket. O formulário New sandbox escolhe um tamanho (Small 1 GB, Medium 2 GB por padrão, Large 4 GB ou X-Large 8 GB, cada um com a sua própria imagem), o tempo de ociosidade antes da suspensão (a partir de 1 minuto, 15 por padrão), o tempo de vida (até 8 horas, incluindo o tempo suspenso), se ele deve ser encerrado depois de algum tempo suspenso, se conectar a ele o retoma, e variáveis de ambiente extras, que não servem para segredos: elas ficam visíveis dentro do sandbox e são armazenadas com o registro dele. Criá-lo chama run-microvm com o connector da parte 2, HTTP_INGRESS, SHELL_INGRESS e essas configurações. O sandbox recebe os placeholders, as configurações da CA, o próprio nome, AWS_SDK_UA_APP_ID e AWS_REQUEST_CHECKSUM_CALCULATION (Teste 12), e nenhuma configuração de proxy. Medido através do CloudFront:
| Etapa | 2026-11-04, duas execuções | 2026-11-05 |
|---|---|---|
POST /api/sandboxes retorna | 0,32 s / 0,22 s | 0,26 a 0,29 s |
| …depois o agente dentro da VM responde | 1,38 s / 4,02 s depois | 1,35 s depois |
No navegador, do clique em Create até um sandbox rodando com o terminal conectado levou 2,40 s; o estado de execução e o terminal conectado chegaram no mesmo poll. O terminal abre em uma sessão tmux com uma breve mensagem de boas-vindas, em /root/work.
Não existe opção offline. Uma lista vazia de connectors de egress não isola uma MicroVM: o Lambda anexa no lugar o seu connector gerenciado INTERNET_EGRESS. Eu rodei uma com [] para conferir: lá dentro, api.github.com resolveu para um endereço real do GitHub e respondeu diretamente, sem allowlist, sem troca de chave e sem log de auditoria. Por isso a API se recusa a rodar um sandbox sem o connector da parte 2, com um 503.
Teste 2: Claude Code no navegador
O botão “Start Claude Code” digita claude no terminal, e o Claude Code abre direto no seu prompt: Opus 5.5, ~/work, bypass permissions on. Em um build anterior da imagem, a primeira inicialização levou cerca de 18 segundos; com o warm-up do /validate, a primeira versão tinha um prompt pronto 1,3 s depois do clique em um sandbox recém-criado e 1,7 s em outro. Eu pedi que ele criasse hello.py, imprimisse os dez primeiros números de Fibonacci e me mostrasse a saída; ele escreveu o arquivo, rodou e imprimiu 0 1 1 2 3 5 8 13 21 34 em cerca de cinco segundos de trabalho. Tarefas pequenas como essa (um arquivo de notas, uma lista de tarefas, um script de benchmark que ele escreveu e rodou) voltaram em 7 a 8,5 segundos a partir do Enter. Na stack com proxy compartilhado, um claude -p headless respondeu em 5,9 s, e em 5,1 s em uma execução posterior.
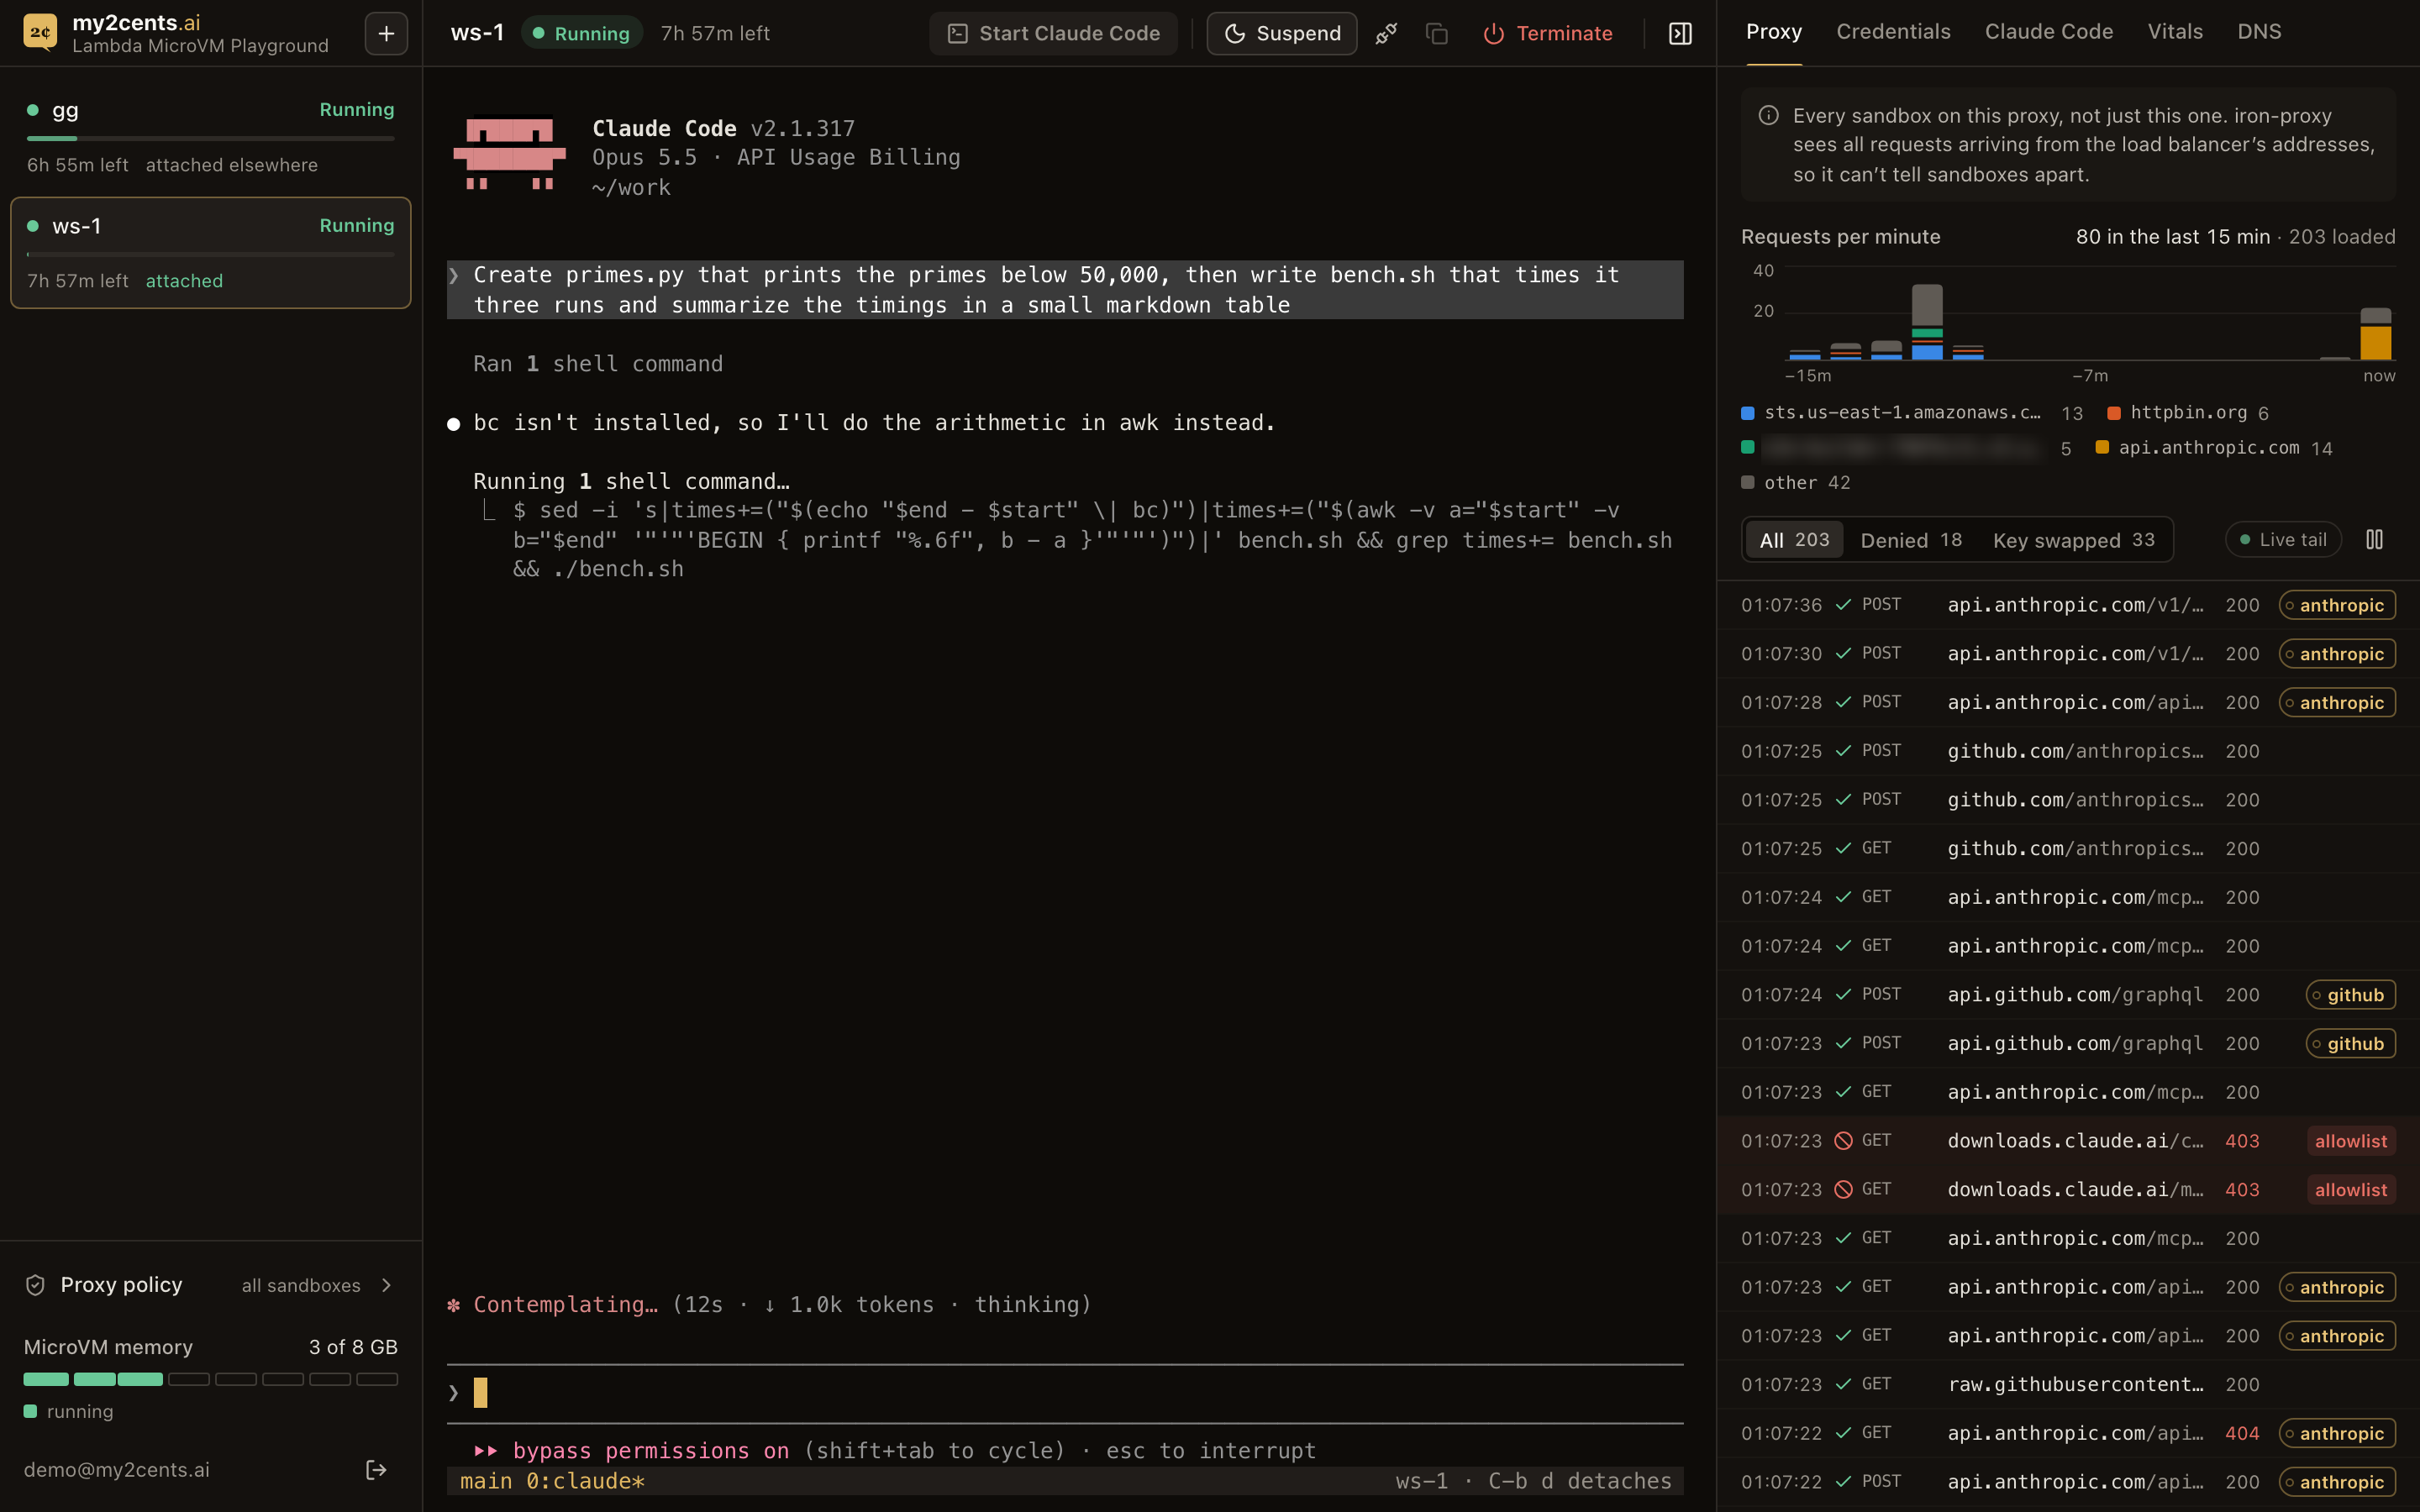
A primeira versão deixava o botão habilitado enquanto o Claude Code rodava, então um segundo clique digitava claude no próprio prompt do Claude, como uma mensagem. Agora o poll de estatísticas ao vivo também pergunta ao tmux o que está rodando no painel, e o botão fica desabilitado assim que você clica nele, continua desligado enquanto o painel roda o Claude Code e volta alguns segundos depois do /exit.
O painel do proxy mostra a inicialização do Claude Code enquanto ela acontece: chamadas a api.anthropic.com (bootstrap, configurações, log de eventos, o registro de MCP e, depois, as mensagens) com a chave da Anthropic trocada onde o Claude Code envia uma, e os hosts que a allowlist recusa, como downloads.claude.ai. Sem o painel, um desenvolvedor nunca vê nada disso.
Teste 3: O feed do proxy e o uso de credenciais
A aba Proxy faz o stream do log de auditoria do iron-proxy pelo CloudWatch Logs Live Tail: horário, método, host e path, status, permitido ou negado (e por qual estágio), uma tag de chave para cada credencial trocada e um selo “aws” para chamadas à AWS assinadas novamente. A aba Credentials conta os usos por credencial nos últimos 15 minutos. Na primeira versão, os cards mostravam:
anthropic  39 uses · api.anthropic.com
demo        1 use  · httpbin.org
github      9 uses · api.github.com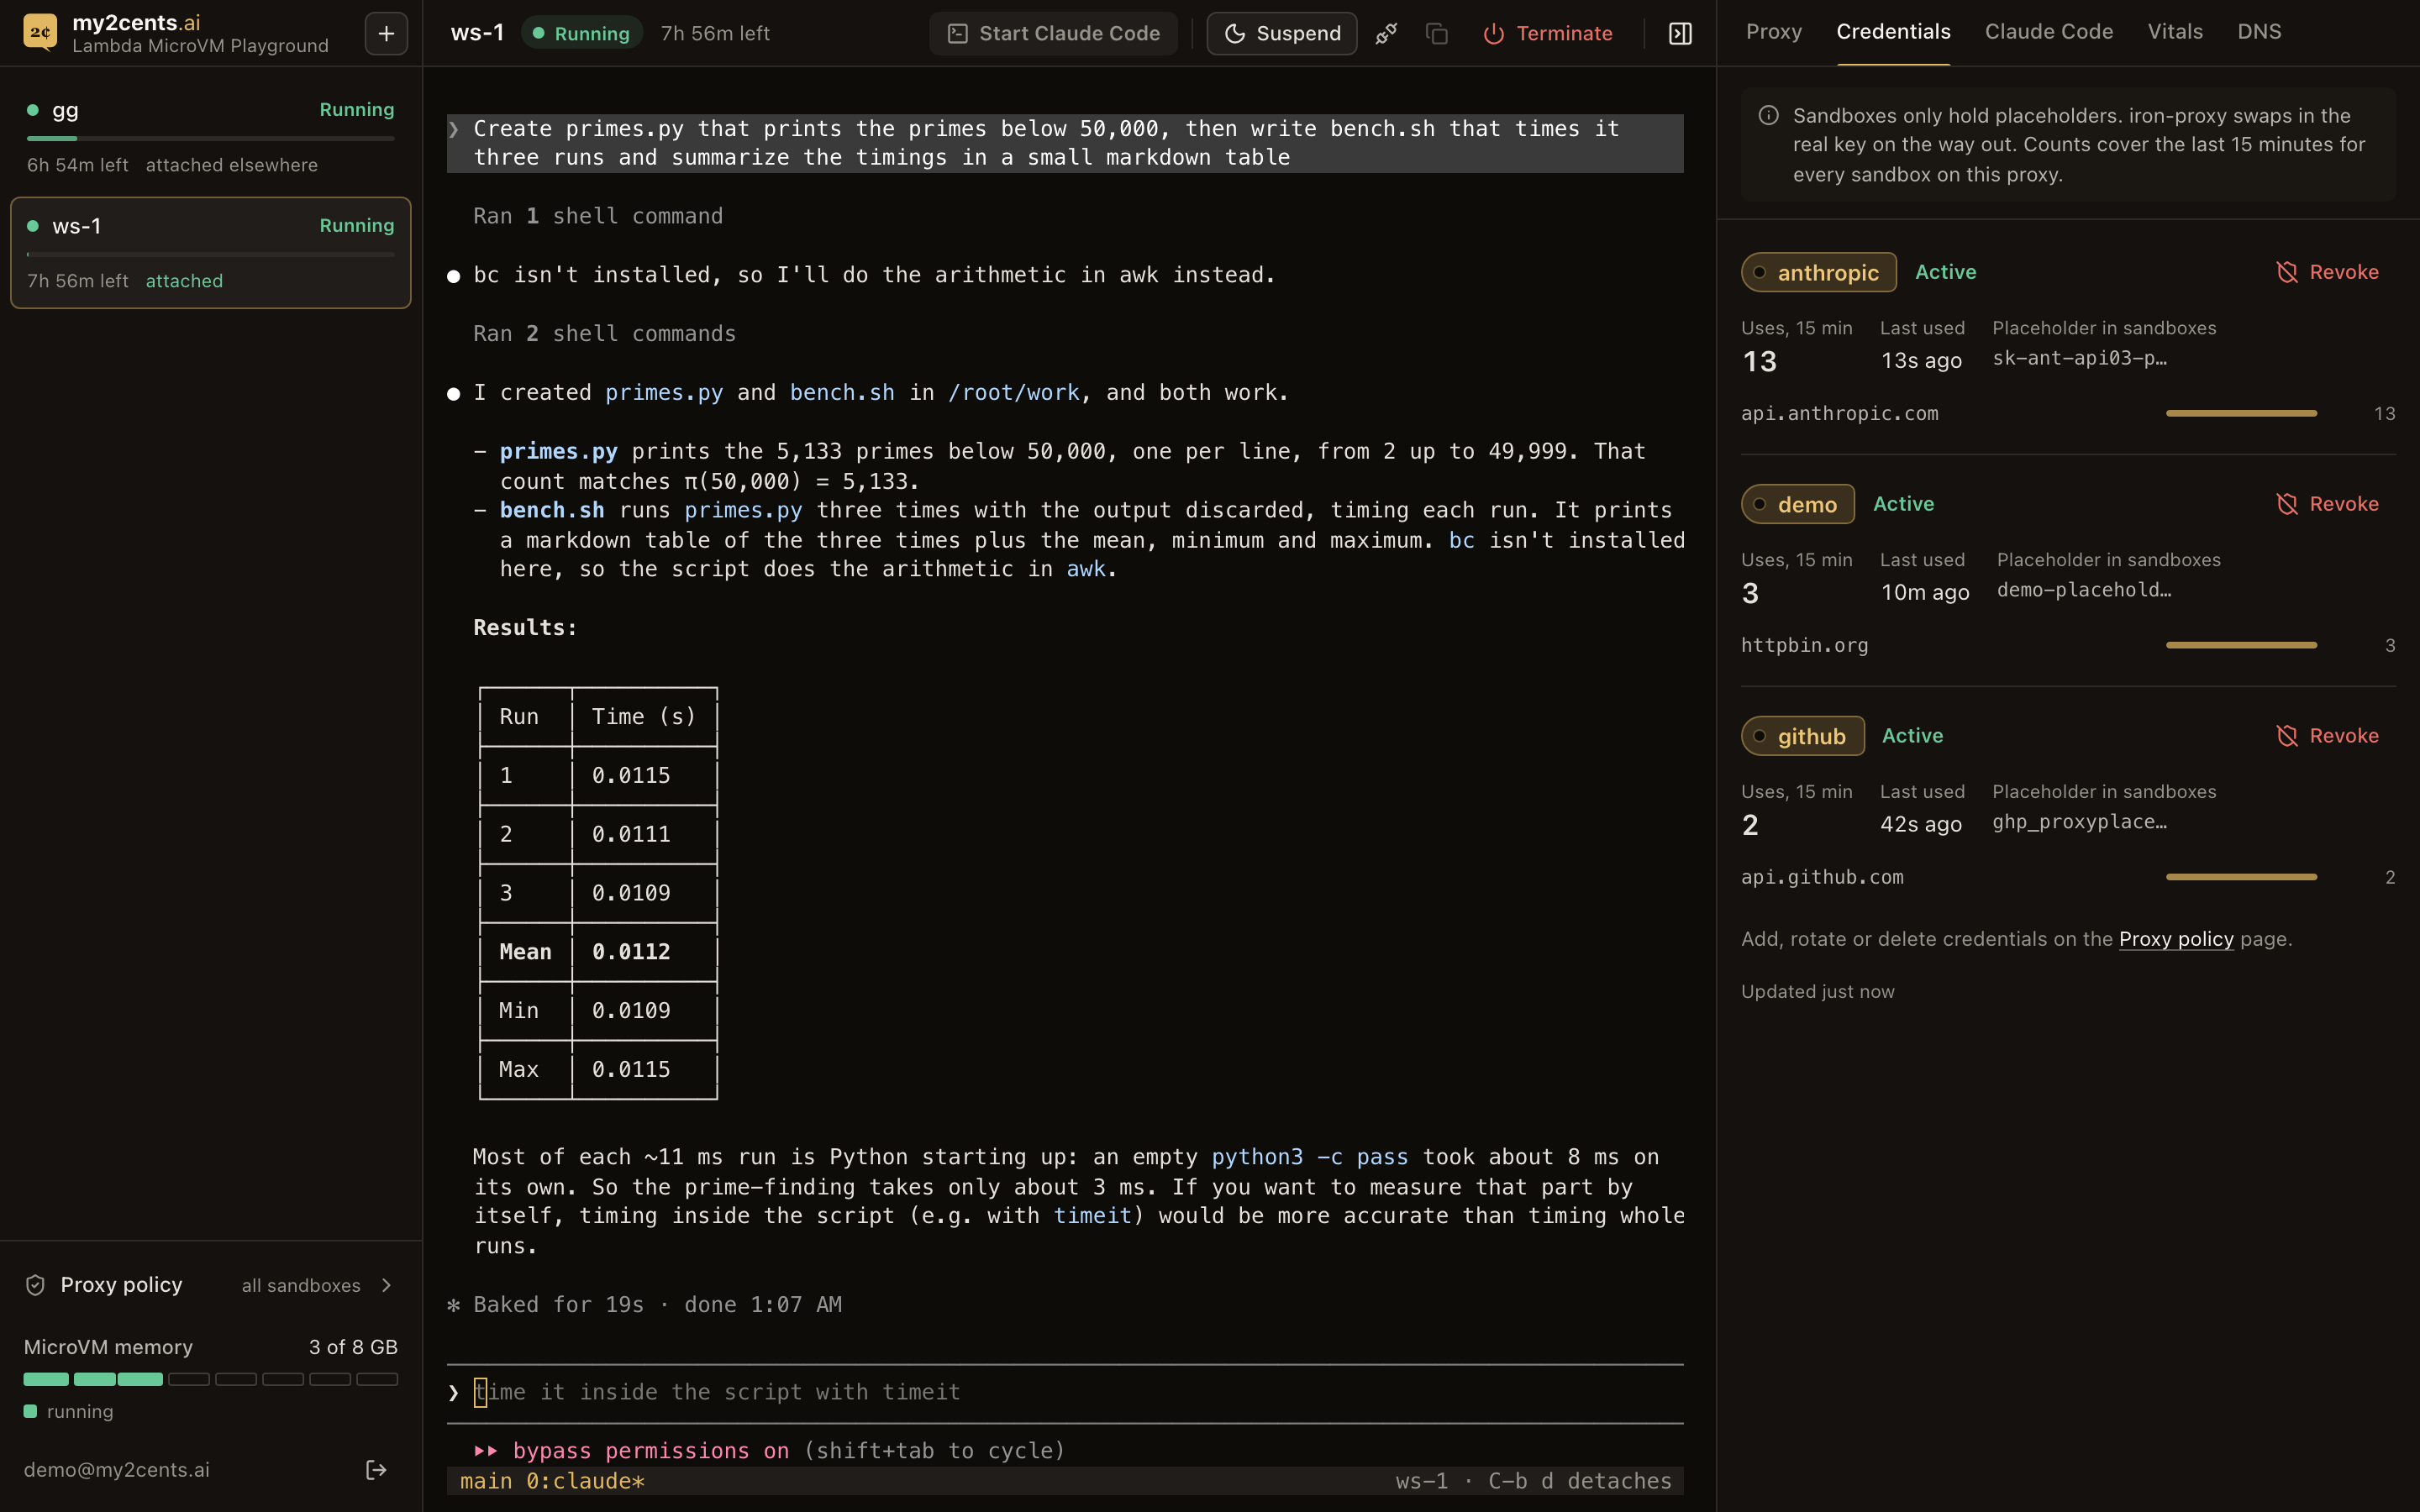
Os dois painéis dizem a mesma coisa no topo: eles cobrem todos os sandboxes deste proxy. O iron-proxy vê todo request vindo dos endereços do load balancer (parte 2), então o feed não pode ser filtrado para um sandbox, e os contadores também não. Para um desenvolvedor, tudo bem; para um time, significa que todo mundo vê o tráfego de todo mundo. Na stack com proxy compartilhado, uma amostra de 50 segundos do stream de eventos trouxe juntas as linhas de proxy e DNS de dois sandboxes de teste, 77 eventos, e um segundo usuário, que não era admin, recebeu os mesmos 77.
Teste 4: Tokens e custo
A aba Claude Code lê, através do agente, as transcrições de sessão do próprio Claude Code (~/.claude/projects/**/*.jsonl) e calcula o custo delas com os preços de tabela da Anthropic. Esta é por sandbox, já que lê o próprio sandbox, não o proxy. Depois da tarefa do Fibonacci, na primeira versão (o proxy não altera esse caminho):
Estimated cost $0.05 · Tokens 63.1k · Turns 1 · Sessions 1
session 1698f548…  claude-opus-5-5  input 6 · output 397 · cache read 56.6k · cache write 6.2k
Quase tudo é leitura de cache: o system prompt e as ferramentas do Claude Code, relidos a cada chamada. Esse é o número a observar quando um sandbox roda por horas.
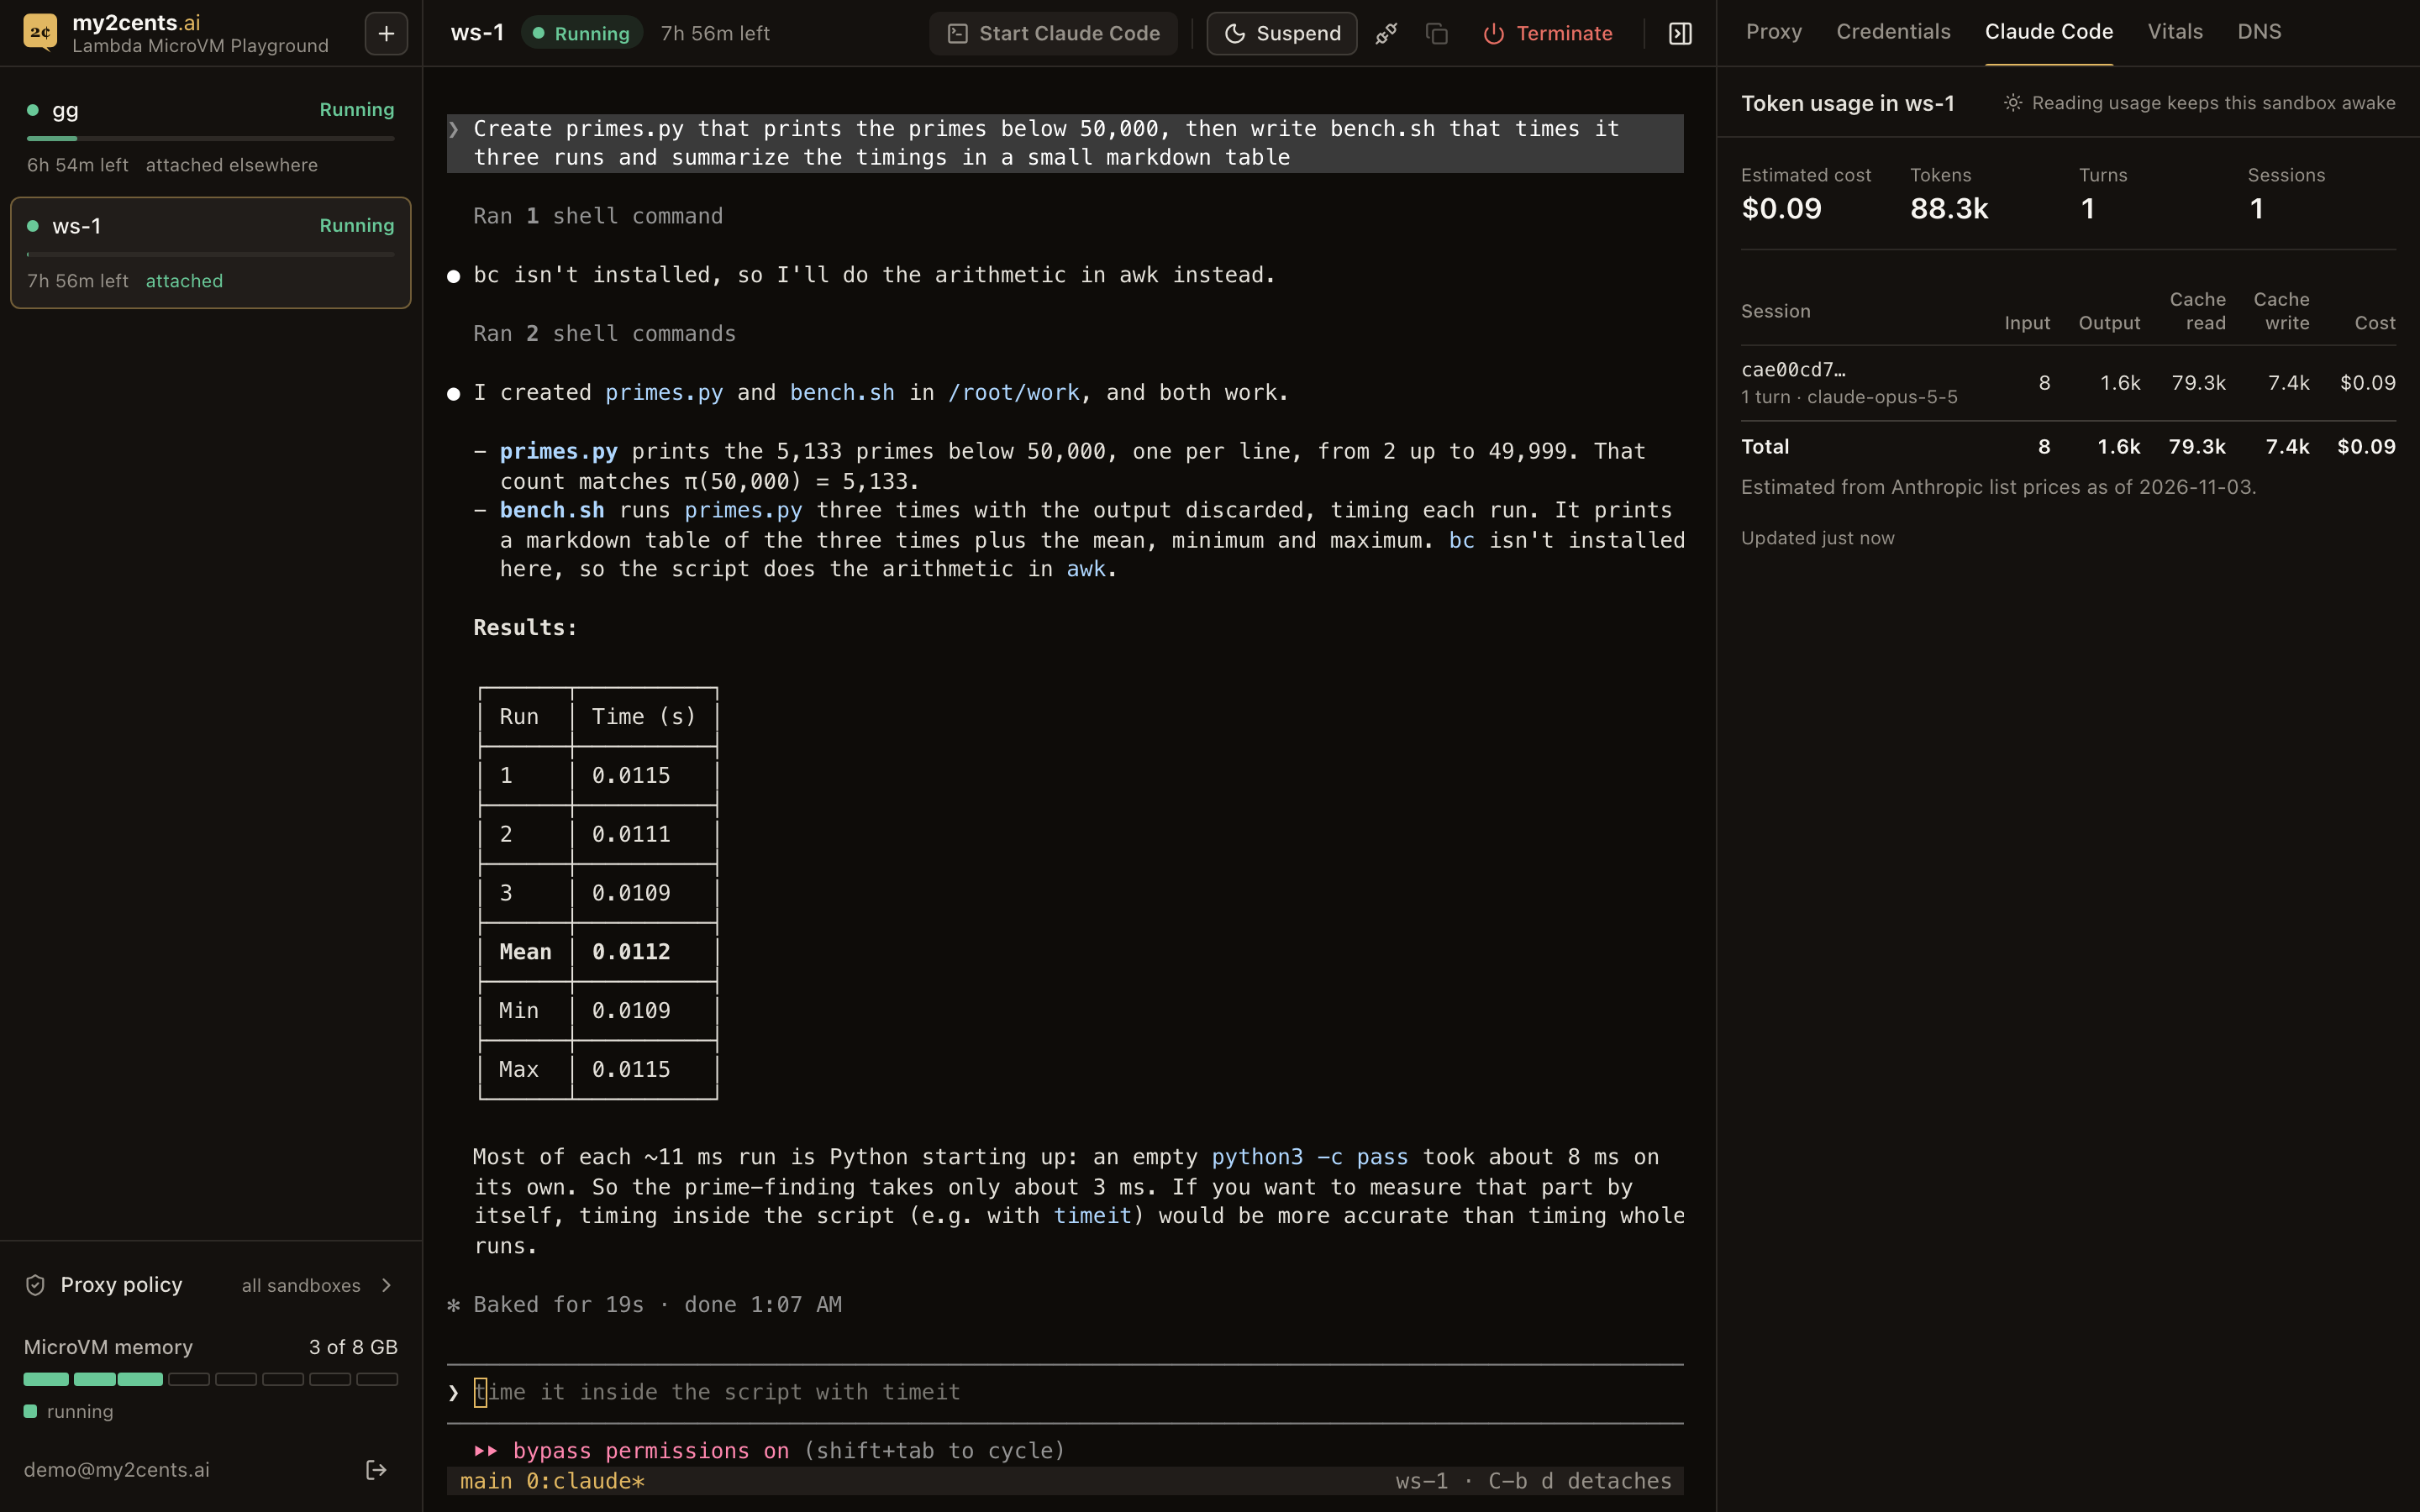
Na versão atual, depois da tarefa dos números primos na captura de tela acima, a aba mostrou um turno com 88,3k tokens, cerca de US$ 0,09, de novo principalmente leituras de cache:
Teste 5: Vitals e o custo de observar
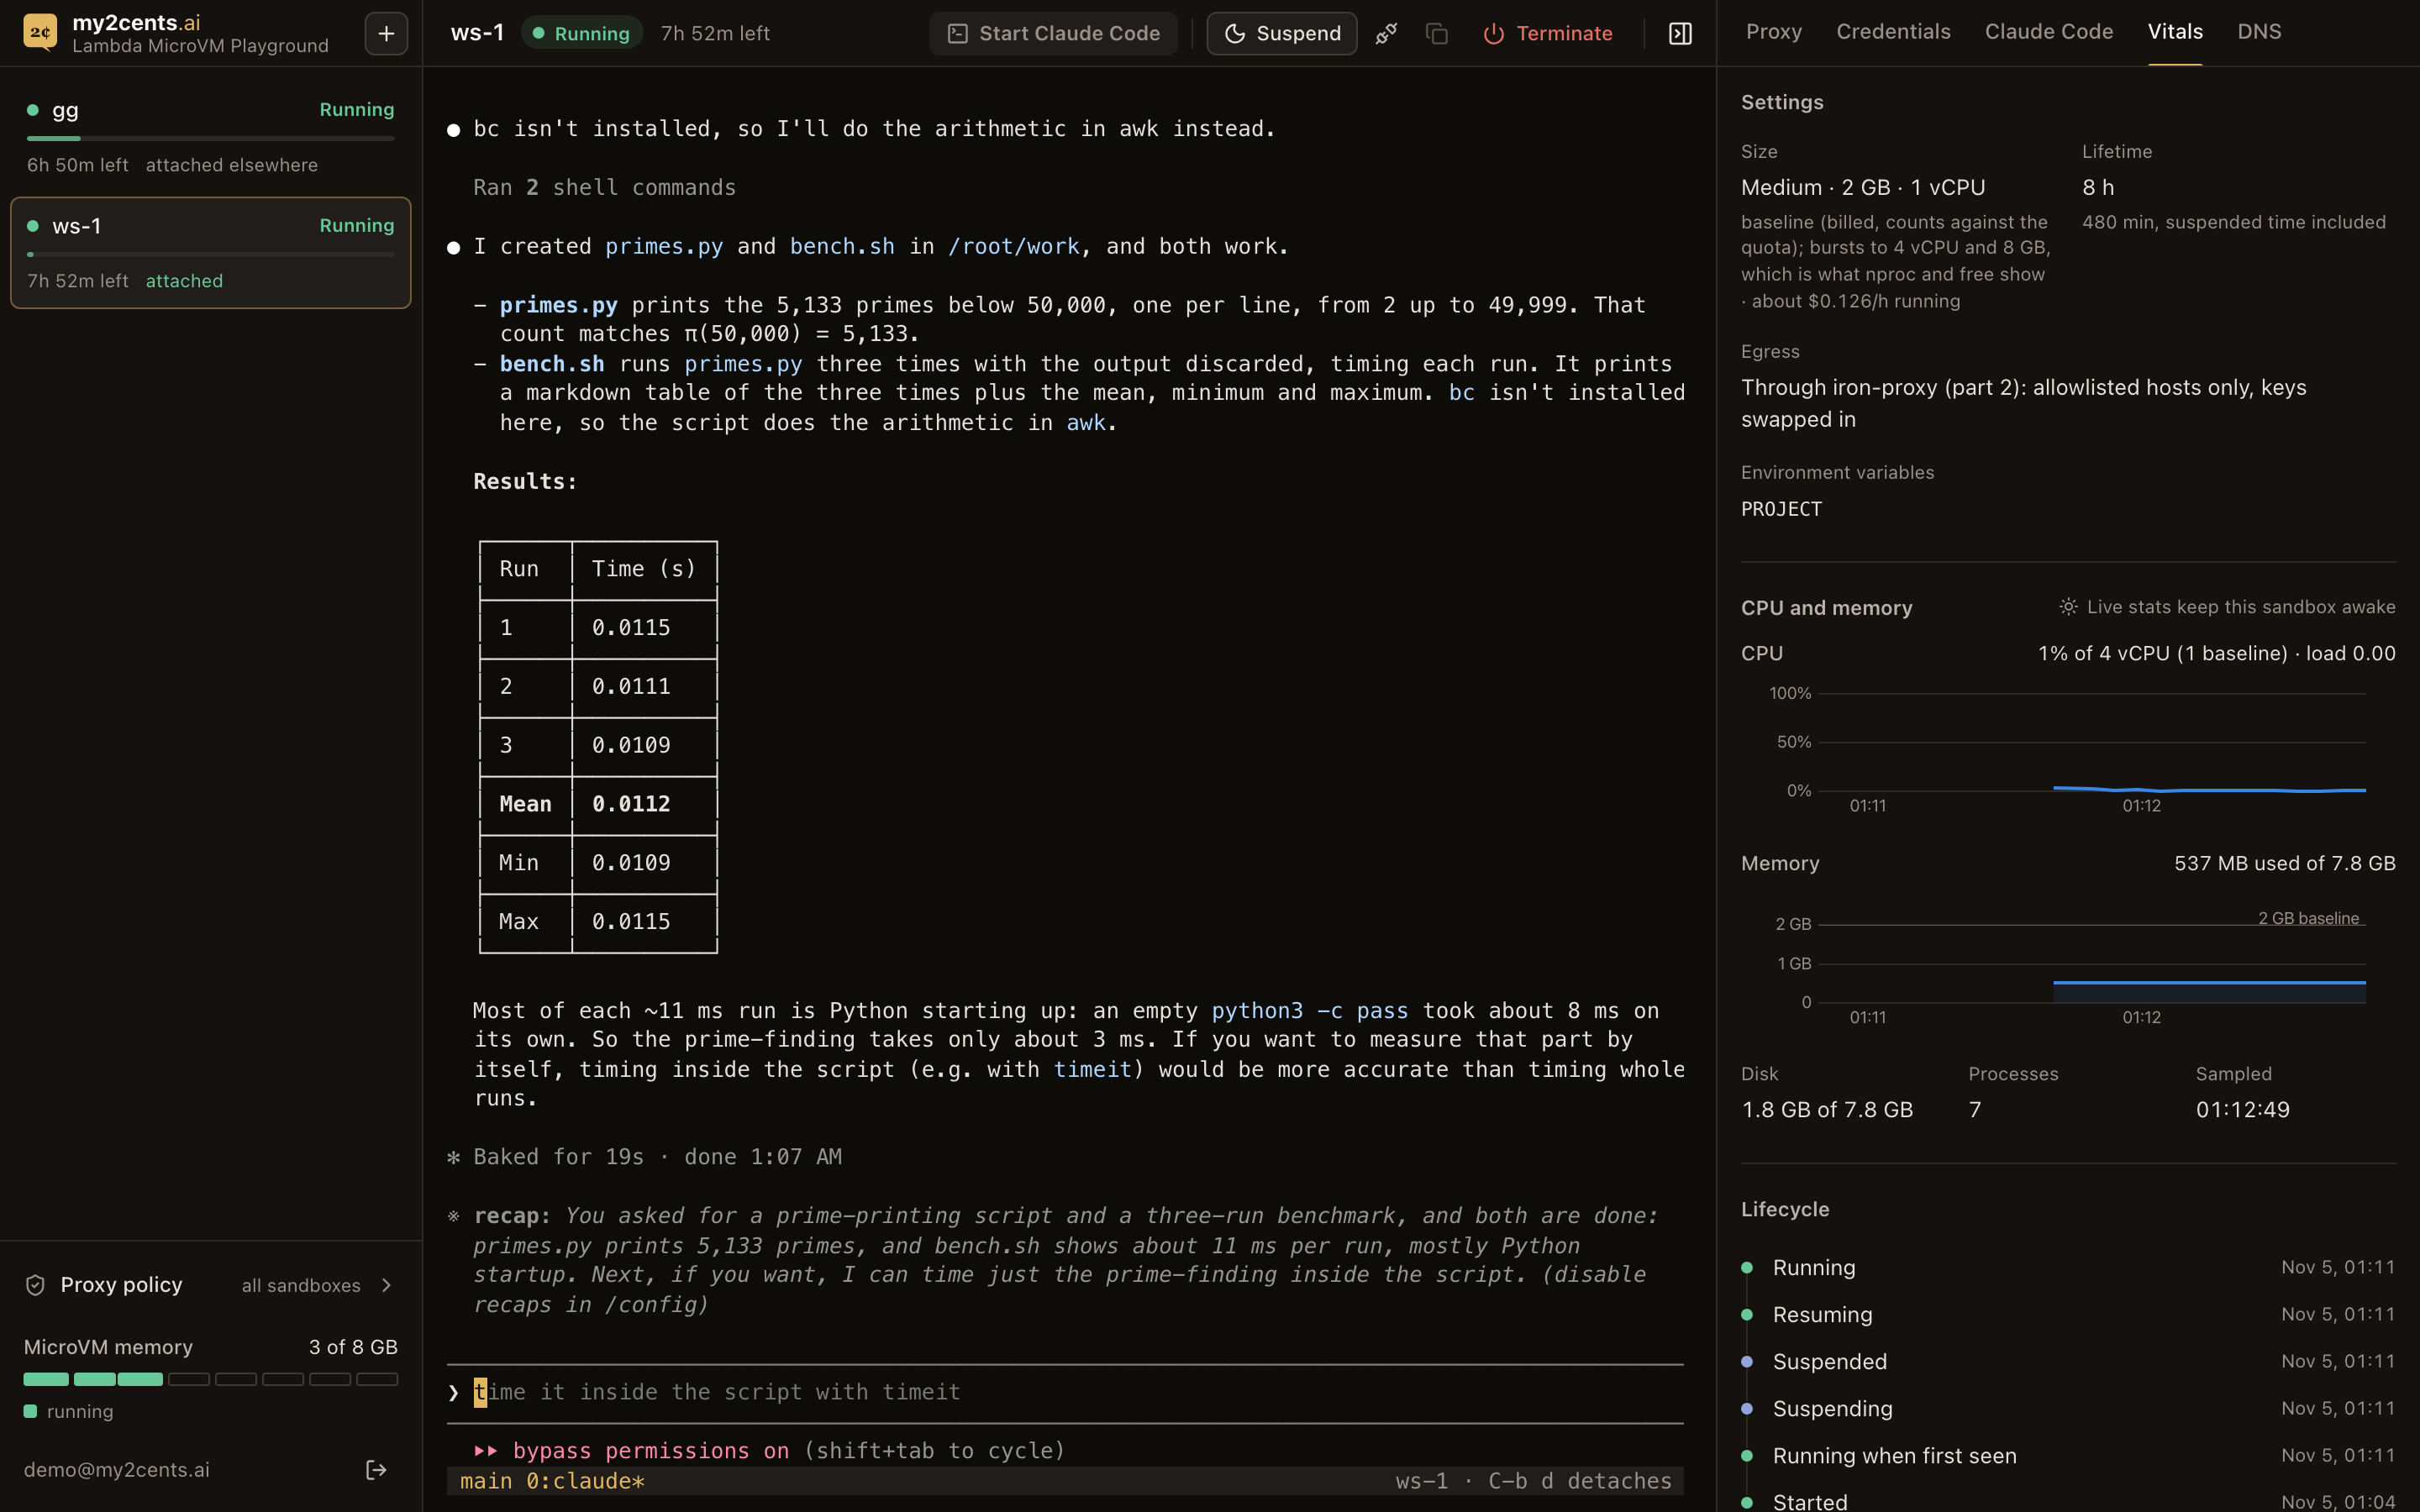
A aba Vitals mostra o estado, o uptime, uma barra de tempo de vida (“7h 59m left of 8h · stops at 03:43, suspended time counts”), a policy de ociosidade, CPU e memória em relação ao tamanho do sandbox, disco e processos, e uma linha do tempo do ciclo de vida. O tamanho é um baseline, o que é cobrado e o que conta para a cota; lá dentro, nproc e free mostram o teto de burst, 4x o tamanho (um sandbox Medium enxerga 4 vCPU e cerca de 8 GB), e o painel avisa isso. CPU e memória ao vivo vêm do agente dentro da MicroVM, e perguntar qualquer coisa ao agente é tráfego de entrada, o que mantém o sandbox acordado (parte 1). Por isso o painel só coleta amostras enquanto um terminal está conectado neste navegador, e avisa isso (“Live stats keep this sandbox awake”); caso contrário, ele mostra as últimas amostras e lê o estado do control plane, o que não conta como atividade. Peça estatísticas ao vivo de um sandbox suspenso e a API retorna uma explicação em vez de acordá-lo.
Teste 6: Suspender, retomar e a mesma tela do Claude
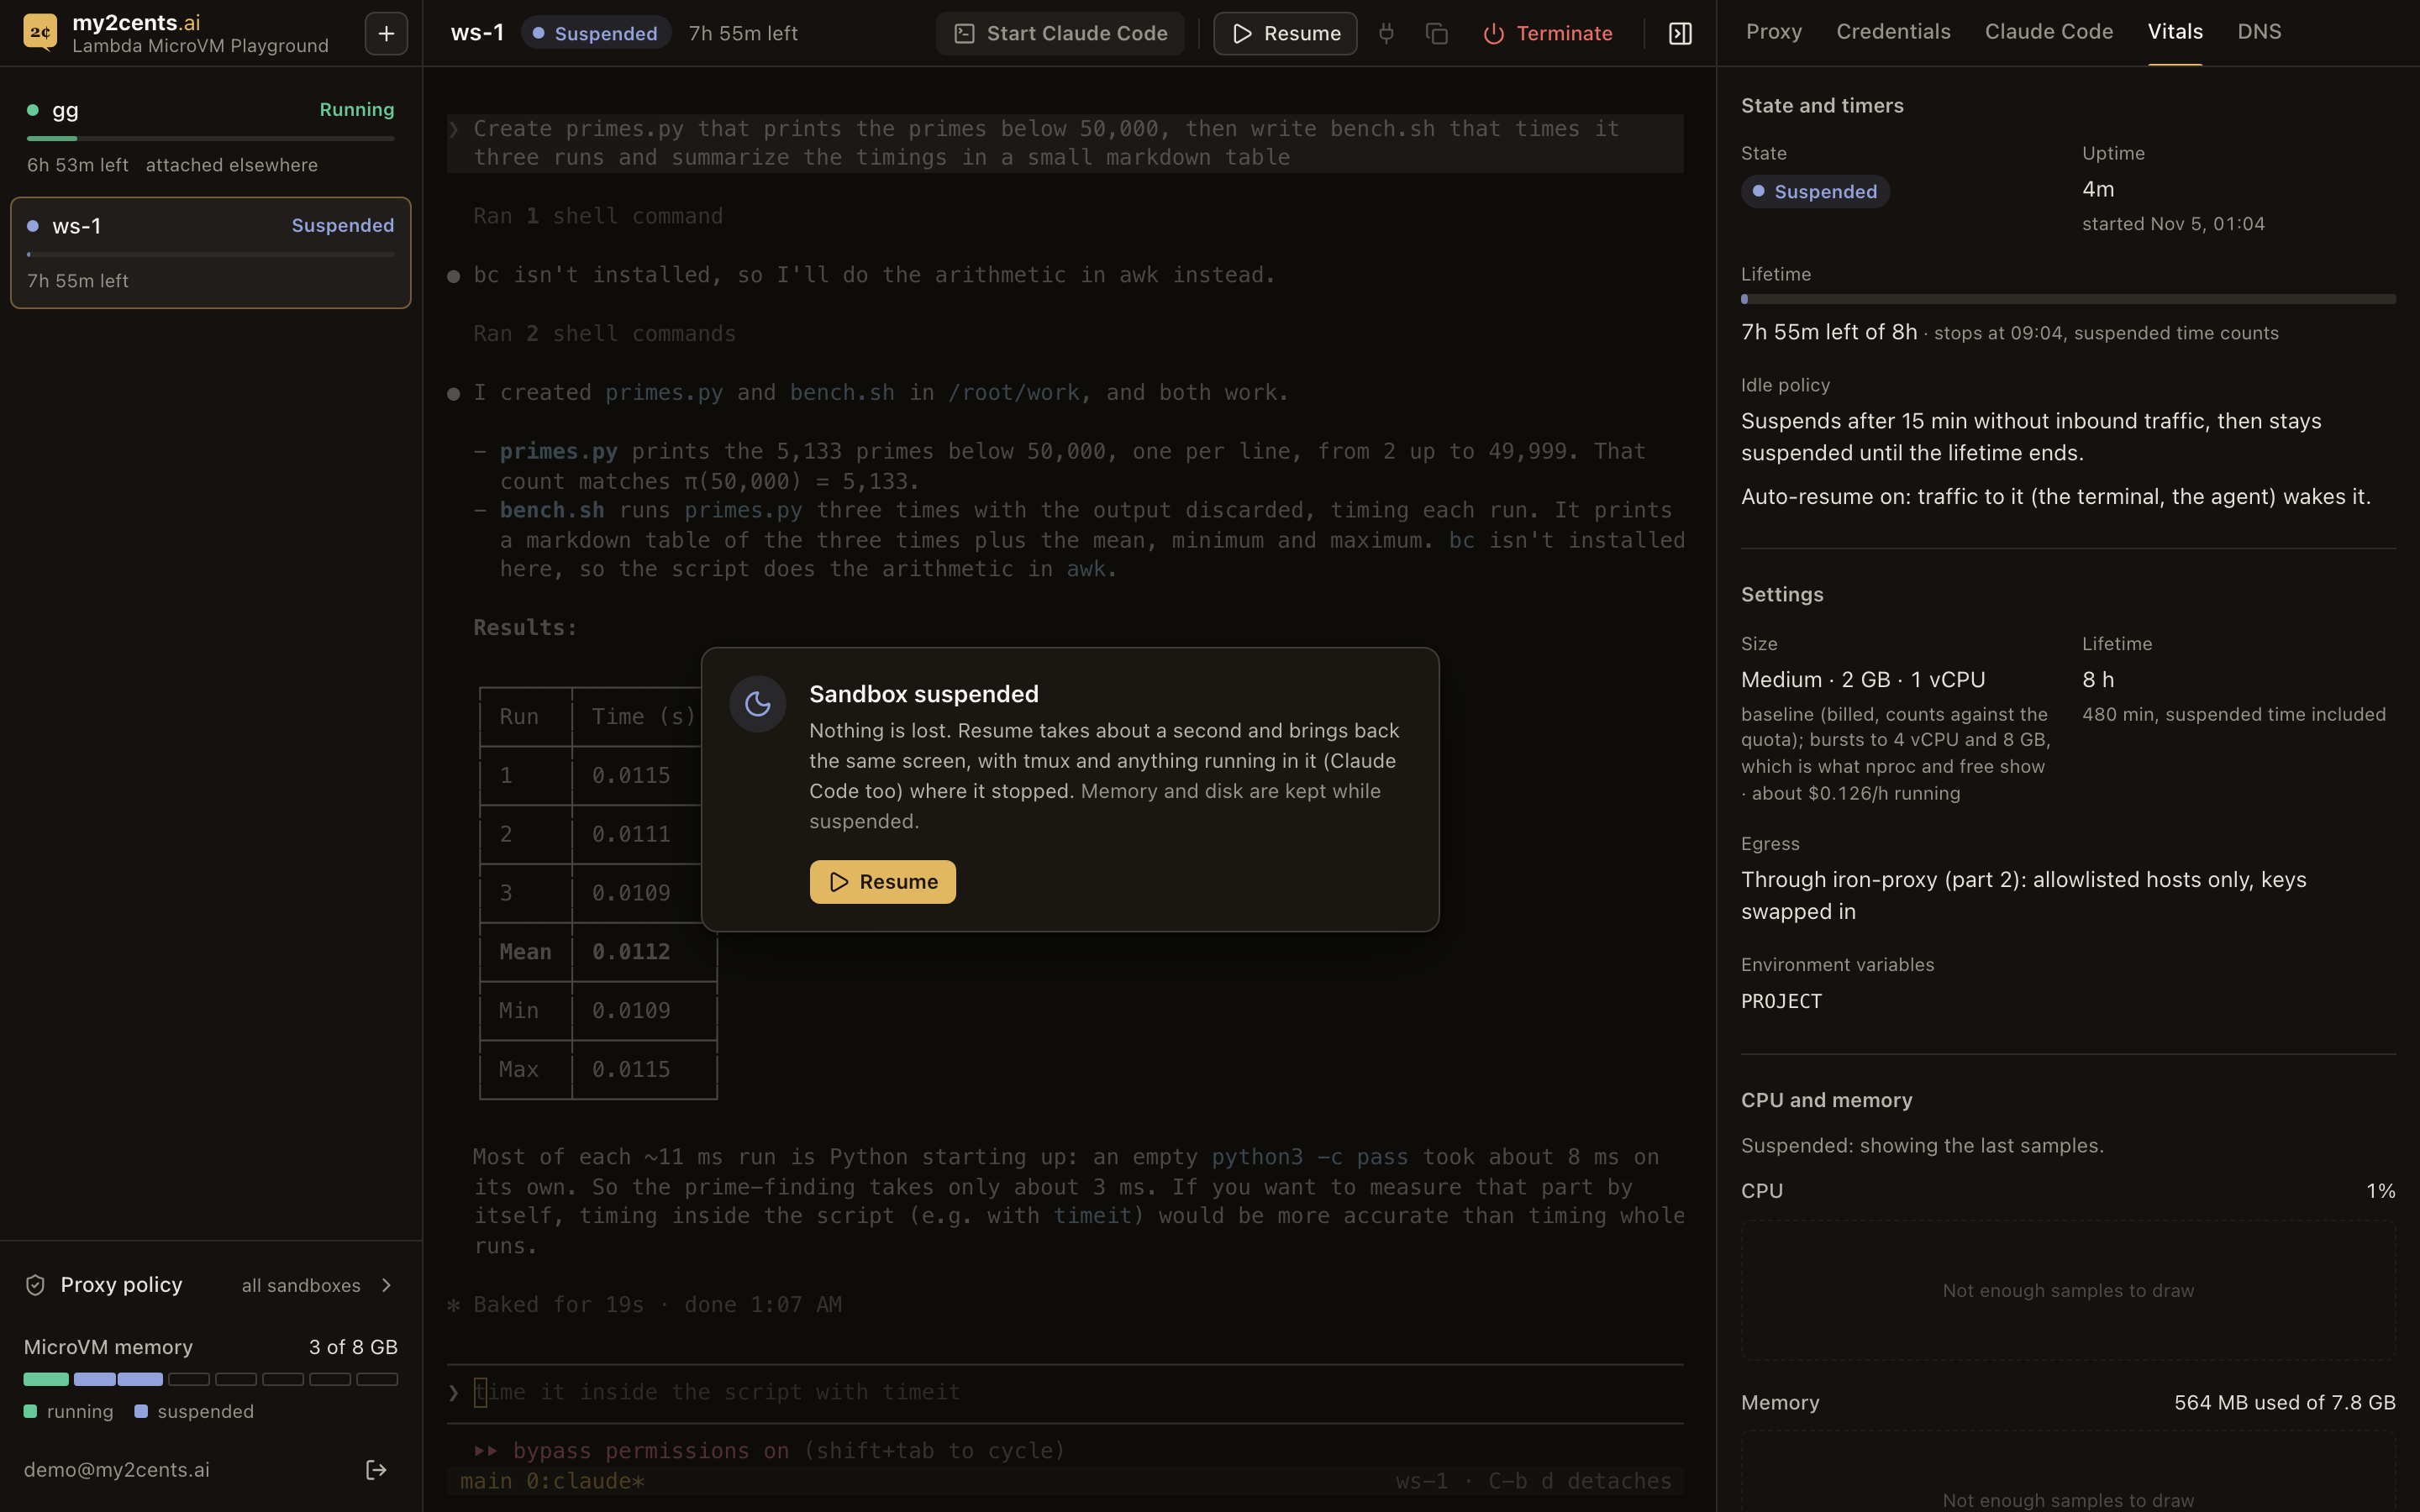
Suspender congela a MicroVM; o terminal mostra um overlay “Sandbox suspended” com um botão Resume. Retomar a traz de volta, e o terminal se reconecta à mesma sessão tmux, com a tela do Claude Code exatamente como estava e os mesmos IDs de processo.
A primeira versão levava de 10 a 30 segundos para mostrar isso, embora as chamadas à API levem menos de um segundo. Dois caches eram os culpados: a API servia, por 2 segundos após cada chamada, um estado anterior à ação guardado em cache, e depois o poll de 10 segundos da lista na UI colocava o estado antigo de volta, o que reabria o overlay de suspenso sobre um terminal ativo. Depois da correção (a API faz polling do control plane a cada 0,25 s até o estado se estabilizar e envia a mudança ao navegador na hora), medido através do CloudFront em três ciclos por um script que chama a API, na primeira versão (o proxy não altera esse caminho):
| A partir da chamada à API | Mediana (intervalo) |
|---|---|
| Suspender: o estado mostra SUSPENDED | 0,48 s (0,48–0,83) |
| Suspender: a ponte do terminal informa que suspendeu | 0,63 s (0,61–0,70) |
| Retomar: o estado mostra RUNNING | 0,78 s (0,76–0,86) |
| Retomar: a ponte do terminal informa que reconectou | 0,66 s (0,64–0,73) |
Menos de um segundo para o estado, nos dois sentidos. No navegador, o overlay de suspenso apareceu 0,66 a 0,84 s depois do clique em Suspend, e a mesma tela do Claude Code voltou 1,03 a 1,06 s depois do clique em Resume. Depois de uma retomada, o Claude Code respondeu a um novo prompt em 2,4 s. Um detalhe importa para a UI: abrir o shell em uma MicroVM suspensa a retoma sozinha (0,84 s) quando a configuração Resume on connect do sandbox está ligada, o padrão, e ela pode informar brevemente PENDING, não RUNNING, então a UI precisa ler PENDING depois de SUSPENDED como “resuming”, não “starting”. Na stack com proxy compartilhado, a API retornou SUSPENDED em 0,89 s e RUNNING em 0,47 s, com o agente respondendo 0,51 s depois da retomada e um request pelo proxy funcionando; uma execução posterior levou 0,93 s e 0,77 s.
Teste 7: Feche a aba, volte mais tarde
A graça do tmux e da suspensão é que você pode ir embora. Na primeira versão (o proxy não altera esse caminho), eu configurei um sandbox com a menor policy de ociosidade que o formulário oferecia na época (5 minutos; agora ela desce até 1, e o padrão é 15), dei uma tarefa ao Claude Code e fechei a aba assim que ele respondeu:
| Depois de fechar a aba | O que aconteceu |
|---|---|
| 0,06 s | a API fecha o terminal: o último tráfego de entrada |
| 5 min 7,6 s | SUSPENDING |
| 5 min 9,8 s | SUSPENDED |
O Claude Code continuou chamando api.anthropic.com a cada 30 segundos, mais ou menos, o tempo todo, e, como na parte 1, tráfego de saída não conta como atividade. Voltando logo depois da suspensão, o workspace abriu já logado, com o sandbox selecionado e um card “Sandbox suspended” 0,79 s depois de carregar. Um clique em Resume: Running em 0,86 s, e a mesma tela do Claude Code, sem o overlay, em 1,29 s.
O sandbox não é retomado sozinho quando você abre a página. Isso é proposital: acordar um sandbox é uma decisão de cobrança, e talvez você só tenha aberto a aba para olhar um painel. Às vezes, a única diferença depois de uma retomada é uma linha recap: que o próprio Claude Code adiciona depois de ficar ocioso.
O porém está na direção oposta. Qualquer aba com o terminal conectado mantém o sandbox acordado indefinidamente, porque um terminal é tráfego de entrada (e uma aba conectada também faz polling das estatísticas ao vivo). Durante os testes, uma segunda aba que eu tinha esquecido manteve um sandbox acordado muito além da sua policy de ociosidade de 5 minutos. A barra lateral mostra “attached elsewhere” quando outro navegador está com o terminal, mas o workspace não desconecta abas ociosas por conta própria, e eu deixei assim: desconectar uma aba enquanto o Claude Code trabalha em uma tarefa longa deixaria o sandbox suspender no meio da tarefa, já que as chamadas do próprio agente não contam. Pelo mesmo motivo, o app só se conecta ao sandbox em que você clicou, ou ao que você tinha aberto da última vez; qualquer um que ele escolha por conta própria abre desconectado, com um botão Attach.
Duas configurações do formulário New definem o que acontece depois de uma suspensão por ociosidade. Terminate when suspended encerra um sandbox depois de algum tempo suspenso, mas o Lambda só conta esse tempo depois de uma suspensão por ociosidade: um sandbox suspenso pelo botão Suspend fica até o fim do seu tempo de vida. Com Resume on connect desligado, nada acorda um sandbox suspenso a não ser o botão Resume: abrir o terminal dele mostra “Suspended: press Resume” em vez disso.
Teste 8: Vários sandboxes, uma cota
O “N of 8 GB” no medidor de memória da barra lateral é o limite do Service Quotas desta conta para memória de MicroVM (“Max allocated ARM_64 MicroVM memory”), e ele varia por conta. O app o lê do Service Quotas, guarda em cache por uma hora e informa no tooltip do medidor de onde veio o número. O meu é 8 GB, contra um padrão de 2.048 GB listado no Service Quotas. Como a parte 1 descobriu, aumentá-lo exige um caso de suporte, ou a AWS o aumenta conforme o seu uso cresce. Todo sandbox rodando ou suspenso conta pelo seu tamanho: quatro sandboxes Medium, ou um X-Large, enchem os meus 8 GB.
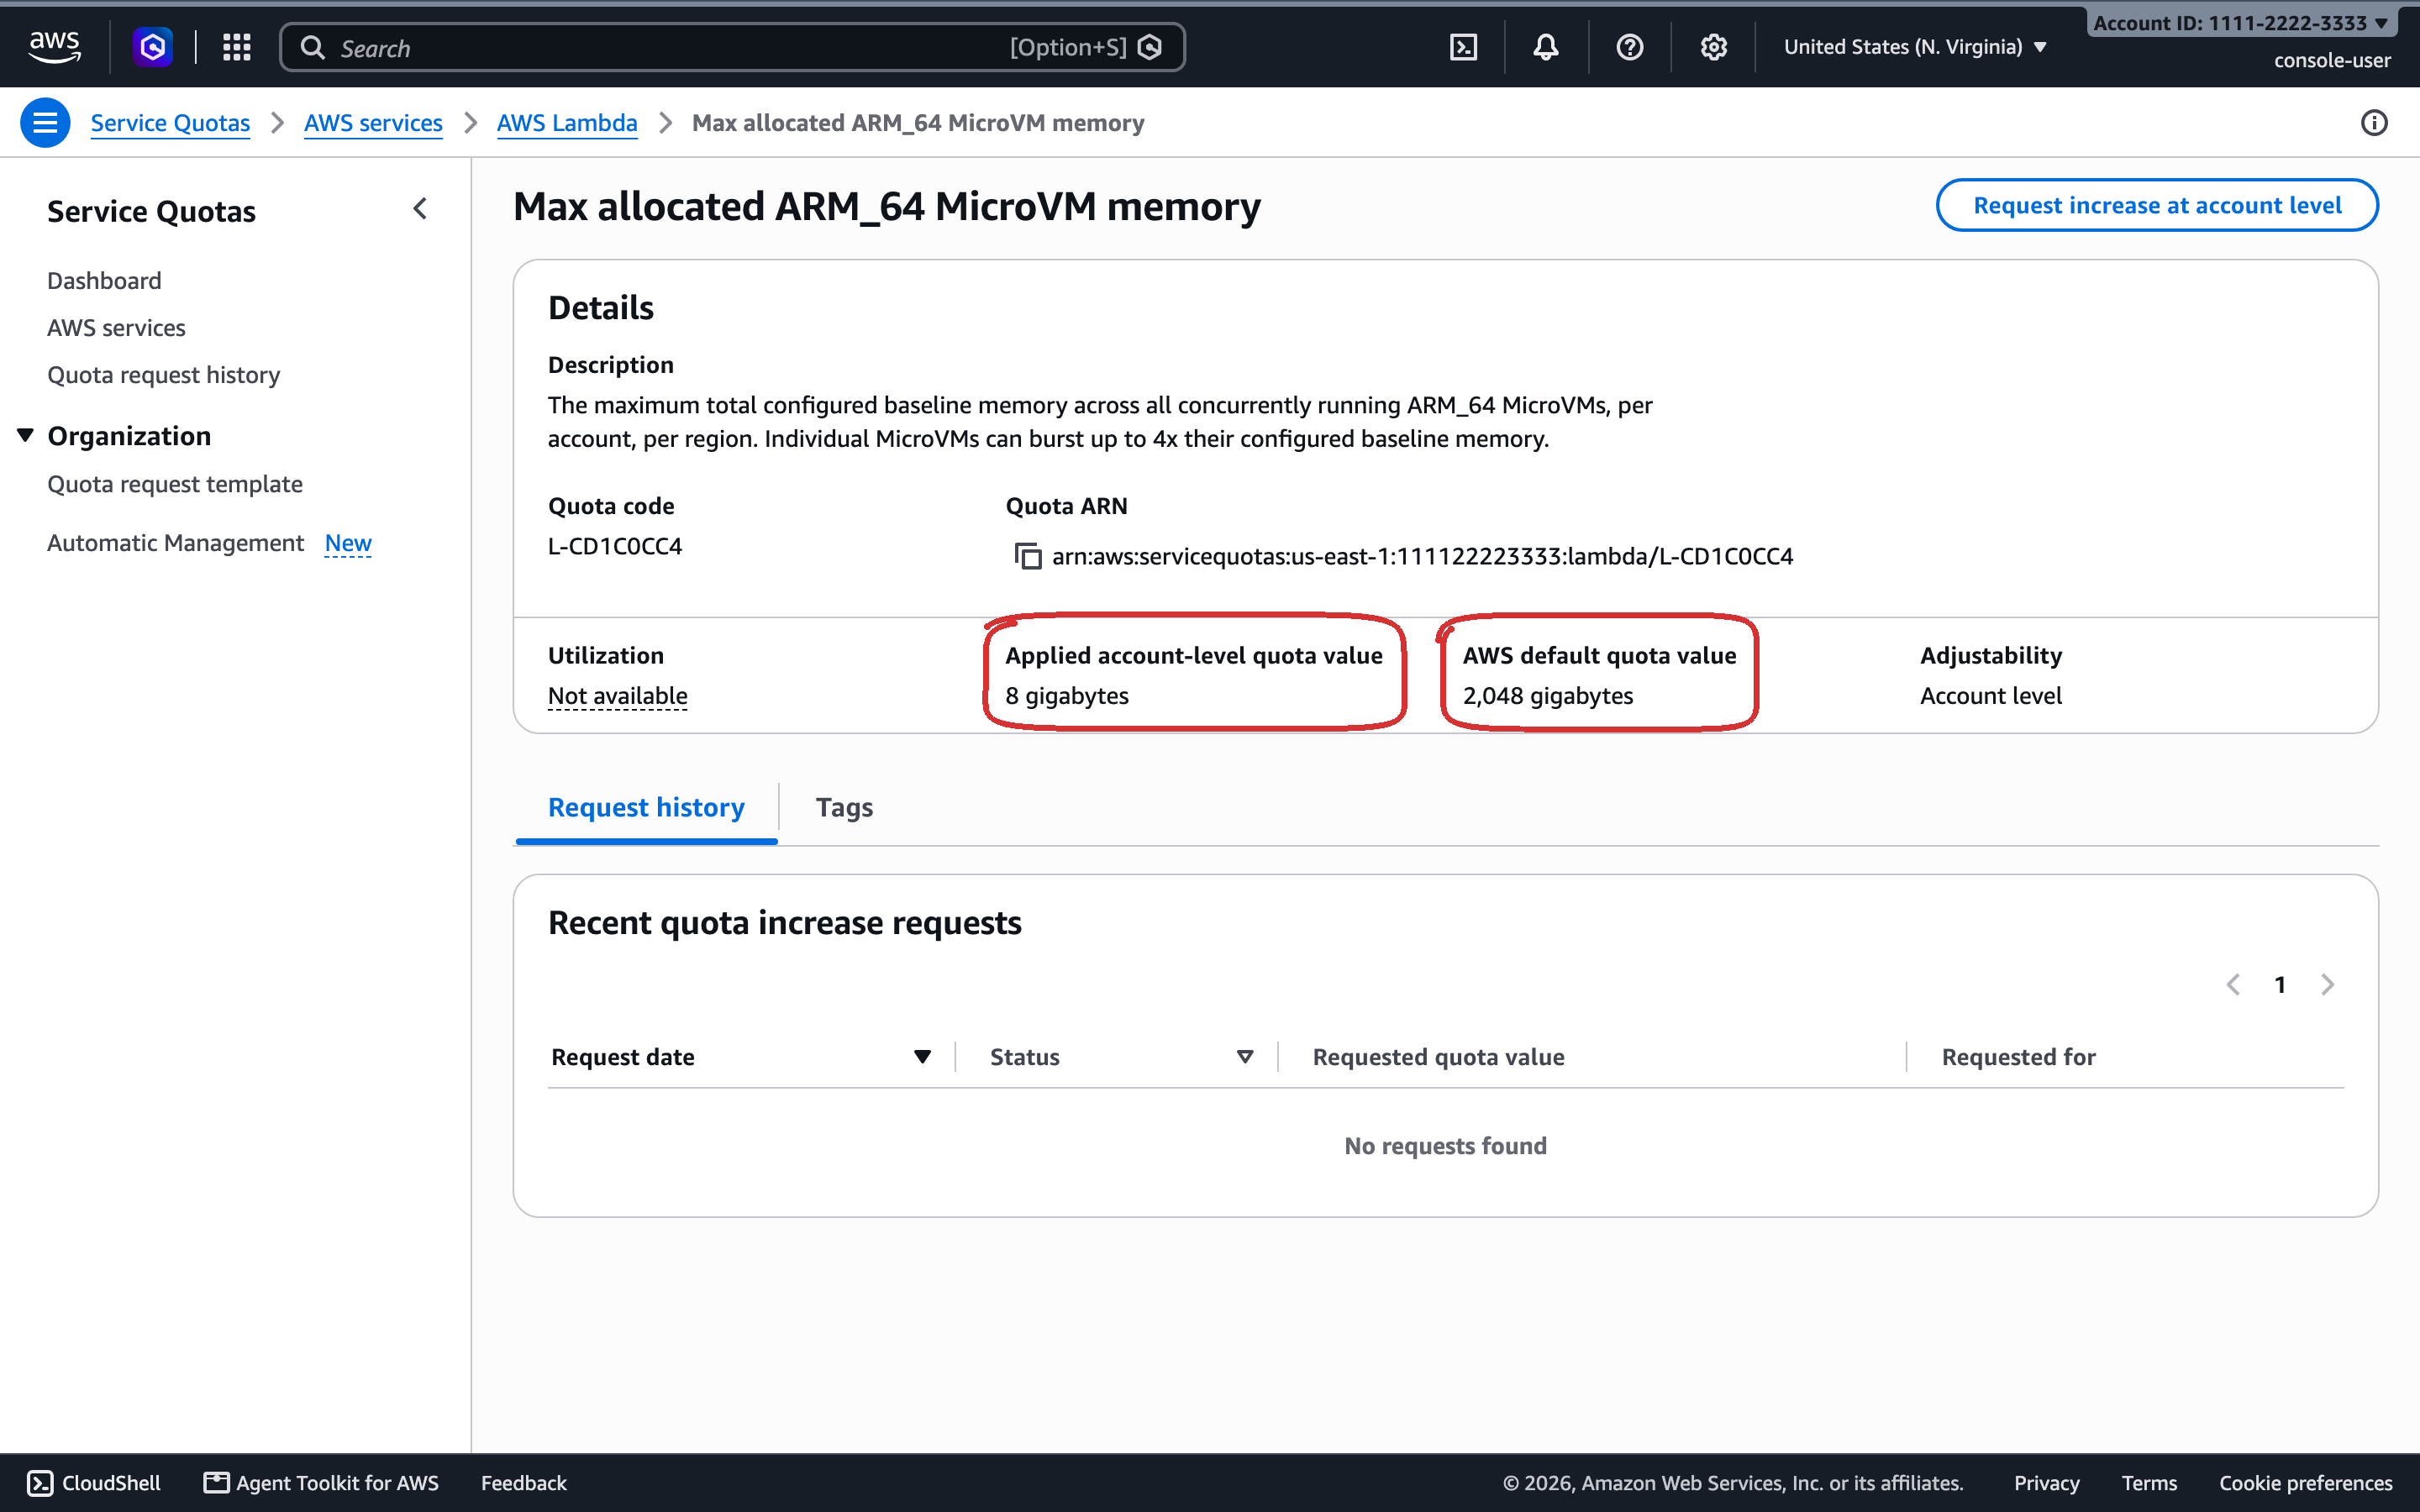
A própria descrição da cota também diz que as MicroVMs “can burst up to 4x their configured baseline memory”, o que bate com o que o free mostrou dentro de um sandbox (Teste 5).
Na primeira versão, quando todo sandbox tinha 2 GB, eu criei quatro em sequência:
| Etapa | Tempo |
|---|---|
| Criar: o sandbox aparece na barra lateral | 0,25 a 0,34 s |
| Criar: terminal conectado | 2,0 a 2,45 s |
| Trocar para outro sandbox: terminal conectado | 0,37 a 0,42 s |
Cada terminal manteve a sua própria sessão tmux: uma linha diferente digitada em cada um continuava lá depois de sair e voltar. O medidor de memória na barra lateral foi de 2 para 8 GB e ficou vermelho.
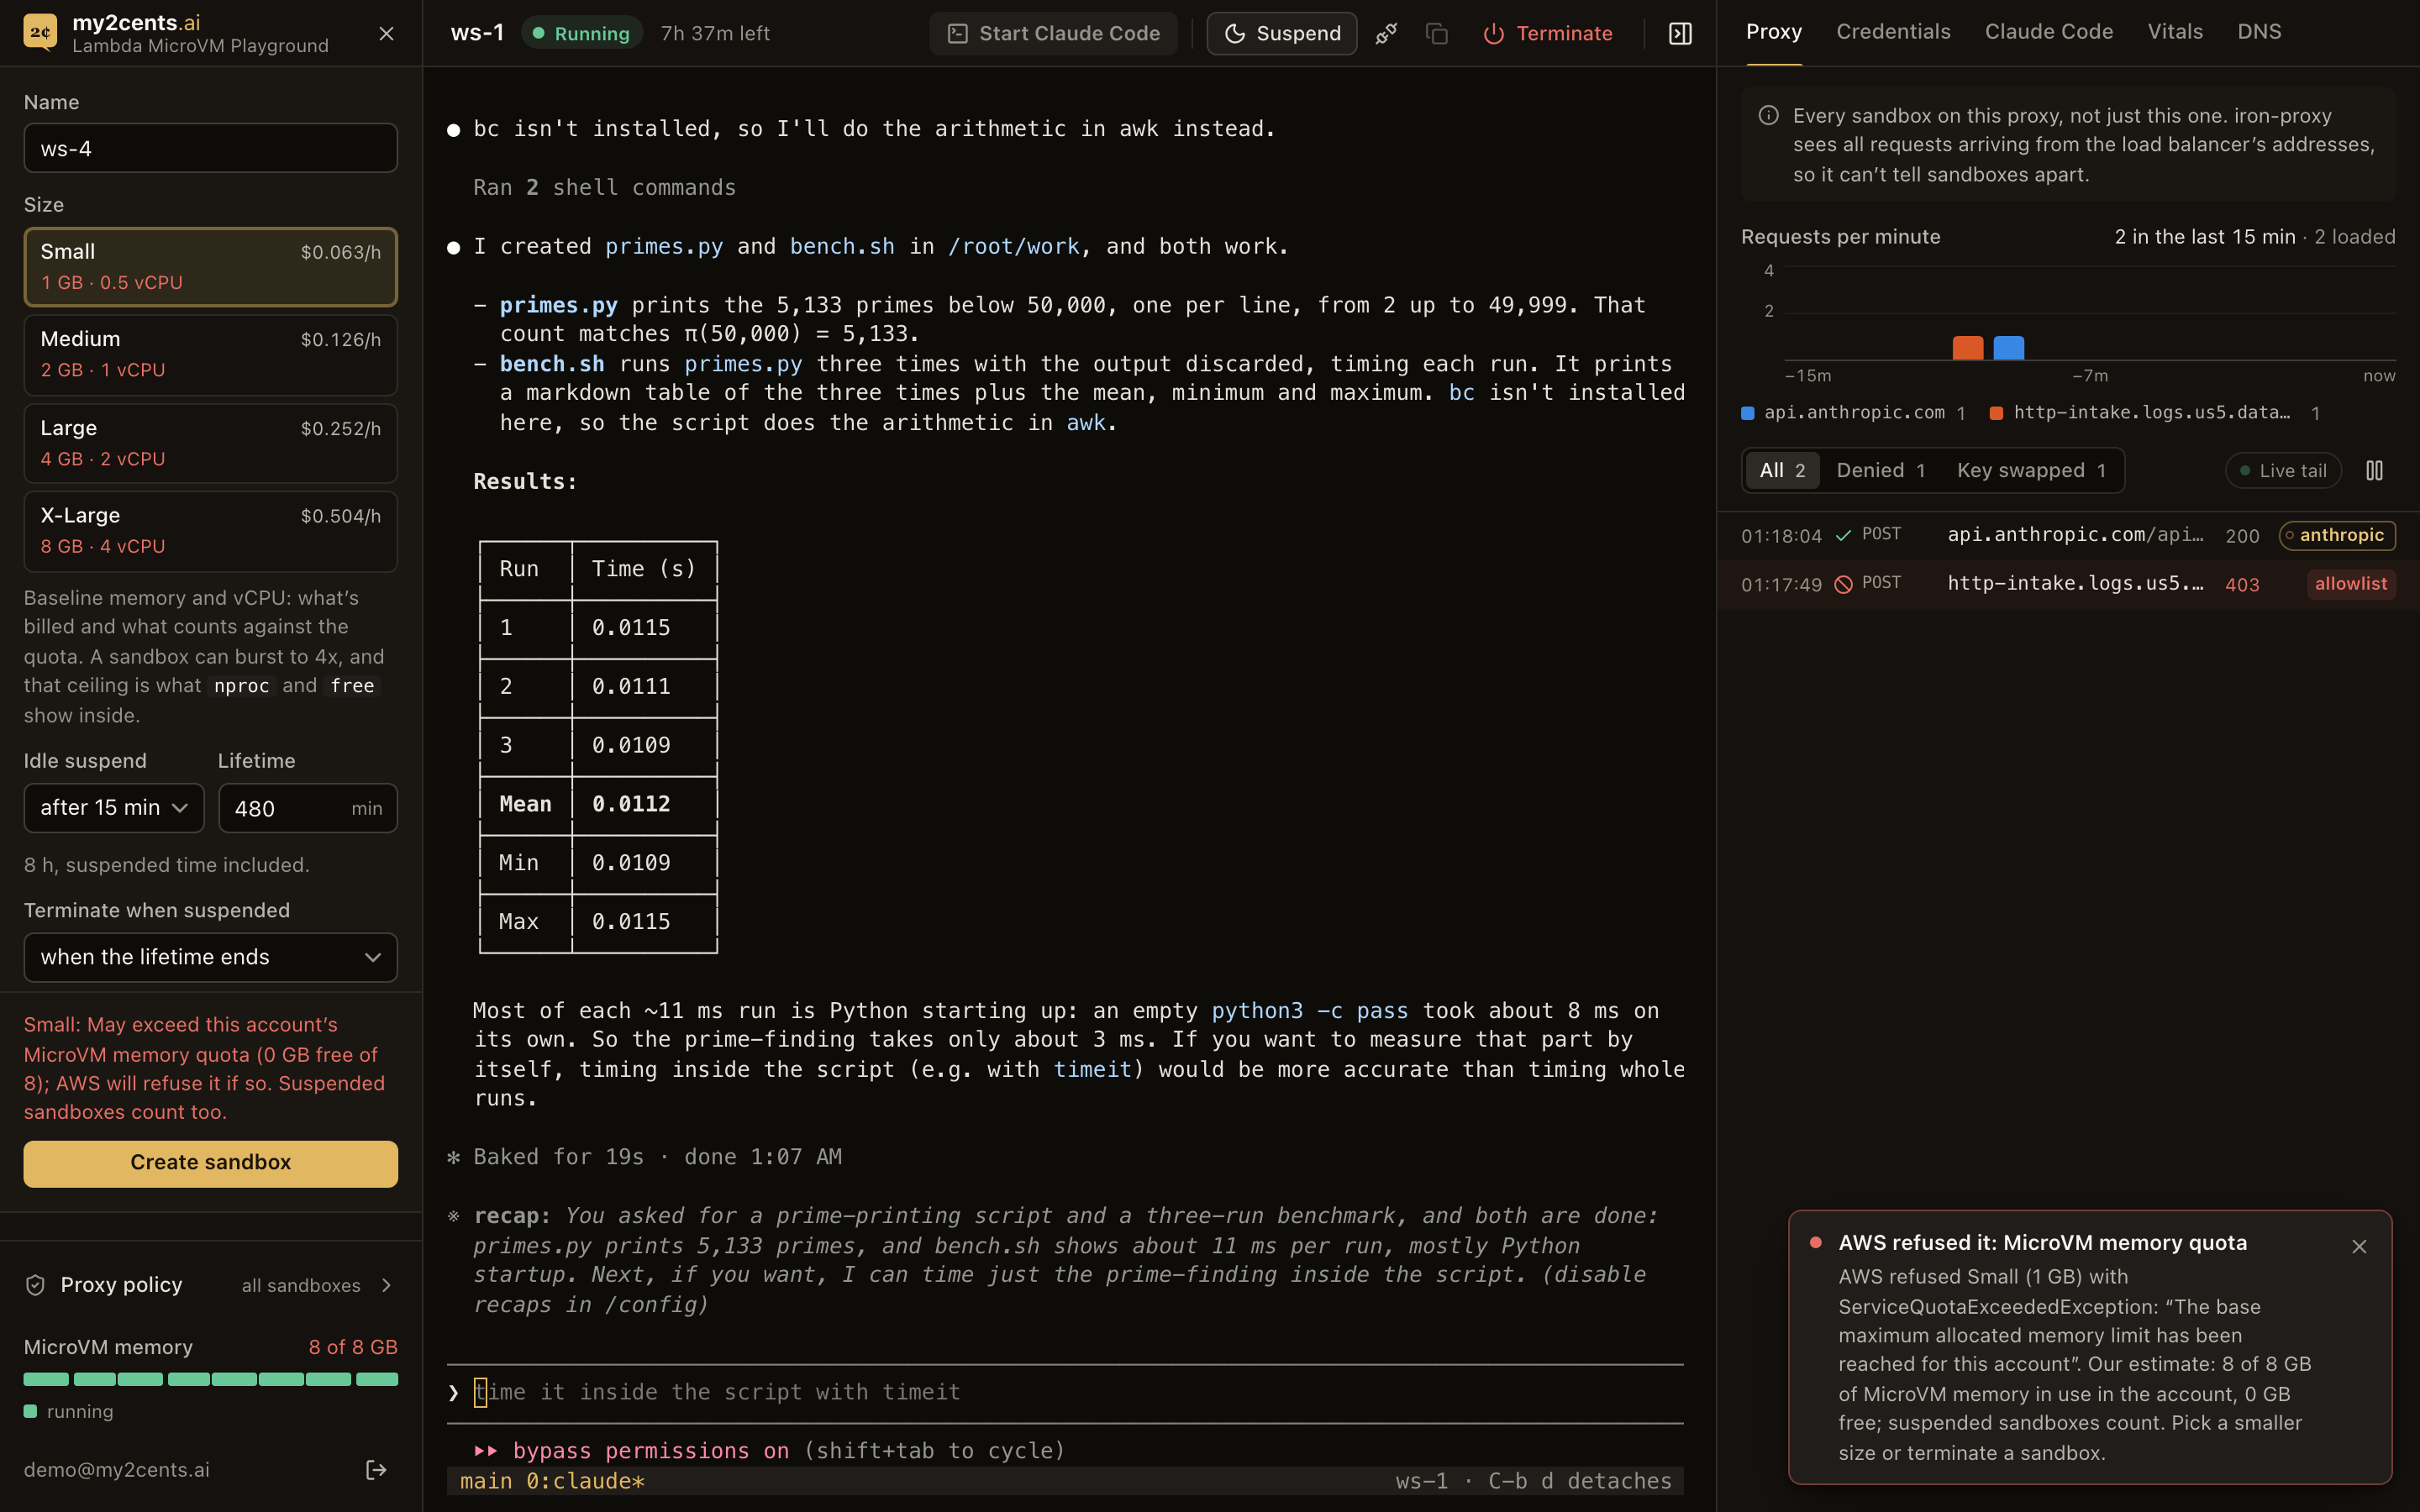
O formulário New mostra a estimativa do app: um tamanho que pode não caber no que resta é sinalizado com “May exceed this account’s MicroVM memory quota (0 GB free of 8); AWS will refuse it if so.” Mas o Create continua habilitado. O app nunca bloqueia uma criação com base na própria estimativa; ele deixa a recusa para a AWS. Uma criação que não cabe vai para o Lambda, que a recusa com ServiceQuotaExceededException (como na parte 1), e a API repassa isso como um 409 com as palavras da própria AWS, “The base maximum allocated memory limit has been reached for this account”, seguidas pela estimativa do app. A cota é por conta, não por usuário, então o medidor também mostra sandboxes iniciados por outros usuários.
Teste 9: O painel de DNS
A aba DNS faz o stream do query log do Route 53 Resolver da VPC do sandbox da parte 2. Na primeira versão, com HTTPS_PROXY e uma única VPC, o painel via pouca coisa: os sandboxes resolviam poucos nomes por conta própria, e a maior parte do log eram as consultas da própria API do workspace. No modo transparente, todo nome que um sandbox consulta passa por esse resolver, e toda consulta recebe o override, um CNAME para o proxy, então nada é resolvido além dele. Nomes que não estão na allowlist do proxy recebem um ícone de aviso. O resolver só registra o que ele não responde a partir do cache, então uma consulta repetida aparece uma vez.
Em um sandbox, nenhum nome, real ou inventado, é resolvido além do override:
$ dig +short api.github.com
proxy.sandbox.internal.
10.50.11.10
10.50.10.10
$ dig +short e2e-<random>.example.com           -> proxy.sandbox.internal. 10.50.10.10 10.50.11.10   (nothing recurses)
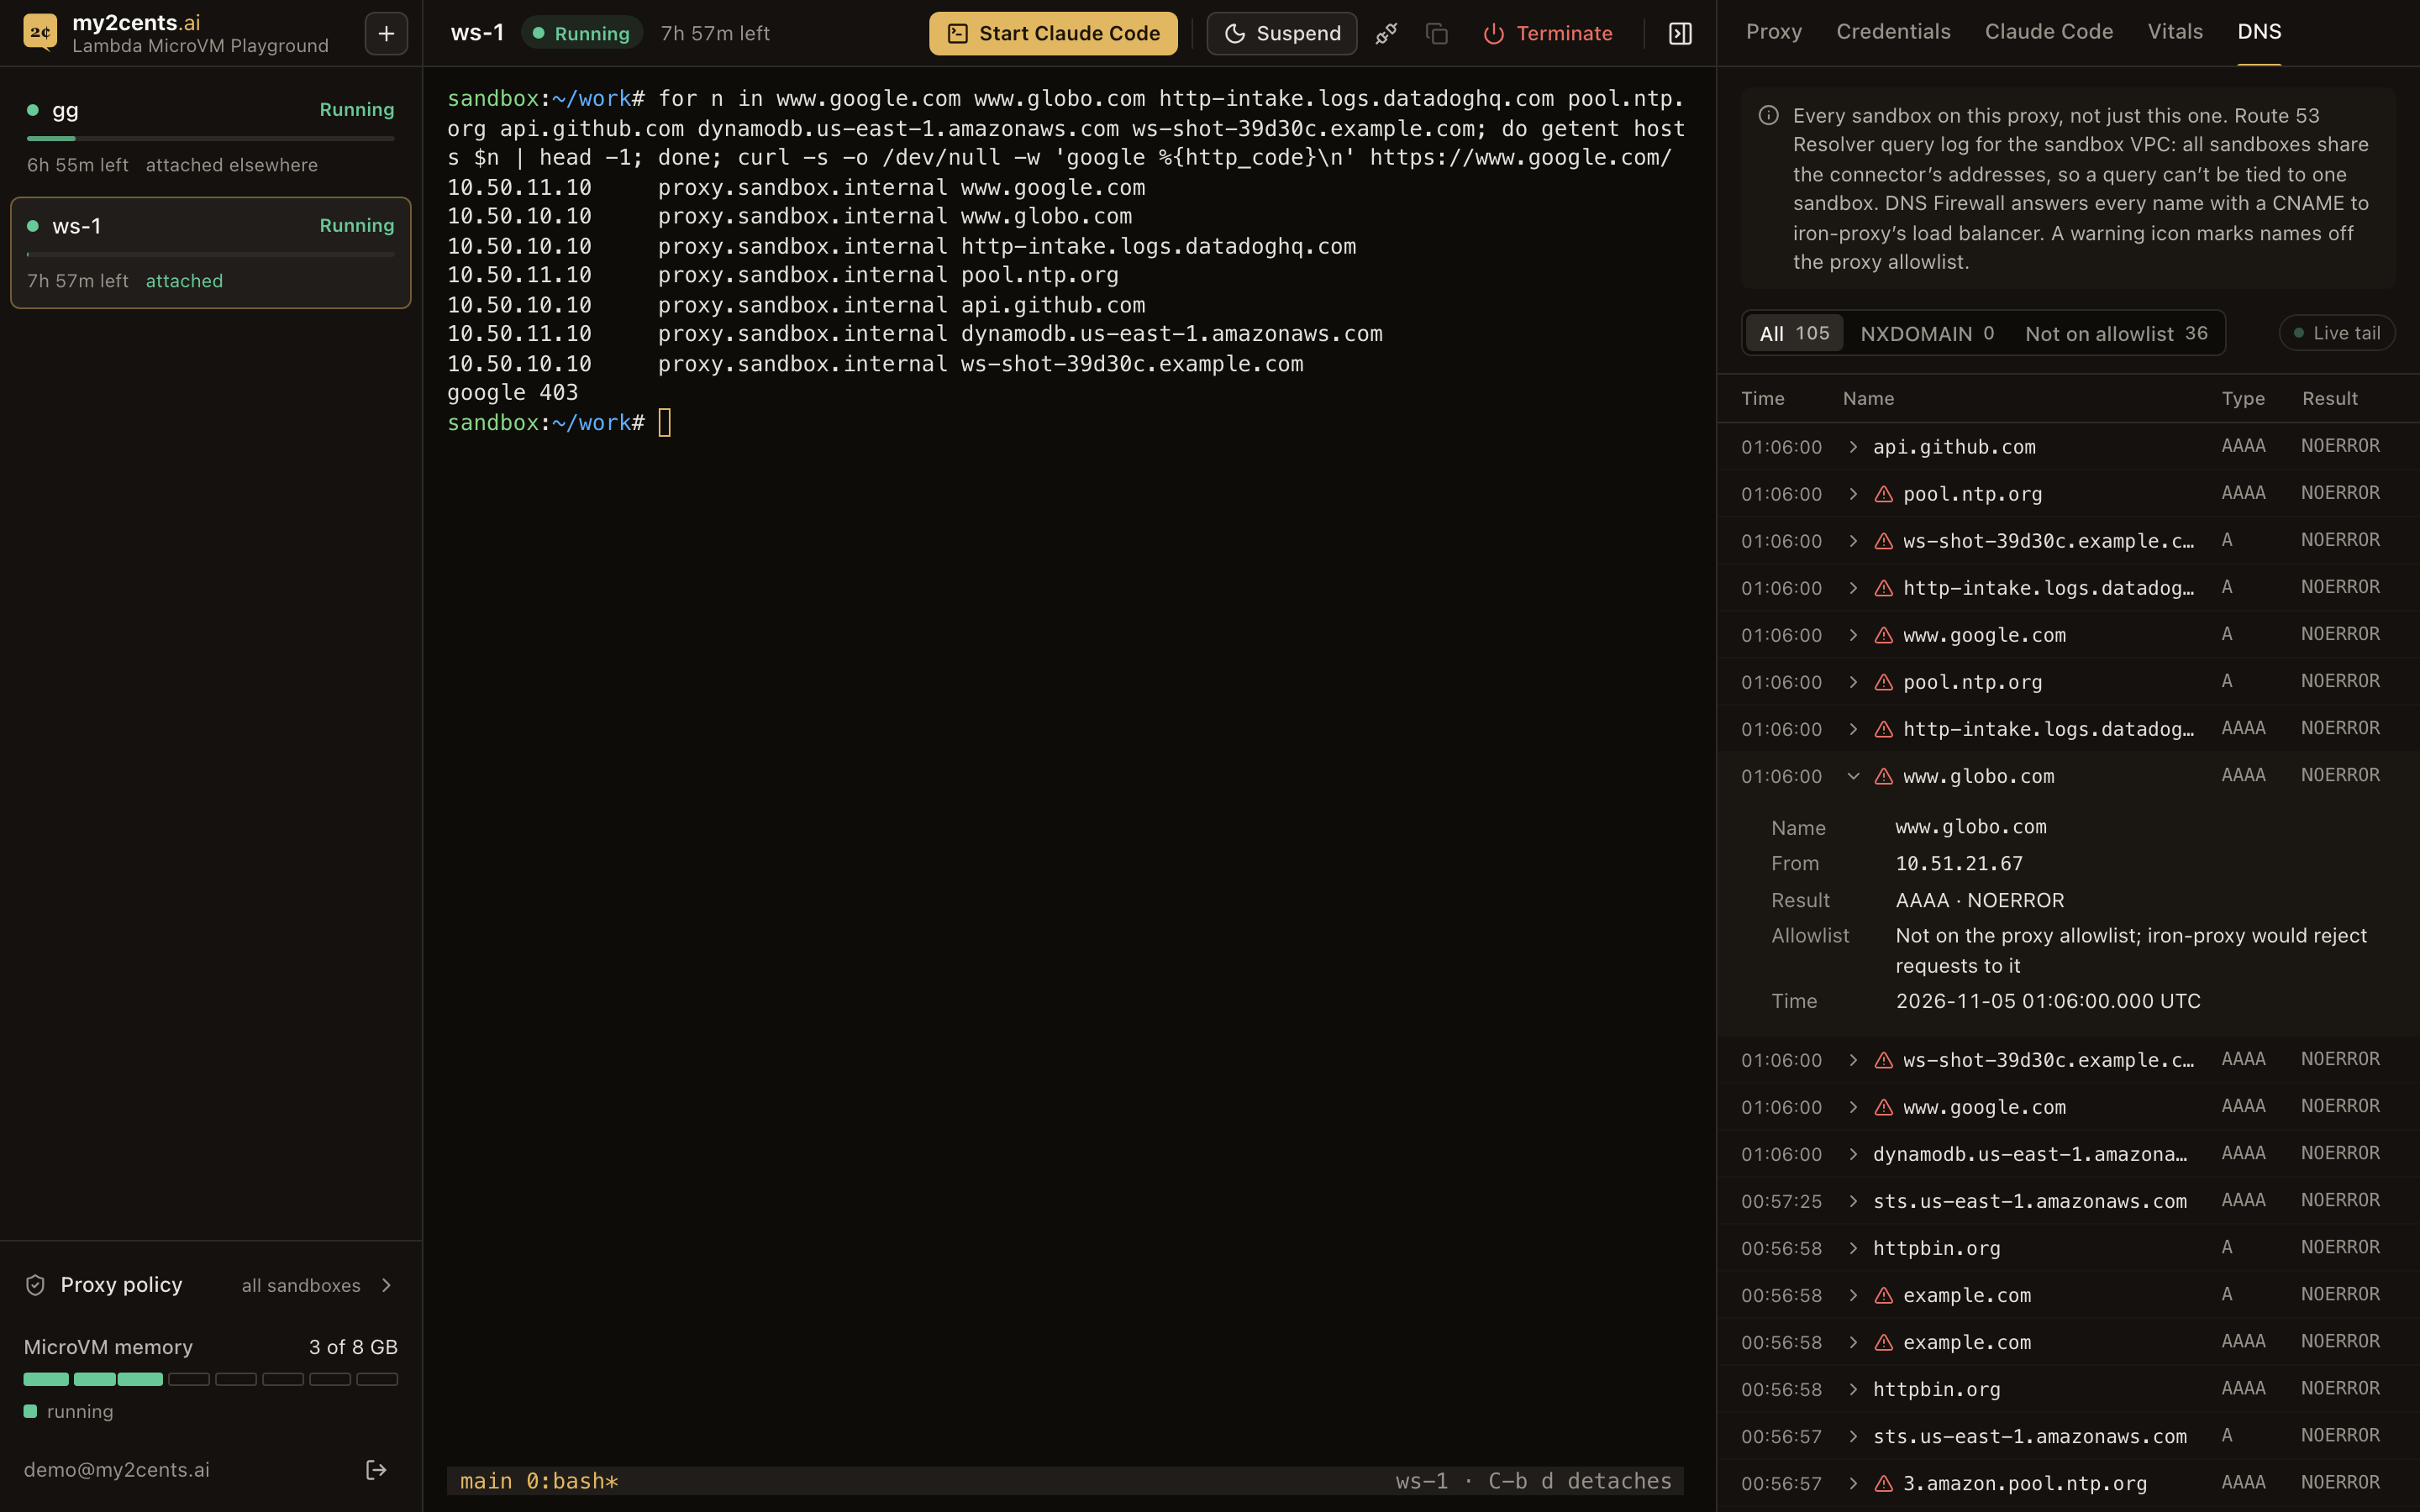
Um loop de getent para sete nomes (www.google.com, www.globo.com, um host de intake do Datadog, pool.ntp.org, um nome aleatório em example.com, api.github.com e dynamodb.us-east-1.amazonaws.com) recebeu os endereços do proxy para todos eles, e curl https://www.google.com/ recebeu o 403 do iron-proxy. A aba DNS sinalizou os cinco primeiros como fora da allowlist do proxy, mas não api.github.com nem o endpoint do DynamoDB, que o escopo AWS padrão view-only permite. Quando eu fiz a captura de tela abaixo, a aba tinha 105 consultas de todos os sandboxes e testes desde que a API iniciou: todas NOERROR com o override, nenhuma NXDOMAIN, 36 fora da allowlist.
As marcações saíram erradas no início. O painel verificava os nomes contra a allowlist do deploy, então marcava como fora da lista endpoints da AWS que o escopo AWS em vigor permitia (DynamoDB, EC2, SQS e outros). Agora ele lê a allowlist em vigor do control plane.
O log traz um endereço de origem, mas na VPC do sandbox ele é uma das duas interfaces de rede do connector (10.51.20.254 e 10.51.21.67 aqui), que todos os sandboxes compartilham, então, assim como o feed do proxy, ele não pode ser associado a um sandbox.
Teste 10: Alterando a allowlist e as credenciais ao vivo
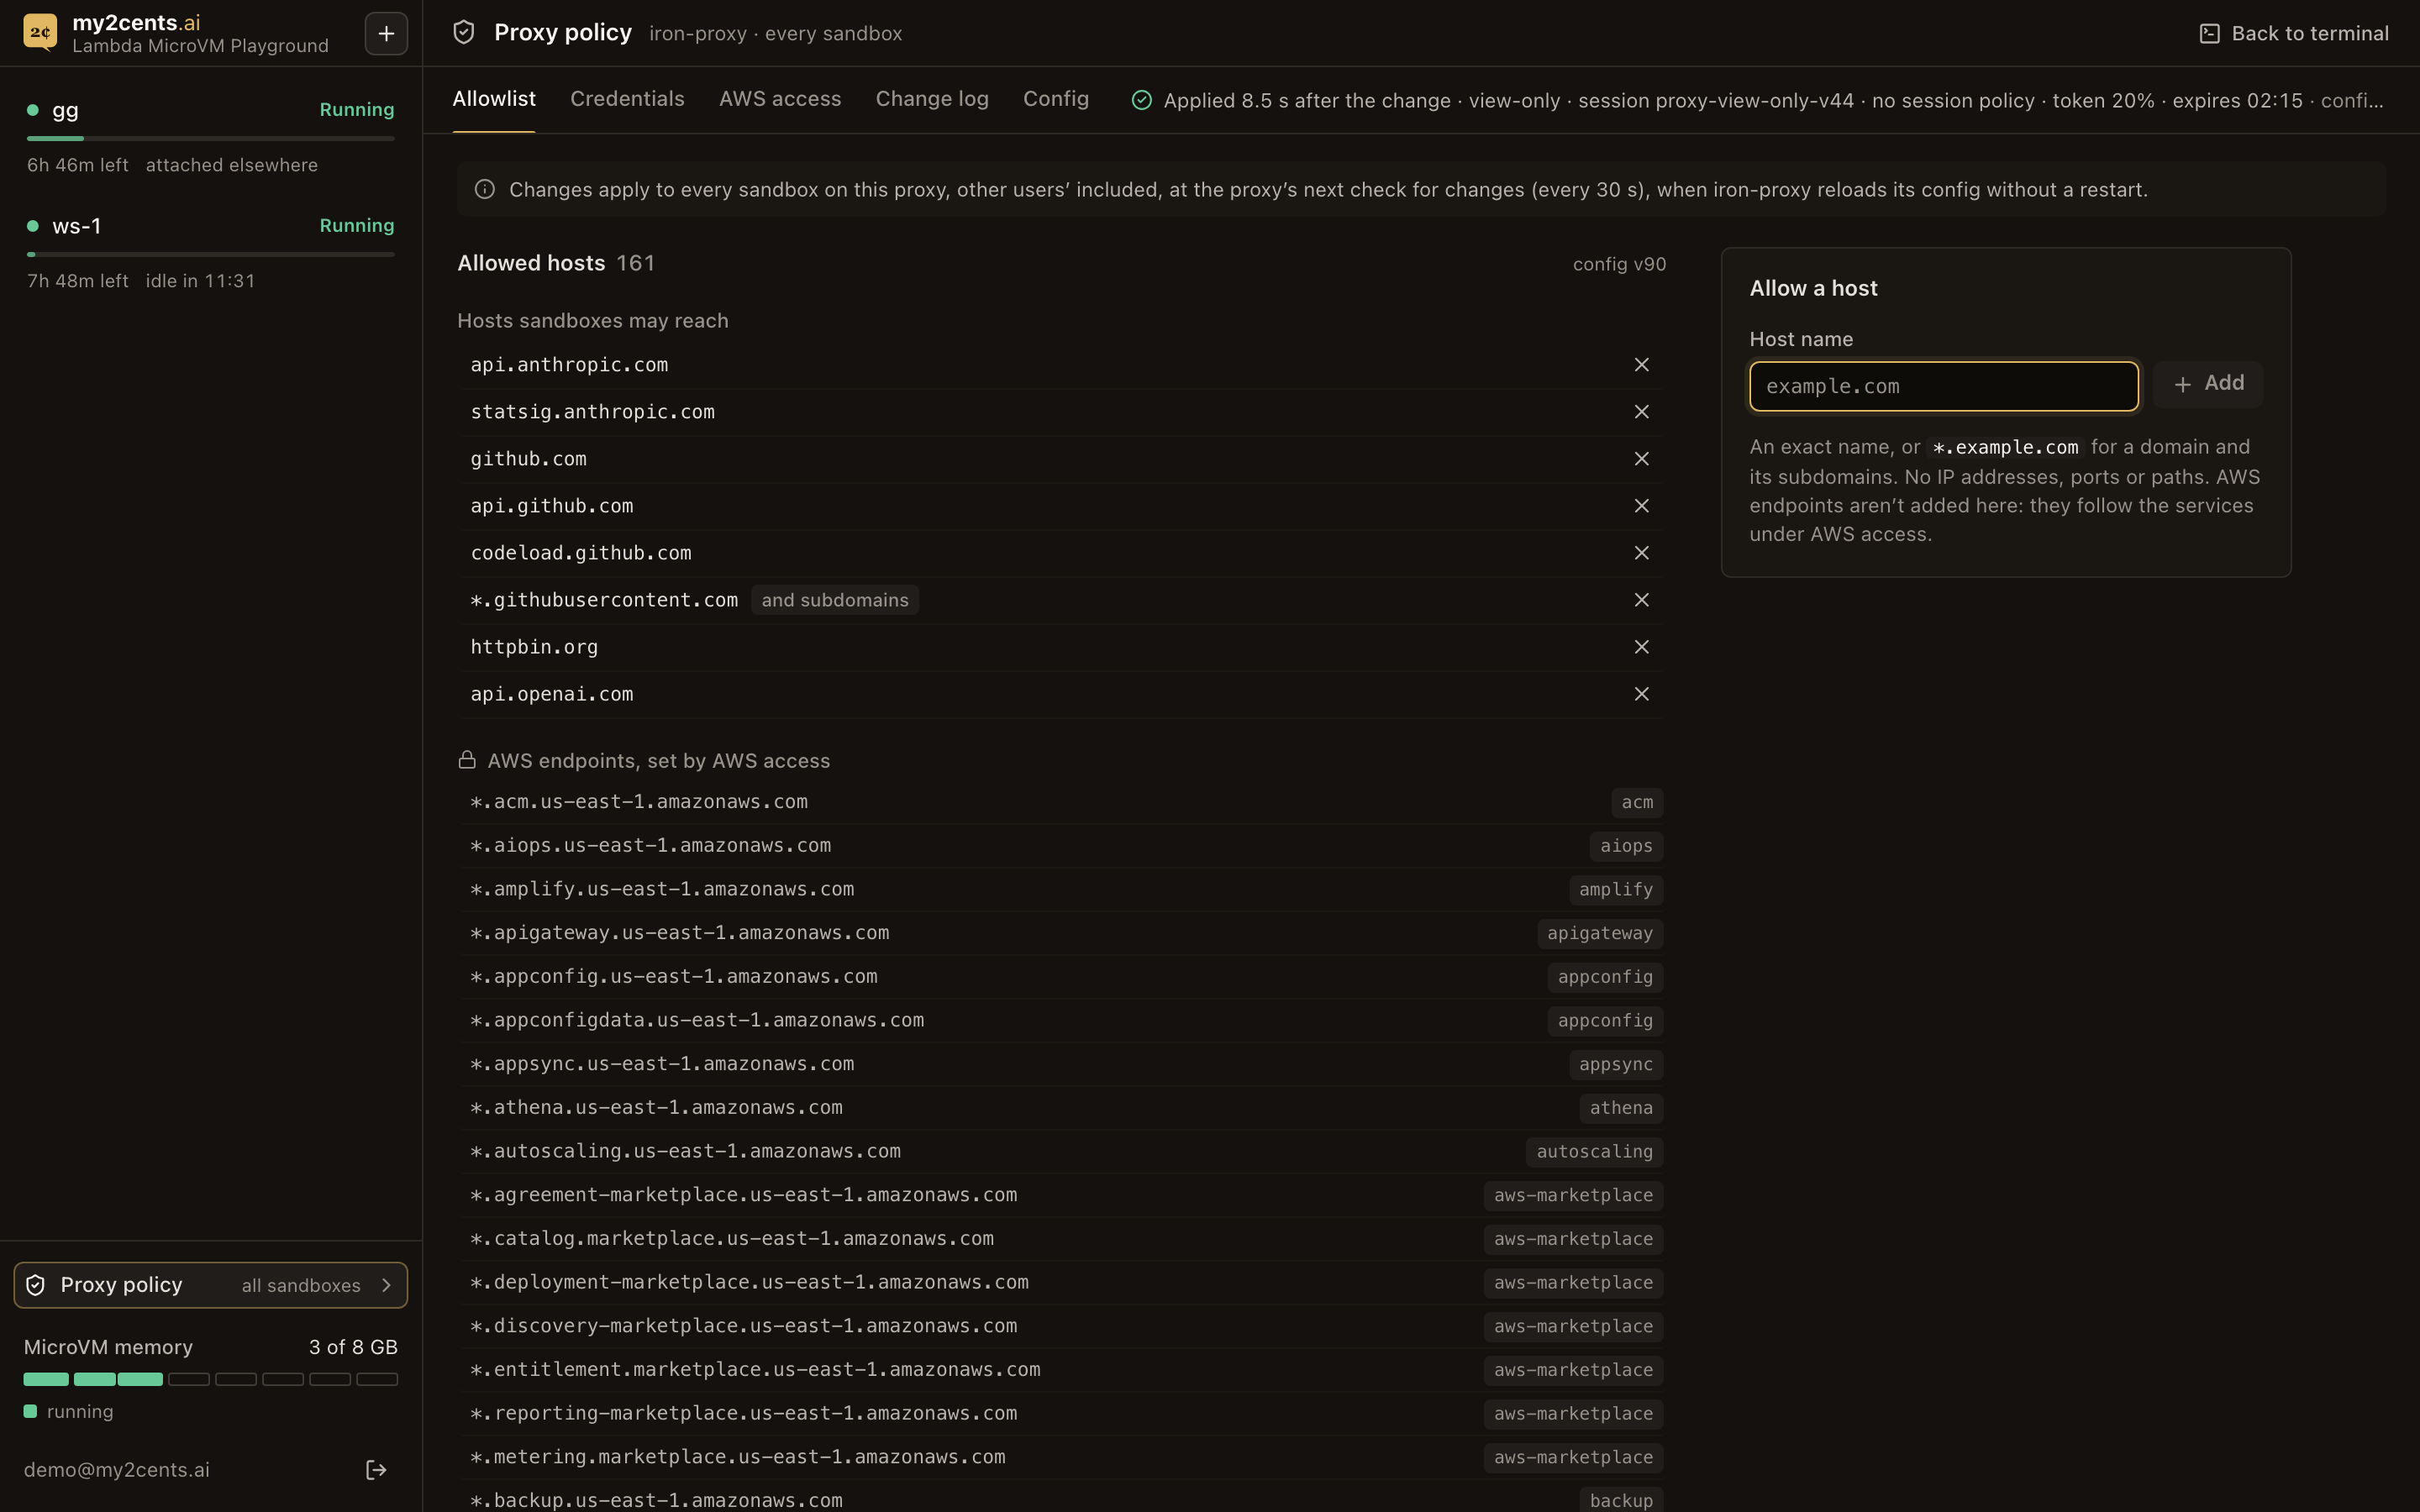
A página Proxy policy edita a configuração do proxy, que todos os sandboxes compartilham; a barra lateral a identifica como “all sandboxes”. A seção de allowlist lista os hosts que os sandboxes podem alcançar. Os endpoints da AWS aparecem separados e bloqueados, porque seguem a seção AWS access. Ao adicionar um host, ela recusa IPs literais, wildcards puros, wildcards sobre um sufixo público como *.co.uk, qualquer coisa sob amazonaws.com e qualquer endpoint do Secrets Manager. O backend altera apenas a allowlist no iron-proxy.yaml, mantém todo o resto (comentários incluídos) e grava o arquivo com If-Match, para que dois admins não sobrescrevam um ao outro. A linha de status faz polling até o sidecar informar o reload, na próxima verificação do bucket.
Medido pela API em 2026-11-05, com um sandbox testando a cada 0,5 s:
| Mudança | Mudança → aplicada | Mudança → visível em um sandbox | Visível como |
|---|---|---|---|
Allowlist: adicionar example.com | 27,7 s | 28,9 s | 403 → 200 |
| Allowlist: removê-lo | 28,8 s | 29,5 s | 200 → 403 |
| Nova credencial | 29,6 s | 31,5 s | o httpbin recebe o valor |
Esses valores ficam perto de 30 s porque cada teste fez a sua mudança logo depois que a anterior entrou em vigor, logo após um poll, então esperou quase um intervalo inteiro. Em 17 mudanças, da gravação no S3 até um reload bem-sucedido levou de 3,3 a 29,5 s, com mediana de 26,3 s; as que por acaso caíram logo antes de um poll levaram de 3,3 a 5,3 s. Uma mudança feita em um momento aleatório leva de 0 a 30 s, cerca de 15 s em média; a captura de tela da allowlist acima pegou uma em 8,5 s. Toda mudança alcançou todos os sandboxes, já que eles compartilham o proxy, e a linha de status diz quanto tempo depois da mudança o iron-proxy fez o reload. Em uma execução anterior, adicionar api.openai.com apareceu em um sandbox como o 401 da própria OpenAI no lugar do 403 do iron-proxy.
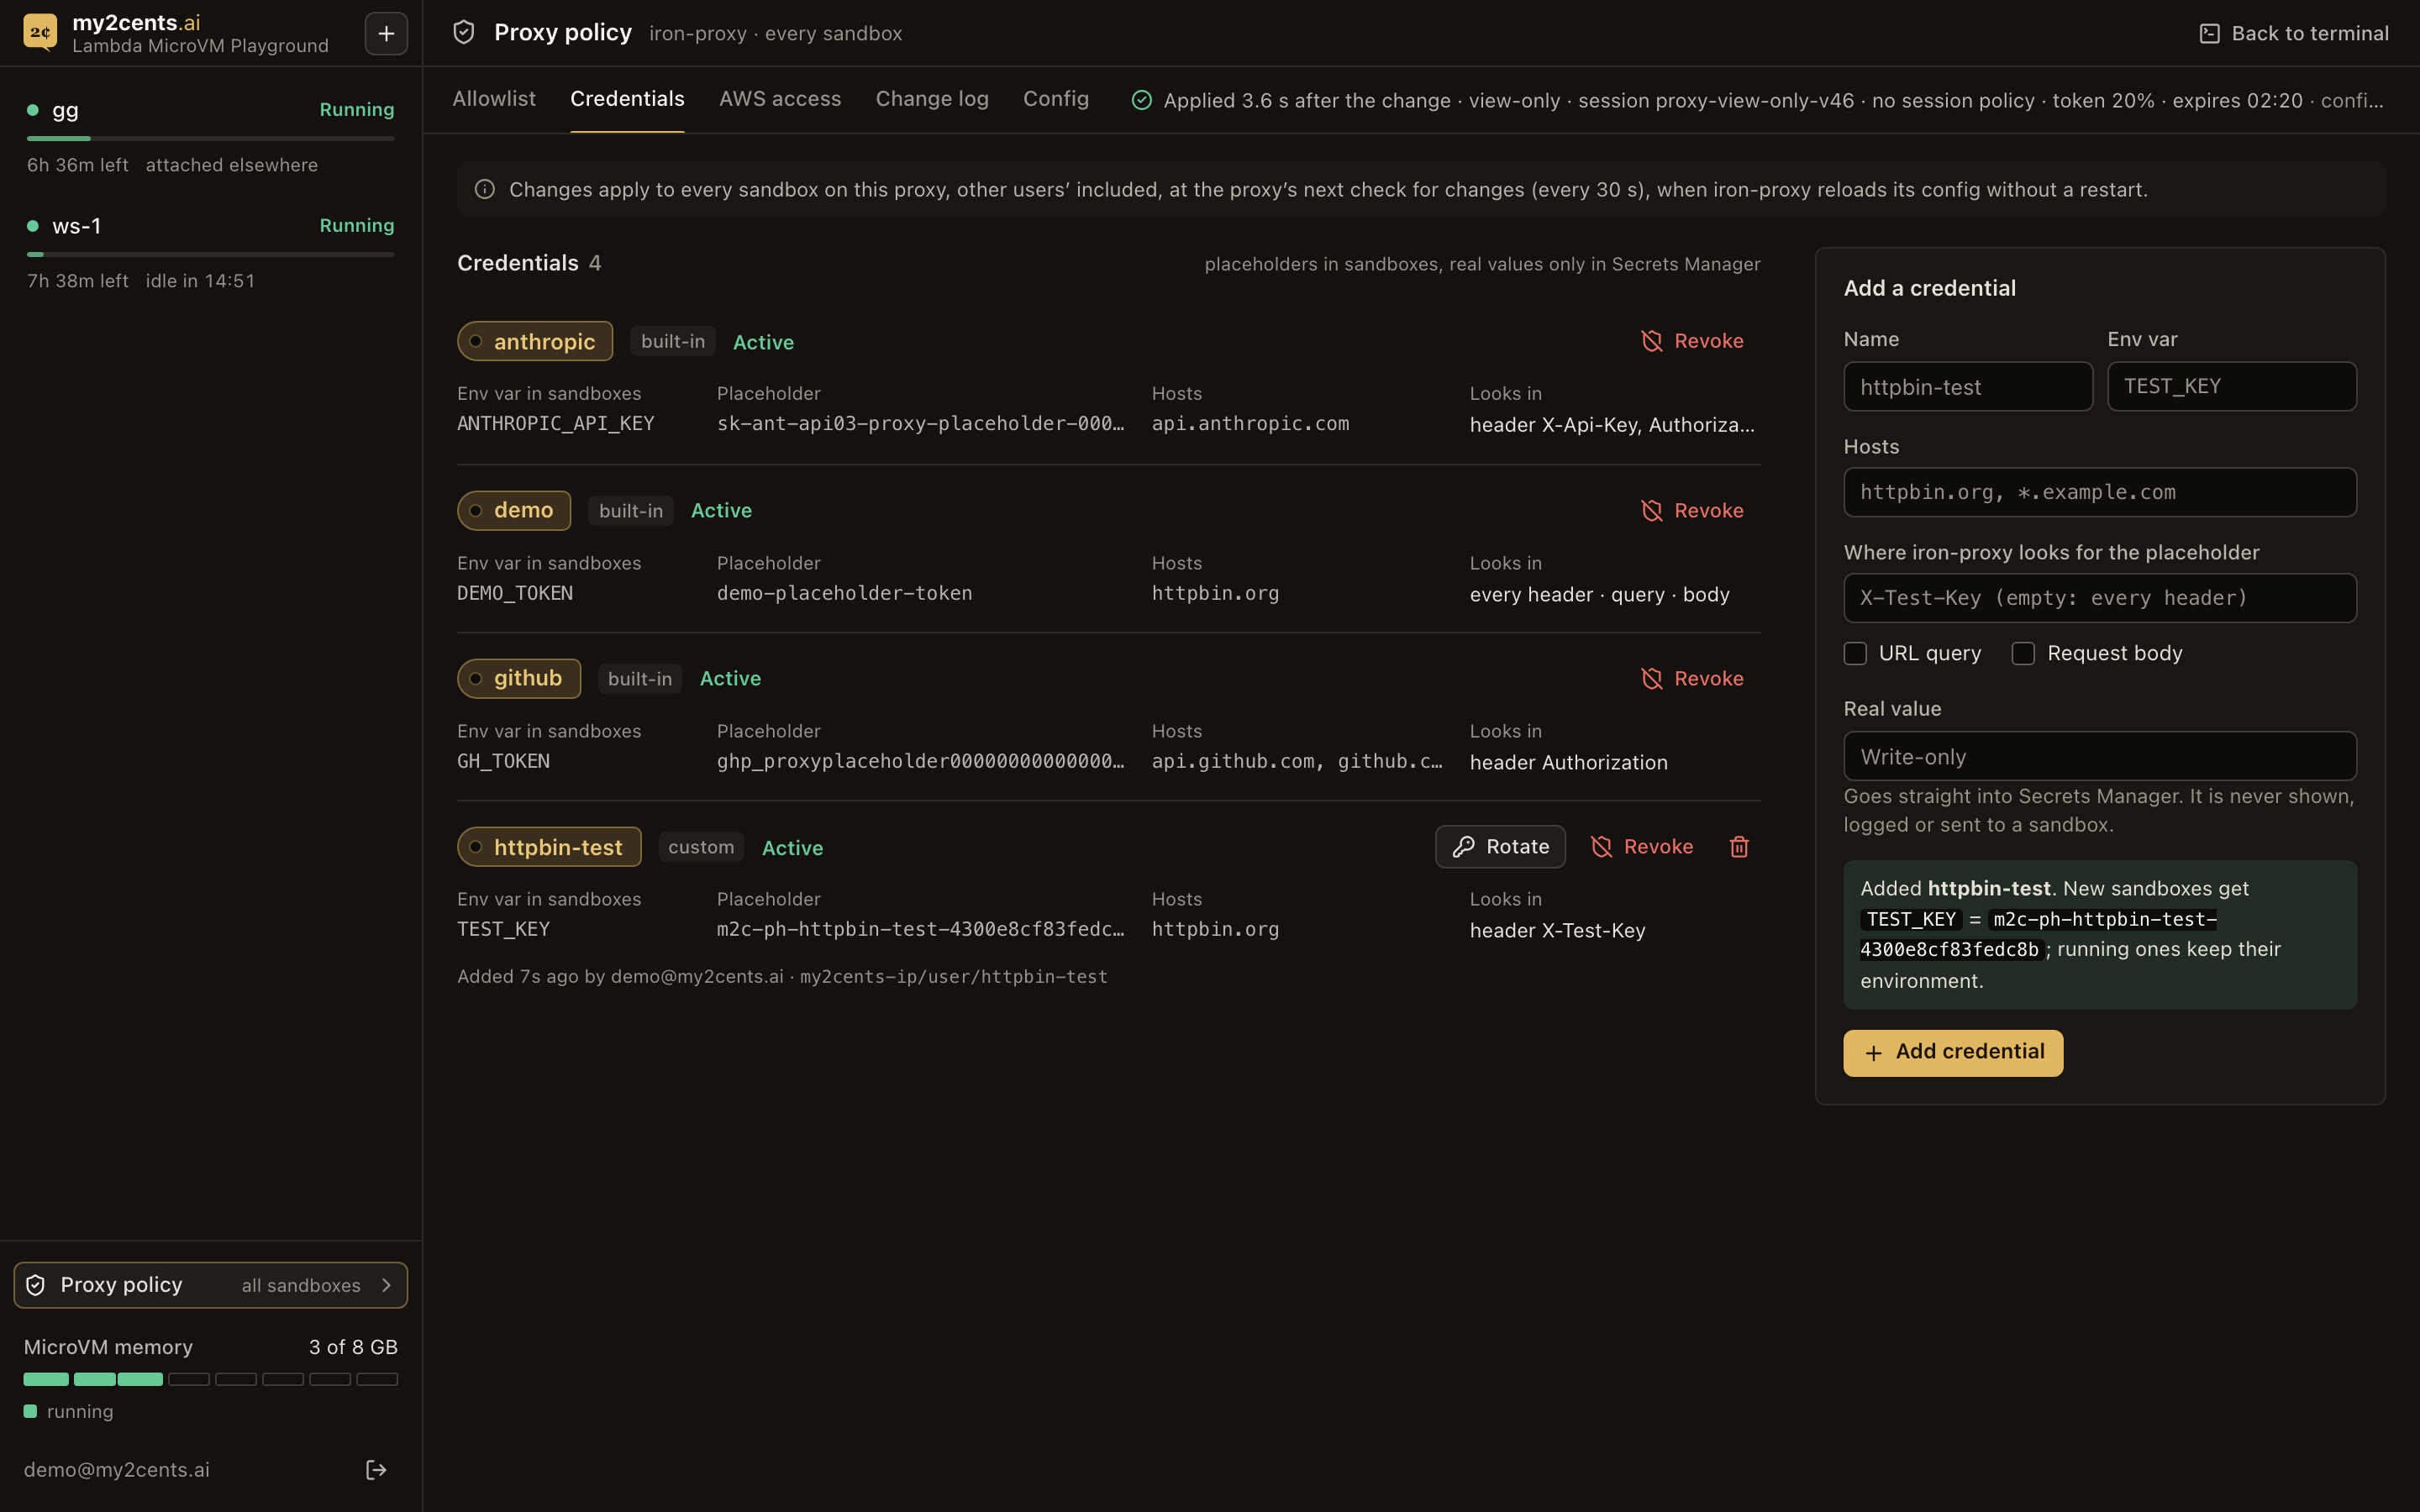
Os admins podem adicionar credenciais próprias. O valor de uma nova credencial vai do formulário direto para o Secrets Manager, nunca para uma resposta, um log ou o log de mudanças, e os sandboxes recebem apenas um placeholder como m2c-ph-<name>-<16 hex>. O segredo fica sob my2cents-ip/user/, que a policy base de cada role permite que o iron-proxy leia. Todo novo sandbox recebe no seu ambiente o placeholder de todas as credenciais; um sandbox que já estava rodando não tem a nova variável, mas um placeholder digitado à mão também funciona lá, já que placeholders não são segredos. Rotacionar o valor de uma credencial não exige reload: o iron-proxy o pega dentro do seu cache de 30 segundos (30,8 s medidos na primeira versão). Toda mudança entra em um log de mudanças com quem a fez e a versão da configuração, e sem nenhum valor secreto.
Os admins também têm uma aba Config, porque “Applied” é uma afirmação que vale a pena conferir. Ela mostra a configuração do proxy e o escopo AWS como estão no bucket S3 (o desejado) ao lado do que o sidecar informa ter aplicado, com um selo: In sync; Pending, enquanto uma versão mais nova espera a próxima verificação do sidecar; Refused, quando o sidecar rejeitou uma configuração, com o motivo; ou Stale, quando o sidecar não envia status há mais de 90 s. O backend oculta qualquer coisa com cara de segredo antes de enviar os arquivos.
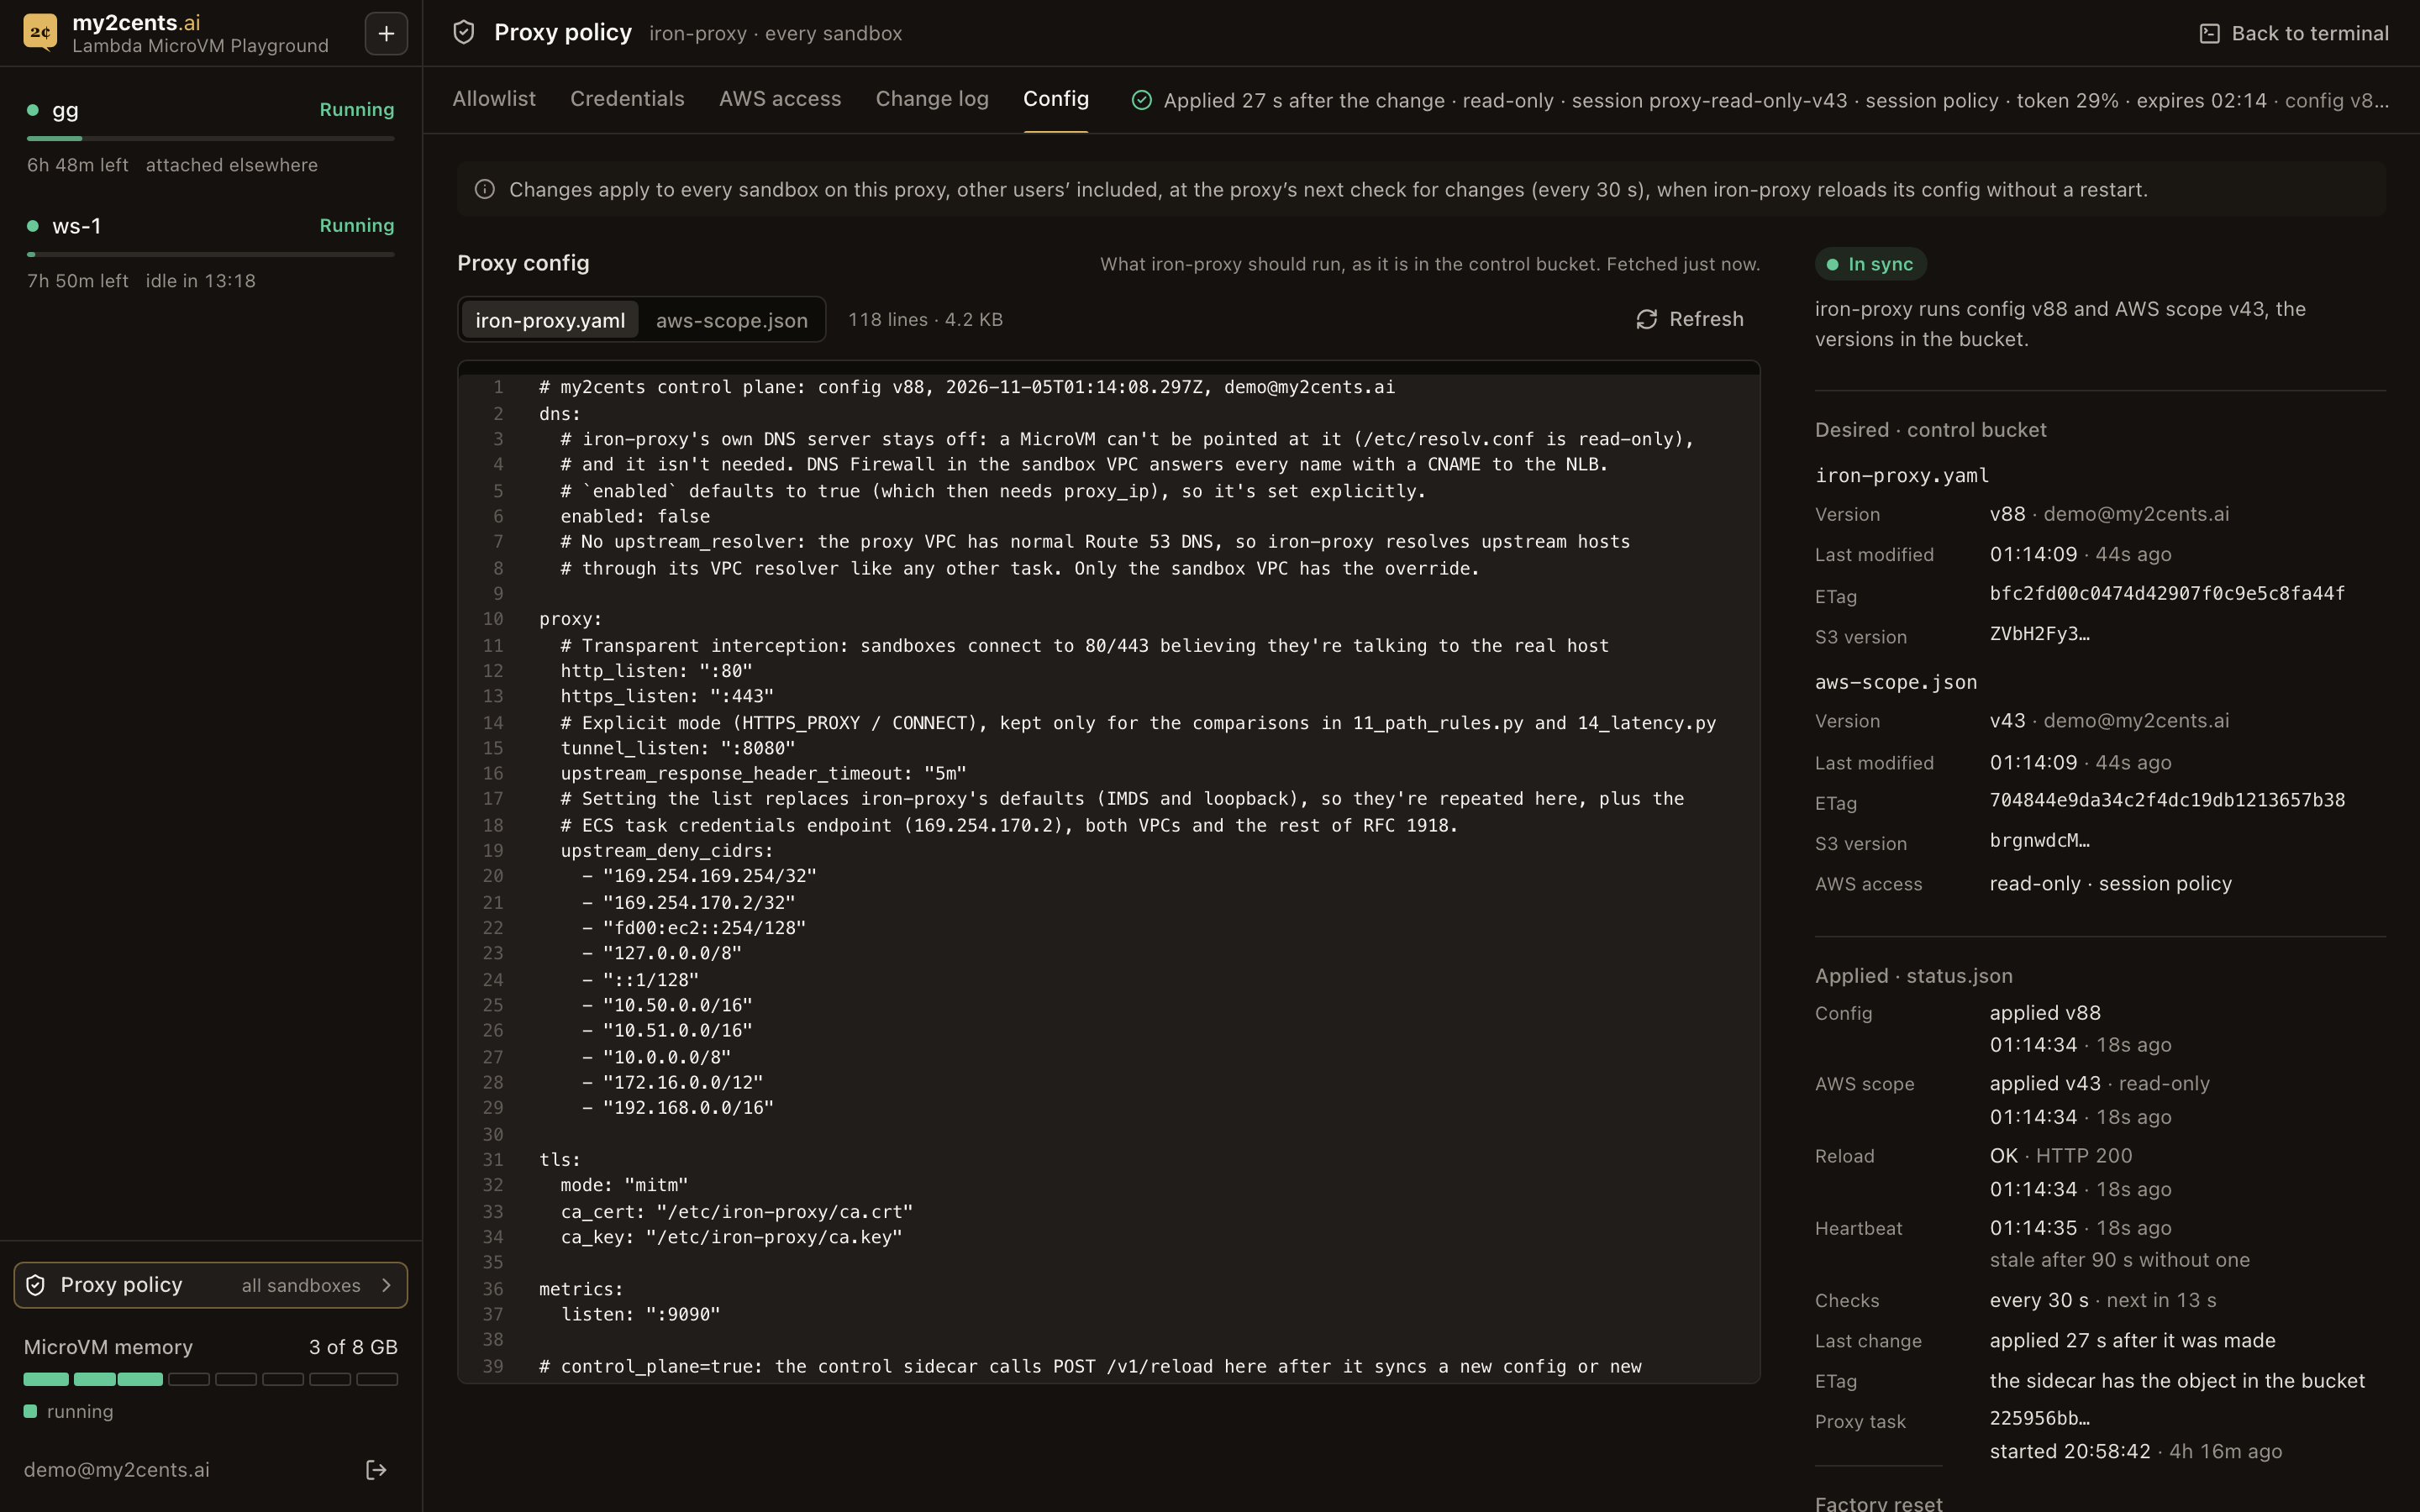
A mesma aba tem uma restauração de fábrica que volta a policy aos padrões de deploy da parte 2: a allowlist inicial, as credenciais embutidas ativas de novo (sem os Deny das revogações), o acesso à AWS de volta para view-only sem session policy, e o iron-proxy.yaml regenerado a partir do iron-proxy.default.yaml da parte 2. As credenciais personalizadas saem da configuração, mas os segredos delas continuam no Secrets Manager, listados no diálogo: adicionar uma de volta com o mesmo nome reaproveita o segredo mantido, o que entrou em vigor em 3,6 s em uma tentativa. Ela mostra antes o que vai mudar, exige digitar reset e entra em vigor na próxima verificação do proxy. Pela API, um reset foi aplicado 27,8 s depois da mudança, a aba Config mostrou In sync em 29,0 s, e um sandbox viu example.com recusado, a chave demo real de novo e a role view-only entre 29,3 e 30,2 s. Pelo navegador, a aba mostrou Pending 1,2 s depois do clique e In sync em 26,3 s.
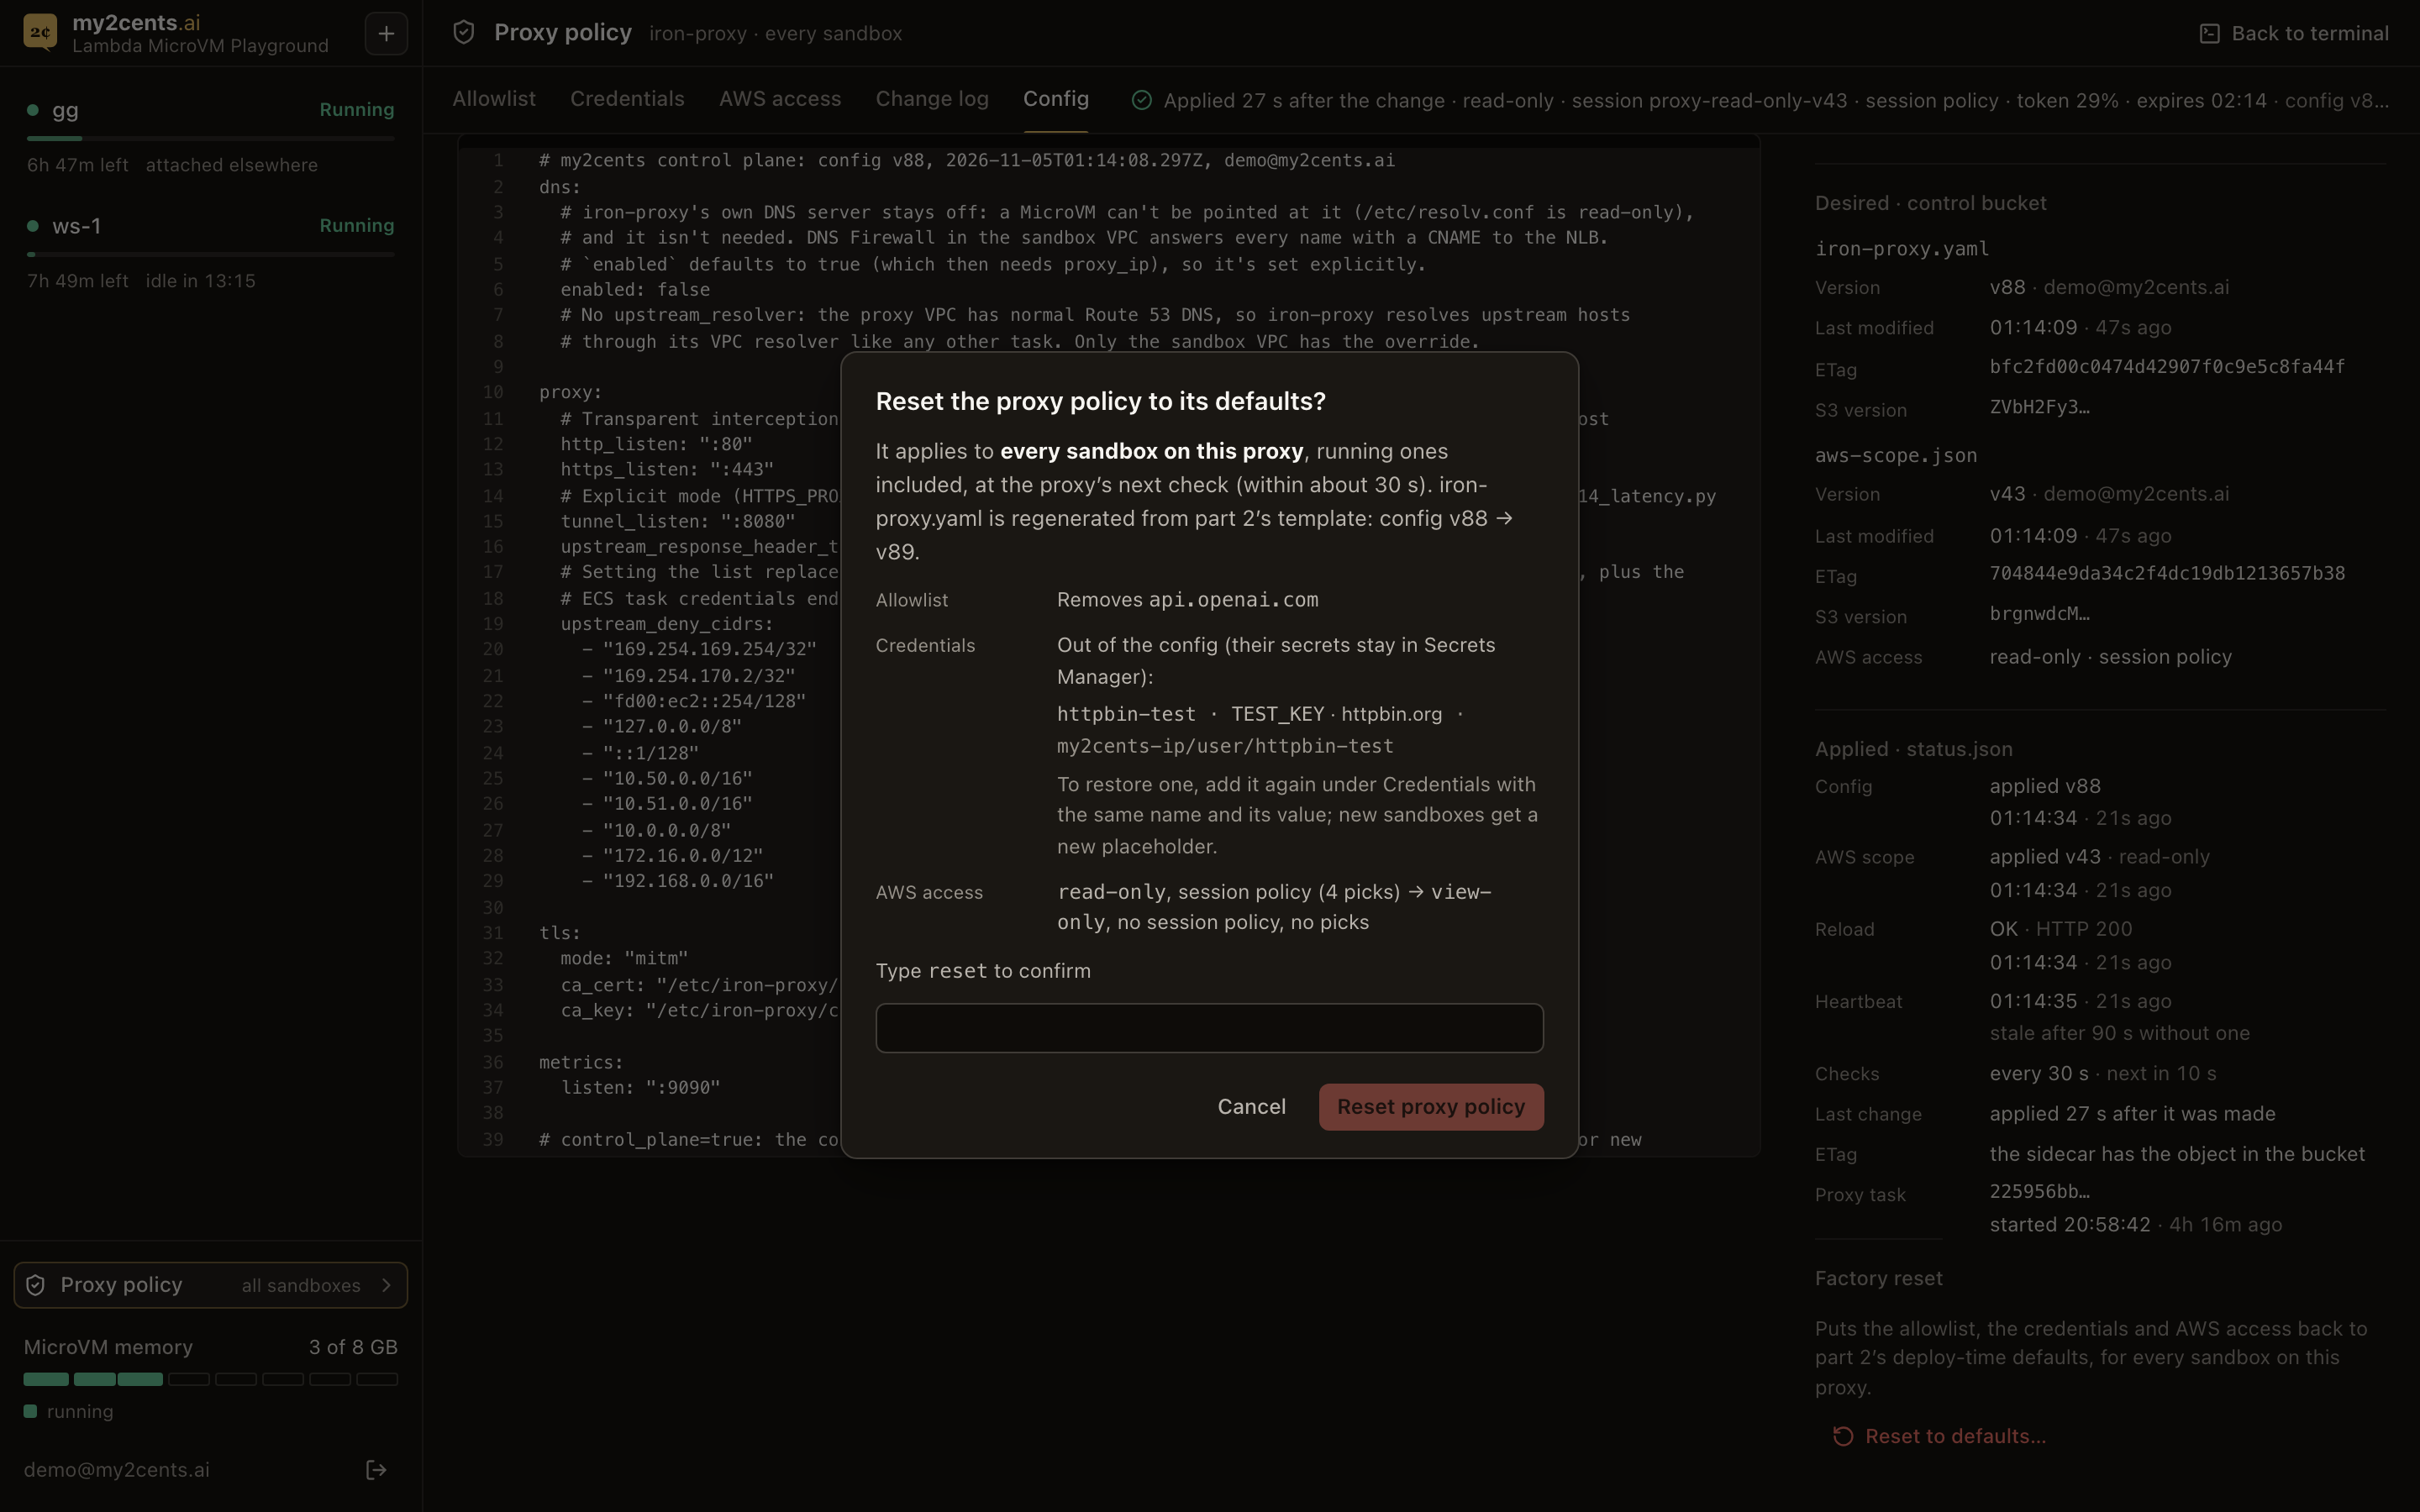
Teste 11: Revogando uma credencial sem reiniciar
O Revoke da primeira versão negava à role do proxy o acesso ao segredo e reiniciava o proxy, porque a parte 2 tinha mostrado que, sem isso, um valor em cache continua sendo injetado. Levava cerca de dois minutos para fazer efeito (115 s até só o placeholder sair), e durante esse tempo o valor antigo continuava funcionando. Com o control plane, o Revoke ainda coloca um Deny na resource policy do segredo, agora para a task role do iron-proxy e para as quatro roles de sandbox (com o control plane ligado, o iron-proxy busca os segredos como a sessão da role assumida). Depois, em vez de reiniciar, ele grava uma nova versão da configuração. Na próxima verificação do sidecar, o reload monta um novo estágio de segredos, então o valor em cache some, a nova busca é negada e o placeholder sai sem troca: o comportamento fail-open da parte 2, usado a nosso favor. Testado com o segredo demo e um sandbox fazendo amostras no httpbin:
| Ação | Mudança → aplicada | Mudança → vista no sandbox | O que o request levava |
|---|---|---|---|
| Revoke | 27,9 s | 29,2 s | o placeholder, sem troca |
| Restore | 28,7 s | 29,3 s | o valor real de novo |
Então uma revogação entra em vigor dentro de um intervalo de poll, sem reiniciar nada: no máximo cerca de 30 s, contra 115 s do reinício da primeira versão. Até a próxima verificação do sidecar, o iron-proxy ainda troca o placeholder pela chave revogada. A revogação também continua valendo para todos os sandboxes ao mesmo tempo, já que eles compartilham o proxy. Para uma chave vazada, revogue-a também na origem (o console da Anthropic, o GitHub): o Revoke daqui impede os sandboxes de usá-la, mas não torna a chave segura.
Teste 12: Acesso à AWS: quatro roles e uma session policy opcional
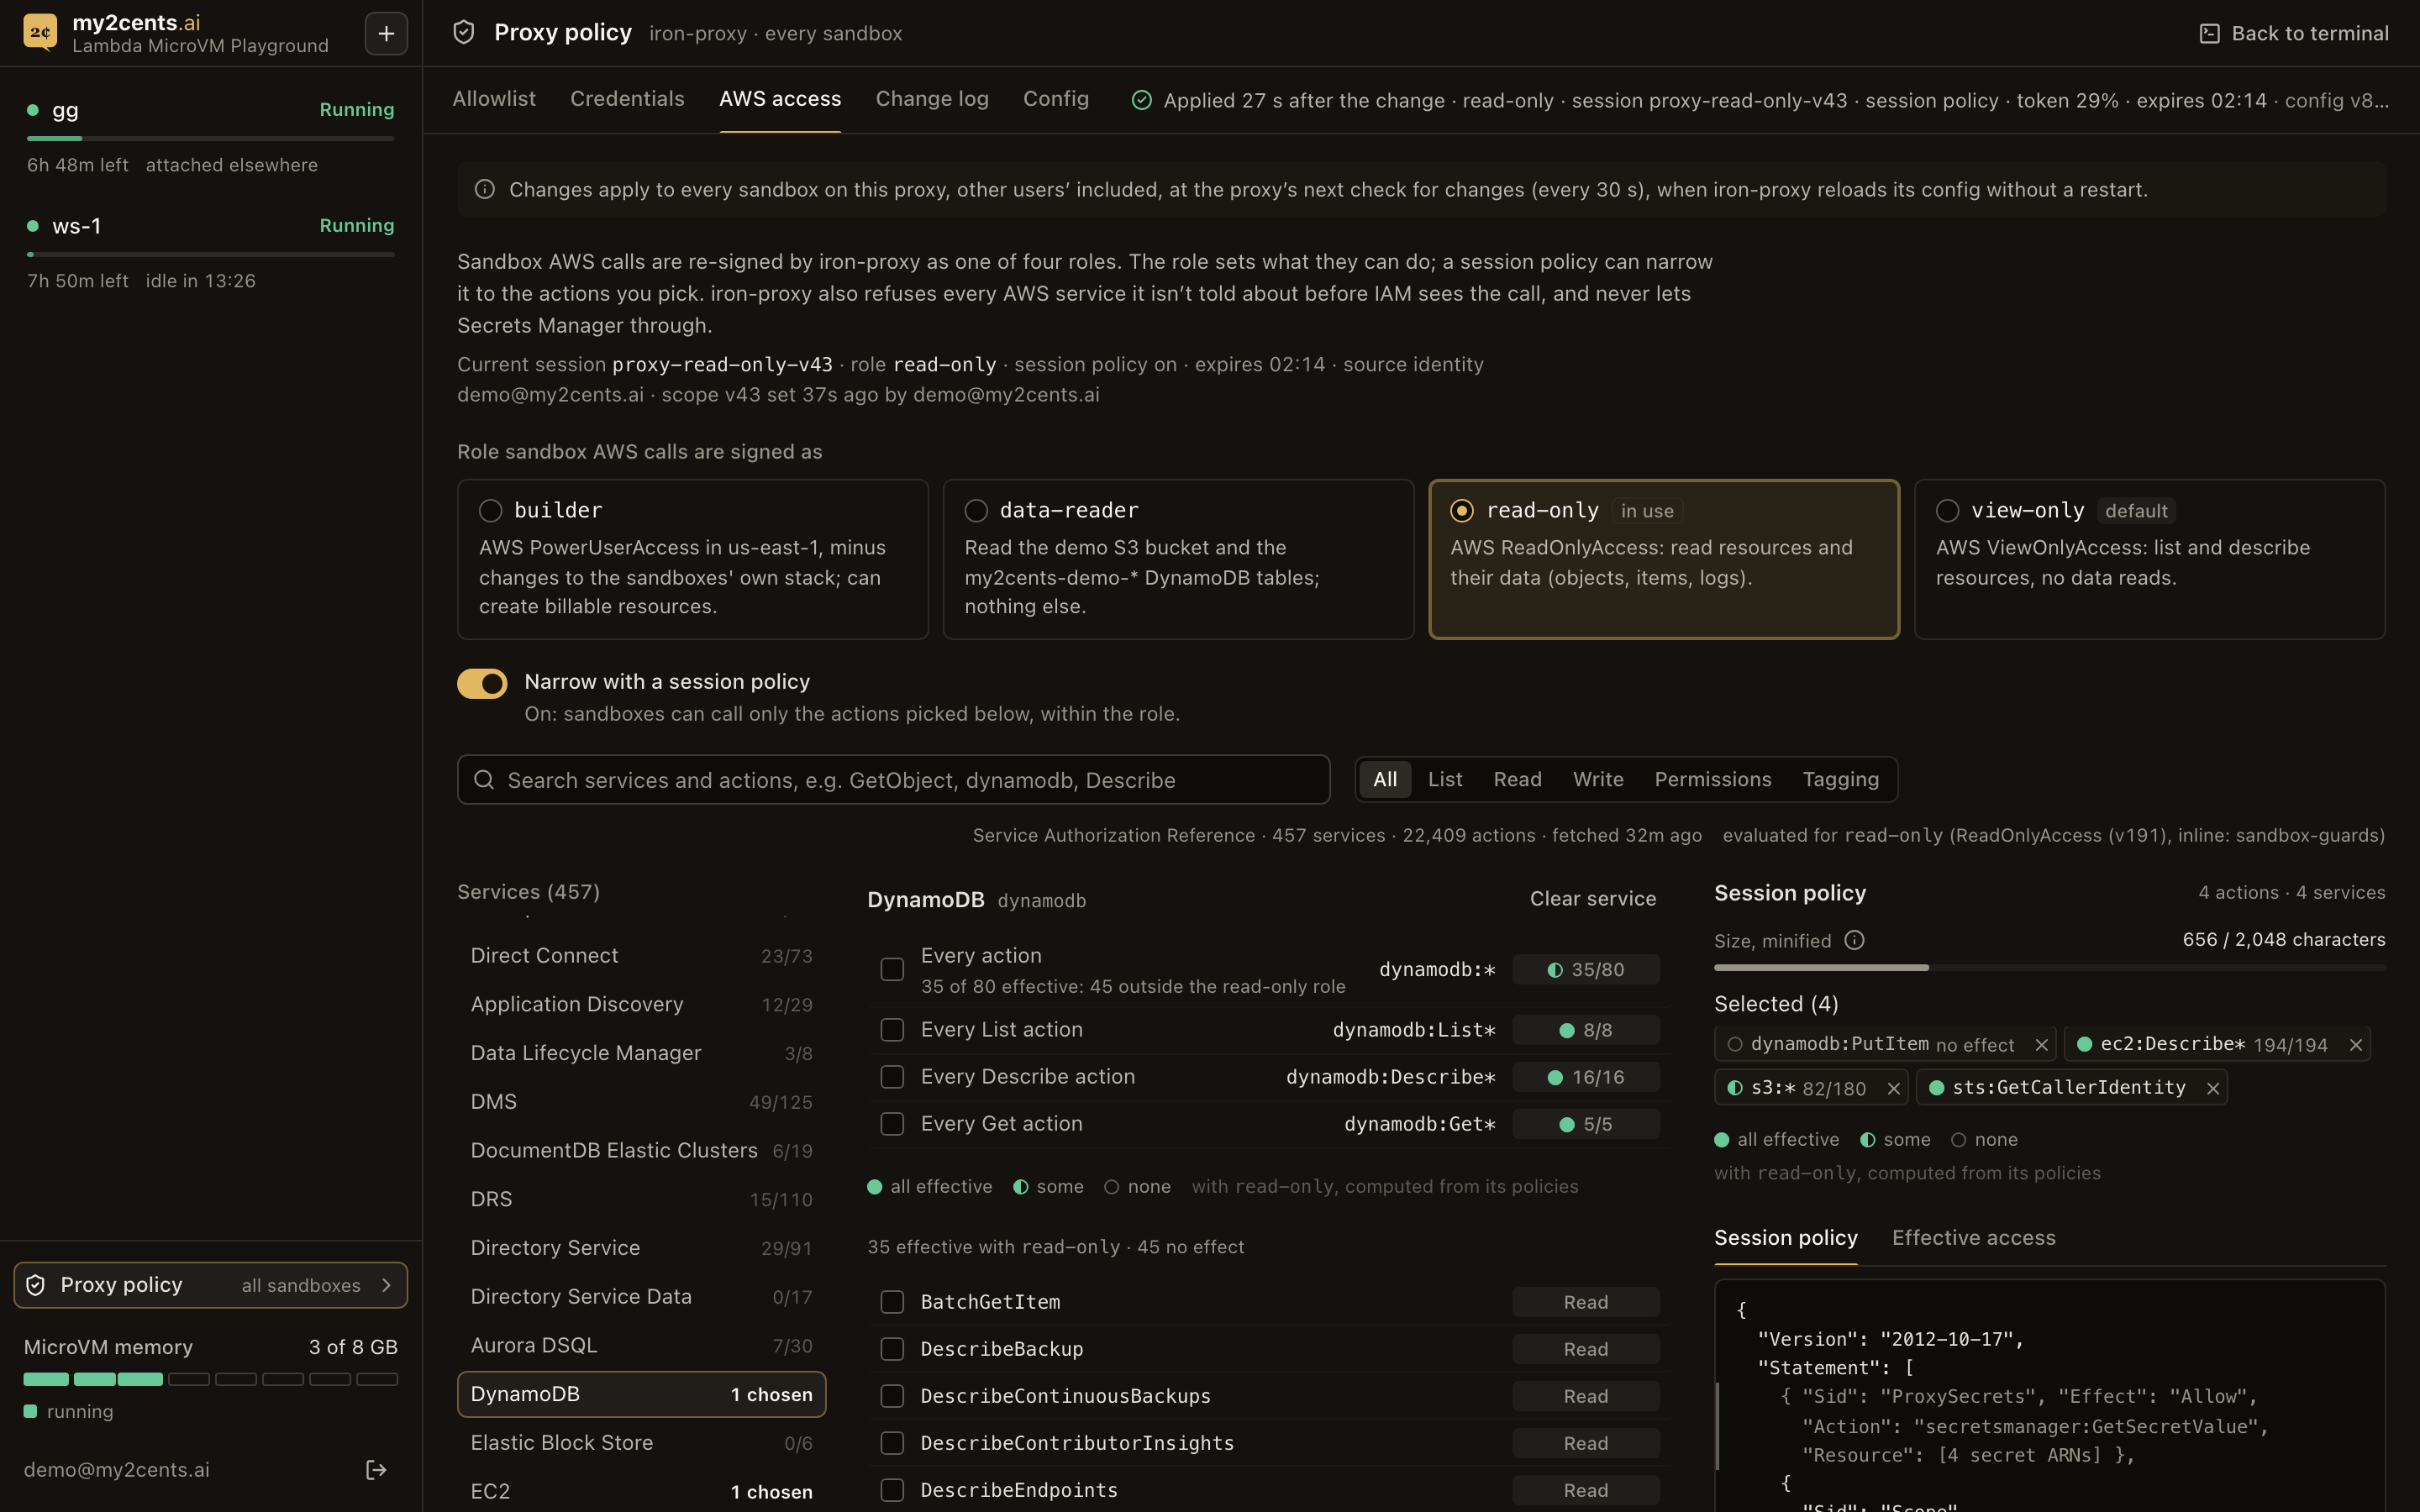
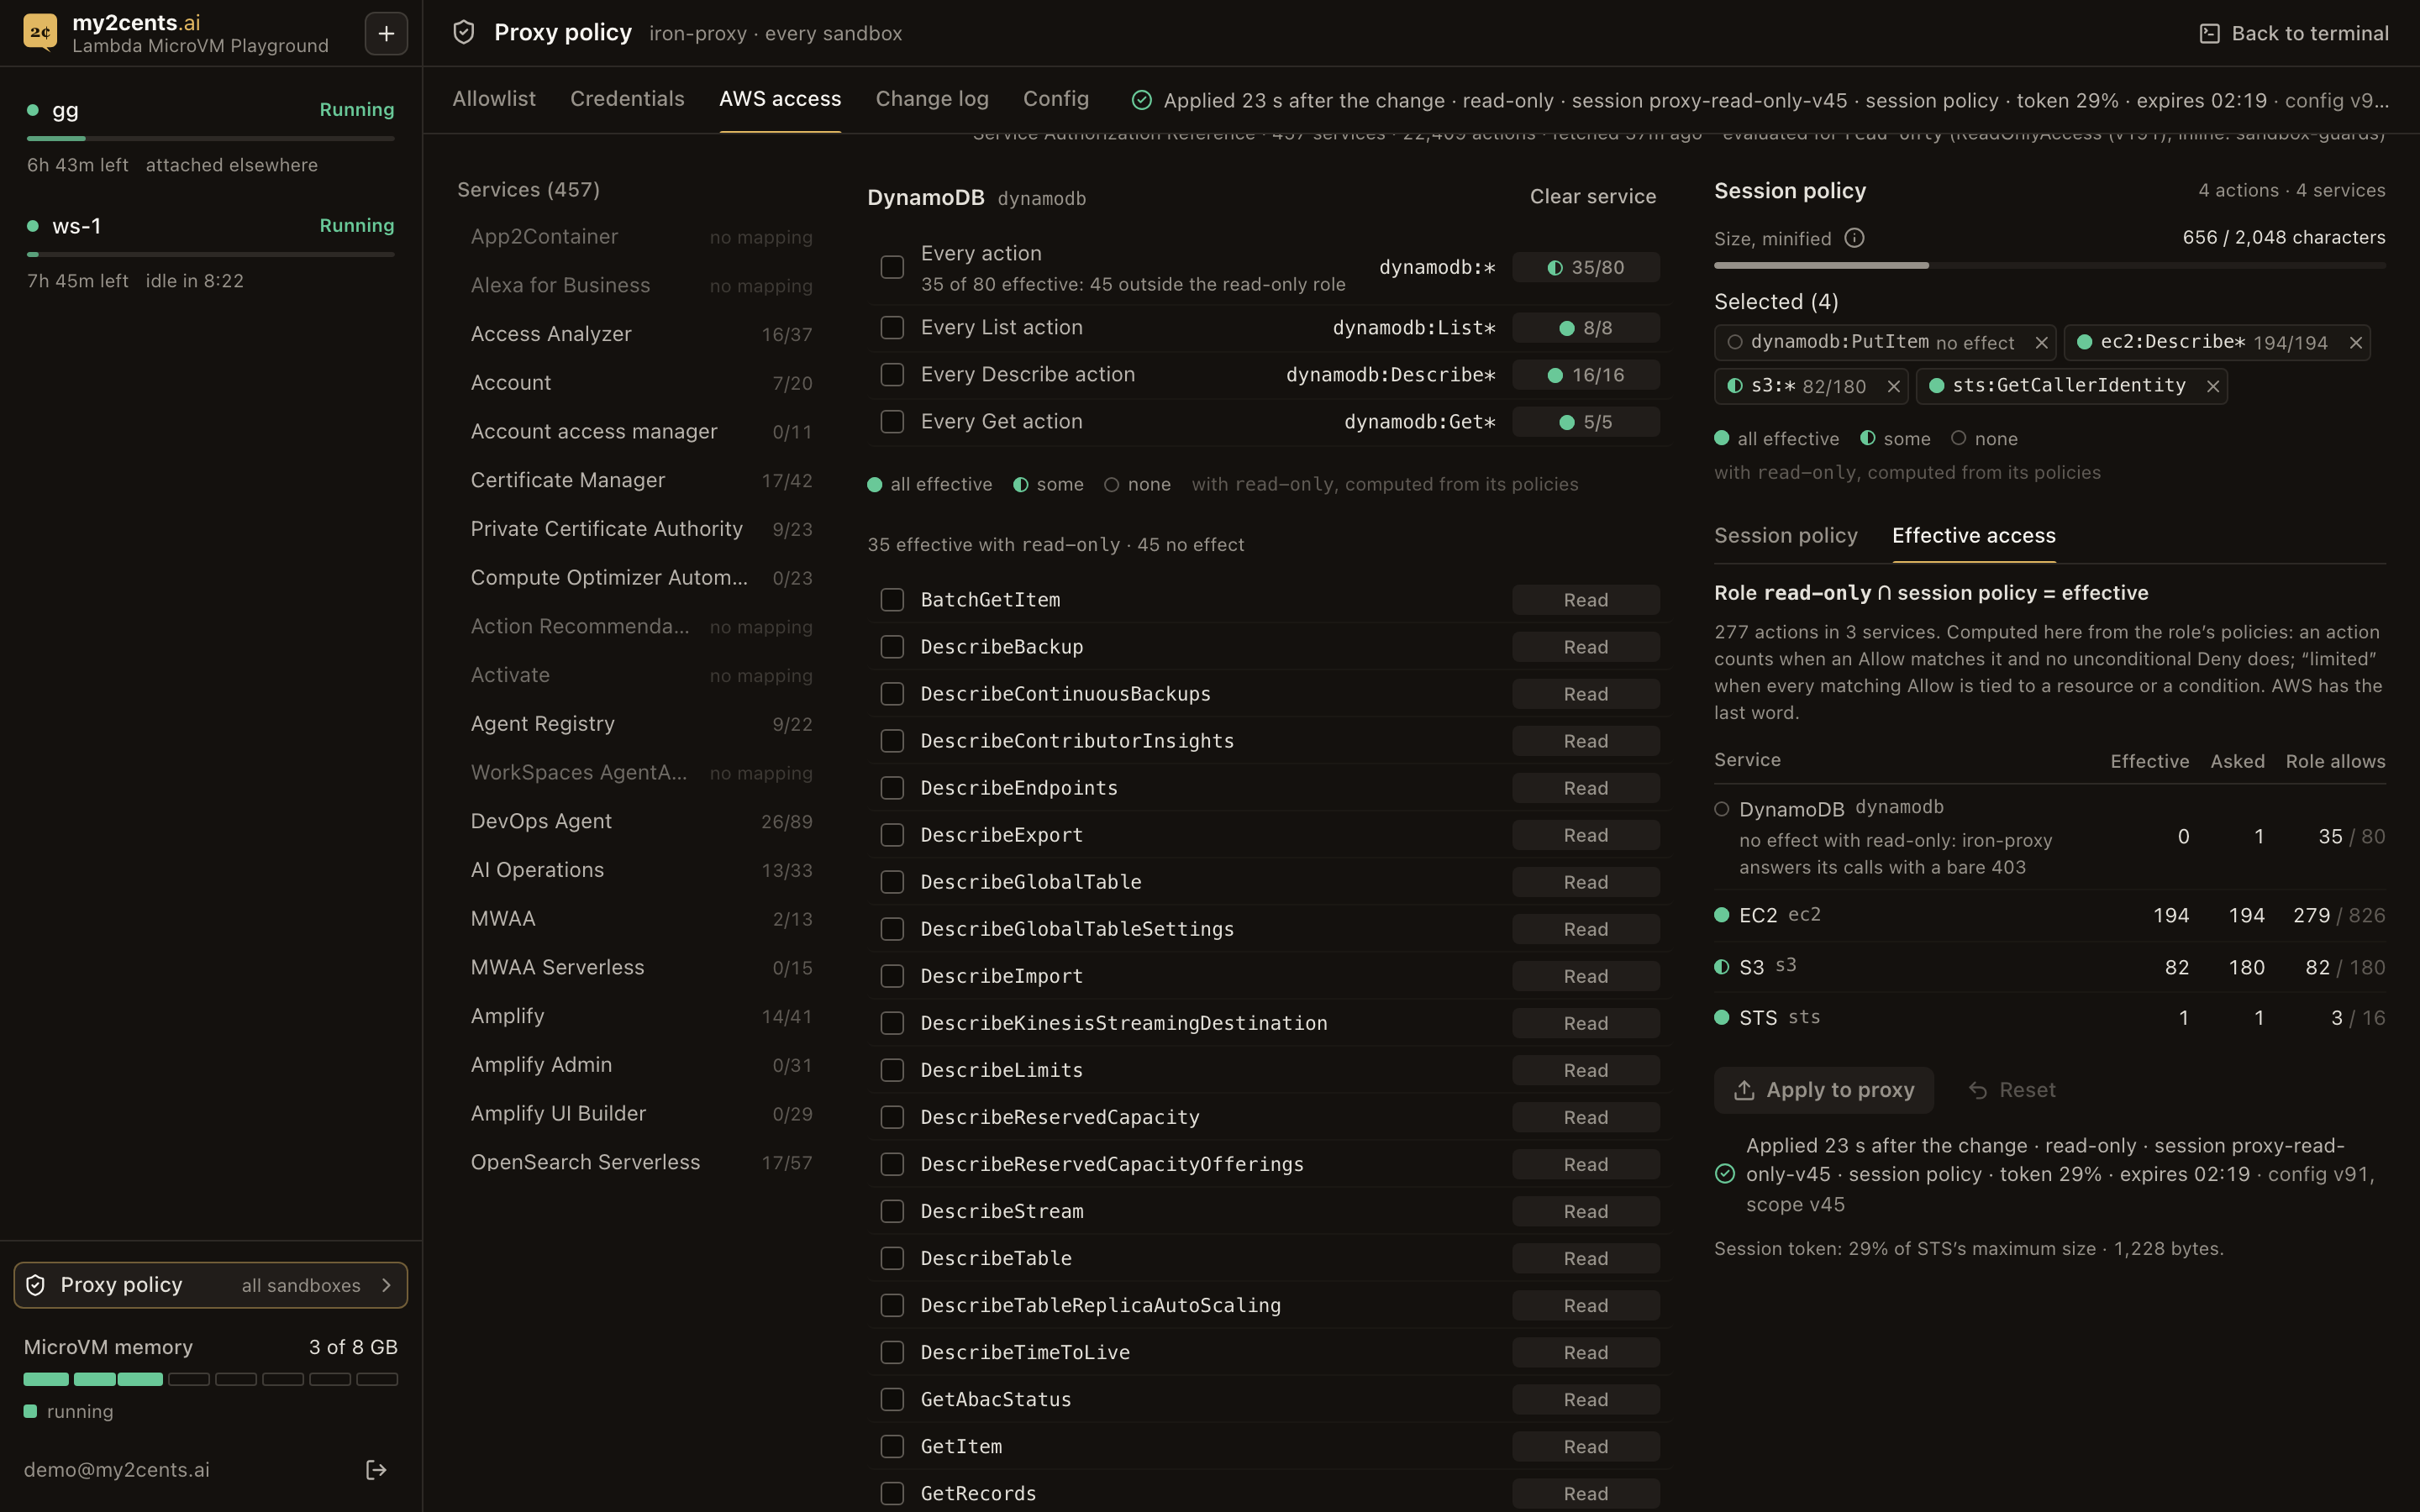
A seção AWS access escolhe uma das quatro roles (view-only por padrão) e, opcionalmente, uma session policy que a restringe. Esse é o objetivo da session policy: em vez de criar uma role para cada combinação de permissões de que um agente possa precisar, manter poucas roles e restringir uma ao necessário. Ela fica mais útil em uma próxima versão do playground, em que essas configurações são por sandbox, para que cada agente receba só o que a sua tarefa precisa. Com a session policy desligada, as chamadas dos sandboxes recebem as permissões completas da role. Com ela ligada, o sidecar envia as ações escolhidas, mais o statement de segredos do proxy, como session policy quando assume a role; quando uma seleção cobre ssm:GetParameter* (ssm:* ou ssm:Get*), a policy adiciona um Deny explícito sobre ela, para que nunca conceda valores de parâmetros.
As ações vêm da Service Authorization Reference da AWS em formato legível por máquina, os mesmos dados por trás da documentação do IAM, buscados pela API: 457 serviços e 22.367 ações, com busca no servidor e um filtro por nível de acesso. Os dados ficam em cache por uma hora; depois disso, a cópia antiga é servida enquanto uma atualização roda em segundo plano. A API lê as policies da role para calcular quanto vale cada seleção. Uma seleção fora da role não é recusada: ela é marcada como “no effect with” a role, para que uma policy possa ser montada antes de trocar de role, e uma seleção sobrevive à troca. Wildcards (s3:*, ou Get*, List* ou Describe* de um serviço) mostram “N of M effective” com um ponto cheio, meio cheio ou vazio, e uma aba Effective access lista, por serviço, o que a role e a session policy permitem juntas. O Secrets Manager não pode ser selecionado de jeito nenhum, e ssm:GetParameter* não pode ser selecionado sozinho. Um medidor de tamanho compara a session policy com o limite de 2.048 caracteres do STS antes de qualquer envio, e depois do Apply a linha de status mostra o que o STS informou para o novo token de sessão: para view-only sem session policy, 19 a 20% do tamanho máximo do STS (808 bytes em uma sessão). As quatro seleções da captura de tela, em read-only, somam 656 caracteres e um token em 29%.
No terminal de um sandbox, a chamada “quem sou eu?” da AWS CLI mostra o resultado:
$ aws sts get-caller-identity --query Arn --output text
arn:aws:sts::<acct>:assumed-role/my2cents-ip-view-only/proxy-view-only-v2
A AWS diz que quem chama é a role do sandbox, por meio de uma sessão chamada proxy-<role>-v<scope version>: aqui, proxy-view-only-v2 em my2cents-ip-view-only. Nos bastidores:
- A CLI assina com chaves falsas. Ela encontra
AWS_ACCESS_KEY_IDeAWS_SECRET_ACCESS_KEYno ambiente e assina o request (SigV4) com elas, sem saber que são placeholders. Não existe uma role para usar como alternativa: a MicroVM roda sem nenhuma, eAWS_EC2_METADATA_DISABLEDimpede a CLI de procurar. - Ela chega ao proxy sem ter pedido. O resolver do sandbox responde
sts.us-east-1.amazonaws.comcom o load balancer do proxy, como qualquer outro nome, então a CLI se conecta ao iron-proxy acreditando que é o STS. O iron-proxy responde ao handshake TLS com um certificado da CA da parte 2, em que a CLI confia por causa doAWS_CA_BUNDLE, e verifica o host contra a sua allowlist. - O iron-proxy assina novamente. O estágio
aws_authdele verifica o serviço (sts) e a região (us-east-1) contra o que a policy permite, descarta a assinatura feita com o placeholder e assina de novo com as credenciais que o sidecar deixou para ele: a sessão da role do sandbox. O sandbox não consegue alcançá-las. - O STS responde com a identidade de quem assinou. O nome da sessão diz qual role e qual versão da policy, e o CloudTrail adiciona o admin que aplicou a policy como
SourceIdentity, e o nome do sandbox pelo user agent: todo sandbox recebeAWS_SDK_UA_APP_ID=ws-<sandbox name>, que as CLIs e os SDKs da AWS acrescentam ao User-Agent e que o iron-proxy não altera. Esse último é um rótulo, não uma identidade: qualquer coisa dentro do sandbox pode mudar o próprio User-Agent, e em um proxy compartilhado ele é a única coisa que diz qual sandbox fez uma chamada.
AssumeRole  proxy-read-only-v3   role my2cents-ip-read-only  caller my2cents-ip-task  sourceIdentity demo@my2cents.ai  policy none    userAgent curl/8.21.0
08:10:53Z sts GetCallerIdentity  arn:aws:sts::<acct>:assumed-role/my2cents-ip-read-only/proxy-read-only-v3  sourceIdentity demo@my2cents.ai  app/ws-e2e-a
08:12:20Z s3 ListBuckets  AccessDenied  …/my2cents-ip-data-reader/proxy-data-reader-v7  app/ws-e2e-guards
08:11:08Z secretsmanager GetSecretValue  …/my2cents-ip-read-only/proxy-read-only-v4  aws-sdk-go-v2/1.45.1   (iron-proxy itself, same session)
No console do CloudTrail, os mesmos rótulos aparecem em um único registro de evento:
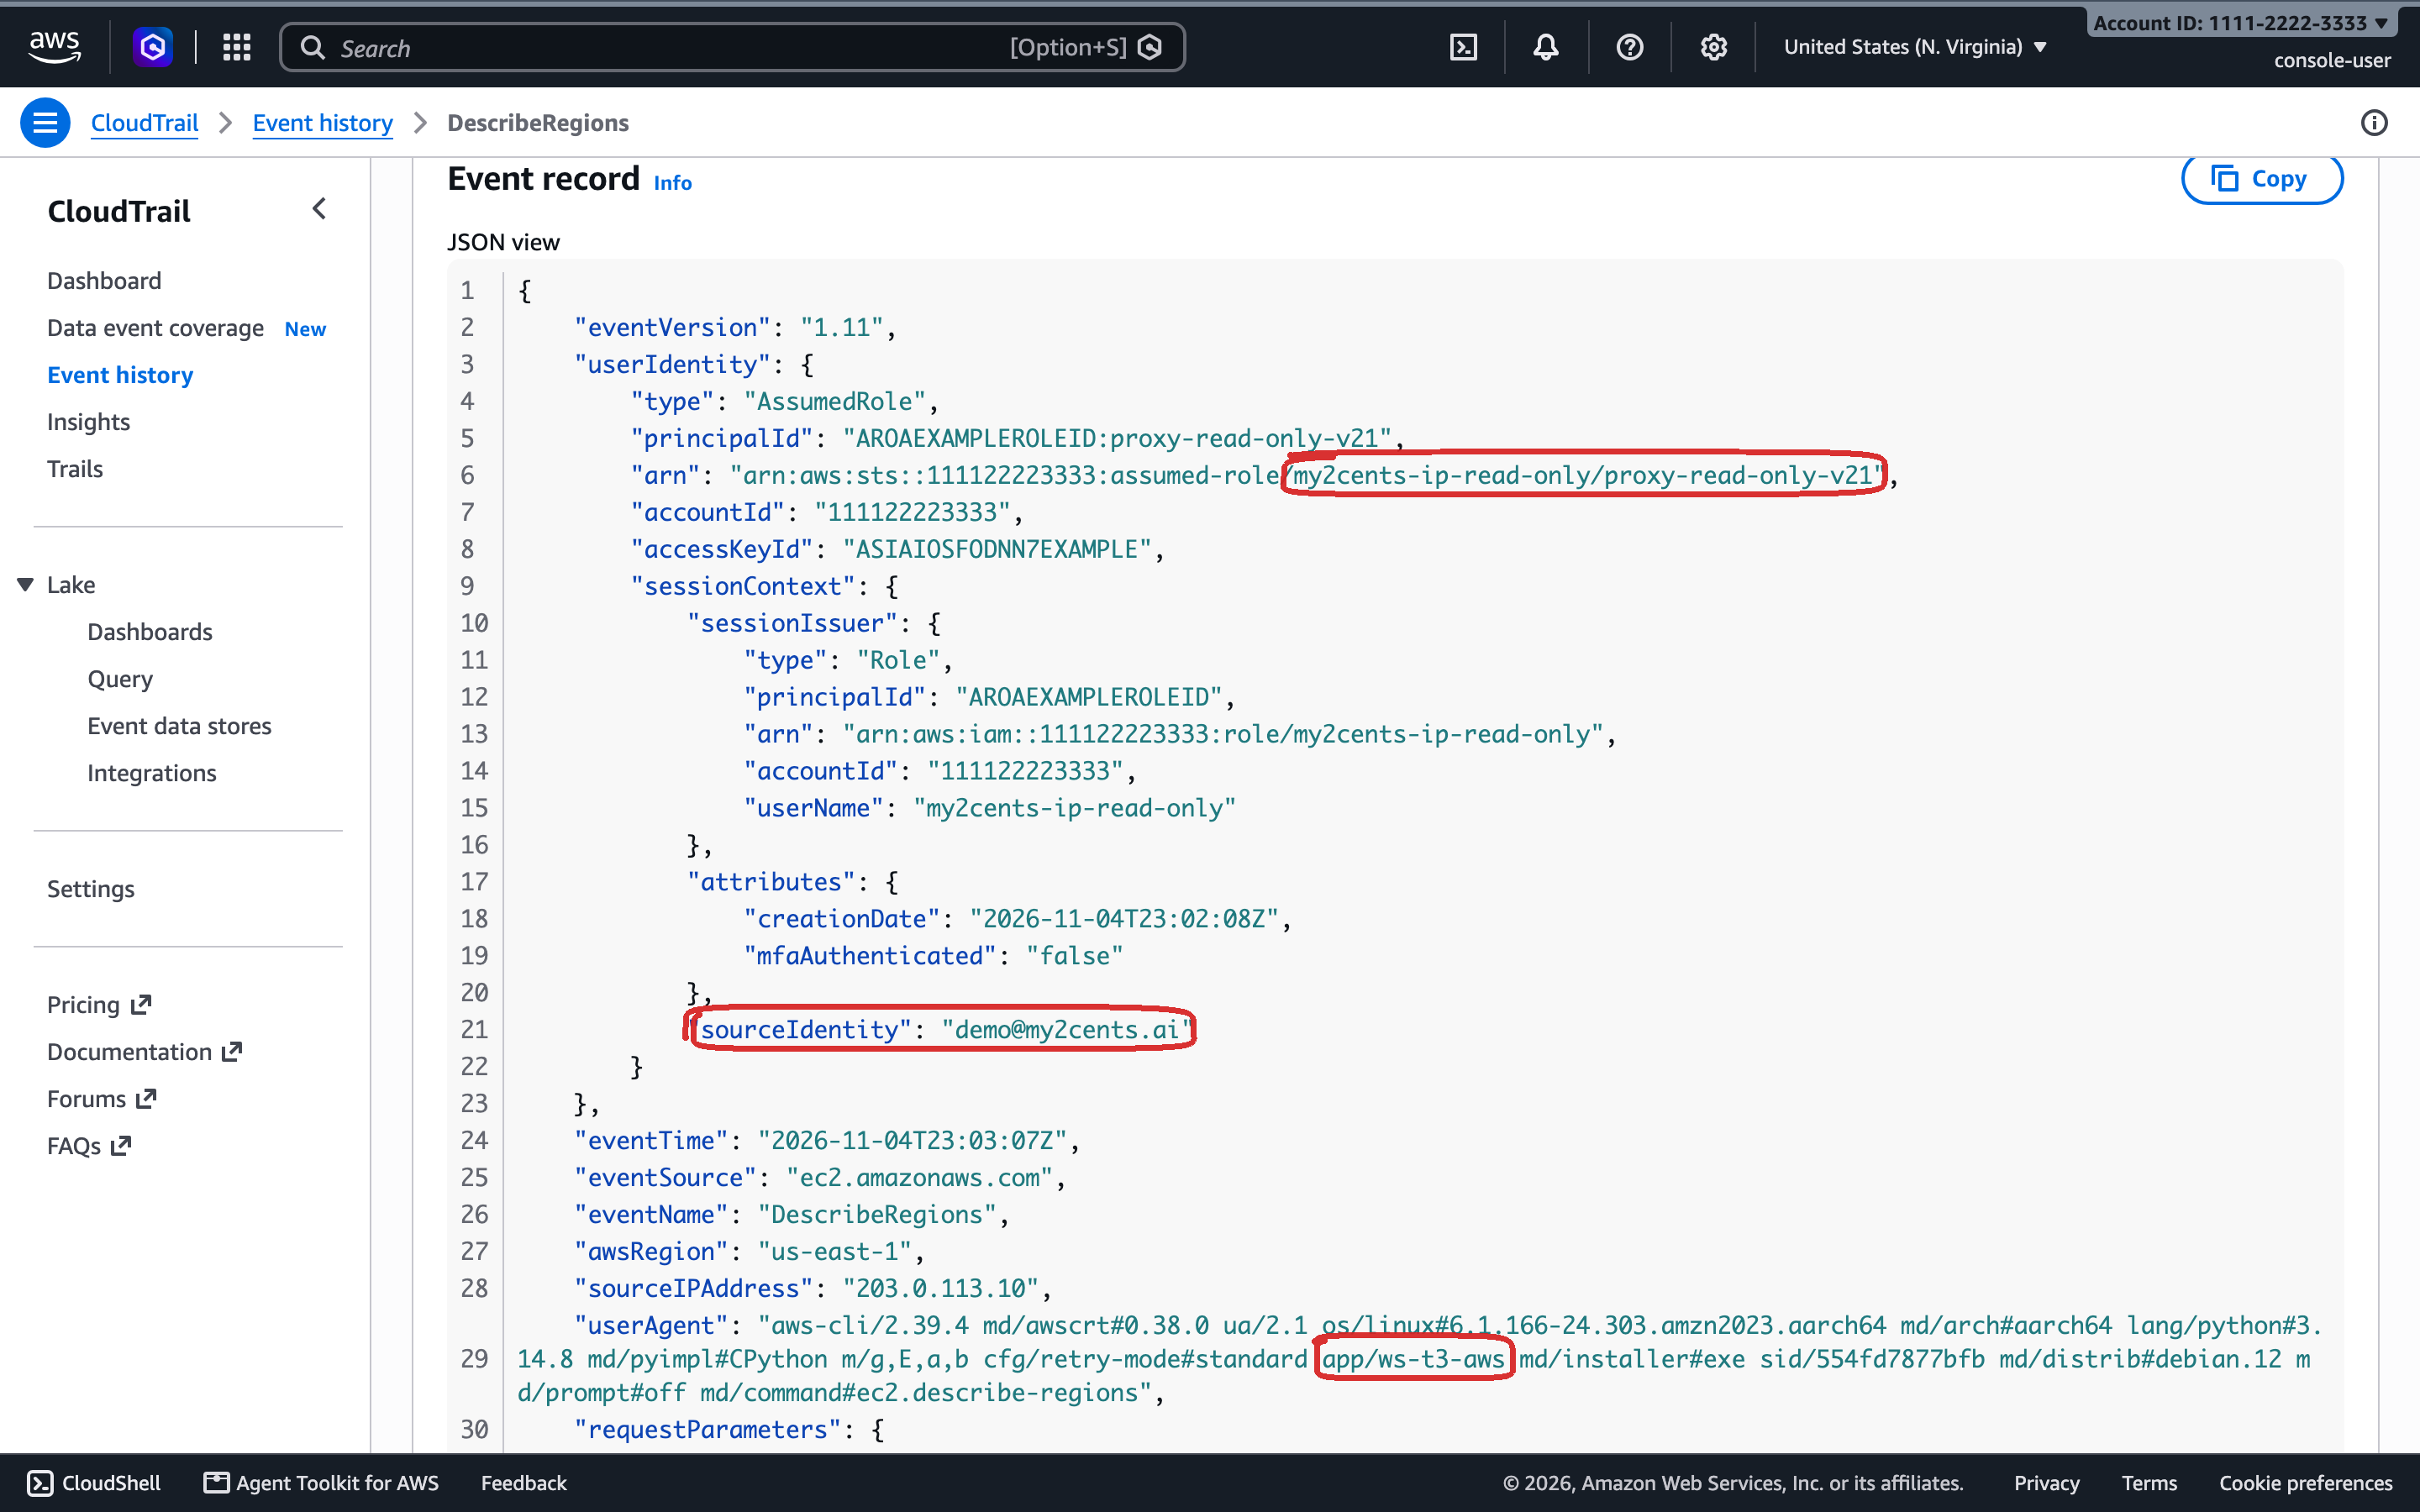
A última linha do trecho acima é o iron-proxy buscando um segredo que ele injeta, sob a mesma sessão das chamadas do sandbox. Uma troca de role chegou a um sandbox na próxima verificação do sidecar: uma troca para read-only foi aplicada 29,5 s depois da mudança e apareceu no get-caller-identity em 32,3 s, e outras três (para read-only, data-reader e builder) foram aplicadas entre 23,0 e 26,3 s e passaram a assinar como a nova role entre 24,4 e 28,9 s. O que cada role permitiu e recusou a partir de um sandbox:
| Role | Permitido | Recusado |
|---|---|---|
view-only | s3api list-buckets (16 buckets) | ler o objeto de demonstração, um scan no DynamoDB (AccessDenied) |
read-only | o objeto de demonstração (35 bytes), um scan de my2cents-demo-items (3 itens) | um parâmetro SecureString do SSM (AccessDenied: o deny explícito de todas as roles) |
data-reader | o objeto de demonstração, o mesmo scan | list-buckets (AccessDenied) |
builder | uma fila SQS e um bucket criados e deletados | os guardrails (Teste 14) |
O iron-proxy só fica sabendo dos serviços com pelo menos uma ação efetiva, então, quando a session policy deixa um serviço de fora, ou as seleções dele não têm efeito com a role, os endpoints do serviço saem da allowlist e a chamada é recusada pelo proxy antes de chegar à AWS. Quando o serviço é permitido mas a ação não, o request é assinado novamente e o IAM o recusa, citando a session policy. Os dois casos aparecem de forma diferente na CLI, e só o segundo aparece no CloudTrail. Com a session policy ligada apenas para STS e listagem do S3 (636 caracteres), a listagem do S3 funcionou 29,3 s depois da mudança (aplicada em 27,5 s), e uma chamada ao ECS, agora fora da policy, recebeu o primeiro tipo: um 403 puro do proxy.
Dois detalhes do S3 apareceram no caminho. O upload padrão da AWS CLI envia um corpo aws-chunked com um checksum no final, que o aws_auth do iron-proxy recusa com um 400, então o payload do run hook agora define AWS_REQUEST_CHECKSUM_CALCULATION=when_required, e os uploads funcionam. E o CopyObject recebe um 501 NotImplemented do S3 depois que o iron-proxy o assina novamente, qualquer que seja a configuração de checksum.
Teste 13: A proteção do Secrets Manager
Um detalhe do iron-proxy molda todo o design: a sessão que assina novamente as chamadas de um sandbox à AWS é a mesma que o iron-proxy usa para buscar os segredos que injeta. A versão 0.55.0 não tem como dar identidades diferentes às duas funções. Então todas as roles podem ler os segredos do próprio proxy, e a única coisa entre um sandbox e secretsmanager:GetSecretValue sobre eles é o próprio proxy. A proteção tem quatro partes:
- O sidecar recusa qualquer configuração que liste o Secrets Manager em
allowed_servicesou na allowlist, então uma gravação ruim nunca chega ao iron-proxy, e a linha de status do workspace mostraria o motivo. Essa verificação foi testada offline, 16 de 16 configurações na imagem do sidecar; nenhuma execução ao vivo produziu uma recusa. aws_auth.allowed_servicesnunca contémsecretsmanager, quaisquer que sejam a role e a policy. Ela também nunca fica vazia, porque o iron-proxy 0.55.0 interpreta uma lista vazia como todos os serviços; com a session policy desligada, o backend grava uma lista explícita: os serviços em que a role permite pelo menos uma ação, menos o Secrets Manager.- Nenhum endpoint do Secrets Manager entra na allowlist: o editor da allowlist os recusa, e a seção AWS access nunca os adiciona.
- As roles negam todas as outras ações e segredos do Secrets Manager, e
ssm:GetParameter*.
Eu testei isso a partir de um sandbox, com o proxy assinando como builder, a role mais ampla: um aws secretsmanager get-secret-value simples e requests forjados. A falsificação vai para secretsmanager.us-east-1.amazonaws.com, mas é assinada com um credential scope que declara outro serviço, como s3. O iron-proxy 0.55.0 pega o serviço do credential scope do cliente, então ela verifica se um sandbox consegue convencer o proxy a assinar novamente uma chamada ao Secrets Manager como um serviço que allowed_services permite. Ela não deveria chegar tão longe, já que nenhum host do Secrets Manager está na allowlist; e, se chegasse, o request seria assinado novamente para o serviço errado e a AWS rejeitaria a assinatura.
| Request a partir do sandbox | Resposta | Recusado por |
|---|---|---|
aws secretsmanager get-secret-value | CLI: An error occurred (403) | allowlist |
o endpoint do Secrets Manager, assinado para secretsmanager | 403, corpo vazio | allowlist |
| o endpoint do Secrets Manager, assinado com um credential scope s3 | 403 | allowlist |
sts.us-east-1.amazonaws.com (permitido), assinado para secretsmanager, target secretsmanager.GetSecretValue | 403, service_not_allowed | aws_auth |
STS, assinado como sts, target secretsmanager.GetSecretValue | assinado novamente; o STS respondeu 302 para aws.amazon.com, que a allowlist recusou | nada a recusar: o STS não atende essa ação |
Host secretsmanager… em uma conexão TLS para sts… | 400 SNI and Host header mismatch | iron-proxy |
Nenhuma resposta continha um segredo. Todo request ao endpoint do Secrets Manager parou na allowlist, independentemente do que o credential scope declarava, então o scope s3 forjado nunca chegou ao aws_auth. Um scope forjado apontado para um host permitido chegou até o aws_auth, que recusou o serviço. Nenhum deles chegou longe o suficiente para testar os denies do IAM por trás disso.
Teste 14: Os guardrails da role builder
A builder é PowerUserAccess, que pode fazer quase tudo, exceto gerenciar IAM e Organizations, então a role carrega Denies explícitos. Eles a mantêm em us-east-1 (inclusive para buckets S3 criados em outra região pelo endpoint de us-east-1, que a verificação de s3:LocationConstraint pega) e a impedem de assumir outras roles. E eles a mantêm longe desta stack e da stack da parte 2: os buckets, o cluster e os serviços do ECS, as duas VPCs, os load balancers, o connector, as MicroVMs, as tabelas, as imagens, os logs, as zonas privadas, o alarme do DNS Firewall, o CloudFront, o Cognito e o Route 53 Resolver. Zonas privadas também não podem ser associadas a nenhuma VPC. O DNS Firewall filtra nomes de zonas privadas também, então uma zona na VPC do sandbox não passaria do override, mas uma zona que se sobreponha a sandbox.internal poderia redirecionar o destino do override, e uma associada à VPC do proxy poderia mudar os endereços aos quais o iron-proxy se conecta para um host da allowlist. Eu testei alguns deles a partir de um sandbox, com o proxy assinando como builder:
A partir de um sandbox como builder |
Resultado |
|---|---|
| criar e deletar uma fila SQS; criar um bucket em us-east-1, fazer upload nele, deletá-lo | permitido |
| um security group na VPC do sandbox | AccessDenied (UnauthorizedOperation) |
um registro na zona sandbox.internal; a associação do DNS Firewall | AccessDenied |
| deletar do bucket de controle ou fazer upload nele | AccessDenied |
| um bucket em eu-west-1 pelo endpoint de us-east-1 | AccessDenied |
| os atributos do NLB da parte 2; o serviço ECS do iron-proxy | AccessDenied |
| a retenção do log group da API | AccessDenied |
sts:AssumeRole | AccessDenied |
| SQS em us-west-2 | 403 da allowlist do iron-proxy, antes do IAM |
O IAM recusou todas as mudanças na stack, e o CloudTrail registrou cada uma com o seu código de erro. Outra região nunca chegou ao IAM, porque a allowlist só contém endpoints de us-east-1. Os guardrails protegem a stack, não o resto da conta. A builder ainda pode criar recursos que geram cobrança em us-east-1 e alterar a maior parte do que existe lá e não seja este workspace ou a parte 2; CloudFront, Cognito, Route 53 Resolver e network connectors ficam fora de alcance em qualquer lugar, já que os ARNs deles não trazem um nome utilizável. Em um proxy compartilhado, escolher essa role dá esse alcance a todos os sandboxes em execução de uma vez, e é por isso que gravações de policy exigem o grupo admins.
Preços
O workspace adiciona um pouco de infraestrutura fixa sobre a camada de proxy da parte 2 (preços de tabela em us-east-1):
| Recurso | Por hora |
|---|---|
| Application Load Balancer (capacity units à parte) | US$ 0,0225 |
| Dois endereços IPv4 públicos para o ALB | US$ 0,010 |
| Task da API no Fargate (ARM, 0,5 vCPU / 1 GB) | US$ 0,0198 |
| Workspace, fixo | ≈ US$ 0,052 |
| Parte 2, fixo (NAT gateway, NLB, iron-proxy, IPv4 público, segredos, zona privada), com o control plane | ≈ US$ 0,096 |
| Ambos, sem nenhum sandbox rodando | ≈ US$ 0,15 (≈ US$ 3,60 por dia) |
| Cada sandbox rodando (preços da parte 1): Small 1 GB / Medium 2 GB / Large 4 GB / X-Large 8 GB | ≈ US$ 0,063 / US$ 0,126 / US$ 0,252 / US$ 0,504 |
| Ambos, com 8 GB de sandboxes rodando (qualquer combinação de tamanhos) | ≈ US$ 0,65 |
O control plane responde por cerca de US$ 0,95 por mês da linha da parte 2: os requests do sidecar ao S3 (GETs condicionais e uma gravação de status a cada 30 s) e o segredo do token de gerenciamento (US$ 0,40). O sidecar cabe na task já existente do iron-proxy, então o custo de computação não muda. Por uso, além disso: CloudFront, S3, DynamoDB, Cognito, ECR, ingestão de logs, dados do NAT, DNS Firewall a US$ 0,60 por milhão de consultas e capacity units do load balancer, que somam centavos para uma demo.
Um item é fácil de errar: o CloudWatch Logs Live Tail é cobrado por minuto de sessão (US$ 0,01 por minuto, ou seja, US$ 0,60 por hora, depois de 1.800 minutos gratuitos por mês). A primeira versão da API mantinha um tail aberto 24 horas por dia, o que teria custado cerca de US$ 14 por dia, mais do que todo o resto aqui somado. Agora ela roda uma sessão apenas enquanto um navegador mostra o painel Proxy ou DNS em uma página visível, e a encerra 60 segundos depois que o último fecha, preenchendo até 10 minutos a partir dos log groups quando um painel é reaberto. Uma aba deixada em um desses painéis ainda custa US$ 0,60 por hora depois que os minutos gratuitos acabam.
Limpeza
O workspace é construído sobre a parte 2, então desmonte tudo nesta ordem:
- O workspace:
bash scripts/destroy.sha partir do diretório dele. Oscripts/destroy.shencerra todas as MicroVMs iniciadas a partir das quatro imagens do workspace, força a exclusão das credenciais que os admins adicionaram sob o prefixomy2cents-ip/user/da parte 2 (para que os nomes possam ser reutilizados imediatamente), rodaterraform destroynos recursos do próprio workspace (CloudFront, o ALB, o serviço da API, Cognito, DynamoDB, ECR e o log group da API) e deleta as quatro imagens de sandbox. - Os sandboxes da parte 2:
python 13_cleanup.pya partir do diretório da parte 2. O13_cleanup.pyencerra as MicroVMs da própria parte 2 e deleta a imagem de sandbox dela, que de outra forma continua gerando cobrança de armazenamento de snapshot, e o log group de build dela. - Parte 2:
scripts/destroy.sh, também a partir do diretório da parte 2. Ele se recusa a rodar enquanto houver qualquer serviço além do iron-proxy no cluster ECS, o que acontece até o passo 1 remover a API do workspace. Depois, ele desliga a proteção contra mutação da associação do DNS Firewall, rodaterraform destroye, com o control plane ligado, força a exclusão de qualquer credencial que tenha sobrado sobmy2cents-ip/user/.
O que o workspace usa da parte 2, e por que a parte 2 sai por último:
- a VPC do sandbox e o seu connector de egress, sobre os quais todo sandbox roda;
- o iron-proxy, o load balancer dele, o override do DNS Firewall e a zona privada, por onde passam o tráfego e as consultas de todo sandbox;
- o bucket de controle e o sidecar (
control_plane=true), que a página Proxy policy edita; - as quatro roles com que as chamadas dos sandboxes à AWS são assinadas;
- os segredos injetados e a CA, em que as imagens de sandbox confiam;
- o cluster ECS, em que a API do workspace roda.
Remover só o workspace deixa a parte 2 rodando e gerando cobrança: cerca de US$ 0,096 por hora pelo NAT gateway, load balancer, task do iron-proxy, IP público, segredos, zona privada e control plane, mais o armazenamento de snapshot da imagem de sandbox dela até o passo 2 deletá-la.
Veredito
As Lambda MicroVMs são uma boa base para este tipo de workspace, e o motivo é a suspensão. Um sandbox inicia em segundos, o Claude Code fica pronto um ou dois segundos depois, e um sandbox suspenso volta para a mesma tela do Claude Code em cerca de um segundo. Combinado com o tmux, isso transforma “fechar a aba” de uma decisão em algo sem importância. O proxy da parte 2 manteve todas as credenciais reais fora dos sandboxes, e os painéis tornaram isso visível, em vez de algo em que você precisa acreditar.
O control plane mudou a função do proxy. Com a configuração no S3 e as mudanças aplicadas por reload, um admin pode liberar um host, adicionar uma credencial, revogar uma ou trocar a role da AWS a partir de um navegador, e o proxy assume a mudança em cerca de 30 s, sem o reinício de dois minutos. Nada disso exigiu mudança no iron-proxy. O que ele ainda não consegue fazer é distinguir os sandboxes: um proxy significa uma policy e um log para todo mundo.
A maior parte do trabalho foi em volta da plataforma, e não nela. Não existe uma API de exec, e os tokens de uma MicroVM dão acesso root no sandbox, então a API faz a ponte de todo terminal em vez de entregar tokens aos navegadores. Requests ao /validate são derrubados em algum ponto antes dos 12 segundos, então o warm-up roda em segundo plano. O /etc/resolv.conf é somente leitura, o que colocou os truques de DNS na VPC e não na VM. E a detecção de ociosidade só conta tráfego de entrada, o que definiu as estatísticas ao vivo, a conexão do terminal e o que o app faz quando você o abre.
O que funciona
- Velocidade. Segundos do Create até um terminal conectado, 1,3 a 1,7 s até um prompt do Claude Code na primeira versão, e cerca de um segundo para voltar à mesma tela depois de uma retomada, medidos através do CloudFront.
- Continuidade. Suspensão, suspensão por ociosidade e fechamento da aba sempre voltaram para a mesma sessão tmux e a mesma tela do Claude Code.
- Visibilidade. Todo request que passa pelo proxy, toda troca de credencial e todo host negado, e o log de DNS da VPC do sandbox, na tela, além dos tokens e do custo estimado do Claude Code por sessão.
- Uma policy que você pode mudar com os sandboxes rodando. Allowlist, credenciais e acesso à AWS aplicados por reload em cerca de 30 s, com um log de mudanças, um status “Applied” vindo do sidecar do proxy e uma aba Config que mostra o que está armazenado versus o que foi aplicado.
- Acesso à AWS com nome e sobrenome. Poucas roles escolhidas por um admin, restringidas com uma session policy opcional montada a partir do próprio catálogo da AWS, em vez de uma role para cada combinação, e registros do CloudTrail que nomeiam a role, a versão da policy, o admin e, como rótulo, o sandbox.
- Sem prompts, sem chaves. O Claude Code inicia direto no seu prompt em bypass mode, e as únicas chaves na VM são placeholders.
O que não funciona
- Proxy compartilhado, visão compartilhada, policy compartilhada. O feed do proxy, os contadores de credenciais e o painel de DNS cobrem todos os sandboxes, e toda mudança de policy, revogação e troca de role se aplica a todos eles. Identidade por sandbox no proxy é trabalho futuro.
- Observar custa dinheiro. Terminais conectados e as suas estatísticas ao vivo mantêm um sandbox acordado, e o Live Tail é cobrado por minuto enquanto um painel de feed está aberto.
- A role builder alcança a conta. Os guardrails dela protegem esta stack, não todo o resto em us-east-1, e ela pode criar recursos que geram cobrança.
- Acesso de leitura não é inofensivo.
ReadOnlyAccesspode expor segredos que ficam em configuração (variáveis de ambiente do Lambda, task definitions do ECS, user data do EC2); a proteção cobre o Secrets Manager e os parâmetros do SSM, não esses. - Uma identidade para duas funções. A sessão que assina as chamadas dos sandboxes à AWS também pode ler os segredos injetados; só as regras do próprio proxy mantêm o Secrets Manager fora de alcance.
- Pequeno por padrão. A cota de memória de MicroVM da minha conta é de 8 GB, e ela varia por conta: quatro sandboxes Medium, ou um X-Large.
- Bypass permissions. Adequado para um sandbox cercado com chaves placeholder; ainda assim, é um agente que nunca pergunta antes de agir.
Quem deve usar
Um desenvolvedor ou um time pequeno que queira o Claude Code em um navegador, rodando na própria conta AWS, com as credenciais mantidas fora do sandbox, uma visão do que o agente toca e uma policy que possa ser alterada sem novo deploy. É uma implementação de referência de um playground self-service, não um produto: uma versão multi-tenant precisa de identidade por sandbox no proxy, para que policy, logs e acesso à AWS possam pertencer a um único sandbox, e de uma cota maior. É também aí que a session policy se paga: configurações por sandbox permitiriam que cada agente recebesse só o que a sua tarefa precisa.