Google AX no Amazon EKS: Stress Test em Dois Nodes
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Container Insights, só métricas
- Passo 2: Um sampler para a visão detalhada
- Passo 3: Começar cada teste do zero
- Testes
- Teste 1: Teto de densidade
- Teste 2: Latência sob concorrência
- Teste 3: Wake on request, e por que os limites de CPU importam
- Teste 4: Carga no control plane
- Teste 5: Noisy neighbors
- Teste 6: Tempestade de snapshots
- O que o CloudWatch viu
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
Explica (TLDR) como se eu fosse...
Imagina uma prateleira de brinquedos com espaço para muitos robôs ajudantes. Eu fui colocando robozinhos até a prateleira dizer "não cabe mais", e couberam uns cento e cinquenta, desde que cada robô pedisse só um pouquinho de energia.
A surpresa foi que os robôs com pouquinha energia acordam devagar da soneca, enquanto os robôs com mais energia acordam quase na hora. E quando um robô sai correndo feito doido, os vizinhos dele ficam mais lentos também.
Esta é uma avaliação de capacidade e performance de um runtime de agentes self-hosted, com um orçamento fixo e deliberadamente pequeno de duas máquinas. As conclusões relevantes para planejamento são o teto rígido de sandboxes simultâneos, a latência que um usuário final perceberia e os custos operacionais que crescem com o uso.
Duas exposições de custo se destacam: os uploads de snapshots saem da rede por um gateway tarifado, a menos que um endpoint gratuito de storage seja configurado, e o add-on de monitoramento cobra por observação enquanto está ligado. Nenhuma das duas fica visível até a fatura chegar.
Eu fiz um stress test do sistema em seis eixos, cada um com uma carga controlada e resultados medidos: capacidade, latência sob concorrência, tempo de wake, carga no control plane, interferência entre vizinhos e bursts de storage. Os resultados vêm de execuções únicas em dois nodes, então trate-os como uma linha de base, não como um estudo populacional.
Principais achados: a capacidade é definida pelas reservas de CPU, não pela memória; limites de CPU muito pequenos deixam o wake vinte vezes mais lento; e vizinhos que consomem muita CPU deixaram outros sandboxes cerca de setenta por cento mais lentos, apesar dos limites.
Testes de carga costumam expor a distância entre o que esperávamos que um sistema fizesse e o que ele realmente faz, e essa distância pode parecer uma decepção. Aqui, na maior parte, foi tranquilizador: nada caiu, e os limites foram fáceis de nomear.
A conversa mais difícil é sobre os trade-offs: colocar mais sandboxes significa que cada um acorda mais devagar, e os vizinhos afetam uns aos outros mais do que os limites sugerem. Essas são escolhas que um time deve fazer junto, com os números na frente.
Pense em duas salas de ensaio pequenas e quantos músicos couberem. As salas comportaram uns cento e cinquenta, mas cada um afinava devagar quando mal tinha espaço para respirar, enquanto um músico com espaço ficava pronto em um décimo de segundo.
Coloque um baterista que nunca para na sala ao lado e o tempo de todo mundo escorrega uns setenta por cento, com parede ou sem parede. O diretor de palco, o control plane, nem suou.
A manchete: dois nodes modestos comportaram cerca de cento e cinquenta sandboxes de agentes ociosos, acordaram um sandbox suspenso em cerca de um décimo de segundo com uma CPU inteira, e o control plane ficou em torno de meio core no pico.
O posicionamento honesto é "denso para ociosos, rápido para acordados, planeje para os vizinhos". É uma história forte para times de plataforma dimensionando uma frota de agentes, desde que definam os limites de CPU de forma deliberada e adicionem um endpoint S3 gratuito antes que os snapshots comecem a fluir.
 Veja o código-fonte aqui: google-ax-stress
Visão Geral
Os números do Google para o Agent Substrate, o runtime por baixo do Google AX, são grandes: o post de lançamento no GKE promete resume abaixo de 500 ms, mais de 500 ativações de suspend/resume por segundo e mais de 1.000 agentes dormentes por host. Nenhum deles vem acompanhado de hardware, tamanho do agente ou método, e o repository tem os cenários de benchmark, mas nenhum resultado. O único teste independente que encontrei, um teste de campo em dois nodes GKE c3-standard-4, mediu resume de 220 ms para agentes de poucos megabytes e 3,5 s com 1 GiB. O próprio PR #1934 do upstream relatou wake de 1,3 a 1,4 s em um cluster de dois nodes.
Então eu medi os meus, nesta última parte da série, no mesmo cluster: dois nodes m7i.xlarge no Amazon EKS 1.37, AX a496fc1, Substrate d3f2363. É o cluster da parte 1, sem alterações, e o orçamento ao qual me ative: nenhum node extra. Seis testes, cada um forçando uma dimensão: densidade, latência sob concorrência, wake on request, carga no control plane, noisy neighbors e uma tempestade de snapshots. Todos os gráficos abaixo são gerados a partir dessas execuções pelo código complementar.
Como ler os números: a menos que um teste diga o contrário, as latências são cronometradas a partir do meu laptop pela CLI ax, então incluem o round trip até o cluster, do jeito que um usuário do AX as percebe. Os tempos de wake-on-request são medidos dentro do cluster com curl. Cada teste rodou uma vez, em um cluster que de resto estava vazio.
Arquitetura
Configuração
Passo 1: Container Insights, só métricas
O Terraform do post de instalação tem uma variável opcional container_insights que adiciona o add-on Amazon CloudWatch Observability. Eu desliguei os container logs e o Application Signals (ambos cobrados à parte) e defini preserve = false, porque, caso contrário, o módulo EKS deixa o agente rodando depois que você o remove do mapa de add-ons:
amazon-cloudwatch-observability = {
  configuration_values = jsonencode({
    containerLogs = { enabled = false }
    manager       = { applicationSignals = { autoMonitor = { monitorAllServices = false } } }
  })
  pod_identity_association = [{ role_arn = aws_iam_role.cloudwatch[0].arn, service_account = "cloudwatch-agent" }]
  preserve = false
}
O 01_metrics.py aplica isso e registra o início da janela de teste:
== terraform apply -var container_insights=true
  Creation complete after 47s [id=ax-eks:amazon-cloudwatch-observability]
  Apply complete! Resources: 3 added, 0 changed, 0 destroyed.
== the agent: one pod per node
cloudwatch-agent-bg8m2   1/1   Running   ip-10-40-33-18.ec2.internal
cloudwatch-agent-n5t2d   1/1   Running   ip-10-40-28-182.ec2.internal
Passo 2: Um sampler para a visão detalhada
O Container Insights tem resolução de um minuto. Para detalhe por segundo, cada teste envolve seu trabalho em um Sampler que consulta o kubelet stats de cada node pelo API server e grava CPU e memória por pod em CSV:
class Sampler:
    """Polls each node's kubelet stats summary every `every` seconds and writes
    per-pod and per-node CPU (millicores) and memory (MiB) to results/<name>.csv."""
    def _run(self):
        ...
        s = json.loads(kubectl("get", "--raw", f"/api/v1/nodes/{node}/proxy/stats/summary").stdout)
        for pod in s["pods"]:
            if pod["podRef"]["name"].startswith(self.PODS):
                cpu = sum(c["cpu"]["usageNanoCores"] for c in pod["containers"])
O Substrate roda o runsc dentro dos seus worker pods, não como uma RuntimeClass do Kubernetes, então os números de um worker pod são a soma dos sandboxes que ele hospeda. O Kubernetes não enxerga sandboxes individuais; o registro do próprio Substrate (kubectl-ate get workers) mostra o que cada worker reservou.
Passo 3: Começar cada teste do zero
Um bug no meu harness moldou este passo. Minhas primeiras execuções faziam a limpeza entre testes listando as tasks e deletando-as, e deixaram cerca de cem tasks do teste de densidade rodando, o que depois empurrou todos os testes seguintes para erros no worker has room. A causa: ax get tasks retorna no máximo 50 tasks. O ListTasks do AX tem limite padrão de 50, e a CLI não tem flag para pedir mais. Agora todo teste começa deletando até que nada seja listado, e os números abaixo vêm de re-execuções limpas:
def delete_all(prefix=""):
    """`ax get tasks` returns at most 50 tasks, so list and delete until nothing is left."""
    while True:
        names = [t for t in list_tasks() if t.startswith(prefix)]
        if not names:
            return
        delete_names(names)
Testes
Teste 1: Teto de densidade
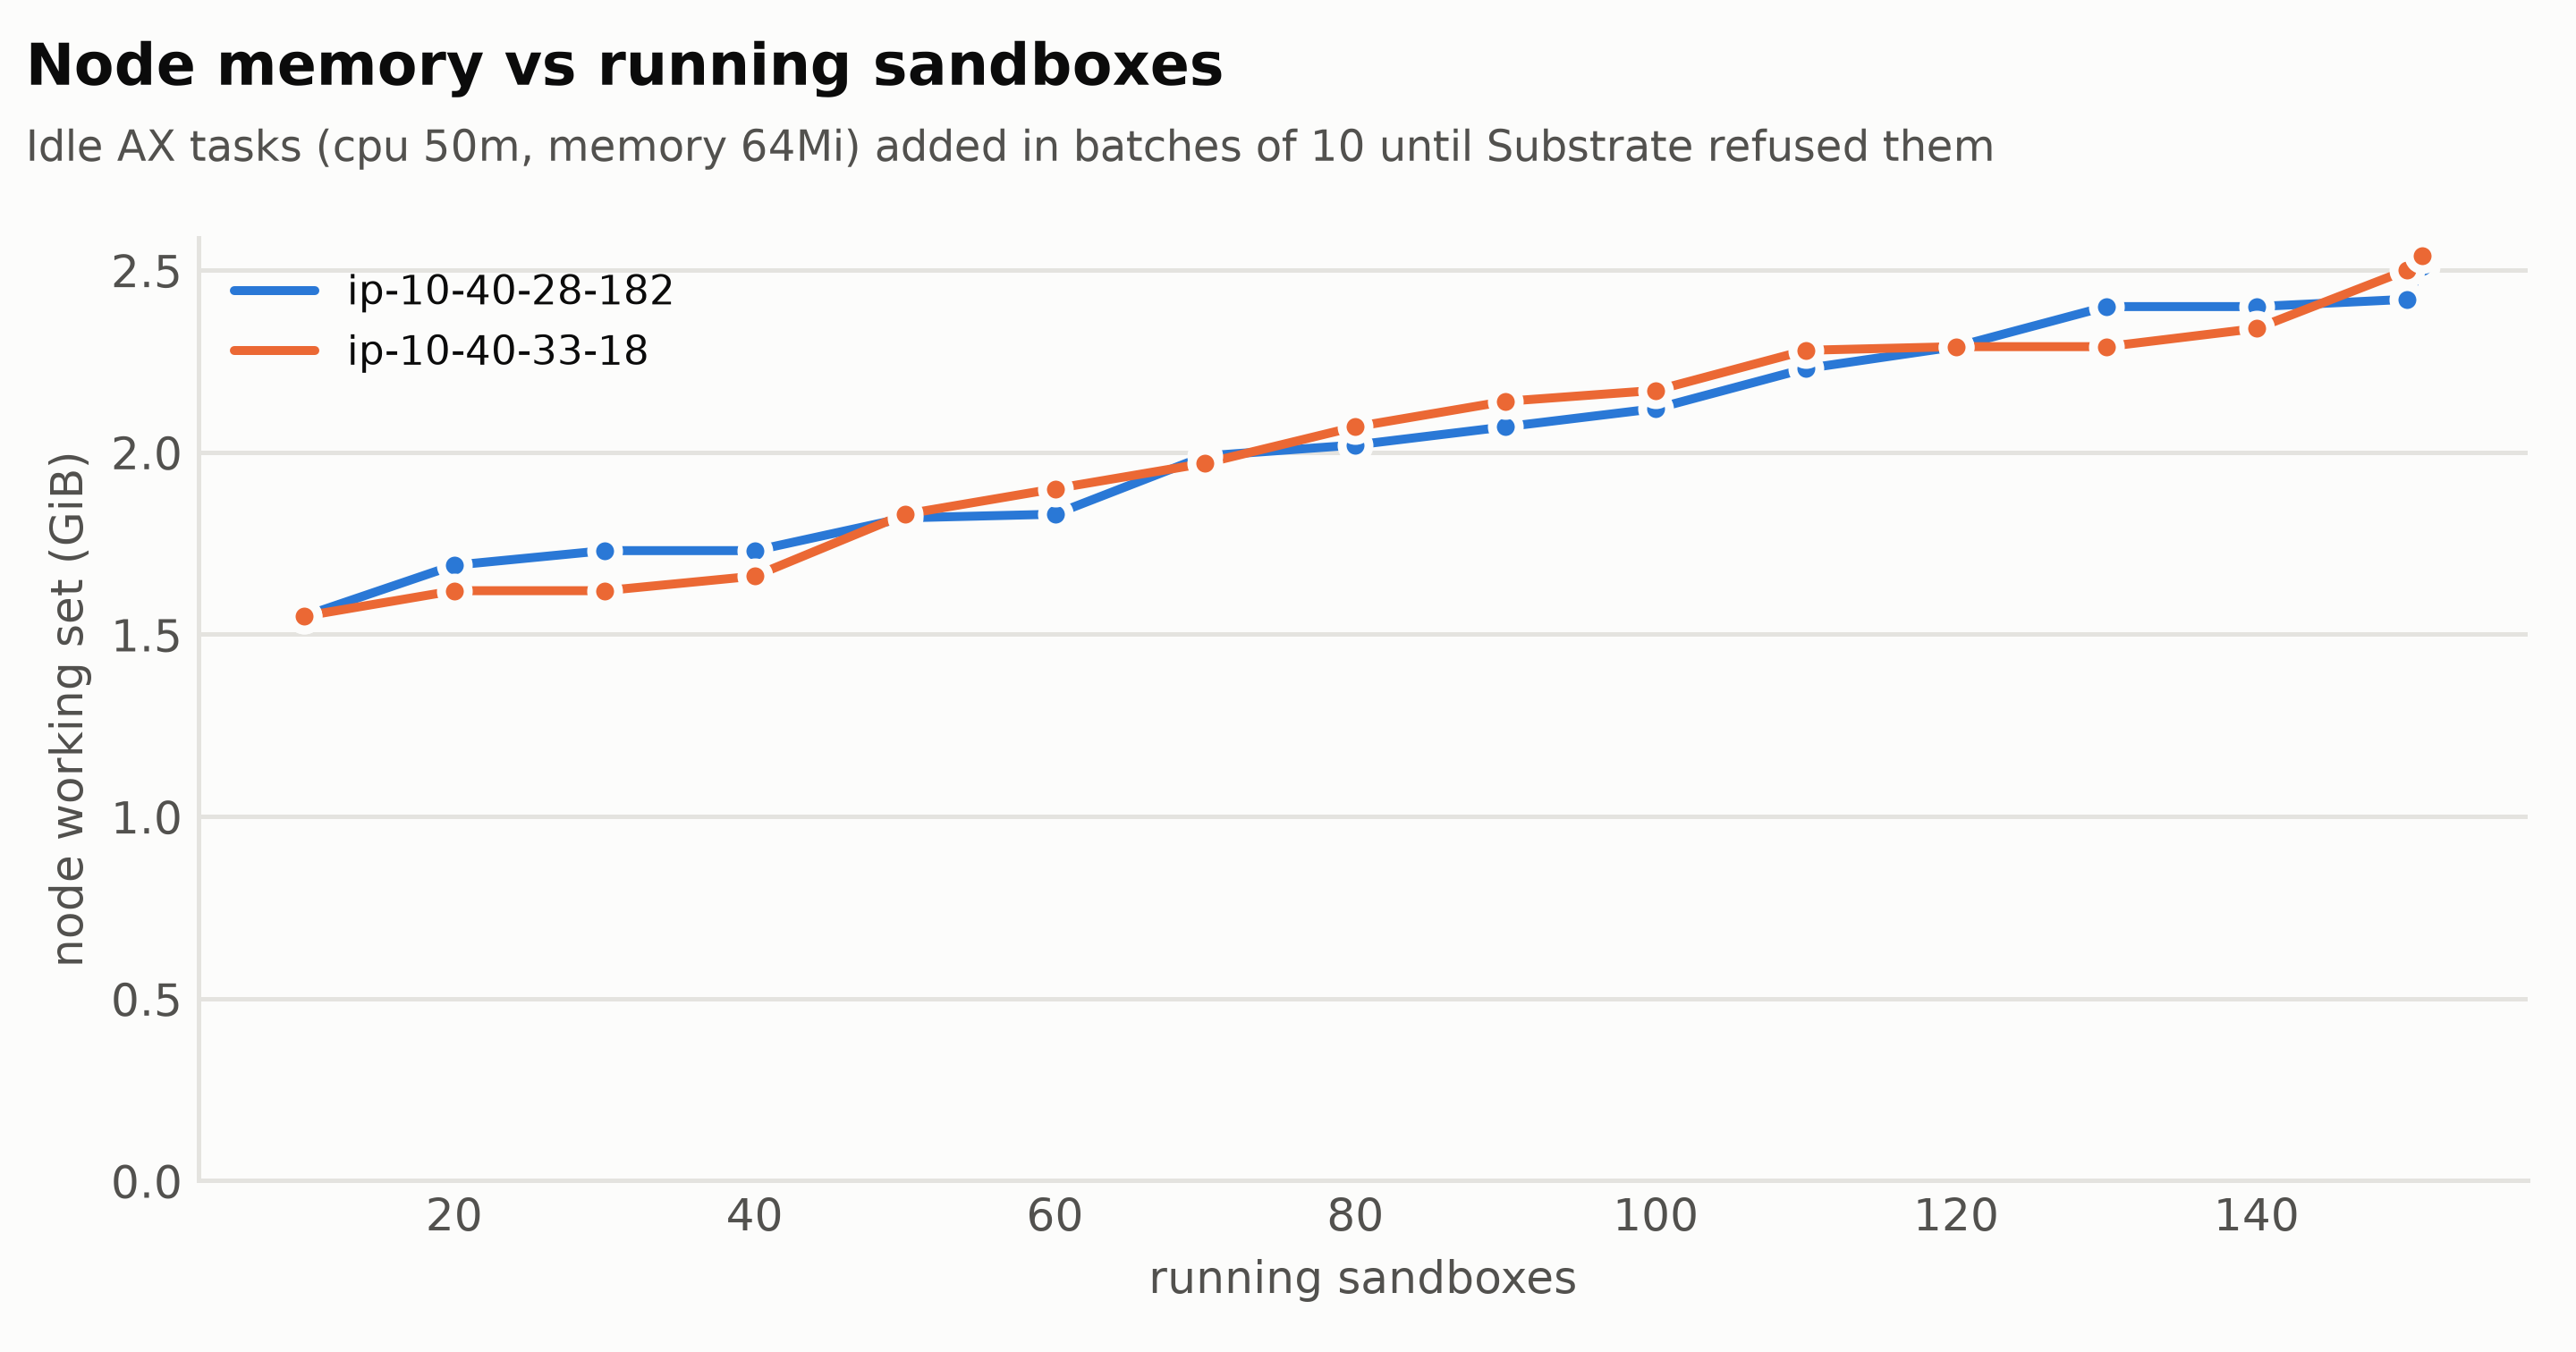
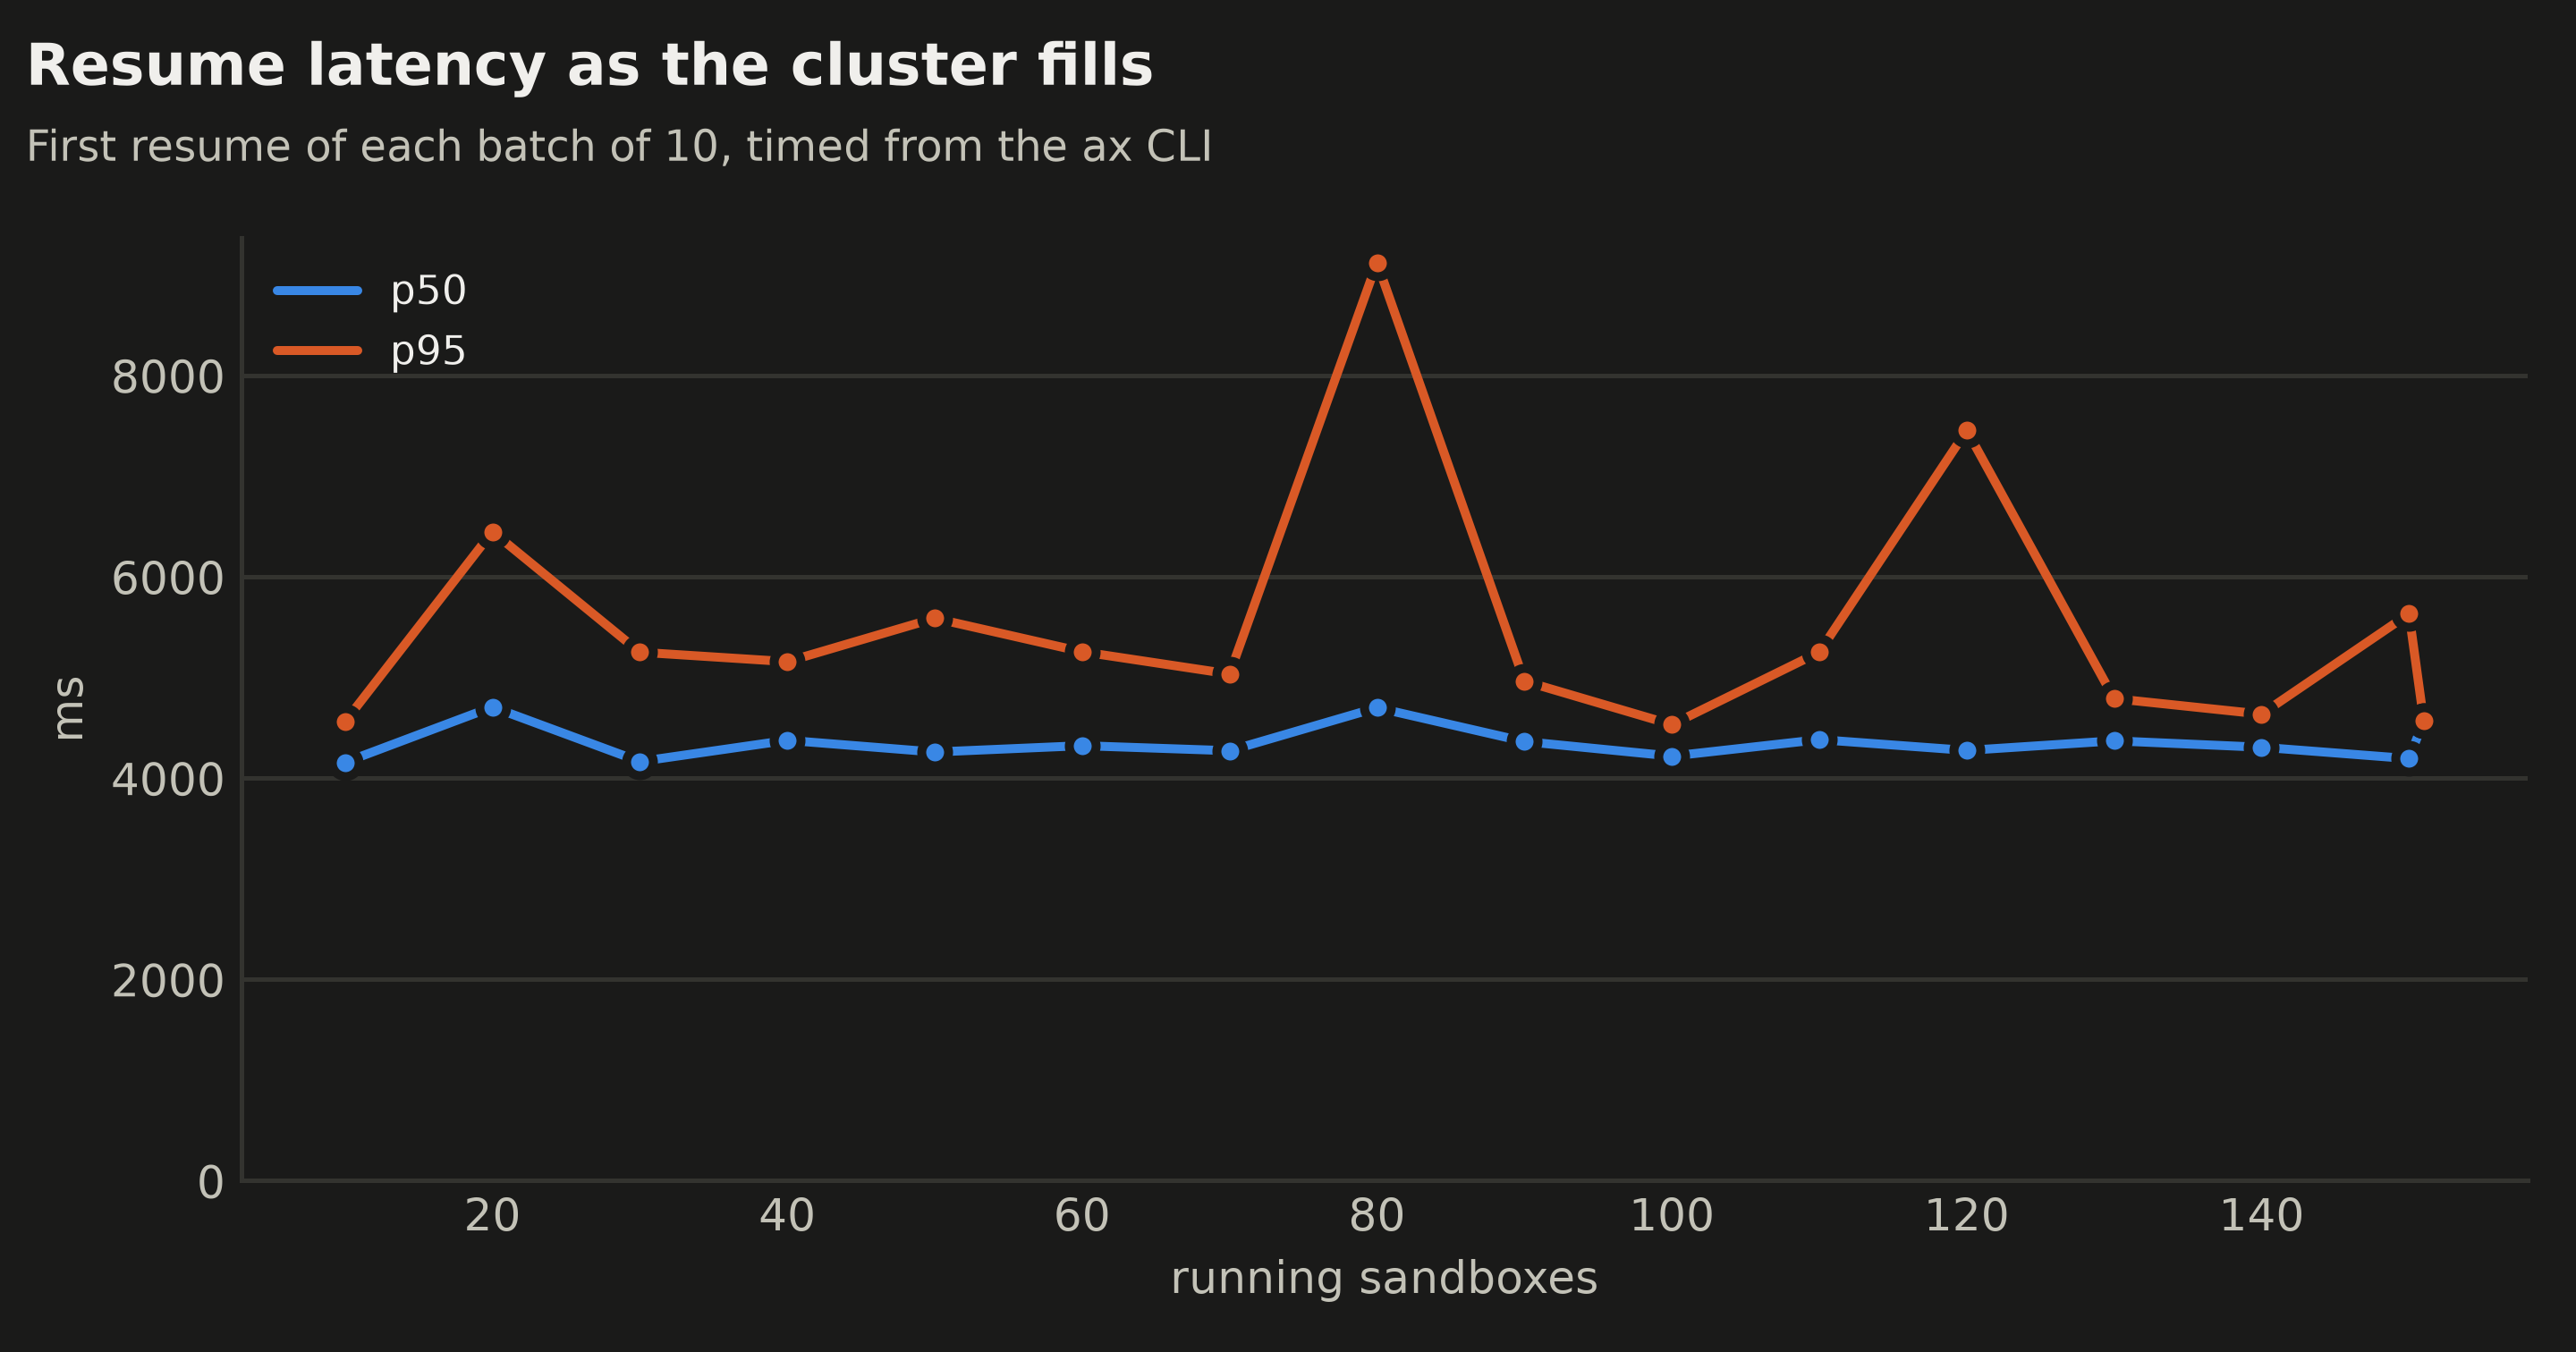
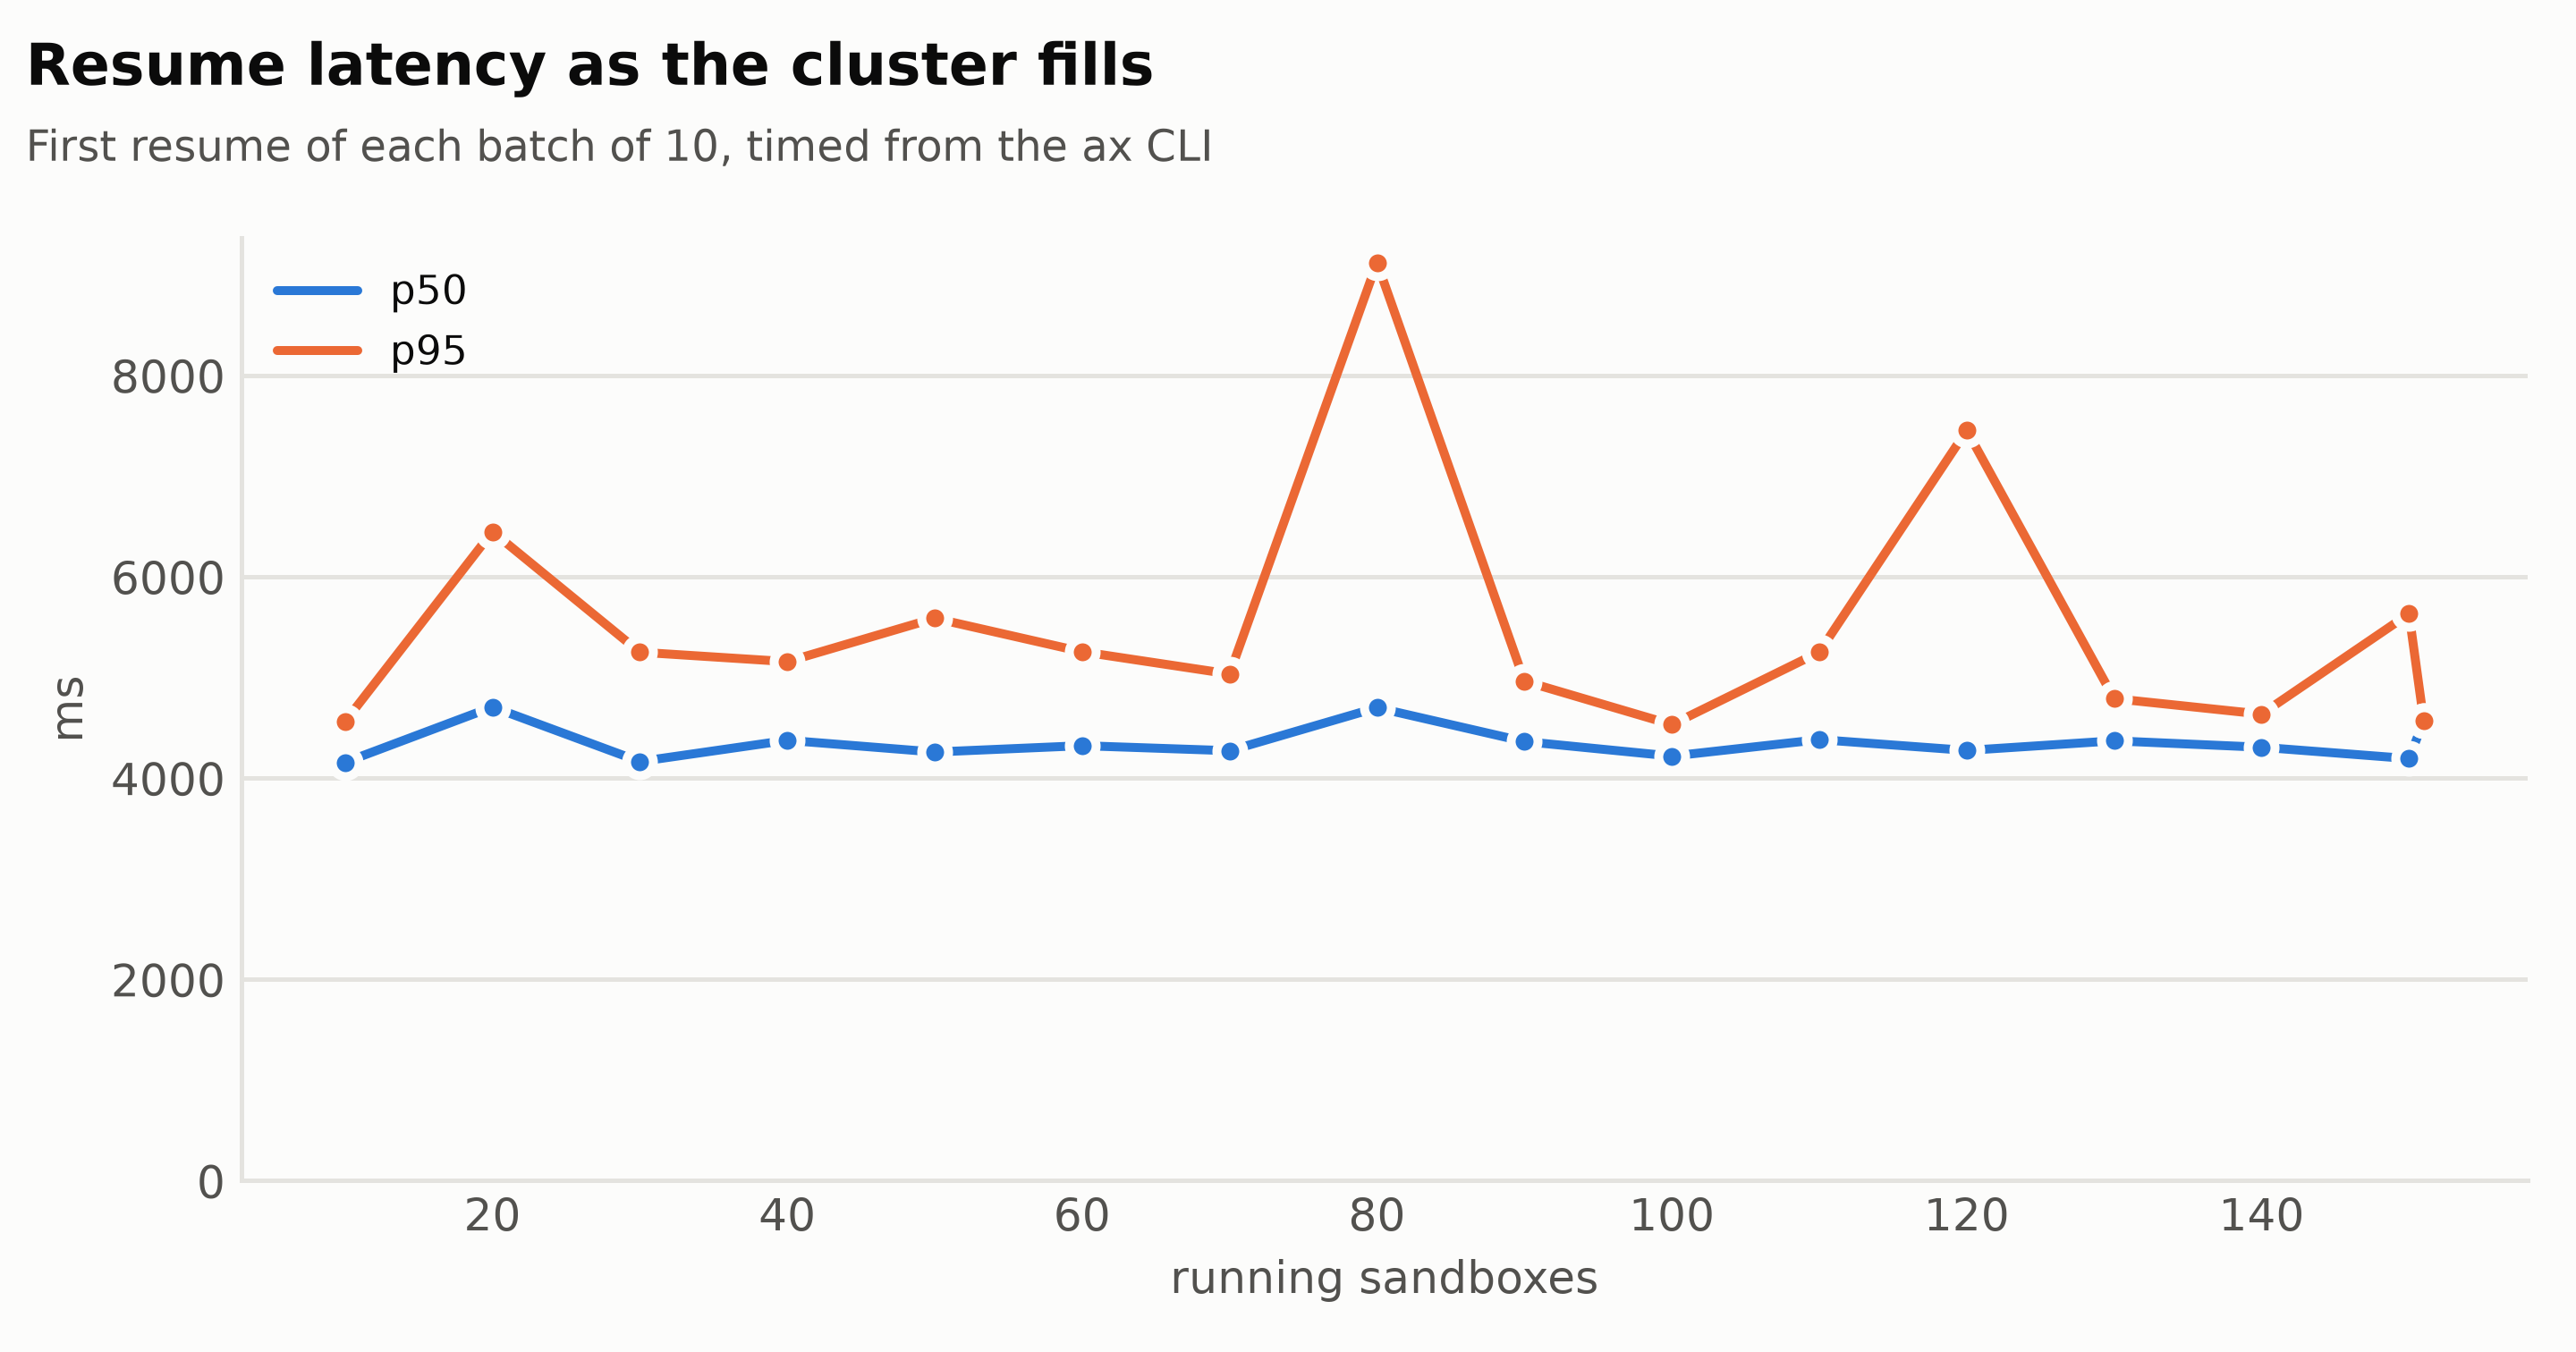
O 02_density.py adiciona tasks ociosas (sleep infinity, cpu 50m, memory 64Mi) de dez em dez e faz resume de cada lote, até o Substrate recusar:
for start in range(1, MAX + 1, BATCH):
    names = [f"st-d-{i:03d}" for i in range(start, start + BATCH)]
    parallel(lambda n: create(n, cpu="50m", memory="64Mi"), names, 10)
    res = parallel(lambda n: timed_call(ax, "resume", "task", n), names, 10)
10 running (+10/10) resume p50 4156 ms node memory 1.6 / 1.6 GiB
50 running (+10/10) resume p50 4259 ms node memory 1.8 / 1.8 GiB
100 running (+10/10) resume p50 4218 ms node memory 2.1 / 2.2 GiB
150 running (+10/10) resume p50 4193 ms node memory 2.4 / 2.5 GiB
151 running (+ 1/10) resume p50 4570 ms node memory 2.5 / 2.5 GiB
refused: no worker has room for the actor
all resumes: n=151 p50 4286 ms, p95 5255, p99 7454, max 9121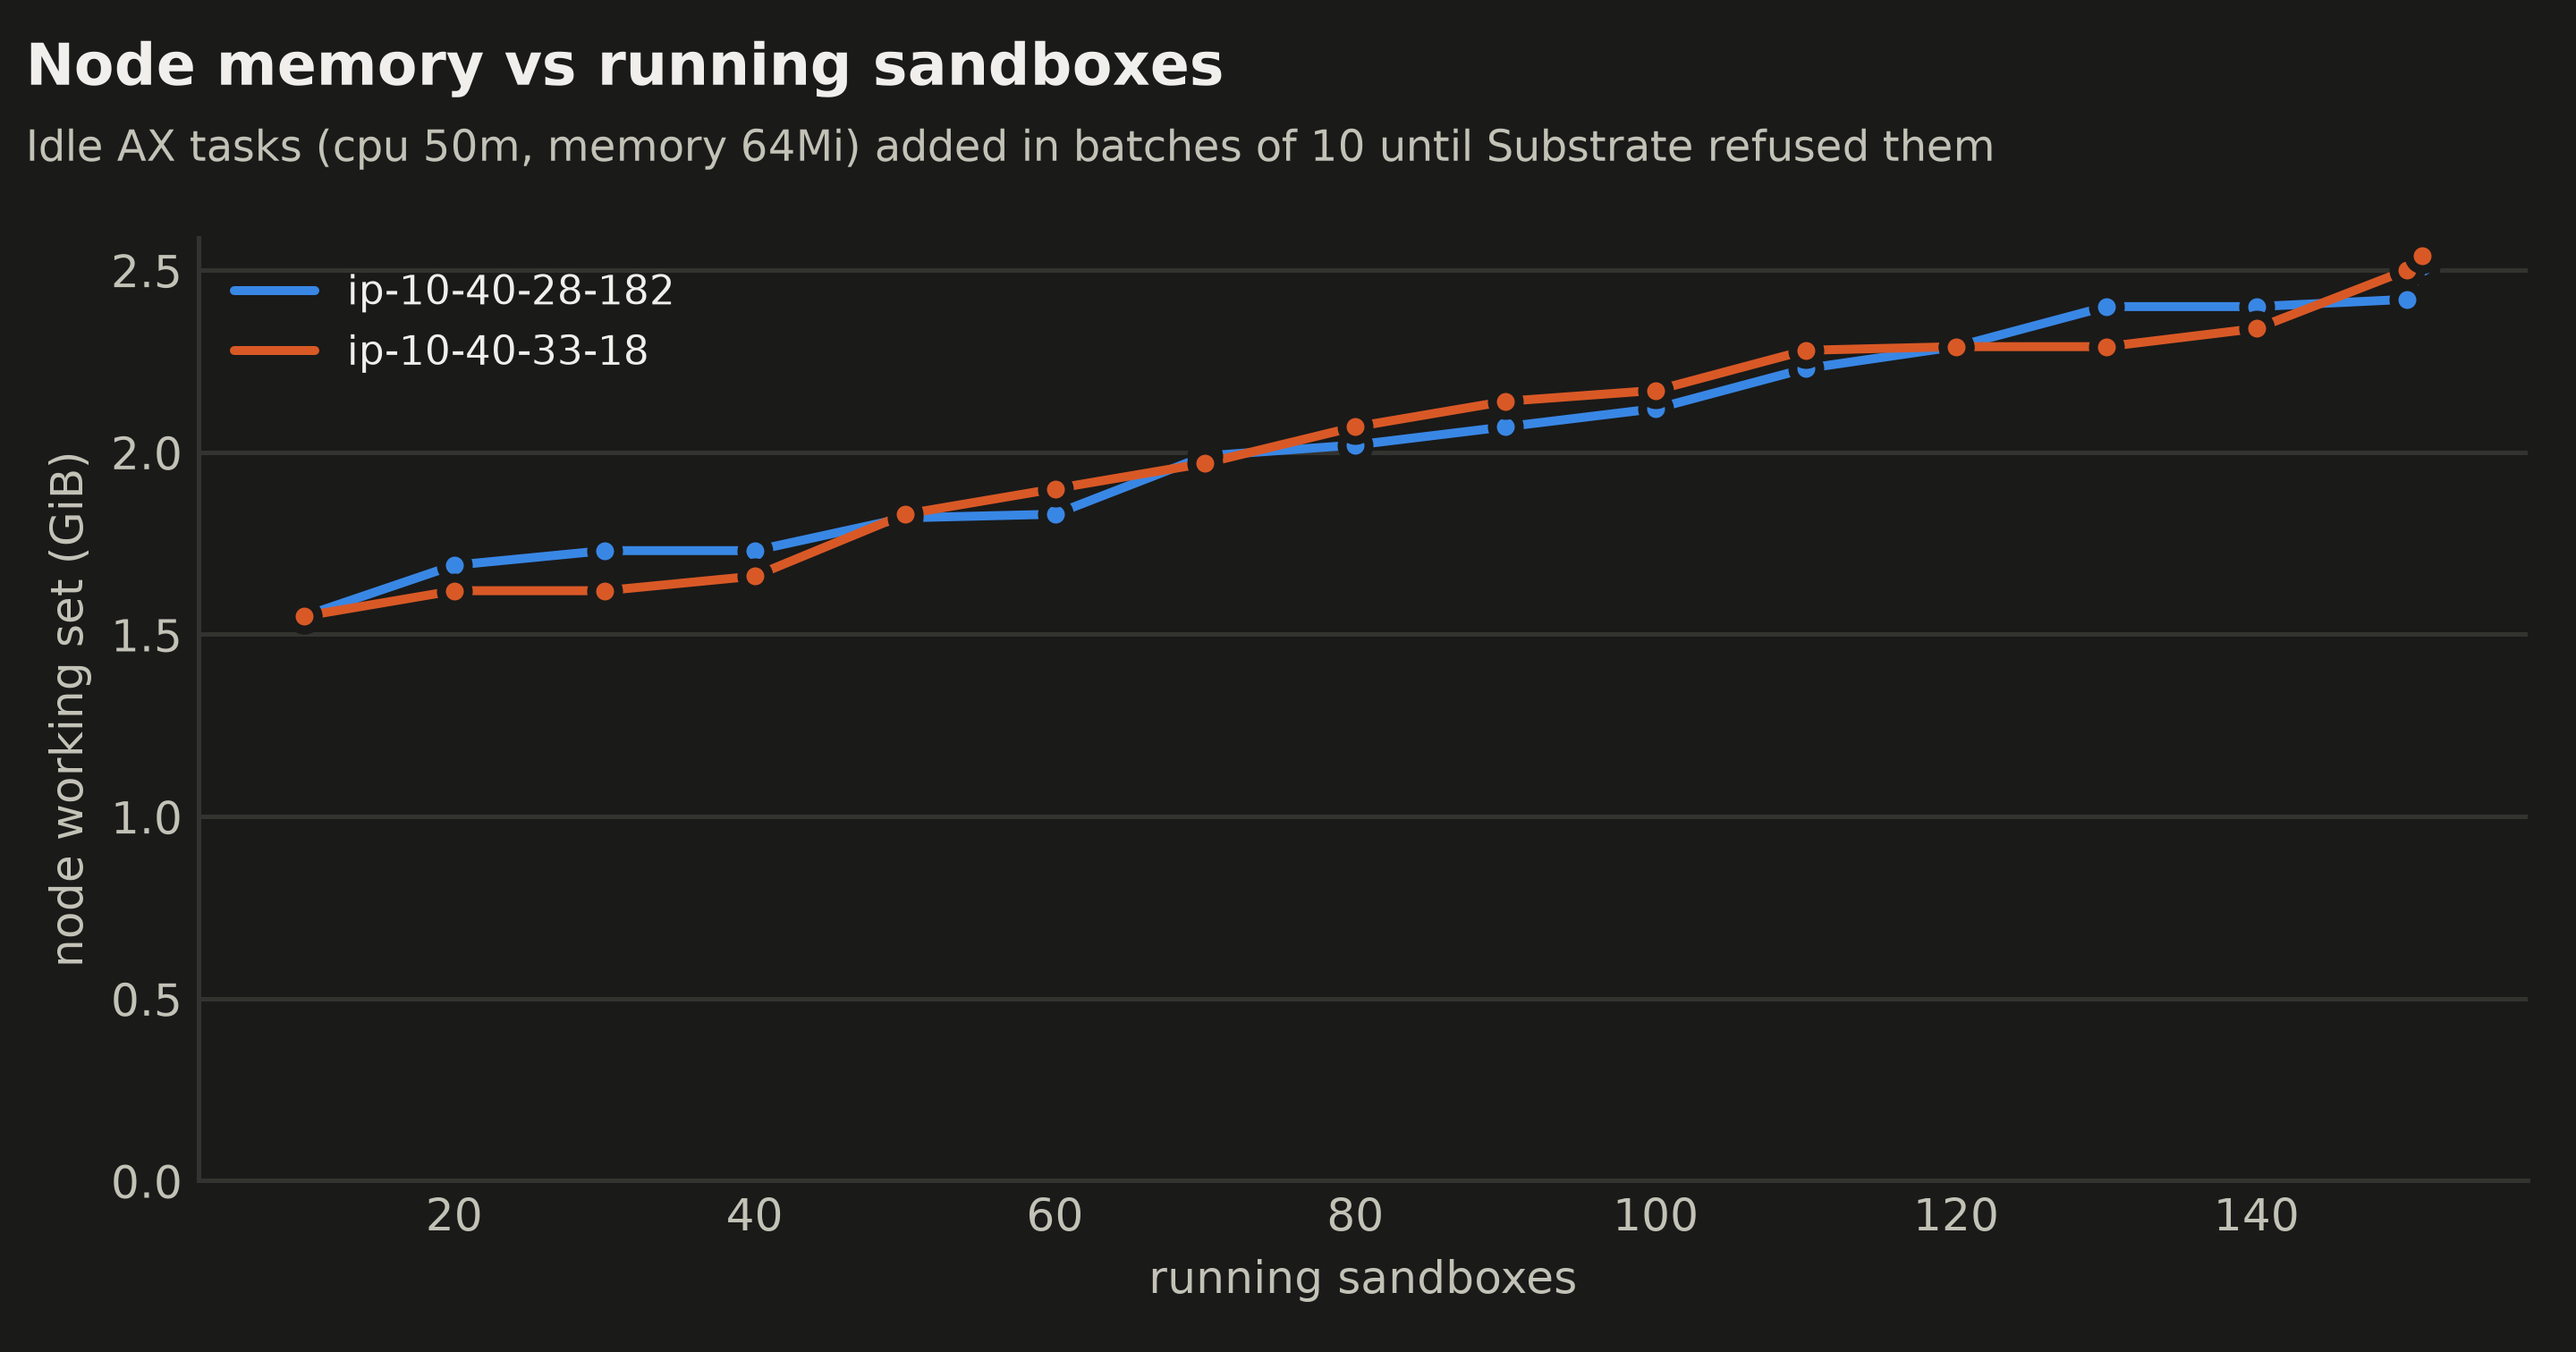
| Sandboxes rodando | Memória do node (GiB, cada node) | Resume p50 (ms) |
|---|---|---|
| 10 | 1,6 / 1,6 | 4.156 |
| 50 | 1,8 / 1,8 | 4.259 |
| 100 | 2,1 / 2,2 | 4.218 |
| 151 | 2,5 / 2,5 | 4.570 |
151 sandboxes, e depois recusas. O teto são as reservas de CPU: cada worker reserva o limite de CPU de cada task contra os 3,92 CPU alocáveis do seu node, o que em teoria comporta 78 tasks de 50m por worker; na prática, a 152ª foi recusada. A memória quase não se mexeu: 151 sandboxes ociosos adicionaram cerca de um gigabyte por node, aproximadamente 13 MiB cada. A latência de resume ficou estável enquanto o cluster enchia, mas foi lenta, em torno de 4,3 s, e o Teste 3 mostra por quê: um sandbox de 50m faz boot devagar. Para agentes ociosos que raramente rodam, dois nodes pequenos comportam muita coisa. Os “1.000 agentes dormentes por host” do Google contam agentes dormentes, que não ocupam nenhum sandbox; no AX, uma task suspensa também não reserva nada.
Teste 2: Latência sob concorrência
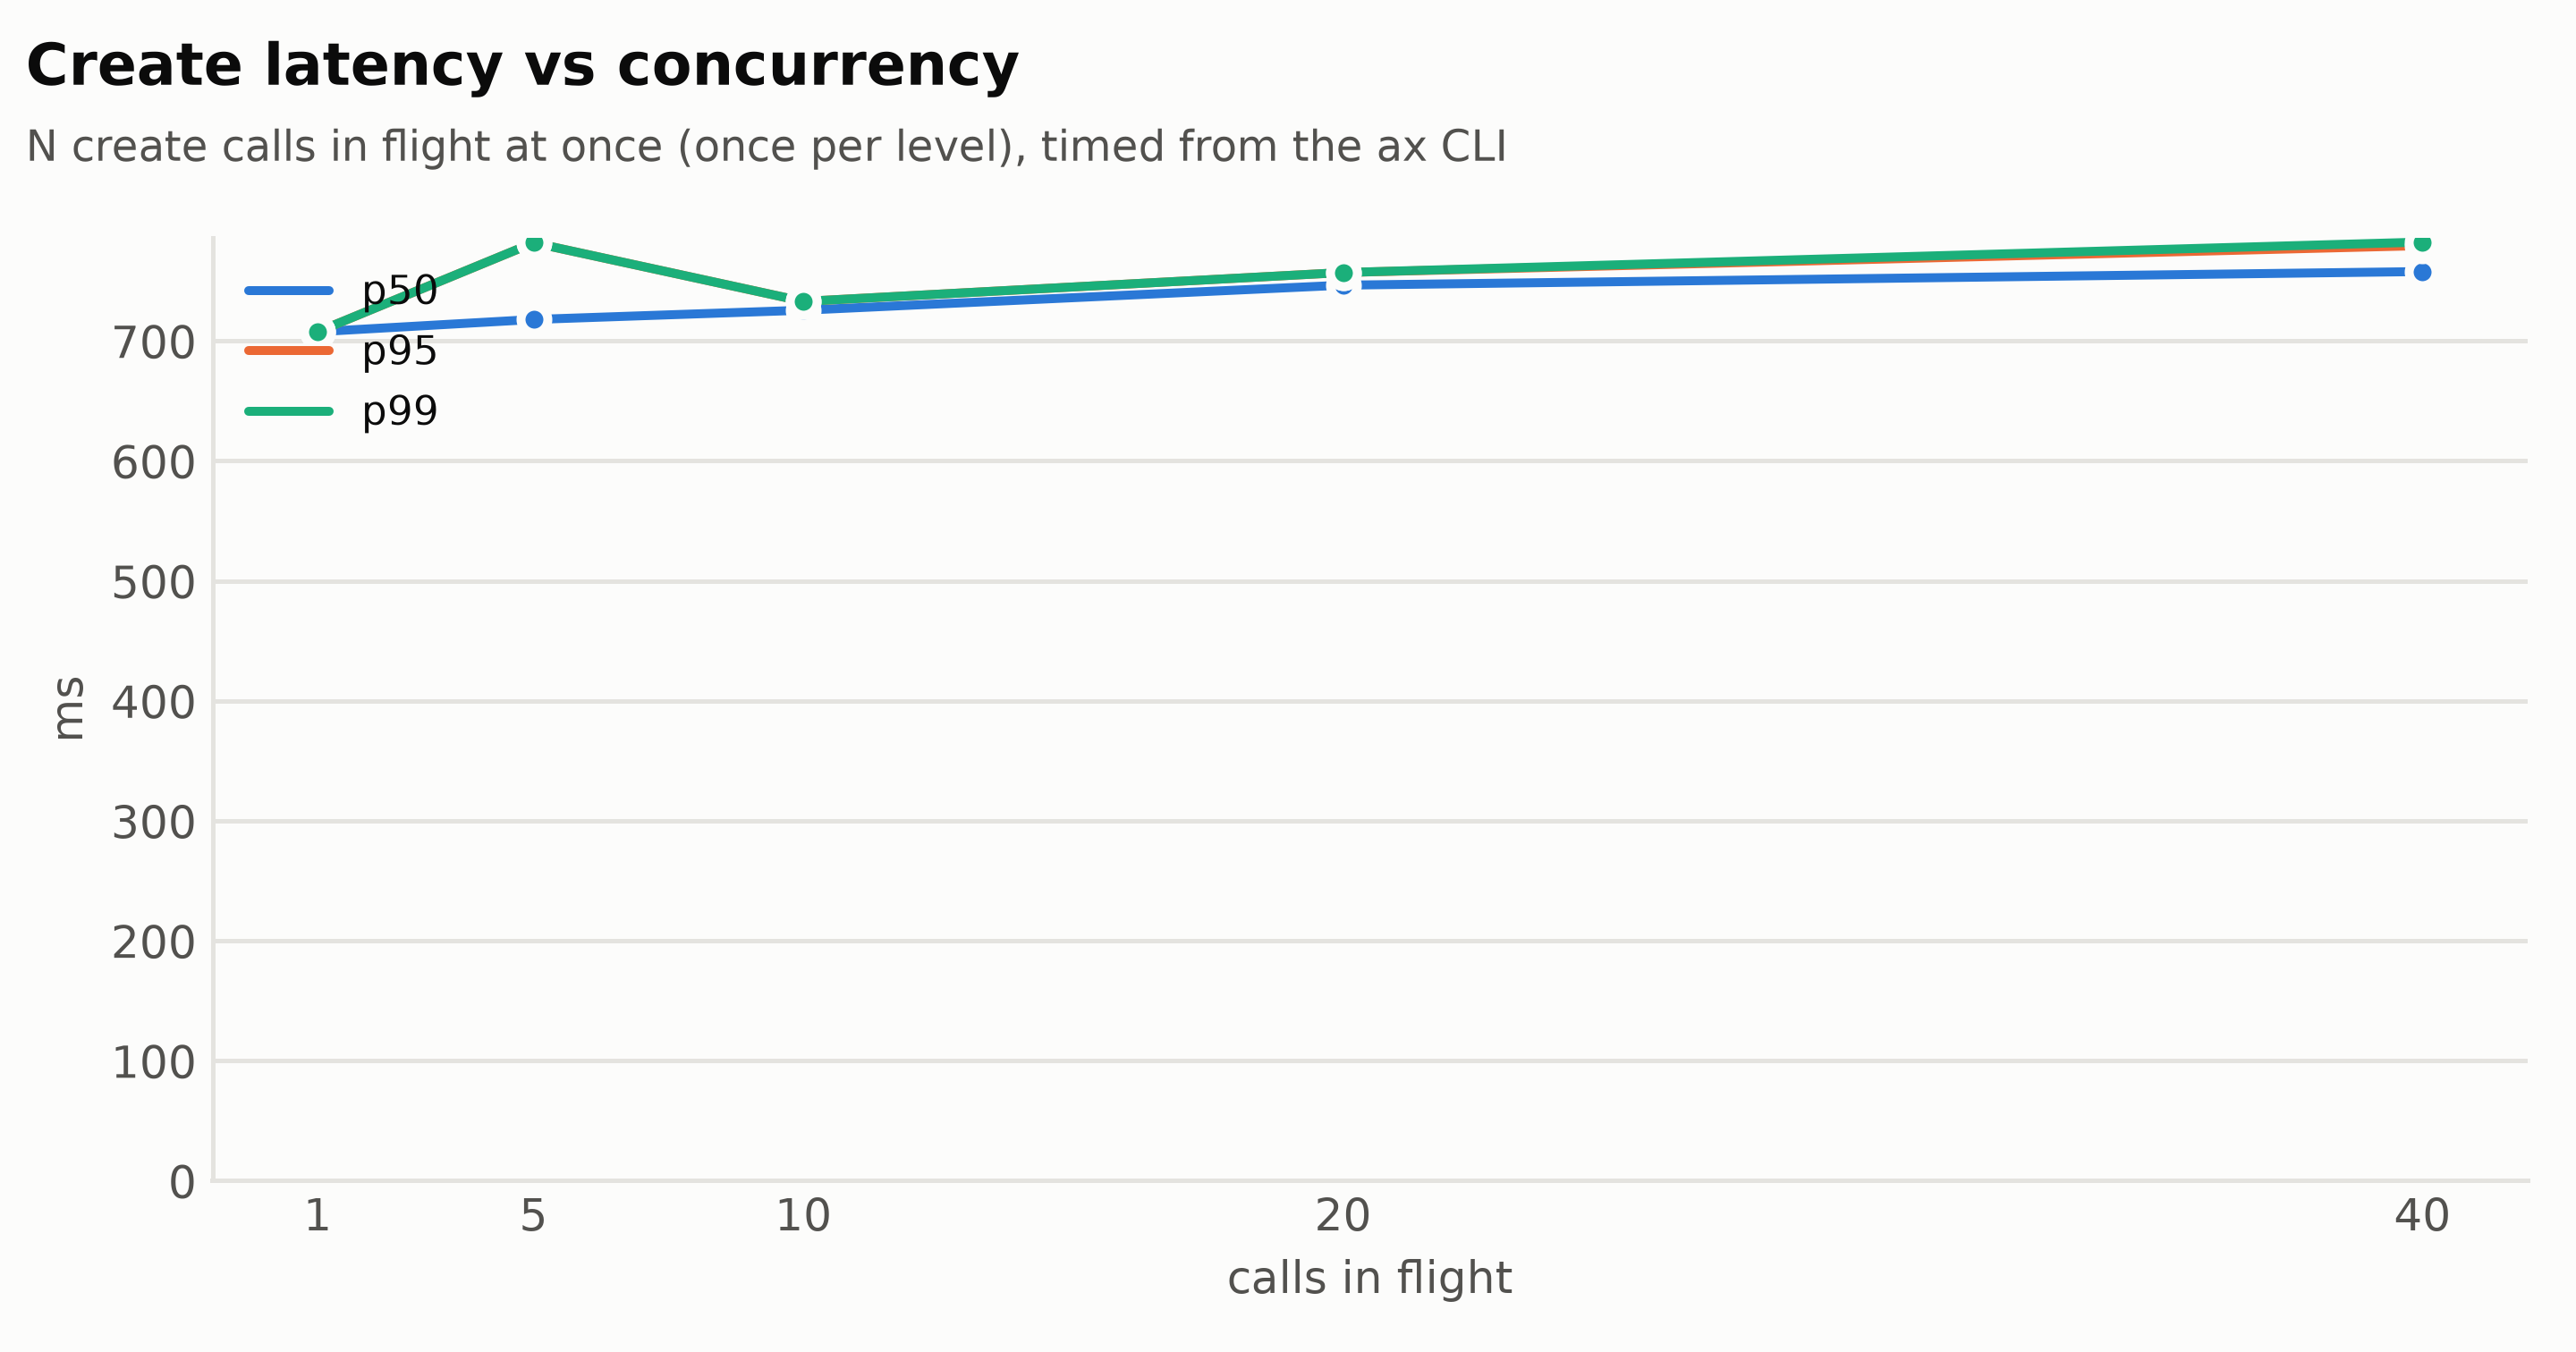
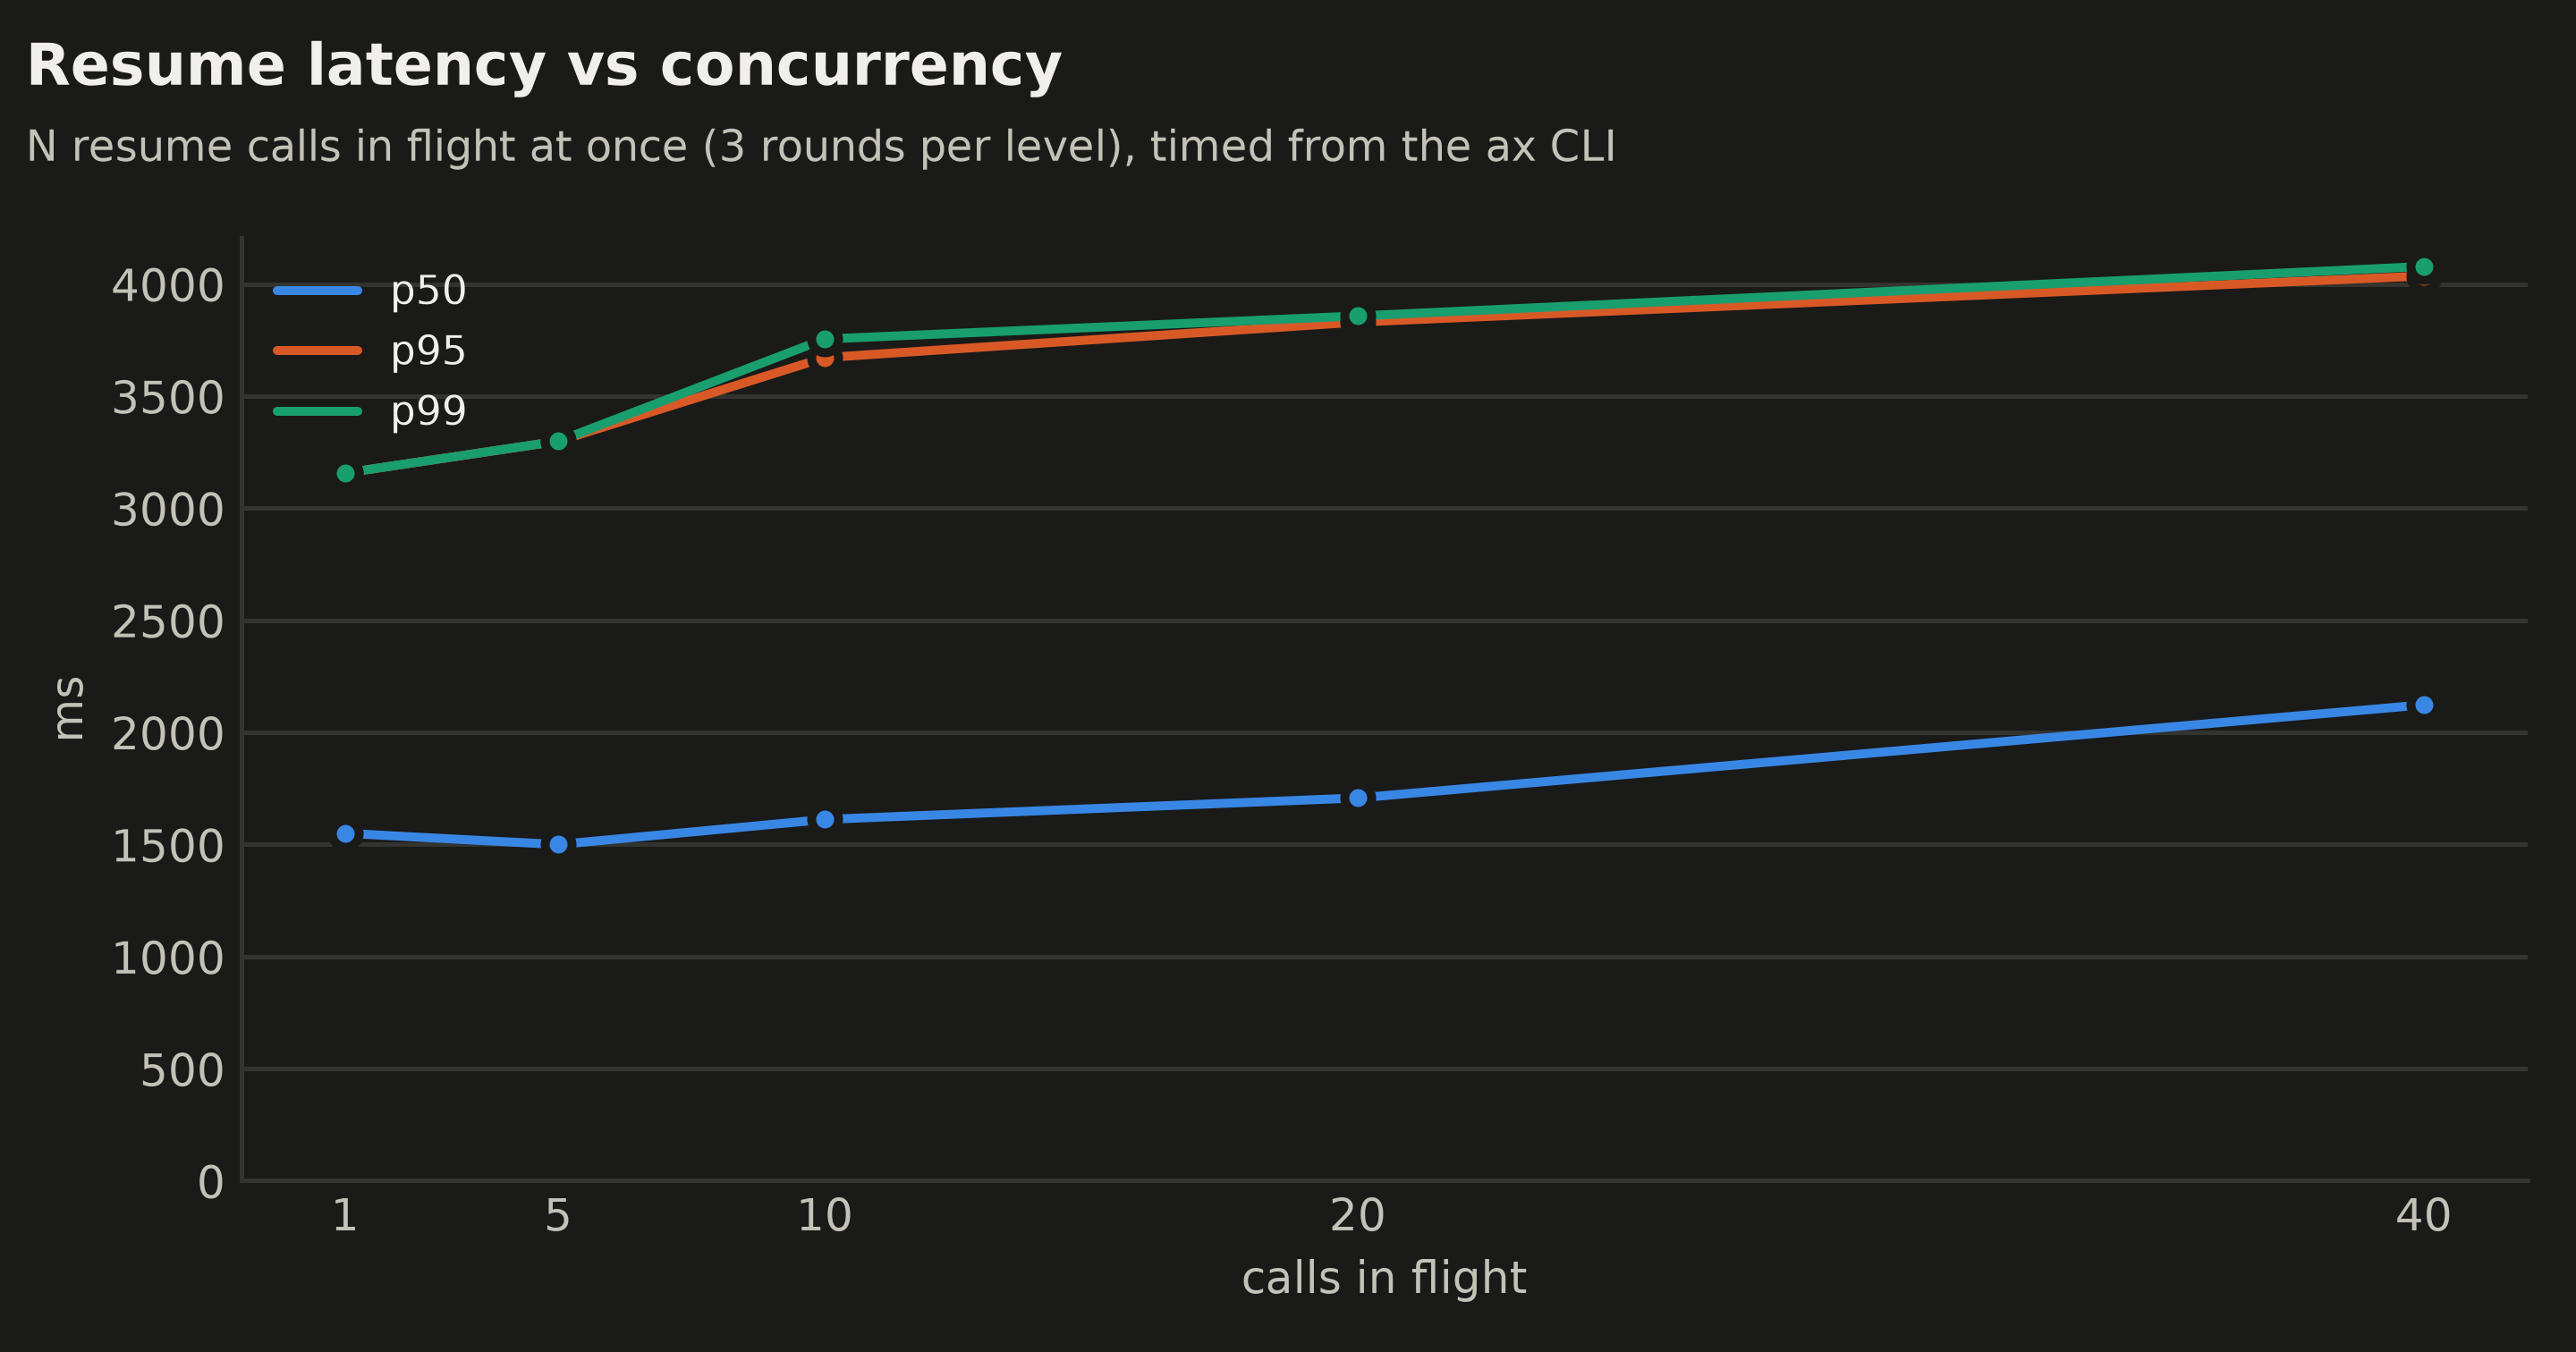
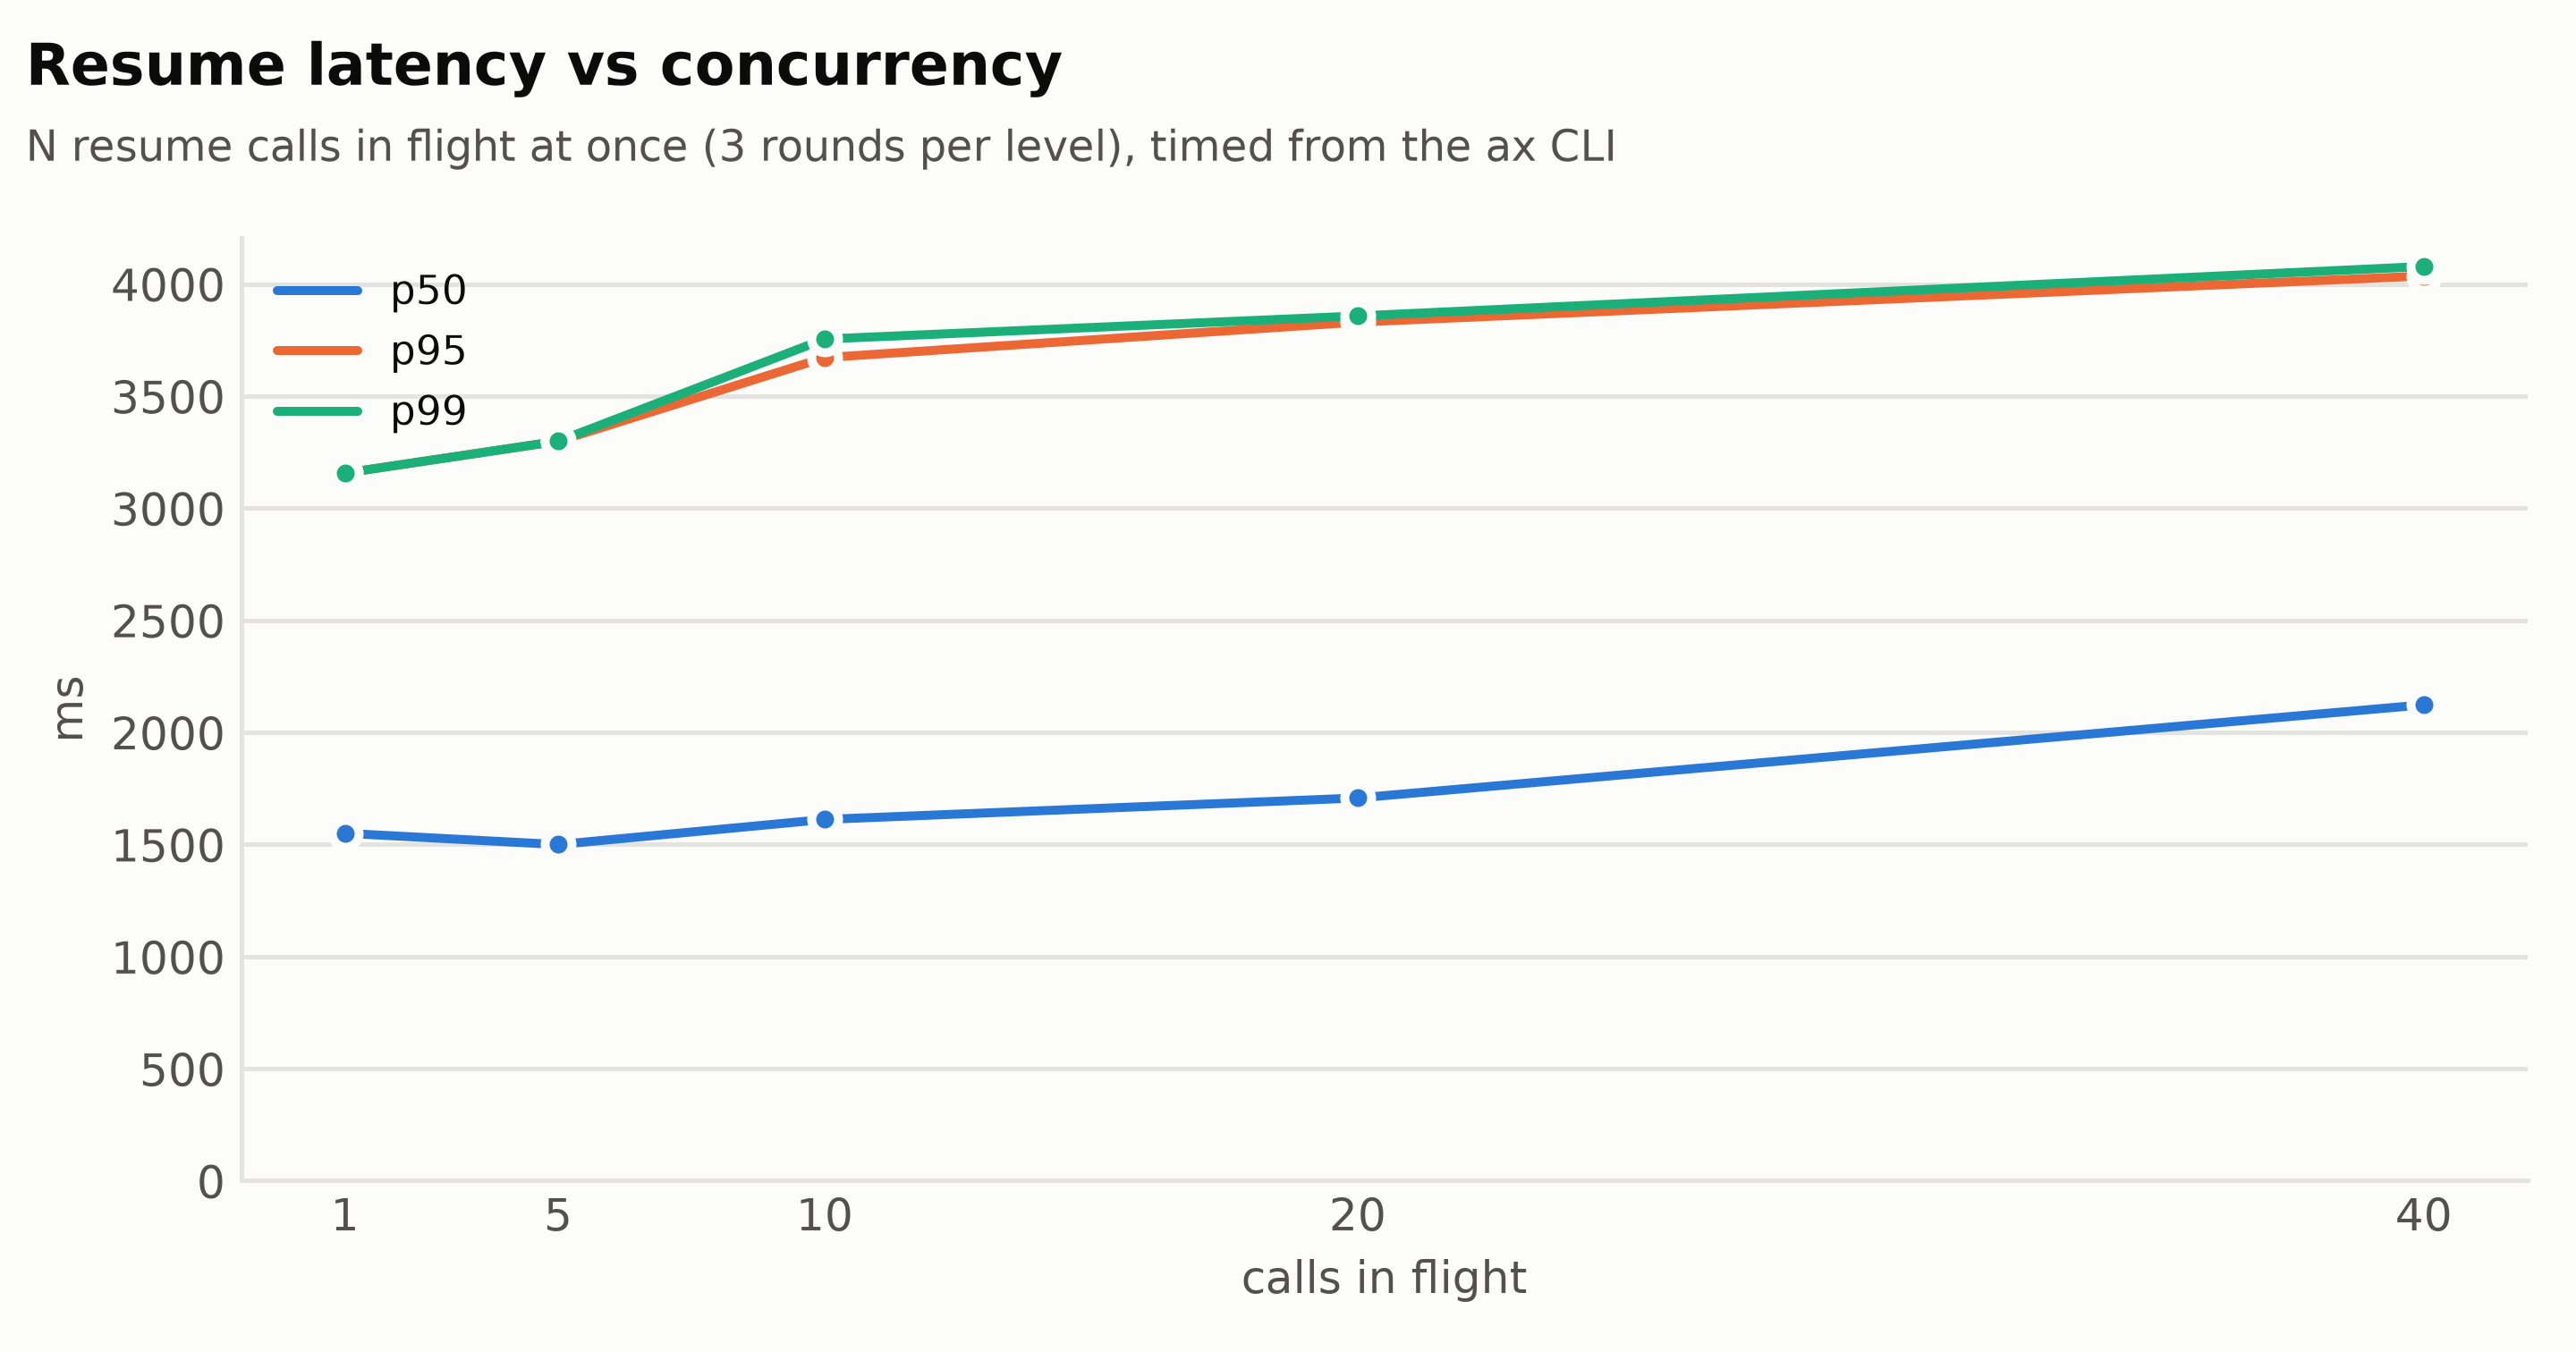
O 03_latency.py cria N tasks de uma vez (cpu 100m, memory 128Mi), depois faz resume e suspend de todas as N de uma vez, em três rodadas, para N de 1 a 40:
for n in (1, 5, 10, 20, 40):
    out = parallel(create_one, names, n)
    for _ in range(3):
        for verb in ("resume", "suspend"):
            out = parallel(op(verb), names, n)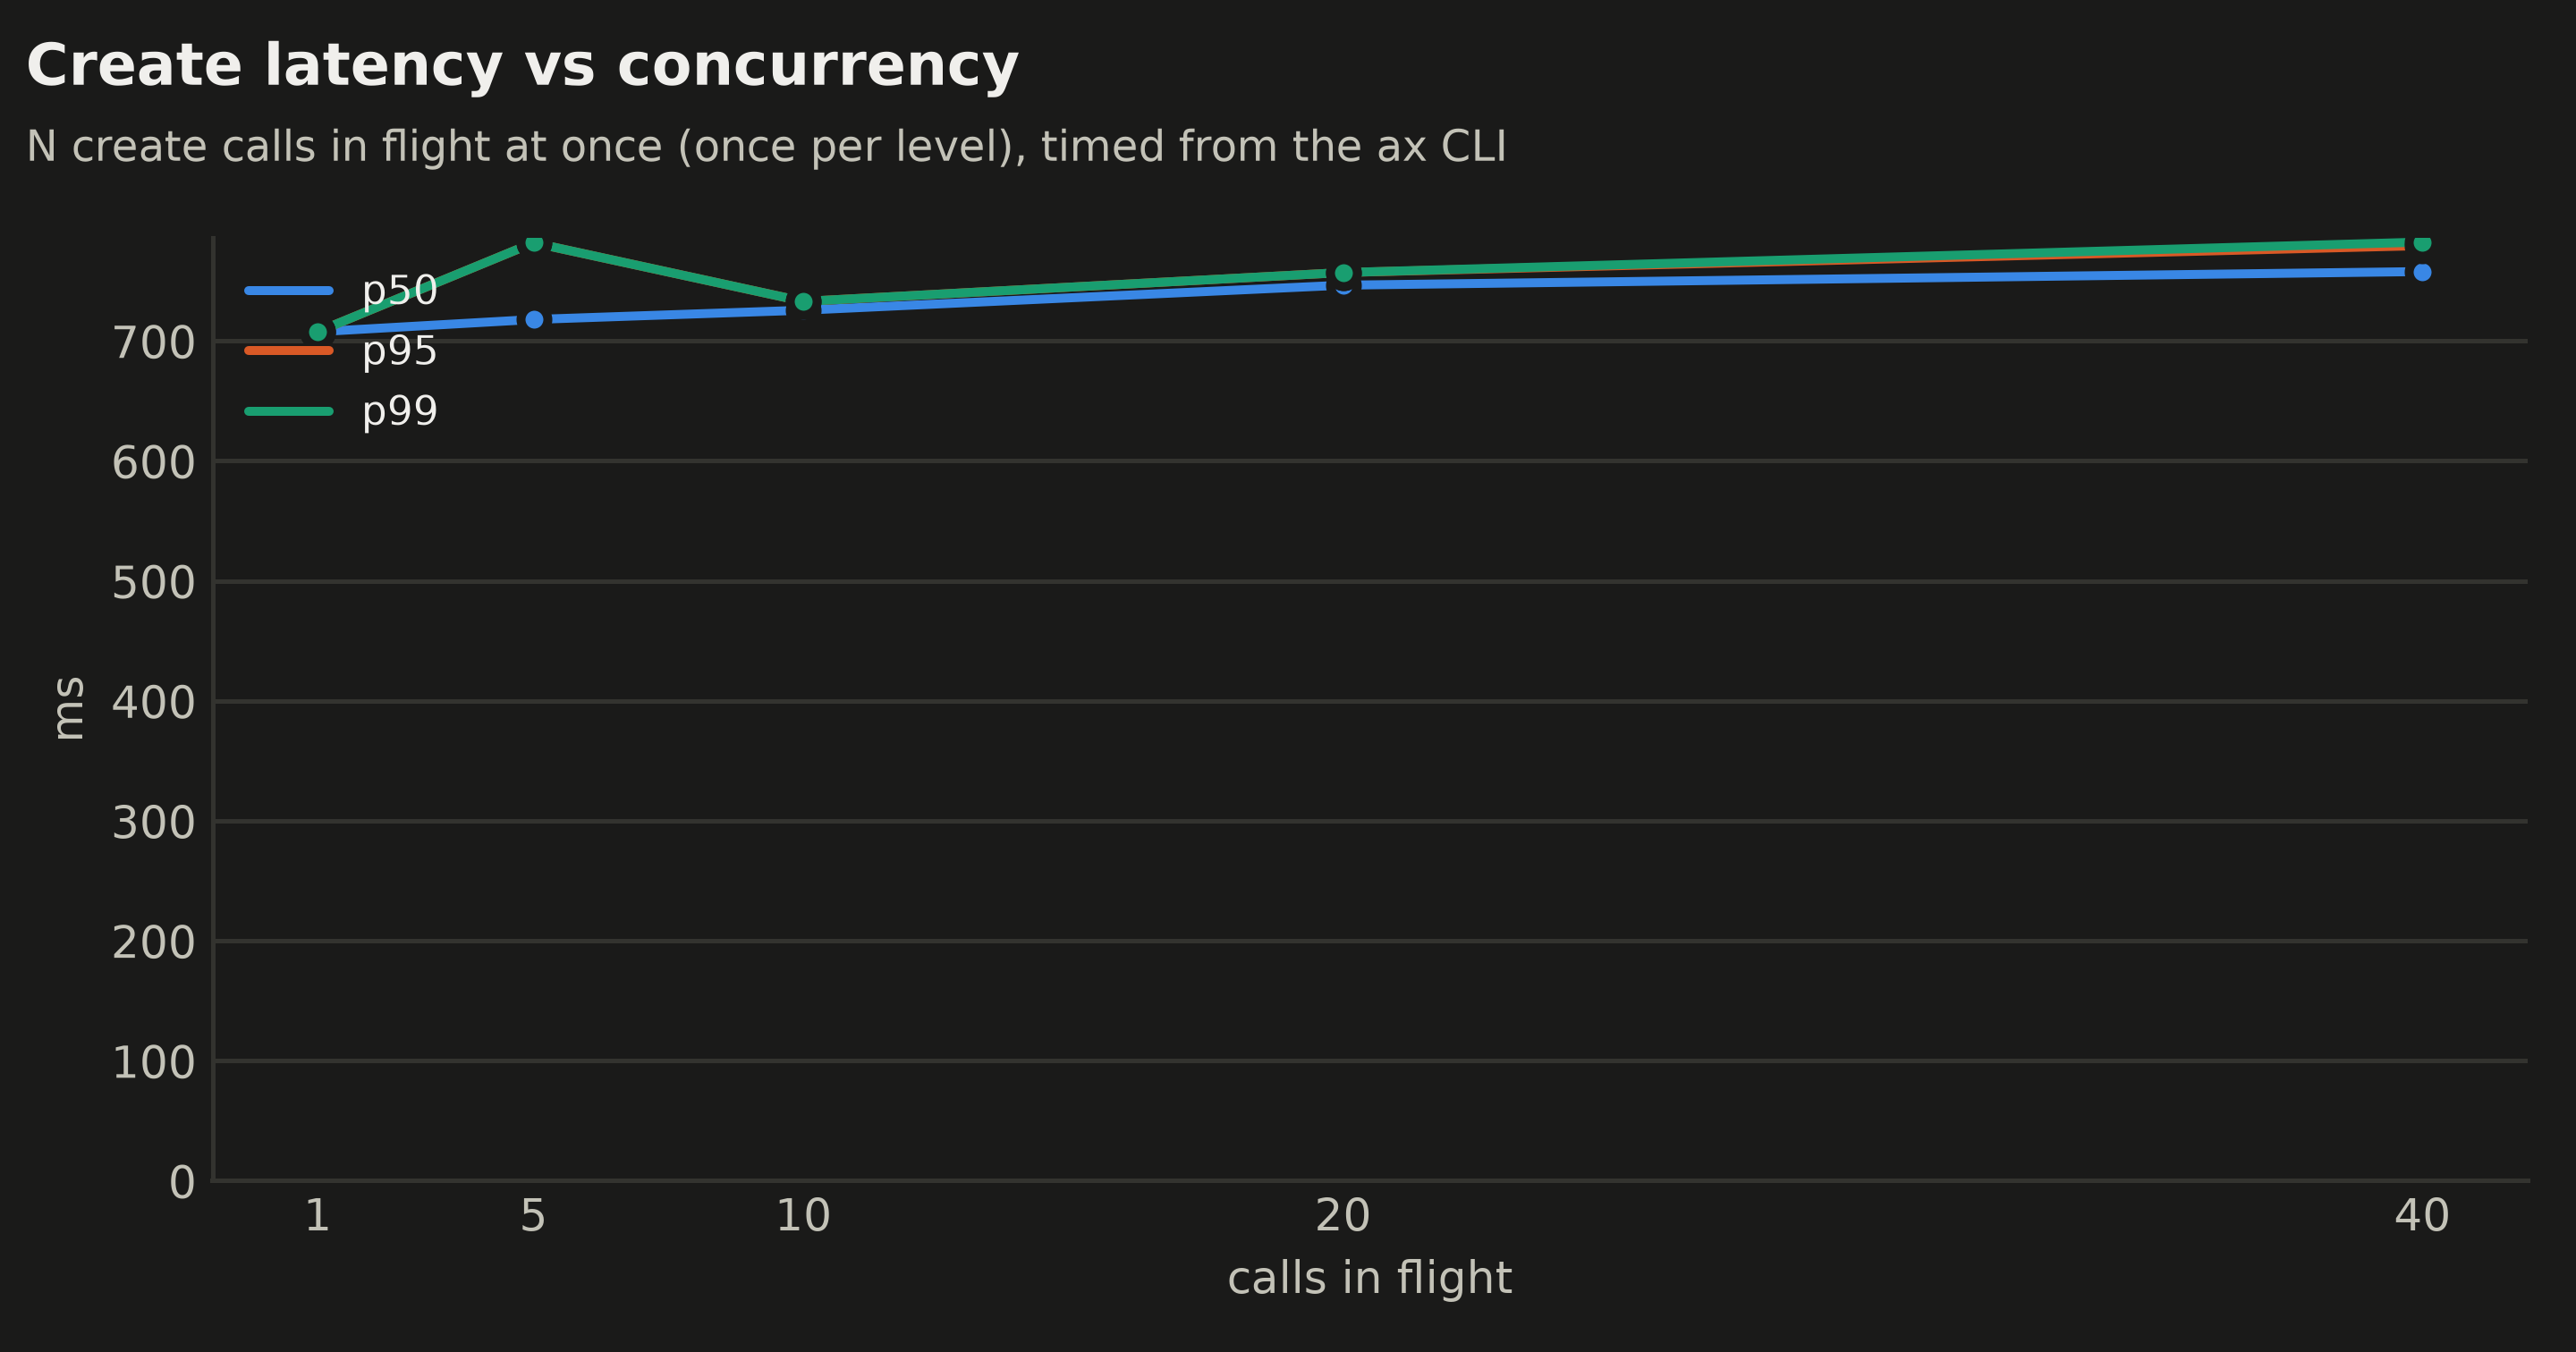
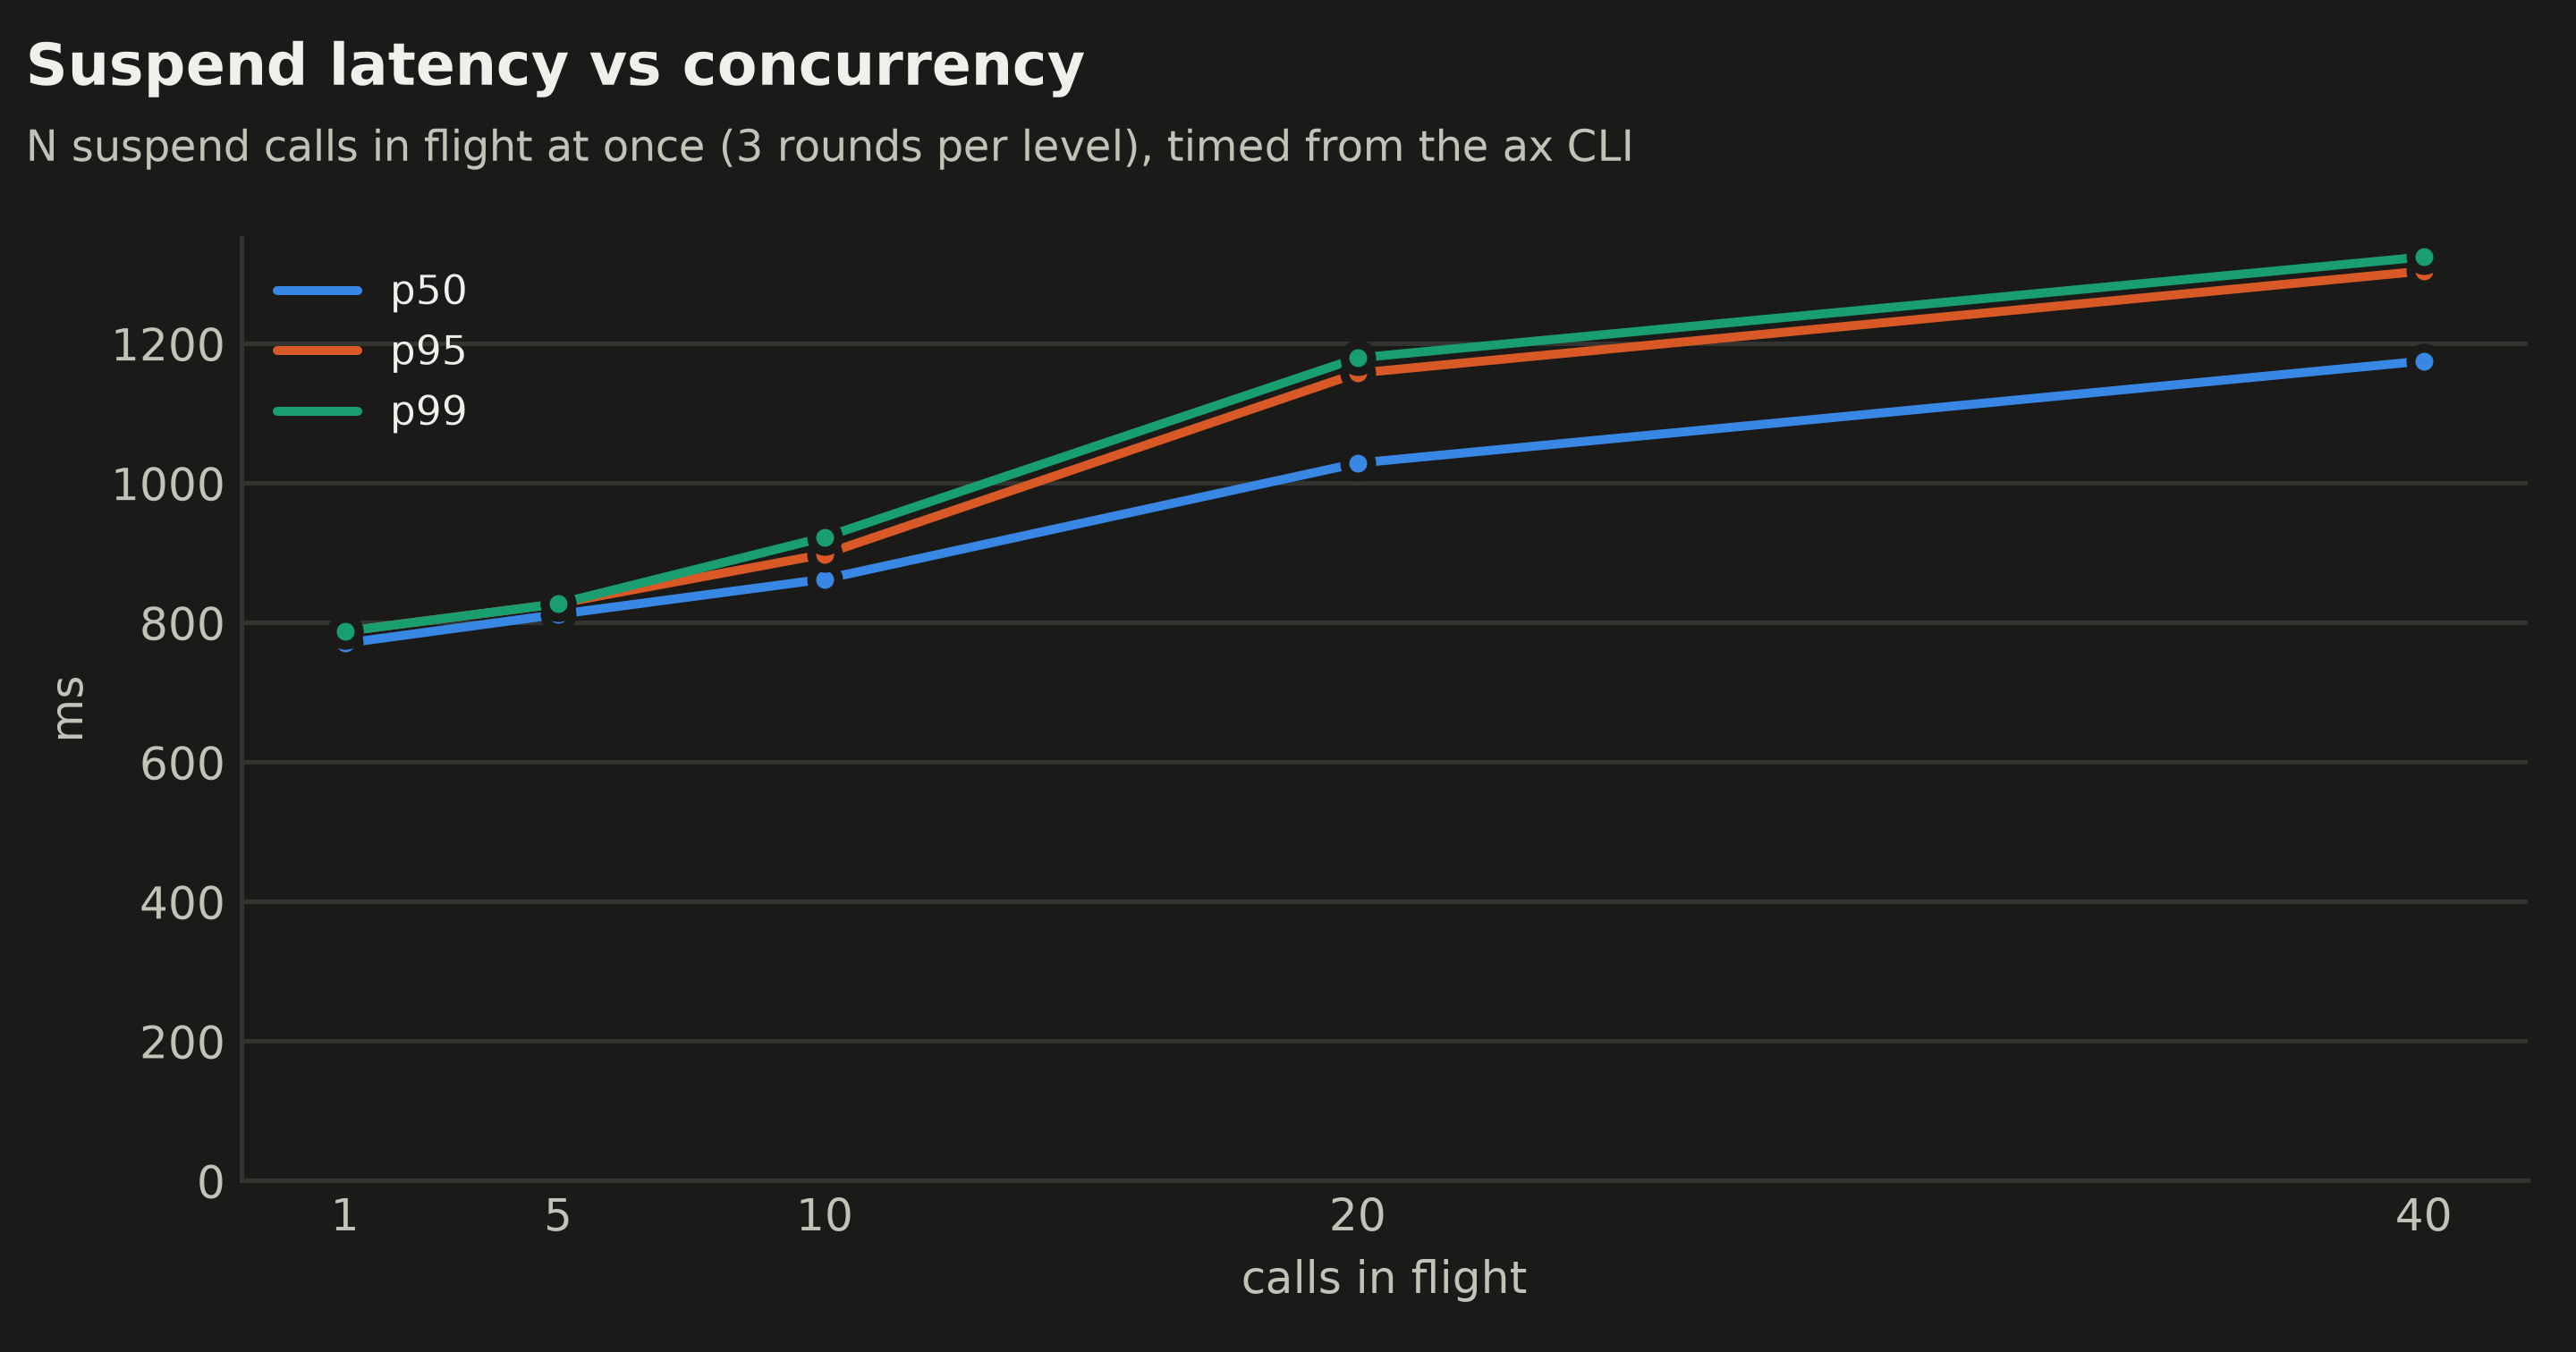
| Chamadas em andamento | Create p50 | Resume p50 / p95 | Suspend p50 / p95 |
|---|---|---|---|
| 1 | 708 ms | 1.550 / 3.157 ms | 770 / 788 ms |
| 5 | 718 ms | 1.500 / 3.298 ms | 812 / 827 ms |
| 10 | 726 ms | 1.612 / 3.671 ms | 862 / 898 ms |
| 20 | 746 ms | 1.707 / 3.830 ms | 1.029 / 1.158 ms |
| 40 | 758 ms | 2.123 / 4.035 ms | 1.175 / 1.304 ms |
Nada falhou em nenhum nível, e a latência degradou de forma suave: de 1 para 40 chamadas em andamento, a mediana do resume subiu 37% e a mediana do suspend, 53%. O p95 do resume é o primeiro resume de cada task, um boot a partir do golden snapshot do template, em cerca de 3 a 4 segundos; os resumes seguintes restauram o snapshot da própria task e puxam a mediana para baixo. O create mal sentiu a carga: ele registra a task e cria o seu actor no Substrate, sem fazer boot de nada.
Teste 3: Wake on request, e por que os limites de CPU importam
O 04_wake_burst.py acorda tasks suspensas com requisições HTTPS pelo router do Substrate, a partir de um pod que roda com a identidade do ax-server (o router só aceita mTLS dele; veja a parte 2). Primeiro uma task em três tamanhos de CPU, depois bursts:
for cpu in ("50m", "250m", "1"):
    create(nm, cpu=cpu, memory="256Mi"); ax("resume", "task", nm)
    for _ in range(5):
        ax("suspend", "task", nm)
        ms += wake([nm])[0]          # curl time_total from inside the cluster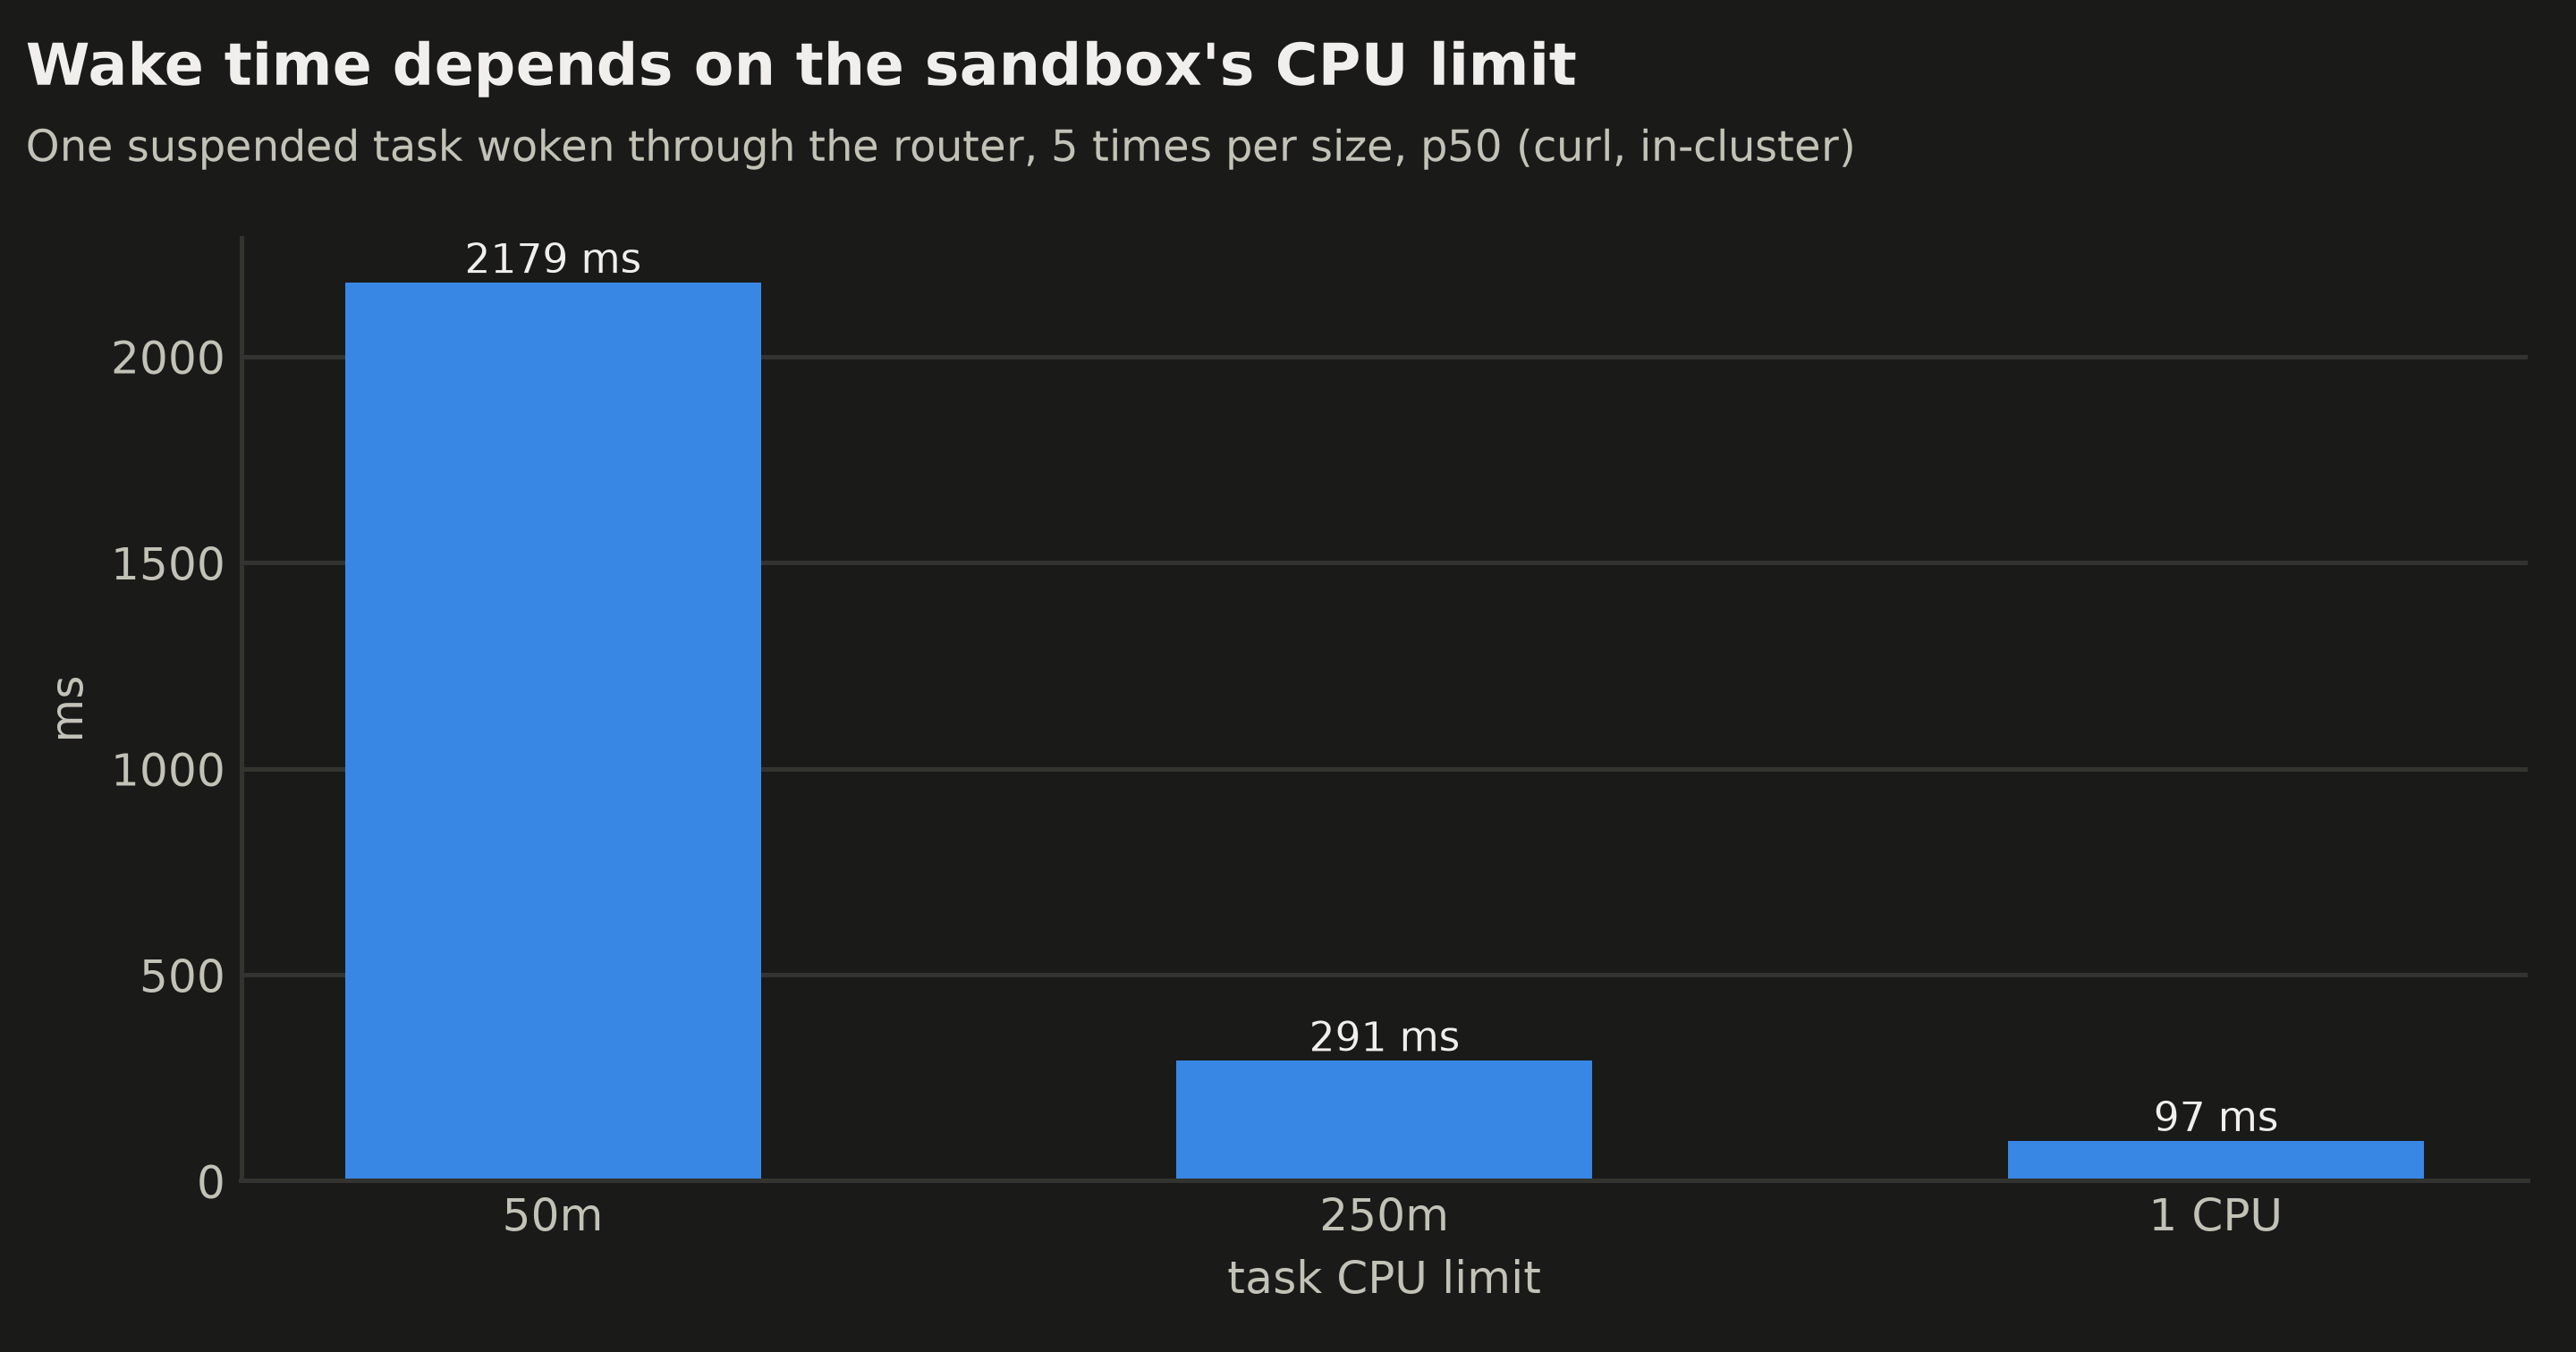
| Limite de CPU da task | Wake p50 (5 wakes) | p95 |
|---|---|---|
| 50m | 2.179 ms | 3.452 ms |
| 250m | 291 ms | 415 ms |
| 1 CPU | 97 ms | 111 ms |
Este foi o resultado mais útil da série. O tempo de wake é, na maior parte, o sandbox fazendo boot do runner do AX, e um limite de CPU estrangula esse boot. Com uma CPU inteira, uma task suspensa respondeu à requisição em cerca de 100 ms (mediana); com 50 millicores, em cerca de dois segundos. É o mesmo trade-off que o teste de densidade esconde: dá para colocar 151 tasks de 50m, mas cada uma acorda vinte vezes mais devagar que uma task de 1 CPU, das quais cabem só seis. Os 220 ms do teste de campo e o abaixo de 500 ms do Google ficam ambos dentro dessa faixa; nenhum dos dois diz qual CPU o agente tinha.
Bursts com 250m:
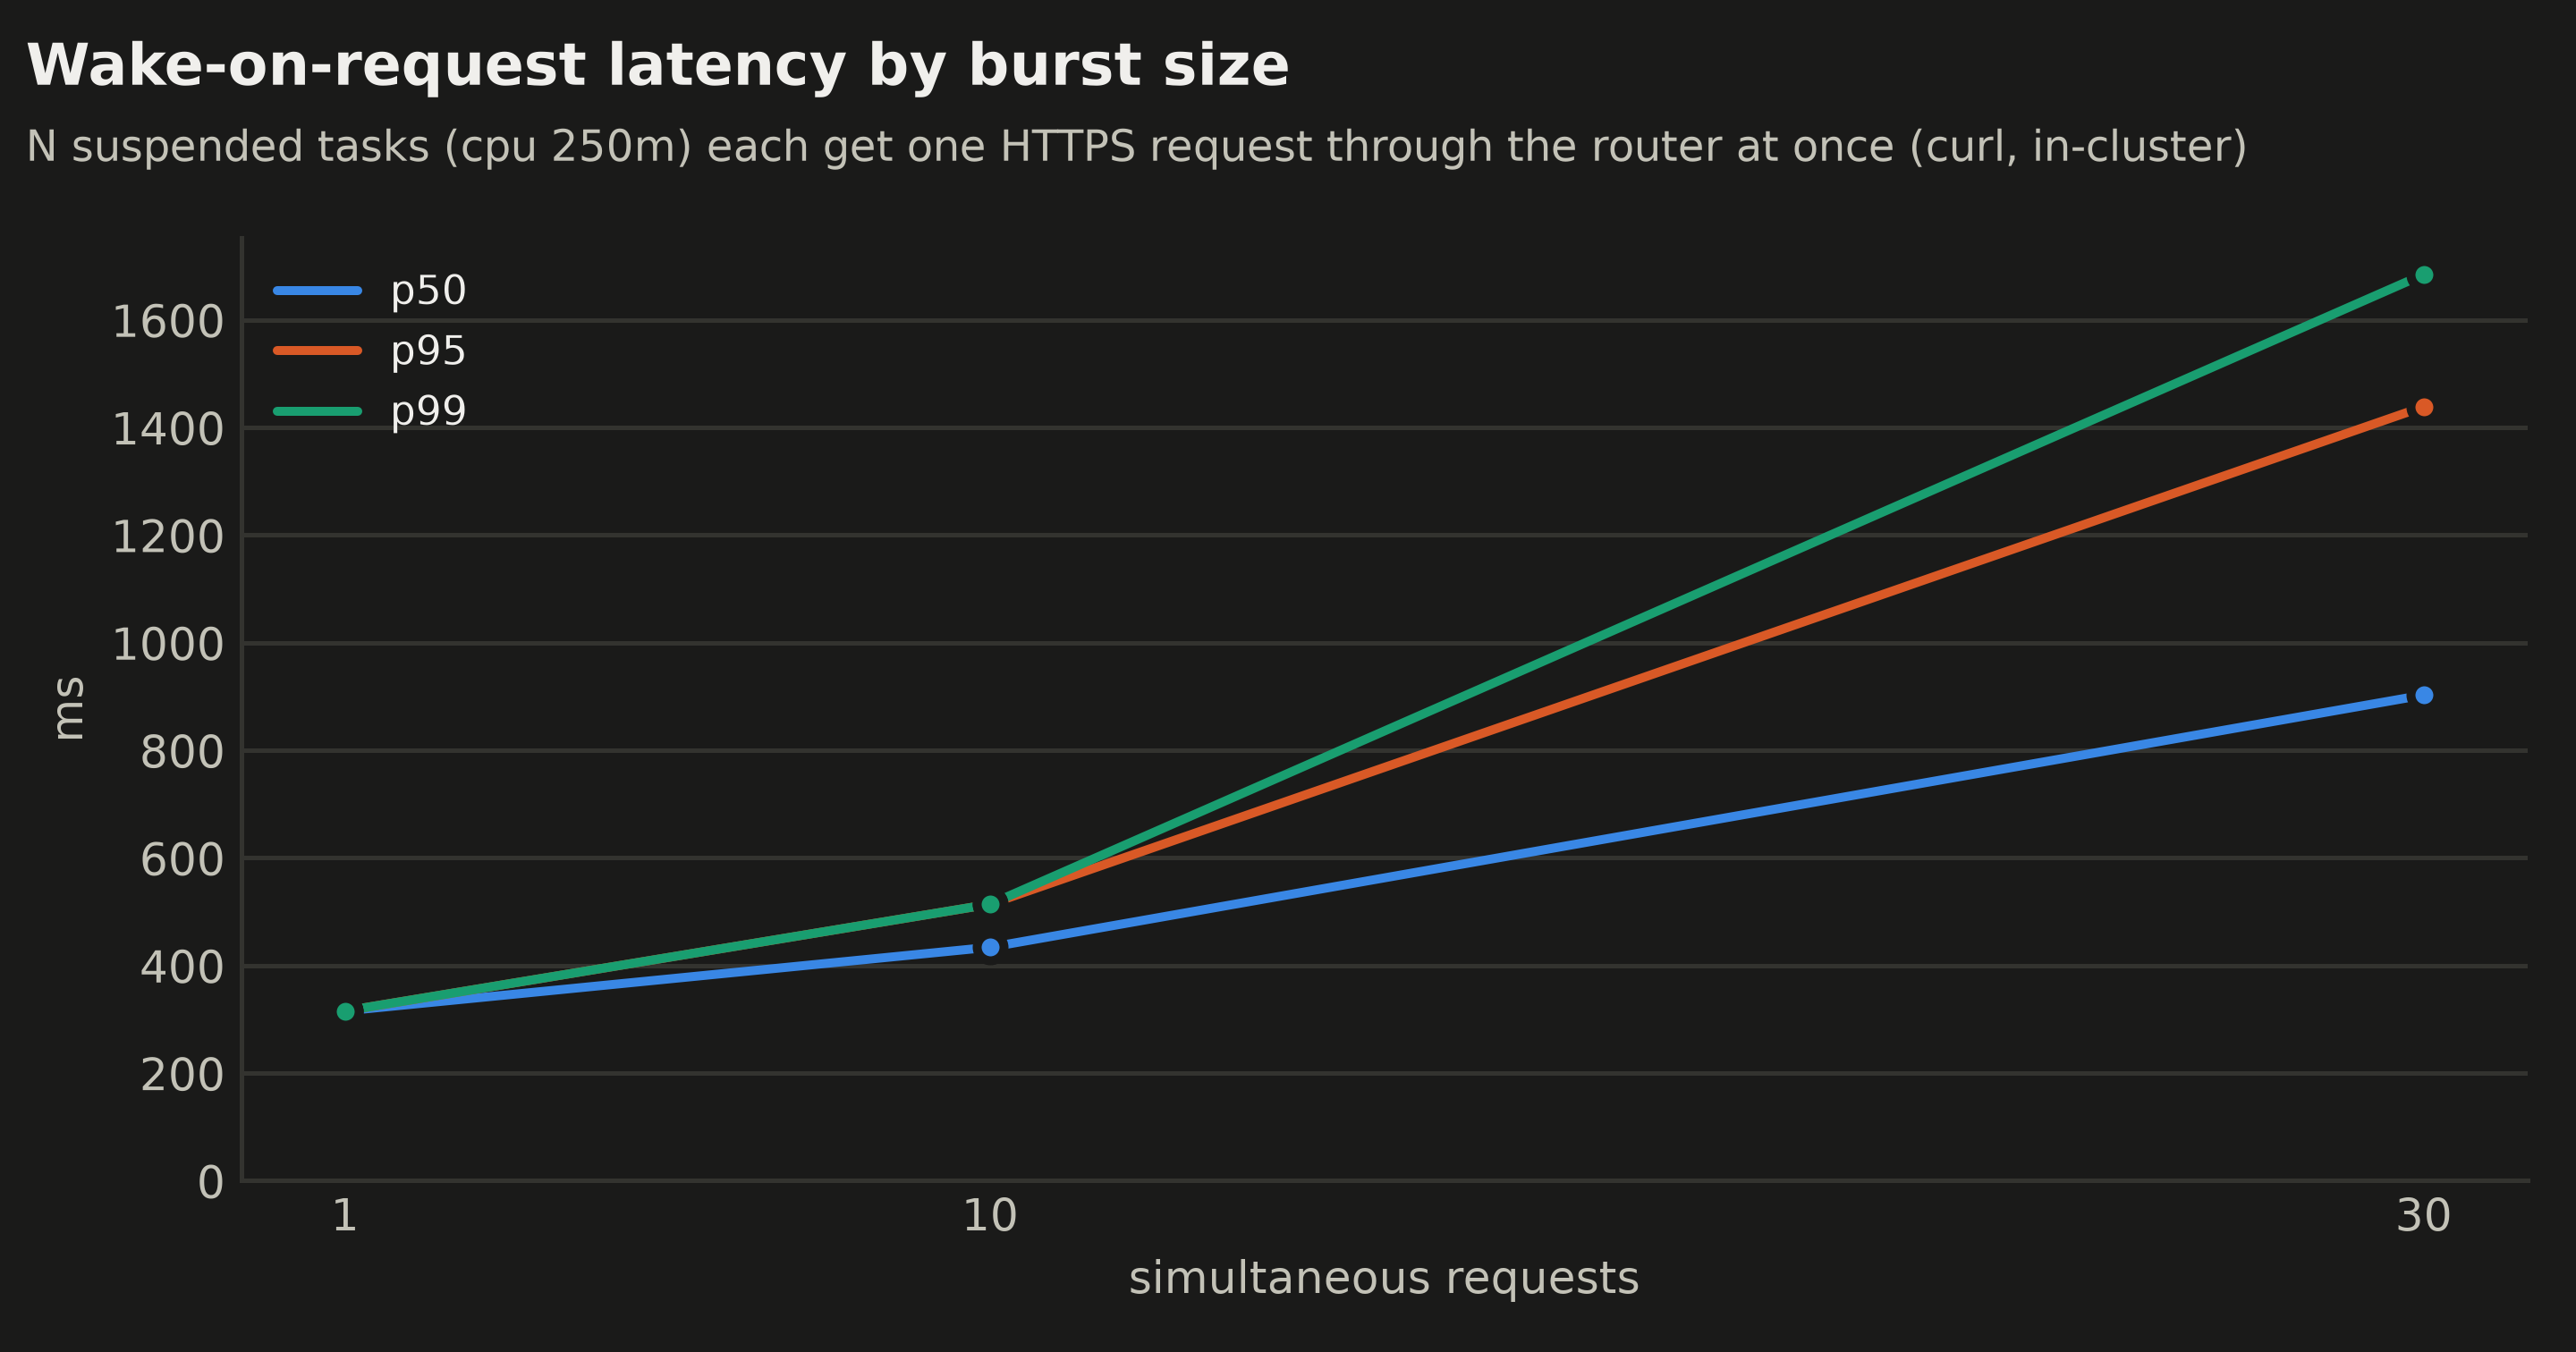
| Requisições simultâneas | p50 | p95 | p99 | Erros |
|---|---|---|---|---|
| 1 | 316 ms | 316 ms | 316 ms | 0 |
| 10 | 434 ms | 514 ms | 514 ms | 0 |
| 30 | 903 ms | 1.439 ms | 1.684 ms | 0 |
Trinta wakes simultâneos tiveram sucesso, com o mais lento abaixo de 1,7 s. Em uma execução anterior, contaminada por cerca de cem tasks remanescentes, um burst de 60 recebeu alguns 503s: com o cluster cheio, o router segura uma requisição que bate em “no worker has room” por até 5 segundos e depois desiste.
Teste 4: Carga no control plane
O 05_control_plane.py passa 120 tasks minúsculas (cpu 25m) por create, resume, suspend e delete com 20 chamadas em andamento, enquanto o sampler registra o control plane a cada poucos segundos:
== create 120 tasks, 20 at a time
  120 ok, 0 failed, 4.5 s wall, 26.4 creates/s
== resume 120 tasks, 20 at a time
  resume: n=120 p50 6305 ms, p95 7528, p99 7982
  120 ok, 0 failed, 40.7 s wall, 3.0 resumes/s
== suspend 120 tasks, 20 at a time
  120 ok, 0 failed, 6.1 s wall, 19.7 suspends/s
== delete 120 tasks, 20 at a time
  120 ok, 0 failed, 5.4 s wall, 22.4 deletes/s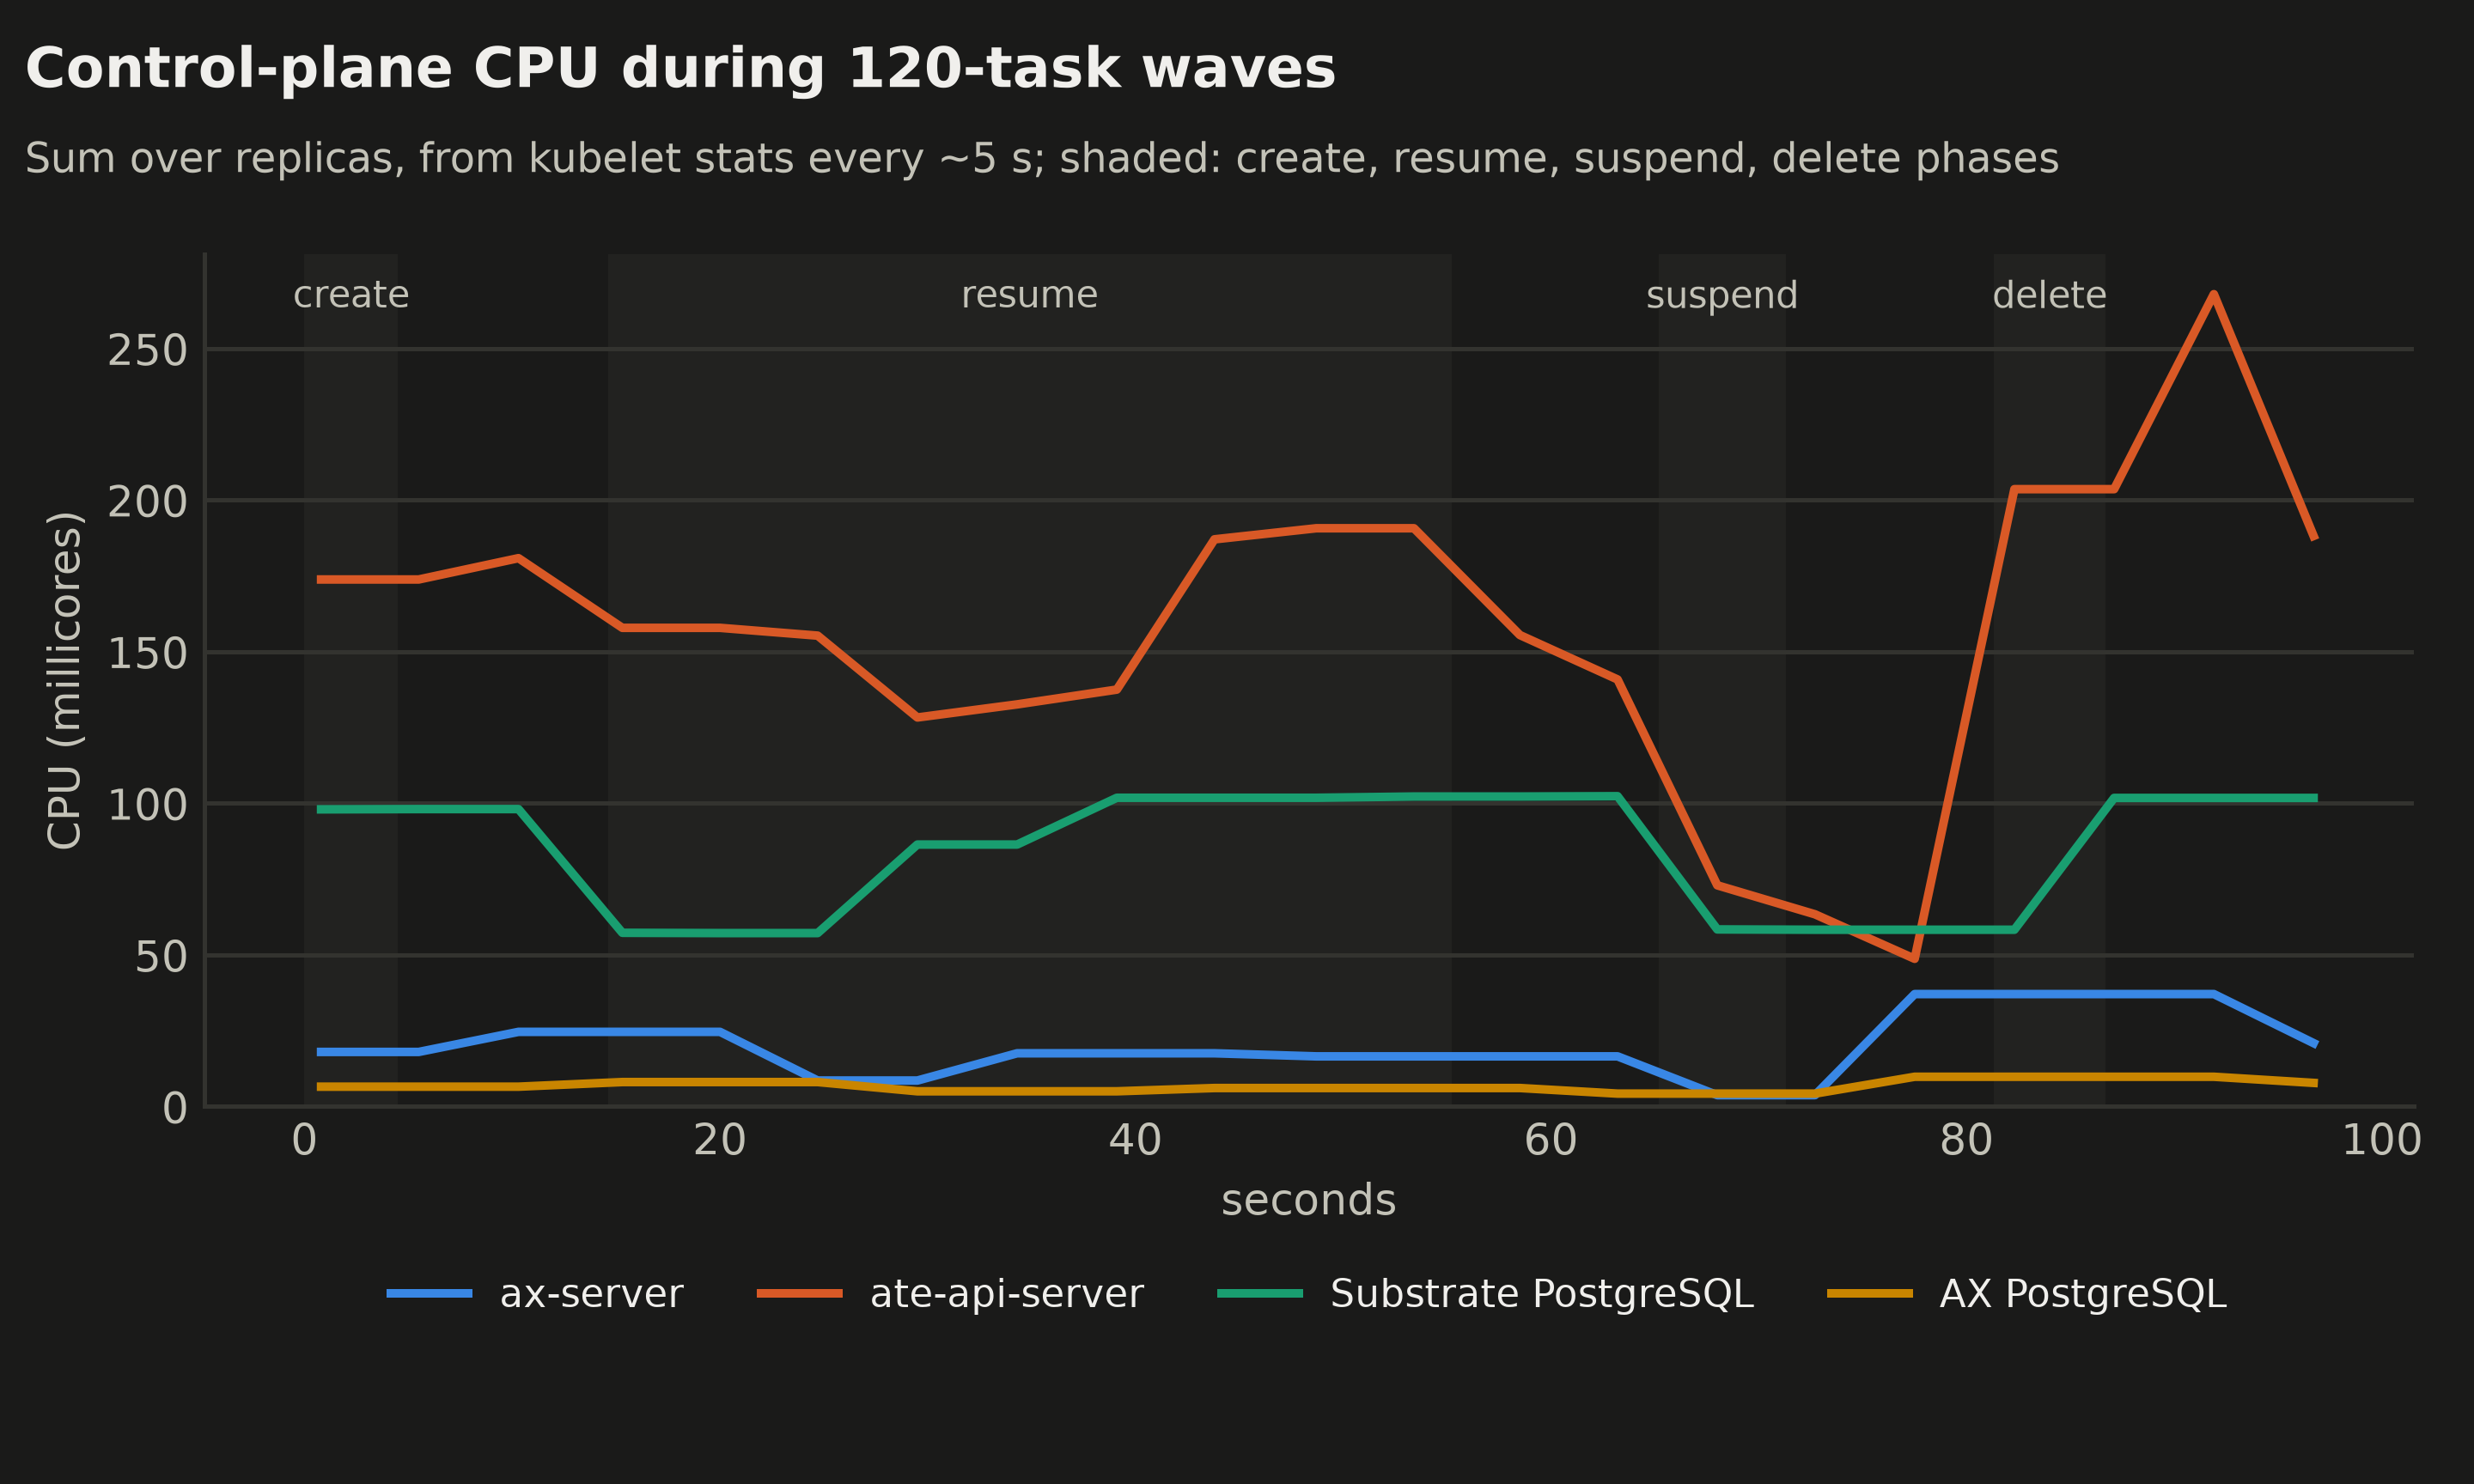
| Fase | Throughput | p50 | Pico de CPU do control plane |
|---|---|---|---|
| Create | 26,4 /s | 728 ms | ate-api-server ~180m |
| Resume (primeiro, tasks de 25m) | 3,0 /s | 6.305 ms | ate-api-server ~190m, PostgreSQL do Substrate ~100m |
| Suspend | 19,7 /s | 920 ms | ate-api-server ~75m |
| Delete | 22,4 /s | 848 ms | ate-api-server ~200m |
O control plane nunca foi o gargalo. O ate-api-server teve pico de cerca de um terço de core, o PostgreSQL do Substrate de um décimo, o ax-server abaixo de 40 millicores e o próprio PostgreSQL do AX em torno de 10; os quatro juntos ficaram em torno de meio core. O throughput de resume (3 por segundo) foi definido pelos sandboxes: 120 primeiros boots com 25 millicores cada. Então não consigo confirmar nem refutar “mais de 500 ativações por segundo”; em dois nodes, pela CLI do AX, os sandboxes se esgotam muito antes da API do Substrate. O README do Substrate vai além, com 1.500 ativações por segundo; o único cenário de benchmark no repo que chega a essa taxa substitui o data plane por um fake, o que mediria exatamente a parte que não era o meu limite.
Teste 5: Noisy neighbors
O 06_noisy.py inicia seis tasks vítimas (cpu 250m), cada uma rodando um benchmark fixo de CPU e uma escrita de 64 MB com fsync, depois adiciona quatro vizinhos de cada tipo e mede de novo:
HOGS = {
    "cpu": (["sh", "-c", "for i in 1 2; do (while :; do :; done) & done; wait"], {"cpu": "1"}),
    "disk": (["sh", "-c", "while :; do dd if=/dev/zero of=/workspace/fill bs=1M count=512 conv=fsync; done"], {"cpu": "500m"}),
    "memory": (["python3", "-c", "b=[]\nwhile True: b.append(bytearray(64*2**20))"], {"memory": "512Mi"}),
}  # abbreviated: each hog also sets cpu, see 06_noisy.py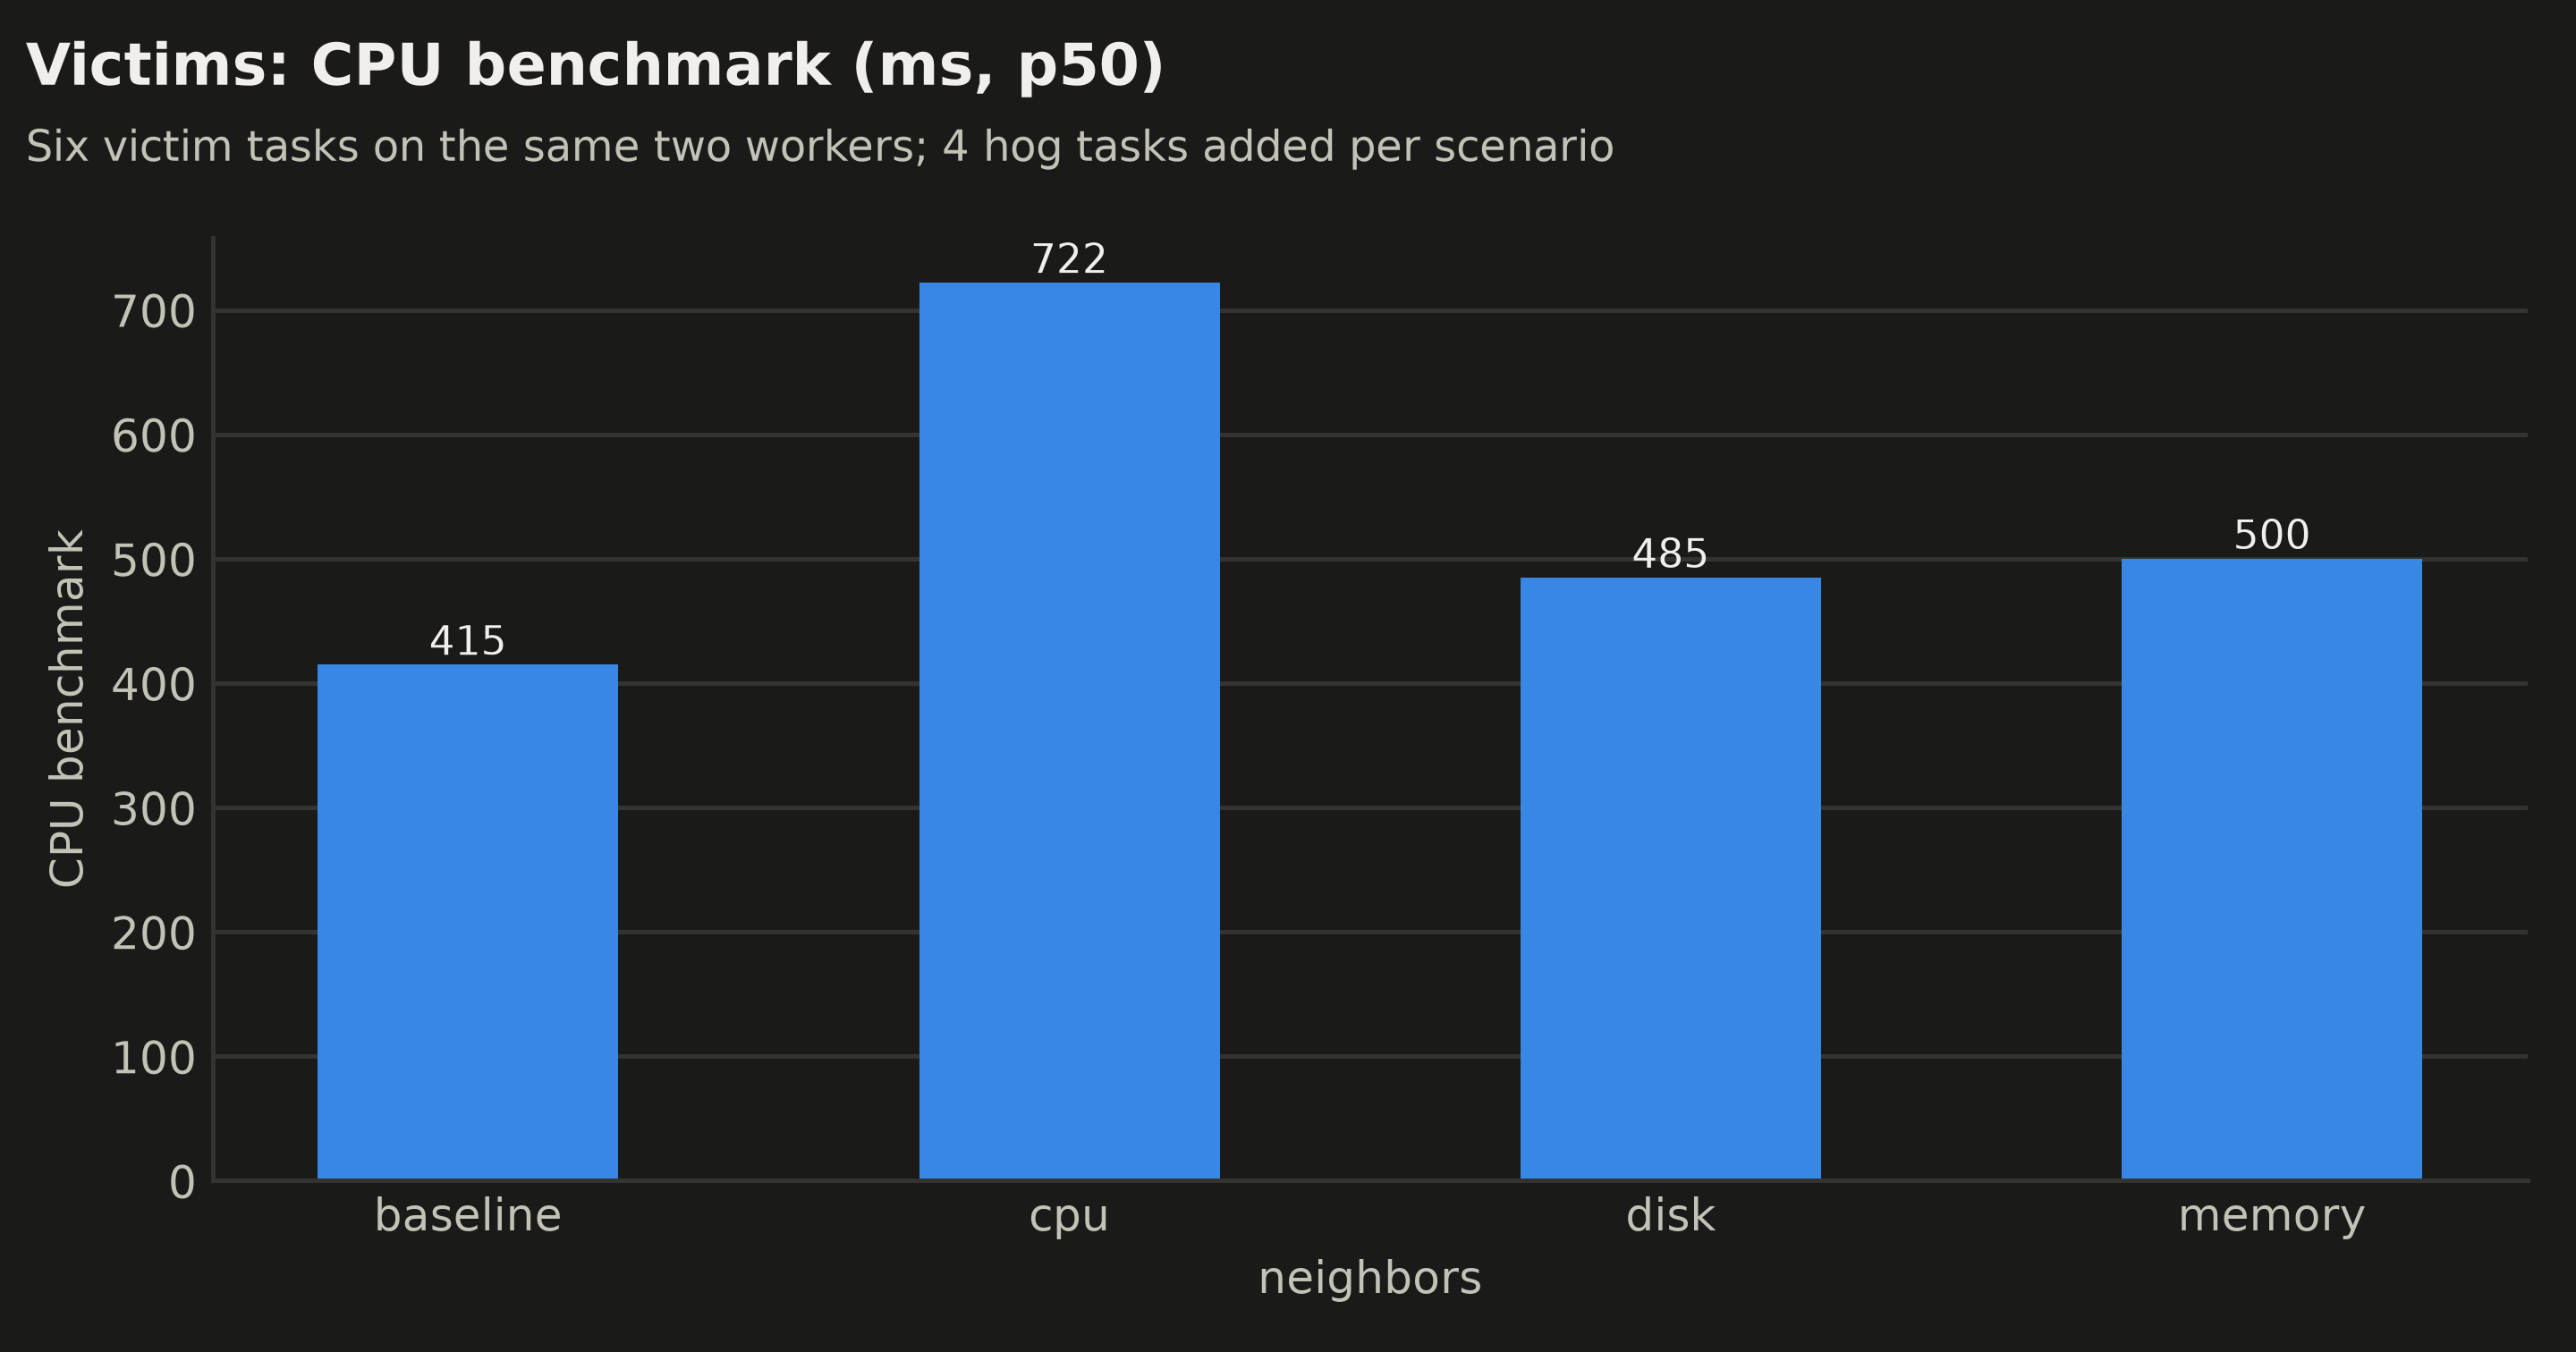
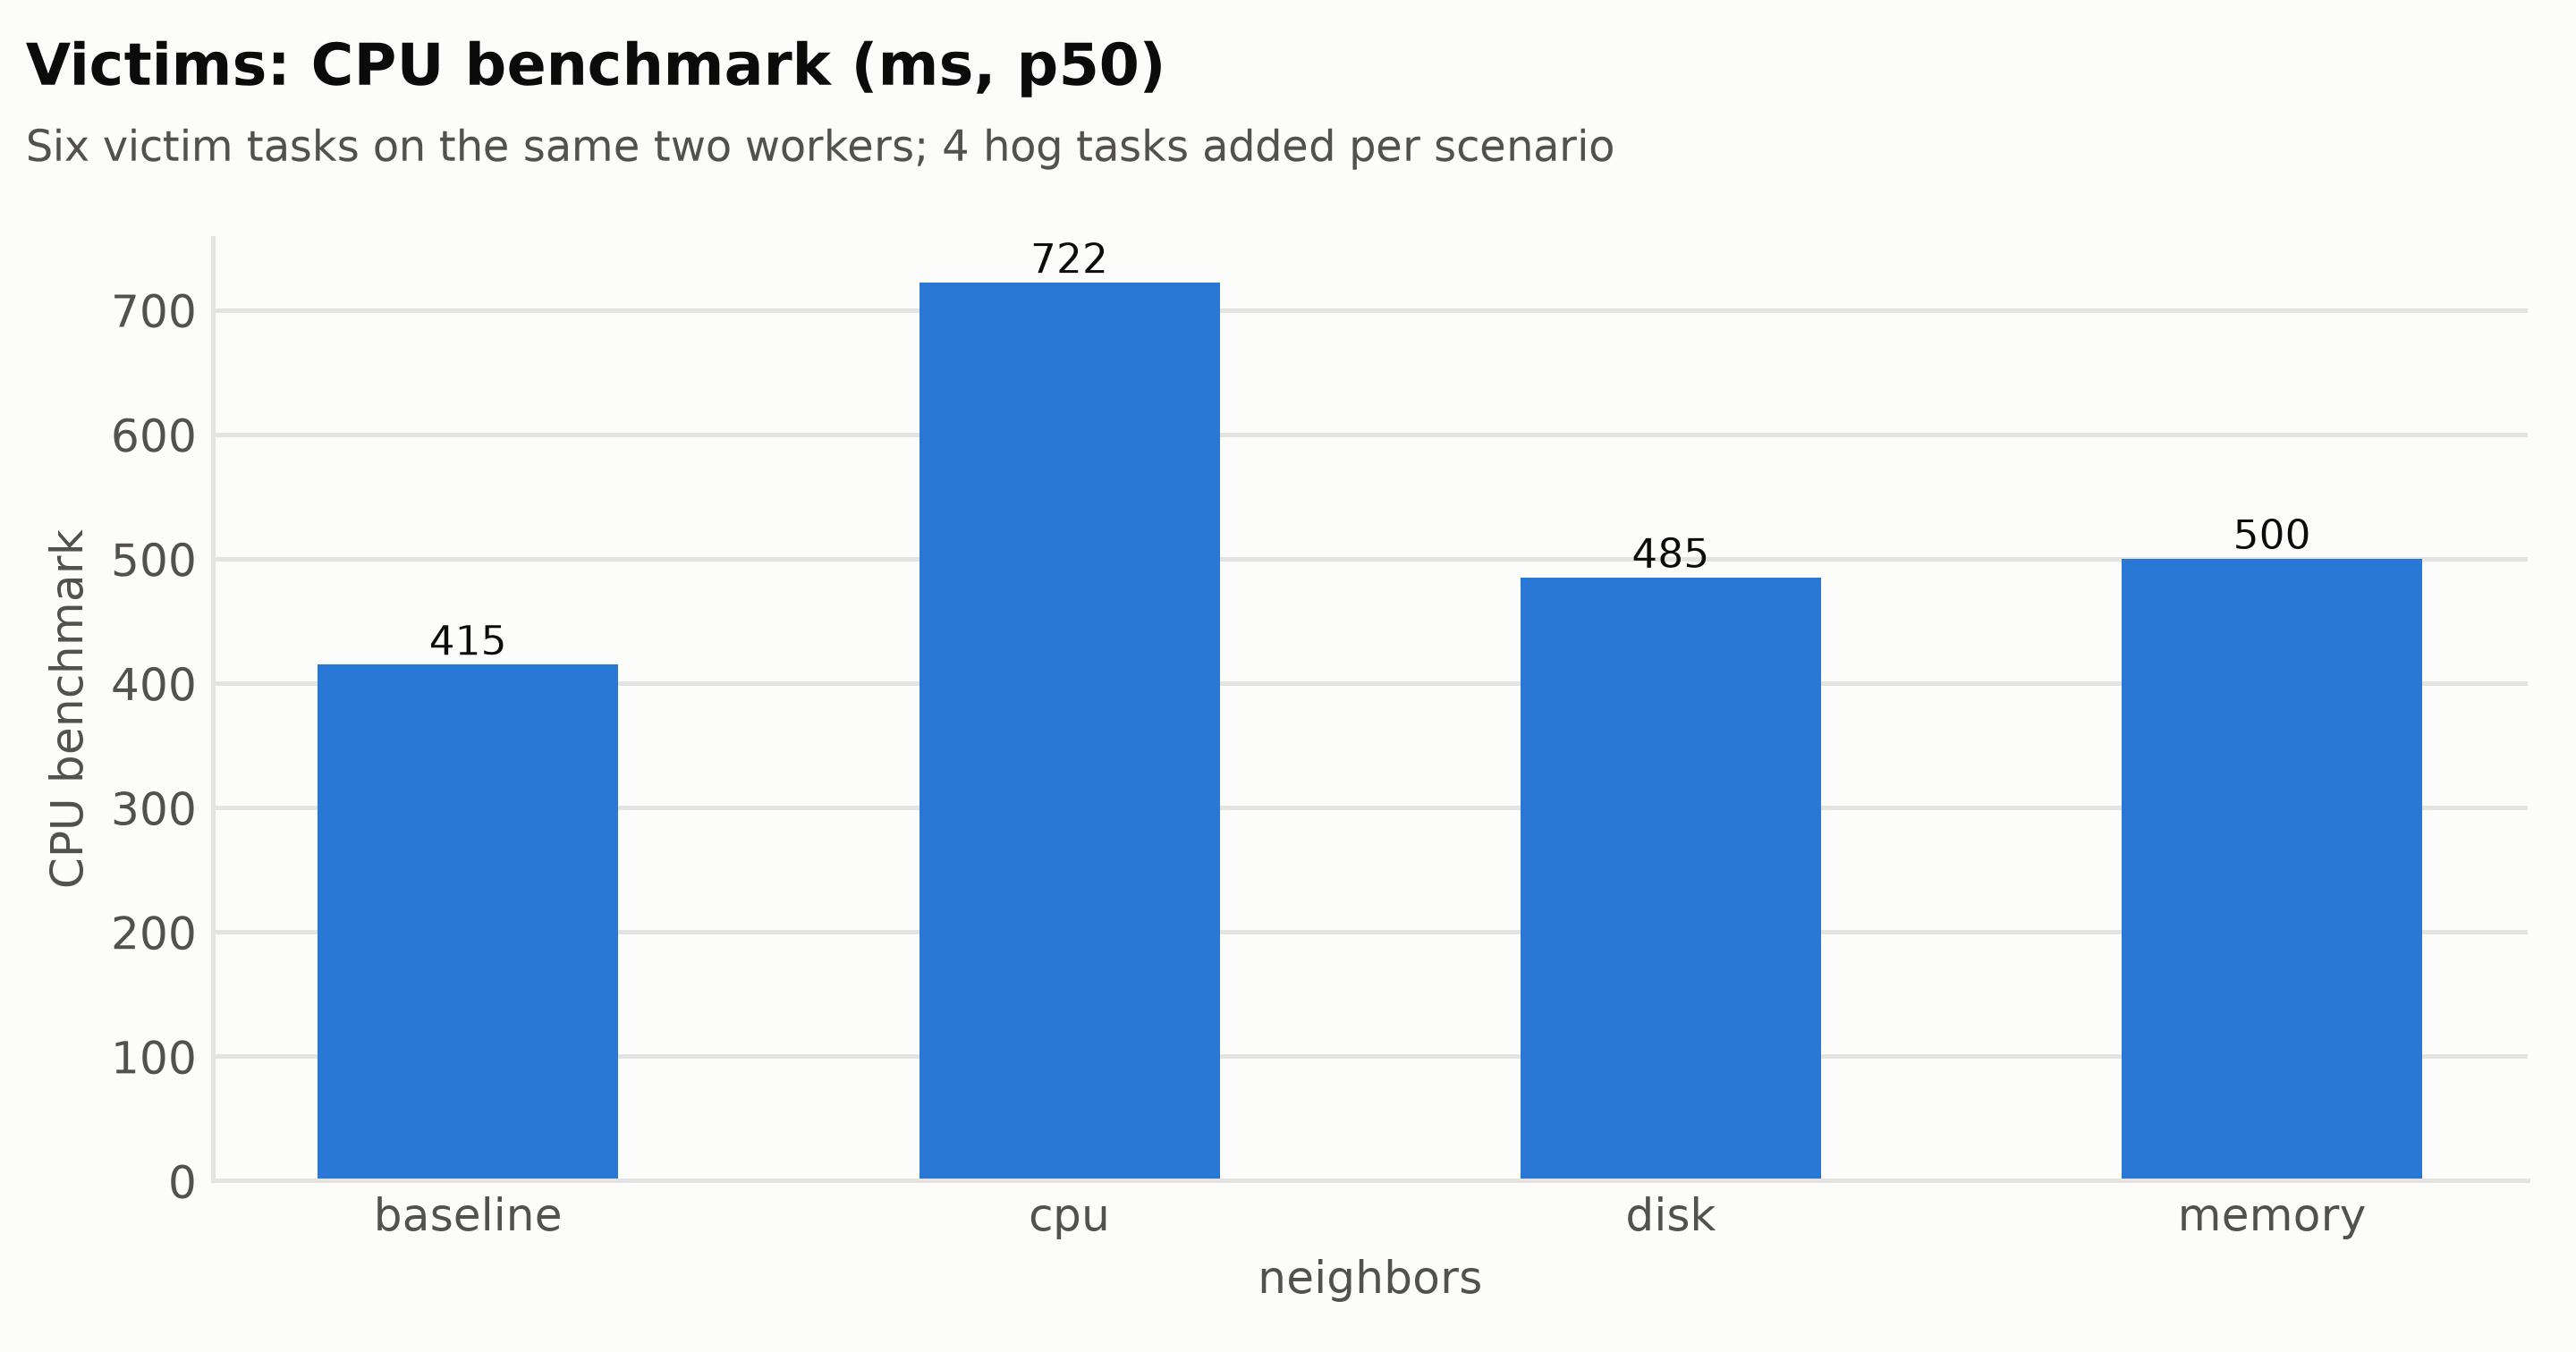
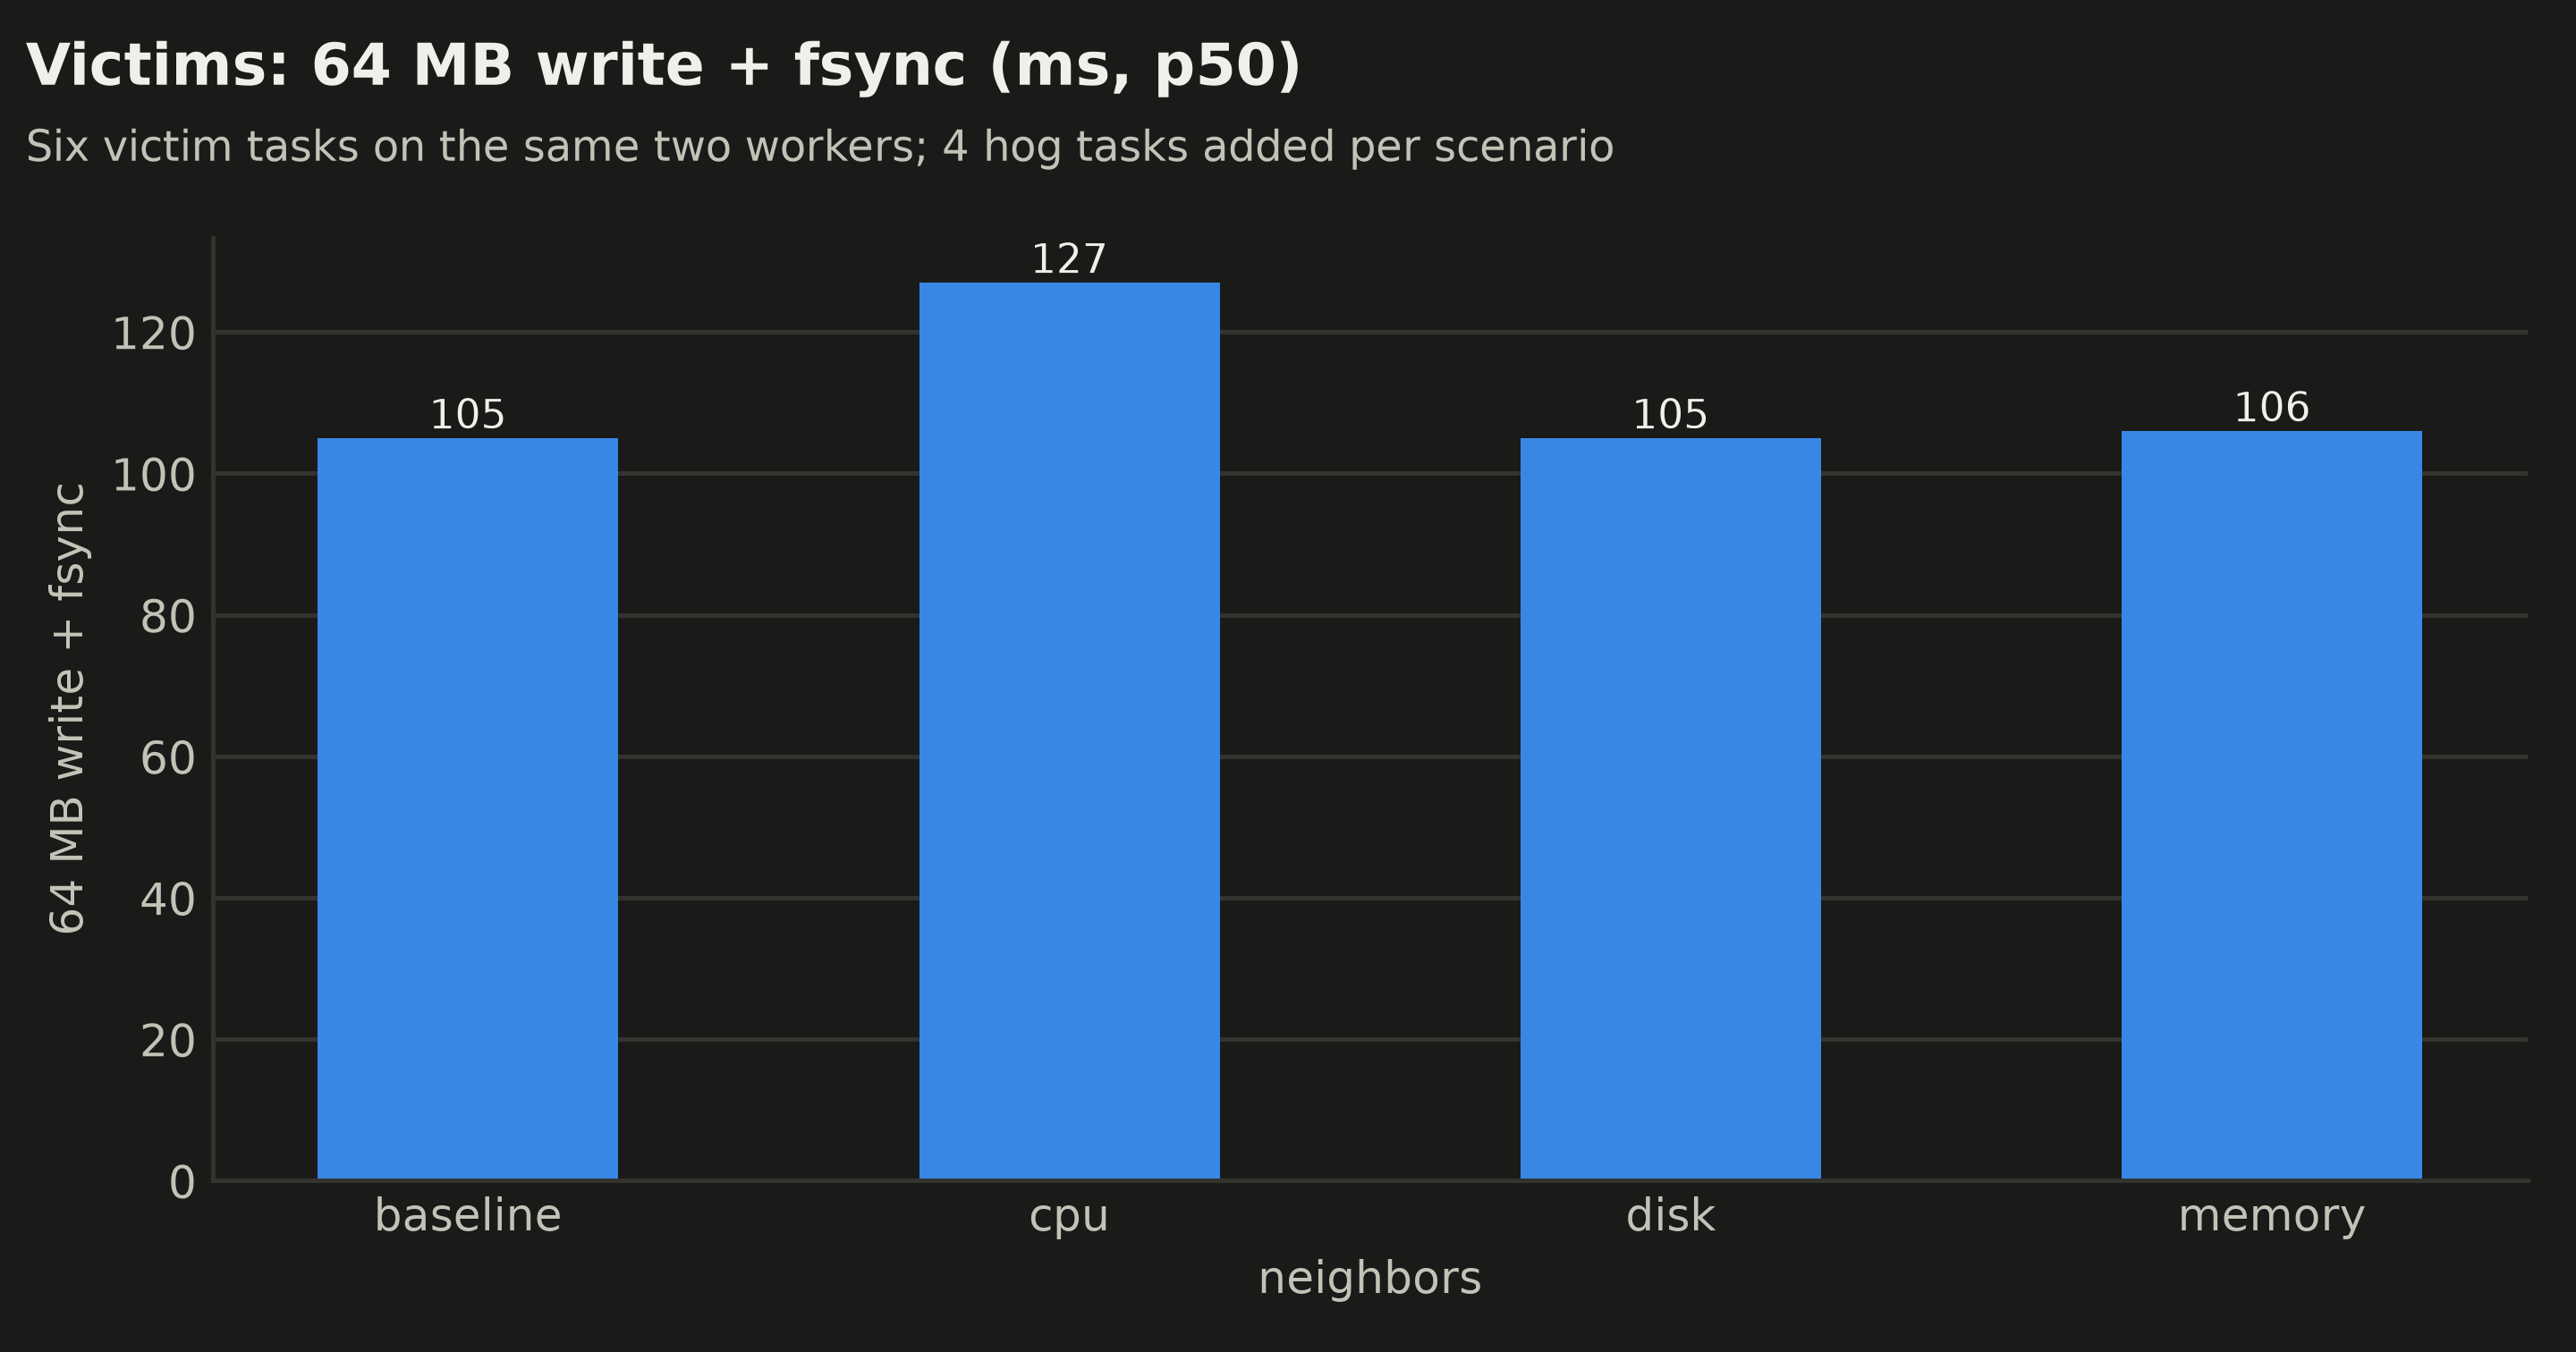
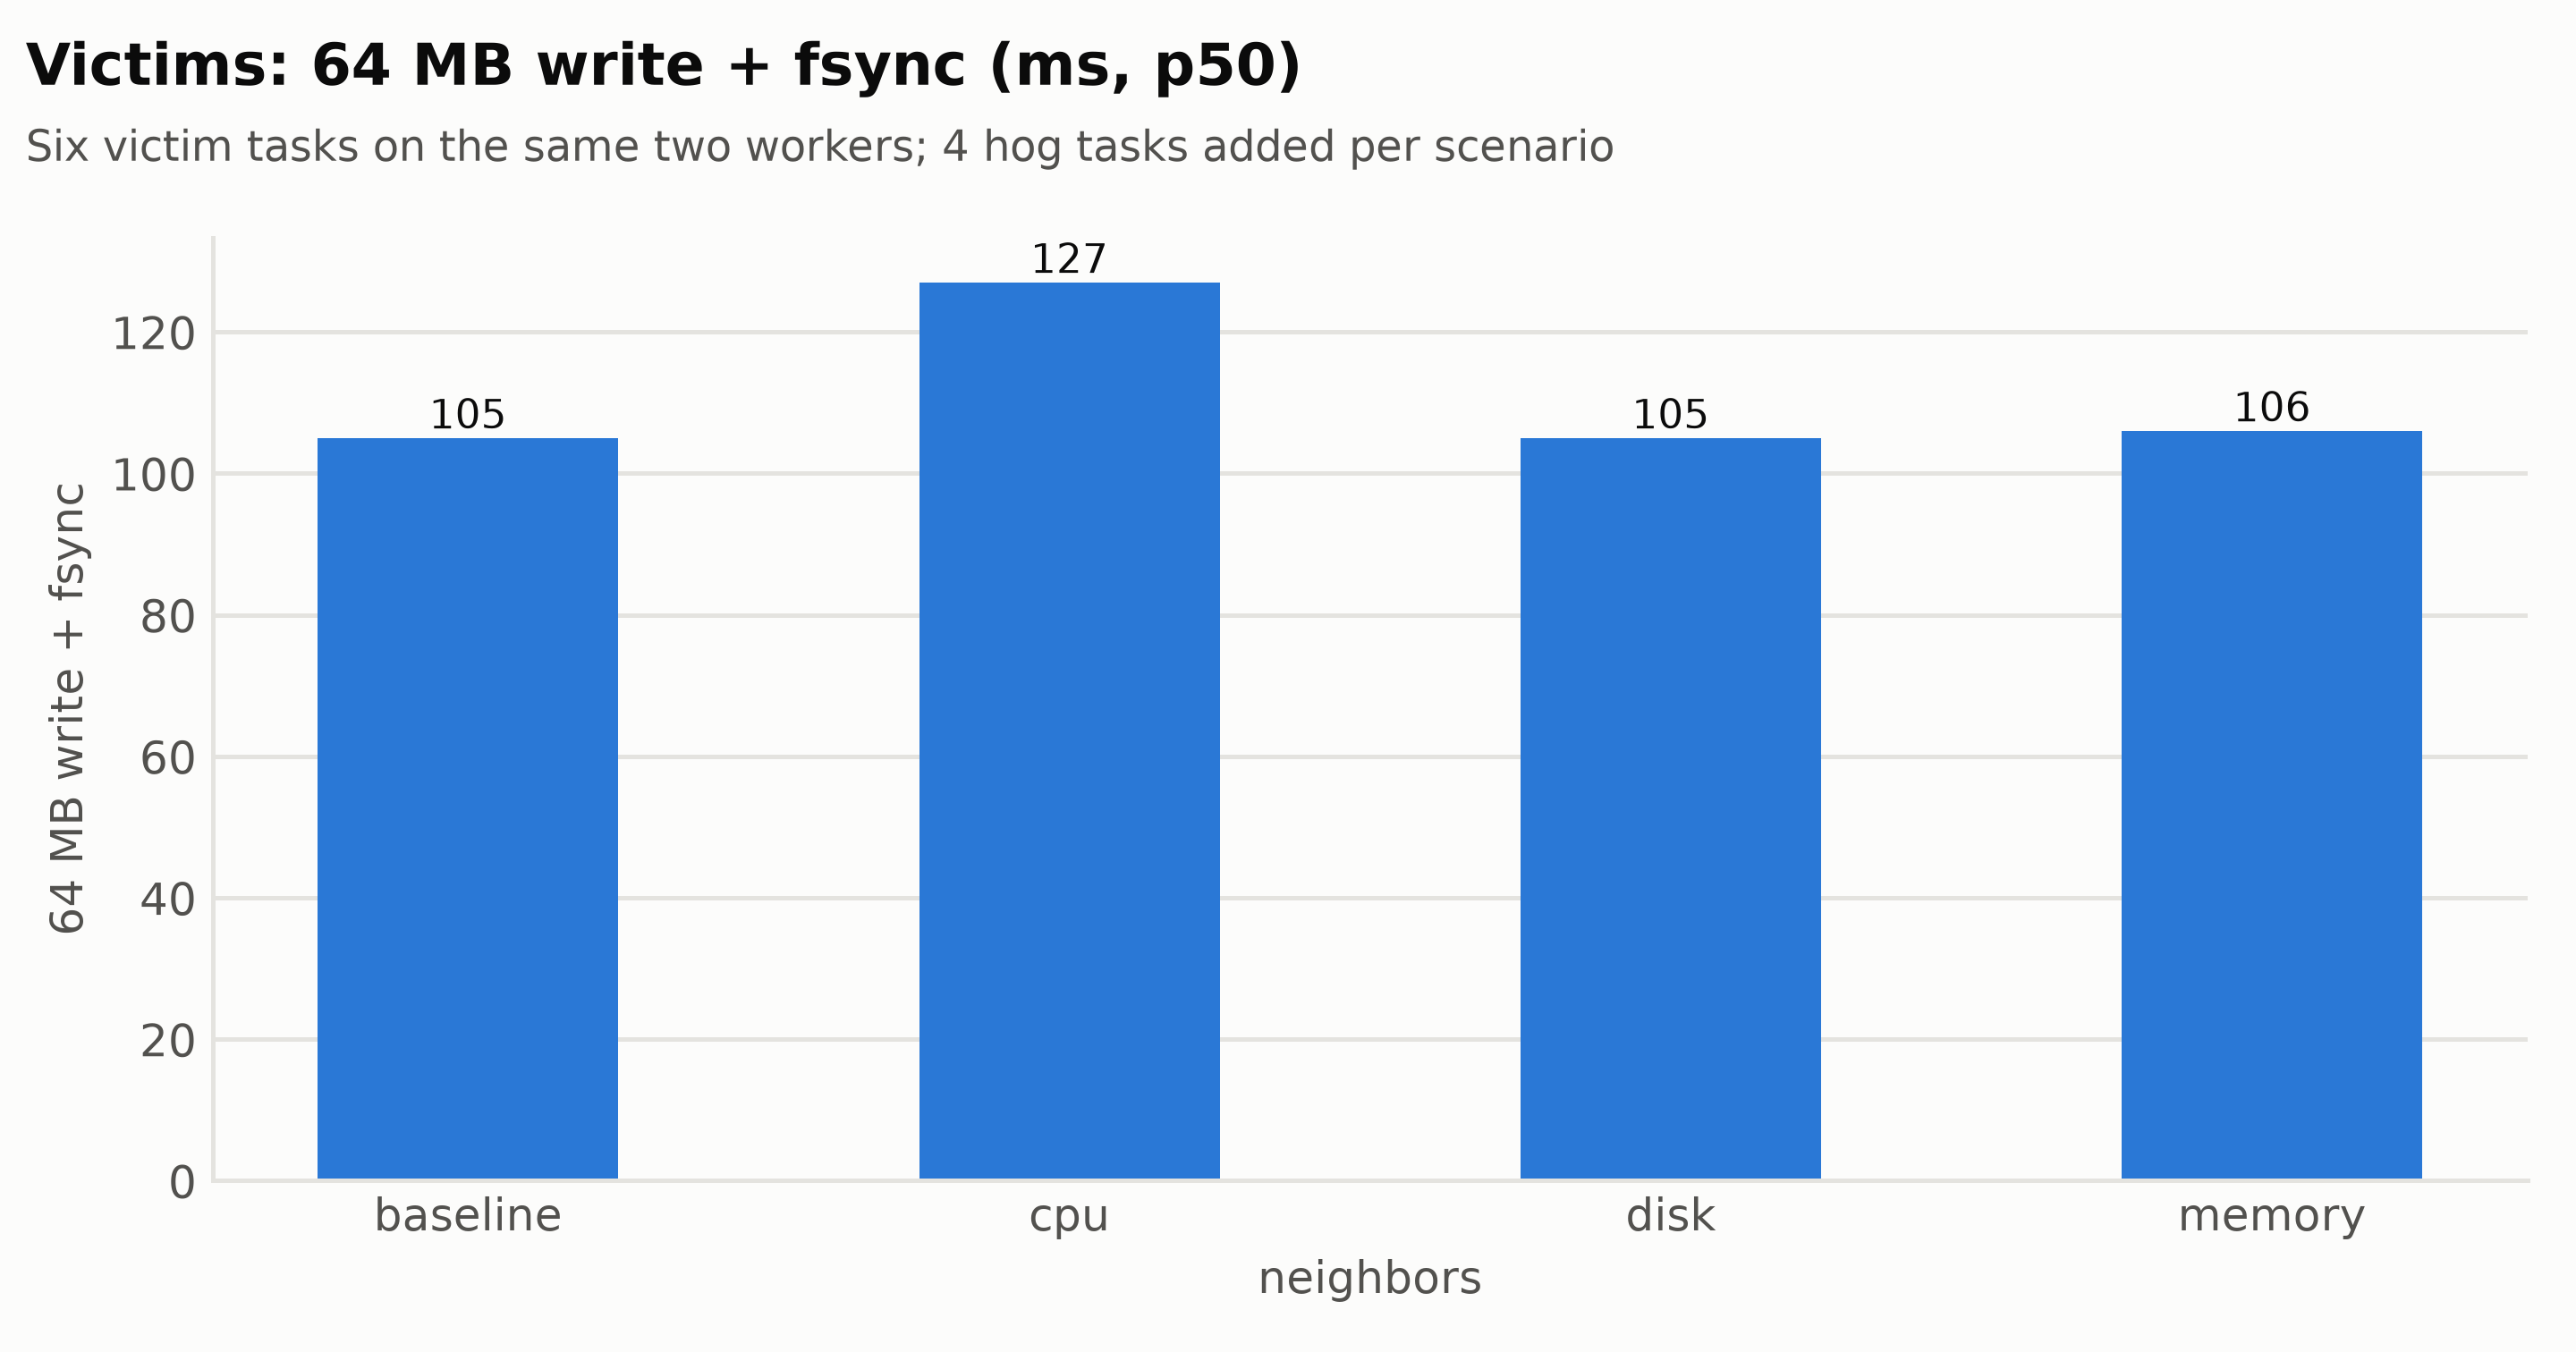
| Vizinhos | Benchmark de CPU p50 | Escrita + fsync p50 / p95 | Suspend p50 / p95 |
|---|---|---|---|
| Nenhum | 415 ms | 105 / 192 ms | 1.805 / 1.836 ms |
| 4 CPU hogs (1 CPU cada) | 722 ms | 127 / 180 ms | 1.329 / 1.753 ms |
| 4 disk hogs | 485 ms | 105 / 1.097 ms | 1.295 / 3.543 ms |
| 4 memory hogs (512Mi, alocando sem parar) | 500 ms | 106 / 191 ms | 1.654 / 1.825 ms |
Limites de CPU são um teto, não uma garantia. Cada vítima estava limitada a 250 millicores, mas com quatro vizinhos queimando CPU o seu benchmark fixo levou 74% mais tempo. Os limites que o Substrate aplica impedem que um sandbox pegue mais do que a sua parte; eles não reservam essa parte para ele quando o node está ocupado. Os disk hogs não afetaram a mediana da escrita, mas estouraram a cauda: o p95 das escritas foi de 192 ms para 1,1 s, e o p95 do suspend de uma vítima, que copia o seu workspace, para 3,5 s. Os memory hogs pouco afetaram os vizinhos; o limite de memória do sandbox segurou, e o AX continuou reportando os hogs como Running.
Teste 6: Tempestade de snapshots
O 07_snapshot_storm.py faz 20 tasks escreverem 100 MB de dados aleatórios cada, suspende todas de uma vez e acompanha o registro do Substrate até que todos os snapshots estejam duráveis no S3:
== suspend all 20 at once
  suspend: n=20 p50 1124 ms, p95 1879, p99 1879, max 1879
== wait for every snapshot to be durable in S3
  +   5s   0/20 durable
  ...
  + 300s   0/20 durable
  + 325s  20/20 durable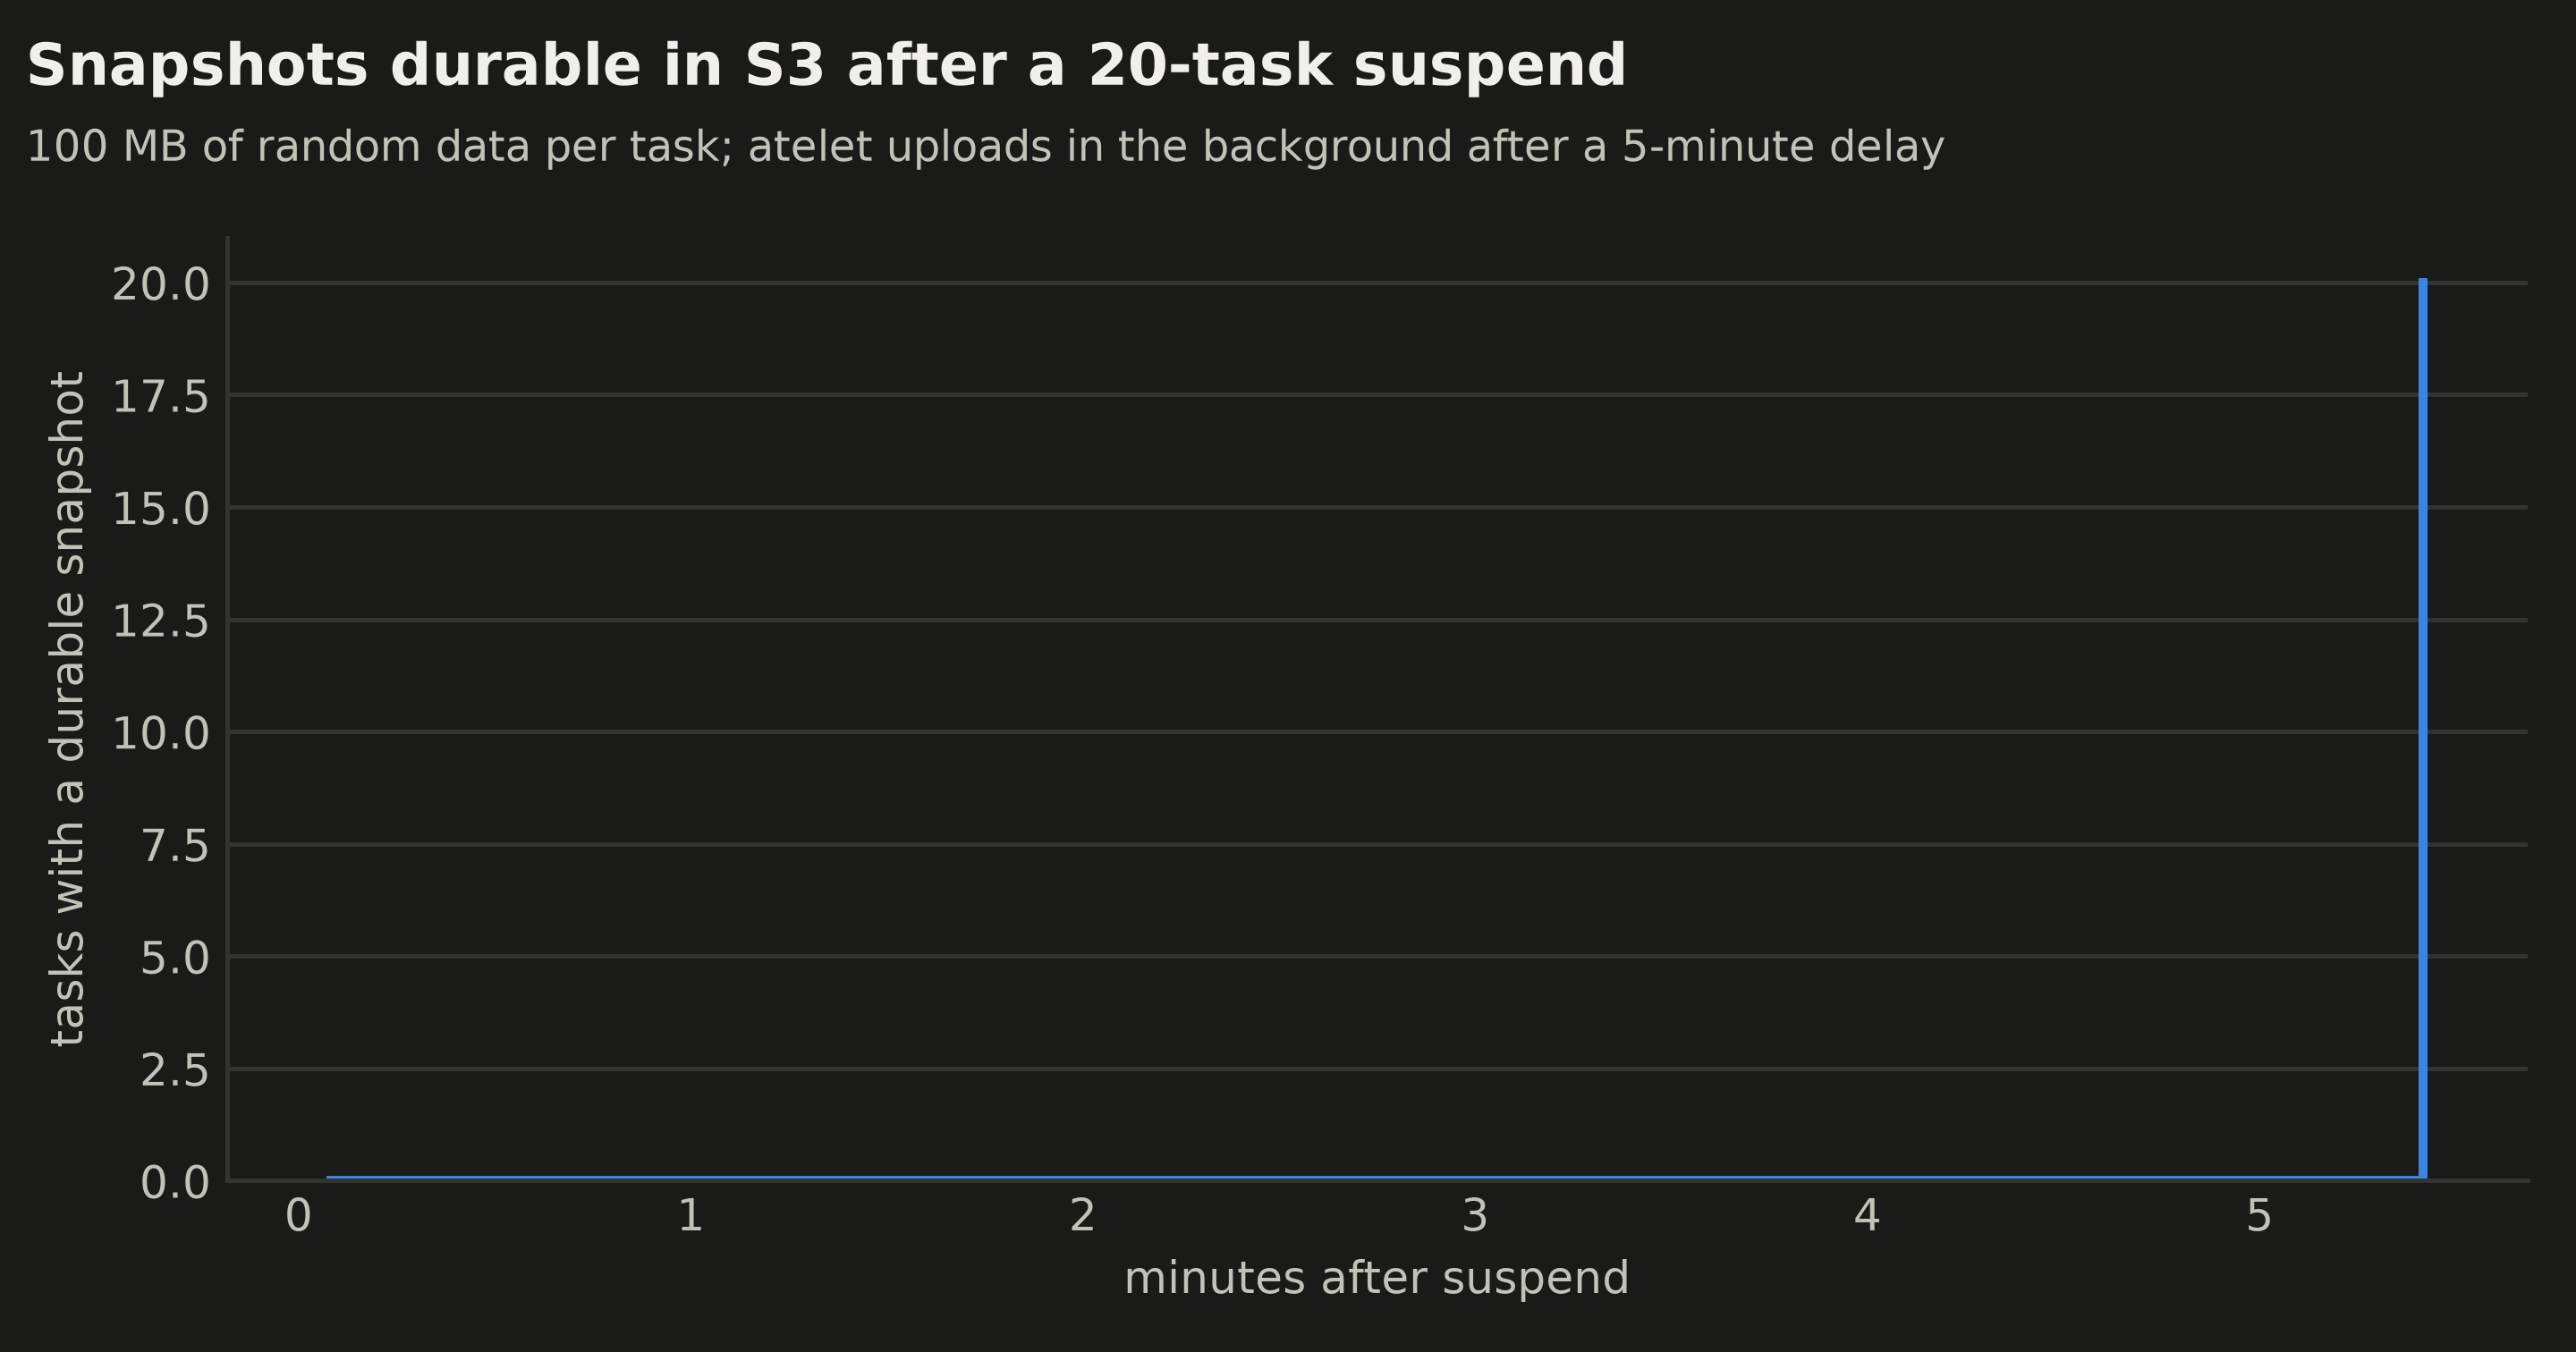
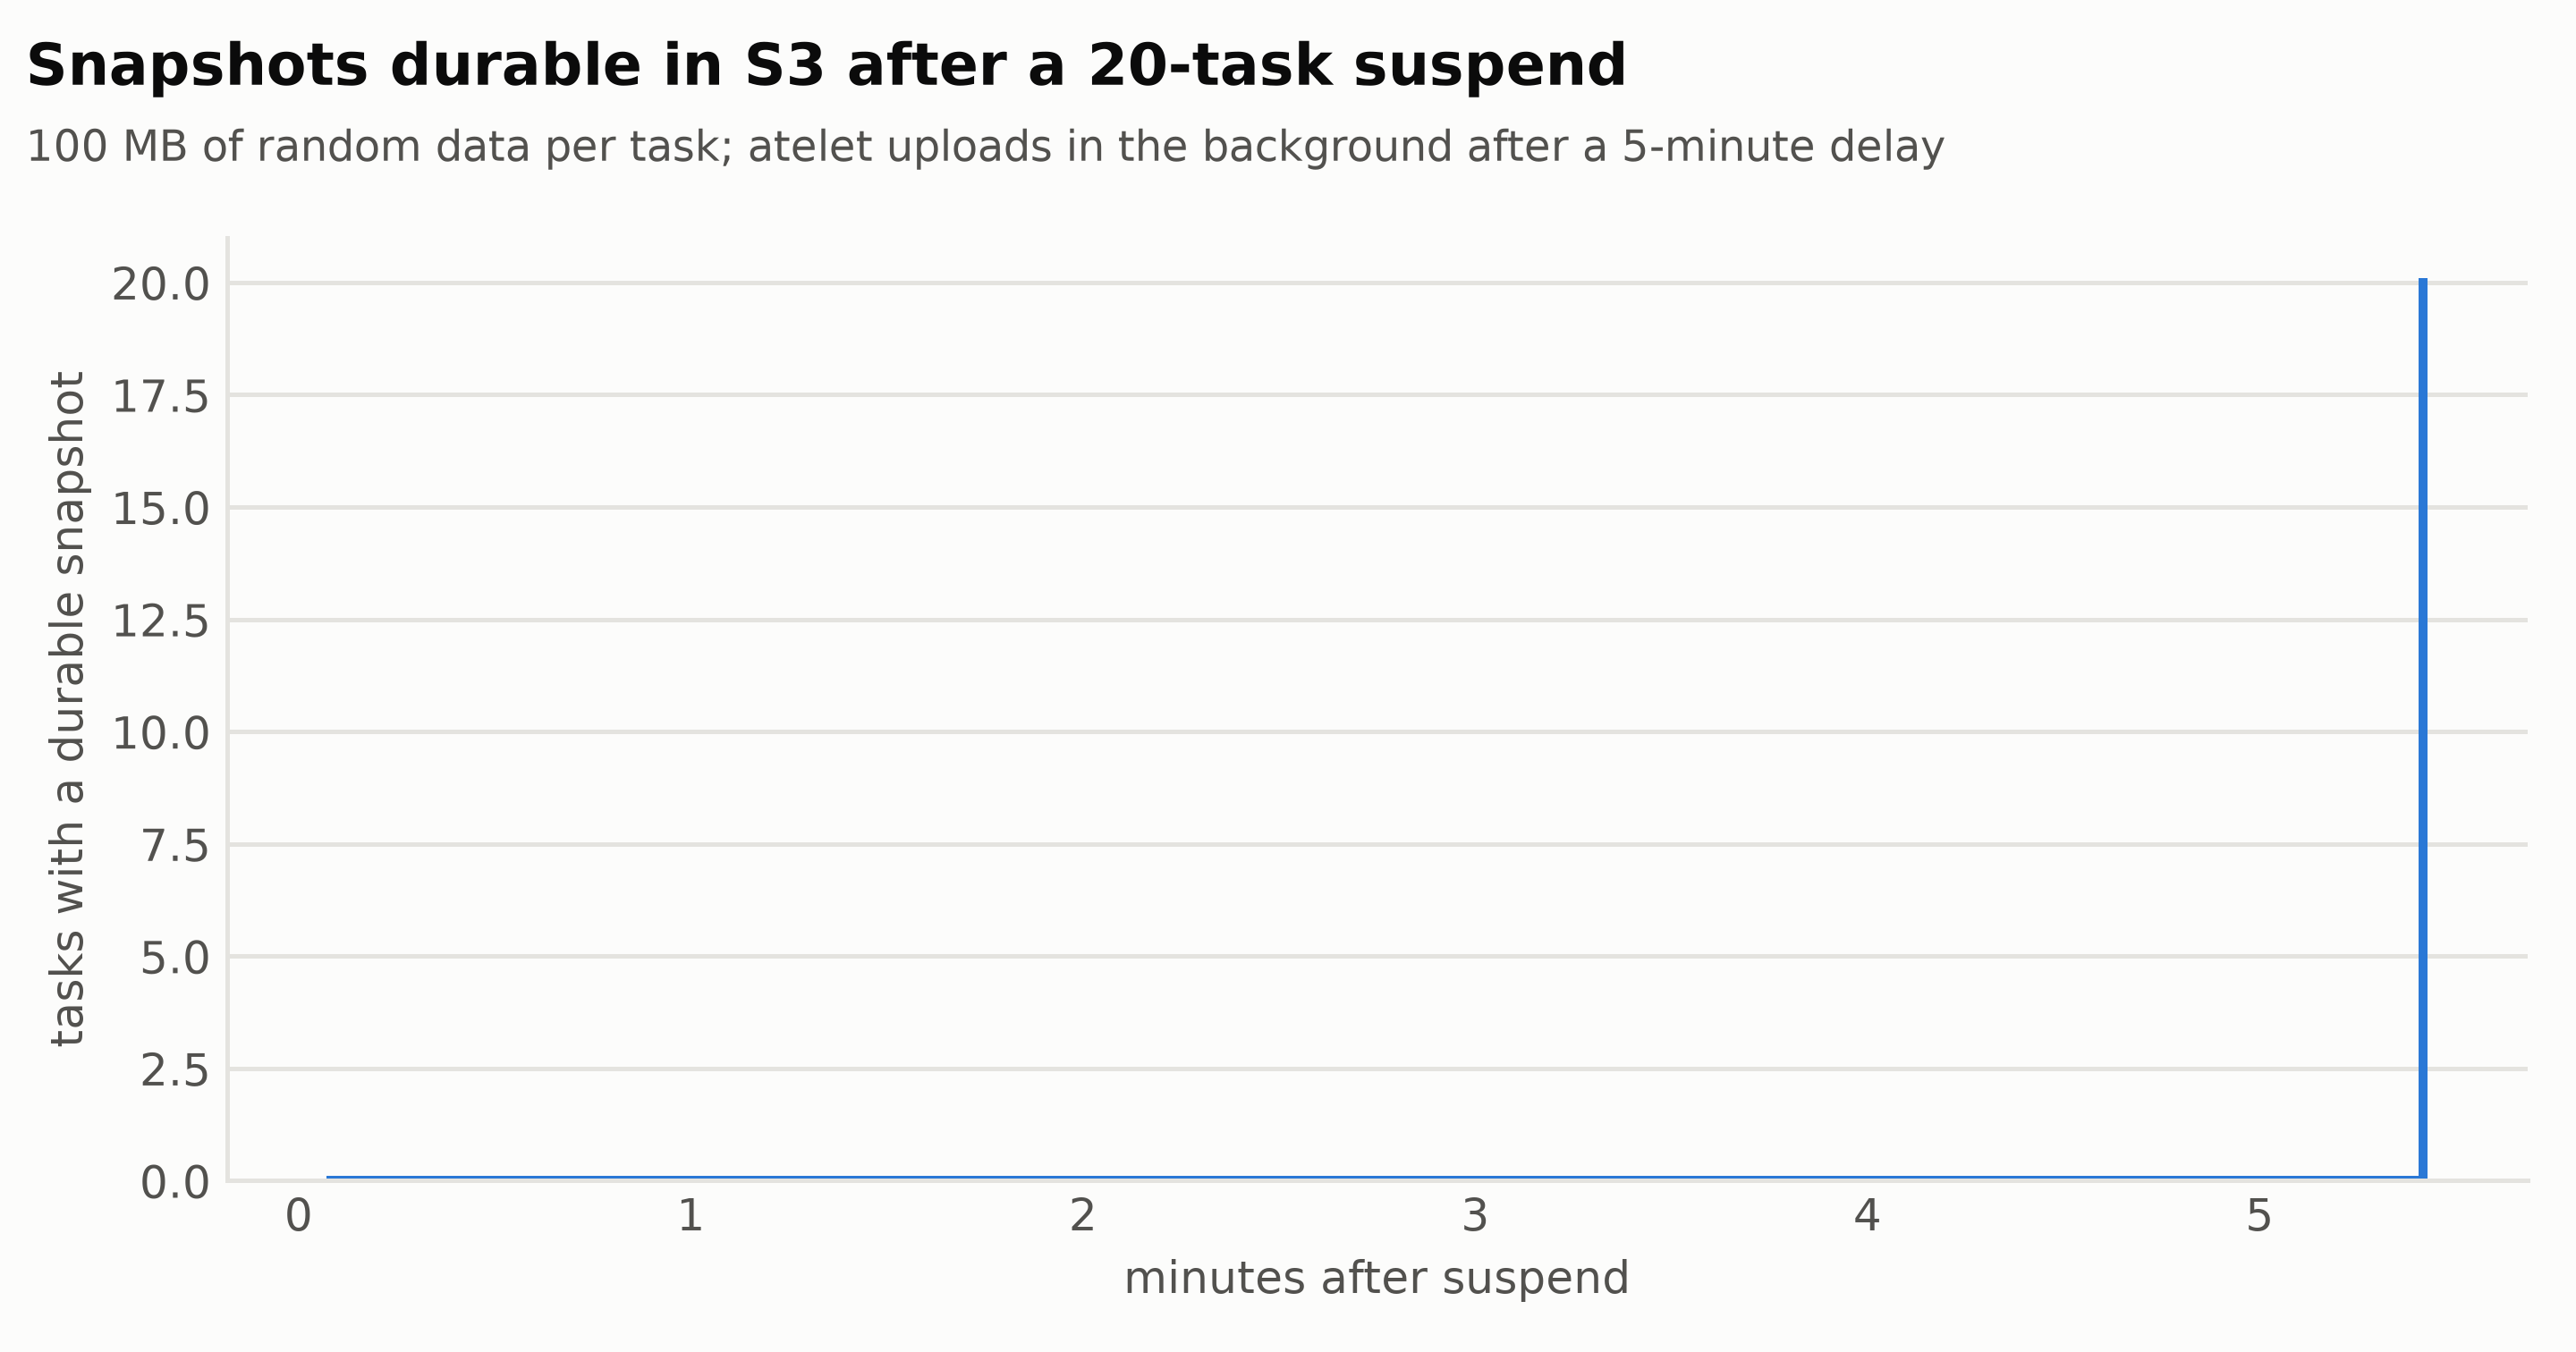
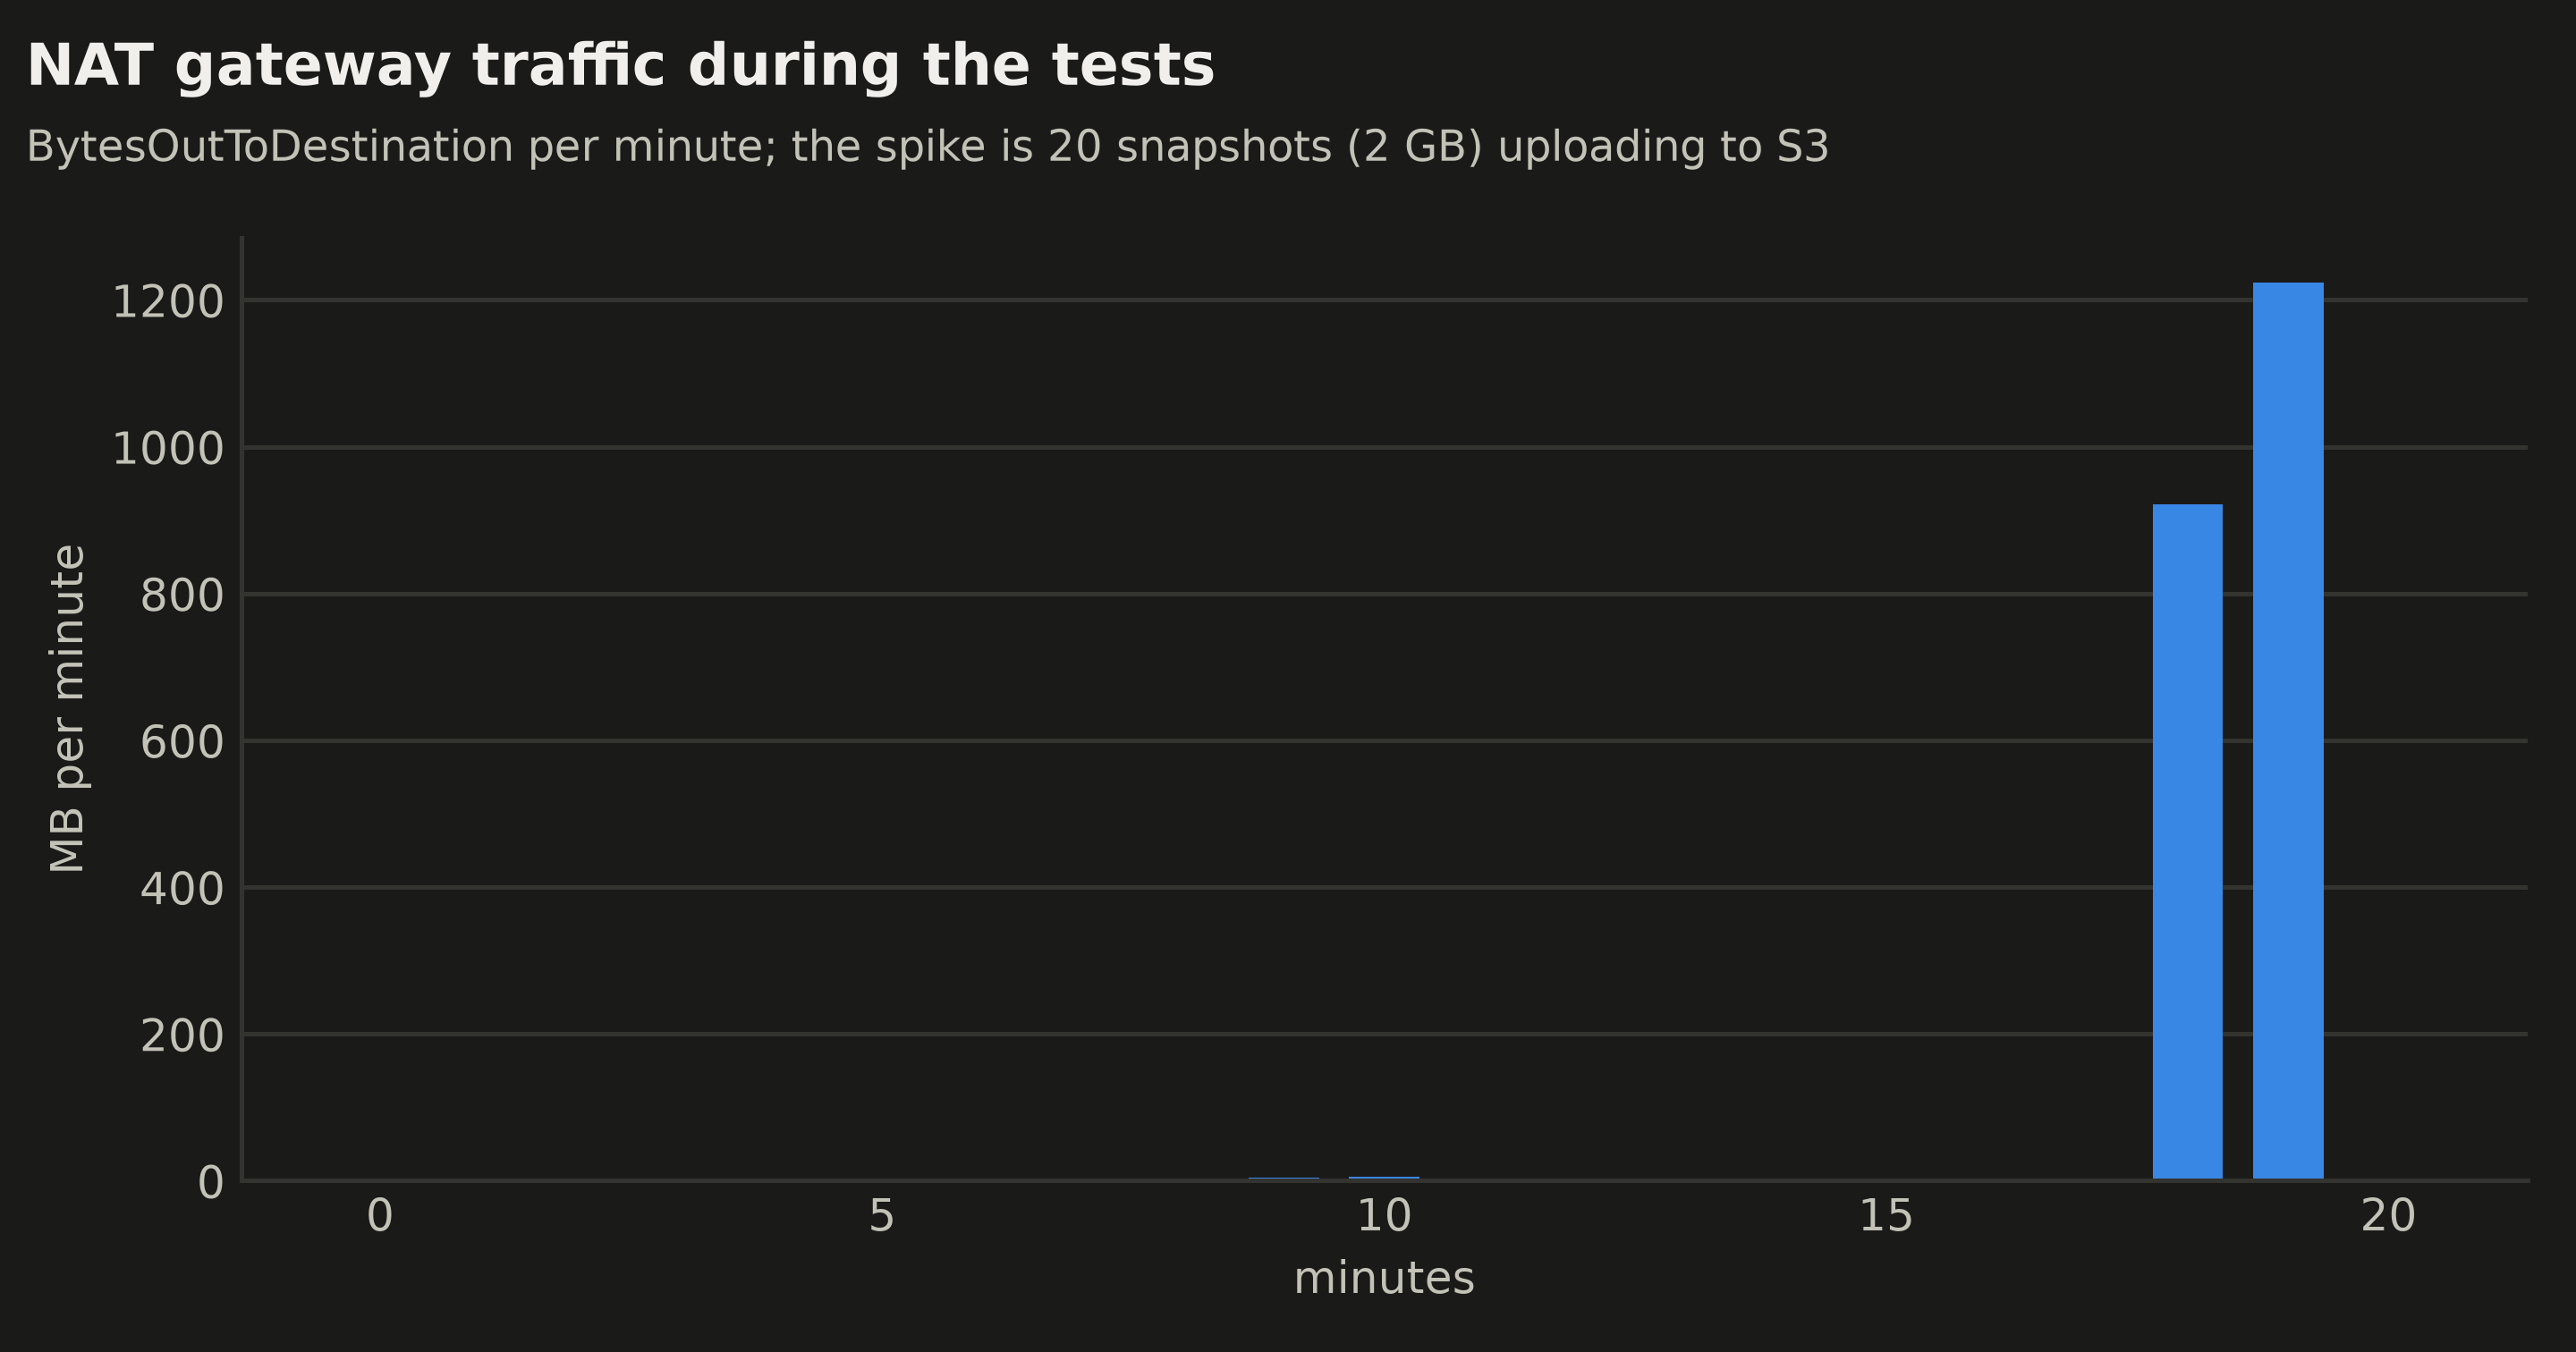
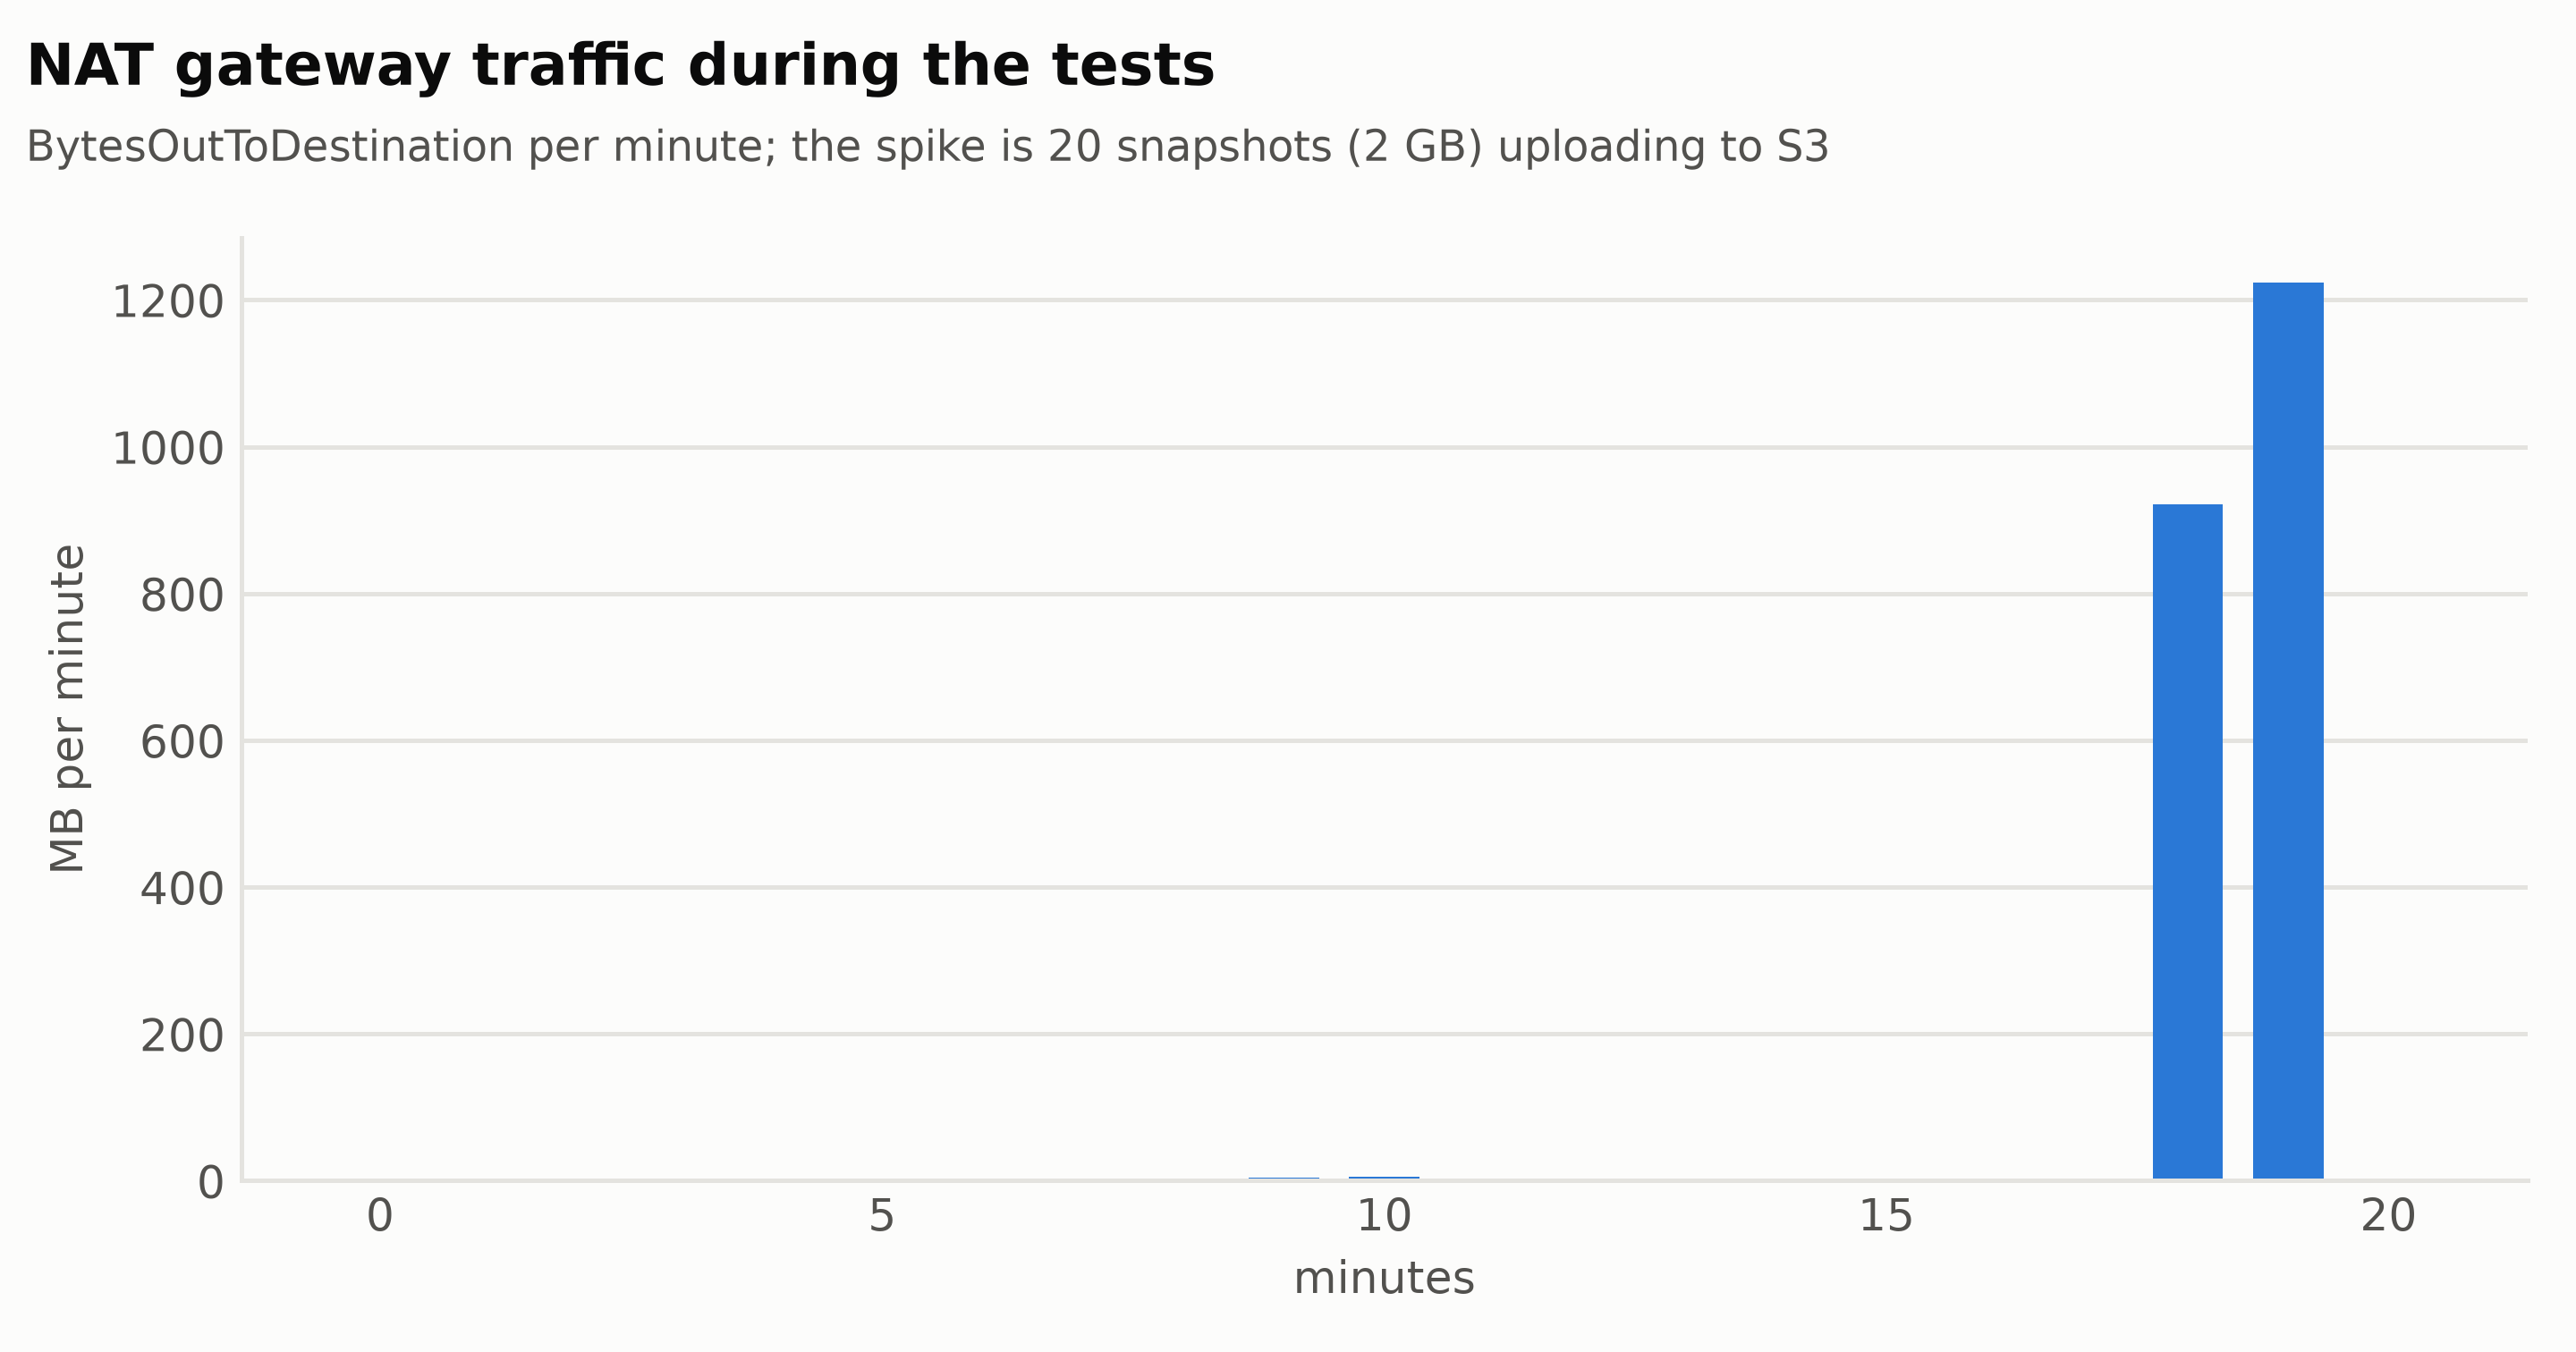
Os suspends em si levaram cerca de um segundo cada, todos os 20 de uma vez. Depois, nada por cinco minutos, o atraso padrão de upload do Substrate, e todos os 20 snapshots, 2 GB, ficaram duráveis juntos. O gráfico do NAT gateway mostra para onde esses bytes foram: para fora pelo NAT gateway, cerca de 2,1 GB em dois minutos. A VPC do post de instalação não tem endpoint S3, então todo upload de snapshot paga o processamento de dados do NAT ($0.045 por GB em us-east-1). Isso é pouco aqui e real em escala, e um gateway VPC endpoint para S3 é gratuito. Adicione um antes que os snapshots comecem a fluir:
module "vpc" {
  # ...
}

resource "aws_vpc_endpoint" "s3" {
  vpc_id            = module.vpc.vpc_id
  service_name      = "com.amazonaws.${var.region}.s3"
  vpc_endpoint_type = "Gateway"
  route_table_ids   = module.vpc.private_route_table_ids
}
A #2806 do upstream relata suspends de até dois minutos sob carga co-localizada, causados por uploads serializados. Meus dados não conseguem descartar esse gargalo, mas aqui ele não afetou os suspends: eles retornaram em cerca de um segundo e os uploads aconteceram depois, dentro de dois minutos.
O que o CloudWatch viu
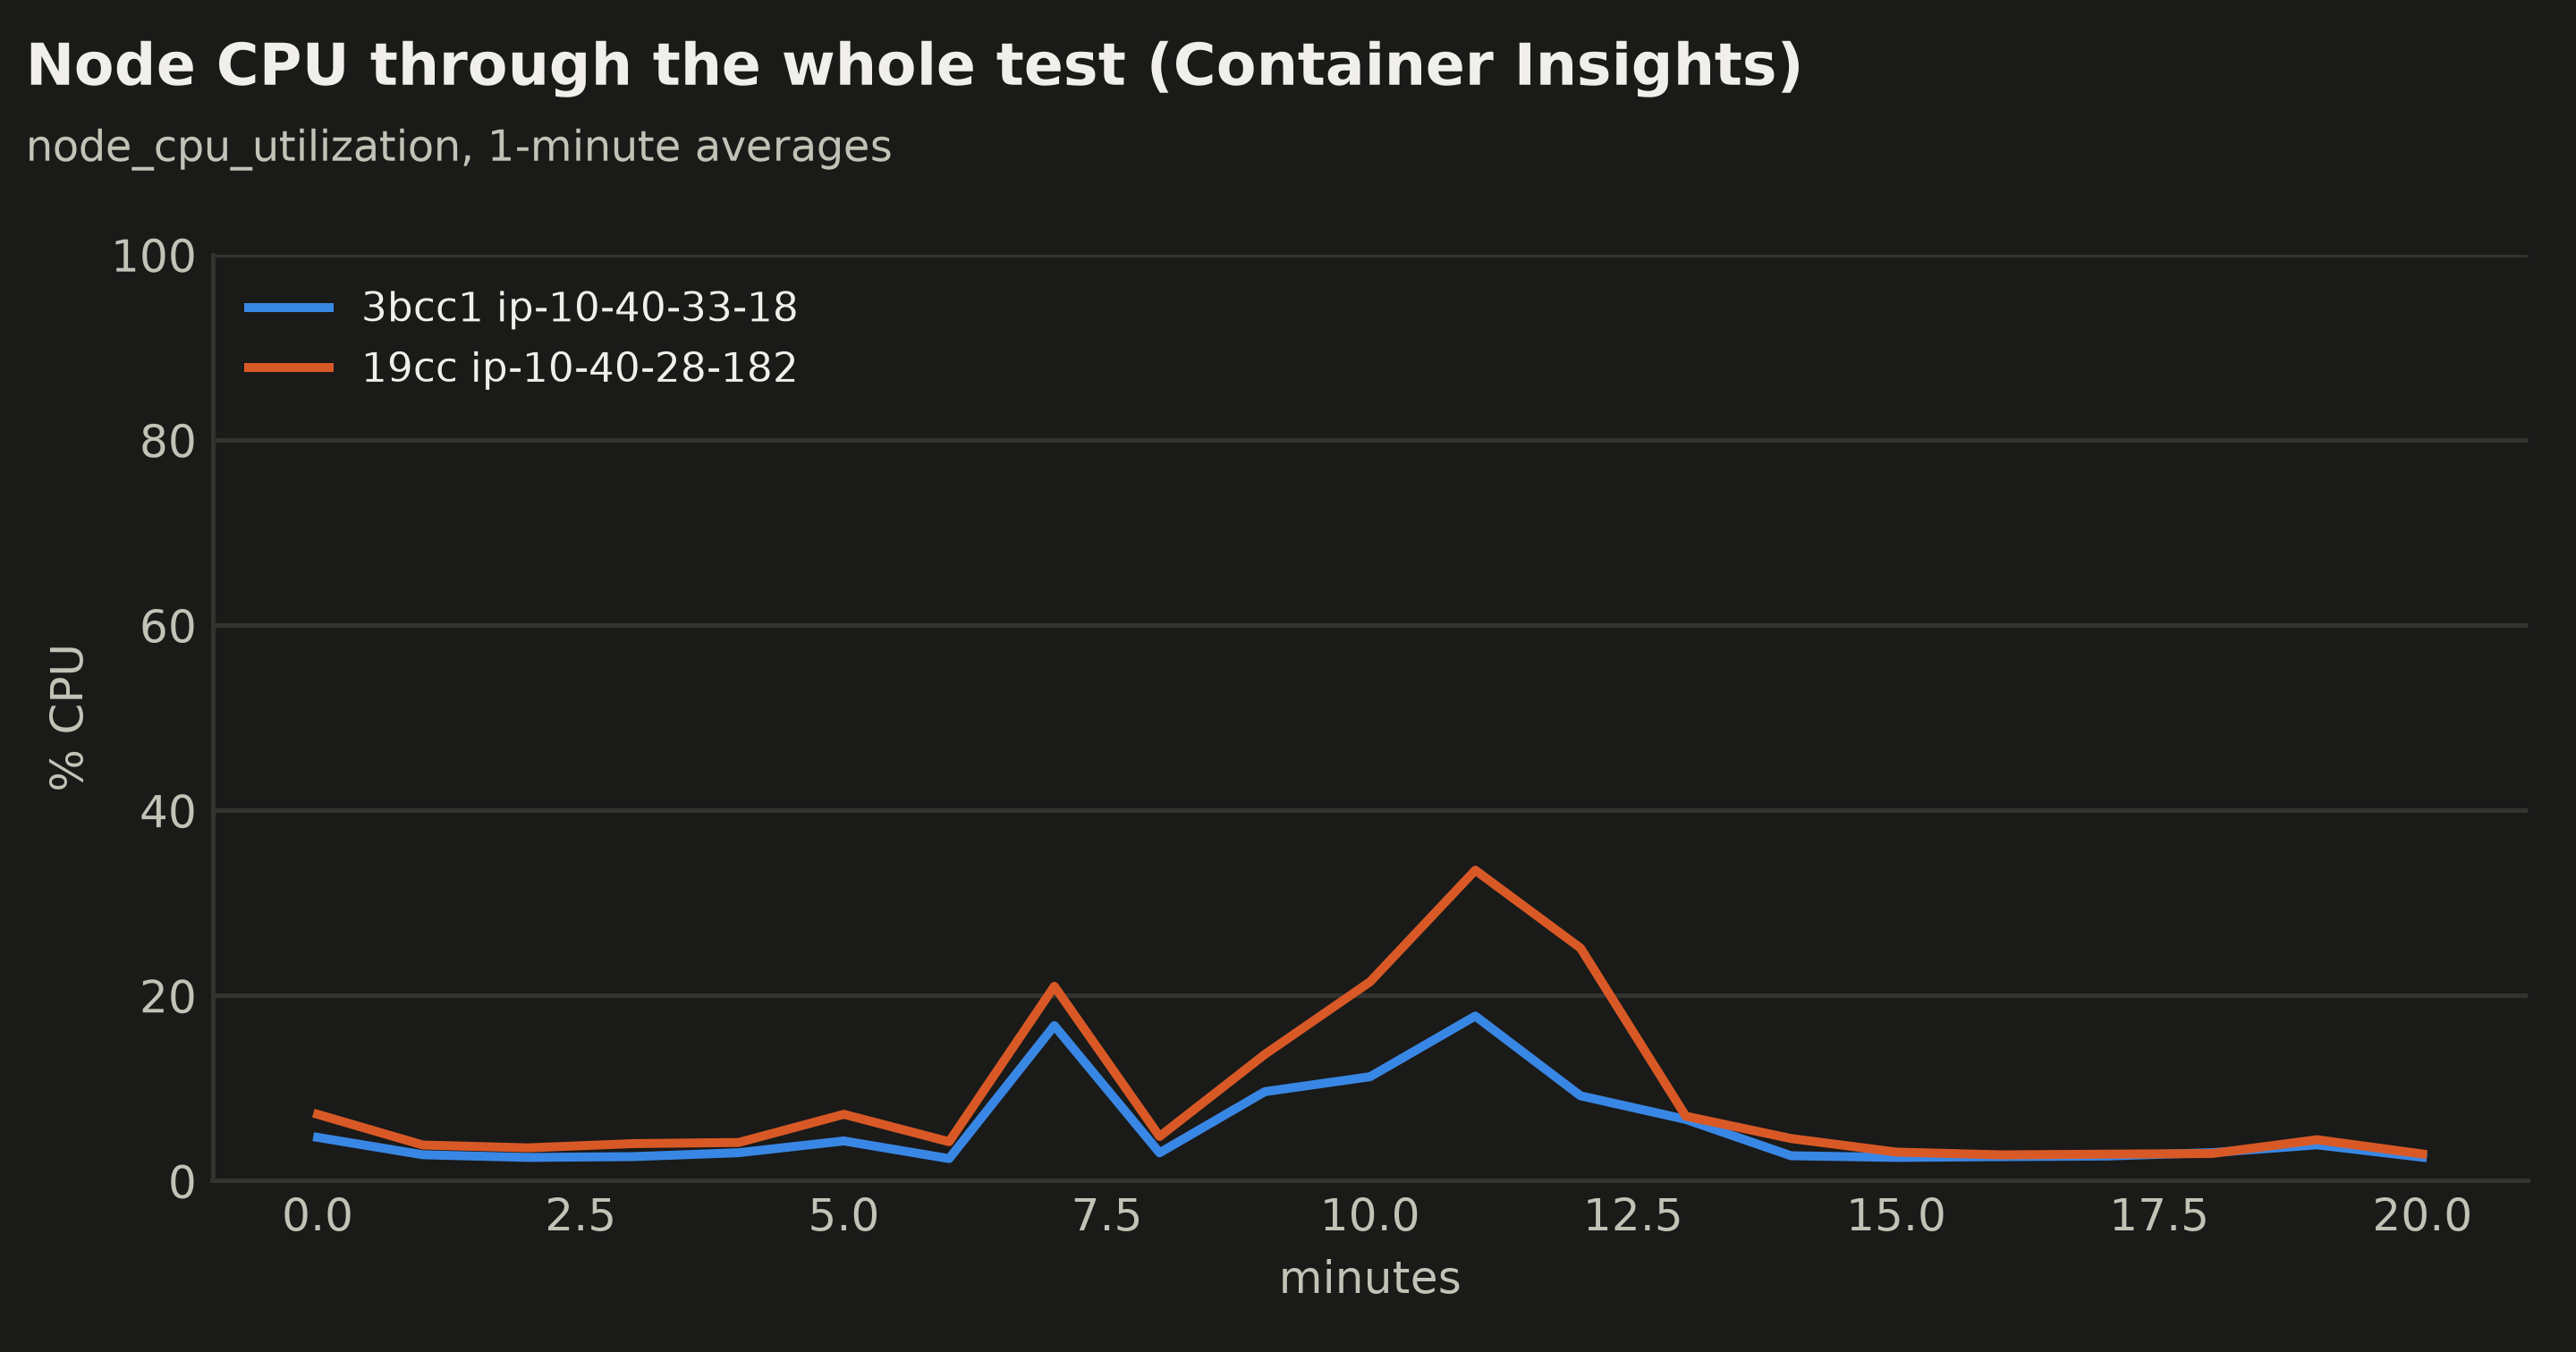
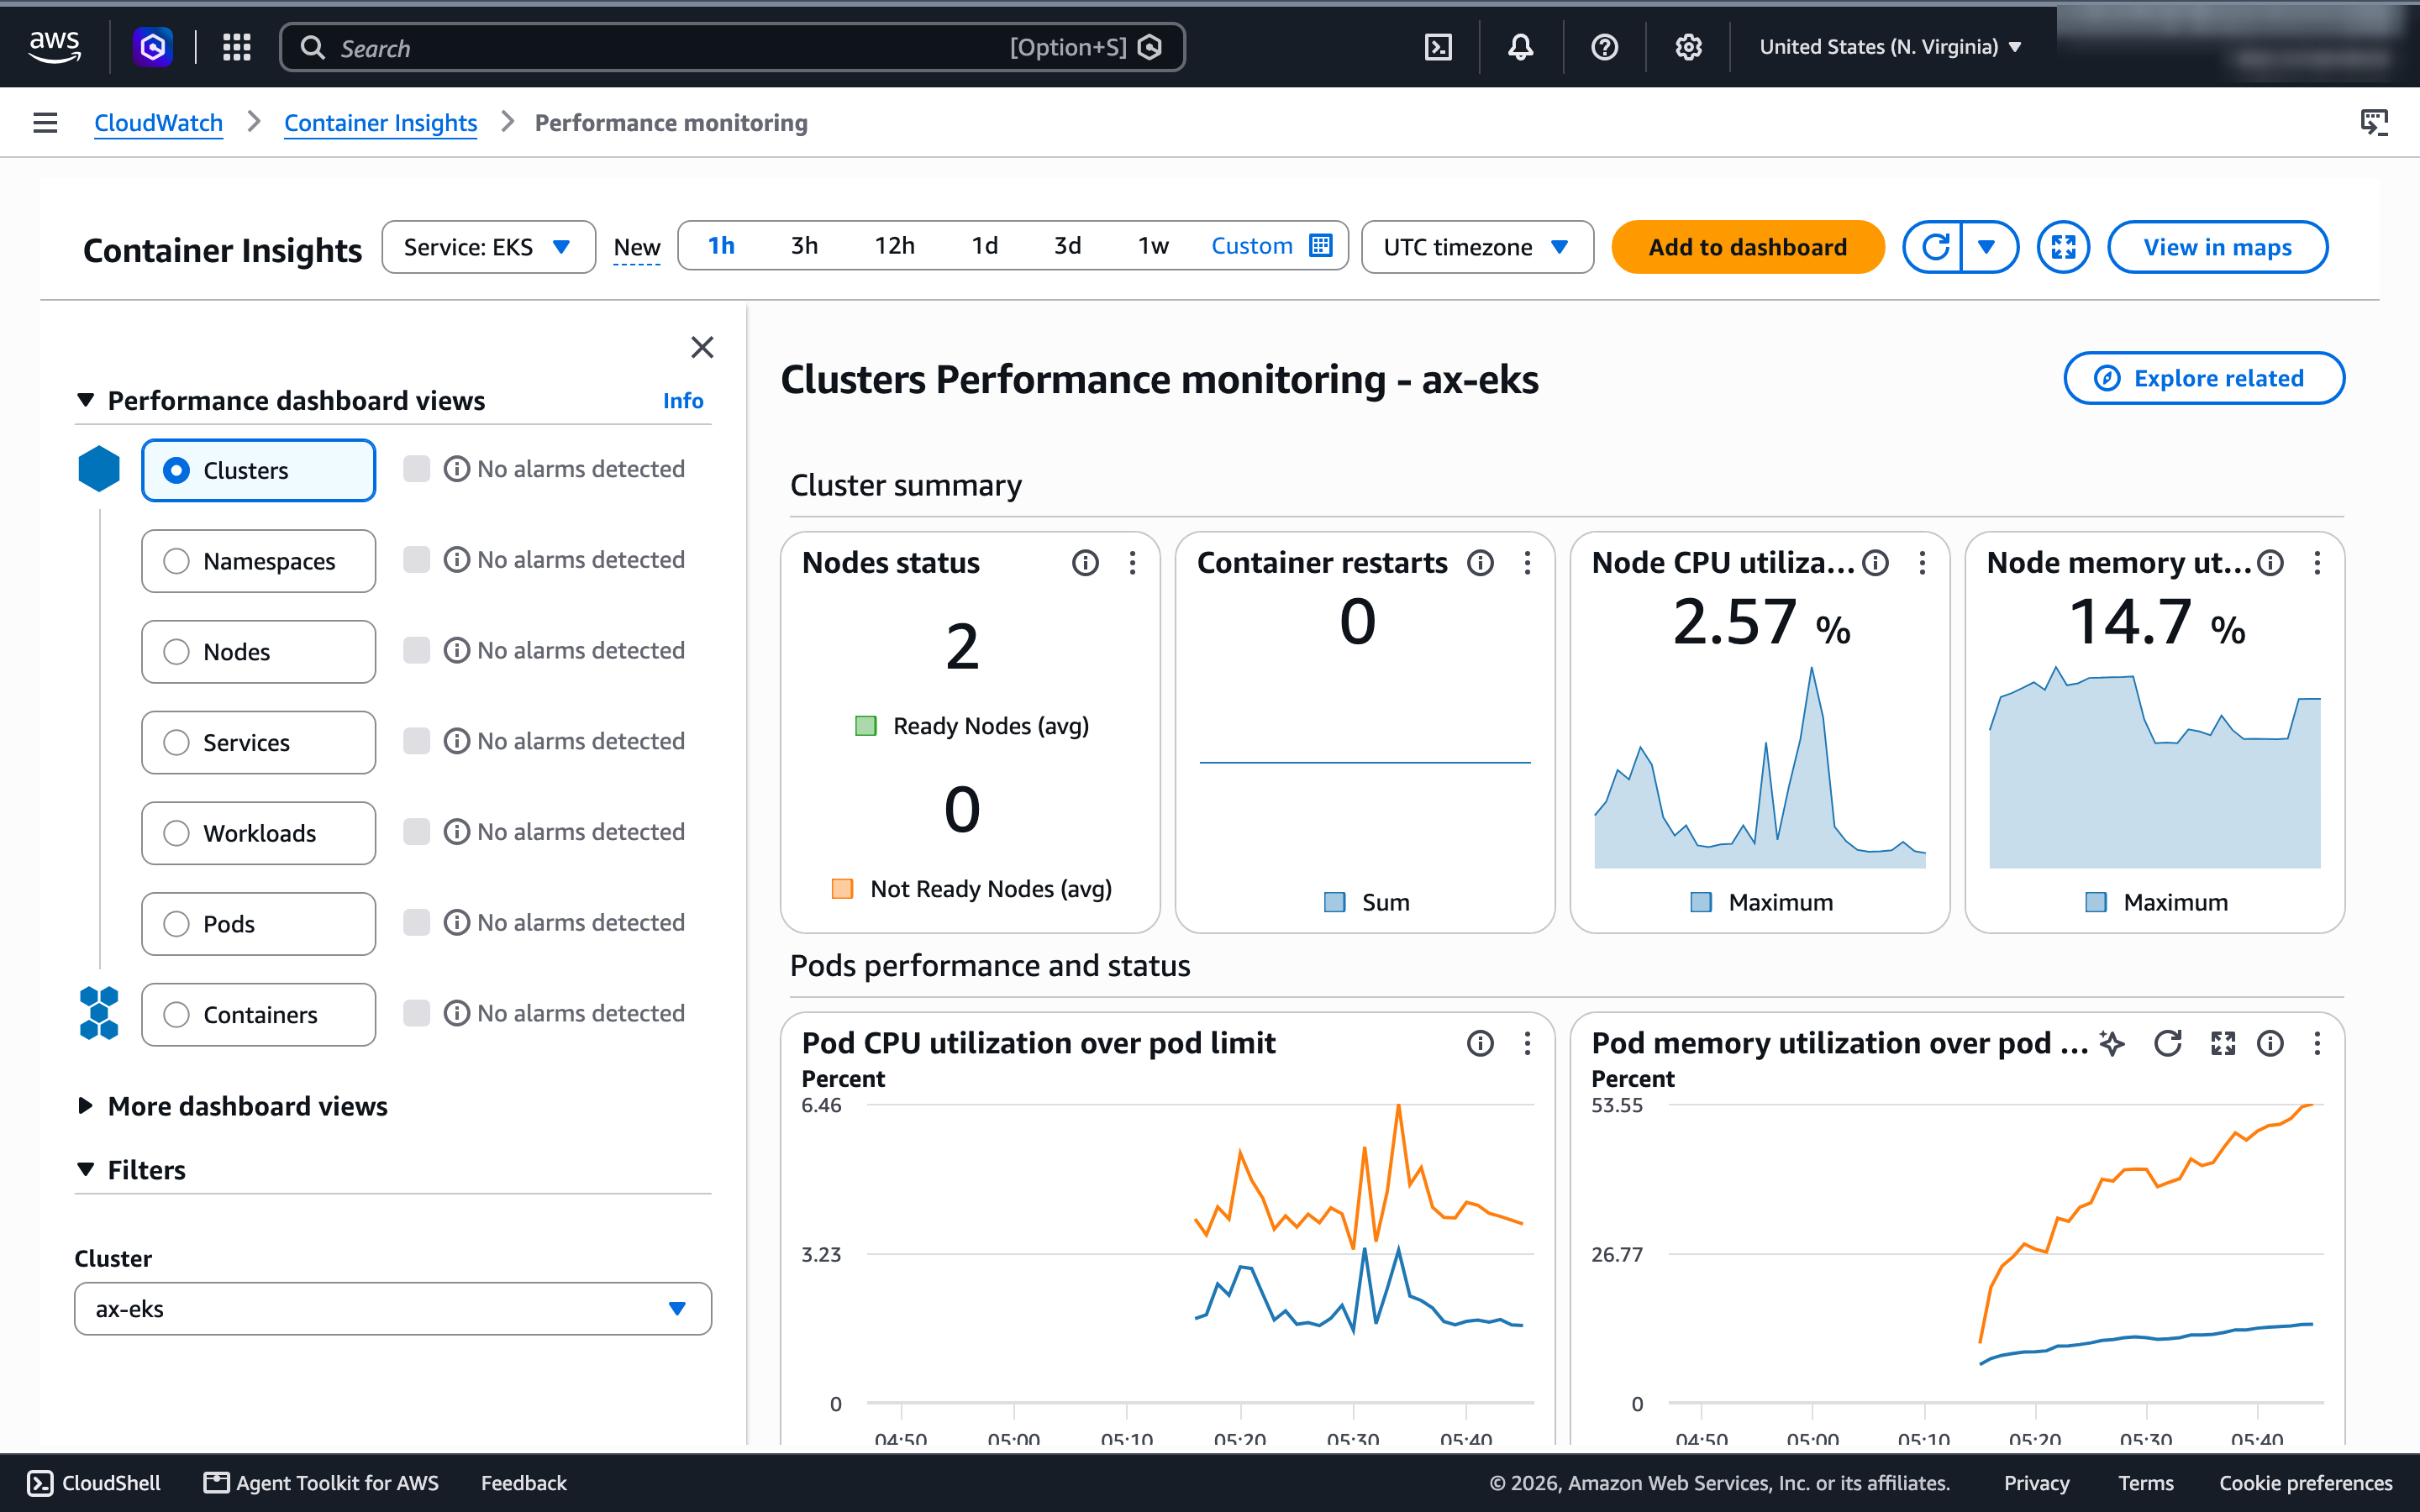
A janela começa alguns minutos antes das re-execuções limpas, enquanto as tasks remanescentes da minha primeira tentativa ainda estavam sendo deletadas, o que explica o platô inicial de memória. Ao longo dela, os nodes nunca passaram de cerca de um terço da CPU em médias de um minuto, e a memória ficou abaixo de 17%. O Container Insights confirma o quadro das amostras do kubelet, com granularidade mais grossa: em dois nodes, essas cargas de trabalho esgotam a CPU reservada muito antes de as máquinas esgotarem qualquer coisa. Zero reinícios de container nos seis testes.
Resumo dos resultados
| Teste | Resultado em 2 × m7i.xlarge |
|---|---|
| Densidade | 151 sandboxes ociosos com 50m; as reservas de CPU são o teto, memória ~13 MiB por sandbox ocioso |
| Latência, 1 → 40 em andamento | Sem erros; resume p50 1,5 → 2,1 s, suspend p50 0,77 → 1,18 s, create ~0,7 s |
| Wake on request | 97 ms com 1 CPU, 291 ms com 250m, 2,2 s com 50m; 30 simultâneos: p99 1,7 s, sem erros |
| Control plane | ≤ 0,3 core para o ate-api-server com 20 chamadas em andamento; nunca foi o gargalo |
| Noisy neighbors | CPU hogs +74% no trabalho de CPU das vítimas; disk hogs 6x o p95 de escrita |
| Tempestade de snapshots | 20 suspends em ~1 s; todos os 20 duráveis após 5,4 min; 2,1 GB pelo NAT gateway |
Preços
O cluster custa cerca de $0.63 por hora, esteja sob carga ou não (veja a parte 1). O que o stress test adicionou:
| Item | Tarifa | Este teste |
|---|---|---|
| Container Insights (enhanced observability) | por observação de métrica | cerca de uma hora; aproximadamente $2.65/dia se ficar ligado, estimado a partir do exemplo de preços da AWS |
| Processamento de dados do NAT gateway | $0.045/GB | ~2,1 GB de snapshots: cerca de $0.10 |
| Storage e requisições do S3 | tarifas padrão | centavos |
Limpeza
O 10_cleanup.py deleta todas as tasks no atespace stress, desliga o Container Insights e deleta os seus log groups, que sobrevivem ao add-on:
== tasks in atespace 'stress'
  remaining: 0
== terraform apply -var container_insights=false
  Apply complete! Resources: 0 added, 0 changed, 3 destroyed.
Para parar de pagar pelos nodes sem derrubar tudo, escale o node group para zero. O módulo EKS ignora mudanças posteriores no tamanho desejado de um node group, então é uma chamada de CLI:
aws eks update-nodegroup-config --cluster-name ax-eks \
  --nodegroup-name "$(aws eks list-nodegroups --cluster-name ax-eks --query 'nodegroups[0]' --output text)" \
  --scaling-config minSize=0,maxSize=1,desiredSize=0
O control plane, o NAT gateway e os volumes EBS continuam sendo cobrados, cerca de $5 por dia. O 99_teardown.sh da parte 1 remove tudo, incluindo os volumes do PostgreSQL que o terraform destroy deixa para trás.
Veredito
Em dois nodes de quatro cores, o AX e o Agent Substrate se saíram bem. Nada quebrou, nenhum container reiniciou, a latência degradou suavemente até 40 chamadas em andamento, os 30 wakes simultâneos tiveram sucesso, e o control plane usou uma fração de um core enquanto fazia isso. Os limites que encontrei foram de reservas, não de falhas: o Substrate recusou de forma limpa com no worker has room quando a CPU acabou.
Os números que importam para dimensionar uma frota AX:
- Densidade é uma decisão de limite de CPU. 6 tasks com o padrão do AX de 1 CPU, 30 com 250m, 151 com 50m nos mesmos dois nodes. A memória nunca chegou perto de um limite para agentes ociosos.
- O tempo de wake é o outro lado dessa decisão. 97 ms com 1 CPU, 2,2 s com 50m. Escolha os limites por task pelo tempo de wake que você precisa, não só pela quantidade que você quer encaixar.
- Limites de CPU não isolam. Vizinhos ocupados deixaram tasks limitadas 74% mais lentas. Se a latência importa, mantenha agentes pesados em CPU e agentes sensíveis à latência em worker pools ou nodes diferentes.
- Fique de olho no caminho dos snapshots. Os uploads esperam cinco minutos e depois saem todos juntos, pelo NAT gateway, a menos que você adicione um endpoint S3 gratuito.
- Atenção aos limites do tooling. O
ax get taskspara silenciosamente em 50 tasks, o que é fácil de deixar passar em scripts que fazem limpeza listando.
Os números de destaque do Google só ficam dentro do que eu medi com ressalvas que ele não declara: abaixo de 500 ms para um único wake com 250m ou mais, não com limites de CPU pequenos e não para bursts; ativações por segundo definidas pelos boots dos sandboxes em um cluster deste tamanho, não pela API. Nos meus dois nodes, o resumo honesto é: denso para ociosos, rápido para acordados, e planeje para os vizinhos.