Google AX no Amazon EKS: Hands-On com uma Instalação Self-Hosted
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Setup
- Passo 1: Ferramentas e o código de apoio
- Passo 2: O cluster
- Passo 3: O código-fonte, e por que o EKS precisa de um patch
- Testes
- Teste 1: O cluster atende ao nível exigido pelo Substrate?
- Teste 2: Instalar o Agent Substrate com o overlay de EKS
- Teste 3: O WorkerPool
- Teste 4: Build e deploy do AX
- Teste 5: O smoke test
- Teste 6: Uma primeira olhada no suspend
- Resumo dos resultados
- Preços
- Cleanup
- Veredito
- Com o que você está se comprometendo
- Quem deveria usar
Explica (TLDR) como se eu fosse...
Imagina que o Google construiu uma garagem de brinquedos enorme onde ajudantes robôs ganham cada um o seu quartinho para trabalhar, mas as instruções só explicam como montar tudo na sala de brincar do próprio Google. Eu montei numa outra sala de brincar, uma que é da Amazon.
Funcionou depois que eu troquei algumas peças, tipo onde ficam guardadas as caixas de brinquedo. Uma surpresa: quando um robô tira uma soneca e acorda, ele só lembra do que guardou numa gaveta especial. Todo o resto do quartinho some.
O AX é um orquestrador Apache 2.0 do Google que executa tarefas de agentes de IA em sandboxes isoladas num cluster Kubernetes operado por você. O Google dá suporte à própria nuvem e a um setup local no laptop; rodar na AWS não tem suporte, e o projeto avisa sobre breaking changes antes de uma release estável.
A exposição material é controle de acesso: o servidor do AX não tem autenticação própria, um problema reportado como crítico e ainda em aberto. Trate qualquer deployment como ambiente de avaliação, mantenha o control plane fora da rede e reserve orçamento para a infraestrutura que fica rodando ociosa.
A queixa principal era se o orquestrador de agentes do Google sobrevive a um transplante do Google Cloud para a AWS. Diagnóstico: sim, no Kubernetes 1.37, com um overlay pequeno e um patch curto no instalador. A evidência é uma instalação bem-sucedida, um smoke test passando e tempos medidos.
Efeitos colaterais a monitorar: o suspend descarta memória, processos em execução e tudo que está fora da pasta de workspace, então ele está mais próximo de um restart do que de uma pausa. Contraindicações: uso em produção, clusters compartilhados e qualquer ambiente onde o control plane sem autenticação possa ser alcançado.
Existe uma tensão conhecida em adotar algo que uma empresa grande abriu como open source: a empolgação com um design capaz, e a preocupação silenciosa de que ele só funciona de verdade na casa deles. Colocar para rodar em outro lugar costuma aliviar essa preocupação, e essa instalação aliviou.
O novo atrito é a honestidade sobre maturidade. O projeto muda todo dia, algumas promessas da cobertura de lançamento já não batem com o código, e o time que adota precisa assumir sozinho o cluster, os upgrades e as lacunas de segurança.
Pense no AX como um arranjo de sessão escrito para um estúdio específico. As partes são boas, a banda é afiada, mas a partitura pressupõe a sala e o equipamento do Google. Levar para uma sala da AWS significou religar alguns cabos: storage, pull de imagens e a ideia que o instalador tinha de onde estava tocando.
Depois de afinado, todo take saiu de primeira. A surpresa foi a pausa entre os takes: a banda esquece tudo, menos as notas deixadas numa única estante de partitura, então um resume é uma nova contagem, não um acorde sustentado.
A história é portabilidade com etiqueta de preço. O orquestrador de agentes do Google roda na AWS hoje, num cluster EKS 1.37 padrão, com menos de meia hora de build e instalação e cerca de sessenta centavos de dólar por hora de custo ocioso.
O posicionamento é para times de plataforma avaliando um runtime de agentes self-hosted, não para times de produto querendo sandboxes amanhã. O pitch honesto é "seja dono do runtime e do cluster", com um cluster que cobra enquanto está ocioso e precisa de manutenção como preço desse controle.
 Veja o código-fonte aqui: google-ax-eks
Visão Geral
O AX (Agent Executor) é o orquestrador open source do Google para tarefas de agentes, lançado sob Apache 2.0. Você descreve uma tarefa em YAML, o AX executa ela numa sandbox isolada, e você pode suspender a tarefa enquanto ela espera e retomar depois. Ele fica em cima do Agent Substrate, um segundo projeto do Google que executa cada sandbox como um “actor” dentro do gVisor, num pool de pods Kubernetes pré-aquecidos. Um dos co-criadores do AX o descreveu no Hacker News como “mais próximo de orquestração de jobs” do que de um framework de agentes, e esse é o enquadramento certo: o AX não raciocina, ele agenda e isola o que quer que raciocine.
O próprio AX só diz que precisa de Kubernetes e Agent Substrate; o Substrate e a documentação do Google cobrem dois lugares para rodar isso: GKE e um cluster kind local. Para esta série eu queria hospedar por conta própria, na nuvem que eu já uso. Este post, parte 1 de 4, é a instalação. A Parte 2 cobre o ciclo de vida das tarefas, a parte 3 a injeção de credenciais, e a parte 4 faz um teste de estresse nos mesmos dois nodes.
Eu rodei o AX no Amazon EKS 1.37, com build a partir dos commits que o próprio guia de instalação do AX fixa como baseline de desenvolvimento: AX a496fc1 (2026-10-28) com Substrate d3f2363 (v0.6.0). Tudo está em Terraform e sete shell scripts. Todos os tempos abaixo são das minhas execuções em 2026-10-30.
Eu não sou o primeiro a tentar na AWS. Anton Weiss rodou o Agent Substrate no EKS em outubro com IRSA, RDS e S3, e abriu um overlay aws upstream como PR #2241, ainda sem merge. Ele não instalou o AX. Eu peguei um caminho mais leve (EKS Pod Identity em vez de IRSA, o PostgreSQL embutido em vez de RDS) e fui até uma tarefa do AX rodando.
Arquitetura
Dois control planes dividem o cluster. O AX (ax-system) armazena as tarefas no próprio PostgreSQL e transforma cada uma num actor do Substrate. O Substrate (ate-system) é dono dos actors: o ate-api-server guarda o estado deles, o ate-controller gerencia os pools de workers, o router atenet alcança as sandboxes em execução, e um DaemonSet atelet em cada node faz de fato o checkpoint e o restore. Os workers gVisor que hospedam as sandboxes ficam num WorkerPool que você mesmo cria, aqui em ax-system. Não existe Helm chart e não existem imagens publicadas, então tudo é buildado a partir do código-fonte e enviado para o ECR.
O que faz disso EKS em vez de GKE se resume a quatro coisas:
| Aspecto | GKE (o que o Google entrega) | EKS (o que eu fiz) |
|---|---|---|
| APIs de certificado de pod | GKE 1.37, ou 1.36 com APIs beta habilitadas | Só EKS 1.37, porque o EKS não permite habilitar APIs beta |
| Storage de snapshots | GCS, com troca de token por actor | S3, com a própria role do pod via EKS Pod Identity |
| Pull de imagens pelo atelet | Artifact Registry via credential provider do GKE | ECR via ecr-credential-provider do AL2023 |
| Instalador | Caminho GKE do ate-setup | ate-setup mais um patch de 11 linhas e um overlay kustomize |
Setup
Passo 1: Ferramentas e o código de apoio
Você precisa de uma conta AWS que consiga criar recursos de EKS, VPC, IAM, S3 e ECR, além de Terraform 1.9+, AWS CLI, kubectl, jq, Docker com buildx, e Go 1.26 ou mais novo. O AX e o Substrate fixam Go 1.27.x; os scripts definem GOTOOLCHAIN=auto para que o Go faça o download. Eu fiz o build de tudo num Mac com Apple Silicon; as imagens são linux/amd64, porque o Substrate só roda em amd64.
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/google-ax-eks| Script | O que ele faz |
|---|---|
01_cluster.sh | terraform apply, kubeconfig, e depois verifica se o cluster atende aos requisitos do Substrate |
02_sources.sh | Faz checkout do AX e do Substrate nos commits fixados, aplica o patch e o overlay de EKS |
03_substrate.sh | Faz o build de todas as imagens do Substrate com ko, faz push para o ECR, instala o ate-system |
04_workerpool.sh | Cria o WorkerPool gVisor onde o AX agenda as tarefas |
05_ax.sh | Faz o build do ax CLI e das imagens do AX, faz deploy do PostgreSQL e do ax-server |
06_check_task.sh | O smoke test do guia de instalação, com tempos |
07_suspend.sh | O que sobrevive a ax suspend e ax resume |
99_teardown.sh | Apaga as tarefas, os repositórios do ECR, tudo que o Terraform criou e os volumes do PostgreSQL |
Passo 2: O cluster
O Terraform cria uma VPC com um NAT gateway, um cluster EKS 1.37 com dois nodes m7i.xlarge em Amazon Linux 2023, os add-ons, um bucket S3 para snapshots, duas roles de Pod Identity e um template de criação de repositório no ECR. O tamanho do node espelha o mínimo do Google para GKE (c3-standard-4, 4 vCPU e 16 GB).
module "eks" {
  source  = "terraform-aws-modules/eks/aws"
  version = "~> 21.0"

  name               = var.name
  kubernetes_version = "1.37" # PodCertificateRequest + ClusterTrustBundle are GA here

  addons = {
    vpc-cni = {
      before_compute       = true
      configuration_values = jsonencode({ enableNetworkPolicy = "true" })
    }
    eks-pod-identity-agent = { before_compute = true }
    kube-proxy             = {}
    coredns                = {}
    aws-ebs-csi-driver = {
      # AX's PostgreSQL needs a default StorageClass for its 10 GiB volume.
      configuration_values = jsonencode({ defaultStorageClass = { enabled = true } })
      pod_identity_association = [{ role_arn = aws_iam_role.ebs_csi.arn, service_account = "ebs-csi-controller-sa" }]
    }
  }

  eks_managed_node_groups = {
    workers = {
      ami_type       = "AL2023_x86_64_STANDARD"
      instance_types = ["m7i.xlarge"]
      min_size       = 2
      max_size       = 2
      desired_size   = 2
      disk_size      = 100
    }
  }
}
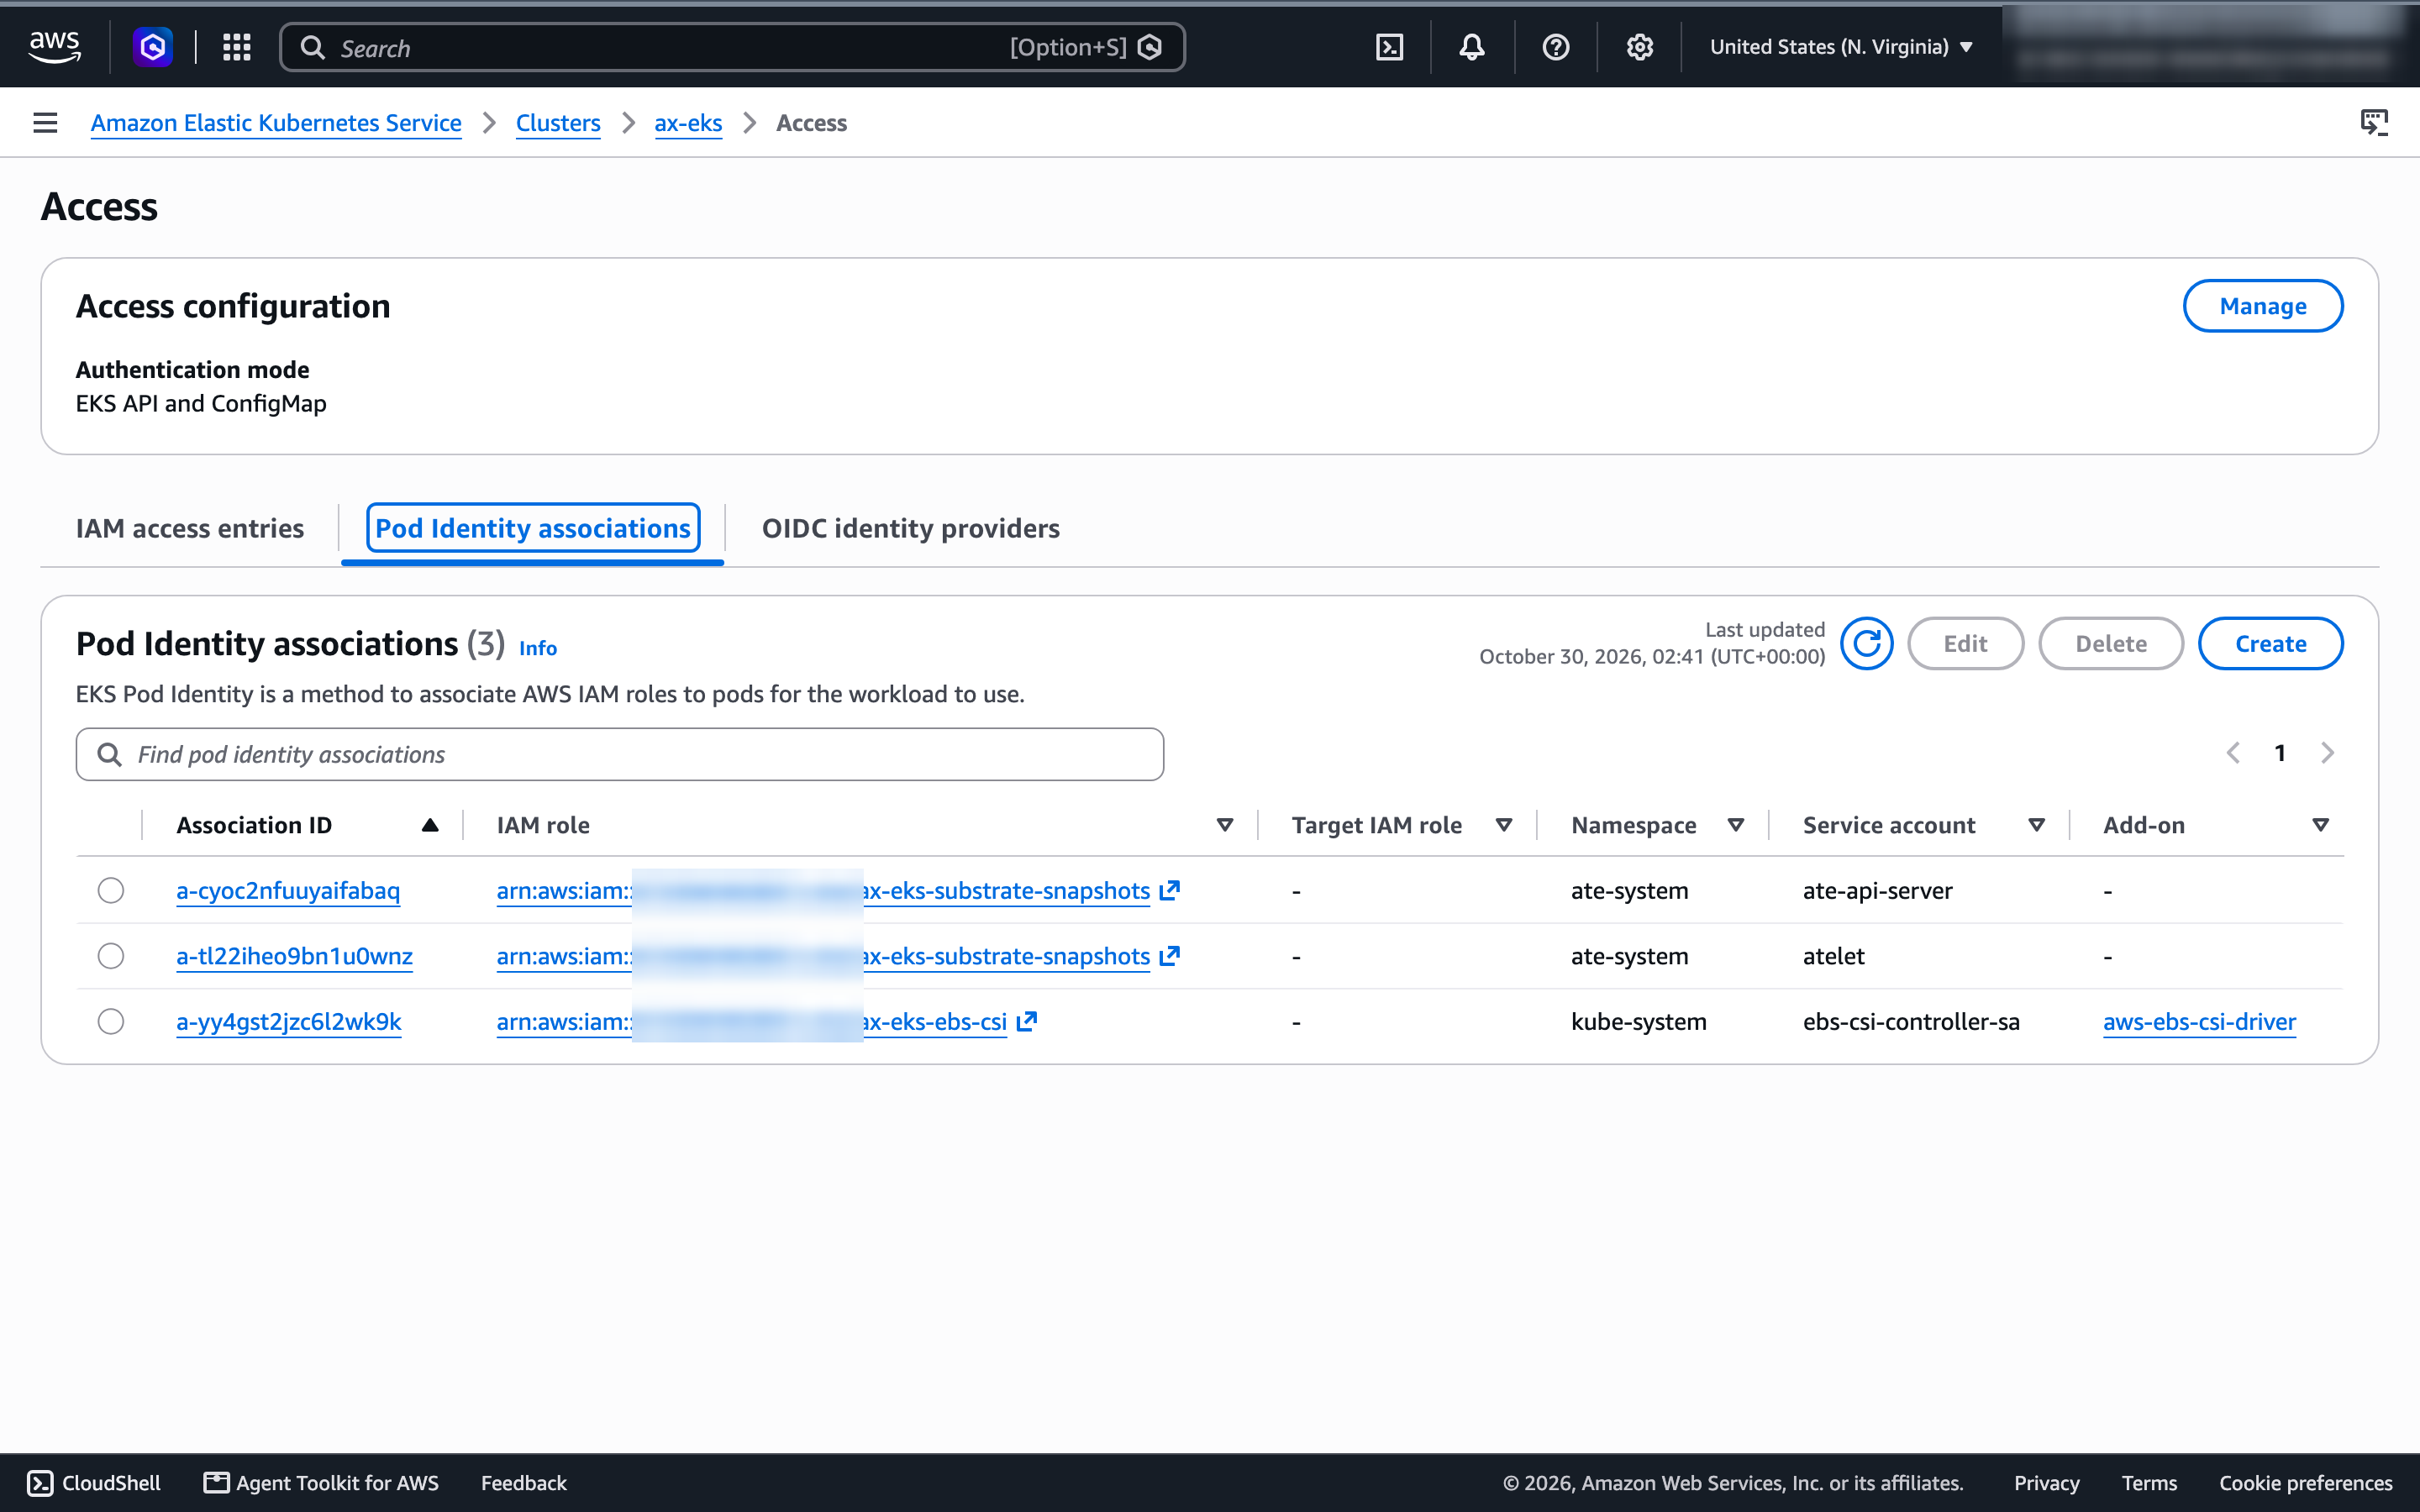
Dois detalhes da AWS pesam mais. Os sidecars de snapshot do Substrate rodam no ate-api-server e no atelet, então as duas service accounts recebem uma role de S3 via Pod Identity. E nenhum dos dois projetos publica imagens: o ko faz push de um repositório por binário, então um template de create-on-push do ECR sob o prefixo ax-eks evita ter que pré-criar uma dúzia de repositórios.
resource "aws_eks_pod_identity_association" "snapshots" {
  for_each        = toset(["ate-api-server", "atelet"])
  cluster_name    = module.eks.cluster_name
  namespace       = "ate-system"
  service_account = each.key
  role_arn        = aws_iam_role.snapshots.arn
}

resource "aws_ecr_repository_creation_template" "images" {
  prefix      = var.name
  applied_for = ["CREATE_ON_PUSH"]
}atunnel failed to open egress tunnel ... context deadline exceeded. O Terraform de apoio agora adiciona uma regra self-referencing para todas as portas. Minha execução gravada é anterior a ela, então mostra 67 recursos em vez de 68.
node_security_group_additional_rules = {
  ingress_self_all = {
    description = "Node to node, all ports (pod-to-pod across nodes)"
    protocol    = "-1"
    from_port   = 0
    to_port     = 0
    type        = "ingress"
    self        = true
  }
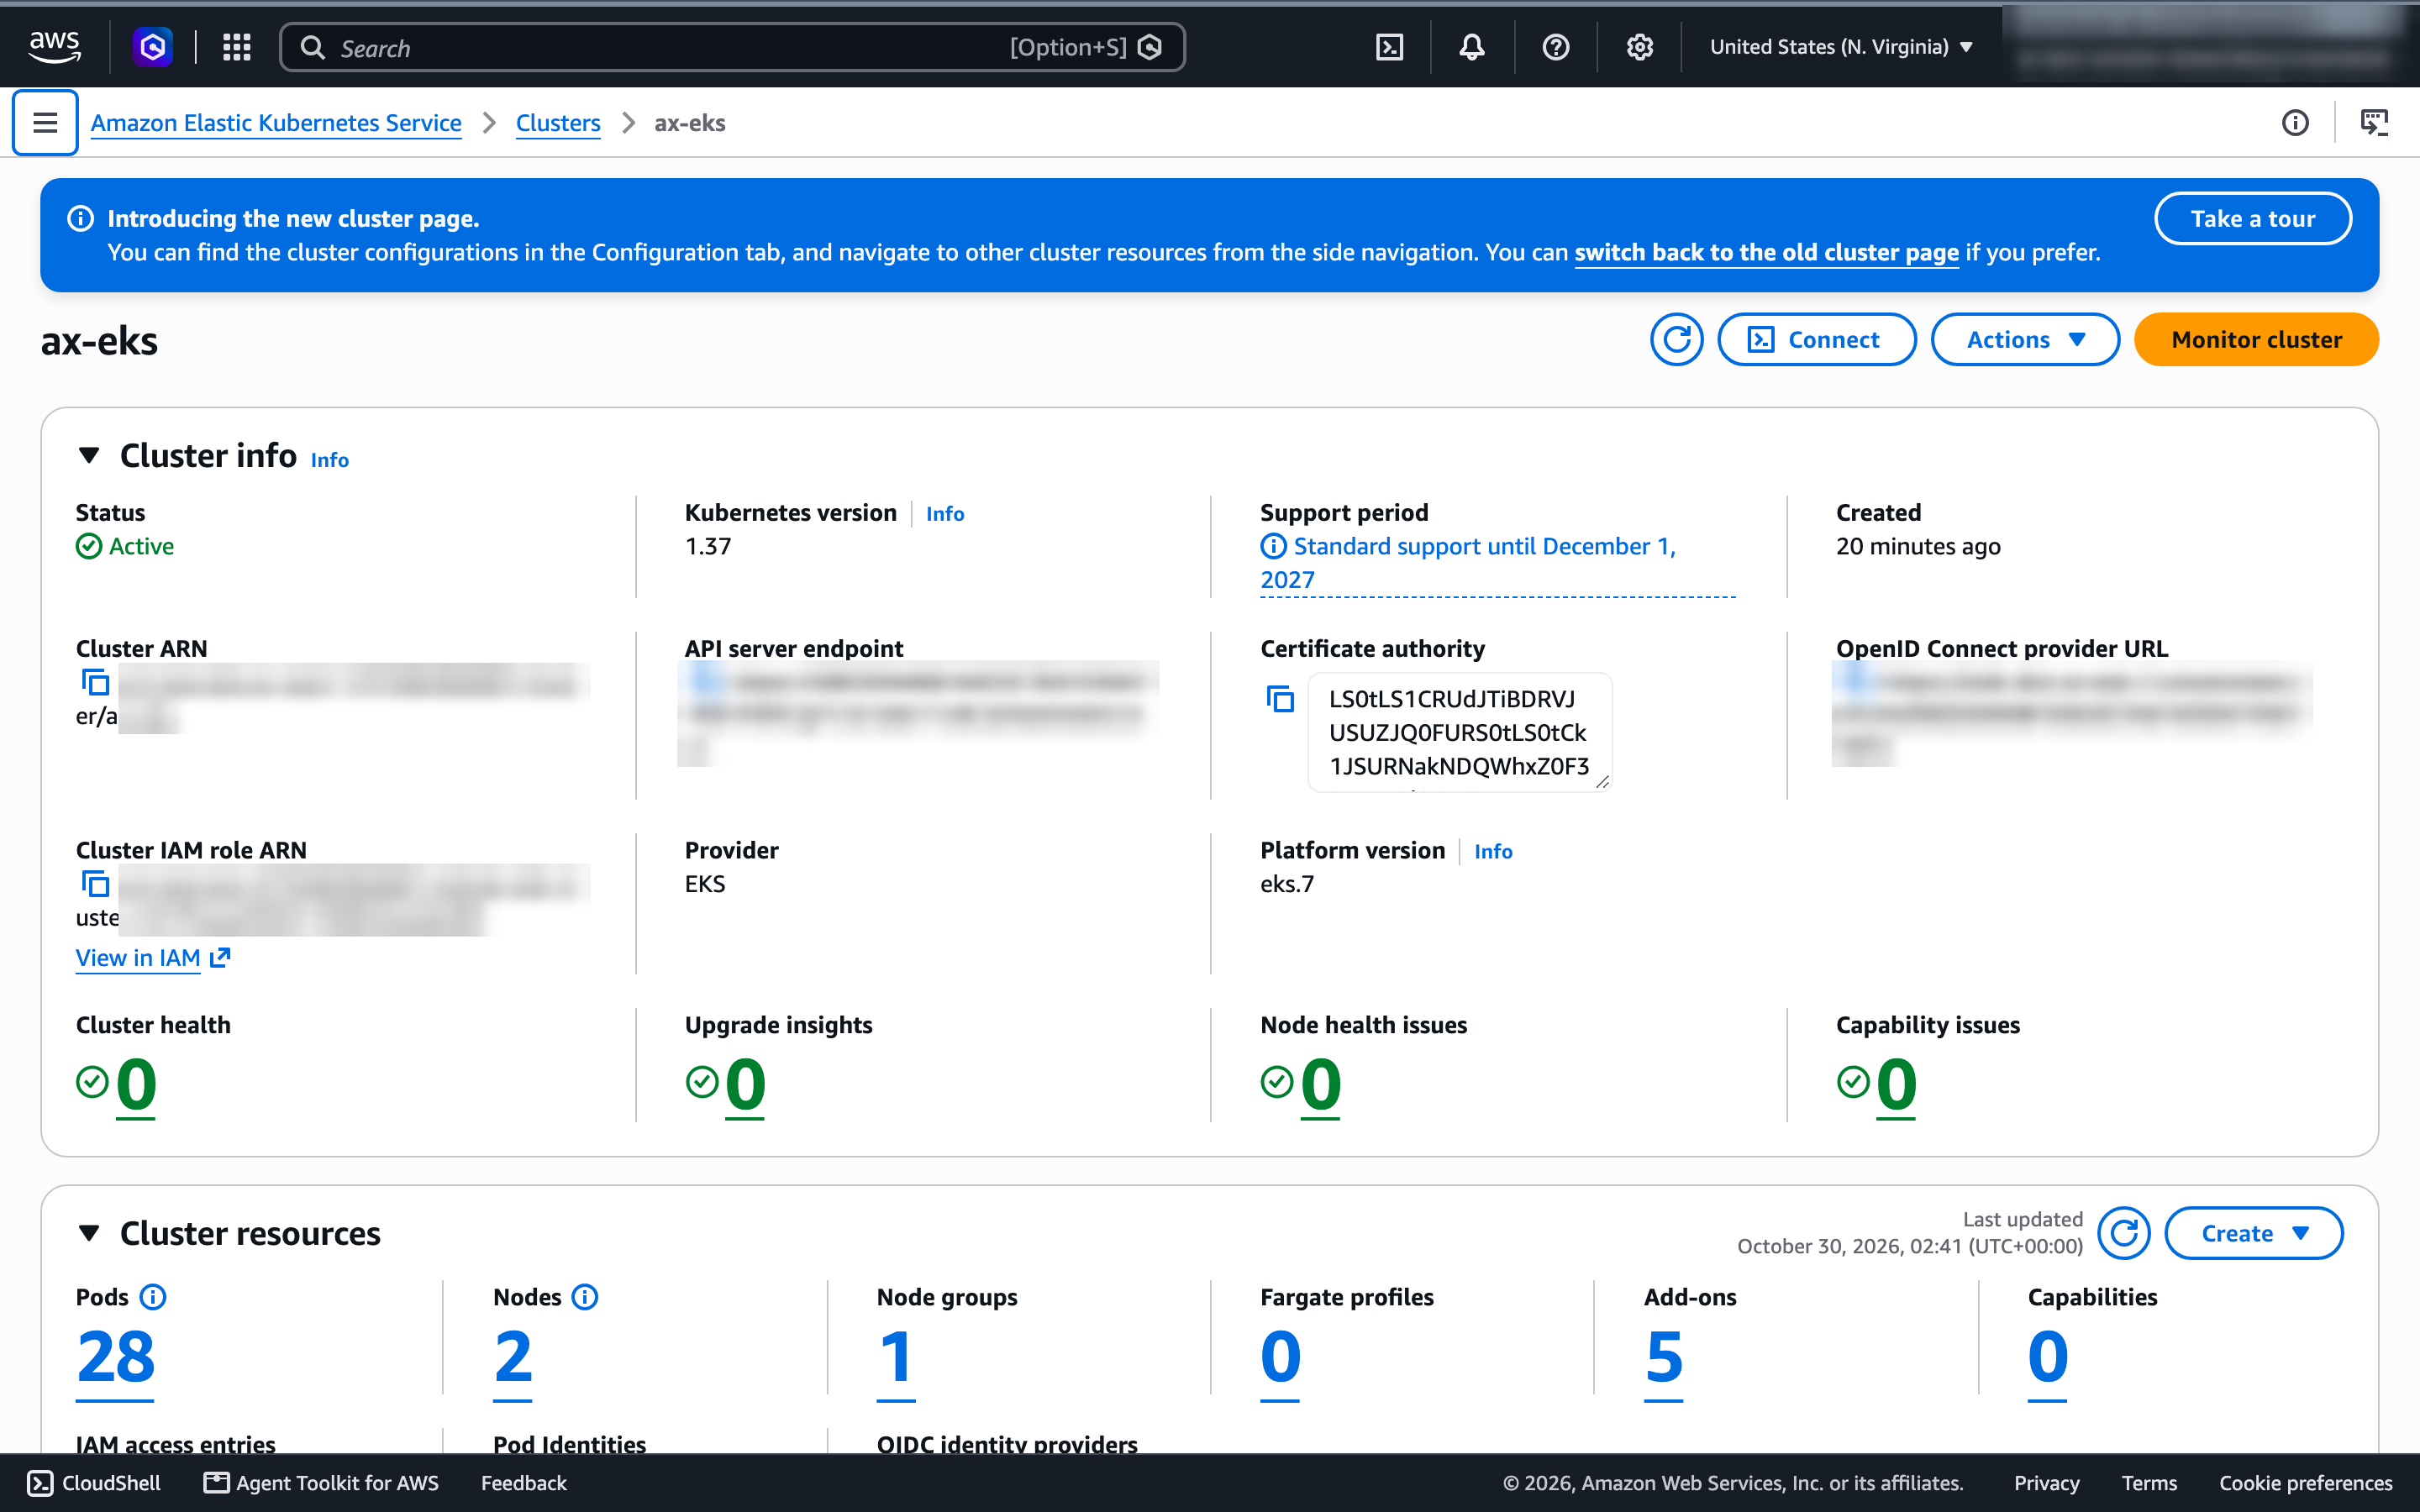
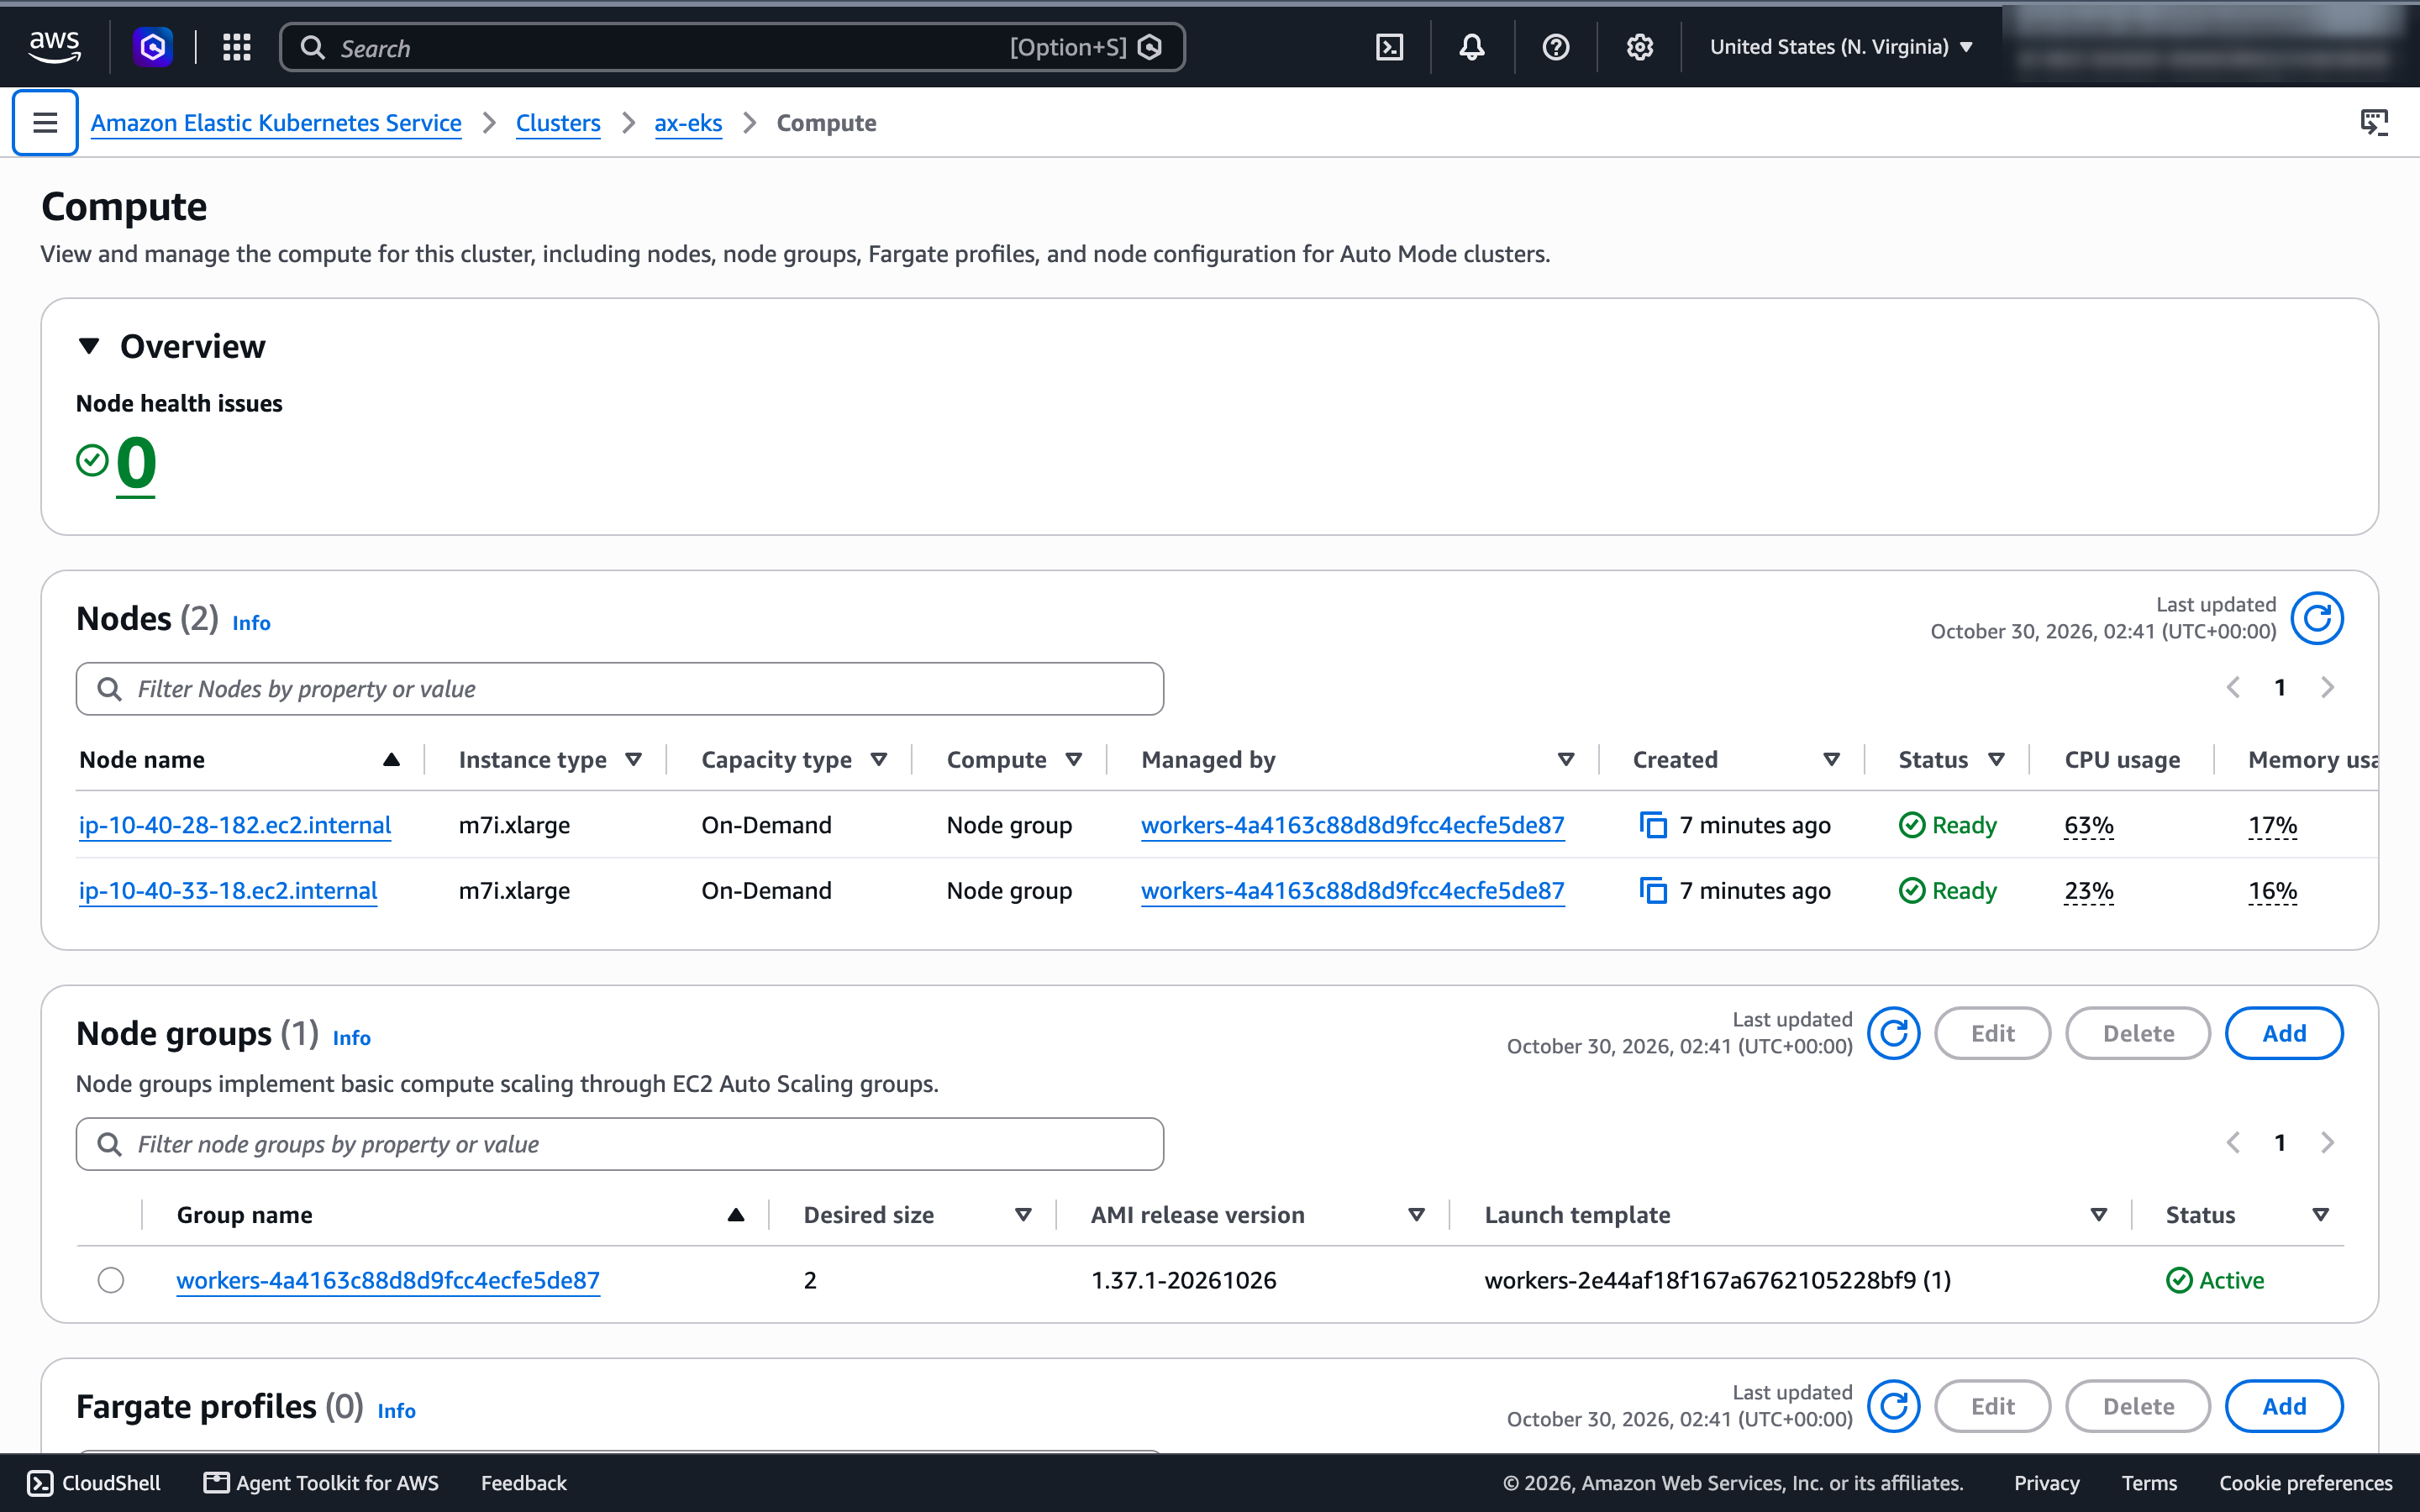
}./scripts/01_cluster.shO apply criou 67 recursos em 14 minutos e 9 segundos; só o control plane do EKS levou 11 minutos e 11 segundos, o NAT gateway quase 2 e o node group 1 minuto e 18 segundos. O cluster subiu em v1.37.1-eks-577a51e, platform version eks.7:
Passo 3: O código-fonte, e por que o EKS precisa de um patch
O instalador do Substrate, o ate-setup, conhece exatamente duas plataformas: --kind (um clone de S3 dentro do cluster chamado rustfs, com registry local) ou GKE (GCS, mais uma service account do Google sem a qual ele se recusa a iniciar). Uma instalação em EKS não se encaixa em nenhuma das duas, então o código de apoio adiciona um override ATE_SYSTEM_OVERLAY, aponta o ConfigMap de telemetria para a cópia do overlay e pula a verificação da service account do GCS quando ele está definido. São 11 linhas adicionadas no total; o núcleo:
func SystemOverlay(cfg *config.Config) string {
	// my2cents.ai EKS patch: an install outside kind and GKE names its own
	// kustomization, relative to the repository root.
	if overlay := os.Getenv("ATE_SYSTEM_OVERLAY"); overlay != "" {
		return overlay
	}
	switch {
	// ... agentgateway variants, then kind, then the GKE base bundle
O overlay fica ao lado dos bundles base (GKE) e kind do próprio Substrate. Ele muda três coisas: os snapshots vão para o S3 sem endpoint nem chaves estáticas (o Pod Identity fornece as credenciais), o atelet monta o credential provider do AL2023 em vez do do GKE, e os objetos exclusivos do GKE são removidos (um recurso PodMonitoring cujo CRD só existe no GKE, e o endpoint gerenciado de OpenTelemetry).
patches:
  - patch: |-
      apiVersion: apps/v1
      kind: DaemonSet
      metadata: { name: atelet, namespace: ate-system }
      spec:
        template:
          spec:
            initContainers:
            - name: objectstore-plugin
              env:
              - { name: ATE_STORAGE_BACKEND, value: s3 }
              - { name: AWS_REGION, value: us-east-1 }
            volumes:
            - name: image-credential-provider-bin
              hostPath: { path: /etc/eks/image-credential-provider, type: Directory }
            - name: image-credential-provider-config
              hostPath: { path: /etc/eks/image-credential-provider/config.json, type: File }
O código do Substrate estava mais preparado para isso do que o instalador. O comentário acima das flags de credential provider do atelet diz que ele executa o credential provider do próprio node para que “o mesmo binário autentique no Artifact Registry no GKE e no ECR no EKS”, e o backend S3 existe no plugin de object store. Só o caminho de instalação pressupõe o Google.
./scripts/02_sources.shO script é um wrapper fino: faz checkout dos dois repositórios nos commits fixados, aplica o patch e copia o overlay para a árvore de manifests do Substrate, onde o ate-setup espera encontrar.
checkout https://github.com/google/ax.git "$AX_SRC" "$AX_REF"                              # a496fc1…
checkout https://github.com/agent-substrate/substrate.git "$SUBSTRATE_SRC" "$SUBSTRATE_REF" # d3f2363…
(cd "$AX_SRC" && go list -m go.ate.dev/substrate)   # confirm AX's go.mod agrees

git -C "$SUBSTRATE_SRC" apply "$ROOT/substrate-eks/ate-setup-overlay.patch"
cp -R "$ROOT/substrate-eks/overlay" "$SUBSTRATE_SRC/manifests/ate-install/eks"
== Sources
ax at a496fc1ff1cf (2026-10-28)
substrate at d3f2363590a1 (2026-10-22)
== AX's recorded Substrate dependency
go.ate.dev/substrate v0.6.0
== EKS overlay for Substrate
M cmd/ate-setup/internal/config/config.go
M cmd/ate-setup/internal/steps/overlay.go
?? manifests/ate-install/eks/Fixe os dois. O guia do AX avisa que um CLI instalado com go install …@latest “pode usar uma API RPC diferente” de um servidor buildado a partir da main, e a release v0.3.1 do AX (Redis, um controller separado) já não se parece com a main (PostgreSQL, um único servidor). O Substrate lançou a v1.0.0-rc.1 um dia antes de eu escrever isto; o guia do AX diz para não trocar por um Substrate mais novo do que o registrado no go.mod dele.
Testes
Teste 1: O cluster atende ao nível exigido pelo Substrate?
O Substrate precisa de três features do Kubernetes que o EKS não anuncia: as APIs PodCertificateRequest e ClusterTrustBundle, e a fonte de projected volume podCertificate que entrega a identidade mTLS de cada pod. Elas são GA e ficam ligadas por padrão a partir do Kubernetes 1.37. Antes disso, a PodCertificateRequest é beta (1.35 e 1.36) ou alpha (1.34), e o EKS não te dá nenhum jeito de ligar nenhuma das duas. É por isso que uma instalação em EKS 1.36 descartou a projeção silenciosamente, e por isso que a primeira tentativa do Weiss num cluster mais antigo travou. No EKS, 1.37 é o mínimo.
O 01_cluster.sh verifica as três em cerca de 10 segundos, logo depois do terraform apply. As duas primeiras são chamadas simples de discovery. A terceira é a que vale a pena copiar: um dry run server-side de um pod que pede um volume podCertificate. Nada é agendado, mas o pod passa pela cadeia inteira de admission, então se alguma coisa no cluster descartar o campo você vê voltar um {} vazio.
k get --raw /apis/certificates.k8s.io | jq -r '.versions[].groupVersion'
k api-resources --api-group=certificates.k8s.io -o wide

cat <<'EOF' | k create --dry-run=server -o jsonpath='{.spec.volumes[0].projected.sources}{"\n"}' -f -
apiVersion: v1
kind: Pod
metadata: { name: podcert-probe, namespace: default }
spec:
  containers: [{ name: c, image: public.ecr.aws/docker/library/busybox:1.37, command: ["true"] }]
  volumes:
  - name: id
    projected:
      sources:
      - podCertificate: { signerName: example.com/probe, keyType: ED25519, credentialBundlePath: bundle.pem }
EOF

k get nodes -o custom-columns='NODE:.metadata.name,KERNEL:.status.nodeInfo.kernelVersion,OS:.status.nodeInfo.osImage'
k é uma shell function para kubectl --context ax-eks, definida em scripts/env.sh junto com os commits fixados e os outputs do Terraform que todo script lê.
certificates.k8s.io/v1

NAME                         APIVERSION               NAMESPACED   KIND
certificatesigningrequests   certificates.k8s.io/v1   false        CertificateSigningRequest
clustertrustbundles          certificates.k8s.io/v1   false        ClusterTrustBundle
podcertificaterequests       certificates.k8s.io/v1   true         PodCertificateRequest

== Pod certificate projection survives admission
[{"podCertificate":{"credentialBundlePath":"bundle.pem","keyType":"ED25519","signerName":"example.com/probe"}}]

== Worker kernel
NODE                           KERNEL                            OS
ip-10-40-28-182.ec2.internal   6.18.56-125.164.amzn2023.x86_64   Amazon Linux 2023.12.20261026
ip-10-40-33-18.ec2.internal    6.18.56-125.164.amzn2023.x86_64   Amazon Linux 2023.12.20261026
As três passam. Só a v1 é servida, e a v1beta1 não pode ser habilitada num control plane gerenciado, mas os clients do Substrate tentam v1 primeiro e caem para v1beta1, então nada precisou mudar. O dry run importa por causa de um report no kagent de que o EKS 1.37 removia a fonte podCertificate. O autor depois rastreou isso até mutating webhooks mais antigos (aws-load-balancer-controller v3.1.0, bank-vaults v1.22.0) e um cache de schema do kubectl desatualizado, não até o EKS. Se você roda algum desses webhooks, esse probe é como você descobriria antes de os pods do Substrate entrarem em crash-loop. O kernel precisa ser 6.8 ou mais novo por causa da opção de mount lowerdir+ do OverlayFS que o cache de imagens do Substrate usa; o AL2023 vem com 6.18.
Teste 2: Instalar o Agent Substrate com o overlay de EKS
./scripts/03_substrate.shexport KO_DOCKER_REPO="$IMAGE_REPO/substrate" # 111122223333.dkr.ecr.us-east-1.amazonaws.com/ax-eks/substrate
export KO_DEFAULTPLATFORMS=linux/amd64
export SNAPSHOT_LOCATION="s3://ax-eks-snapshots-111122223333/"
export ATE_SYSTEM_OVERLAY=manifests/ate-install/eks
go run ./cmd/ate-setup --no-dev-env deploy ate-system \
--rollout-timeout=5m \
--credential-provider='{"name":"k8s.io"}' \
--ateapi-authz-bootstrap-owners="system:serviceaccount:ate-system:ate-client,system:serviceaccount:ax-system:ax-server" \
--ingress-allowed-spiffe-ids="spiffe://cluster.local/ns/ax-system/sa/ax-server"Esse é o coração do 03_substrate.sh. O script exporta essas configurações, roda o ate-setup através de tee para .records/ate-setup.log e filtra o terminal para mostrar só as linhas de [step] e de rollout, porque o ko imprime uma linha para cada layer que ele faz push. As duas últimas flags vêm do guia de instalação do AX: a conta do servidor do AX precisa ser owner no Substrate (ela cria actors) e um caller permitido do router de ingress (ela alcança as sandboxes).
O ate-setup compilou a si mesmo, fez build e push de todas as imagens do Substrate com ko, instalou os CRDs, o pod certificate controller, o PostgreSQL e o control plane, e esperou cada rollout. O script guarda os milhares de linhas de log do ko em .records/ate-setup.log e imprime só os passos. Na minha primeira instalação, com os caches de build do Go e do ko vazios, levou 6 minutos e 26 segundos; no rebuild limpo que eu gravei para o vídeo, com caches quentes mas repositórios do ECR vazios, 2 minutos e 39 segundos. As duas funcionaram de primeira, com todos os componentes prontos:
== ate-system
NAME                                      READY   UP-TO-DATE   AVAILABLE
deployment.apps/ate-api-server            2/2     2            2
deployment.apps/ate-controller            1/1     1            1
deployment.apps/ate-idp-server            2/2     2            2
deployment.apps/atenet-egress             1/1     1            1
deployment.apps/atenet-router             1/1     1            1
deployment.apps/k8s-credential-provider   1/1     1            1

NAME                    DESIRED   CURRENT   READY   UP-TO-DATE   AVAILABLE
daemonset.apps/atelet   2         2         2       2            2

NAME                        READY
statefulset.apps/postgres   1/1
O sidecar de object store confirmou o backend S3, e o agente de Pod Identity tinha injetado credenciais nele:
{"level":"INFO","msg":"Using S3 storage backend"}
{"level":"INFO","msg":"Serving credential exchange","address":"[::]:8445"}
ATE_STORAGE_BACKEND AWS_REGION POD_NAMESPACE AWS_STS_REGIONAL_ENDPOINTS
AWS_CONTAINER_CREDENTIALS_FULL_URI AWS_CONTAINER_AUTHORIZATION_TOKEN_FILEAs imagens chegaram no ECR sem um único repositório criado na mão:
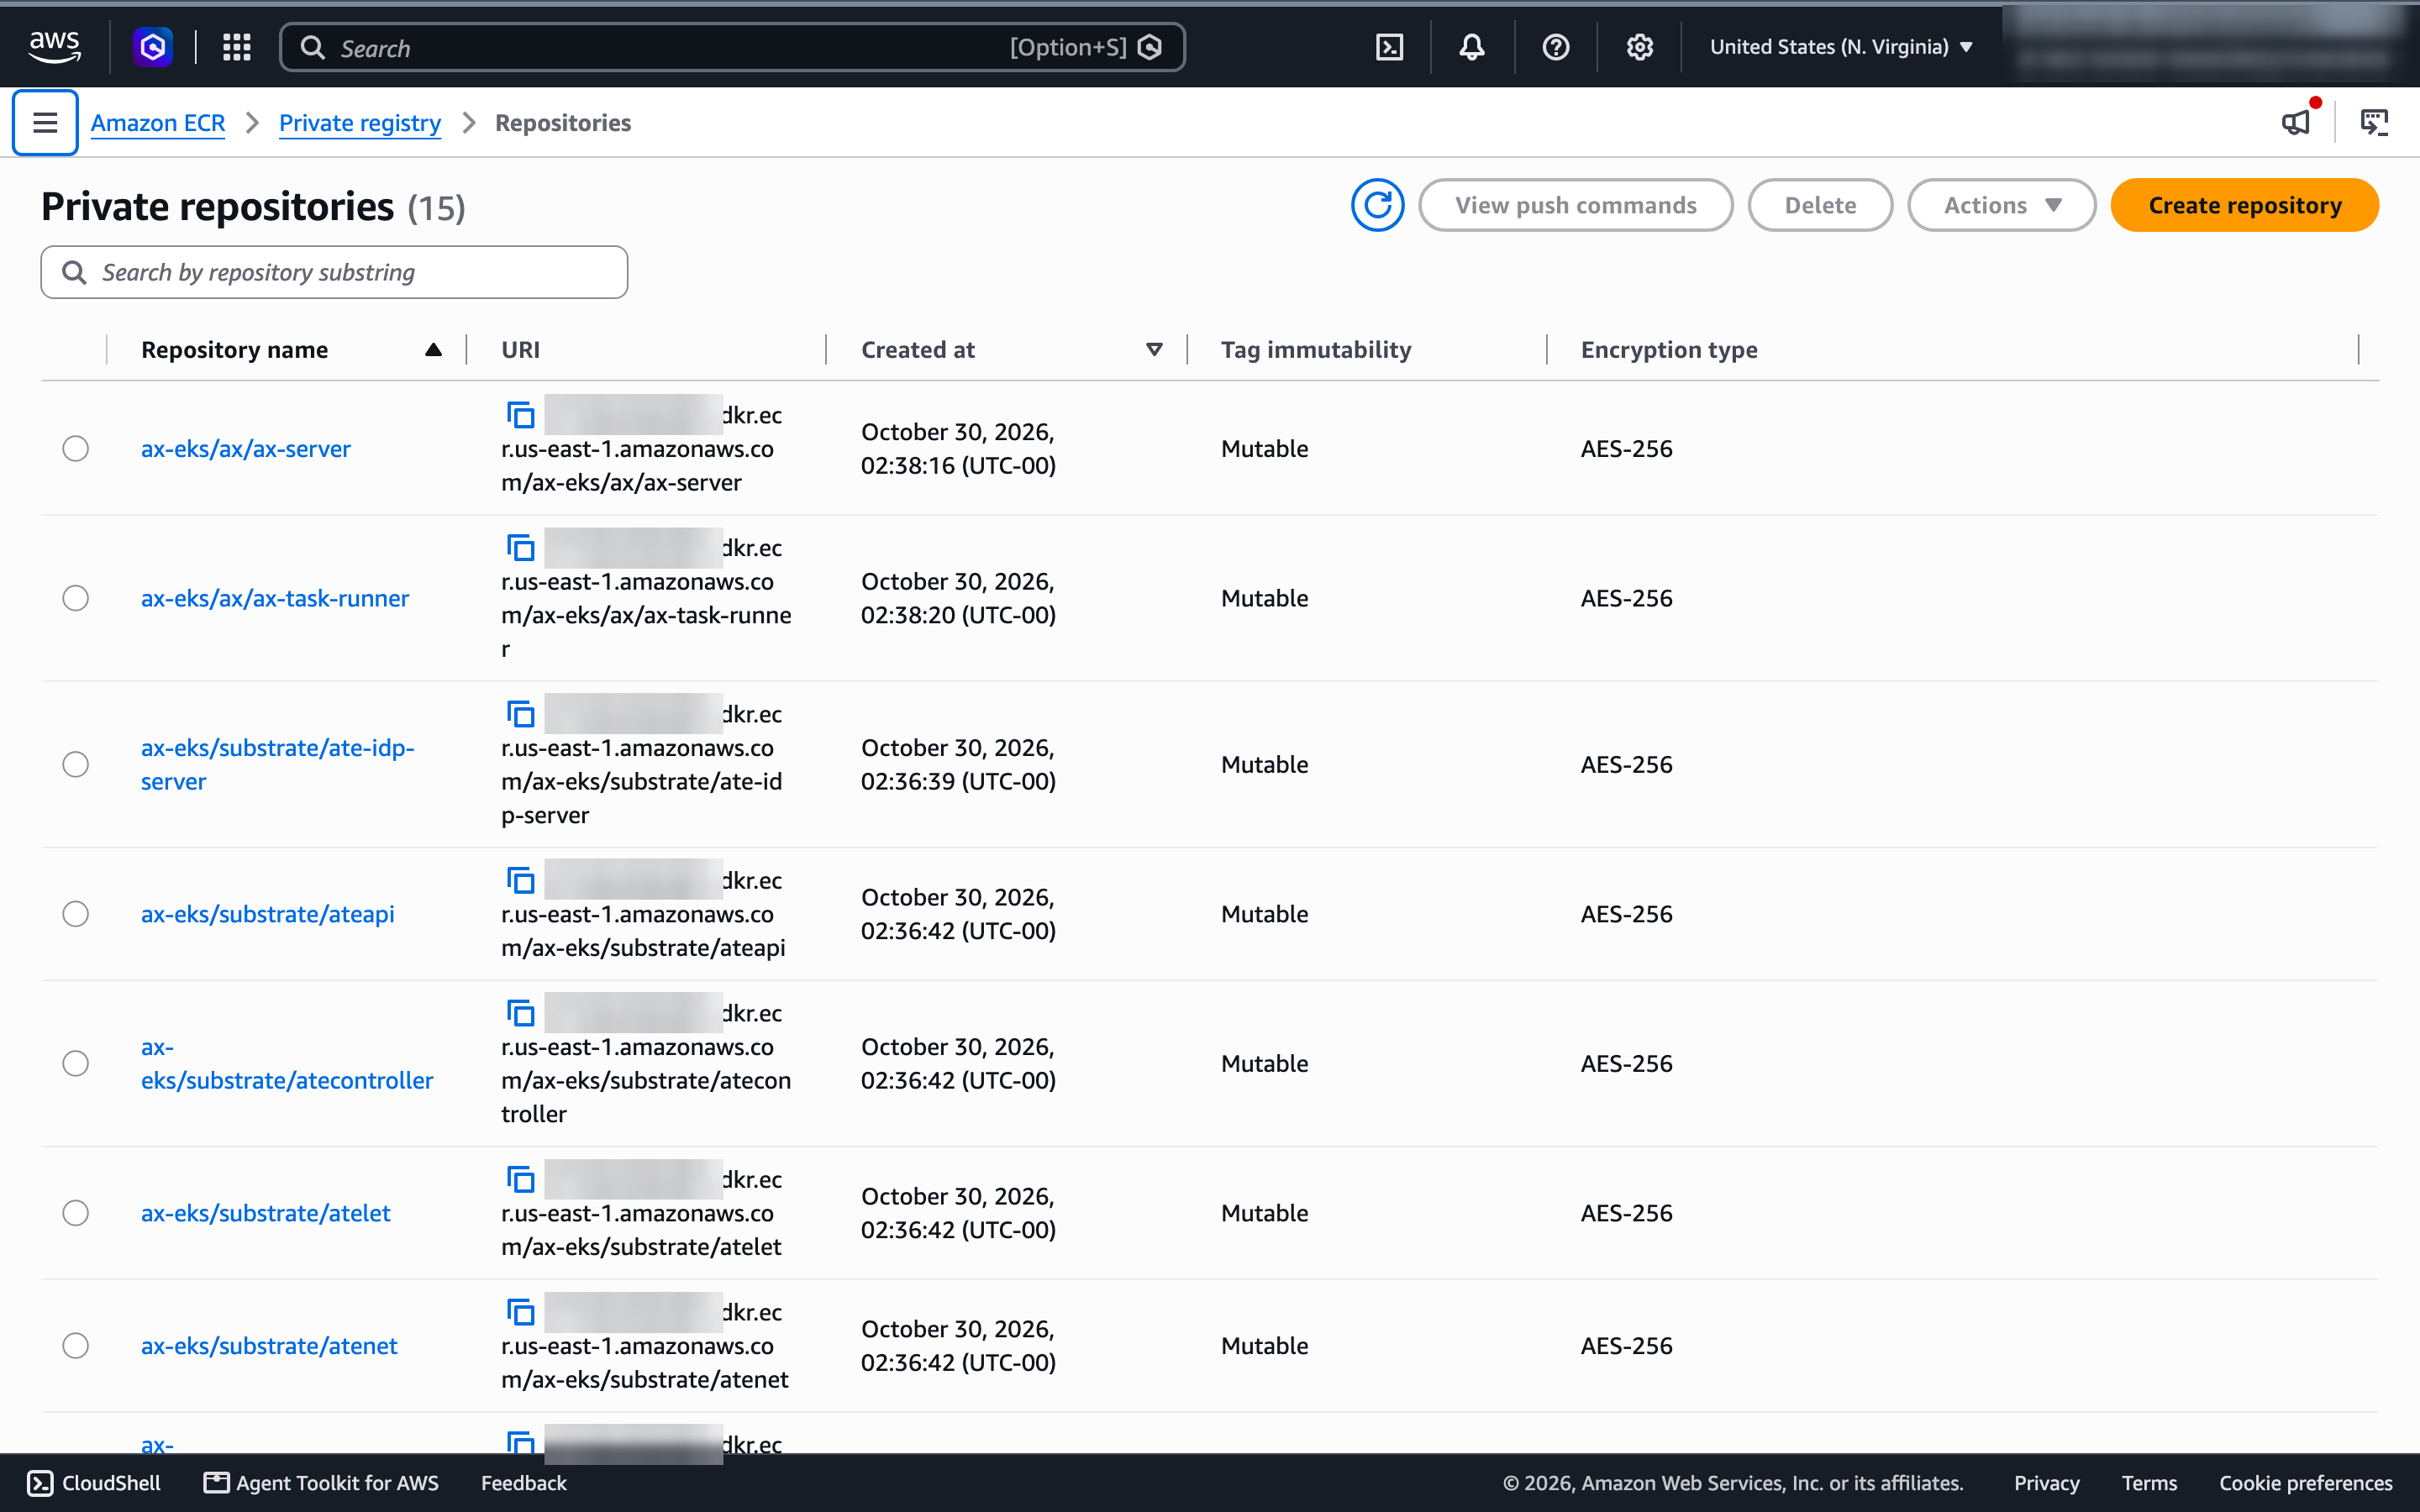
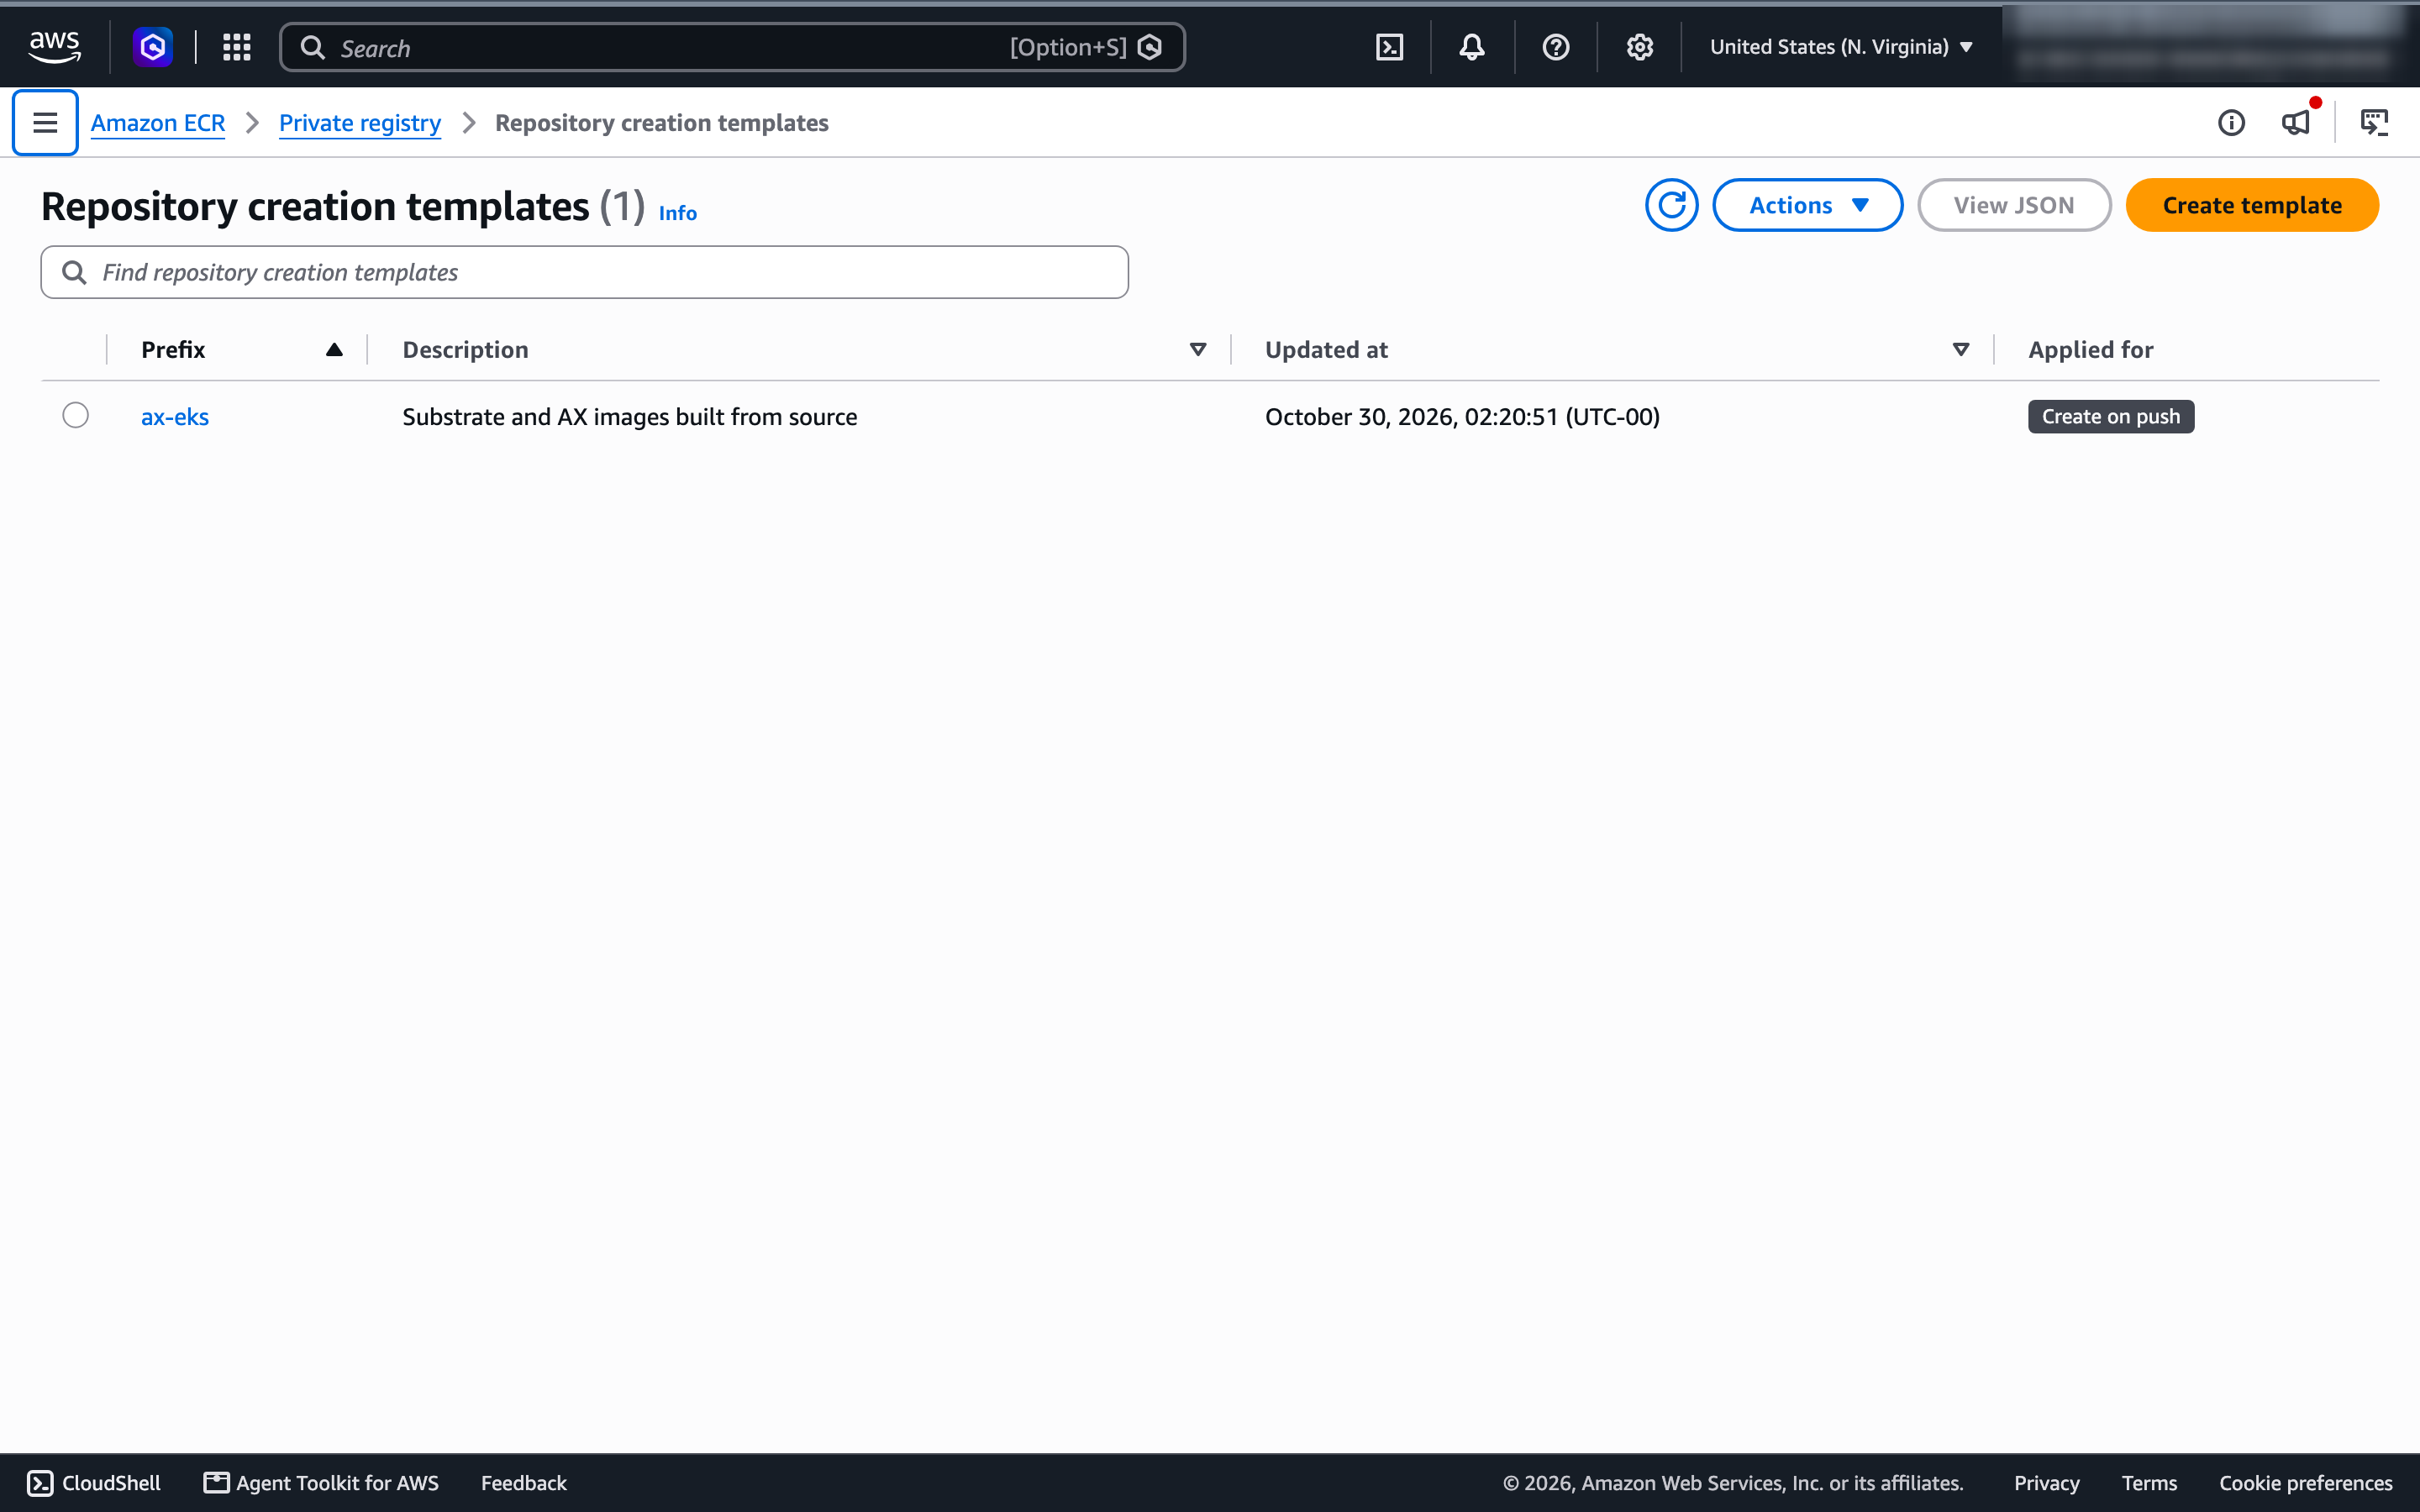
O único tropeço local não foi da AWS. O docker login no ECR falhou a partir de um script com User interaction is not allowed. (-25308): o Docker Desktop guarda os logins no keychain do macOS, que recusa escritas não interativas. Em vez disso, o código de apoio inclui um credential helper do Docker de 16 linhas, restrito ao registry do ECR, que chama aws ecr get-login-password a cada pull ou push e não armazena nada.
Teste 3: O WorkerPool
Instalar o Substrate não cria nenhum lugar para as sandboxes rodarem. O quickstart do AX também não cria (#437), então a primeira tarefa falha. O 04_workerpool.sh cria um pool de dois workers gVisor:
apiVersion: ate.dev/v1alpha1
kind: WorkerPool
metadata:
  name: ax-workers
  namespace: ax-system
spec:
  replicas: 2
  workerImage: ko://go.ate.dev/substrate/cmd/ateworker-gvisor
  sandboxClasses:
  - name: gvisor
    configRef:
      name: gvisor-default
NAMESPACE NAME DESIRED REPLICAS READY SANDBOXCONFIG RESOLVED AGE
ax-system ax-workers 2 2 2 gvisor-default True 4sCerca de 20 segundos na execução gravada, incluindo o build e o push com ko. O gVisor não precisou de nada do node: nenhum equivalente ao GKE Sandbox, nenhuma virtualização aninhada, nenhuma AMI customizada. O runtime runsc vem dentro da imagem do worker.
Teste 4: Build e deploy do AX
./scripts/05_ax.shIsso segue o guia de instalação do AX à risca: faz o build do CLI no próprio bin/ do checkout (para que um ax mais antigo no seu PATH não seja usado), faz o build do ax-server e do ax-task-runner com make images, e faz deploy por digest, nunca por tag. O núcleo do 05_ax.sh:
(cd "$AX_SRC" && GOBIN="$AX_SRC/bin" make install)            # the ax CLI, from the same commit

make images CONTAINER_CLI=docker IMAGE_ARCH=amd64 \
  AX_IMAGE_REPO="$AX_IMAGE_REPO" IMAGE_TAG="$IMAGE_TAG" ...     # builds and pushes both images

# make images writes each pushed digest to bin/*.digest; deploy those, not tags
AX_SERVER_IMAGE="$AX_IMAGE_REPO/ax-server@$(cat "$AX_SRC/bin/ax-server.digest")"
AX_DEFAULT_TASK_IMAGE="$AX_IMAGE_REPO/ax-task-runner@$(cat "$AX_SRC/bin/ax-task-runner.digest")"
sed -e "s|\${AX_SERVER_IMAGE}|$AX_SERVER_IMAGE|g" \
    -e "s|\${AX_DEFAULT_TASK_IMAGE}|$AX_DEFAULT_TASK_IMAGE|g" \
    "$AX_SRC/deploy/ax-server.yaml" > "$RECORDS/ax-server.yaml"

# PostgreSQL reads its password only when it initializes an empty volume,
# so the secret is created once and never replaced.
k -n ax-system get secret ax-postgres >/dev/null 2>&1 \
  || k -n ax-system create secret generic ax-postgres --from-literal=password="$(openssl rand -hex 24)"
k apply -f "$AX_SRC/deploy/postgres.yaml"
k apply -f "$RECORDS/ax-server.yaml"
O make images faz cross-compile para amd64 num Mac arm64: 54 segundos na primeira vez, 21 segundos no rebuild. O script registra exatamente o que foi deployado:
AX_REF=a496fc1ff1cf9bea4c34924348e4119172cfea5b
SUBSTRATE_REF=d3f2363590a11b2f50489971985ba033b4c9eff7
AX_SERVER_IMAGE=111122223333.dkr.ecr.us-east-1.amazonaws.com/ax-eks/ax/ax-server@sha256:3e357269…
AX_DEFAULT_TASK_IMAGE=111122223333.dkr.ecr.us-east-1.amazonaws.com/ax-eks/ax/ax-task-runner@sha256:455beac6…
A imagem padrão de tarefa importa mais do que parece. O default embutido no AX, e a imagem dos manifests de exemplo dele, é uma imagem privada do Google (#424), então você precisa do seu próprio ax-task-runner e deve apontar AX_DEFAULT_TASK_IMAGE para ele. O PostgreSQL e o ax-server fizeram rollout em cerca de 30 segundos:
NAME                          READY   STATUS    RESTARTS   AGE
ax-postgres-0                 1/1     Running   0          31s
ax-server-6b5d69b569-lxshd    1/1     Running   0          8s
ax-workers-7d9cc594c5-hpt7j   1/1     Running   0          61s
ax-workers-7d9cc594c5-wbmtx   1/1     Running   0          62s
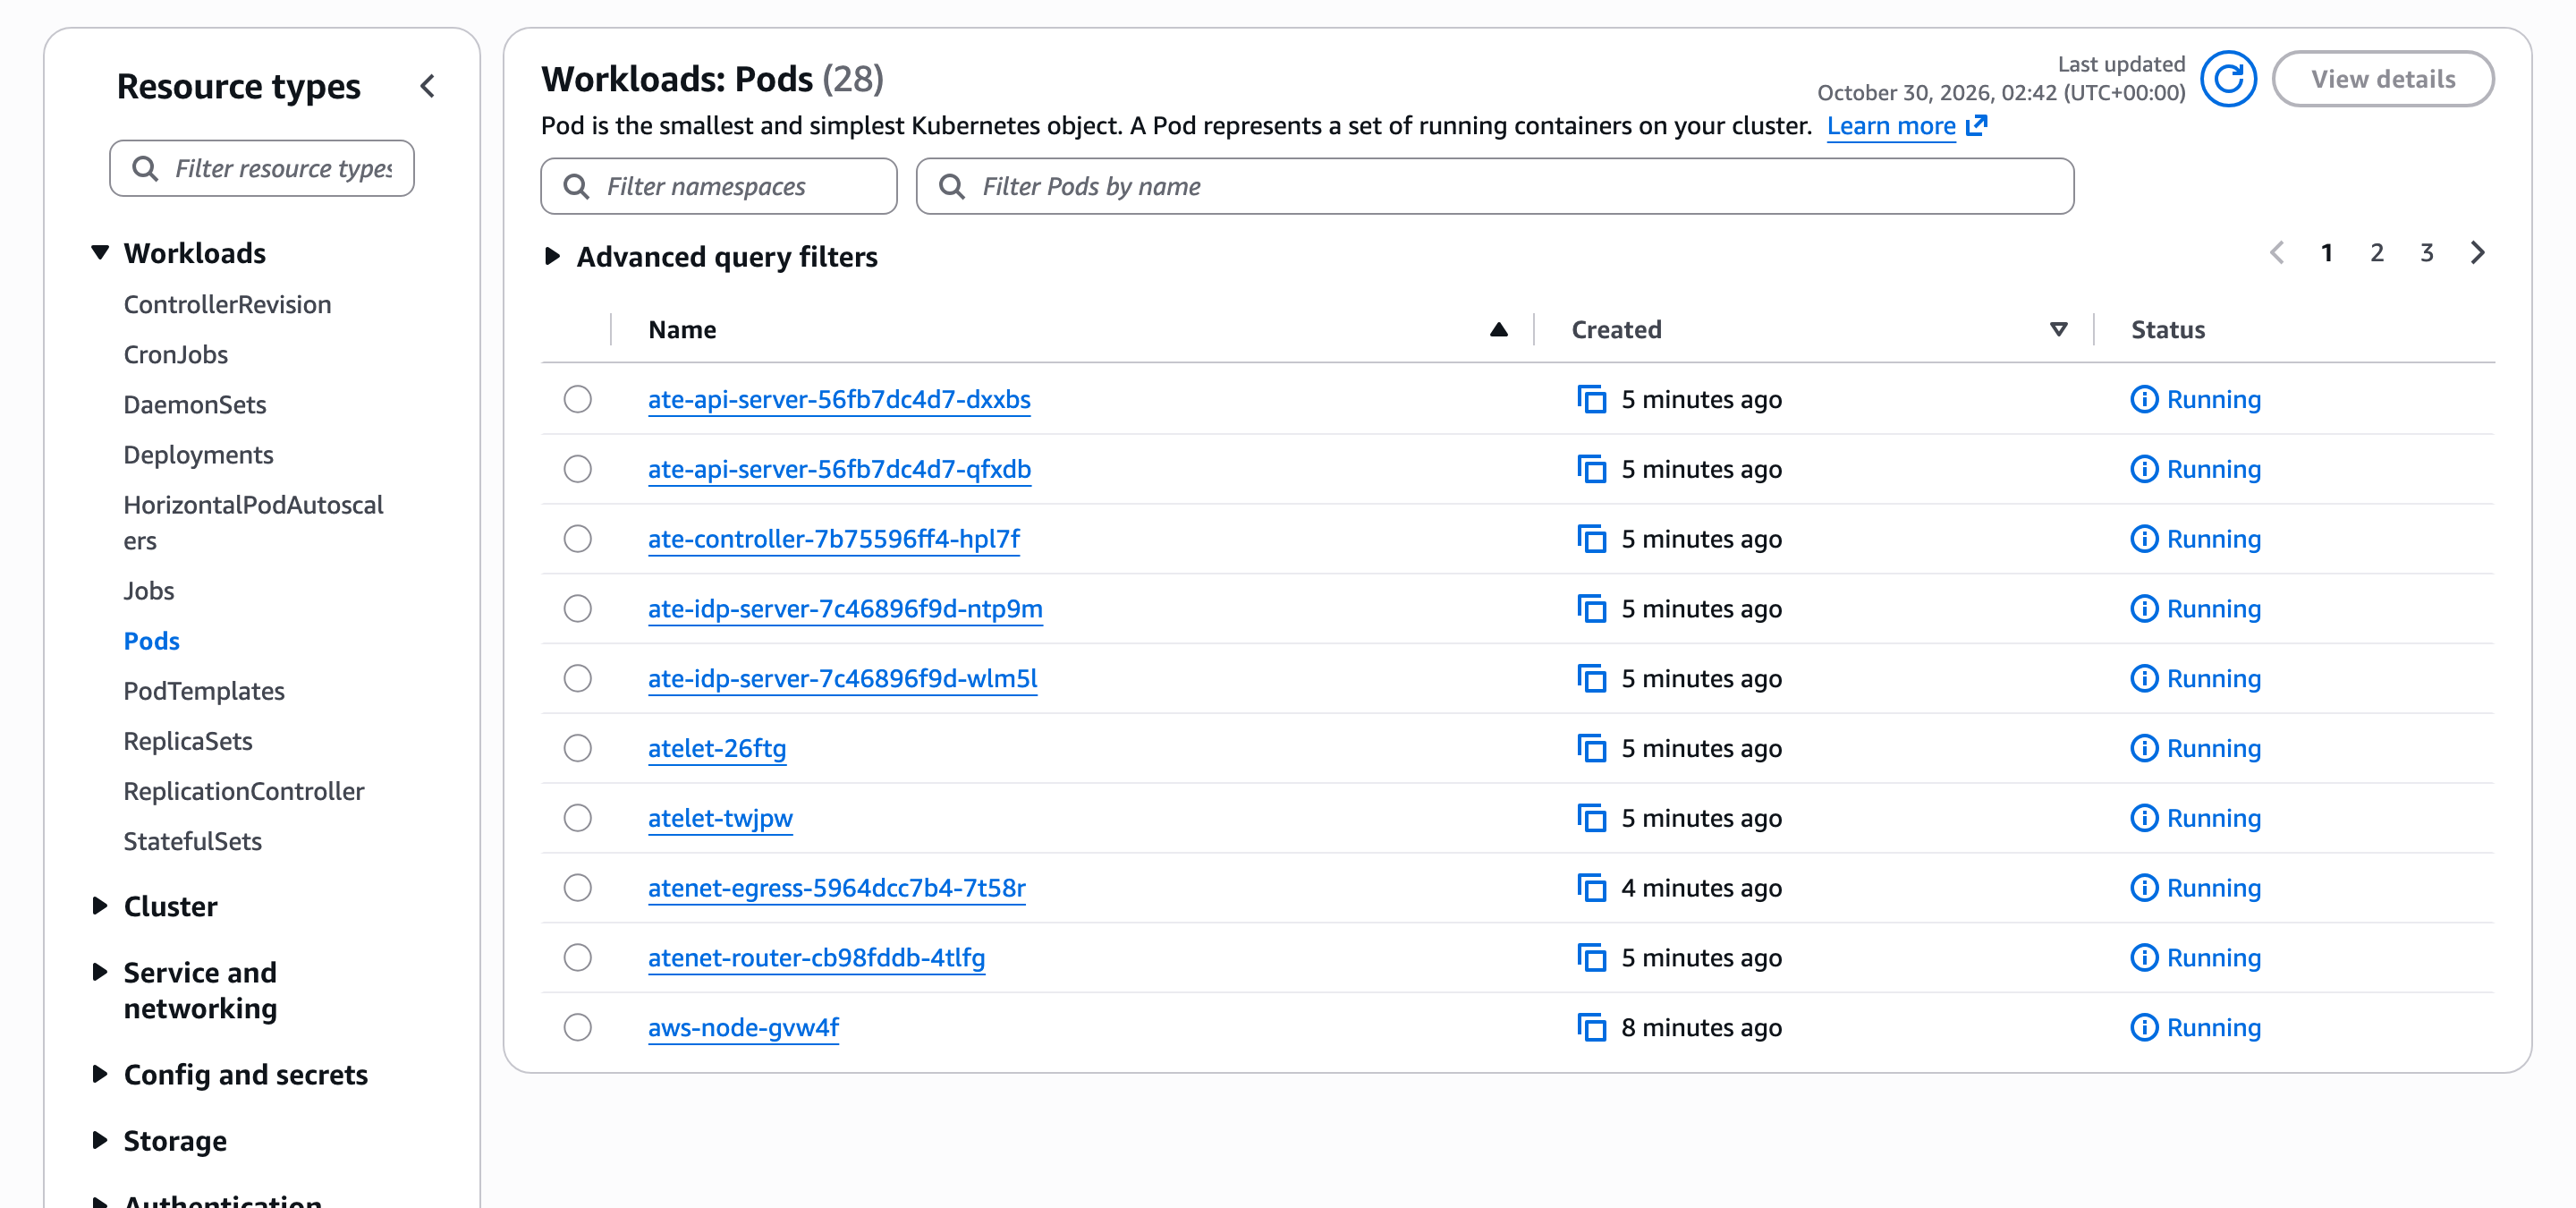
A visão do console do EKS sobre o cluster depois das duas instalações: 28 pods, todos rodando.
Teste 5: O smoke test
O guia do AX termina com uma verificação que não precisa de Workspace, nem de Model, nem de API key: uma tarefa que roda sleep infinity, é retomada e depois acessada via ax ssh. O 06_check_task.sh escreve o manifest abaixo e envolve cada chamada do CLI num timer em milissegundos:
timed() { local t0; t0=$(ms); "$@"; echo "  -> $(( $(ms) - t0 )) ms"; }

timed ax apply -f "$RECORDS/task.yaml"      # create: the task lands Suspended
timed ax resume task "$TASK"                 # Substrate restores it onto a gVisor worker
timed ax ssh "$TASK" -- sh -c 'echo installation-ok; uname -a; cat /proc/version'
timed ax delete task "$TASK"
ax é uma shell function para o CLI buildado no Teste 4, fixada no context do cluster e no namespace ax-system.
apiVersion: ax.io/v1alpha1
kind: Task
metadata:
  name: ax-install-1793327949
  atespace: default
spec:
  debug: true          # required for ax ssh
  command: ["sleep", "infinity"]
== apply (a new task starts Suspended)
task.ax.io/ax-install-1793327949 created
-> 1985 ms
Phase: Suspended
Ready False Suspended Actor is suspended
== resume
task.ax.io/ax-install-1793327949 resumed
-> 4627 ms
Phase: Running
Worker IP: 10.40.45.158
WorkspaceReady True SetupComplete Workspace setup completed at 10.40.45.158
Ready True TaskRunning Task is running and its workspace is ready
== ssh
installation-ok
Linux actor 4.19.0-gvisor #1 SMP Sun Jan 10 15:06:54 PST 2016 x86_64 GNU/Linux
-> 7243 ms
== delete
task.ax.io/ax-install-1793327949 deleted
-> 911 msO AX roda no EKS. A linha do kernel é o que denuncia que o comando rodou dentro do gVisor: 4.19.0-gvisor é a versão que o gVisor reporta, enquanto o node por baixo roda 6.18. Uma tarefa nova começa Suspended em vez de rodando, como a #426 aponta; o README ainda mostra Running. O tempo do ax ssh inclui o CLI montando a conexão: o IP do pod do worker não é roteável a partir do meu laptop, então ele passa por um port-forward até o router do Substrate sobre mTLS.
Teste 6: Uma primeira olhada no suspend
O ciclo de vida completo fica para a parte 2, mas eu queria saber uma coisa antes de dar a instalação como concluída: para onde vai uma tarefa suspensa? O README do AX diz que o ax suspend vai “fazer checkpoint do estado do actor e pausar”, e o Substrate anuncia resume com preservação de memória em menos de 400 ms. O 07_suspend.sh escreve um arquivo em /tmp, um marcador e um arquivo de 50 MB em /workspace, inicia um sleep 3000 em background, depois suspende e retoma a tarefa e olha de novo:
./scripts/07_suspend.shax ssh "$TASK" -- sh -c '
echo tmp-ok > /tmp/marker
echo workspace-ok > /workspace/marker
dd if=/dev/urandom of=/workspace/blob bs=1M count=50 2>/dev/null
nohup sleep 3000 >/dev/null 2>&1 &'
timed ax suspend task "$TASK"
aws s3 ls --recursive --summarize "$SNAPSHOT_LOCATION" | tail -2 # what reached S3?
timed ax resume task "$TASK"
ax ssh "$TASK" -- sh -c '
cat /workspace/marker; ls -la /workspace/blob
cat /tmp/marker
echo "background sleep 3000 running: $(ps -eo args | grep -cx "sleep 3000")"; uptime'O match ps -eo args | grep -cx é exato de propósito: um grep sleep mais solto também conta a própria linha de comando do sh -c, que contém as mesmas palavras.
== write state: /tmp, /workspace (50 MB) and a background process
-rw-r--r-- 1 root root        7 Oct 30 02:39 /tmp/marker
-rw-r--r-- 1 root root 52428800 Oct 30 02:39 /workspace/blob
-rw-r--r-- 1 root root       13 Oct 30 02:39 /workspace/marker
background sleep 3000 running: 1

== suspend
task.ax.io/suspend-1793327967 suspended
  -> 856 ms
Phase:        Suspended

== objects in the S3 snapshot bucket
Total Objects: 5
   Total Size: 962

== resume
task.ax.io/suspend-1793327967 resumed
  -> 845 ms

== what came back
workspace-ok
-rw-r--r-- 1 root root 52428800 Oct 30 02:39 /workspace/blob
cat: /tmp/marker: No such file or directory
background sleep 3000 running: 0
 02:39:41 up 0 min,  0 users,  load average: 0.00, 0.00, 0.00

== where the checkpoint went
"msg":"pruned local checkpoint","path":"/var/lib/ate/snapshots/8e5ddf9b-…/local-checkpoint/e13cf568-…"
Os dois abaixo de um segundo, mas o que sobrevive é só o /workspace: o arquivo de 50 MB voltou, os arquivos em outros lugares e o processo em background não, e o uptime diz que a sandbox acabou de dar boot. Isso é by design. O AX pede ao Substrate um snapshot só de volumes, e a documentação do runner do AX diz que uma tarefa retomada vê “os mesmos arquivos, mas uma nova árvore de processos”. O Substrate consegue fazer snapshot de memória; o AX é que não pede. Então um suspend do AX é um restart que preserva um volume, não uma pausa que preserva um processo em execução.
A outra surpresa foi para onde o snapshot foi. O atelet registrou um local-checkpoint no próprio disco do worker. Enquanto a tarefa ficou suspensa, o bucket S3 guardava cinco objetos somando 962 bytes (manifests de tags, nenhum dado de snapshot), e o Substrate apagou esses objetos junto com a tarefa:
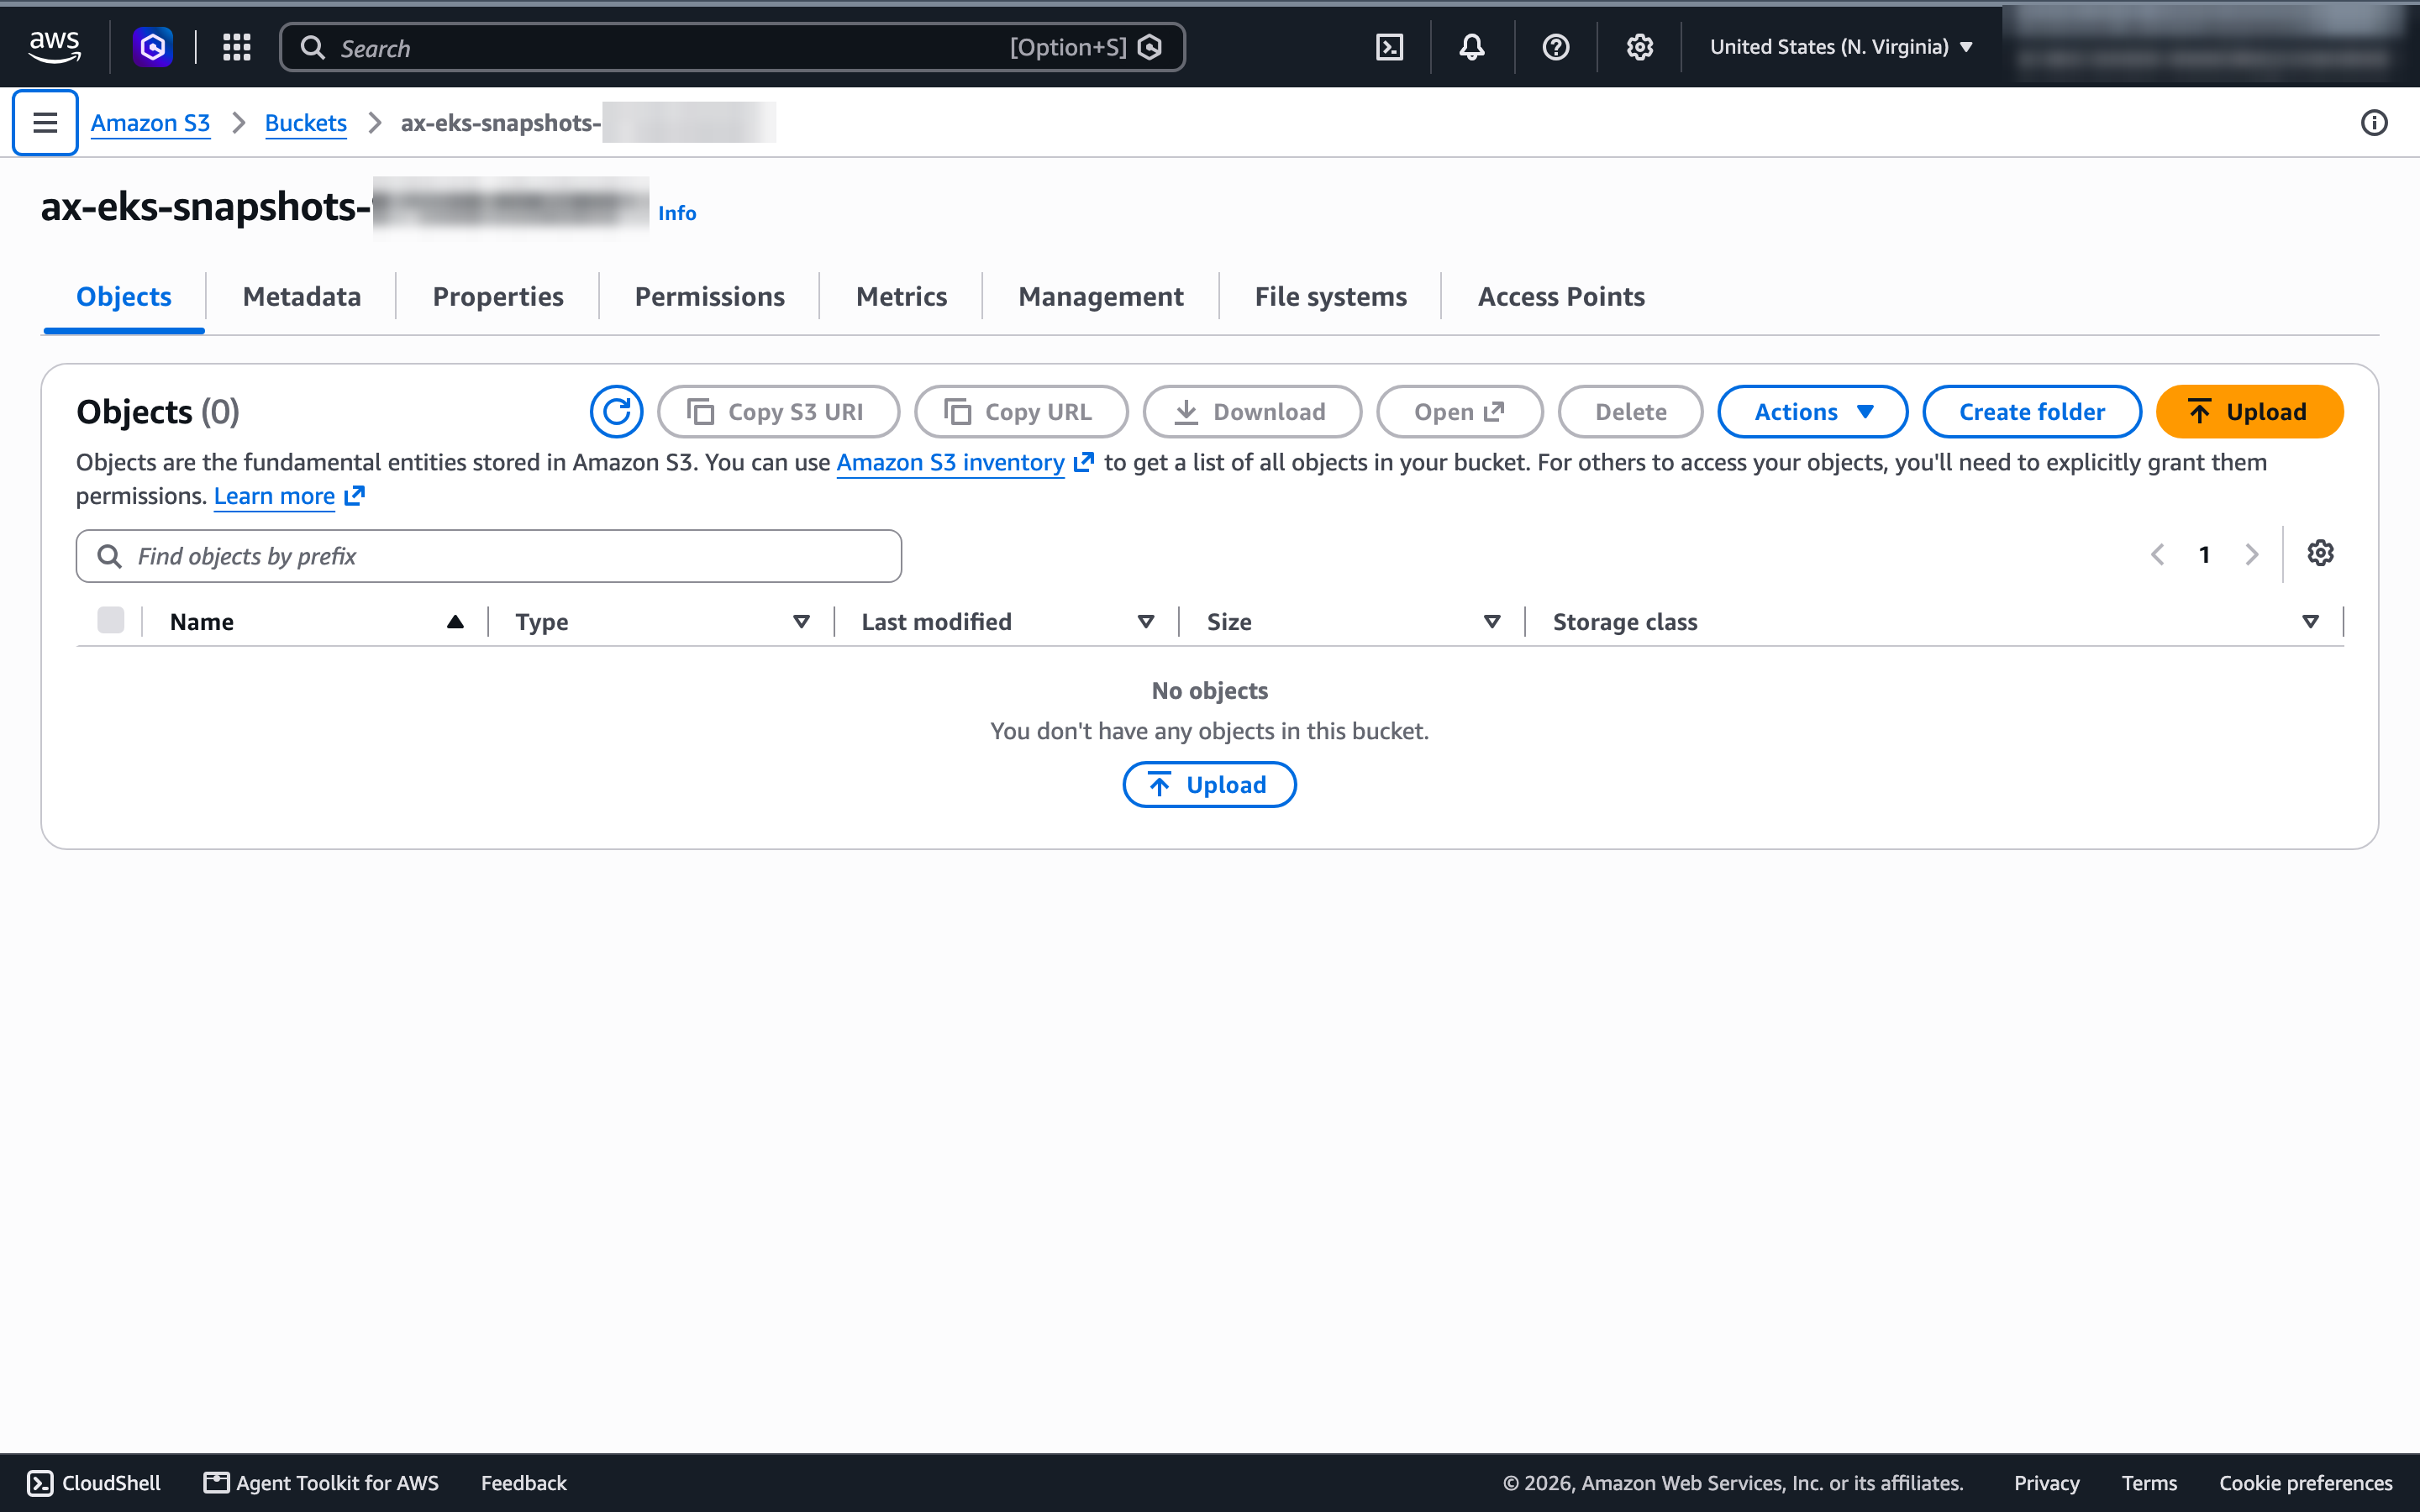
O S3 está conectado; meus testes só nunca esperaram por ele. O suspend do Substrate é assíncrono por padrão: o checkpoint vai primeiro para o node, o atelet faz upload dele para o object storage em background cinco minutos depois (--snapshot-upload-delay), e descarta a cópia local depois de 30 minutos (--snapshot-detach-delay). Minhas tarefas foram apagadas segundos depois de suspensas, então nada chegou a ser enviado. O post sobre o ciclo de vida espera esse tempo.
Resumo dos resultados
| Etapa | Rebuild gravado | Primeira execução (caches frios) | Observações |
|---|---|---|---|
terraform apply (67 recursos) | 14 min 9 s | 12 min 47 s + 22 s | Control plane do EKS: 11 min 11 s |
| Verificações de prontidão do cluster | ~10 s | ~10 s | certificates v1, projeção intacta, kernel 6.18 |
Build + instalação do Substrate (ate-setup) | 2 min 39 s | 6 min 26 s | ko faz build e push; de primeira nas duas vezes |
| WorkerPool (2 workers gVisor) | ~20 s | ~40 s | nenhuma mudança nos nodes para o gVisor |
Imagens do AX (make images) | 21 s | 54 s | amd64 a partir de um Mac arm64 |
PostgreSQL do AX + ax-server | ~30 s | ~30 s | |
| Create / resume / ssh / delete de tarefa | 2.0 / 4.6 / 7.2 / 0.9 s | 2.7 / 4.8 / 7.3 / 4.9 s | ssh inclui o port-forward |
| Suspend / resume | 0.86 / 0.85 s | 0.85 / 0.81 s | só o /workspace sobrevive |
99_teardown.sh | 11 min 36 s | 12 repositórios do ECR, 67 recursos |
De uma conta AWS vazia até um smoke test passando: cerca de 19 minutos no rebuild gravado, cerca de 22 na minha primeira execução, quase tudo esperando pelo EKS e pelos builds.
Preços
O AX e o Substrate são gratuitos. A conta é o cluster, e ele roda tendo ou não alguma tarefa rodando:
| Recurso | Preço (us-east-1, on-demand) | Por hora |
|---|---|---|
| Control plane do EKS (suporte padrão) | $0.10/h | $0.10 |
2 × m7i.xlarge | ~$0.20/h cada | ~$0.40 |
| NAT gateway | ~$0.045/h + dados | ~$0.05 |
| IPv4 público do NAT gateway | $0.005/h | $0.005 |
| EBS gp3: 2 × discos de node de 100 GB, PostgreSQL do Substrate 500 GiB, PostgreSQL do AX 10 GiB | $0.08/GB-mês | ~$0.08 |
| S3, ECR | centavos para este teste | ~0 |
| Total | ~$0.63/h, cerca de $15/dia |
A linha surpresa é o storage. O PostgreSQL embutido do Substrate pede um volume de 500 GiB, dimensionado para o perfil de cluster grande, que custa mais do que o control plane do EKS. Para uma avaliação daria para reduzir isso no overlay; eu deixei o default do Substrate.
Esse é o piso para um cluster de avaliação, pago tendo ou não uma única tarefa rodando, então o cluster só se paga quando está ocupado. O pitch do AX, muitos agentes quase sempre ociosos empacotados em poucos workers, é exatamente sobre chegar lá.
Cleanup
./scripts/99_teardown.shEle apaga as tarefas do AX que restarem, depois os repositórios do ECR sob ax-eks/ (criados no push, então o Terraform não é dono deles), roda terraform destroy e, por fim, apaga os volumes do PostgreSQL:
for repo in $(aws ecr describe-repositories --region "$AWS_REGION" \
    --query "repositories[?starts_with(repositoryName, '${CLUSTER_NAME}/')].repositoryName" --output text); do
  aws ecr delete-repository --region "$AWS_REGION" --repository-name "$repo" --force >/dev/null
done
terraform -chdir="$TF_DIR" destroy -input=false -auto-approve
for vol in $(aws ec2 describe-volumes --region "$AWS_REGION" \
    --filters "Name=tag-key,Values=kubernetes.io/cluster/$CLUSTER_NAME" Name=status,Values=available \
    --query 'Volumes[].VolumeId' --output text); do
  aws ec2 delete-volume --region "$AWS_REGION" --volume-id "$vol"
done
Esse último loop existe porque eu errei na primeira vez. Os dois volumes do PostgreSQL (500 GiB para o Substrate, 10 GiB para o AX) são criados pelo driver EBS CSI para os PersistentVolumeClaims deles, não pelo Terraform, então o terraform destroy deixa os volumes para trás, desanexados e ainda cobrando cerca de $41 por mês. O driver EBS CSI coloca neles a tag kubernetes.io/cluster/ax-eks, que é como o loop os encontra.
Na minha execução ele removeu doze repositórios e 67 recursos em 11 minutos e 36 segundos. O bucket de snapshots tem force_destroy = true, então objetos que sobraram não bloqueiam o destroy. Confira os consoles do EC2 e do EKS depois; um load balancer ou ENI travado é o motivo usual para uma VPC se recusar a ser apagada.
Veredito
O AX roda no EKS. Com Kubernetes 1.37, um patch de 11 linhas no instalador e um overlay pequeno, a stack inteira (o control plane do Substrate, os workers gVisor, o servidor do AX) subiu de primeira e passou no próprio smoke test do AX. A maior parte do crédito vai para o Substrate: o código dele já antecipava ECR e S3, e só o instalador pressupõe o Google. É a mesma conclusão a que o Weiss chegou (“o núcleo é portável. As bordas ainda têm o formato do Google”), agora com o AX por cima.
O que eu teria em mente antes de construir em cima disso:
- EKS 1.37 é um piso rígido. As APIs de certificado de pod das quais o Substrate depende não podem ser habilitadas em control planes gerenciados mais antigos. Rode a verificação de 10 segundos do Teste 1 antes de qualquer outra coisa.
- Isto é software de avaliação. O AX está na
v0.3.1com uma APIv1alpha1, amainjá foi muito além da release, e o Substrate está no meio do caminho para a 1.0. Fixe os commits exatos que o guia do AX registra e faça o rebuild de tudo junto. - As lacunas de segurança são reais. O
ax-servernão tem autenticação nem autorização (#376, classificada como crítica, aberta e sem resposta de maintainer), então qualquer um que consiga alcançá-lo pode ler e apagar todas as tarefas. Mantenha ele atrás dekubectl port-forward. No S3, os sidecars de snapshot do Substrate usam uma única role para todos os actors (#3095), enquanto no GCS cada actor recebe um token com escopo próprio. - Suspend é um restart com os seus arquivos. Só o
/workspacesobrevive. Se você contava com retomar um agente no meio de um raciocínio, o AX não faz isso hoje. - Você é dono de um cluster que custa dinheiro enquanto está ocioso. Cerca de $15 por dia antes da primeira tarefa rodar, um terço disso no volume de 500 GiB do PostgreSQL do Substrate.
Com o que você está se comprometendo
| Aspecto | AX no EKS hoje |
|---|---|
| Quem opera | Você: EKS, o control plane do Substrate, dois databases PostgreSQL, o bucket S3 |
| Isolamento | gVisor (runsc) dentro de um pod worker; o Substrate também tem uma classe microVM que eu não usei |
| O que o suspend preserva | Só os arquivos do /workspace; memória e processos se perdem |
| Acordar sob demanda | Sim, via router do Substrate; ainda sem suspend automático por ociosidade |
| Custo ocioso | O cluster inteiro, cerca de $0.63/h |
| Autenticação | Nenhuma no ax-server (#376) |
| Licença | Apache 2.0, os dois projetos |
| Tempo de setup (minhas execuções) | Cerca de 20 minutos de tempo de máquina, mais leitura |
Quem deveria usar
O AX no EKS faz sentido para um time de plataforma na AWS que quer ser dono do próprio runtime de agentes: manter sandboxes, snapshots e tráfego na própria conta, rodar gVisor nos próprios nodes e empacotar muitos agentes quase sempre ociosos num pool fixo de nodes. É também o jeito mais barato que eu conheço de entender como o Google pensa sobre agendamento de agentes, porque tudo está aberto.
Ainda não faz sentido para quem precisa de sandboxes em produção no mês que vem, precisa retomar um agente com a memória intacta ou não quer operar um cluster. A Parte 2 coloca o ciclo de vida das tarefas do AX à prova, incluindo o momento em que esses snapshots finalmente chegam ao S3.