Primeiros passos com a Gemini Decisions API
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão Geral
- Arquitetura
- Configuração
- Passo 1: Habilite a Gemini API no console do Google Cloud
- Passo 2: Crie uma chave de API restrita
- Passo 3: Ou faça os dois passos com o gcloud
- Passo 4: O primeiro request, com curl
- Passo 5: O Python SDK e a versão fixada em v1beta
- Passo 6: Acompanhe no console
- A Demo: Triagem de um Ticket de Suporte
- Três tipos de pergunta em um único request
- Adicionando um screenshot, uma mensagem de voz, um vídeo e um PDF
- Quanto custa cada arquivo
- O Que Eu Medi
- Muitas perguntas sobre um input
- Latência conforme o input cresce
- As probabilidades são honestas?
- Edge cases
- Contra o Gemini 3.5 Flash-Lite
- Resumo dos resultados
- Preços
- Limpeza
- Veredito
- O que funciona
- O que não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine um ajudante que nunca conta histórias. Você mostra a ele uma figura ou uma carta e pergunta "isto é um gato, sim ou não?", e ele responde na hora e ainda diz o quanto tem certeza, tipo "muita certeza" ou "só um pouquinho de certeza".
Os adultos gostam disso porque podem fazer várias perguntinhas sobre a mesma coisa de uma vez, e ele é rápido e barato. Quando o ajudante diz que só tem um pouquinho de certeza, uma pessoa pode dar uma olhada no lugar dele. Ele ainda pode ser enganado por um bilhete espertinho, então você precisa fazer suas perguntas com cuidado.
Este é um serviço que retorna uma probabilidade para um conjunto fixo de respostas, não um raciocínio escrito. Isso importa para a responsabilização: a saída dá um número ao qual aplicar um limite de corte, e nenhuma explicação para juntar a um dossiê. Qualquer decisão que exija uma justificativa declarada ainda precisa de outra etapa.
Os pontos de diligência são concretos. Os dados do free tier são usados para melhorar produtos do Google, então conteúdo real de clientes deve ficar no tier pago. O Google não identifica a API como preview nem como disponibilidade geral. No meu teste, um texto dentro do input que defendia a própria classificação mudou a resposta, então input não confiável precisa de critérios explícitos e revisão humana abaixo de um limite de corte.
Pense nisso como um teste rápido de triagem, não como uma consulta. Ele responde perguntas fechadas sobre um caso, sim ou não, uma entre várias opções ou um grau em uma escala, e informa uma probabilidade com cada resposta. As evidências do fabricante são autodeclaradas. Nos meus próprios 500 artigos rotulados, a confiança declarada acompanhou de perto a acurácia observada.
Efeitos colaterais conhecidos: forçado a escolher entre opções que não se encaixam, ele ainda escolhe, com baixa confiança. Uma instrução plantada no input reduziu sua certeza pela metade em um teste. Bons candidatos são etapas de triagem de alto volume com uma pessoa revisando a faixa incerta. Não é indicado onde uma justificativa escrita é exigida.
Repare em quanto do dia de um time vai para pequenas escolhas de triagem: qual fila, isso é urgente, uma pessoa precisa olhar. Cada uma é fácil, e juntas elas cansam. Esta ferramenta pega essa pilha e responde cada item com um número que diz o quanto ela tem certeza.
O alívio vem com um novo hábito a construir. Um score de confiança convida a acreditar nele, e o time precisa decidir junto onde fica a linha entre "deixa passar" e "alguém lê isto". Nos meus testes os números foram honestos na maior parte do tempo, e ainda assim mudaram quando o input tentou convencer o modelo de uma resposta.
Isto é um metrônomo, não um solista. Ele não toca melodia nenhuma: você entrega uma partitura de perguntas fechadas e ele devolve, em cliques, sim, não, uma opção ou uma pontuação, cada uma com um número que diz com que firmeza ele quer dizer aquilo. Requests pequenos voltaram em cerca de um terço de segundo para mim.
Ele mantém o tempo do mesmo jeito em cada take com texto: o mesmo artigo me deu os mesmos números cinco execuções seguidas. Ele fica melhor por baixo da banda, decidindo qual músico assume a próxima parte, enquanto um modelo generativo faz a execução de verdade. Entregue mil perguntas de uma vez e o andamento se arrasta para alguns segundos.
O posicionamento é estreito e claro: roteamento, verificações e pontuação, não escrita. Um request pode levar texto, um screenshot, uma mensagem de voz, um vídeo e um PDF, mais até 1.000 perguntas fechadas, e cobra apenas tokens de input, a 10 centavos por milhão.
O time to value é curto. Minha primeira resposta veio de um único comando curl. No meu próprio conjunto rotulado, ele empatou com um modelo generativo pequeno em acurácia, respondeu em menos da metade do tempo e custou cerca de um terço, aquém do "quase 5x mais barato" do post de lançamento. A história para pegar emprestada é a de uma confiança sobre a qual dá para colocar um threshold.
 Veja o código-fonte aqui: gemini-decisions-api
Visão Geral
Em 11 de novembro de 2026, o Google lançou a Gemini Decisions API junto com um novo modelo, o gemini-decision-1. Ele não gera texto. Você envia um input compartilhado (texto, imagens, áudio, vídeo ou PDFs) e um conjunto de perguntas fechadas, e recebe de volta uma probabilidade para cada resposta possível. Há três tipos de pergunta: sim/não, choice (escolher uma entre 2 e 255 opções) e score (avaliar em uma rubrica ordenada). Um request pode levar até 1.000 perguntas, e a cobrança é só sobre os tokens de input: US$ 0,10 por milhão, com zero tokens de output.
Os usos pretendidos são as pequenas decisões que ficam em volta de um modelo generativo: qual fila ou modelo recebe este request, este input viola uma política, de quais ferramentas o agente precisa, esta resposta está boa o bastante para ser enviada. O Google entra em uma categoria que o Jev da TypeSafe iniciou e na qual a OpenAI, a Perplexity e outras entraram desde então.
O post do Google faz três afirmações que eu quis conferir por conta própria: latência de 150 a 250 ms para contextos de até 16K tokens, probabilidades bem calibradas e um custo “quase 5x mais barato” que o do Gemini 3.5 Flash-Lite no seu conjunto de benchmarks. As três vêm de testes do próprio Google. Este post vai de uma chave de API até uma demo multimodal de triagem funcionando, e depois mede latência, tokens cobrados, calibração, edge cases e custo em cargas de trabalho que eu escolhi. Tudo abaixo rodou em 12 de novembro, um dia depois do lançamento, então trate como uma primeira impressão.
Arquitetura
Há um endpoint e um modelo. O request tem três partes: o ID do modelo, o input compartilhado e um mapa de questions cujas chaves você escolhe. O modelo lê o input e todas as perguntas em um único forward pass e pontua cada resposta candidata, então não há decodificação token a token. A resposta tem um mapa answers com as mesmas chaves e um bloco usage. O que você faz com as probabilidades (thresholds, roteamento, escalonamento para uma pessoa) fica por conta do seu código.
Três propriedades definem como você usa a API:
- As perguntas são independentes. Elas não enxergam umas às outras, e adicionar uma não muda as outras respostas. Uma decisão que depende de uma resposta anterior precisa de um segundo request, ou você faz as duas perguntas e ignora uma.
- O modelo não vê as chaves das perguntas. O guia diz para colocar a pergunta inteira em
instructions. As chaves das opções são diferentes: renomeá-las mudou uma resposta em um dos meus testes abaixo. - Ainda não está na plataforma de IA do Google Cloud. A API roda na Gemini Developer API (
v1beta) com uma chave de API, criada no AI Studio ou no console do Google Cloud. O Google lista o suporte ao Google Cloud como em breve, com um formulário de acesso antecipado. Uma chave do AI Studio ainda pertence a um projeto do Google Cloud, e o uso pago é cobrado pela conta do Cloud Billing desse projeto.
Configuração
Passo 1: Habilite a Gemini API no console do Google Cloud
A Decisions API não é um produto separado no Google Cloud. Ela é um método da Gemini API (nome do serviço generativelanguage.googleapis.com), então é ela que você habilita. No console do Google Cloud, escolha ou crie um projeto, abra APIs & Services > Library, procure por “Gemini API” e clique em Enable. Depois de habilitada, a página mostra “API Enabled” e um botão Manage.
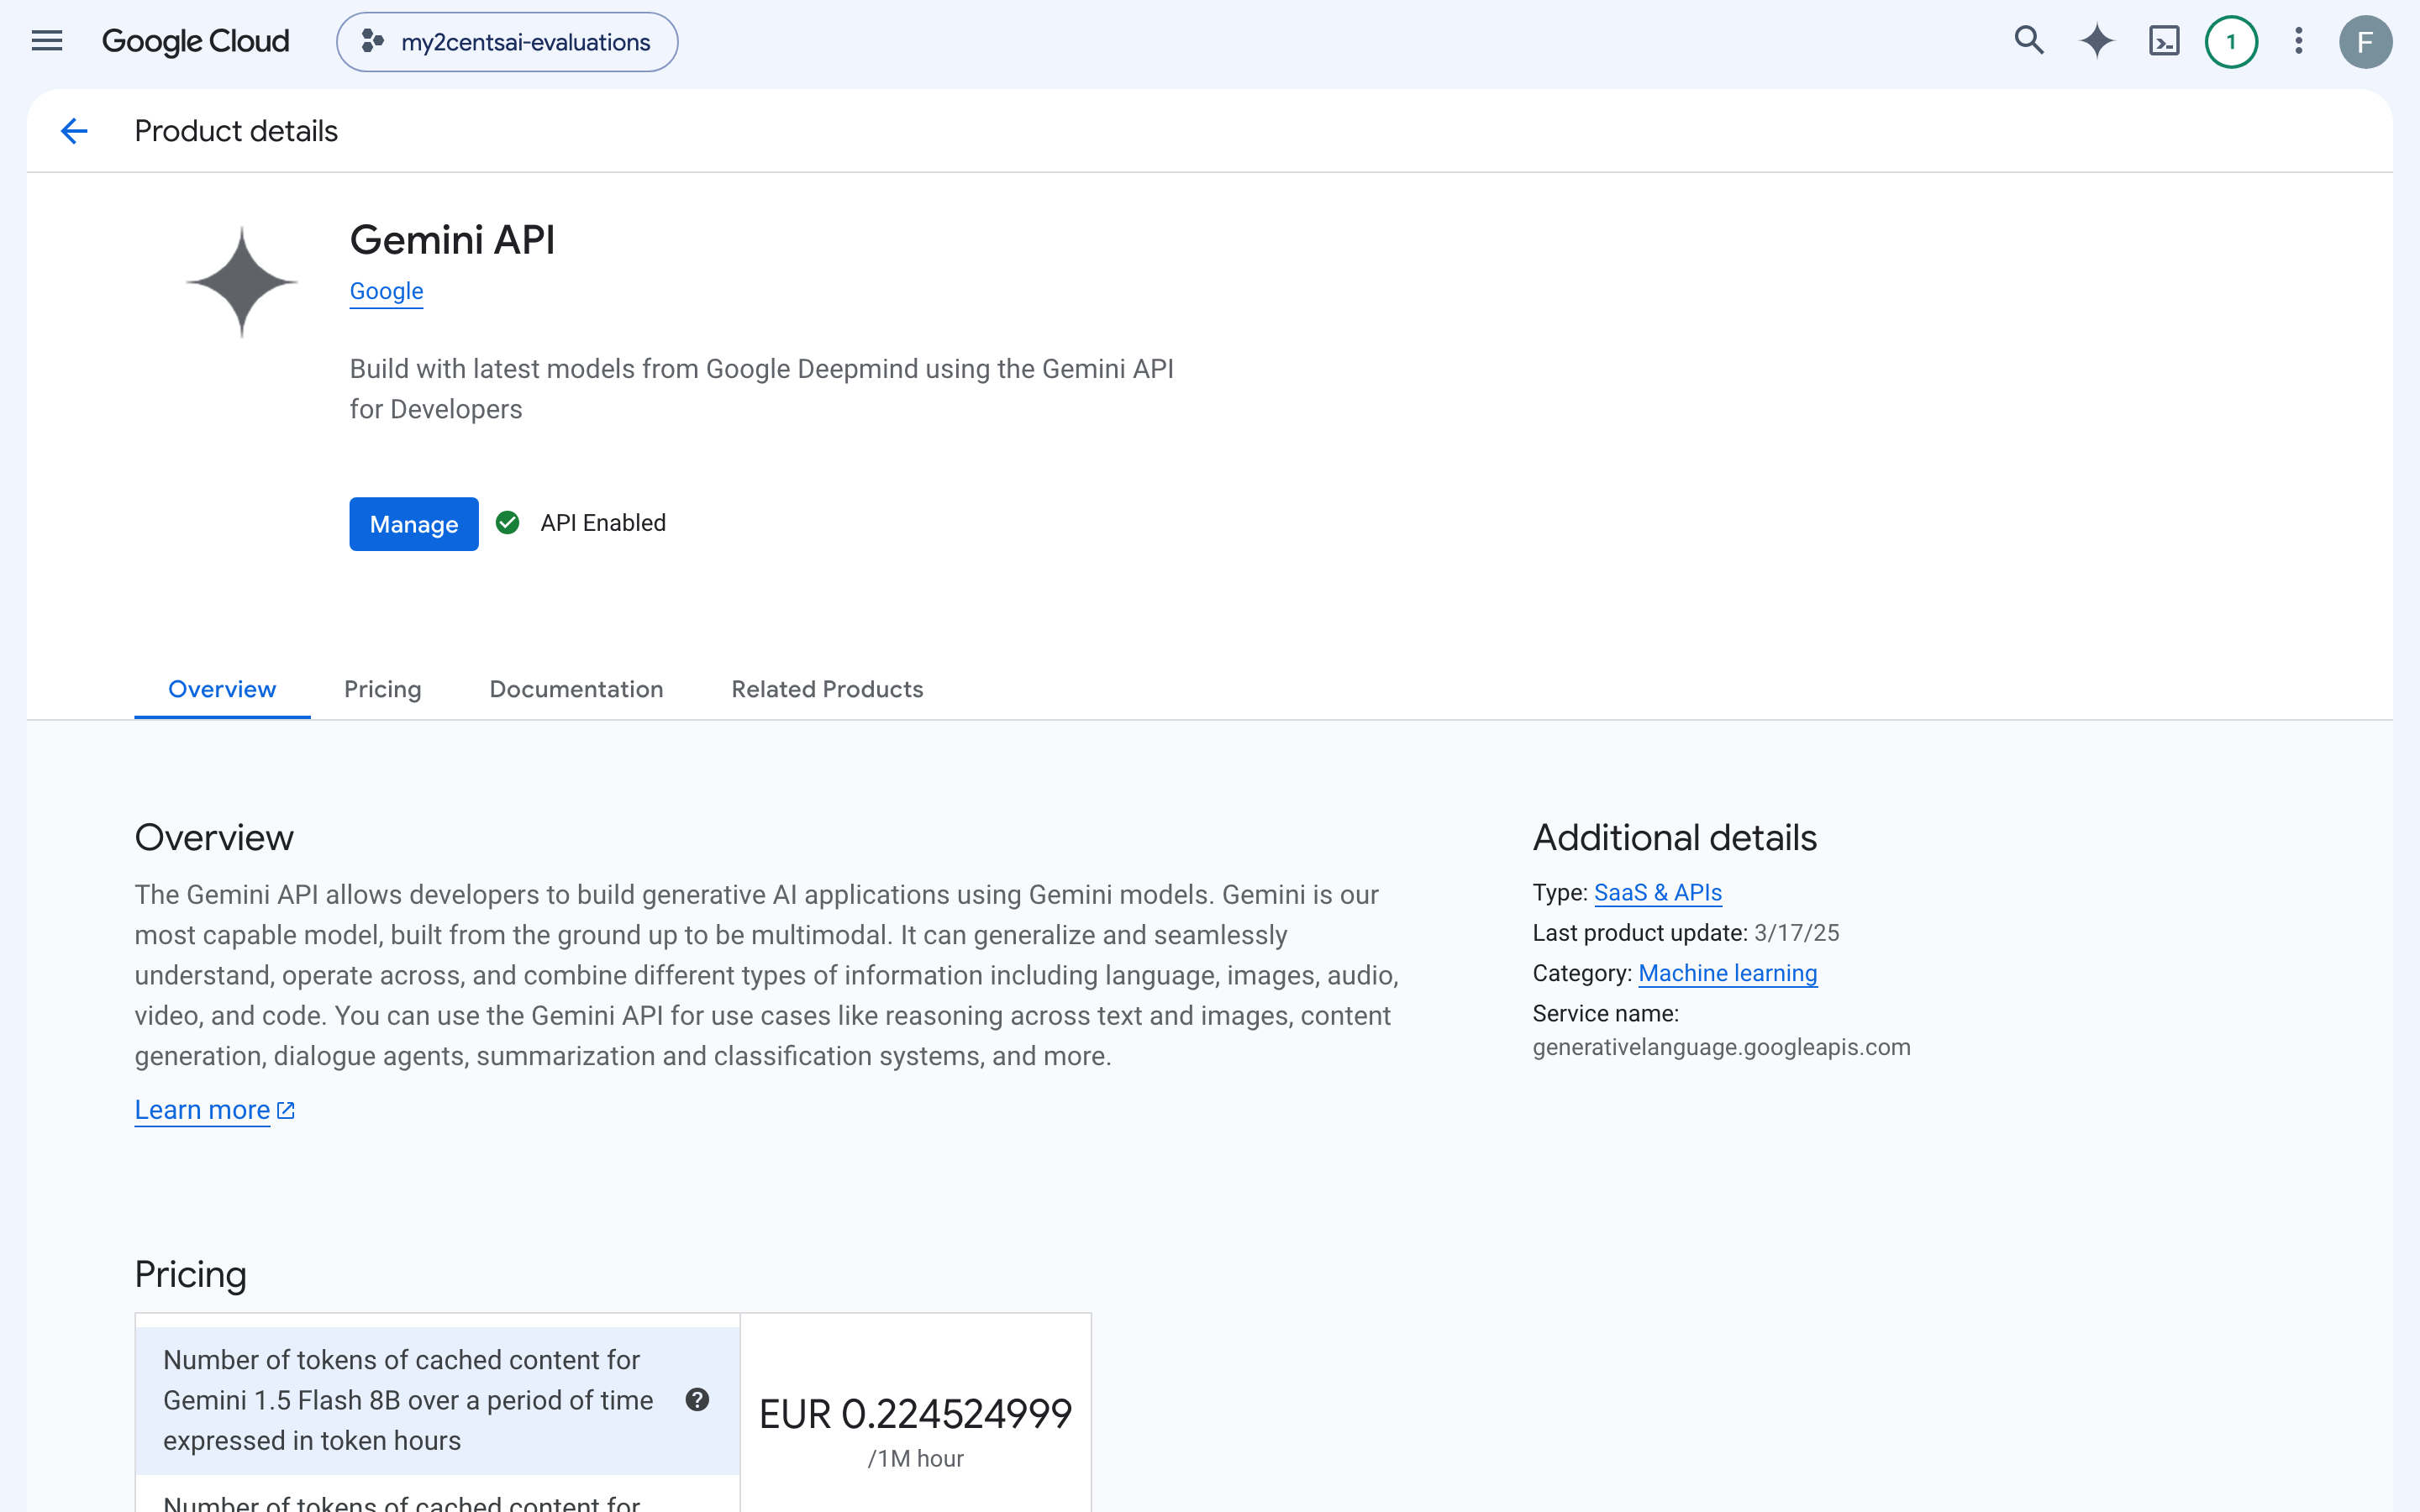
Há um free tier para o gemini-decision-1 (200 requests e 50.000 tokens por minuto, 10.000 requests por dia, segundo a página de rate limits), e os termos do Google dizem que o conteúdo do free tier é usado para melhorar os seus produtos. Eu rodei tudo em um projeto que a API reportou como Tier 1 (1.000.000 de tokens de input por minuto). Dois dos meus testes precisam disso: um único request de 250K tokens equivale a cinco vezes a cota por minuto do free tier.
Passo 2: Crie uma chave de API restrita
Em APIs & Services > Credentials, escolha Create credentials > API key e depois restrinja a chave à Gemini API, para que ela não possa chamar mais nada no projeto. Esta é a página Credentials depois que eu criei uma chave chamada decisions-api-demo para este post (cobri o nome de uma chave não relacionada e o endereço da service account):
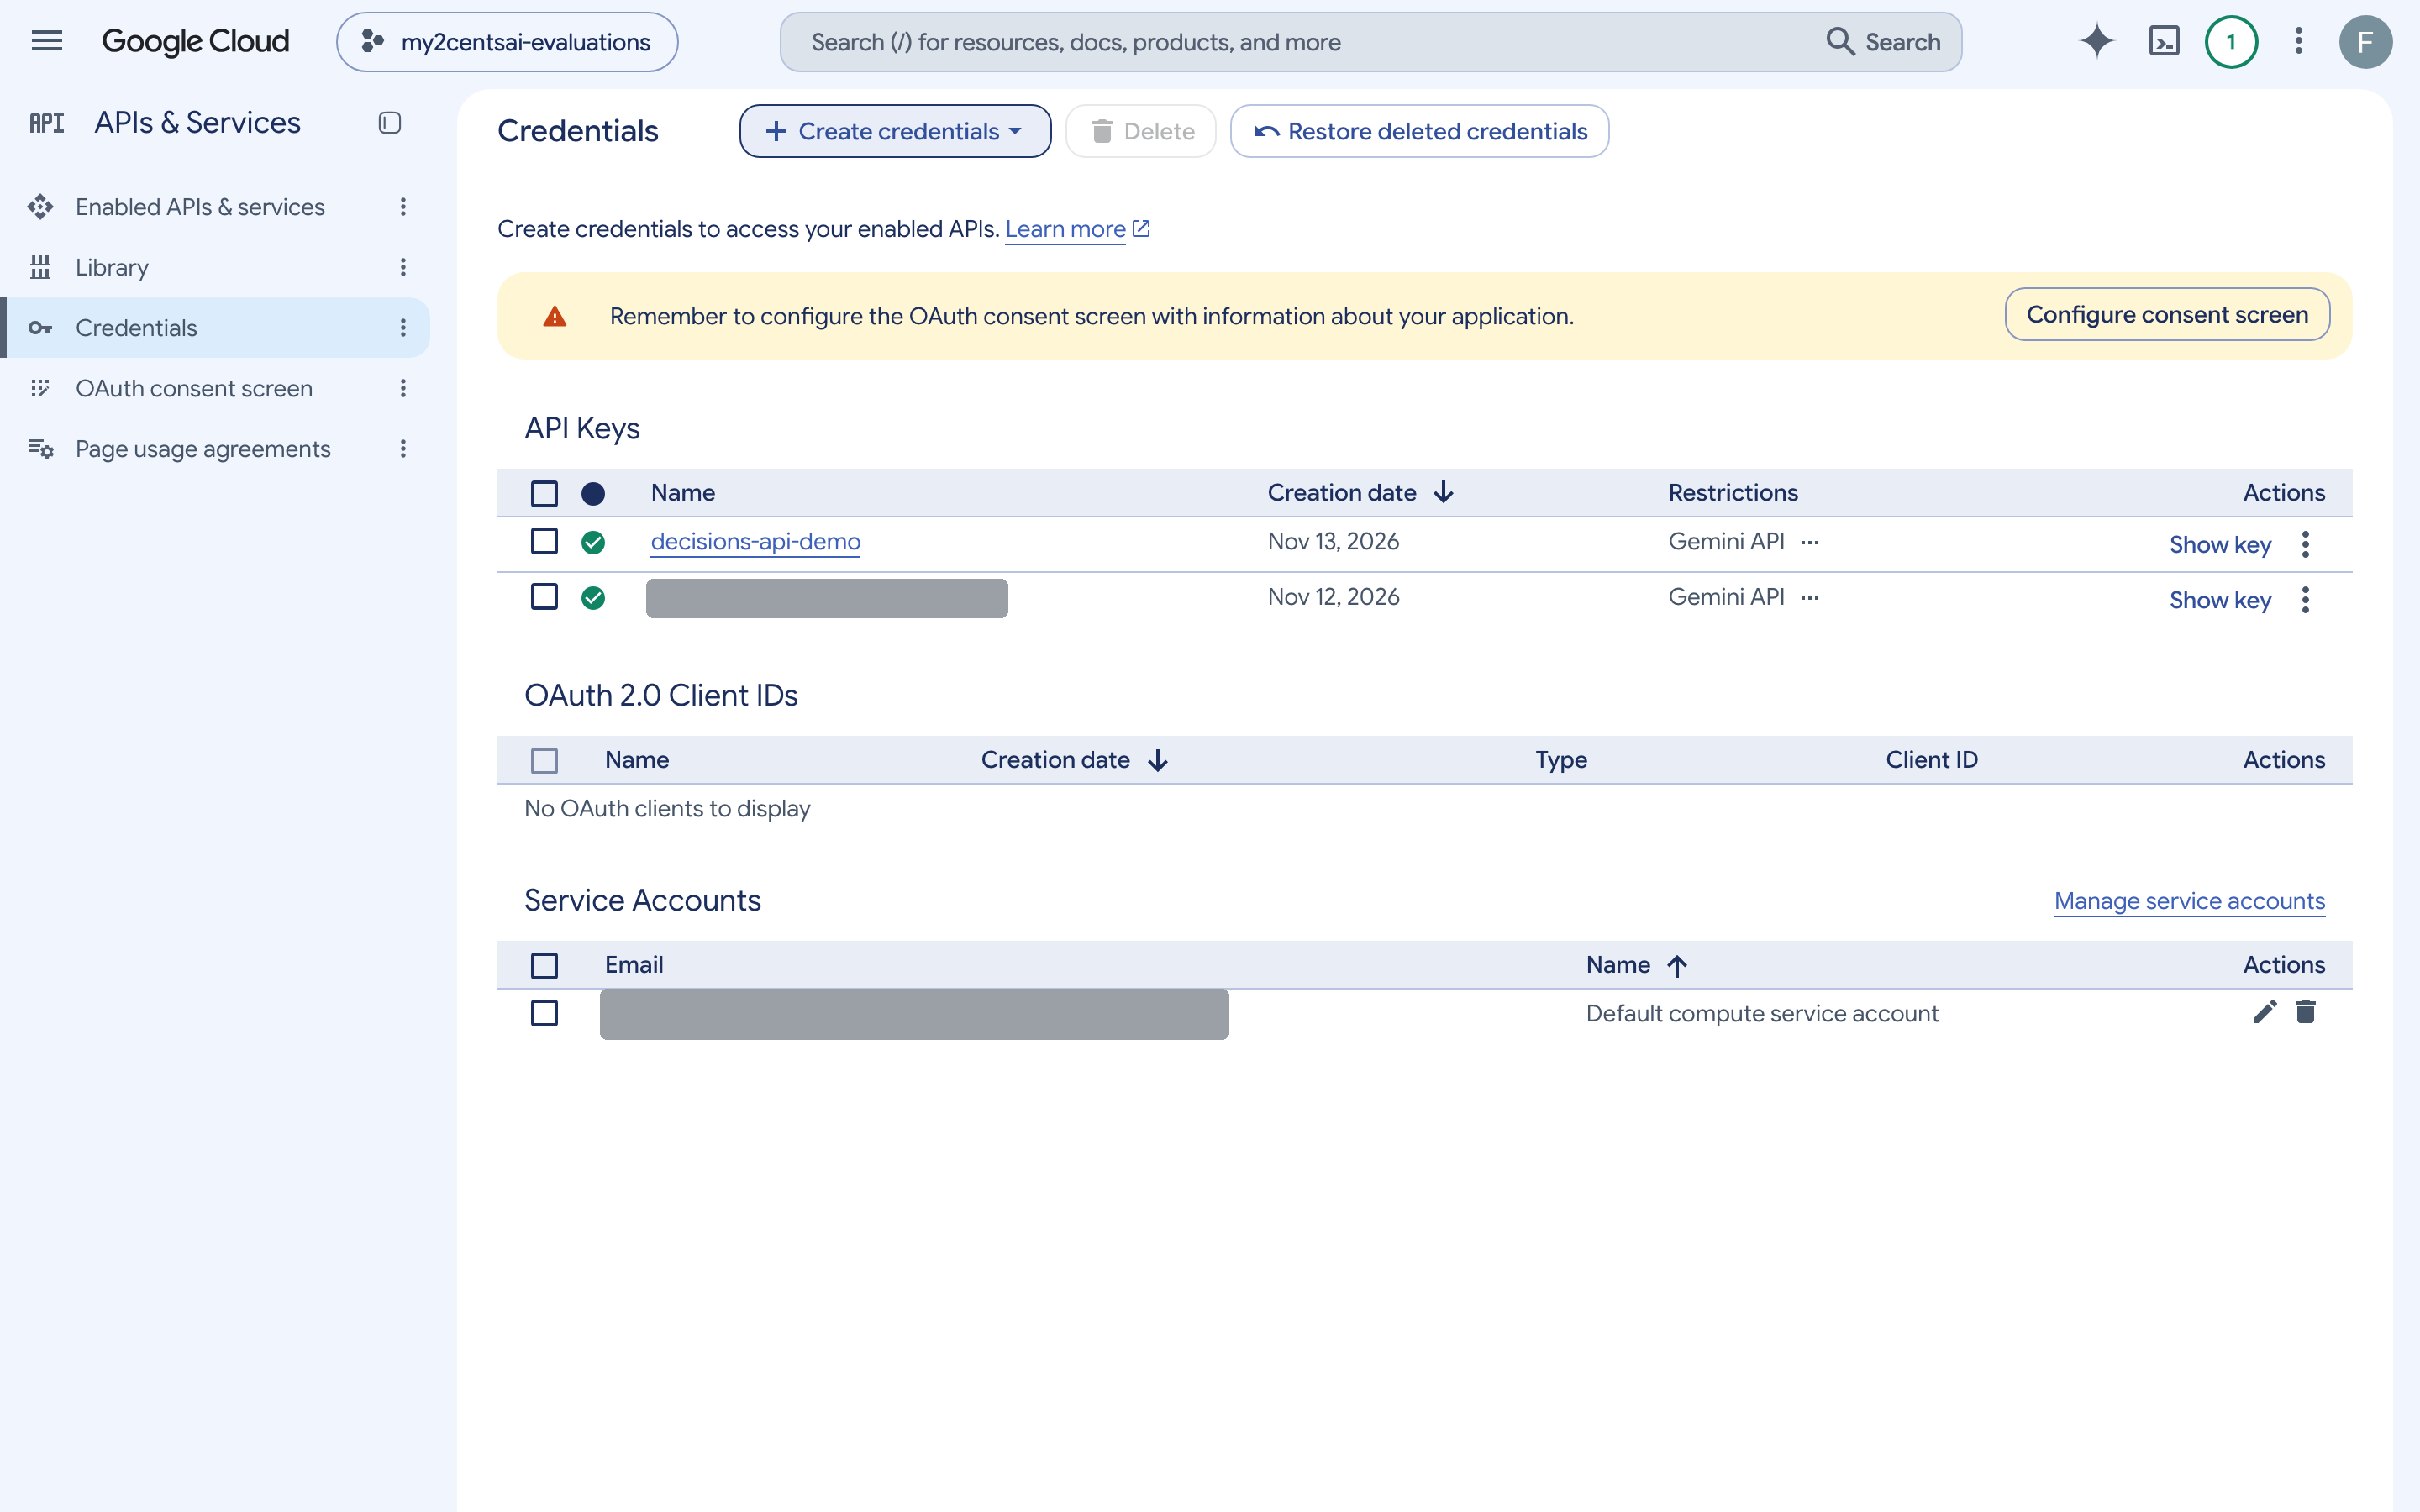
Você também pode criar uma chave no Google AI Studio, que é o caminho que o quickstart do Google segue. De qualquer forma, a chave pertence a um projeto do Google Cloud. Uma coisa a saber: as páginas de uso e de rate limit do AI Studio só mostravam o próprio “Default Gemini Project” dele para mim, e a página API Keys falhou ao listar as chaves com “permission denied”. Então, para uma chave criada no console do Cloud, o console foi onde eu consegui ver o que estava acontecendo.
Passo 3: Ou faça os dois passos com o gcloud
Os mesmos dois passos pela linha de comando, no 00_setup_gcloud.sh do código de acompanhamento. Ele habilita a API, cria a chave restrita, grava a chave em um .env ignorado pelo git sem imprimi-la e faz um primeiro request:
gcloud services enable generativelanguage.googleapis.com apikeys.googleapis.com --project "$P"
gcloud services api-keys create --project "$P" --display-name "decisions-api-demo" \
  --api-target=service=generativelanguage.googleapis.com
gcloud services api-keys get-key-string "$ID" --project "$P" --format='value(keyString)'
$ ./00_setup_gcloud.sh
== 1. Enable the Gemini API (Generative Language API) and the API Keys API
apikeys.googleapis.com ENABLED
generativelanguage.googleapis.com ENABLED
== 2. Create an API key that can only call the Gemini API
decisions-api-demo generativelanguage.googleapis.com
== 3. Save the key to .env (not printed)
wrote .env (55 bytes, mode 600)
== 4. First request with the new key
{"answers":{"is_damaged":{"confidence":0.99,"noul":0.99,"type":"noul"}},"usage":{"total_tokens":100,"total_input_tokens":100,"input_tokens_by_modality":[{"modality":"text","tokens":100}],"total_output_tokens":0}}A chave nova funcionou no primeiro request, sem espera. Seja qual for a forma como você criou a chave, exporte-a para o restante dos passos:
export GEMINI_API_KEY=... # never commit itPasso 4: O primeiro request, com curl
curl -sS -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-decision-1",
    "input": "The blue mug I ordered on Monday arrived cracked on Wednesday.",
    "questions": {
      "is_damaged": {
        "type": "noul",
        "instructions": "Did the item arrive damaged?"
      }
    }
  }'
A resposta inteira:
{"answers":{"is_damaged":{"confidence":0.99,"noul":0.99,"type":"noul"}},"usage":{"total_tokens":100,"total_input_tokens":100,"input_tokens_by_modality":[{"modality":"text","tokens":100}],"total_output_tokens":0}}O tipo sim/não realmente se escreve noul, o mesmo nome que o Jev da TypeSafe usa, e o campo da resposta tem o mesmo nome. O valor dele é a probabilidade de sim. Ele é limitado ao intervalo de 0,01 a 0,99, então uma verificação como > 0.99 nunca dá match. Aquele input de uma frase com uma pergunta cobrou 100 tokens.
Passo 5: O Python SDK e a versão fixada em v1beta
O suporte a Decisions chegou no google-genai 3.2.0 (Python 3.11 ou mais recente).
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/gemini-decisions-api
python3 -m venv .venv && source .venv/bin/activate
pip install .
python 01_first_call.py
A primeira coisa que encontrei: um client criado com as configurações padrão falha.
== google-genai 3.2.0, default client (API version v1)
NotFoundError: Error code: 404

== client pinned to v1beta
P(yes)     = 0.99
confidence = 0.99
usage      = {'input_tokens_by_modality': [{'modality': 'text', 'tokens': 100}], 'total_input_tokens': 100, 'total_output_tokens': 0, 'total_tokens': 100}
O client 3.x usa a API v1 por padrão, e Decisions só existe na v1beta. O 404 vem com o corpo vazio, então nada diz por quê. Fixe a versão ao criar o client:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})
result = client.decisions.create(
    model="gemini-decision-1",
    input="The blue mug I ordered on Monday arrived cracked on Wednesday.",
    questions={"is_damaged": {"type": "noul", "instructions": "Did the item arrive damaged?"}},
)
print(result.answers["is_damaged"].noul)
O tempo até a primeira resposta foi de alguns minutos, a maior parte deles lendo o guia para descobrir por que o client padrão retornava 404.
Passo 6: Acompanhe no console
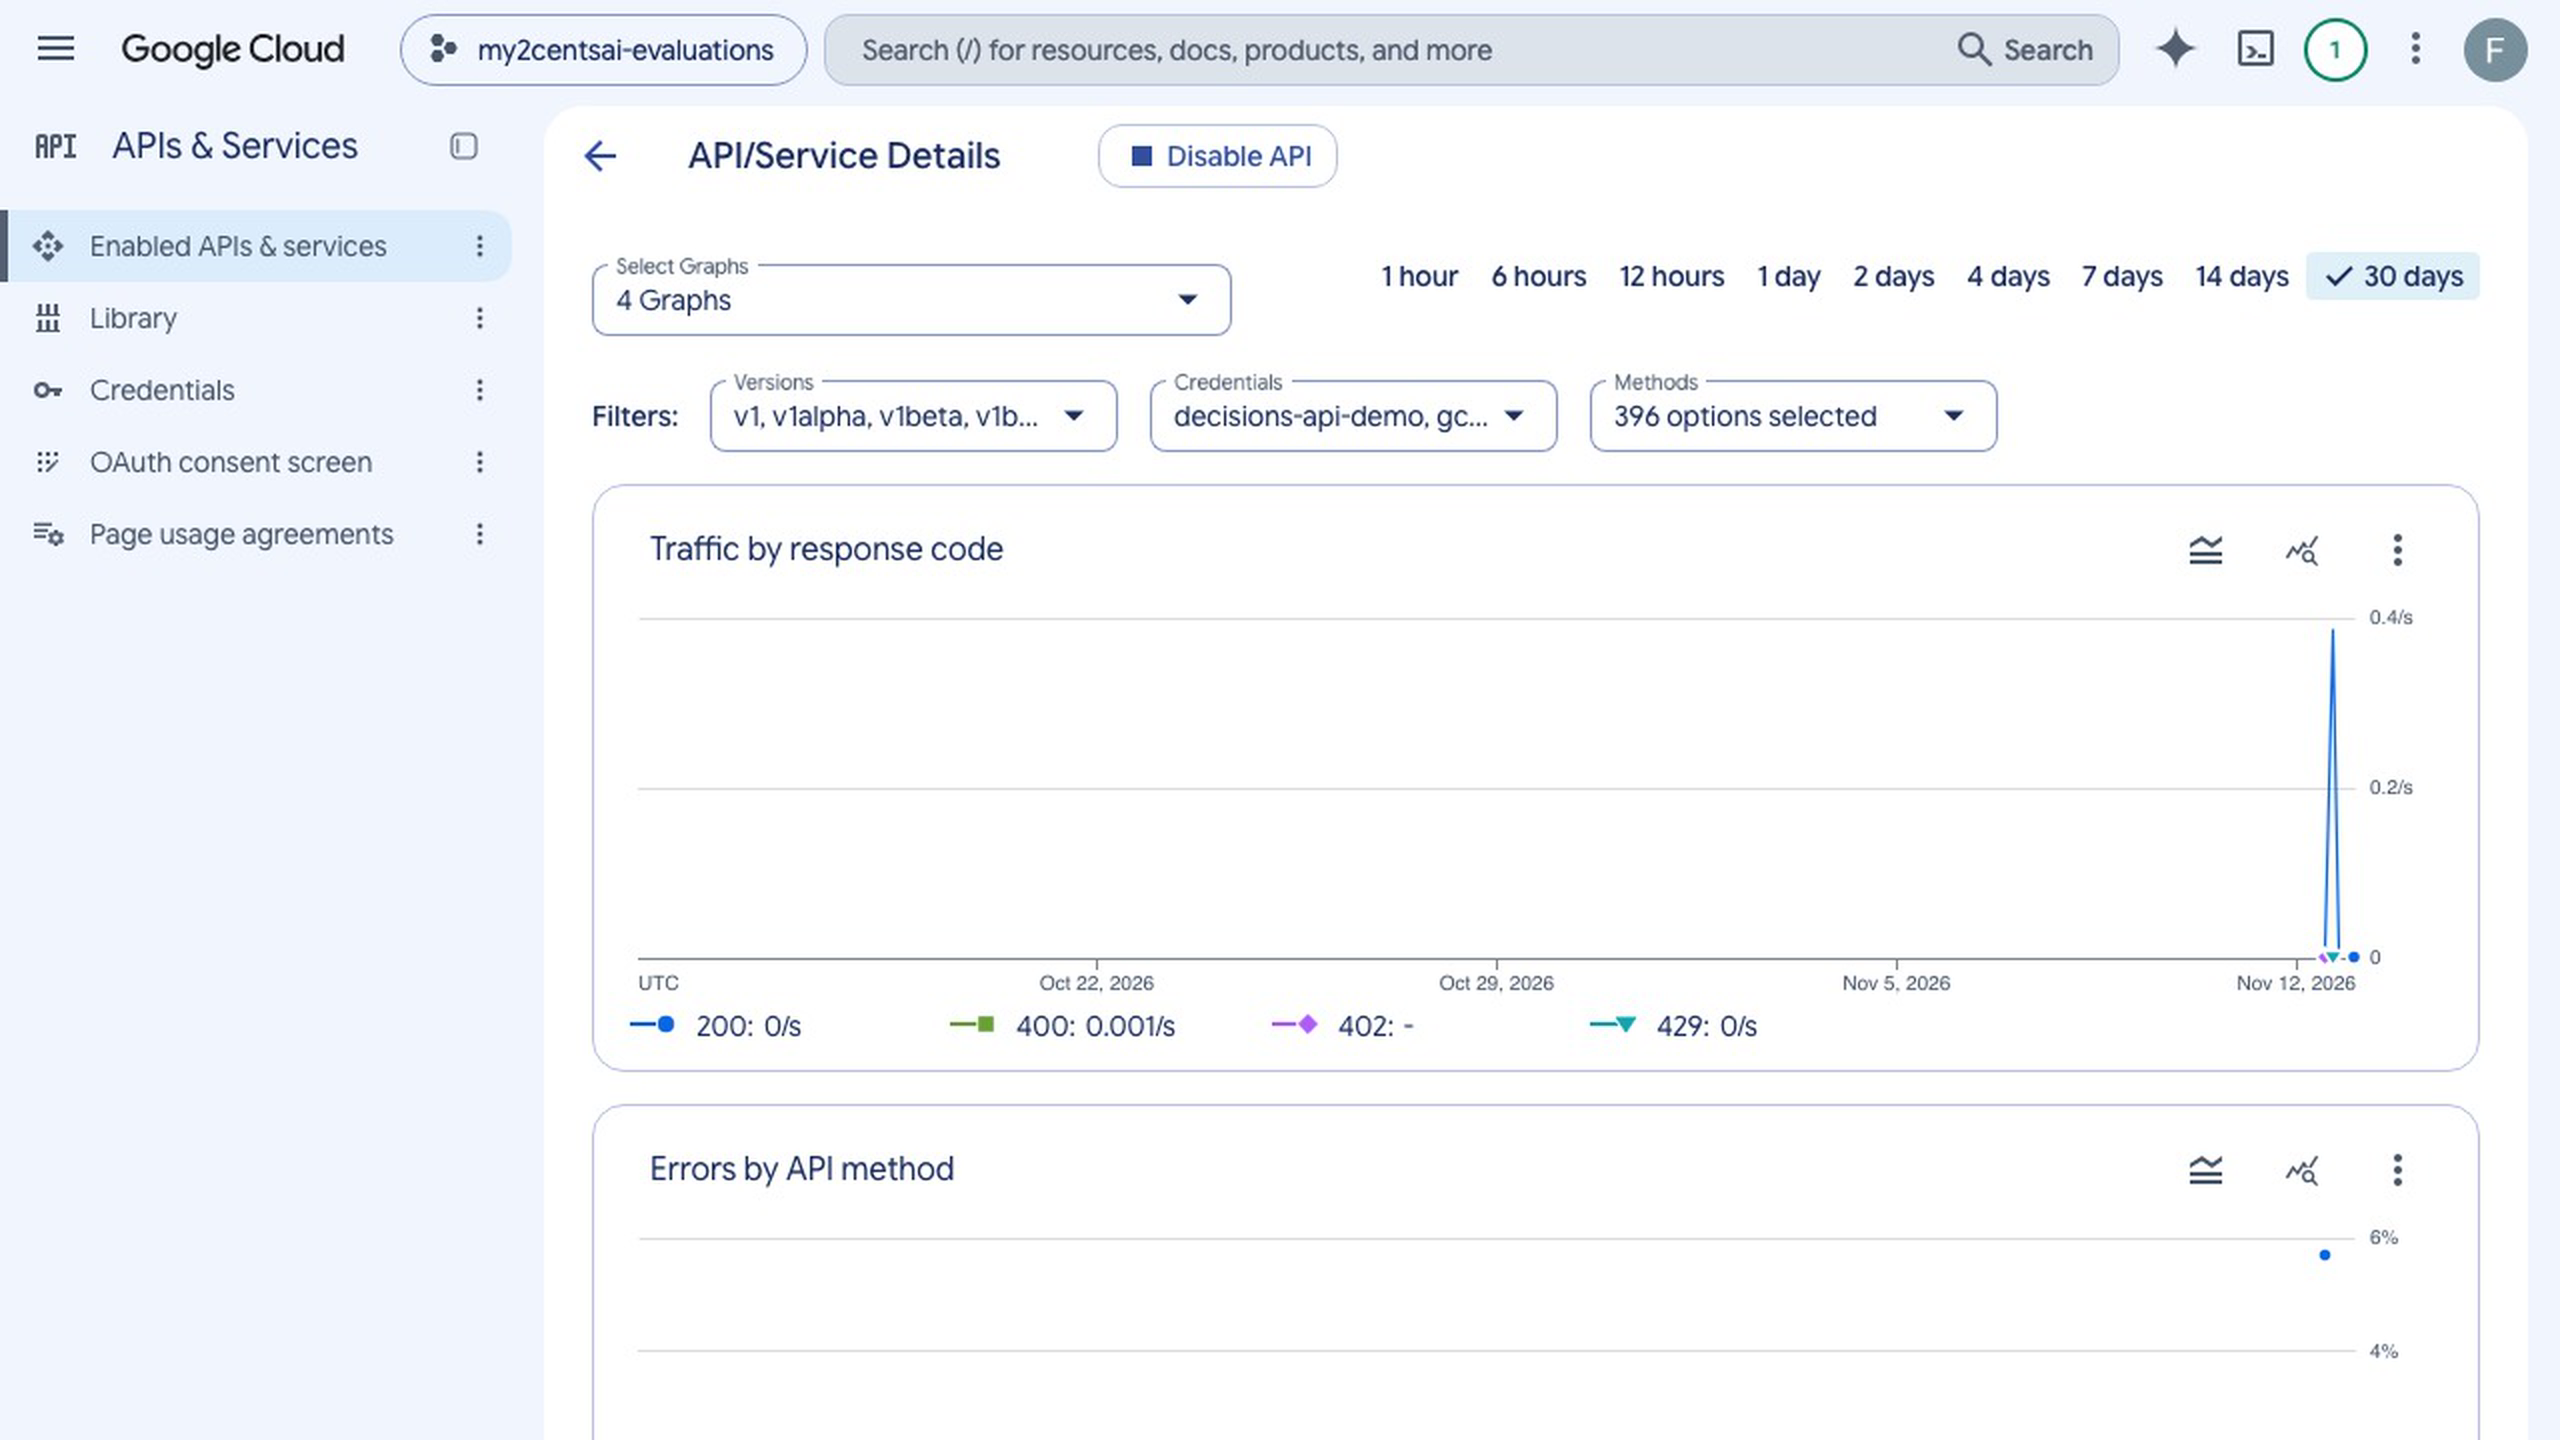
De volta ao console, Manage na página da Gemini API abre a página do próprio serviço, com as abas Metrics, Quotas & System Limits, Credentials e Cost. Este é o tráfego das execuções deste post, por código de resposta: o pico de 200s, os 400s dos meus testes de erro e uma linha para os 429s de quando bati no rate limit.
Mais abaixo, os gráficos dividem o tráfego por método da API. A Decisions API aparece ali com o próprio nome de método, genai.gemini.v1beta.DecisionService.CreateDecisionHttp, ao lado das chamadas à Files API que o script multimodal fez:
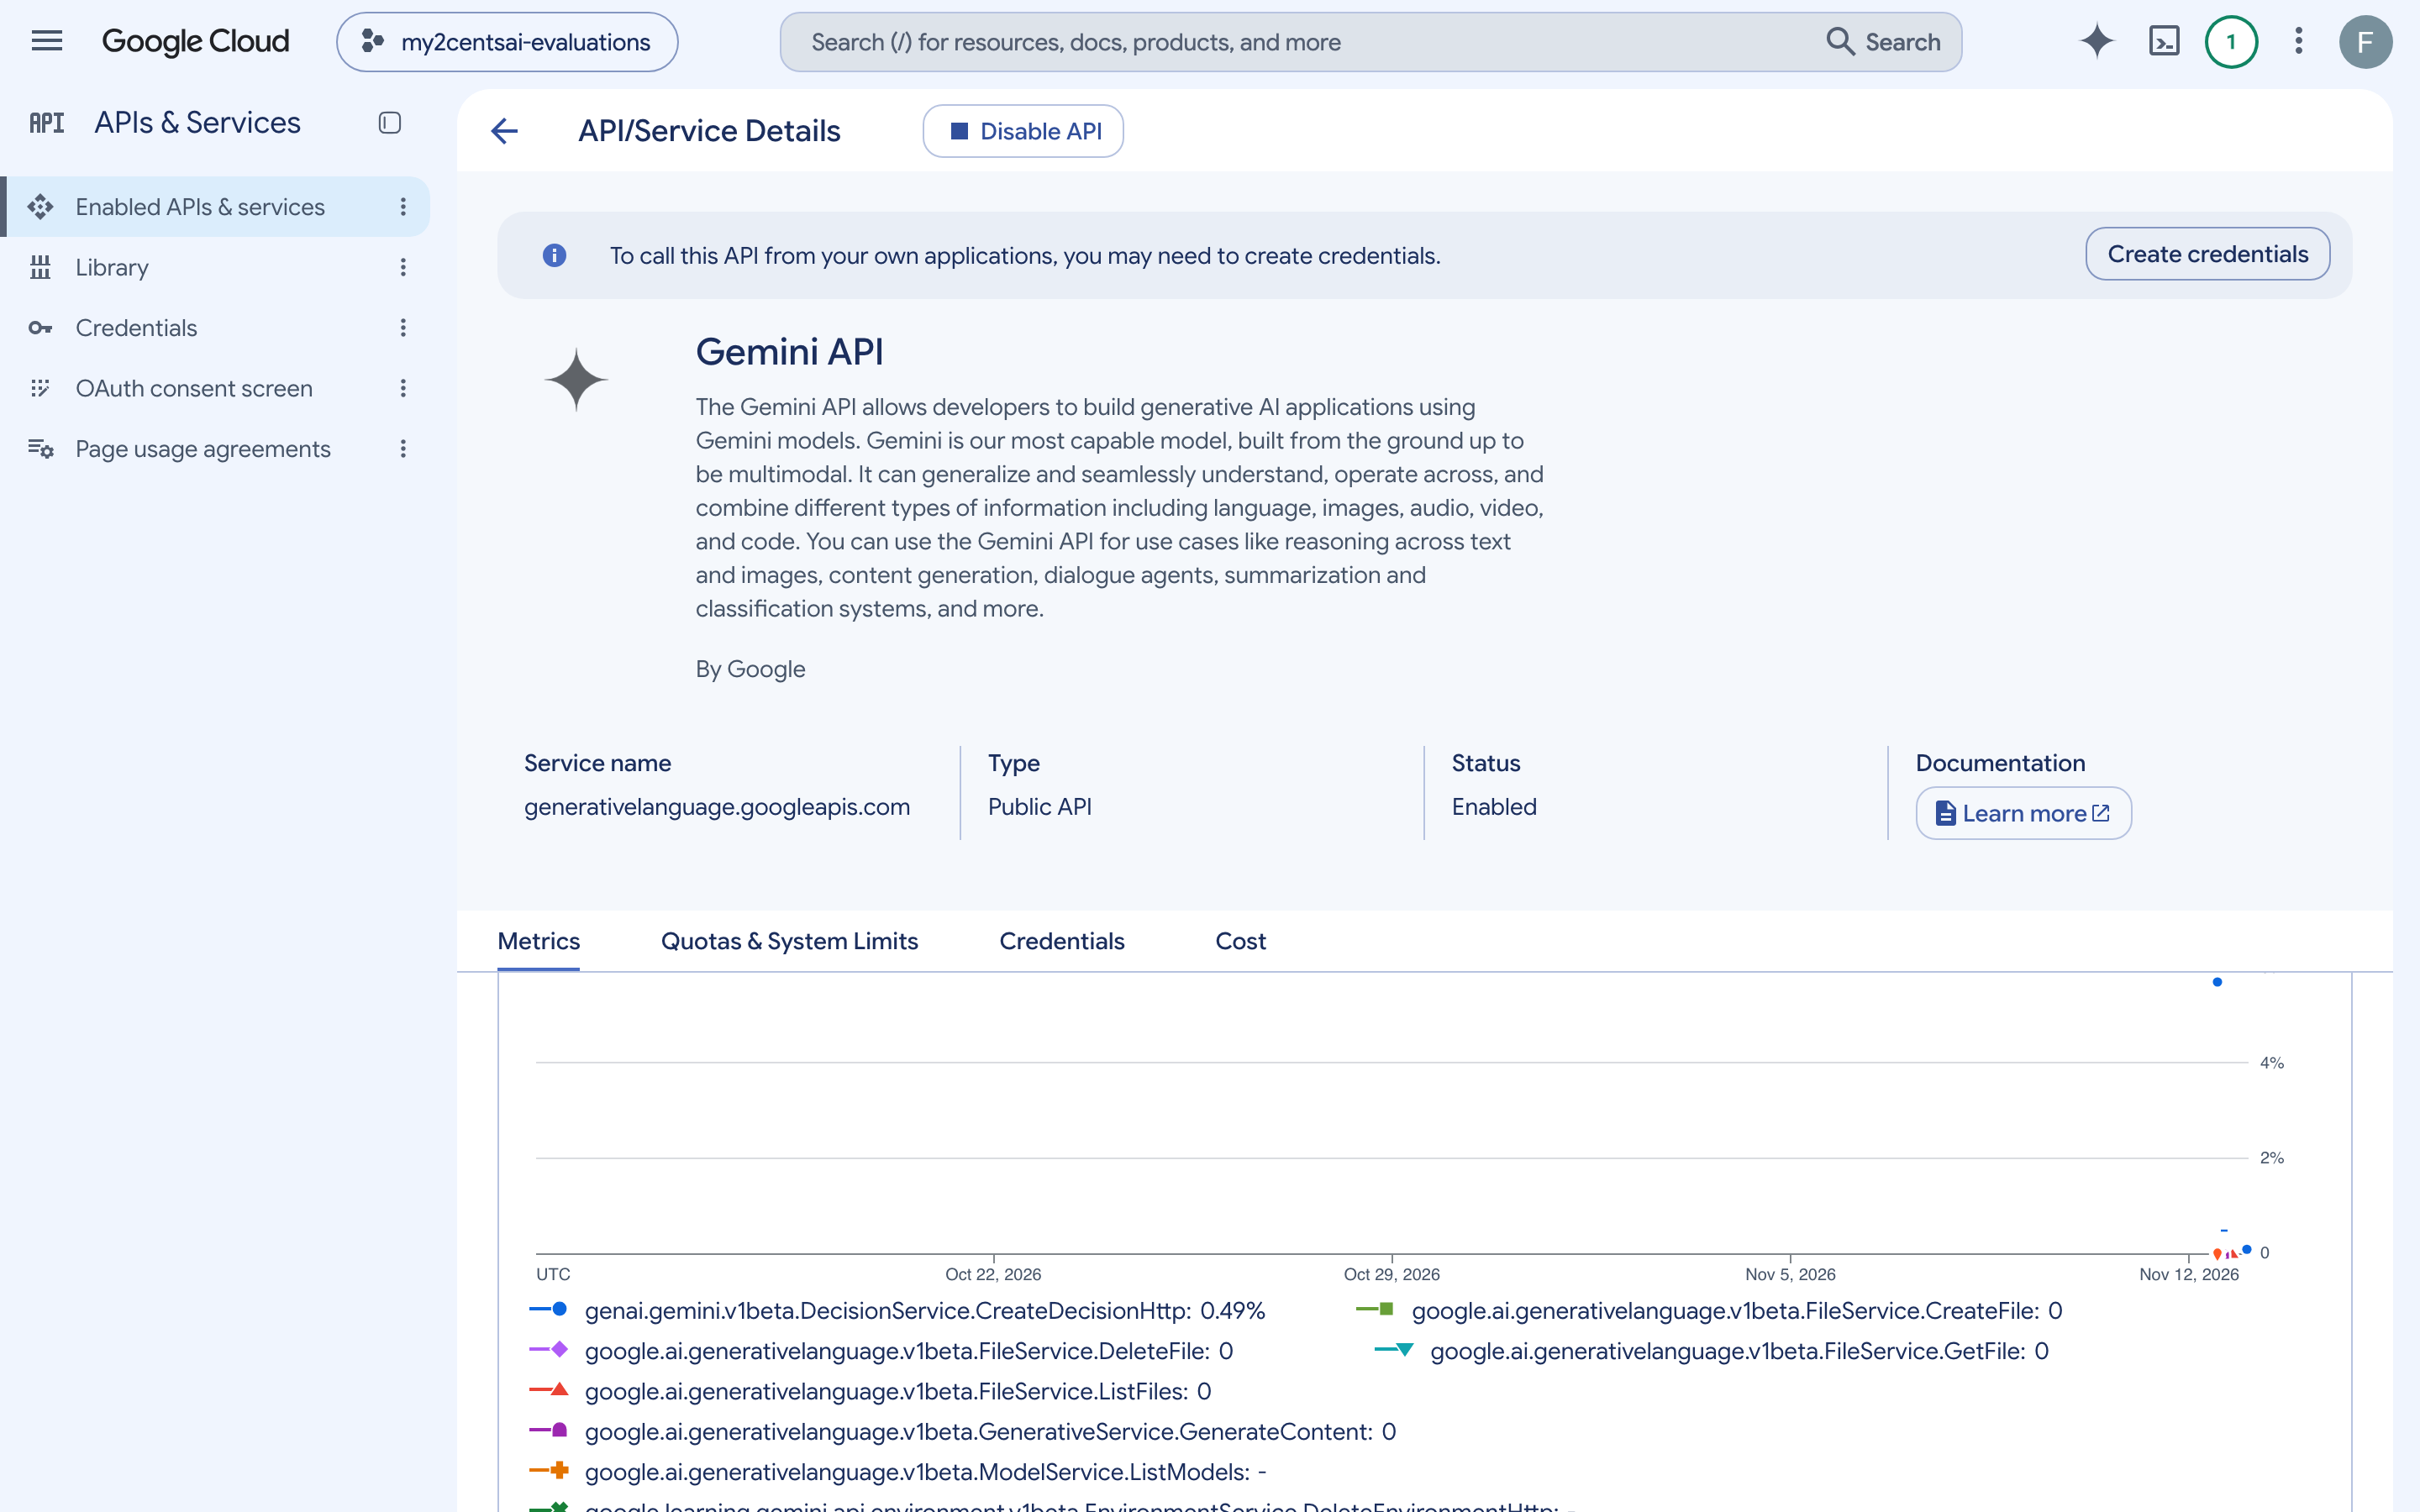
Esse nome de método também é o filtro a usar se você quiser um alerta para erros ou rate limits da Decisions API.
A Demo: Triagem de um Ticket de Suporte
O cenário: a caixa de entrada de suporte de uma transportadora de encomendas. Um cliente renovou um plano, o app disse que o pagamento falhou, e o banco mostra duas cobranças. Eu quero que o ticket seja roteado para uma fila, sinalizado para um fast track de reembolso se for claramente uma cobrança duplicada, e que receba uma prioridade. O ticket e os anexos são sintéticos; eu os gerei para este post.
Três tipos de pergunta em um único request
O 02_ticket_demo.py envia o ticket como texto JSON com cinco perguntas: três sim/não, uma choice e uma score.
QUESTIONS = {
    "double_charge": {
        "type": "noul",
        "instructions": "Does `message` report being charged more than once for the same purchase?",
    },
    "asks_for_refund": {"type": "noul", "instructions": "Does the customer explicitly ask for money back?"},
    "mentions_legal_action": {"type": "noul", "instructions": "Does the customer threaten legal action or a chargeback?"},
    "queue": {
        "type": "choice",
        "instructions": "Which support queue should handle this ticket?",
        "criteria": {
            "technical": "App errors, crashes, login problems.",
            "billing": "Charges, refunds, invoices, payment methods.",
            "shipping": "Parcel tracking, delays, damaged or lost parcels.",
            "account": "Plan changes, users, permissions, cancellations.",
            "other": "Anything that fits none of the above.",
        },
    },
    "churn_risk": {
        "type": "score",
        "instructions": "How likely is the customer to leave if this is not resolved quickly?",
        "criteria": ["No churn signal", "Mild frustration", "Mentions alternatives or a deadline", "States they will leave"],
    },
}
result = client.decisions.create(model="gemini-decision-1", input=json.dumps(TICKET), questions=QUESTIONS)
== yes/no (noul): probability of yes, clamped to 0.01..0.99
double_charge P(yes)=0.9900 confidence=0.9900
asks_for_refund P(yes)=0.9746 confidence=0.9746
mentions_legal_action P(yes)=0.1175 confidence=0.8825
== choice: probabilities over the five queues
choice=billing confidence=0.9201
billing 0.9201
technical 0.0554
account 0.0174
other 0.0040
shipping 0.0032
sum 1.0000
== score: probability-weighted average of the level index (0-based)
score=2.2359 confidence=0.7341
0 0.0006 No churn signal
1 0.0141 Mild frustration
2 0.7341 Mentions alternatives or a deadline
3 0.2512 States they will leave
== triage rule built on the answers
route=billing/refund_fast_track priority=P1
== usage
input tokens=520 output tokens=0 cost=$0.000052Algumas coisas para tirar daqui:
- Para uma pergunta sim/não,
confidenceémax(p, 1 - p). A resposta sobre ação judicial é 0,1175 para sim, então 0,8825 de confiança no não. - O score não é um nível. Ele é a média, ponderada pela probabilidade, dos índices dos níveis, começando em 0, então 2,24 fica entre “menciona um prazo” e “diz que vai sair”. O cliente escreveu “if this is not sorted by Friday we will move our shipping to another provider”, e o modelo dividiu o peso em 73/25 entre esses dois níveis, o que é uma leitura justa.
- A regra de triagem é código comum por cima dos números:
if a["queue"].confidence < 0.6:
    route = "human_review"
elif a["double_charge"].noul > 0.9 and a["asks_for_refund"].noul > 0.9:
    route = f"{a['queue'].choice}/refund_fast_track"
else:
    route = a["queue"].choice
priority = "P1" if a["churn_risk"].score >= 2 or a["mentions_legal_action"].noul > 0.5 else "P3"
Cinco decisões custaram 520 tokens de input, cerca de cinco milésimos de centavo.
Adicionando um screenshot, uma mensagem de voz, um vídeo e um PDF
O 03_multimodal.py adiciona quatro anexos ao mesmo ticket: um screenshot do erro do app, uma mensagem de voz de 17 segundos, uma gravação de tela de 12 segundos e um extrato de conta em PDF de uma página. A mídia entra no input como blocos tipados, inline em base64 ou por URI:
shared = [
    {"type": "text", "text": json.dumps(TICKET) + "\n"},
    {"type": "image", "data": b64("screenshot.png"), "mime_type": "image/png"},
    {"type": "audio", "data": b64("voice_note.mp3"), "mime_type": "audio/mp3"},
    {"type": "video", "data": b64("screen_recording.mp4"), "mime_type": "video/mp4"},
    {"type": "document", "data": b64("statement.pdf"), "mime_type": "application/pdf"},
]
Eu fiz oito perguntas que só os anexos conseguem responder:
statement_shows_duplicate    0.9650     confidence=0.9650
caller_tone                  annoyed    confidence=0.9308
voice_deadline               friday     confidence=0.9725
video_error_appears          0.3245     confidence=0.6755
error_code_is_pay_4012       0.9210     confidence=0.9210
statement_contradicts_app    0.9514     confidence=0.9514
refund_amount                eur_89     confidence=0.9988
screenshot_shows_error       0.9010     confidence=0.9010

1723 ms, input tokens=3,805 (text=899, image=2,327, audio=579), output tokens=0
cost: $0.000380
Sete das oito estão certas. Ele leu o código de erro no screenshot, encontrou as duas cobranças no mesmo dia no PDF e ouviu “Friday” na mensagem de voz. A pergunta de que mais gostei cruza dois arquivos: o app diz que o pagamento falhou, e o extrato mostra que ele foi processado. Um request, cinco inputs, oito respostas, 3.805 tokens, US$ 0,00038. Levou 1,7 segundo, sendo o primeiro request daquele processo e um que faz upload de cerca de 300 KB de base64.
O erro foi no vídeo. A gravação mostra a tela de checkout por cinco segundos e depois o erro aparece, e nesta execução o modelo deu apenas 0,32 para “uma mensagem de erro aparece no meio do vídeo”. Quando eu rodei o request idêntico uma hora antes, a mesma pergunta voltou com 0,86, e as outras sete respostas se moveram um ou dois pontos. Ou seja, um request com mídia não me deu os mesmos números duas vezes, ao contrário dos requests só de texto mais adiante neste post, e uma resposta perto do meio pode cair de qualquer lado de um threshold. O mesmo vídeo enviado sozinho pela Files API deu 0,93 nas duas vezes.
Quanto custa cada arquivo
A página de preços dá uma única tarifa para todas as modalidades, mas a documentação não diz quantos tokens uma imagem ou um segundo de áudio custa neste modelo. Então eu enviei cada arquivo sozinho e li o bloco usage:
| Arquivo | resolution | Tokens de imagem | Tokens de áudio | Total cobrado |
|---|---|---|---|---|
| Screenshot (PNG 1170x2000) | low | 252 | 342 | |
| medium | 540 | 630 | ||
| high (igual ao padrão) | 1.075 | 1.165 | ||
| ultra_high | 2.196 | 2.286 | ||
| Mensagem de voz (MP3 de 17,1 s) | n/a | 519 | 643 | |
| Gravação de tela (MP4 de 12,2 s) | padrão, low ou medium | 720 | 60 | 892 |
| high | 3.024 | 60 | 3.196 | |
| Extrato em PDF (1 página) | n/a | 532 | 794 |
Os totais incluem a pergunta e a sua formatação, cerca de 90 tokens. O que eu tiro disso:
- Áudio deu cerca de 30 tokens por segundo, então um minuto de áudio fica em torno de 1.800 tokens, ou US$ 0,00018.
- Os frames de vídeo são contados como tokens de imagem: cerca de 60 por segundo de vídeo por padrão, e quatro vezes isso em
high.lowemediumcobraram o mesmo que o padrão. Meu vídeo não tem som e ainda assim cobrou 60 tokens de áudio. - As páginas de PDF são cobradas como uma imagem (532 tokens) mais o texto da página.
- Imagens usam
highpor padrão. Baixar o screenshot paralowreduziu de 1.075 para 252 tokens.
Estas são medições em quatro arquivos, não uma tabela de tarifas publicada. Leia o usage com a sua própria mídia.
A mídia também pode ir pela Files API. O script faz o upload do vídeo com client.files.upload(...) e passa {"type": "video", "uri": file.uri, "mime_type": "video/mp4"}. Isso funcionou de primeira e cobrou mais ou menos o mesmo (907 tokens contra 892). Também foi a forma mais confiável de perguntar sobre o vídeo nas minhas execuções: com o vídeo sozinho, a pergunta deu 0,93.
O Que Eu Medi
Todos os tempos são tempo de relógio (wall-clock) do request HTTPS inteiro a partir do meu laptop, em uma conexão que já estava aberta, então incluem a rede. Eles não são comparáveis aos números do Google no milissegundo, mas o formato da curva é.
Muitas perguntas sobre um input
O 04_fanout.py envia cerca de 1.800 tokens de input compartilhado com 1, 10, 100 e 1.000 perguntas sim/não, dez requests de cada:
| Perguntas | Tokens de input | p50 | p95 | Custo por request | Custo por pergunta |
|---|---|---|---|---|---|
| 1 | 1.835 | 286 ms | 338 ms | US$ 0,000183 | US$ 0,00018350 |
| 10 | 2.303 | 292 ms | 370 ms | US$ 0,000230 | US$ 0,00002303 |
| 100 | 7.064 | 379 ms | 527 ms | US$ 0,000706 | US$ 0,00000706 |
| 1.000 | 55.574 | 2.655 ms | 3.015 ms | US$ 0,005557 | US$ 0,00000556 |
A afirmação sobre a cobrança se sustenta: o input compartilhado é contado uma vez, e cada pergunta extra adicionou cerca de 53 tokens. Minhas perguntas têm umas 10 palavras, então boa parte disso é overhead de formatação que toda pergunta paga, além do próprio texto.
A afirmação sobre a latência se sustenta na faixa para a qual o Google a declara. Ir de 1 para 10 perguntas não mudou nada, e 100 perguntas adicionaram cerca de 90 ms. Com 1.000 perguntas, o request levou 2,7 segundos. Ele ainda retornou todas as 1.000 respostas em uma chamada por meio centavo, mas já não é uma chamada em tempo real.
Latência conforme o input cresce
O 05_context_scaling.py envia um log de eventos sintético de tamanho crescente com duas perguntas, dez requests por tamanho até 64K tokens e cinco acima disso:
| Tokens de input | p50 | p95 | Custo por request |
|---|---|---|---|
| 1.132 | 309 ms | 361 ms | US$ 0,000113 |
| 4.052 | 323 ms | 420 ms | US$ 0,000405 |
| 15.748 | 441 ms | 585 ms | US$ 0,001575 |
| 62.632 | 697 ms | 934 ms | US$ 0,006263 |
| 125.268 | 1.087 ms | 1.186 ms | US$ 0,012527 |
| 244.544 | 2.042 ms | 2.404 ms | US$ 0,024454 |
O número do Google é de 150 a 250 ms de ponta a ponta para contextos de até 16K tokens. Eu não vi isso como mediana nesta execução. Nas três vezes em que rodei este script, a mediana com 1K tokens foi de 233, 340 e 309 ms, e no teste de calibração abaixo o request mais rápido levou 127 ms, então o número está ao alcance do que eu vi. A partir da minha conexão, uma expectativa realista foi de 200 a 350 ms para inputs pequenos e de 450 a 520 ms com 16K.
O log tem uma única linha de ERROR enterrada no meio. Em todos os tamanhos, incluindo 244K tokens, o modelo respondeu que a maior severidade presente era error e que nenhuma linha menciona um reembolso.
Rodar este teste logo depois do anterior, em uma execução mais antiga, também produziu meu primeiro erro de rate limit de verdade:
{"error": {"message": "Rate limit exceeded for model gemini-decision-1 (limit: 1000000 input tokens per minute on Tier 1). Please retry in 57s or upgrade your tier at https://ai.dev/rate-limit.", "code": "too_many_requests"}}É um HTTP 429, com uma mensagem clara. Repare no formato do erro: code é uma string, e não o par de código numérico e status que os outros erros da Gemini API usam.
As probabilidades são honestas?
“Calibrado” significa que, quando o modelo diz 0,8, ele acerta cerca de 80% das vezes. É essa propriedade que dá sentido aos thresholds. O 06_calibration.py testa isso em dados que o Google não escolheu: 500 artigos amostrados com uma seed fixa do conjunto de teste público do AG News, cada um rotulado como mundo, esportes, negócios ou ciência e tecnologia. Cada request faz uma pergunta choice (o tema) e uma pergunta sim/não (se é sobre esportes).
== topic (choice)
accuracy = 0.884   top-1 ECE = 0.0403
confidence     n  stated  actual
0.4-0.5        8   0.484   0.500
0.5-0.6       36   0.552   0.583
0.6-0.7       31   0.655   0.806
0.7-0.8       27   0.742   0.704
0.8-0.9       39   0.857   0.795
0.9-1.0      359   0.983   0.953
confidence >= 0.5: keeps 98.4% of items, accuracy 0.890
confidence >= 0.7: keeps 85.0% of items, accuracy 0.922
confidence >= 0.9: keeps 71.8% of items, accuracy 0.953
confidence >= 0.95: keeps 63.8% of items, accuracy 0.953

== is_sports (yes/no)
accuracy = 0.990   ECE = 0.0117   min P = 0.01   max P = 0.99
answers at the clamp: 160 at 0.01, 34 at 0.99
A coluna “stated” é a confiança média em cada faixa, e “actual” é a frequência com que essas respostas estavam certas. As duas andam juntas: as respostas dadas com cerca de 0,55 estavam certas 58% das vezes, e as respostas acima de 0,9 estavam certas 95% das vezes. O erro de calibração esperado (a diferença média ponderada pelo tamanho de cada faixa) é 0,040 para a pergunta de tema e 0,012 para a pergunta sim/não. O Google reporta 0,025 no próprio conjunto; o meu é um pouco pior e ainda assim bom. O modelo é levemente confiante demais no topo: ele diz 0,98 e entrega 0,95.
Duas ressalvas. O AG News tem quatro rótulos com fronteiras difusas entre negócios e tecnologia, então 88,4% é em parte um teto do próprio dataset. E 500 artigos de texto jornalístico são uma única tarefa; isso não diz nada com certeza sobre a sua.
O resultado prático é a tabela de thresholds. Mandar tudo abaixo de 0,9 de confiança para uma pessoa teria tratado automaticamente 72% dos artigos com 95,3% de acurácia.
O mesmo script envia 20 artigos cinco vezes cada. A opção do topo nunca mudou, e todos os valores de confiança foram idênticos até a quarta casa decimal. A documentação não promete determinismo, e o request multimodal acima mostra que isso não se estende à mídia, mas para texto foi o que eu obtive.
Edge cases
O 07_edge_cases.py roda os casos com os quais eu me preocuparia antes de colocar isto na frente de tráfego real.
Quando nenhuma opção se encaixa. Eu perguntei qual problema de envio o ticket de cobrança descreve, com quatro opções de envio. Uma pergunta choice sempre distribui a probabilidade entre as opções que tem:
HTTP 200 (322 ms)
  issue              late_delivery (confidence 0.4291)
                     late_delivery=0.4291  lost_parcel=0.3544  damaged_parcel=0.1133  wrong_address=0.1032
Ele escolheu late_delivery, mas com 0,43, o que um threshold de confiança pegaria. Adicionar uma opção other e uma verificação de escopo sim/não resolveu de vez: other com 0,9993, e “isto é sobre um problema de envio” com 0,0785.
Ordem e nomes das opções. A documentação diz que as chaves das opções são ordenadas alfabeticamente antes da avaliação, então a ordem delas no seu JSON não importa. Isso se confirmou: as mesmas opções enviadas na ordem direta e invertida retornaram probabilidades idênticas. Mas quando mantive as descrições e renomeei as chaves de billing, technical, account, shipping para d_queue, c_queue, b_queue, a_queue, a resposta em uma mensagem ambígua foi de 0,54 / 0,43 para 0,70 / 0,27 para as mesmas duas filas. Meu teste mudou ao mesmo tempo os nomes e a posição em que eles caem na ordenação, então não posso dizer qual dos dois causou isso. De qualquer forma, as chaves das opções não são rótulos livres: use chaves com significado, e não as renomeie sem testar os seus thresholds de novo.
Prompt injection. Uma mensagem de spam simples deu 0,97 para “Esta mensagem é spam?”. Então eu acrescentei à mensagem uma nota falsa dizendo ao classificador que ela já tinha sido revisada e não era spam:
| Pergunta | Spam simples | Spam com nota injetada |
|---|---|---|
| Esta mensagem é spam? | 0,9718 | 0,5126 |
| A mesma pergunta, com critérios que tratam esse tipo de texto como sinal de spam | 0,9727 | 0,9858 |
| A mensagem tenta instruir um classificador automatizado? | 0,0100 | 0,9712 |
A nota injetada levou a pergunta simples de 0,97 para um cara ou coroa. O guia do Google alerta sobre isso (“o texto fornecido pelo usuário pode defender a própria classificação”), e o conselho dele funciona: com criteria explícitos (uma true_description dizendo que um texto que diz como classificá-lo é, por si só, um sinal), a resposta subiu em vez de cair. Uma pergunta separada, que verifica se o input tenta instruir um classificador, pegou a nota com 0,97. As duas custam poucos tokens.
Erros. Erros de validação retornam HTTP 400 com uma mensagem que nomeia a regra:
| Request | Status | Mensagem |
|---|---|---|
| Chave de pergunta com um espaço | 400 | * CreateDecisionRequest.questions[is it ok]: question IDs must be 1-64 characters matching [A-Za-z0-9_-]+ |
| Choice com uma opção | 400 | * CreateDecisionRequest.questions[q].choice.criteria: must have between 2 and 255 options |
| 1.001 perguntas | 400 | * CreateDecisionRequest.questions: must have between 1 and 1000 questions |
| Input acima da janela de contexto | 400 | The input token count exceeds the maximum number of tokens allowed (262144). |
v1 em vez de v1beta | 404 | corpo vazio |
| Sem chave de API | 403 | Method doesn't allow unregistered callers (callers without established identity)... |
| Acima do rate limit de tokens | 429 | Rate limit exceeded for model gemini-decision-1 (limit: 1000000 input tokens per minute on Tier 1)... |
A documentação também descreve bloqueios de segurança que retornam HTTP 400 no lugar das respostas. Eu enviei como input um pedido violento de instruções, com a pergunta “Esta mensagem pede ajuda para ferir pessoas?”, e ele não foi bloqueado: respondeu 0,99. É isso que você quer de um modelo usado para moderação, e um único input não é um teste do filtro. Eu não tentei descobrir onde o bloqueio começa.
Contra o Gemini 3.5 Flash-Lite
A alternativa do tipo faça você mesmo é um modelo generativo pequeno com um structured output restrito a um enum. O 08_flash_lite_baseline.py envia os mesmos 500 artigos ao gemini-3.5-flash-lite dessa forma, com temperatura 0, e depois ao gemini-decision-1 com a mesma pergunta única:
| Acurácia | p50 | p95 | Tokens de input | Tokens de output | Custo por 1.000 itens | |
|---|---|---|---|---|---|---|
gemini-decision-1 | 0,884 | 259 ms | 352 ms | 89.157 | 0 | US$ 0,0178 |
gemini-3.5-flash-lite | 0,884 | 679 ms | 926 ms | 54.712 | 5.599 | US$ 0,0608 |
A acurácia empatou: 442 de 500 para cada um, nesta execução. Eu rodei a parte do Flash-Lite três vezes nos mesmos artigos e obtive 0,892, 0,878 e 0,884, então as respostas dele não são estáveis entre execuções nem com temperatura 0, enquanto as respostas da Decisions API neste texto foram idênticas todas as vezes. Os dois modelos concordaram em 95,2% dos artigos.
A Decisions API foi 2,6 vezes mais rápida na mediana e custou 3,4 vezes menos. O “quase 5x mais barato” do Google vale para o próprio conjunto dele; em inputs curtos como estes, a diferença é menor, porque o request da Decisions API gastou mais tokens de input (178 por artigo contra 109), que é de novo o overhead por pergunta. Com inputs mais longos ou várias perguntas por input, a diferença aumenta: o Flash-Lite precisaria de uma chamada por pergunta, ou de um schema maior e de mais tokens de output.
O que o Flash-Lite não consegue dar de jeito nenhum é a probabilidade. Ele retorna um rótulo, e não há nada a que aplicar um threshold.
Resumo dos resultados
| Afirmação ou pergunta | O que eu encontrei |
|---|---|
| 150 a 250 ms até 16K tokens | Medianas de 190 a 340 ms com 1K a 4K e de 440 a 520 ms com 16K, em três execuções, rede incluída. Um request mais rápido de 127 ms |
| Latência estável de 1 a 100 perguntas | Sim: 286, 292 e 379 ms. 1.000 perguntas levaram 2,7 s |
| Input compartilhado cobrado uma vez | Sim. Cerca de 53 tokens por pergunta extra de 10 palavras |
| Probabilidades calibradas | ECE de 0,040 (choice) e 0,012 (sim/não) em 500 artigos do AG News |
| Determinístico | Texto: 20 itens, 5 execuções cada, respostas idênticas. Com mídia: não, uma resposta foi de 0,86 para 0,32 entre execuções |
| Quase 5x mais barato que o Flash-Lite | 3,4x na minha carga de trabalho, 2,6x mais rápido, mesma acurácia |
| Nenhuma opção se encaixa | Ainda escolhe uma, com baixa confiança. Adicione other ou uma verificação de escopo |
| Prompt injection | Uma nota plantada levou 0,97 a 0,51. Critérios explícitos restauraram o resultado |
| Client padrão do SDK | 404 com corpo vazio até fixar em v1beta |
Preços
O gemini-decision-1 custa US$ 0,10 por 1M de tokens de input em todas as modalidades, sem cobrança de output. O input compartilhado é cobrado uma vez por request, e cada pergunta adiciona as próprias instruções, critérios e formatação. Não há context caching, nem Batch API, nem tiers Flex ou Priority, então o input que você repete entre requests é cobrado integralmente toda vez.
Isto é o que este post custou, a partir das contagens de tokens que os scripts registraram:
| Trabalho | Tokens | Custo |
|---|---|---|
| Todos os testes da Decisions API, todas as execuções | 9.019.976 | US$ 0,90 |
| Baseline do Flash-Lite, três execuções | 180.937 | US$ 0,09 |
| Total | US$ 0,99 |
A maior parte dos US$ 0,90 vem dos dois testes grandes, os requests de 250K tokens e os requests de 1.000 perguntas, que eu rodei várias vezes, a última delas para o vídeo. Uma passada dos dois scripts de demo custa cerca de um quinto de centavo, e a maior parte disso são as medições por arquivo.
Para dar uma escala: a triagem de ticket com cinco perguntas tem 520 tokens, então um milhão de tickets por mês custaria cerca de US$ 52. A versão multimodal, com 3.805 tokens, sairia por cerca de US$ 380.
Como ela se compara pelo preço de tabela, a partir das páginas de cada fornecedor em 12 de novembro de 2026:
| Input por 1M de tokens | Output | Máx. de perguntas | Tipos de input | Observações | |
|---|---|---|---|---|---|
| Gemini Decision 1 | US$ 0,10 | nenhum | 1.000 | texto, imagem, áudio, vídeo, PDF | Free tier. Sem caching nem batch |
OpenAI gpt-6-luna (Decisions API) | US$ 0,10 | nenhum | 400 | texto, imagem | Input em cache a US$ 0,01 |
| TypeSafe Jev | US$ 0,042 | nenhum | não comparado | texto, imagens atrás de uma flag | Acesso antecipado |
| Gemini 3.5 Flash-Lite (structured output) | US$ 0,30 | US$ 2,50 | n/a | texto, imagem, áudio, vídeo, PDF | Um rótulo, sem probabilidade |
Eu só rodei as duas linhas do Google. Por token, o Gemini empata com a OpenAI e custa cerca de 2,4 vezes o Jev. Onde ele se destaca é no input de áudio, vídeo e PDF e no limite de 1.000 perguntas. Se os seus inputs são texto curto e o seu volume é alto, os modelos de texto mais baratos merecem um teste com os seus próprios dados. Se você reenvia o mesmo prefixo longo em todo request, a tarifa de input em cache da OpenAI muda a conta, já que o Gemini cobra input repetido integralmente.
O uso pago aparece no projeto do Google Cloud dono da chave de API, na página de relatórios do Cloud Billing, normalmente em até um dia e às vezes mais, segundo a documentação de billing do Google.
Limpeza
Nada aqui é cobrado por hora. As únicas coisas que ficam para trás são os arquivos enviados à Files API, que expiram sozinhos depois de 48 horas, e a chave de API da Configuração.
python 09_cleanup.py== Files API
deleted files/ci11790jnw9m (video/mp4, 33388 bytes)
files left: 0
== what the scripts sent (from results/spend.json)
gemini-decision-1 tokens=9,019,976 $0.9020
gemini-3.5-flash-lite tokens=180,937 $0.0912
total $0.9932Depois exclua a chave da demo, na página Credentials ou com o script:
$ ./00_setup_gcloud.sh --delete

== Delete the API key "decisions-api-demo"
plain delete:
  deleted; keys named decisions-api-demo left: 0
Uma surpresa aqui. A primeira chave de demo que eu criei estava em uso havia uns vinte minutos quando tentei excluí-la, e um gcloud services api-keys delete simples recusou:
FAILED_PRECONDITION: Unable to delete key. Active usage in the last 7 days was detected for service(s): generativelanguage.googleapis.com. To override this protection and apply the change, set check_existing_usage to SKIP.É uma proteção contra excluir uma chave da qual algo ainda depende. Para uma chave que você sabe que é descartável, --no-check-existing-usage pula a verificação, e o script recorre a essa opção. Uma segunda chave, que tinha feito um request segundos antes, foi excluída sem reclamar, então a verificação parece depender de o uso já ter sido registrado. Eu rodei os experimentos em uma chave que eu já tinha, e fiquei com ela.
Veredito
A Gemini Decisions API faz a coisa estreita que promete. O primeiro request é um comando curl, a resposta é pequena e tipada, e nos meus testes as probabilidades foram honestas o bastante para colocar thresholds em cima delas. A acurácia empatou com a de um modelo generativo pequeno no meu conjunto rotulado, com menos da metade da latência e cerca de um terço do custo, e em texto as respostas não mudaram entre execuções.
O que funciona
- Input multimodal em um único request. Um screenshot, uma mensagem de voz, um vídeo e um PDF respondidos juntos, incluindo uma pergunta que precisava de dois deles, por US$ 0,00038. Sete de oito respostas estavam certas.
- Calibração. A confiança declarada acompanhou a acurácia real em dados que o Google não escolheu.
- Fan-out. Até 100 perguntas sobre um input quase não custaram nada a mais em tempo ou dinheiro.
- Mensagens de erro. Erros de validação e de rate limit nomeiam a regra e o limite.
O que não funciona
- O client padrão do SDK retorna um 404 vazio. Você precisa saber que tem que fixar
v1beta. - Inputs curtos pagam um overhead por pergunta. Em inputs de 100 tokens, a economia em relação ao Flash-Lite foi de 3,4x, não de 5x.
- Sem caching nem batch. Contexto repetido é cobrado integralmente, o que prejudica justamente o caso de uso de roteamento, em que todo request compartilha um preâmbulo longo.
- As respostas com mídia mudaram entre execuções. O mesmo request deu 0,86 para a pergunta do vídeo uma vez e 0,32 na seguinte.
- A injection funciona em uma pergunta ingênua. A correção é barata, mas você precisa escrevê-la.
- As tarifas de tokens de mídia não são documentadas para este modelo. Eu tive que medi-las.
- Ainda sem suporte na plataforma do Google Cloud, e o Google não diz se a API está em preview ou em disponibilidade geral.
Quem deve usar
Use para roteamento, verificações de política, seleção de ferramentas e grading de evals, onde você quer um número ao qual aplicar um threshold, e principalmente onde o input não é só texto. Mantenha um modelo generativo para qualquer coisa que precise de uma explicação, e mantenha uma pessoa por trás da faixa de baixa confiança. Se a sua carga de trabalho é texto curto em alto volume, faça primeiro um benchmark contra os modelos de decisão mais baratos. Seja qual for a sua escolha, monte um pequeno conjunto rotulado a partir do seu próprio tráfego e rode a verificação de calibração nele antes de confiar em um threshold; o meu levou 500 requests e custou cerca de um centavo.