GKE Agent Sandbox: Hands-On com Warm Pools, Pod Snapshots e o Fallback Silencioso
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão geral
- Configuração
- Passo 1: Projeto, ferramentas e versões
- Passo 2: O cluster e seus node pools
- Passo 3: O bucket de snapshots e suas permissões
- Testes
- Teste 1: Duas formas de instalar
- Teste 2: Isolamento e postura de rede
- Teste 3: Latência de claim em warm pool
- Teste 4: Pod Snapshots
- Teste 5: Restore no tipo de máquina errado
- Teste 6: gVisor e microVM em um só cluster
- Teste 7: O que um operador consegue ver
- Resumo dos resultados
- Monitoramento
- Preços
- Veredito
- O que funciona
- O que não funciona, ainda
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagine uma loja de brinquedos com uma fileira de caixas de brincar já abertas. Quando uma criança pede uma, a loja entrega na hora, e isso é rápido. Se todas as caixas abertas já foram levadas, o dono da loja precisa montar uma nova, e isso demora muito mais.
Existe também uma foto mágica: você pode congelar um jogo no meio, guardar a caixa, e mais tarde ela volta exatamente como estava. Mas se você descongelar em um tipo de mesa diferente, ela começa o jogo do zero em silêncio e não avisa ninguém.
O Agent Sandbox é um software open source que você roda no seu próprio cluster GKE, isolando cada agente em um sandbox gVisor ou microVM. Não há taxa extra. O isolamento, as regras de rede e a política de admissão são de sua responsabilidade configurar e verificar.
Nos meus testes, as regras de rede padrão protegeram apenas os sandboxes criados a partir de um template: um sandbox criado diretamente alcançou o metadata server e o resto do cluster. Um snapshot restaurado em um tipo de máquina diferente começou a frio sem nenhum erro. Verifique os dois antes de depender de qualquer um deles em uma declaração de compliance.
A necessidade apresentada é rodar código de agentes não confiável com isolamento forte e inícios rápidos. O tratamento é um pool de pods gVisor aquecidos, reivindicados sob demanda, mais snapshots para suspender e retomar agentes. Os claims aquecidos levaram uma fração de segundo; um create a frio levou cerca de dois segundos e meio.
Efeitos colaterais a monitorar: quando os claims excedem o warm pool, o excedente levou de 21 a 32 segundos no meu burst, e um restore no tipo de node errado não produziu erro, apenas um contador de volta a zero. Um volume persistente ditou o ritmo: uma retomada levou cerca de 12 segundos com um e cerca de 2 sem.
Existe uma calma que vem de saber que cada agente tem seu próprio quarto com paredes, e boa parte dessa calma é merecida: os quartos aquecidos ficaram prontos em uma fração de segundo, e o snapshot trouxe um agente de volta no meio de um pensamento.
O desconforto está nas falhas silenciosas. Um quarto feito à mão não tinha paredes na rede, e um snapshot restaurado na máquina errada simplesmente recomeçou sem nenhum aviso. Nomear esses momentos com antecedência torna mais fácil planejar em torno deles do que descobri-los às 3 da manhã.
Pense no warm pool como uma banda que já afinou os instrumentos: o claim é a contagem inicial, e a primeira nota cai em uma fração de segundo. Peça mais músicos do que os que estão afinados e o resto precisa desembalar, o que no meu burst significou um longo silêncio antes de eles entrarem.
O snapshot é a gravação da tomada. Tocada na mesma bateria, ela continua no meio do compasso. Tocada em outra bateria, ela não reclama: simplesmente começa a música de novo do início, e ninguém no palco percebe até o contador marcar zero.
A história é de inícios rápidos com isolamento real: claims aquecidos do Agent Sandbox voltaram em bem menos de um segundo nas minhas execuções, em gVisor, sem taxa de licença além do cluster. Os Pod Snapshots adicionam suspender e retomar, e um restore sem volumes voltou em cerca de dois segundos.
O ângulo honesto para um case study está nas letras miúdas: claims excedentes levaram 20 segundos ou mais, sandboxes criados diretamente pulam a network policy padrão, e um snapshot restaurado no tipo de máquina errado começa a frio sem erro. Combine a velocidade com essas três verificações.
 Veja o código-fonte aqui: gcp-sandboxes/gke-agent-sandbox
Visão geral
O Agent Sandbox é um projeto do Kubernetes SIG Apps que o Google oferece no GKE sem custo extra. Ele adiciona quatro custom resources: Sandbox (um pod isolado e com estado), e as extensões SandboxTemplate, SandboxWarmPool e SandboxClaim. Um warm pool mantém pods prontos esperando, e um claim pega um deles. O isolamento vem do GKE Sandbox, seja gVisor ou, em clusters Standard desde a 1.37.0, uma microVM com Kata e Cloud Hypervisor. O Google anunciou a disponibilidade geral em 21 de maio de 2026 com dois números: “300 sandboxes per second, per cluster” e “90% of allocations completing in 200 milliseconds”. A página de conceitos agora recomenda o Agent Substrate para a maioria dos workloads de agentes e mantém o Agent Sandbox para agentes que precisam de um Pod dedicado, GPUs ou TPUs, um PodSpec completo ou Autopilot.
Este post, parte 5 de 6 da série Google Cloud Sandboxes, testa tudo em um cluster real. A Parte 1 mapeia as opções do Google Cloud para rodar código em que você não confia. A Parte 2 cobriu o sandbox por trás do Managed Agents, a parte 3 os sandboxes do Agent Platform, e as partes 4 e 6 cobrem os sandboxes do Cloud Run e o Agent Substrate no GKE. Este é o caso em que o sandbox é um pod no seu próprio cluster, então os padrões do cluster importam tanto quanto os do sandbox.
Eu rodei tudo em 14 de novembro de 2026 em um cluster GKE Standard zonal em us-central1-a (canal Rapid, 1.37.1-gke.2097000), com kubectl, um pequeno harness em Python em torno do SDK k8s-agent-sandbox, e uma execução limpa gravada para o vídeo. Seis resultados se destacaram:
- Existem dois caminhos de instalação, e a documentação mostra um. O
gcloud beta container clusters update --enable-agent-sandboxainda funciona e instala um add-on gerenciado com duas admission policies, mas o console não tem nenhuma linha para ele. O caminho documentado é umkubectl applydo controller open source; usei a última release, v1.0.11, enquanto as páginas do GKE ainda fixam a v1.0.6. - A proteção de rede padrão cobre apenas sandboxes criados por template. Um Sandbox criado a partir de um template não conseguiu alcançar o metadata server, o DNS do cluster nem outros pods. Um Sandbox que criei diretamente alcançou todos eles e obteve um token do metadata server, exatamente como um pod normal faz.
- Um warm claim é rápido, e tudo o que passa do pool é lento. Claims contra um warm pool levaram 0,28 segundo na mediana a partir do meu laptop, e o próprio histograma do controller colocou o percentil 90 em 220 a 233 ms, logo acima dos 200 ms do Google. Em um burst de 20 contra um pool de 10, os 10 claims excedentes levaram de 21 a 32 segundos.
- Um volume decide a velocidade de uma retomada. Sem um, restaurar um Pod Snapshot levou de 2,1 a 2,7 segundos até a primeira resposta, não mais lento que um restart a frio. Com um PersistentVolumeClaim anexado, as retomadas levaram 12 segundos na maioria das minhas execuções e de 3 a 5 segundos em duas, e um snapshot não as deixou mais rápidas.
- Um snapshot restaurado no tipo de máquina errado começa a frio, em silêncio. Em um node N2, o snapshot do C3 foi ignorado: o pod começou do zero, o contador voltou a 5, e nenhum evento ou condition avisou.
- gVisor e microVM diferem onde você esperaria, e uma coisa é igual. O sandbox microVM tinha um kernel 6.6 de verdade, iniciou em cerca de 4 segundos contra 1 do gVisor, e custou 250 mCPU e 130 MiB a mais por pod. Os dois alcançaram o metadata server neste cluster.
Configuração
Passo 1: Projeto, ferramentas e versões
Usei um projeto separado com cobrança e um alerta de orçamento, us-central1-a, e estas versões: Google Cloud CLI 593.0.0 (beta 2026.11.06), kubectl 1.37.2, Python 3.12 e k8s-agent-sandbox 1.0.11. Billing e as APIs do Kubernetes Engine, Compute Engine, Cloud Storage e IAM são os únicos pré-requisitos. As versões do SDK e do controller precisam ser iguais.
Passo 2: O cluster e seus node pools
Standard, zonal, canal Rapid, Workload Identity ativado, Dataplane V2 para que a NetworkPolicy seja aplicada, e Pod Snapshots ativados. O GKE Sandbox também precisa de pelo menos um node pool que não seja sandboxed, então o pool padrão do cluster é um pequeno pool de sistema:
gcloud beta container clusters create sbx-gke --zone us-central1-a --release-channel rapid --num-nodes 1 \
  --machine-type e2-standard-2 --workload-pool=$PROJECT.svc.id.goog --enable-dataplane-v2 \
  --enable-pod-snapshots --no-enable-autoupgrade

gcloud container node-pools create gvisor --cluster sbx-gke --zone us-central1-a --num-nodes 1 \
  --machine-type c3-standard-4 --image-type cos_containerd --sandbox=type=gvisor --workload-metadata=GKE_METADATA
O cluster levou 7 minutos e o pool 1,4 minuto. O pool de sandbox é um c3-standard-4, e não o e2-standard-2 da documentação, porque snapshots de pod inteiro não funcionam em E2. No console, a opção gVisor é a caixa de seleção Enable sandbox with gVisor em Security quando você adiciona um node pool; não há opção de microVM lá, e o pool microVM do Teste 6 é só via gcloud.
Passo 3: O bucket de snapshots e suas permissões
Os Pod Snapshots gravam no Cloud Storage, e o bucket precisa de hierarchical namespace ativado e soft delete desativado, mais uma managed folder. Uma custom role e bindings de Workload Identity permitem que uma service account do Kubernetes grave nele:
gcloud storage buckets create gs://$BUCKET --location=us-central1 --uniform-bucket-level-access \
  --enable-hierarchical-namespace --soft-delete-duration=0
gcloud storage managed-folders create gs://$BUCKET/snapshots/
gcloud iam roles create podSnapshotGcsReadWriterP5 --project=$PROJECT \
  --permissions="storage.objects.get,storage.objects.create,storage.objects.delete,storage.folders.create"
Depois, roles/storage.bucketViewer para o namespace, a custom role e roles/storage.objectUser para a única service account, e roles/storage.objectUser para o robô do snapshot controller do GKE (tudo em 00_cluster.sh no repositório complementar). Dei à role um ID novo porque o ID de uma custom role deletada não pode ser reutilizado por semanas. O próprio controller do Agent Sandbox é o Teste 1.
Testes
Teste 1: Duas formas de instalar
A página de instalação do GKE manda você aplicar um manifest de release. Resultados de busca de antes da mudança da página descrevem uma flag gerenciada, então testei as duas, começando pela flag.
gcloud beta container clusters update sbx-gke --zone us-central1-a --enable-agent-sandboxFuncionou, depois de 6 a 7,5 minutos. O que ela fez:
| O que eu olhei | Resultado |
|---|---|
addonsConfig.agentSandboxConfig | enabled: true |
| CRDs | As quatro CRDs do Agent Sandbox, servindo v1alpha1 e v1beta1 |
| Controller | Nenhum pod em lugar nenhum: o lease de leader election estava com uma VM do control plane, então ele parece rodar do lado do Google |
| Versão | Não visível; a annotation da CRD diz component-version: 1.37.5, que é a do add-on, não a do controller |
| Admission policies | Duas novas: sandbox-core-policy (13 verificações) e sandbox-hardening-policy (4). Elas permitem runtimeClassName: microvm |
| Console | Nenhuma linha para ele na lista Features do cluster, embora Pod Snapshots: Enabled esteja lá; o texto “Agent Sandbox” não aparece em lugar nenhum da página Details |
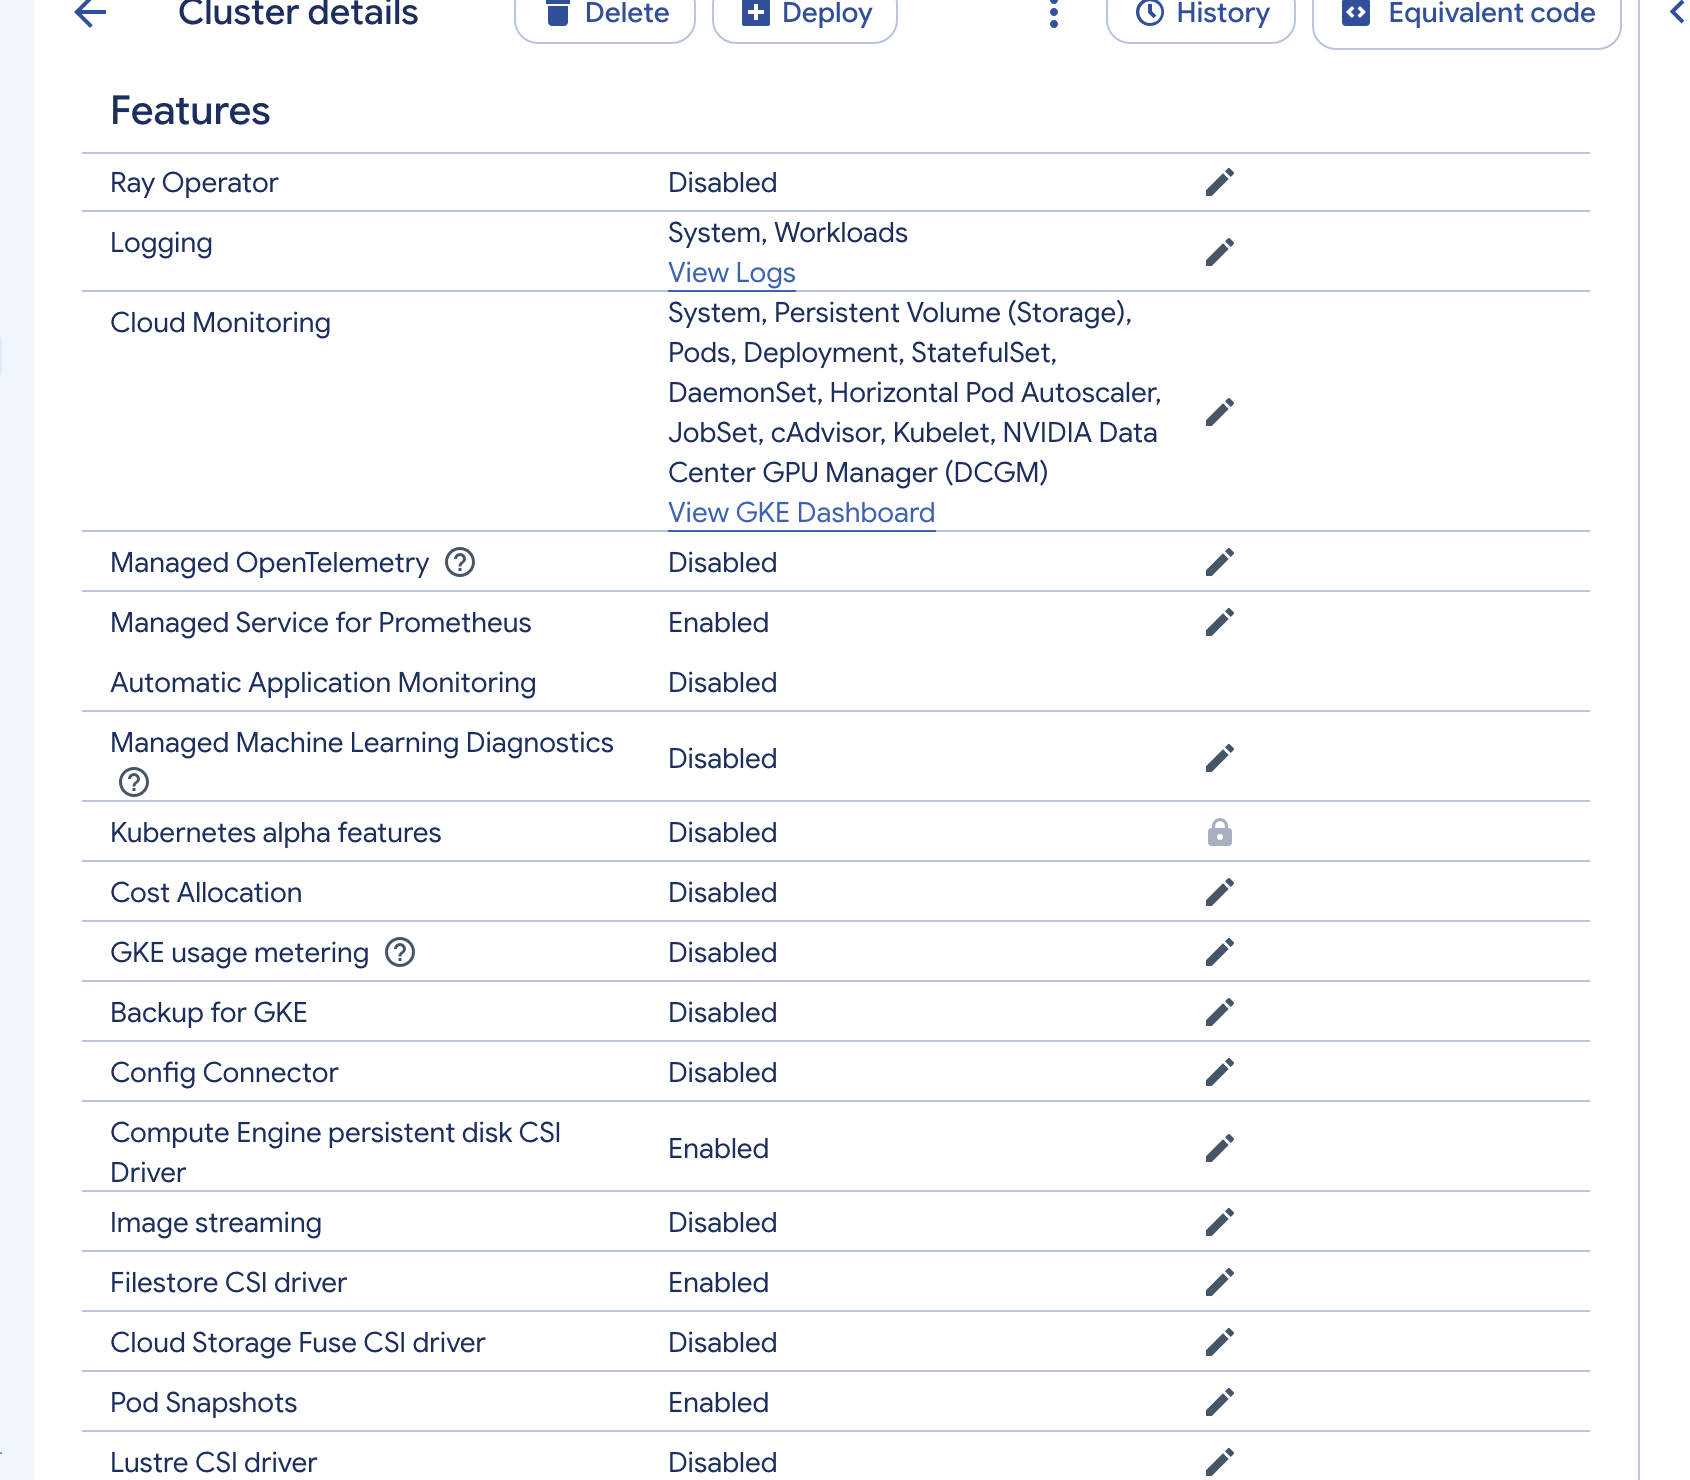
Com o add-on ativado, um template e um pool de 2 ficaram prontos em 8 segundos e um claim voltou em menos de um segundo. Desativá-lo com --no-enable-agent-sandbox levou de 6 a 8 minutos e deixou tudo para trás: as CRDs, as duas policies e bindings, e os meus sandboxes, com o lease do controller desaparecido. Eu os deletei à mão antes do próximo passo.
O caminho documentado:
kubectl apply -f https://github.com/kubernetes-sigs/agent-sandbox/releases/download/v1.0.11/sandbox-with-extensions.yaml
kubectl rollout status deployment/agent-sandbox-controller -n agent-sandbox-system
O apply levou de 6 a 8 segundos e o controller ficou pronto de 8 a 14 segundos depois de iniciado, em duas execuções. Este serve apenas v1beta1, e roda como um pod no node de sistema com --leader-elect=true --extensions. Depois vêm a secure-sandbox-policy recomendada (16 verificações) e o Sandbox Router, de que o cliente Python precisa.
A policy rejeitou os dois Sandboxes que eu esperava que rejeitasse:
The sandboxes "reject-root" is invalid: : ValidatingAdmissionPolicy 'secure-sandbox-policy' with binding
  'secure-sandbox-binding' denied request: Security Violation: Pods or Containers must set 'runAsNonRoot: true', ...
The sandboxes "reject-microvm" is invalid: : ... Security Violation: All Sandboxes must use 'runtimeClassName: gvisor'
Uma coisa que a policy não conta: o template do próprio guia de snapshots não a satisfaz. Ele não tem securityContext, nem capability drop, nem limits, e a página de instalação anterior do guia recomenda a policy. O kubectl apply aceitou o template e um warm pool de 1; o pool simplesmente ficou em DESIRED 1, com READY vazio. O motivo apareceu apenas no log do controller: ... denied request: Security Violation: All containers must explicitly drop 'ALL' capabilities. A policy verifica Sandboxes, e o controller cria esses depois.
Usei a v1.0.11 com a policy recomendada para tudo o que vem a seguir. Segundo as release notes, a v1.0.10 mudou a NetworkPolicy do router para permitir egress na TCP 443 e 6443 e DNS para qualquer destino; mantive esse padrão.
Teste 2: Isolamento e postura de rede
Três workloads no mesmo cluster, uma sonda: um pod runc comum no node de sistema, um Sandbox reivindicado de um SandboxTemplate, e um Sandbox criado diretamente com kind: Sandbox. A página de conceitos do Google diz que o controller não cria uma NetworkPolicy para um Sandbox que você cria diretamente. Eu queria ver o que isso significa.
./02_isolation.sh # runs probe.sh inside each workload| Sonda | Pod runc | Sandbox por template | Sandbox direto |
|---|---|---|---|
uname -r | 6.18.53+ | 4.19.0-gvisor | 4.19.0-gvisor |
dmesg | permission denied | Starting gVisor... | Starting gVisor... |
| Token do metadata server | HTTP 200 | timed out | HTTP 200 |
| Nome DNS do cluster | resolve | falha | resolve |
| Outro pod na :8888 | HTTP 200 | timed out | HTTP 200 |
www.google.com | HTTP 200 | HTTP 200 | HTTP 200 |
O Sandbox por template fica isolado do cluster e aberto para a internet. A NetworkPolicy do controller permite egress para 0.0.0.0/0 exceto 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 e 169.254.0.0/16, e ingress apenas dos pods do router. Ela também define dnsPolicy: None com nameservers públicos 8.8.8.8 e 1.1.1.1, e é por isso que nomes do cluster não resolvem mas www.google.com sim. Um pod runc no node de sistema também não conseguiu alcançar o Sandbox por template.
O Sandbox criado diretamente tem o kernel gVisor e nada disso. Ele alcançou o metadata server e imprimiu o ID do projeto, a zona, o nome do node e um Bearer token para o principal de Workload Identity do namespace, mesmo com automountServiceAccountToken: false definido. Esse token não tem roles a menos que você conceda alguma, mas guias como o de snapshots concedem roles/storage.bucketViewer a toda service account de um namespace. A página GKE Sandbox do Google diz que pods em nodes gVisor “can’t access cluster metadata on the node OS level”; com Workload Identity ativado, quem responde é o metadata server do GKE, e um Sandbox gVisor direto conseguiu usá-lo. O kubectl get networkpolicy -A mostrou uma policy, a do template.
Mais um limite do gVisor vindo da documentação, confirmado: kubectl port-forward para um pod gVisor conecta e depois falha com connection refused. O kubectl exec e o router funcionam.
Teste 3: Latência de claim em warm pool
A promessa do Google é de “300 sandboxes per second” e 90% das alocações em 200 ms, em um hardware que ele não informa. Eu tenho um node c3-standard-4, então não consigo testar 300 por segundo, mas consigo testar os 200 ms. O harness usa o SDK através do router (kubectl port-forward para o service do router) e lê o histograma agent_sandbox_claim_controller_startup_latency_ms do controller antes e depois de cada fase. O template usa requests pequenos (50m, 128Mi) para que 30 sandboxes caibam no node, e o pool pode se reabastecer entre os claims: o harness consulta o readyReplicas do pool antes de cada um.
sb = client.create_sandbox(warmpool="bench-pool10", namespace="default")   # claim created -> claim Ready
sb.commands.run("echo ok") # first round trip through the router| Caso | create_sandbox p50 / p90 / máx | Servidor: claim até Ready |
|---|---|---|
| Pool de 2, 20 claims sequenciais | 0,28 / 0,61 / 0,63 s | p50 no máximo 100 ms, p90 233 ms, 19 de 20 abaixo de 250 ms |
| Pool de 10, 20 claims sequenciais | 0,28 / 0,32 / 0,34 s | p50 no máximo 100 ms, p90 220 ms, 20 de 20 abaixo de 250 ms |
| Sem pool (a frio), 10 sequenciais | 2,5 / 3,4 / 3,5 s | p50 2,4 s, p90 4,4 s |
| Burst de 10 em um pool de 10 | 0,83 / 1,2 / 2,1 s, tudo pronto em 5,1 s | p50 393 ms, p90 750 ms |
| Burst de 20 em um pool de 10 | 12 / 31 / 32 s | claims aquecidos: p50 1,2 s, p90 2,5 s; claims a frio: p50 27 s |
Os buckets do histograma vão de 100, 250, 500, 750 ms e depois 1 s em diante, então os percentis são interpolados dentro de um bucket. Em um pool tranquilo, o percentil 90 caiu no bucket de 100 a 250 ms, em 220 a 233 ms por interpolação. Isso fica perto dos 200 ms do Google, mas não abaixo, e sem uma borda de bucket entre 100 e 250 ms o histograma não consegue confirmar nem refutar a afirmação. Com dez claims chegando juntos, o percentil 90 foi para o bucket de 500 a 750 ms. A mediana do create_sandbox a partir do meu laptop, que inclui o round trip até o API server, foi de 0,28 segundo.
Três coisas que a tabela esconde:
- O primeiro comando é a parte lenta. O
commands.runlevou cerca de 2,4 segundos na primeira vez em todo sandbox e 125 ms depois disso (03b_first_command.py: 2,53, 0,12, 0,14 e 0,12 s em um sandbox, e 2,47 s para o primeiro comando em um segundo), então um warm claim mais um primeiro comando levou cerca de 2,7 segundos de ponta a ponta. Não investiguei o que o SDK faz no primeiro uso; seja o que for, o pool não esconde isso. - O excedente não falha, ele vai a frio. Quando os 20 claims superaram os 10 pods aquecidos, os outros 10 receberam sandboxes novos. Sequencialmente, um create a frio levou 2,5 segundos; no burst, com o pool também se reabastecendo, os dez claims excedentes levaram de 21 a 32 segundos em um node, enquanto os dez aquecidos levaram de 0,8 a 3,4 segundos. Não isolei por que os a frio ficaram tão mais lentos. A Classmethod mediu 25,6 segundos no total para 10 claims concorrentes contra 3 pods aquecidos, em outro hardware e em outra região, o que tem um formato parecido.
- Dimensione o pool para o burst. O caminho aquecido nunca foi o problema. O que eu observaria é a profundidade do pool contra os seus claims concorrentes.
Teste 4: Pod Snapshots
No cluster 1.37.1, o kubectl api-resources lista podsnapshot.gke.io/v1 para os quatro recursos de snapshot, e não a v1alpha1 que algumas páginas do Google mencionam. Rodei um Sandbox com um pequeno app Python que guarda quatro tipos de estado: um contador em memória, uma conexão TCP aberta com www.google.com, um arquivo em um emptyDir e um arquivo em um PVC. Depois de um baseline (suspender sem snapshot, retomar), rodei 5 ciclos: gravar marcadores nos dois volumes, tirar um snapshot com um PodSnapshotManualTrigger, gravar um segundo marcador, definir spec.operatingMode: Suspended, esperar o pod sumir, definir Running e cronometrar.
python 04_pod_snapshots.py 5            # with the PVC
python 04_pod_snapshots.py 3 --no-pvc # the same without it| Sem snapshot, PVC anexado | Snapshot, PVC anexado (5 ciclos) | Sem snapshot, sem PVC | Snapshot, sem PVC (3 ciclos) | |
|---|---|---|---|---|
| Snapshot Ready | 2,1 a 2,5 s | 2,1 a 2,4 s | ||
| Suspend até o pod sumir | 1,1 s | 1,1 a 1,9 s | 1,8 s | 0,8 a 1,8 s |
| Pod Running | 11,6 s | 12,2 a 12,5 s em quatro ciclos, 3,2 s em um | 1,5 s | 1,9 a 2,3 s |
| Primeira resposta do app | 12,0 s | 12,4 a 12,6 s e 3,4 s | 2,1 s | 2,1 a 2,7 s |
| Contador após a retomada | de volta a cerca de 0 | continua a partir do snapshot | de volta a cerca de 0 | continua a partir do snapshot |
O que sobreviveu, por ciclo:
| Estado | Resultado |
|---|---|
| Contador e o processo (mesmo horário de início) | Mantidos, do momento do snapshot, não do suspend |
Arquivo no emptyDir | Mantido como no snapshot: o que escrevi depois dele sumiu |
| Arquivo no PVC | Tudo mantido, inclusive a escrita depois do snapshot, porque o volume nunca fez parte dele |
| Conexão TCP | Derrubada no primeiro restore: BrokenPipeError (meu app não reconectou depois) |
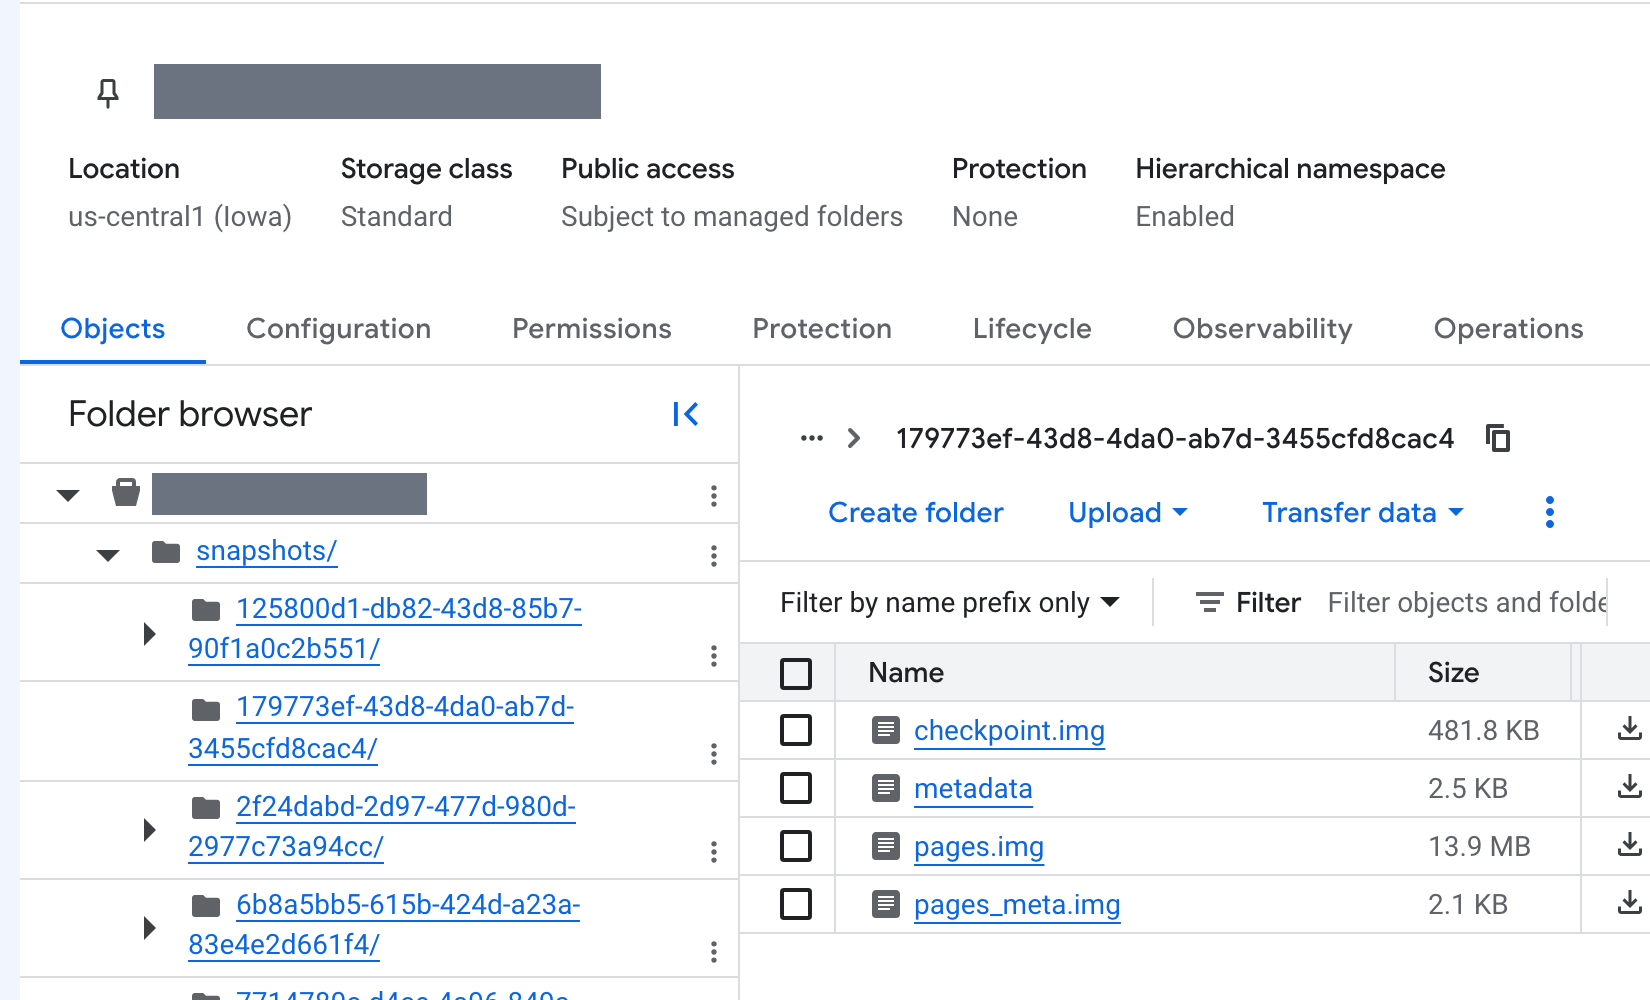
Cada snapshot eram quatro objetos na pasta snapshots/ do bucket, 14,4 MB no total para este pequeno processo Python (pages.img 13,9 MB, checkpoint.img cerca de 0,48 MB). Cada trigger criou um novo, e cinco snapshots do mesmo sandbox ainda estavam todos lá depois: nada os removeu até eu deletar os objetos PodSnapshot. O tempo de Running do pod foi o número interessante. As páginas do Google dizem que o restore leva “a few seconds”, e sem volume foi assim: de 2,1 a 2,7 segundos, o mesmo que um cold start deste app minúsculo. Com um PVC anexado, uma retomada levou 12 segundos em quatro dos cinco ciclos e 3,2 segundos em um, e a única retomada sem snapshot nessa execução levou 11,6 segundos. Na minha execução exploratória, a retomada sem snapshot com o PVC levou 5,1 segundos, então a variação é grande e não sei explicar o porquê. Não cronometrei o attach do volume isoladamente, mas tirar o volume tirou o atraso, então eu culparia o volume, e não o restore da memória. Um snapshot economiza mais em algo que demora muito para inicializar, o que um pequeno processo Python não faz.
Teste 5: Restore no tipo de máquina errado
A cobertura do InfoQ sobre Pod Snapshots avisa que, quando não existe um snapshot compatível, o Pod “starts normally” e “nothing errors”. A página de conceitos do Google diz que um restore de pod inteiro em um node com CPU features incompatíveis “fails”, e o how-to documenta um cold start quando o snapshot não está pronto. Eu queria ver qual dos dois acontece em um tipo de máquina diferente. Os próprios labels do snapshot dizem onde ele foi tirado: podsnapshot.gke.io/node-machine-family: c3, a versão do node e um hash do template do pod. Adicionei um segundo pool gVisor de n2-standard-2, tirei um snapshot no node C3, fiz cordon nesse node, suspendi e retomei:
python 05_mismatch.py before counter= 207 ... emptyDir: 3 lines, last pre3
snapshot 0a8927af-... ready after 2.3s
resumed counter= 5 ... emptyDir: none
landed on the N2 node: True
Normal Scheduled snap-sandbox Successfully assigned ... to gke-sbx-gke-mismatch-...
Normal Pulling snap-sandbox Pulling image "python:3.12-slim"
Normal Pulled snap-sandbox Successfully pulled image "python:3.12-slim" in 2.585s
Normal Started snap-sandbox Container startedO pod iniciou no node N2 5 segundos depois (incluindo um pull de imagem de 2,6 segundos), o contador estava em 5, o emptyDir estava vazio, e a condition Ready do Sandbox dizia que estava tudo bem. Nos restores anteriores, a lista de eventos tinha uma linha GKEPodSnapshotting ... Successfully restored the pod from PodSnapshot. Aqui ela estava ausente, e nada a substituiu: nenhum warning, nenhuma condition. Se você retoma sandboxes em um fluxo automatizado, verifique esse evento de restore ou o estado no app. Um cordon que move o pod para uma família de máquina diferente tem exatamente essa aparência; o InfoQ diz que o upgrade de um node pool pode fazer o mesmo, o que não testei.
Teste 6: gVisor e microVM em um só cluster
Adicionei um node pool microvm em um c3-standard-4: só via gcloud, com --sandbox=type=microvm --enable-nested-virtualization, e levou 1 minuto e 3 segundos (a virtualização aninhada funciona no C3). A policy recomendada só permite gVisor, então o script remove o binding dela enquanto roda e o restaura depois. A RuntimeClass microvm mapeia para kata-clh, traz seu próprio node selector e toleration, e declara um overhead de cpu: 250m, memory: 130Mi.
| gVisor | microVM | |
|---|---|---|
uname -r | 4.19.0-gvisor | 6.6.94-g7b99f7ef5fbf, com um boot log Linux de verdade no dmesg |
| Metadata server | token retornado | token retornado |
| Create a frio até Ready, 10 Sandboxes sequenciais (imagem no node) | mediana de 0,98 s (0,75 a 1,33) | mediana de 3,98 s (3,75 a 4,35) |
| Primeiro início do Sandbox da sonda | 0,85 s | 3,7 s (5,5 s em uma execução anterior, quando a imagem precisou ser baixada) |
| Memória que o Sandbox enxerga (limit 512 Mi) | 512 MiB | 2.467 MiB, que parece o tamanho da VM guest |
| ”Allocated resources” do node para 5 pods pedindo 100m / 128Mi | +500m CPU, +671 MB | +1.750m CPU, +1,35 GB |
| Pod Snapshot | funciona | recusado |
O custo extra da microVM é exatamente o overhead declarado: cinco pods pediram 500m e o node contou 1.750m. A microVM foi cerca de quatro vezes mais lenta para iniciar neste node. A linha do metadata é a surpresa: a página GKE Sandbox do Google diz que pods em nodes gVisor “can’t access cluster metadata on the node OS level”, que essa limitação “doesn’t apply to the microVM sandbox type”, e manda você adicionar uma NetworkPolicy para microVMs. Neste cluster, com Workload Identity ativado, o Sandbox gVisor que criei diretamente também o alcançou (Teste 2), então uma NetworkPolicy é o controle nos dois casos, e não o runtime.
Pedir um snapshot do Sandbox microVM foi o único lugar em que a plataforma disse não, de forma clara. A condition do trigger: cannot trigger a manual checkpoint because the target pod is not using the gvisor runtime class.
Teste 7: O que um operador consegue ver
Uma issue no projeto gVisor relatou que o cAdvisor mostra apenas o escopo do pause container para pods runtimeClassName: gvisor em cgroup v2 com systemd-cgroup ativado. Ela foi fechada em 5 de novembro de 2026, corrigida em uma mudança posterior. Então rodei o mesmo workload, um busy loop limitado a 500m com 100 MiB de memória e uma linha de log por segundo, como um pod runc e como um Sandbox gVisor por seis minutos e comparei o que o GKE mostra:
| Ferramenta | Pod runc | Sandbox gVisor |
|---|---|---|
kubectl top pod --containers | 500m, 104 Mi | 500m, 111 Mi |
/stats/summary do kubelet | CPU e memória por container | CPU e memória por container |
Cloud Monitoring container/cpu/core_usage_time, memory/used_bytes | séries para o container burn | séries para o container burn |
| Linhas de stdout no Cloud Logging | sim | sim |
Nada estava faltando na 1.37.1. A CPU e a memória do container apareceram em todas as ferramentas, com mais memória reportada no gVisor (117 MB contra 109 MB para o container no Cloud Monitoring, e 141 MB contra 110 MB para o pod no kubelet; os dois pods rodaram em tipos de máquina diferentes, então eu não leria muito nisso). Não verifiquei se o meu cluster usa systemd-cgroup, então isso mostra apenas que as métricas funcionaram na 1.37.1.
Resumo dos resultados
| Afirmação ou pergunta | Resultado |
|---|---|
| Instalação | --enable-agent-sandbox funciona (gerenciado, controller escondido, sem linha no console); kubectl apply da v1.0.11 pronto em 8 a 14 s; o template do guia de snapshots falha na policy recomendada sem avisar |
| Postura de rede padrão | Sandbox por template: sem metadata, sem cluster, internet pública; Sandbox criado diretamente: nenhuma policy |
| Claim em warm pool | p50 de 0,28 s no cliente, p90 do servidor de 220 a 233 ms (19 e 20 de 20 abaixo de 250 ms); um primeiro comando acrescenta 2,4 s uma vez |
| Além do pool | Cai para um create a frio: 2,5 s sozinho, 21 a 32 s em um burst de 20 em um node |
| Restore de Pod Snapshot | 2,1 a 2,7 s até a primeira resposta sem volume; 3 a 12 s com um PVC, com snapshot ou não; conexões derrubadas; emptyDir como no snapshot |
| Tipo de máquina errado | Cold start silencioso, sem erro, sem evento |
| microVM | Kernel real, início de 4 s, overhead de 250m e 130 MiB, sem snapshots, mesma exposição do metadata |
| Visibilidade para o operador | kubectl top, kubelet, Monitoring e Logging mostram os sandboxes gVisor |
Monitoramento
Os sandboxes são pods comuns, então as visões Workloads e Observability do console do GKE, as métricas de container do Cloud Monitoring e o Cloud Logging funcionam como para qualquer outro pod (Teste 7). O controller exporta métricas Prometheus na porta 8080, incluindo agent_sandboxes e o histograma de latência de claim que usei; a página do Google mostra um recurso PodMonitoring para coletá-las no Cloud Monitoring. Com o add-on gerenciado não há pod de controller para fazer scrape, então não sei para onde vão as métricas dele. O evento de restore GKEPodSnapshotting está nos eventos do namespace e em nenhum outro lugar em que olhei.
Preços
O Agent Sandbox e os Pod Snapshots não acrescentam taxa: você paga a taxa de gerenciamento do cluster ($0,10 por hora no Standard, que o crédito mensal de $74,40 cobre para um cluster zonal), os nodes, seus boot disks e o Cloud Storage que os snapshots usam. Meu cluster rodou a cerca de $0,40 por hora ao preço de tabela: a taxa do cluster, um node de sistema e2-standard-2 e um node gVisor c3-standard-4 ($0,37 juntos) mais dois boot disks de 100 GB. O pool microVM temporário (c3-standard-4) e o pool N2 (n2-standard-2) acrescentaram cerca de $0,20 e $0,10 por hora enquanto existiram. Os snapshots tinham 14 MB cada, bem dentro do free tier do Cloud Storage. A parte inteira, exploração e gravação juntas, usou cerca de duas horas de cluster e custou cerca de $0,90 ao preço de tabela, com a taxa do cluster contada por inteiro.
A ordem da limpeza importa: delete os Sandboxes, claims e recursos de snapshot, depois os PVCs antes do cluster (caso contrário os discos deles sobrevivem a ele), os pools temporários, o cluster e, por último, o bucket, a custom role e os bindings. O teardown.sh do repositório faz isso e depois lista clusters, instâncias, discos, buckets e a role.
Veredito
O que funciona
O caminho aquecido faz o que a página diz: um claim contra um pool pronto voltou em cerca de um quarto de segundo a partir do meu laptop, e os números do próprio controller estão na faixa dos 200 ms do Google. O isolamento é real: um kernel gVisor por padrão, um kernel Linux de verdade se você pagar pela microVM, e as ferramentas comuns do Kubernetes (kubectl top, Monitoring, Logging, admission policies) funcionam nos dois. Os Pod Snapshots funcionam para o que dizem: a memória do processo voltou no momento do snapshot, e sem volume anexado um restore levou cerca de 2 segundos. A admission policy rejeitou os dois Sandboxes ruins com uma mensagem clara, e a plataforma recusou um snapshot de microVM com uma mensagem explícita.
O que não funciona, ainda
As arestas afiadas são silenciosas. Um Sandbox criado diretamente não tem network policy, então alcança o metadata server e o resto do cluster, e os passos de instalação não dizem isso (a página de conceitos menciona uma vez). O template do guia de snapshots falha na policy do guia de instalação, e a única evidência está no log do controller. Um restore no tipo de máquina errado começa a frio sem evento, e um PVC anexado ao sandbox deixou as retomadas lentas e irregulares, de 3 a 12 segundos, com snapshot ou não. O comportamento de excedente de um pool, de 21 a 32 segundos no meu burst, não está nas documentações que li. A documentação fixa a v1.0.6 enquanto a v1.0.11 já saiu, e o add-on gerenciado fica escondido do console e deixa suas CRDs e policies para trás quando você o desativa. Não testado: o número de 300 por segundo, qualquer coisa além de um node por pool, Autopilot, GPUs, mais de um namespace e restores através de upgrades de node.
Quem deve usar
Se cada agente precisa do seu próprio pod, de um PodSpec completo ou de uma GPU, e você está confortável em ser dono de um cluster Kubernetes, o Agent Sandbox oferece uma boa história de warm start e um limite de isolamento crível. Crie sandboxes a partir de templates, para que a network policy se aplique, ou escreva você mesmo a policy para os diretos. Dimensione os warm pools para o seu pico de claims, deixe os volumes de lado quando quiser restores rápidos, e verifique o evento de restore e o estado antes de confiar em uma retomada. Se você prefere não operar um cluster, as partes anteriores cobrem as opções gerenciadas; e para a história de densidade e suspend-resume em escala, a parte 6 olha o Agent Substrate no GKE.