Agent Substrate no GKE: Hands-On com Suspend e Resume, Densidade e Snapshots no Cloud Storage
Por Fabio Douek
Conduzido por humano, com apoio de IA. Pesquisa e implementação feitas com ferramentas de IA, conduzidas, testadas e editadas por mim. Como os posts são classificados
Ir para seção
- Visão geral
- Configuração
- Passo 1: Projeto, ferramentas e versões
- Passo 2: O cluster
- Passo 3: O que o instalador faz, rodado à mão
- Passo 4: Prontidão e o smoke test
- Testes
- Teste 1: Instalação e a demo nativa Counter
- Teste 2: O que um suspend preserva, AX contra nativo
- Teste 3: Tempos do ciclo de vida
- Teste 4: Wake on request pelo router
- Teste 5: Snapshots no Cloud Storage
- Teste 6: Densidade
- Teste 7: Latência sob concorrência e carga no control plane
- Teste 8: Tempo de wake por limite de CPU, e bursts
- Teste 9: Noisy neighbors
- Teste 10: Tempestade de snapshots, o caminho de rede e modos de falha
- Resumo dos resultados
- Monitoramento
- Preços
- Veredito
- O que funciona
- O que ainda não funciona
- Quem deve usar
Explica (TLDR) como se eu fosse...
Imagina uma caixa de brinquedos com um monte de quartinhos minúsculos, e cada quartinho tem um robô dormindo. Quando uma criança bate na porta, o robô acorda num piscar de olhos e continua de onde parou, e quando ninguém está batendo ele volta a dormir e ocupa quase nenhum espaço.
Eu testei numa caixa de verdade. Acordar levou cerca de um décimo de segundo quando o robô podia usar boa parte da caixa, e muito mais tempo quando podia usar quase nada. E um tipo de robô lembra o que estava fazendo enquanto dormia, e o outro só lembra do dever de casa.
O Agent Substrate é uma infraestrutura open source que suspende a sandbox de um agente para o armazenamento e a retoma sob demanda. No Google Kubernetes Engine ele está em disponibilidade geral desde 9 de novembro de 2026, e eu testei a v1.0.0 em um cluster pequeno, repetindo medições que eu tinha feito no Amazon EKS.
Os pontos materiais: o que é mantido no suspend depende de uma configuração, não da plataforma; os snapshots são gravados no seu próprio bucket do Cloud Storage, sob uma service account dedicada; e o upload do snapshot não atravessou o NAT gateway. Vários defaults, como quem pode chamar o router, exigem uma decisão consciente.
O quadro apresentado são agentes ociosos que custam uma máquina inteira cada um. O tratamento é suspendê-los em disco e acordá-los quando chega uma requisição. Nos meus testes funcionou: um wake levou cerca de 120 ms com CPU suficiente, e 156 sandboxes ociosas couberam em dois nodes de 4 vCPU.
Efeitos colaterais: um wake com um limite de CPU minúsculo levou mais de um segundo, um burst de 30 wakes levou 1,2 segundo na mediana, e uma conexão que estava aberta na hora do suspend não sobreviveu. A memória só sobrevive se o snapshot for configurado para guardá-la.
Há um alívio real em poder colocar um agente para dormir sem perder o lugar onde ele estava. Boa parte do pavor de rodar muitos agentes vem de pagar para cada um deles ficar acordado, e aqui os que dormem custam quase nada.
O atrito aparece nos detalhes que só se aprende testando: o dorminhoco que esqueceu o trabalho porque ninguém pediu para ele lembrar, a conexão aberta que não voltou, e o wake que levou um segundo porque o limite estava baixo demais. Nada disso é difícil depois que você sabe.
Pense numa banda de sessão em que cada músico pode sair do palco no meio da música e voltar exatamente no tempo certo. Quando a sala está quieta, o palco fica quase vazio, e uma requisição leva o músico certo de volta.
O andamento depende do amplificador do músico: com bastante potência a entrada leva cerca de um décimo de segundo, e com quase nenhuma ela se arrasta por mais de um segundo. Mais um detalhe: só voltam no meio da música os músicos a quem se pediu que lembrassem dela; os outros recomeçam do início.
A proposta são agentes ociosos que custam quase nada e respondem em cerca de um décimo de segundo quando chamados. Em um cluster GKE de dois nodes eu medi esse wake, 156 sandboxes ociosas em 8 vCPUs e snapshots salvos no Cloud Storage sem passar pelo NAT gateway.
A nota de rodapé honesta: a velocidade depende do limite de CPU que você dá a cada sandbox, e o que sobrevive a um suspend depende da configuração do snapshot. Os dois são defaults que vale a pena definir de propósito, e os dois estão nos números.
 Veja o código-fonte aqui: gcp-sandboxes/agent-substrate-gke
Visão geral
O Agent Substrate é uma camada open source que roda agentes como actors: uma sandbox (gVisor por padrão, uma microVM Cloud Hypervisor como opção) que pode ser suspensa para um snapshot e retomada depois em um worker pod, ou acordada por uma requisição através de um router. O Google descreve um modelo de zero ocioso e cita “sub-500ms resume operations at over 500 suspend/resume activations per second” e “over 1,000 dormant agents per host” (post de lançamento). As release notes do GKE de 9 de novembro de 2026 o declaram em disponibilidade geral no GKE Standard 1.37 ou posterior, e o instalador do GKE do Google é a forma documentada de instalá-lo.
Este post, parte 6 de 6 da série Google Cloud Sandboxes, testa essas afirmações. A Parte 1 mapeia as opções do Google Cloud para rodar código em que você não confia. A Parte 2 cobriu o Managed Agents, a parte 3 as sandboxes do Agent Platform, a parte 4 as sandboxes do Cloud Run e a parte 5 o GKE Agent Sandbox. Esta parte é uma repetição de propósito. Duas semanas antes, eu rodei o Google AX, um runtime de agentes construído sobre o Substrate, no Amazon EKS (instalação, ciclo de vida, estresse). Aqui eu rodei o mesmo harness, portado, em dois nodes c3-standard-4 (4 vCPU, 16 GiB, Sapphire Rapids, o mesmo formato dos dois m7i.xlarge no EKS), e mostro os números de EKS e GKE lado a lado.
Eu rodei em 14 de novembro de 2026 a partir de um laptop, em um cluster zonal GKE Standard em us-central1-a (canal Rapid, 1.37.1-gke.2097000), com o Substrate v1.0.0 (instalador substrate-gke v1.0.0-gke.0) e o AX no commit eac8313, que fixa o Substrate v1.0.0. As execuções no EKS usaram o Substrate v0.6.0, então uma diferença pode vir da plataforma ou da versão, e eu sinalizo onde isso importa. Sete resultados se destacaram:
- A instalação é um passo de cluster mais dois comandos, e nada pediu uma allowlist. Os passos cronometrados somam cerca de 20 minutos de um projeto vazio até uma task funcionando (7 para o cluster, 10 para a atualização do control plane pelo instalador, cerca de 3 para todo o resto); minha primeira passada, com erros, levou cerca de 36. Dois defaults exigiram uma escolha consciente: quem pode chamar o router e a cota de disco do projeto.
- O que um suspend preserva é uma configuração, e eu consegui ver as duas configurações. O AX pede um snapshot só de volumes: apenas
/workspacevoltou, como no EKS. Um actor nativo do Substrate com memory fidelity manteve seu processo, seu/tmpe seu uptime. Uma conexão aberta não sobreviveu em nenhum dos dois. - Um wake pelo router levou cerca de 120 ms com CPU sobrando. 119 e 120 ms para uma task do AX, e de 107 a 119 ms para um actor nativo depois de um primeiro wake de 314 ms, contra o “sub-500ms” do Google. Com um limite de CPU de 50m levou 1,1 segundo, e um burst de 30 ao mesmo tempo levou 1,2 segundo na mediana.
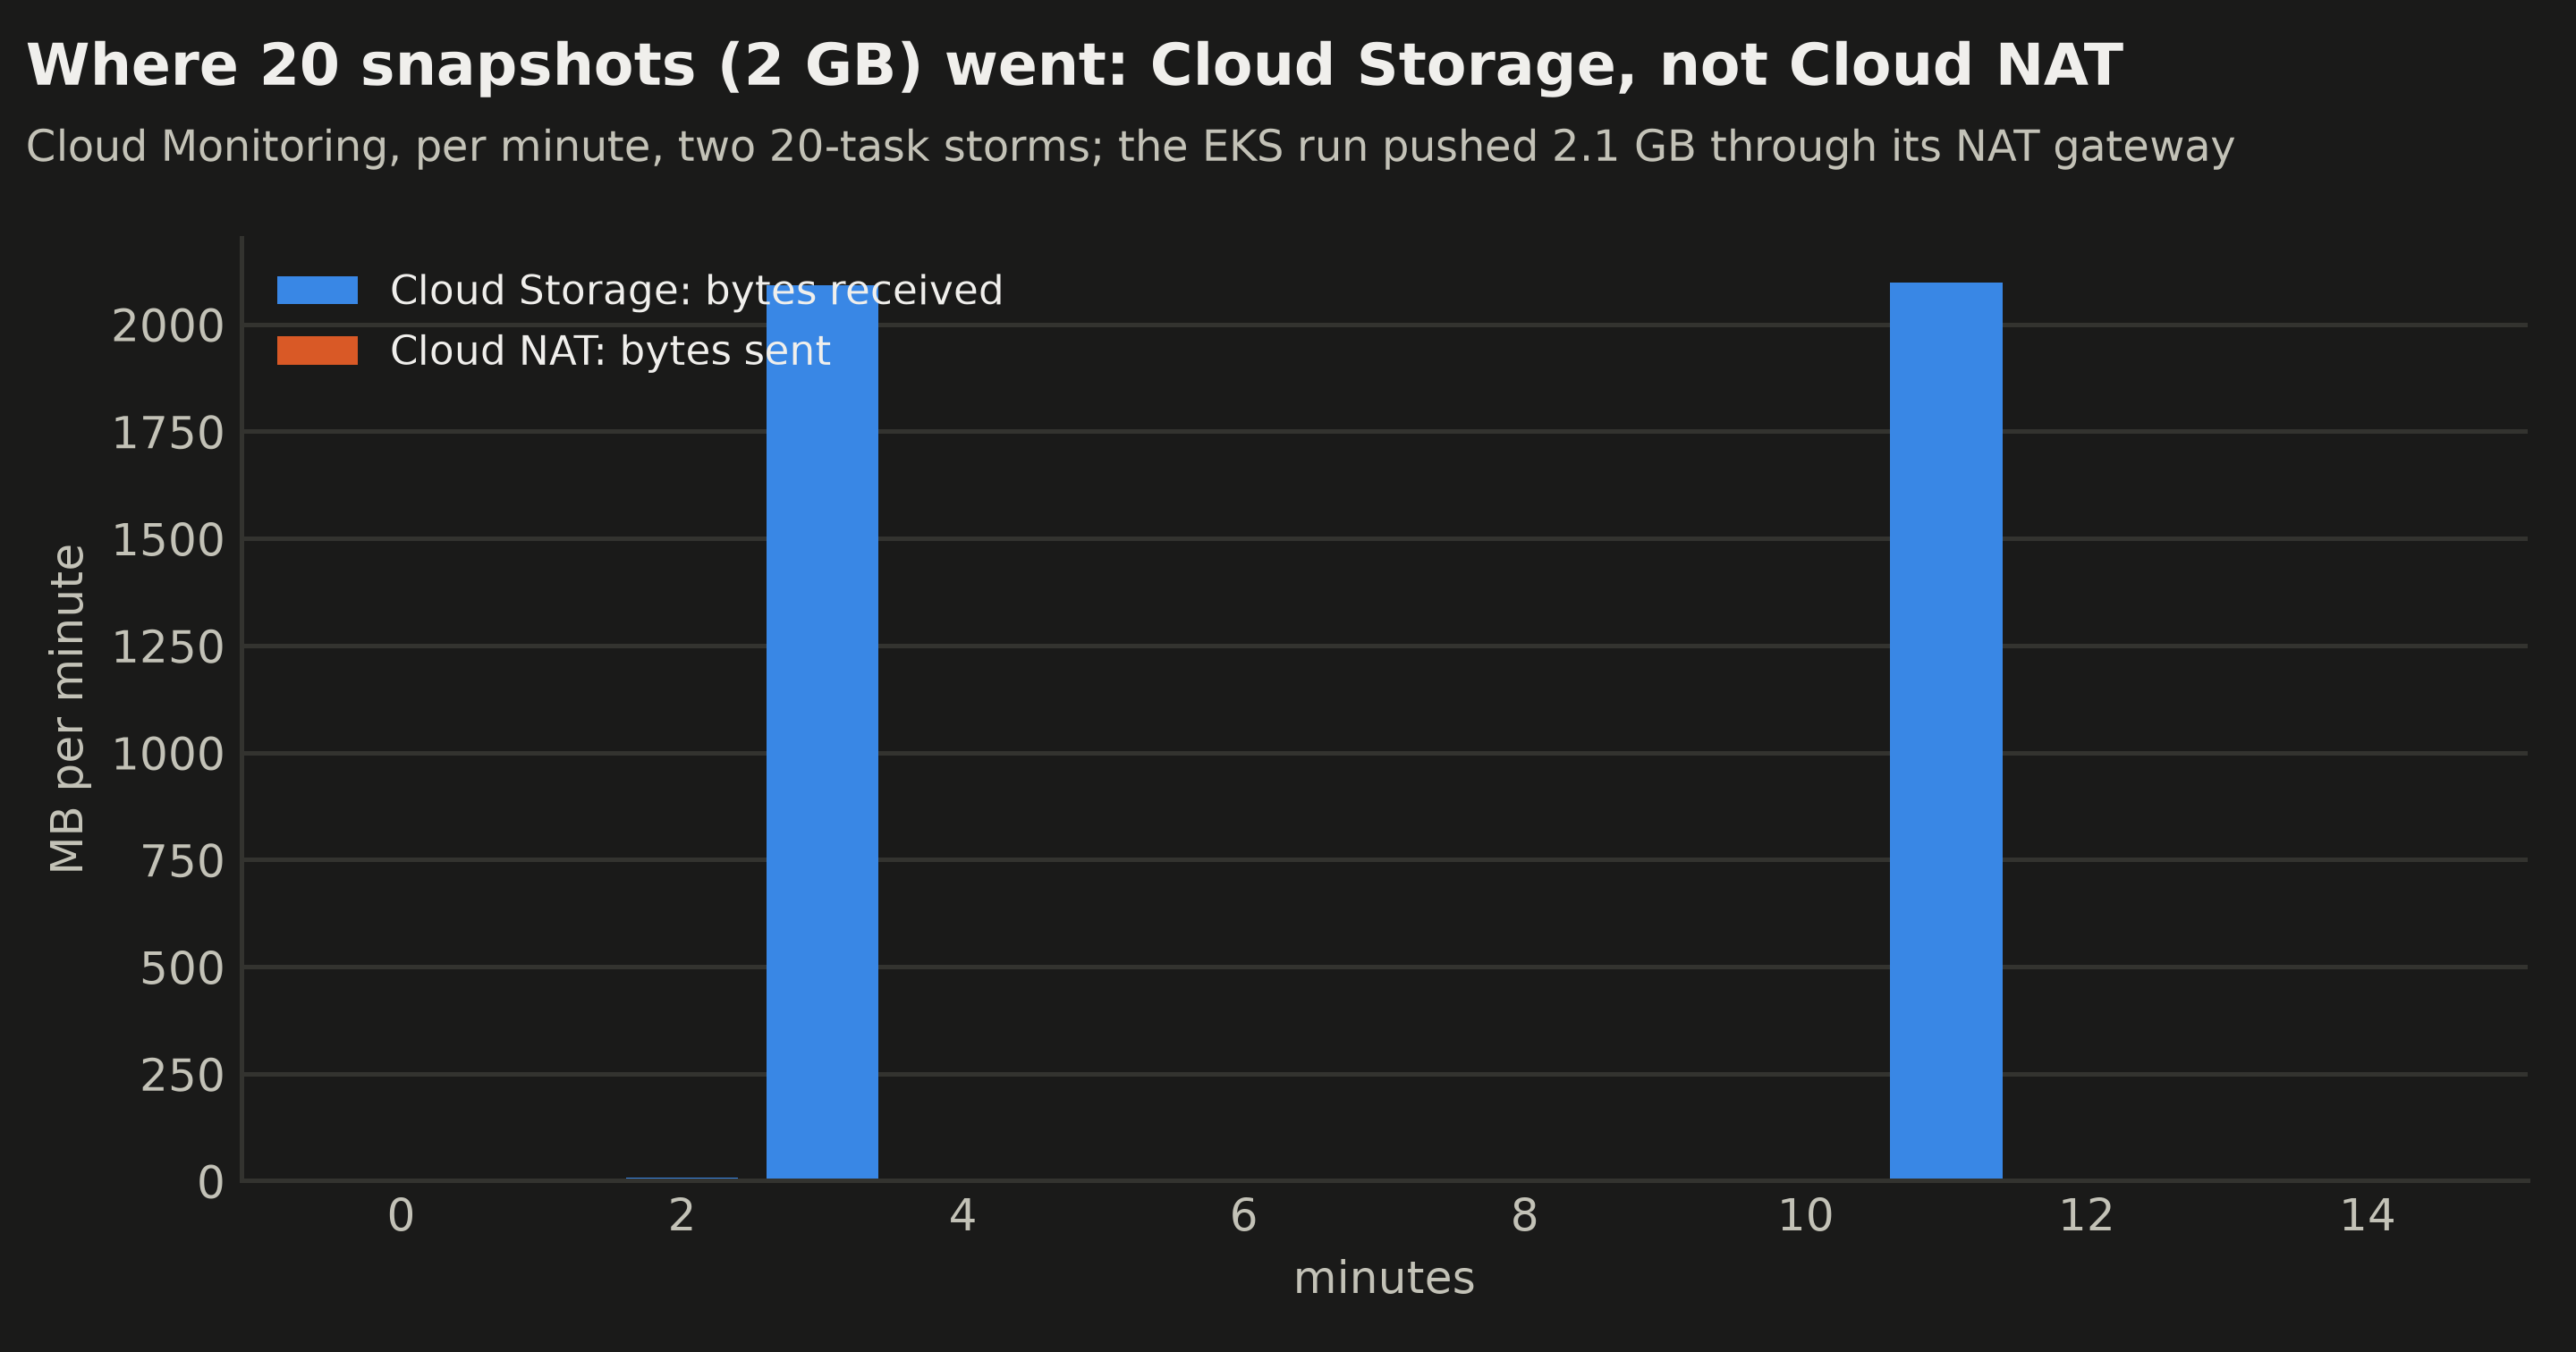
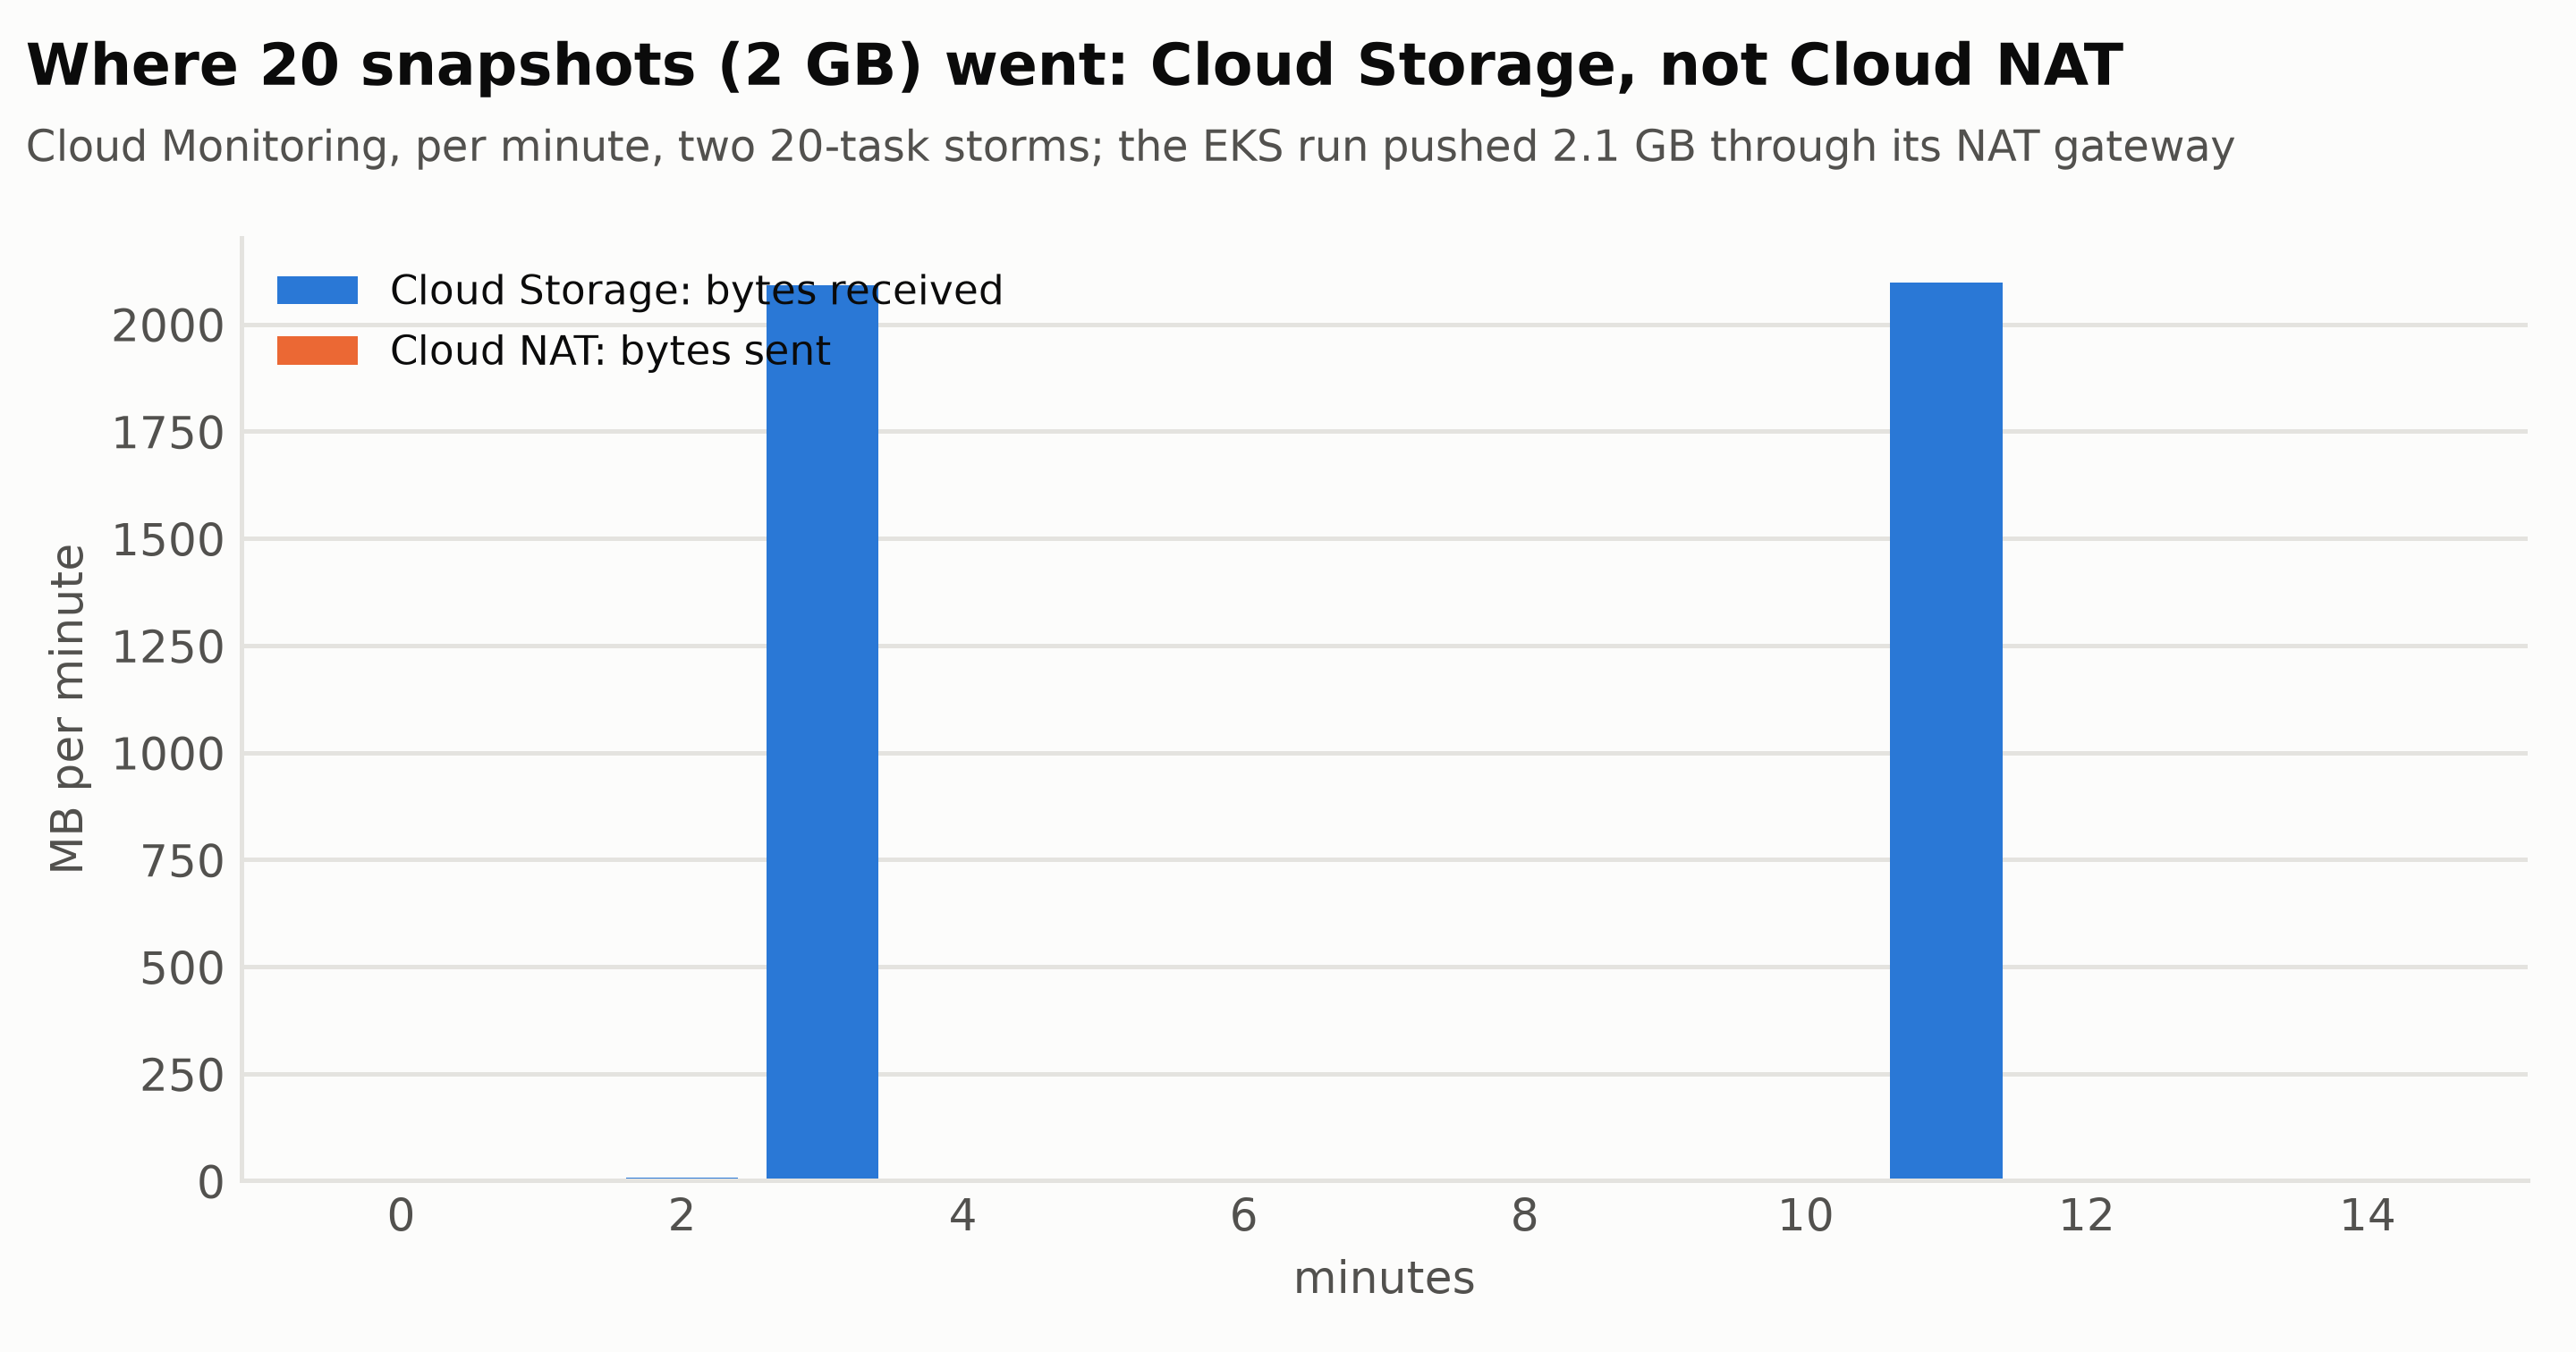
- Os snapshots chegaram ao Cloud Storage 324 segundos depois de um suspend, e nunca passaram pelo Cloud NAT. Vinte snapshots de 100 MB colocaram cerca de 2,1 GB no bucket e 0 bytes pelo NAT gateway. A execução no EKS empurrou os mesmos 2,1 GB pelo seu NAT gateway.
- 156 sandboxes ociosas couberam em dois nodes de 4 vCPU, e então o Substrate recusou a próxima. O EKS parou em 151. As reservas de CPU definiram o teto, não a memória, e por isso nenhuma das execuções chegou perto dos 800 ou 1.000 por host do Google.
- A maioria dos números bateu com o EKS, alguns não. Create, suspend e resume foram de 20 a 30% mais rápidos que no EKS e o primeiro resume ficou dentro de 6%, creates e deletes rodaram mais rápido, resumes sob concorrência foram mais lentos com 40 em andamento, e uma mudança no WorkerPool levou 14 segundos para ser aplicada contra 3 no EKS.
- O caminho do cliente decide o que você mede. A partir do meu laptop, um
ax get taskssem efeito levou 0,5 segundo. Pelo túnel do próprio CLI, as chamadas tiveram picos de 1 a 3 segundos, e os números de suspend e resume estavam errados por essa margem até eu usar um port-forward estável.
Configuração
Passo 1: Projeto, ferramentas e versões
Eu usei um projeto novo do Google Cloud com billing e um alerta de orçamento, e uma máquina local: o instalador falha no Cloud Shell por causa do disco de 5 GB. As ferramentas que registrei:
Google Cloud SDK 593.0.0 (beta 2026.11.06)   kubectl v1.37.2   go1.26.1 (GOTOOLCHAIN=auto fetches Substrate's newer one)
Docker 29.2.1 with Buildx                     GKE 1.37.1-gke.2097000, Container-Optimized OS, kernel 6.18.53+, containerd 2.4.1
substrate-gke v1.0.0-gke.0                    Substrate v1.0.0 (b34fbee)       AX main eac8313 (2026-11-13), go.ate.dev/substrate v1.0.0
O guia de instalação do próprio AX ainda lista o Substrate v0.6.0 como sua base de desenvolvimento, embora seu go.mod já tenha passado para a v1.0.0, então esta combinação é uma que o guia não certifica. Funcionou.
Passo 2: O cluster
O console consegue expressar este cluster: um cluster zonal Standard em us-central1-a, canal Rapid, 1.37, com Dataplane V2, Workload Identity e nodes privados, e um node pool de dois c3-standard-4 com boot disks de 100 GB e sem GKE Sandbox no pool (o taint dele mantém os worker pods do Substrate de fora). Eu o criei pelo CLI para que possa ser repetido, e usei o console para olhá-lo depois. Nodes privados precisam do Cloud NAT para qualquer coisa que não seja do Google, e do Private Google Access na subnet para que as APIs do Google não o usem. O script do repositório faz tudo isso:
gcloud compute networks subnets update default --region us-central1 --enable-private-ip-google-access
gcloud compute routers create ate-router --network default --region us-central1
gcloud compute routers nats create ate-nat --router ate-router --region us-central1 \
  --auto-allocate-nat-external-ips --nat-all-subnet-ip-ranges --no-enable-logging
gcloud beta container clusters create ate-sbx --zone us-central1-a --release-channel rapid --cluster-version 1.37.1-gke.2097000 \
  --num-nodes 2 --machine-type c3-standard-4 --disk-type hyperdisk-balanced --disk-size 100 \
  --enable-dataplane-v2 --workload-pool=<project>.svc.id.goog --enable-private-nodes --enable-ip-alias \
  --no-enable-autoupgrade --no-enable-autorepair \
  --enable-kubernetes-unstable-apis=certificates.k8s.io/v1beta1/podcertificaterequests,certificates.k8s.io/v1beta1/clustertrustbundles
O cluster levou 6 minutos e 54 segundos, contra 14 minutos e 9 segundos do control plane do EKS. Duas coisas que tive de mudar em relação à minha primeira tentativa, e o formulário do console não avisa sobre nenhuma delas:
- Cota de disco. Meu projeto permitia 500 GB de
pd-balancedpor região (conta contra a cota de SSD; o Google diz que as cotas variam por projeto), e o PostgreSQL do Substrate pede um volume de 500 GiB exatamente desse tipo. Com dois boot diskspd-balancedo volume não caberia, então troquei os boot disks parahyperdisk-balanced, e coloquei o PostgreSQL de 10 GiB do AX também em uma StorageClasshyperdisk-balanced. Um pedido de cota precisa de um e-mail de contato, então contornei. - O endereço do control plane. Meu primeiro cluster tinha authorized networks ligado e o endpoint DNS desligado para tráfego externo, então o
kubectldava timeout. Os clusters do próprio instalador usam só o endpoint DNS; acabei com o endpoint público limitado ao endereço do meu laptop, o que também deu o caminho de cliente mais estável (Teste 3).
Passo 3: O que o instalador faz, rodado à mão
O instalador é um programa de terminal interativo, e precisa de um terminal. Eu rodei o que ele roda, passo a passo, a partir do mesmo repositório na mesma tag. O bootstrap levou 10 minutos e 10 segundos, em sua maior parte uma atualização do control plane que liga as APIs beta de certificado, e ele cria o bucket de snapshots e um segundo bucket -assets, a service account ate-snapshot-transfer, um repositório do Artifact Registry, os IAM bindings e três dashboards do Monitoring:
go -C tools/setup-gcp run . bootstrap                                  # 610 s
go run ./cmd/ate-setup deploy ate-system --image-repo ghcr.io/agent-substrate/substrate --image-tag v1.0.0   # 84 s, 63 s on the rerun
O ate-setup não imprimiu nenhuma mensagem de allowlist ou de elegibilidade em momento algum. Todo o ate-system ficou pronto, incluindo as duas réplicas do ate-api-server, o router, o egress gateway e o atelet em cada node. Dois detalhes que as páginas de instalação não deixam óbvios:
- A allowlist do router decide quem pode chamar um actor. O wizard pergunta os SPIFFE IDs dos seus clientes e o README do instalador diz que o
kubectl ate“needs no entry”, mas okubectl ate proxy actor, que passa pelo router, apresentou a identidadens/ate-system/sa/atenet-cliente recebeuremote error: tls: unknown certificateaté eu adicioná-la. O servidor do AX precisa dens/ax-system/sa/ax-serverali, e deATE_API_AUTHZ_BOOTSTRAP_OWNERSpara a própria API. - O AX não define
workerSelector. Qualquer WorkerPool do cluster hospeda tasks do AX. Quando deixei instalado o pool de demonstração Counter do Substrate (três workers), as tasks do AX caíram nele, e os números de densidade abaixo saltaram de 6 para 9 tasks no tamanho padrão. Eu apaguei o pool de demonstração em todas as execuções medidas.
Depois o WorkerPool (dois workers gVisor, um por node, o mesmo manifesto do EKS mas com ate.dev/v1, já que v1alpha1 não é mais servido), e o servidor e o PostgreSQL do AX:
./03_workerpool.sh     # 7 s to 2 of 2 ready (13 s on the rerun)
./04_ax.sh             # make images 42 s (13 s warm), ax-server about 30 s
Passo 4: Prontidão e o smoke test
O post de instalação no EKS verificava três coisas antes de instalar, e as três passam no GKE: certificates.k8s.io serve v1 (e v1beta1) com ClusterTrustBundle e PodCertificateRequest; um dry run server-side de um pod com um volume podCertificate projetado é aceito; e o kernel dos nodes, 6.18.53+, está acima de 6.8. Elas levam 3 segundos. Uma primeira task a partir de um cluster vazio, pelo túnel do próprio CLI do AX, levou 3,9 s para criar, 5,6 s para resume, 12,2 s para o primeiro ssh e 1,2 s para deletar, e reportou 4.19.0-gvisor em um node 6.18, o mesmo que no EKS. Esses tempos incluem um image pull a frio e a montagem do túnel; o Teste 3 tem os tempos estáveis.
Testes
O harness é o dos posts do EKS, portado: chamadas de ax e kubectl ate cronometradas com time.perf_counter(), percentis por nearest-rank, um sampler do kubelet, cada teste em um cluster de resto vazio. Os números do EKS abaixo vêm das minhas execuções anteriores, uma vez cada, como estas. Uma única execução cada significa que diferenças pequenas são ruído.
Teste 1: Instalação e a demo nativa Counter
Os tempos estão acima; a novidade no GKE é a demo que a série do EKS nunca rodou. O ate-setup deploy demo counter constrói a imagem da demo com ko, envia para o Artifact Registry e cria um WorkerPool e um template de actor cujo snapshot fidelity é SNAPSHOT_FIDELITY_MEMORY. Levou cerca de 70 segundos. Um actor desse template conta três coisas a cada requisição: na memória do processo, em um arquivo em um volume durável e no filesystem root. Pelo kubectl ate proxy actor, depois de um suspend, a requisição seguinte retornou preserved memory count: 3 | preserved file counter: 3 | preserved rootfs counter: 3: o contador em memória continuou. Cinco ciclos de suspend e resume pelo kubectl ate levaram 1,41 s e 1,34 s na mediana a partir do meu laptop (Teste 2), mas um kubectl ate get atespace sem efeito leva 1,24 s, então isso é quase tudo round trip. O Teste 4 tem o número dentro do cluster.
Teste 2: O que um suspend preserva, AX contra nativo
O post do EKS disse que o AX pede ao Substrate um snapshot só de volumes e que “Substrate can snapshot memory; AX doesn’t ask it to”. Eu testei isso no GKE. As mesmas sondas rodaram em uma task do AX e em um actor nativo feito a partir de uma imagem task-runner do AX com memory fidelity. Cada uma escreve /tmp/marker, um arquivo de 50 MB em /workspace, inicia um sleep 3000 em background e mantém aberta uma conexão HTTP keep-alive simples com www.google.com pelo egress gateway, e então passa por cinco ciclos de suspend e resume.
| Depois de um suspend e resume | Task do AX (volumes) | Actor nativo (memória) |
|---|---|---|
Arquivo em /workspace | mantido, checksum intacto | mantido |
/tmp/marker | sumiu, em todo ciclo | mantido |
sleep 3000 em background | sumiu | ainda rodando |
| Processo e uptime | reiniciado: up 8 s, uma linha de boot por resume (6 para 1 create e 5 resumes) | continuou: o uptime seguiu contando, uma linha de start no total |
Conexão aberta com www.google.com | sumiu (o processo dela sumiu, o log para de crescer) | quebrada: a escrita seguinte falhou |
| Suspend e resume a partir do laptop | 583 / 631 ms de mediana (n=5) | 1.41 / 1.34 s (n=5, piso de 1.24 s sem efeito) |
Então a memory fidelity é a diferença, e ela é uma configuração do template, não uma propriedade da plataforma. Nenhum dos caminhos preserva uma conexão aberta: o processo do actor nativo é o mesmo, mas a escrita seguinte no seu socket falhou, o que bate com a documentação do Google, de que conexões abertas “aren’t preserved when an agent suspends”. Um agente que mantém uma conexão (uma sessão de banco de dados, uma chamada de streaming) precisa reconectar depois de um resume.
Teste 3: Tempos do ciclo de vida
Os números do EKS entre colchetes. Cinco tasks cada, por um port-forward estável (veja o próximo parágrafo).
| Operação | Mediana GKE (mín. a máx.) | EKS |
|---|---|---|
| Create | 526 ms (503 a 569) | 684 ms |
| Primeiro resume | 2,617 ms (2,614 a 2,624) | 2,780 ms |
| Suspend | 595 ms (583 a 604) | 820 ms |
| Resume | 634 ms (622 a 674) | 817 ms |
Uma task padrão tem 2 CPUs e 524,288 kB de memória vistos de dentro (nproc 2, MemTotal), e com limites de 2 CPU e 2Gi são 2,097,152 kB, ambos idênticos ao EKS. O kernel é 4.19.0-gvisor.
A primeira versão desta tabela estava errada. Pelo túnel do próprio CLI do AX (um kubectl port-forward que ele inicia e reutiliza), cerca de uma chamada em dez levava 3 segundos a mais que as outras, e uma chamada ocasional falhava com error reading server preface. Um suspend de 3,9 s ao lado de um resume de 1,0 s no mesmo ciclo era o túnel, não o Substrate. Foi pior pelo endpoint DNS. Acabei com um port-forward supervisionado e AX_SERVER=localhost:18080, depois do qual um ax get tasks sem efeito levou cerca de 0,5 s sem picos (mediana de 490 ms em 10 chamadas). Tudo daqui em diante usa isso; esse round trip, do meu laptop até us-central1, está em todo número do lado do cliente.
Teste 4: Wake on request pelo router
A documentação de rede do AX diz que o router “resumes it first if it was suspended”. Um pod rodando como a service account ax-server, com um pod certificate, enviou curl -H 'ate-target-actor: <atespace>/<name>' https://atenet-router.ate-system.svc/readyz para uma task suspensa, cronometrado pelo curl de dentro do cluster:
- Task do AX: HTTP 200 em 119,2 ms e 119,9 ms (EKS 100,9 e 103,5 ms; uma execução anterior minha mediu cerca de 140 ms), e a task fica
Runningdepois. - Actor nativo com memory fidelity: HTTP 200 em 314,1 ms no primeiro wake e 119,4 e 107,2 ms nos dois seguintes. Esse é o resume “sub-500ms” que o Google descreve, para o caminho que ele descreve, com 1 CPU.
- Negativos: sem o header
ate-target-actordá 404 em 7,8 ms, e sem certificado de cliente o curl sai com 55. - O Service do router expõe apenas 443 e 8444. A página de rede do AX mostra um caminho na porta 80; o GKE, como o EKS, não tem nenhum.
Teste 5: Snapshots no Cloud Storage
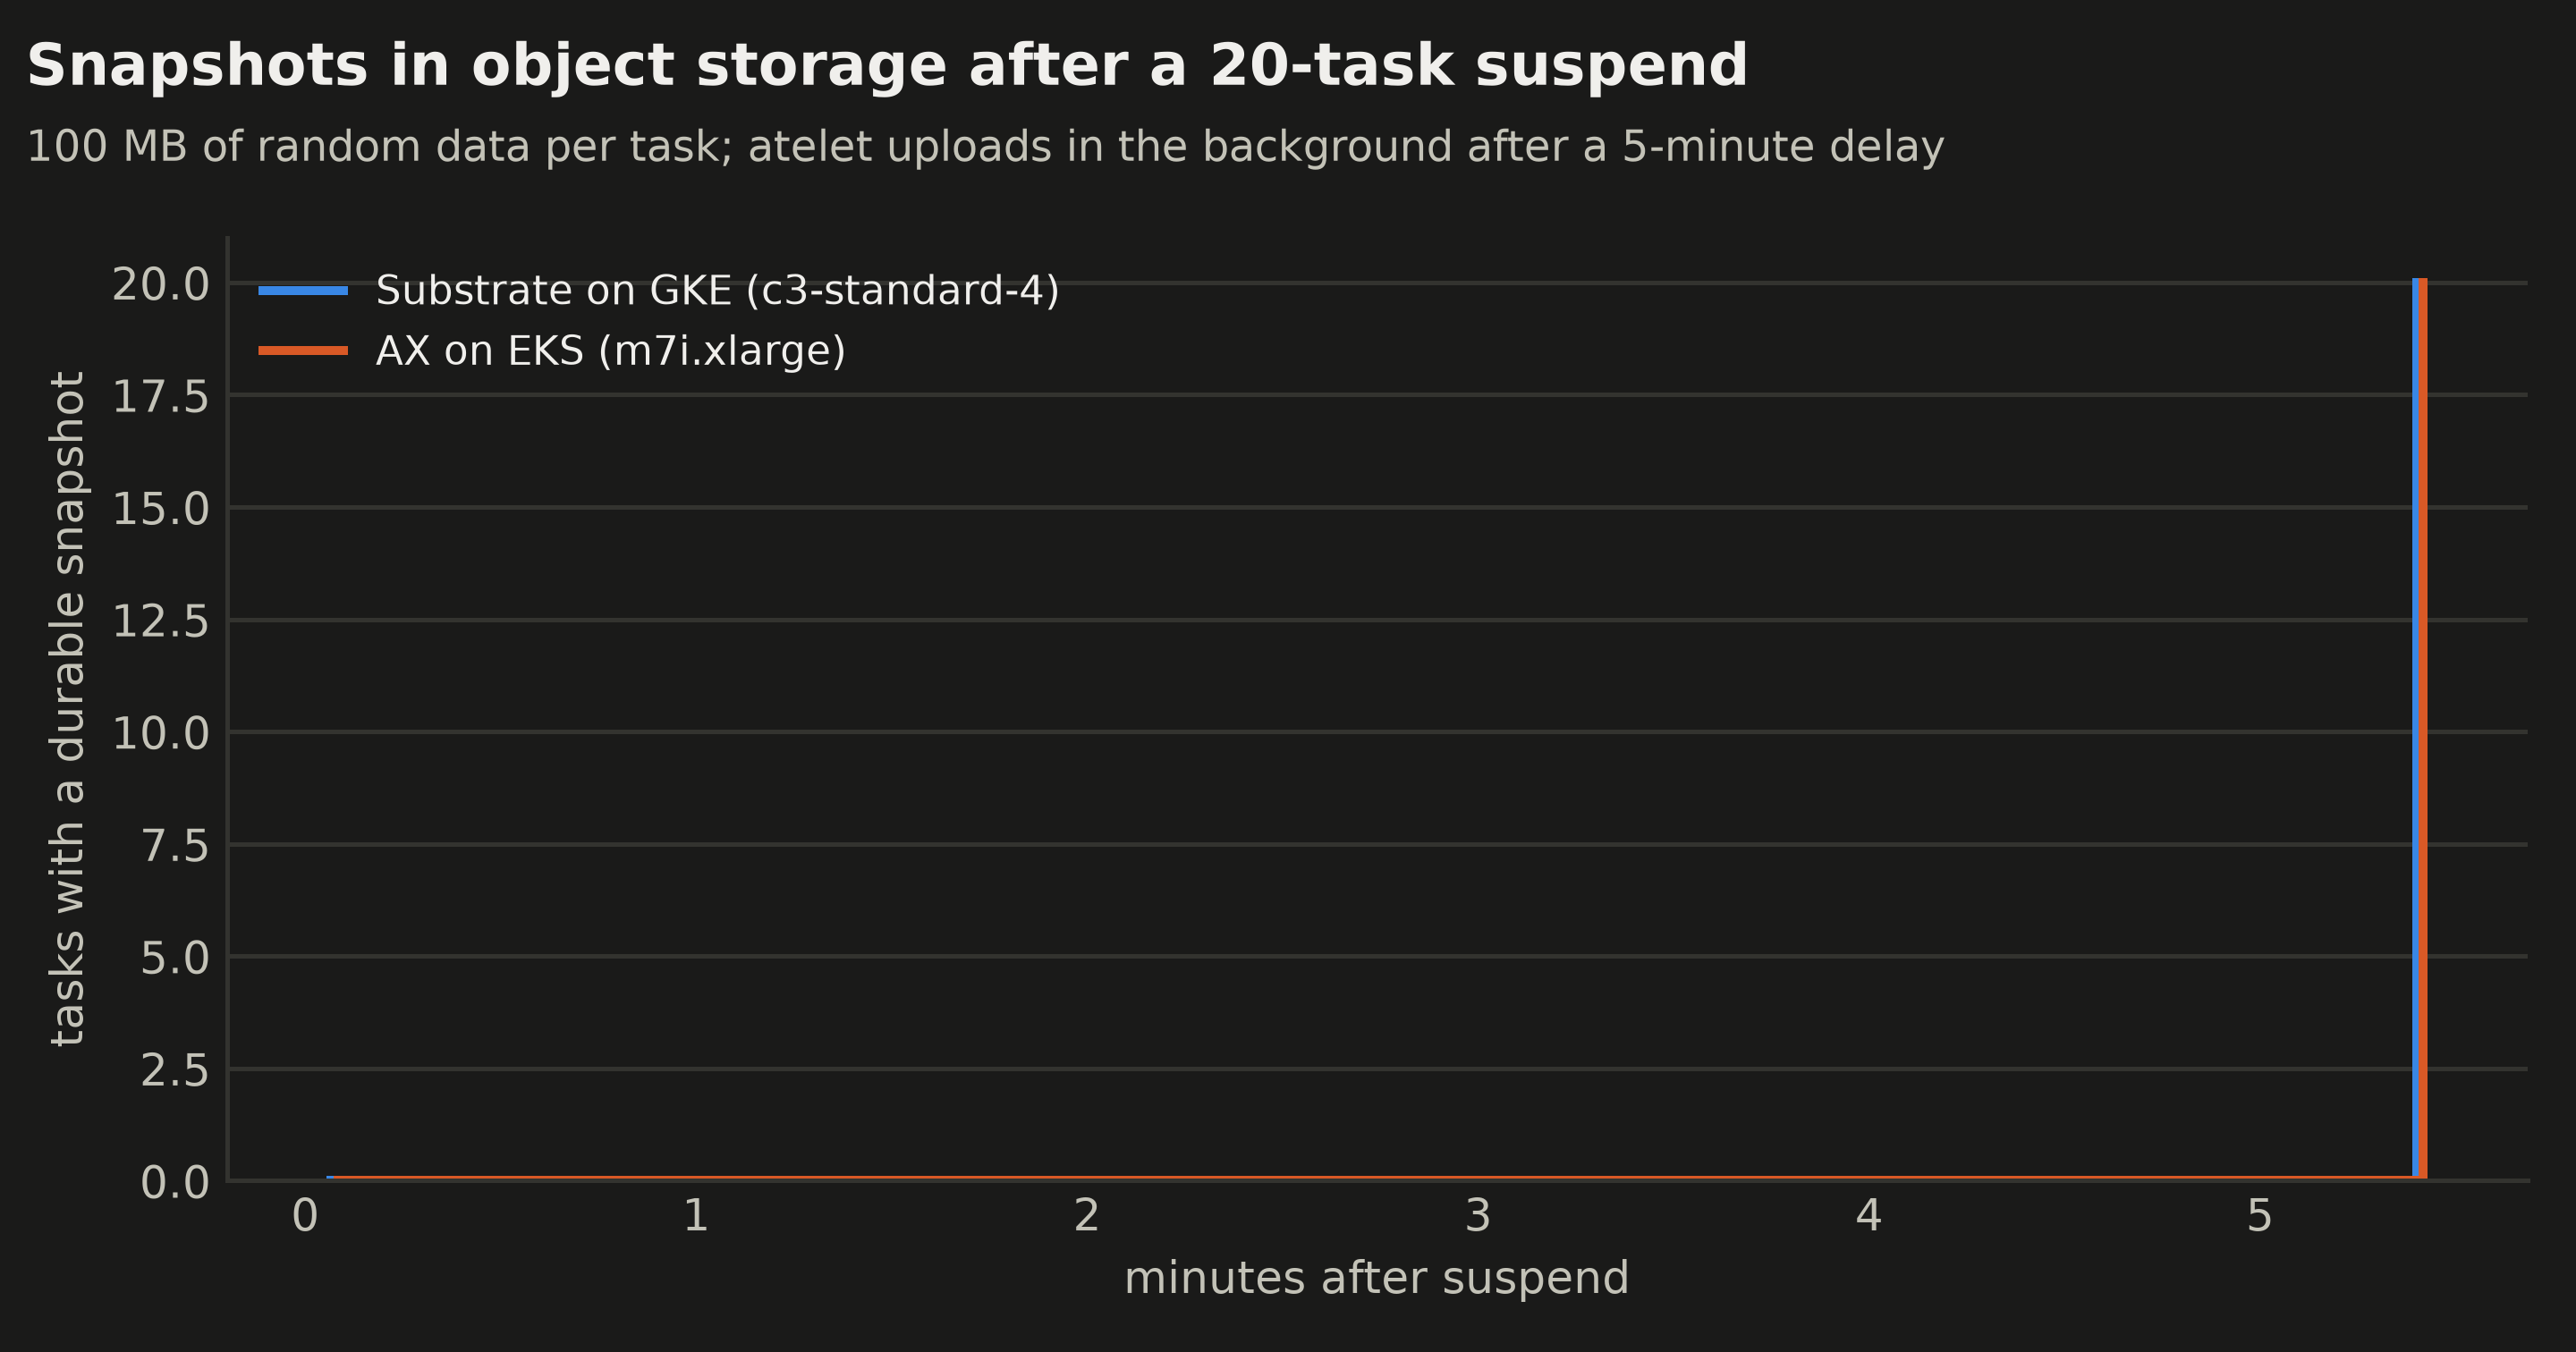
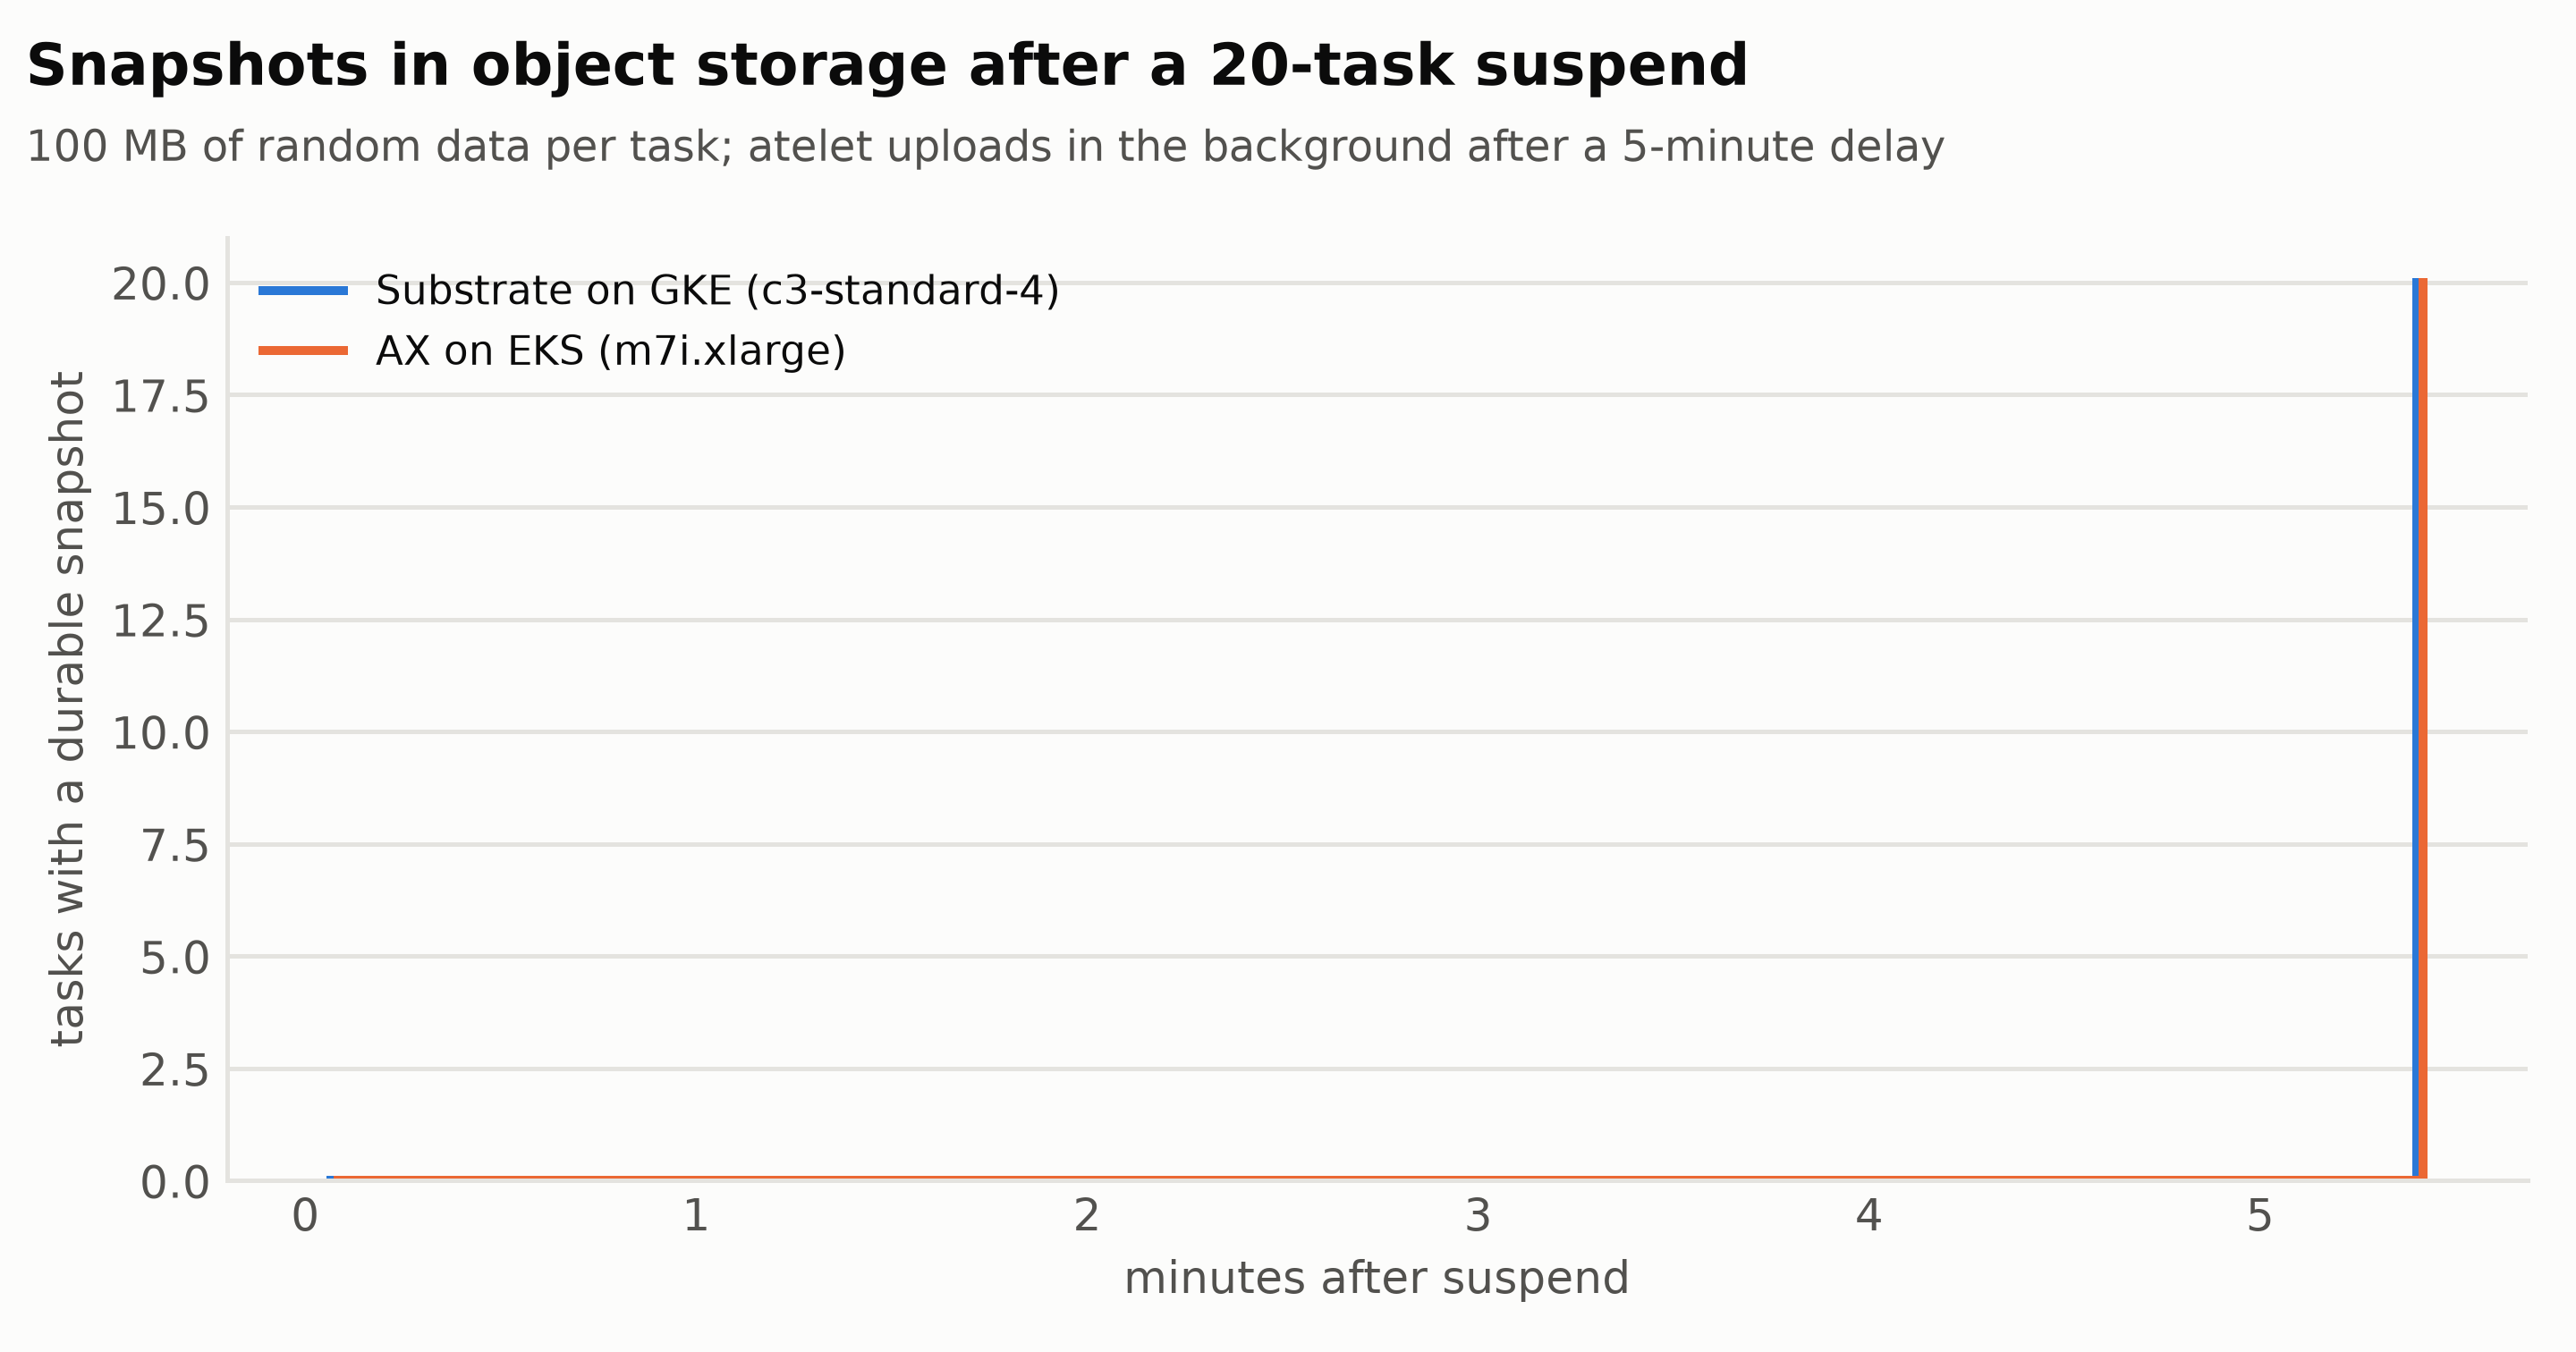
O suspend do Substrate retorna rápido e faz o upload em background depois de um atraso, 5 minutos por padrão. Eu escrevi 100 MB de dados aleatórios e 100 MB de zeros, suspendi e fiz polling do registro do actor:
+    2s  durable copy: PENDING    local copy on: <node>
+  324s  durable copy: COMPLETED  local copy on: <node>
+ 1807s  durable copy: COMPLETED  local copy on: none (detached)
O upload completou 324 segundos depois do suspend e a cópia local do node foi desanexada em 1.807 segundos, contra 324 e 1.801 no EKS: os defaults do Substrate, um atraso de upload de 5 minutos e um atraso de detach de 30 minutos, não mudam no GKE. O objeto tem 104,9 MB em cinco arquivos (o pages.img.zstd carrega quase tudo; os zeros comprimem), o mesmo tamanho do EKS. Um resume com a cópia local desanexada levou 1.724 ms nesta execução (2.305 ms em uma anterior, EKS 1.623 ms) e os dois arquivos foram verificados. Naquela execução anterior meu polling leu o registro do actor por uma chamada de cliente instável e imprimiu “detached” em 356 segundos; o harness agora ignora uma leitura que não retorna nada, e eu repeti o teste.
Um workspace de 2 GB (quatro arquivos aleatórios de 512 MB) foi suspenso em 14,3 s na mediana (10,4 a 17,8 s, EKS 15,5 s) e retomado em 1.004 ms (EKS 875 ms), com todos os bytes intactos em três ciclos. A documentação diz que toda transferência de snapshot roda com um token com escopo para o seu actor, emitido pelo ate-api-server e personificando a service account ate-snapshot-transfer que o bootstrap cria, então os audit logs nomeiam essa conta. Eu verifiquei que a conta e as permissões existem, não a troca em si: no nível de log padrão não encontrei nenhuma linha para ela.
Teste 6: Densidade
O Substrate reserva os limites de CPU e memória de cada sandbox contra a capacidade do seu worker, que para um pool sem capacidade declarada é o allocatable do node: 3.920m de CPU nas duas clouds, e 14,073,824 Ki de memória aqui contra cerca de 15 milhões no EKS.
| Onda | Rodando | Recusadas | Mediana de resume |
|---|---|---|---|
| 12 tasks, padrão (1 CPU, 512 MiB) | 6 (3 por worker) | 6 | 4,561 ms, 2,783 ms na execução registrada (EKS 2,862) |
| 40 tasks, 250m / 256Mi | 30 (15 por worker) | 10 | 3,197 ms, 2,890 ms na execução registrada (EKS 2,951) |
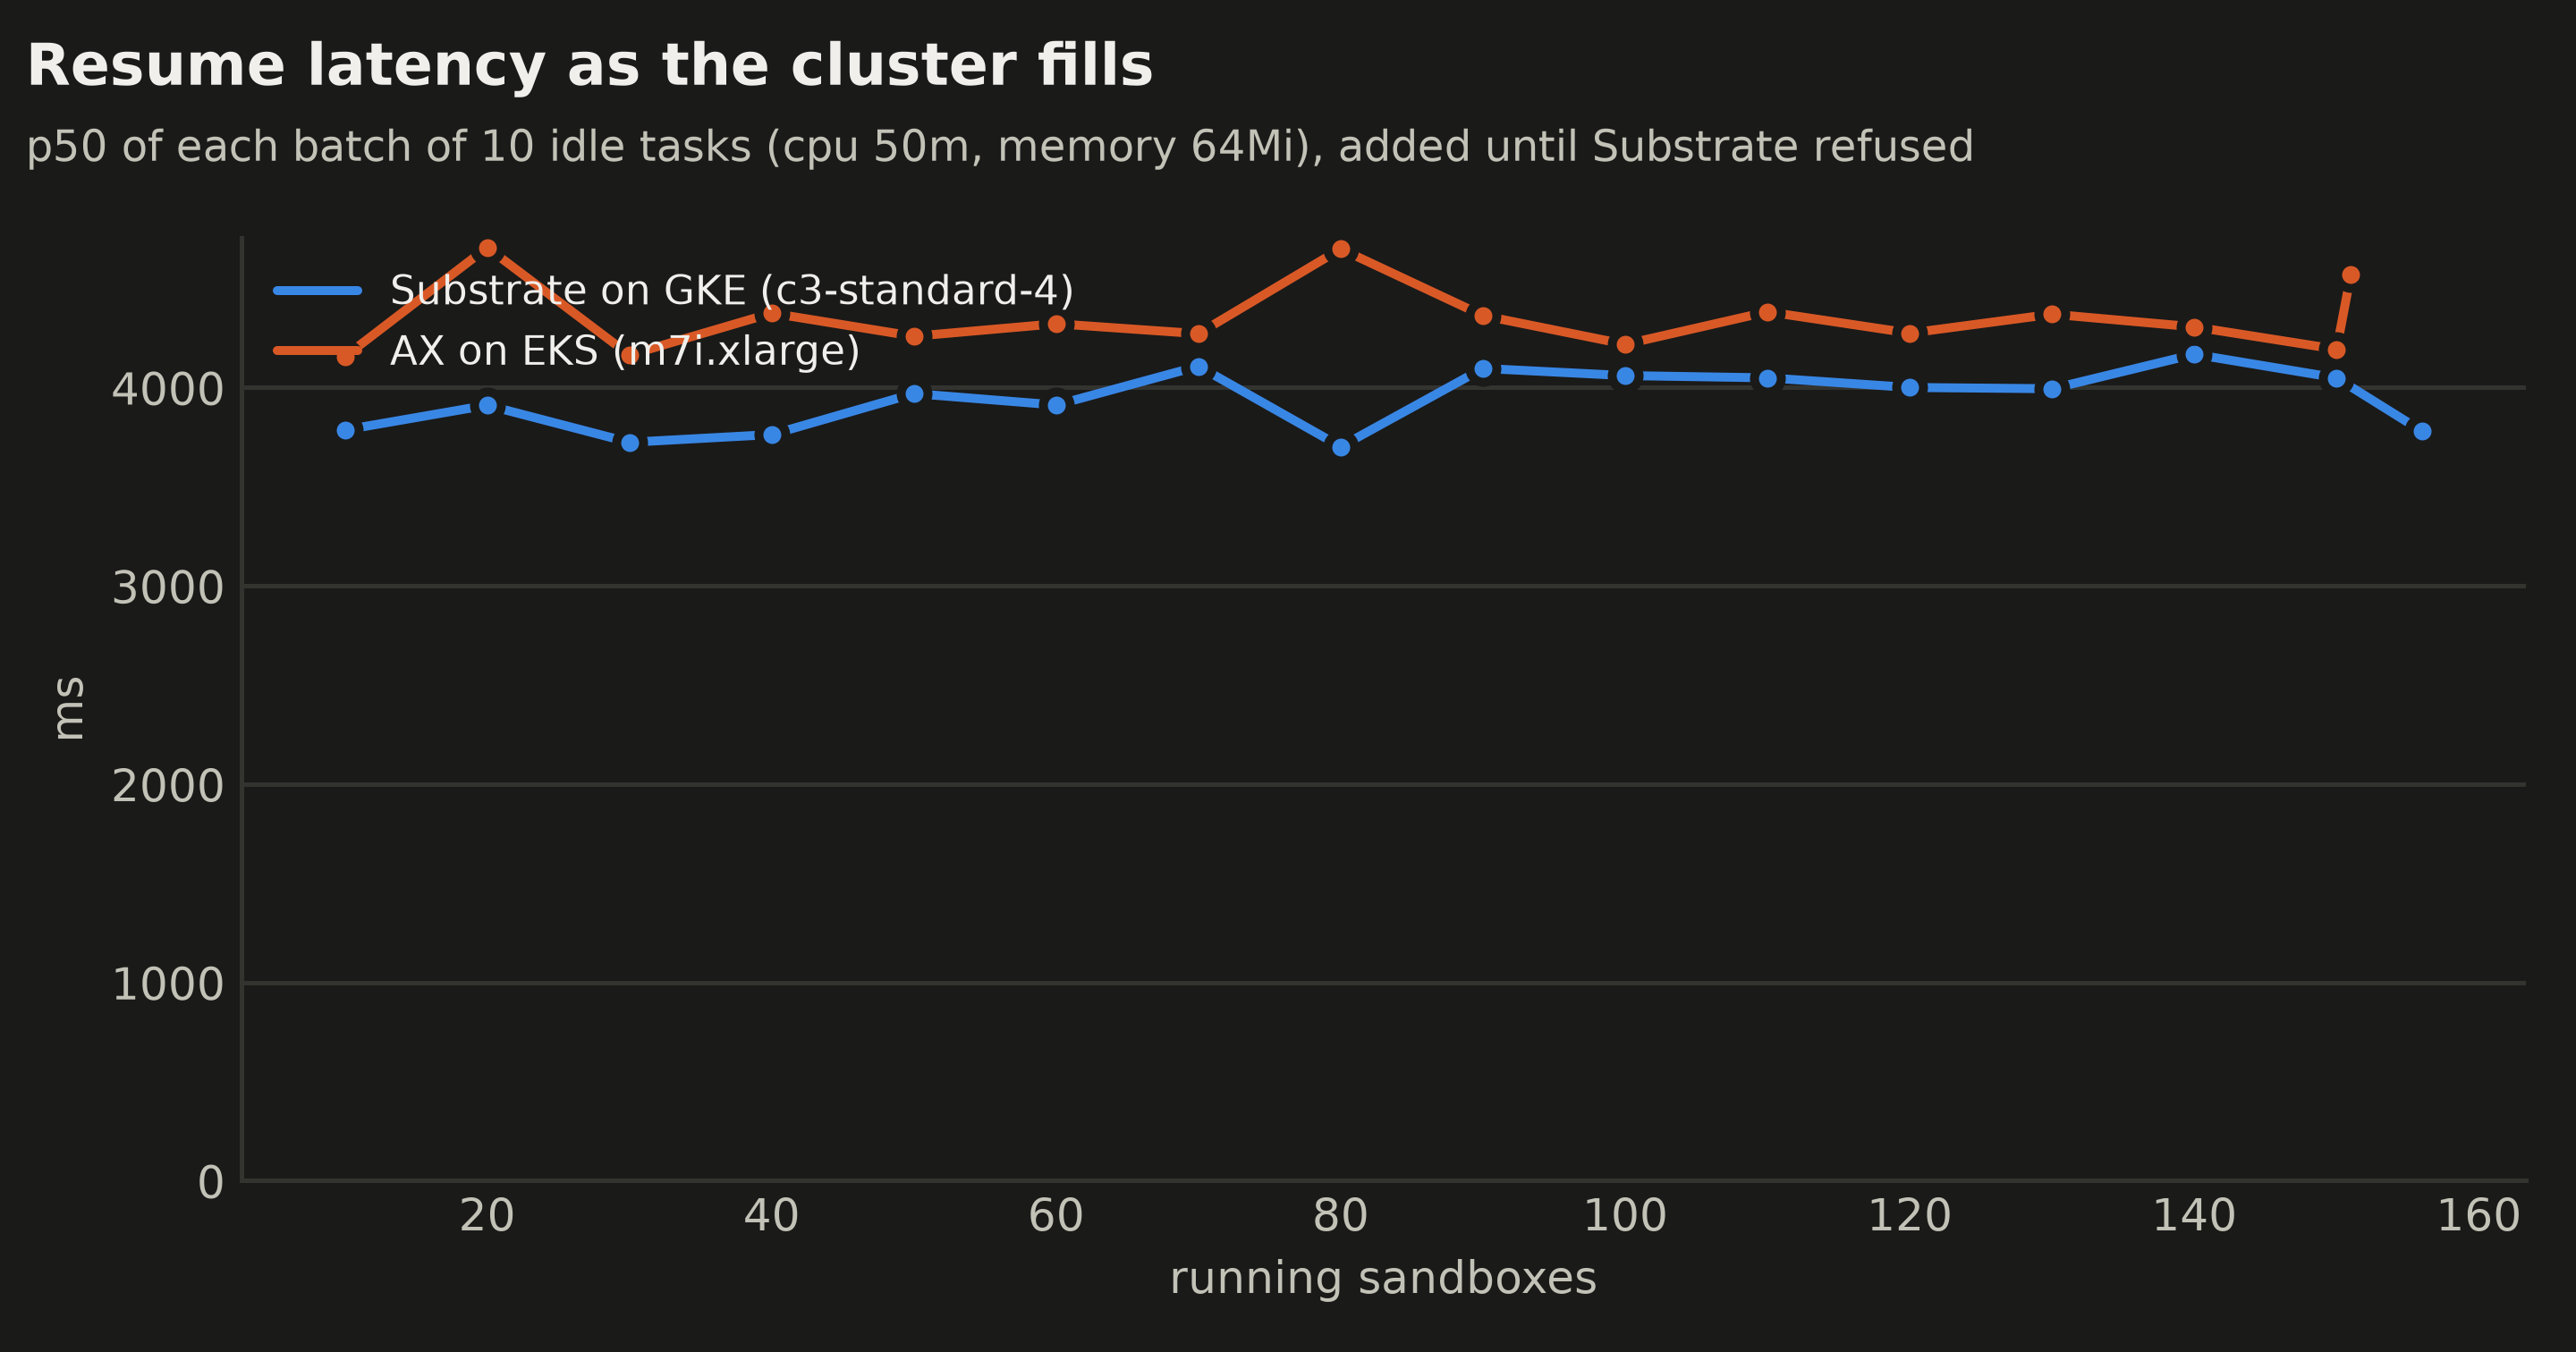
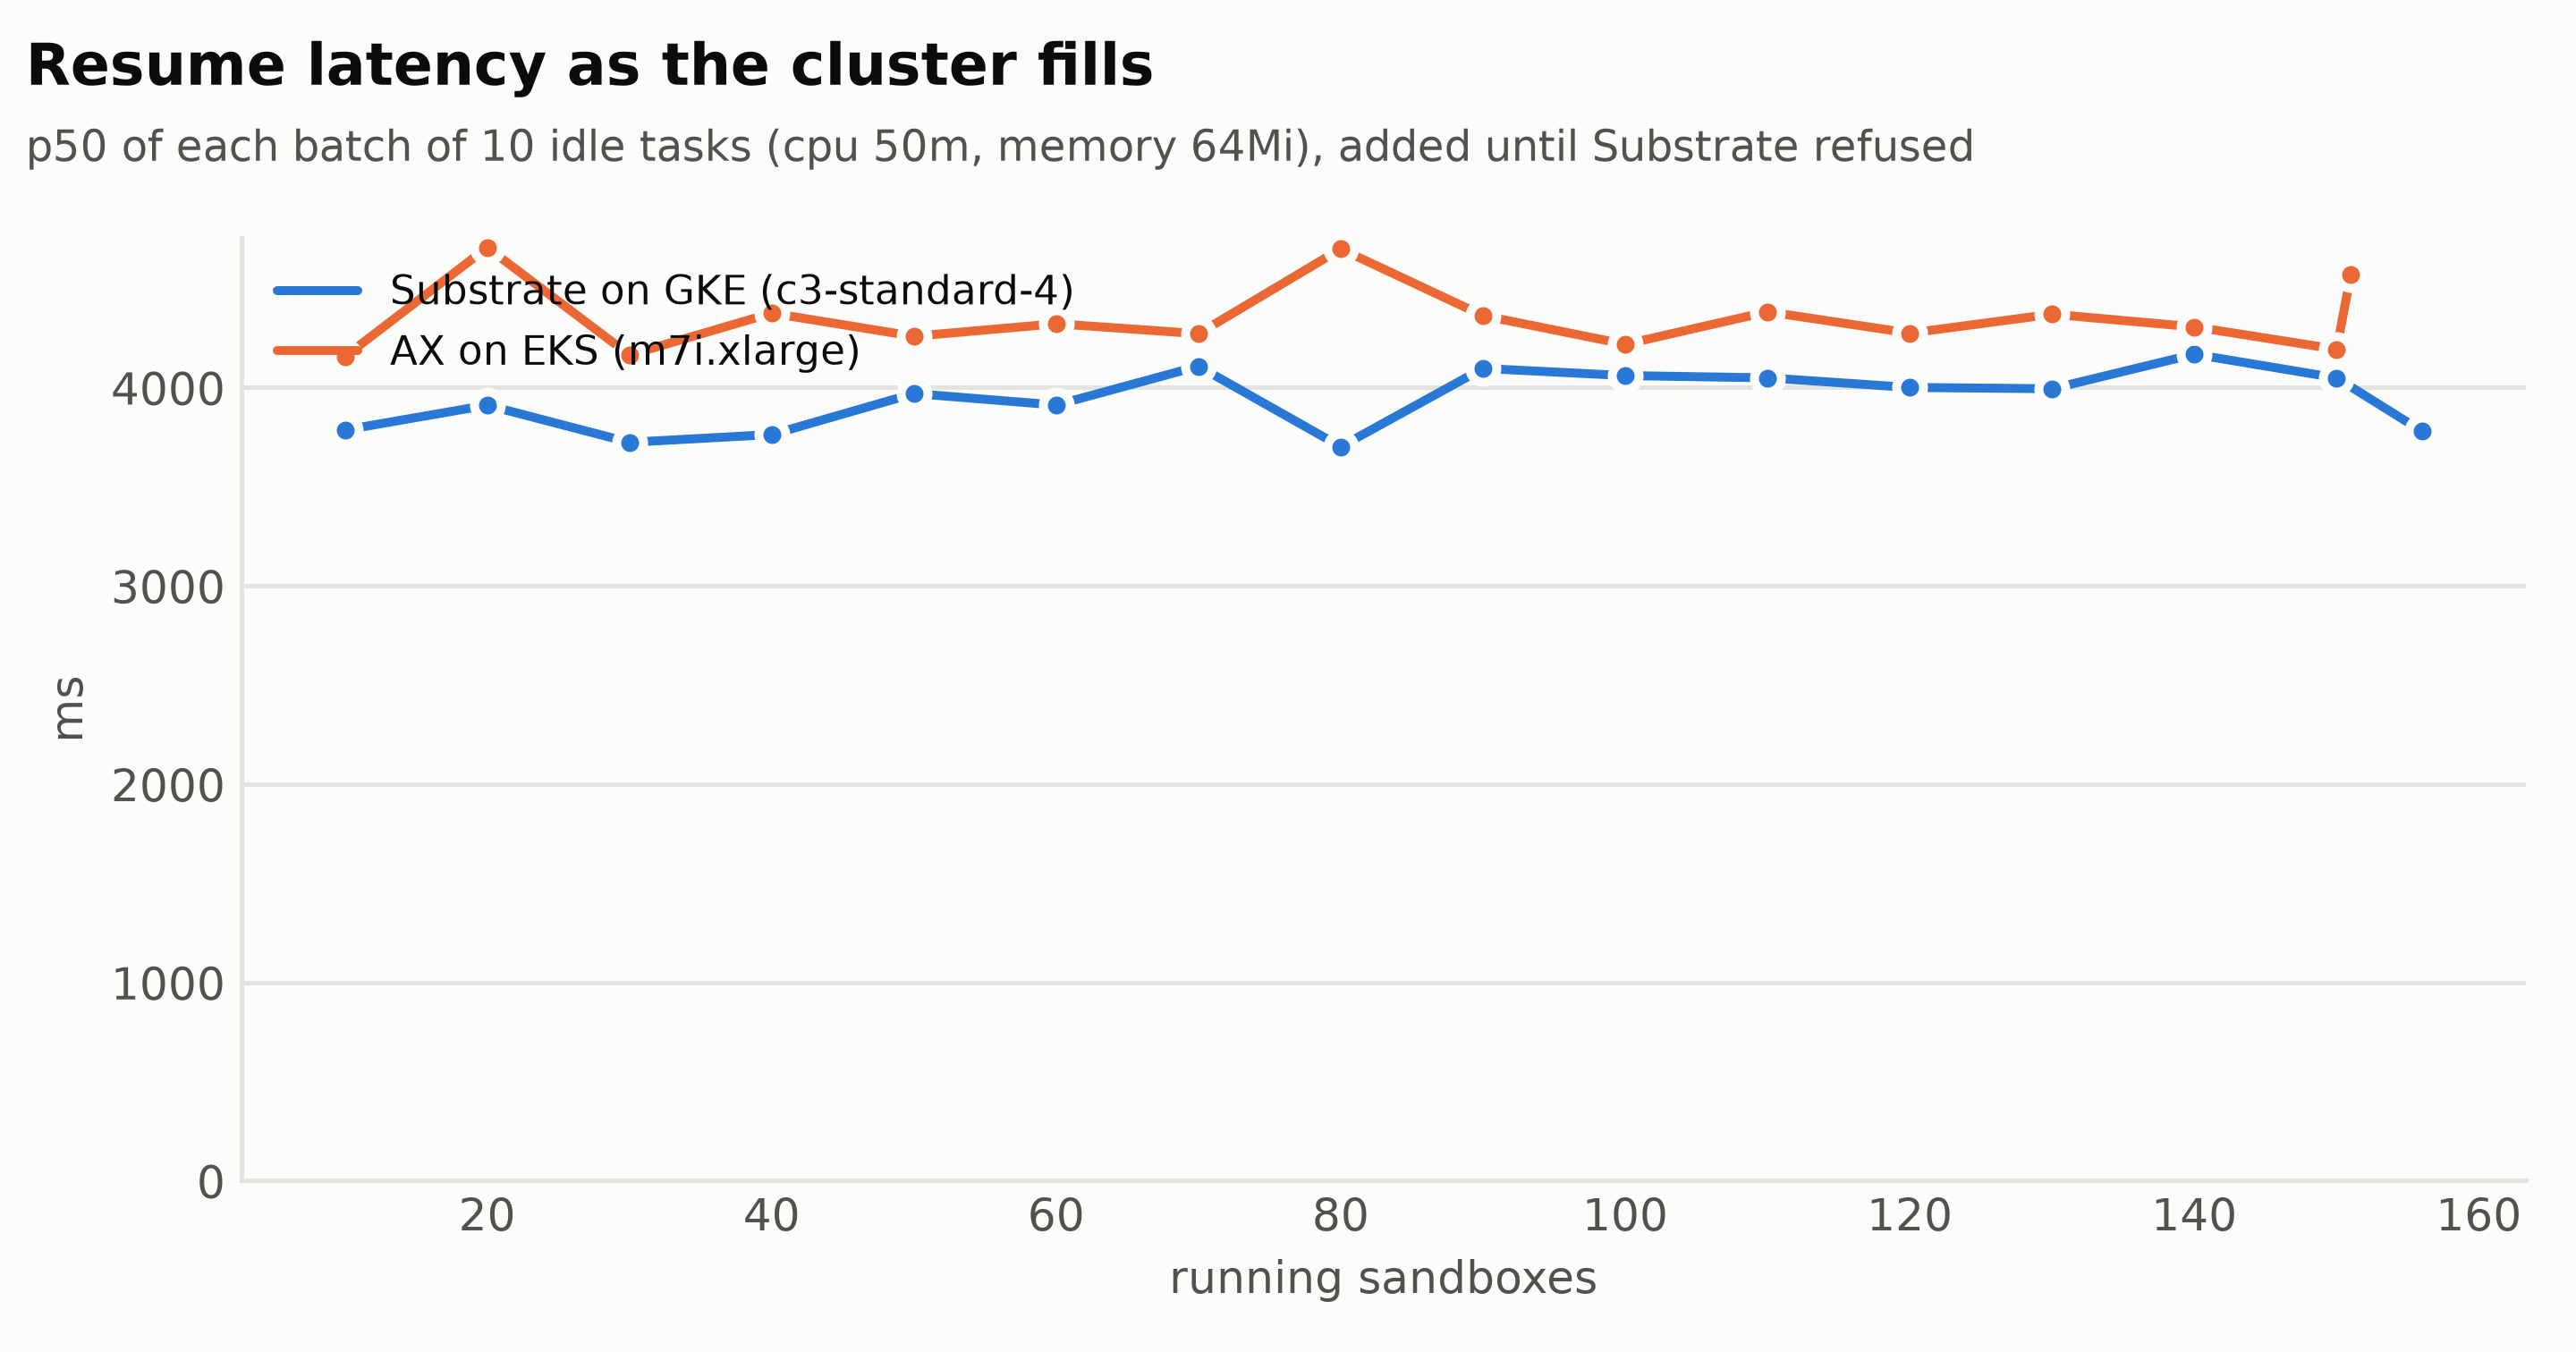
| Rampa em 50m / 64Mi, lotes de 10 | 156 | o lote seguinte | p50 3,910, p95 4,324, p99 4,585 ms (EKS p50 4,286) |
A recusa é a mesma, no worker has room for the actor, e as duas primeiras linhas têm as mesmas contagens do EKS: 6 e 30. A rampa terminou em 156, contra 151 no EKS. O Substrate v1.0.0 diz que reserva o overhead de runtime por actor, o que eu esperava que baixasse o teto, e não vi efeito. Com 156 os nodes tinham 3,1 e 2,9 GiB, contra 2,3 e 2,0 com os primeiros 10 rodando, o que dá cerca de 12,6 MiB por sandbox ociosa adicional (EKS: cerca de 13).
Os dois números de densidade do Google, “over 1,000 dormant agents per host” e o “approximately 800 concurrent sandboxes per node” da documentação antes do ajuste de kernel, são para actors suspensos, que não ocupam capacidade de worker. O que eu contei são sandboxes em execução, e dois nodes de 4 vCPU chegam ao teto perto de 150 no menor tamanho, porque a CPU reservada é 50m cada. Os sysctls de kernel que a documentação diz serem necessários acima de cerca de 800 são os que eu configurei no pool.
Teste 7: Latência sob concorrência e carga no control plane
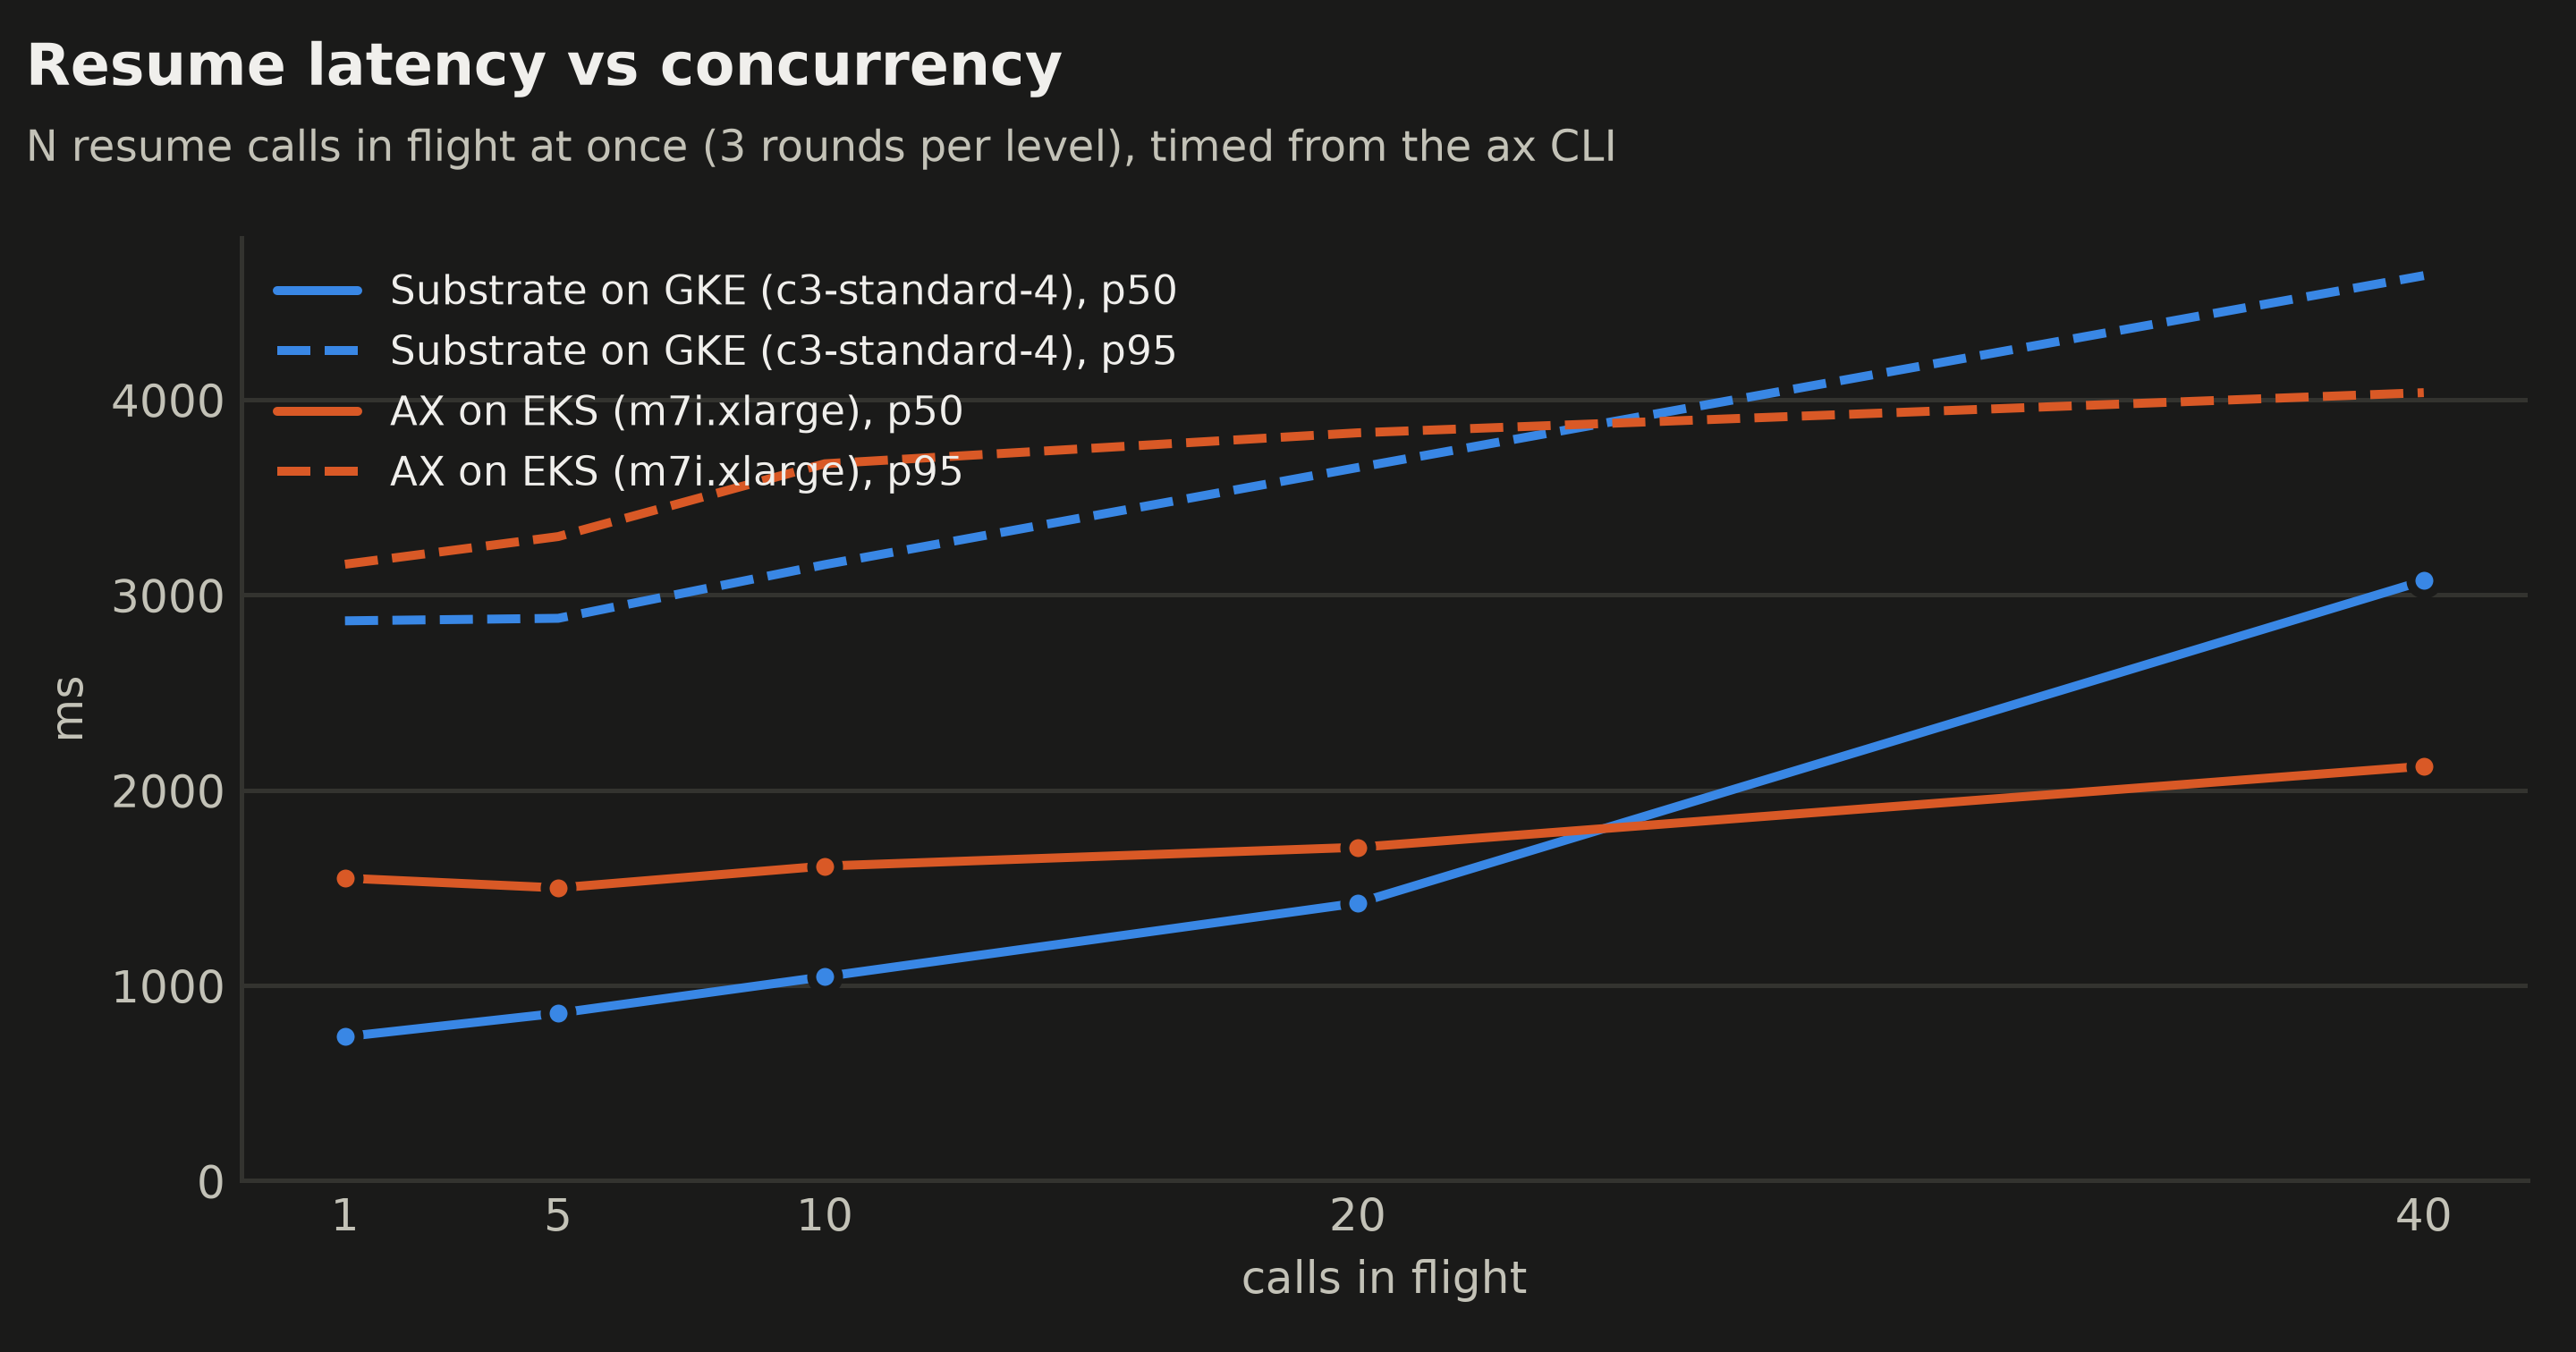
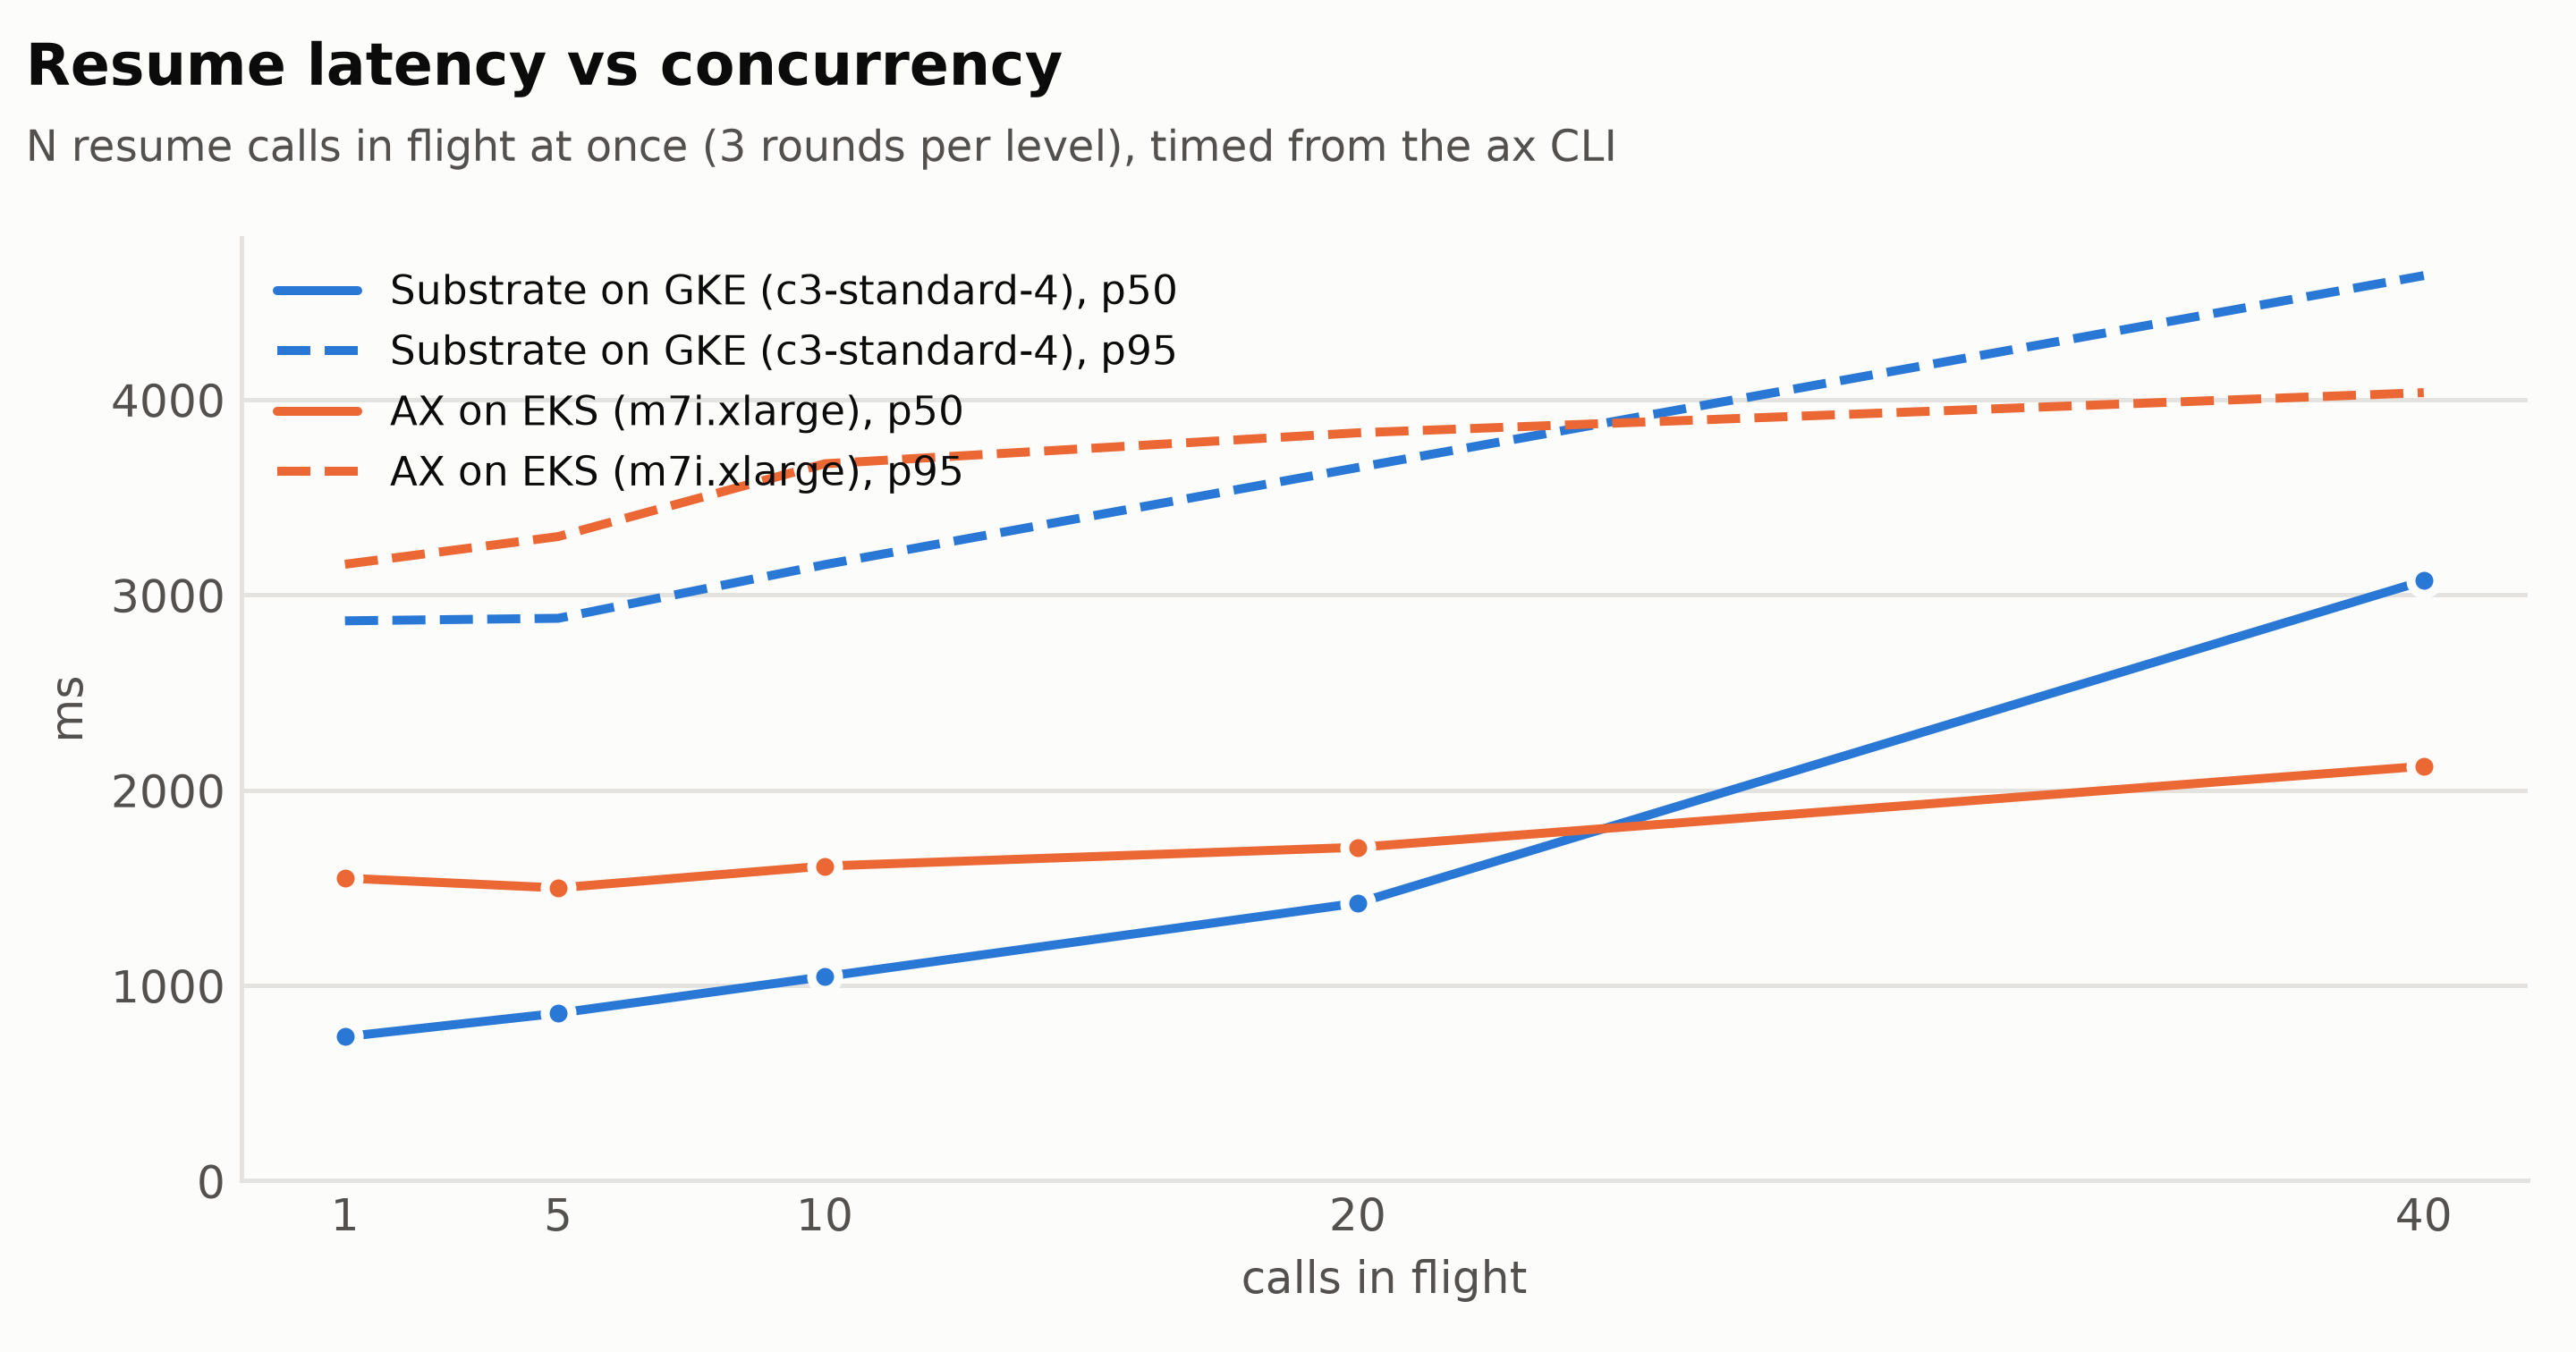
N chamadas em andamento ao mesmo tempo, três rodadas por nível, em 100m / 128Mi. Medianas, com o EKS entre parênteses:
| Em andamento | Create | Resume | Suspend |
|---|---|---|---|
| 1 | 519 (708) | 738 (1,550) | 568 (770) |
| 5 | 536 (718) | 858 (1,500) | 614 (812) |
| 10 | 552 (726) | 1,045 (1,612) | 677 (862) |
| 20 | 652 (746) | 1,422 (1,707) | 804 (1,029) |
| 40 | 889 (758) | 3,072 (2,123) | 1,175 (1,175) |
O GKE foi mais rápido até 20 em andamento e mais lento com 40, onde os resumes subiram para 3,1 s na mediana e 4,6 s no p95 (EKS 2,1 e 4,0 s). O primeiro resume de cada task é mais lento que os seguintes, como no EKS: ele inicia o golden snapshot do template, então o p95 o inclui. Com zero erros em todos os níveis.
O teste de control plane cria, retoma, suspende e deleta 120 tasks com 20 em andamento:
| Fase | Tempo total | Throughput | p50 (EKS) |
|---|---|---|---|
| Create | 4.0 s | 29.7/s (EKS 26.4) | 580 ms (728) |
| Resume | 27.4 s | 4.4/s (EKS 3.0) | 4,352 ms (6,305) |
| Suspend | 7.8 s | 15.4/s (EKS 19.7) | 1,135 ms (920) |
| Delete | 4.3 s | 28.1/s (EKS 22.4) | 682 ms (848) |
Sem falhas. O pico de CPU dos pods mais ocupados: ate-api-server 352m (durante os creates), atelet 243m, o PostgreSQL do Substrate 165m, ax-server 63m e o PostgreSQL do AX 19m, e os quatro que acompanhei no EKS somaram um pico de 599m, cerca de 0,6 de um core (EKS: cerca de 0,5). A conclusão se repete: em dois nodes, as sandboxes, não a API, definem o throughput. O resume é lento porque cada um inicia um runner sob um limite de CPU; as 500 ativações por segundo do Google precisariam de bem mais que 8 vCPUs.
Teste 8: Tempo de wake por limite de CPU, e bursts
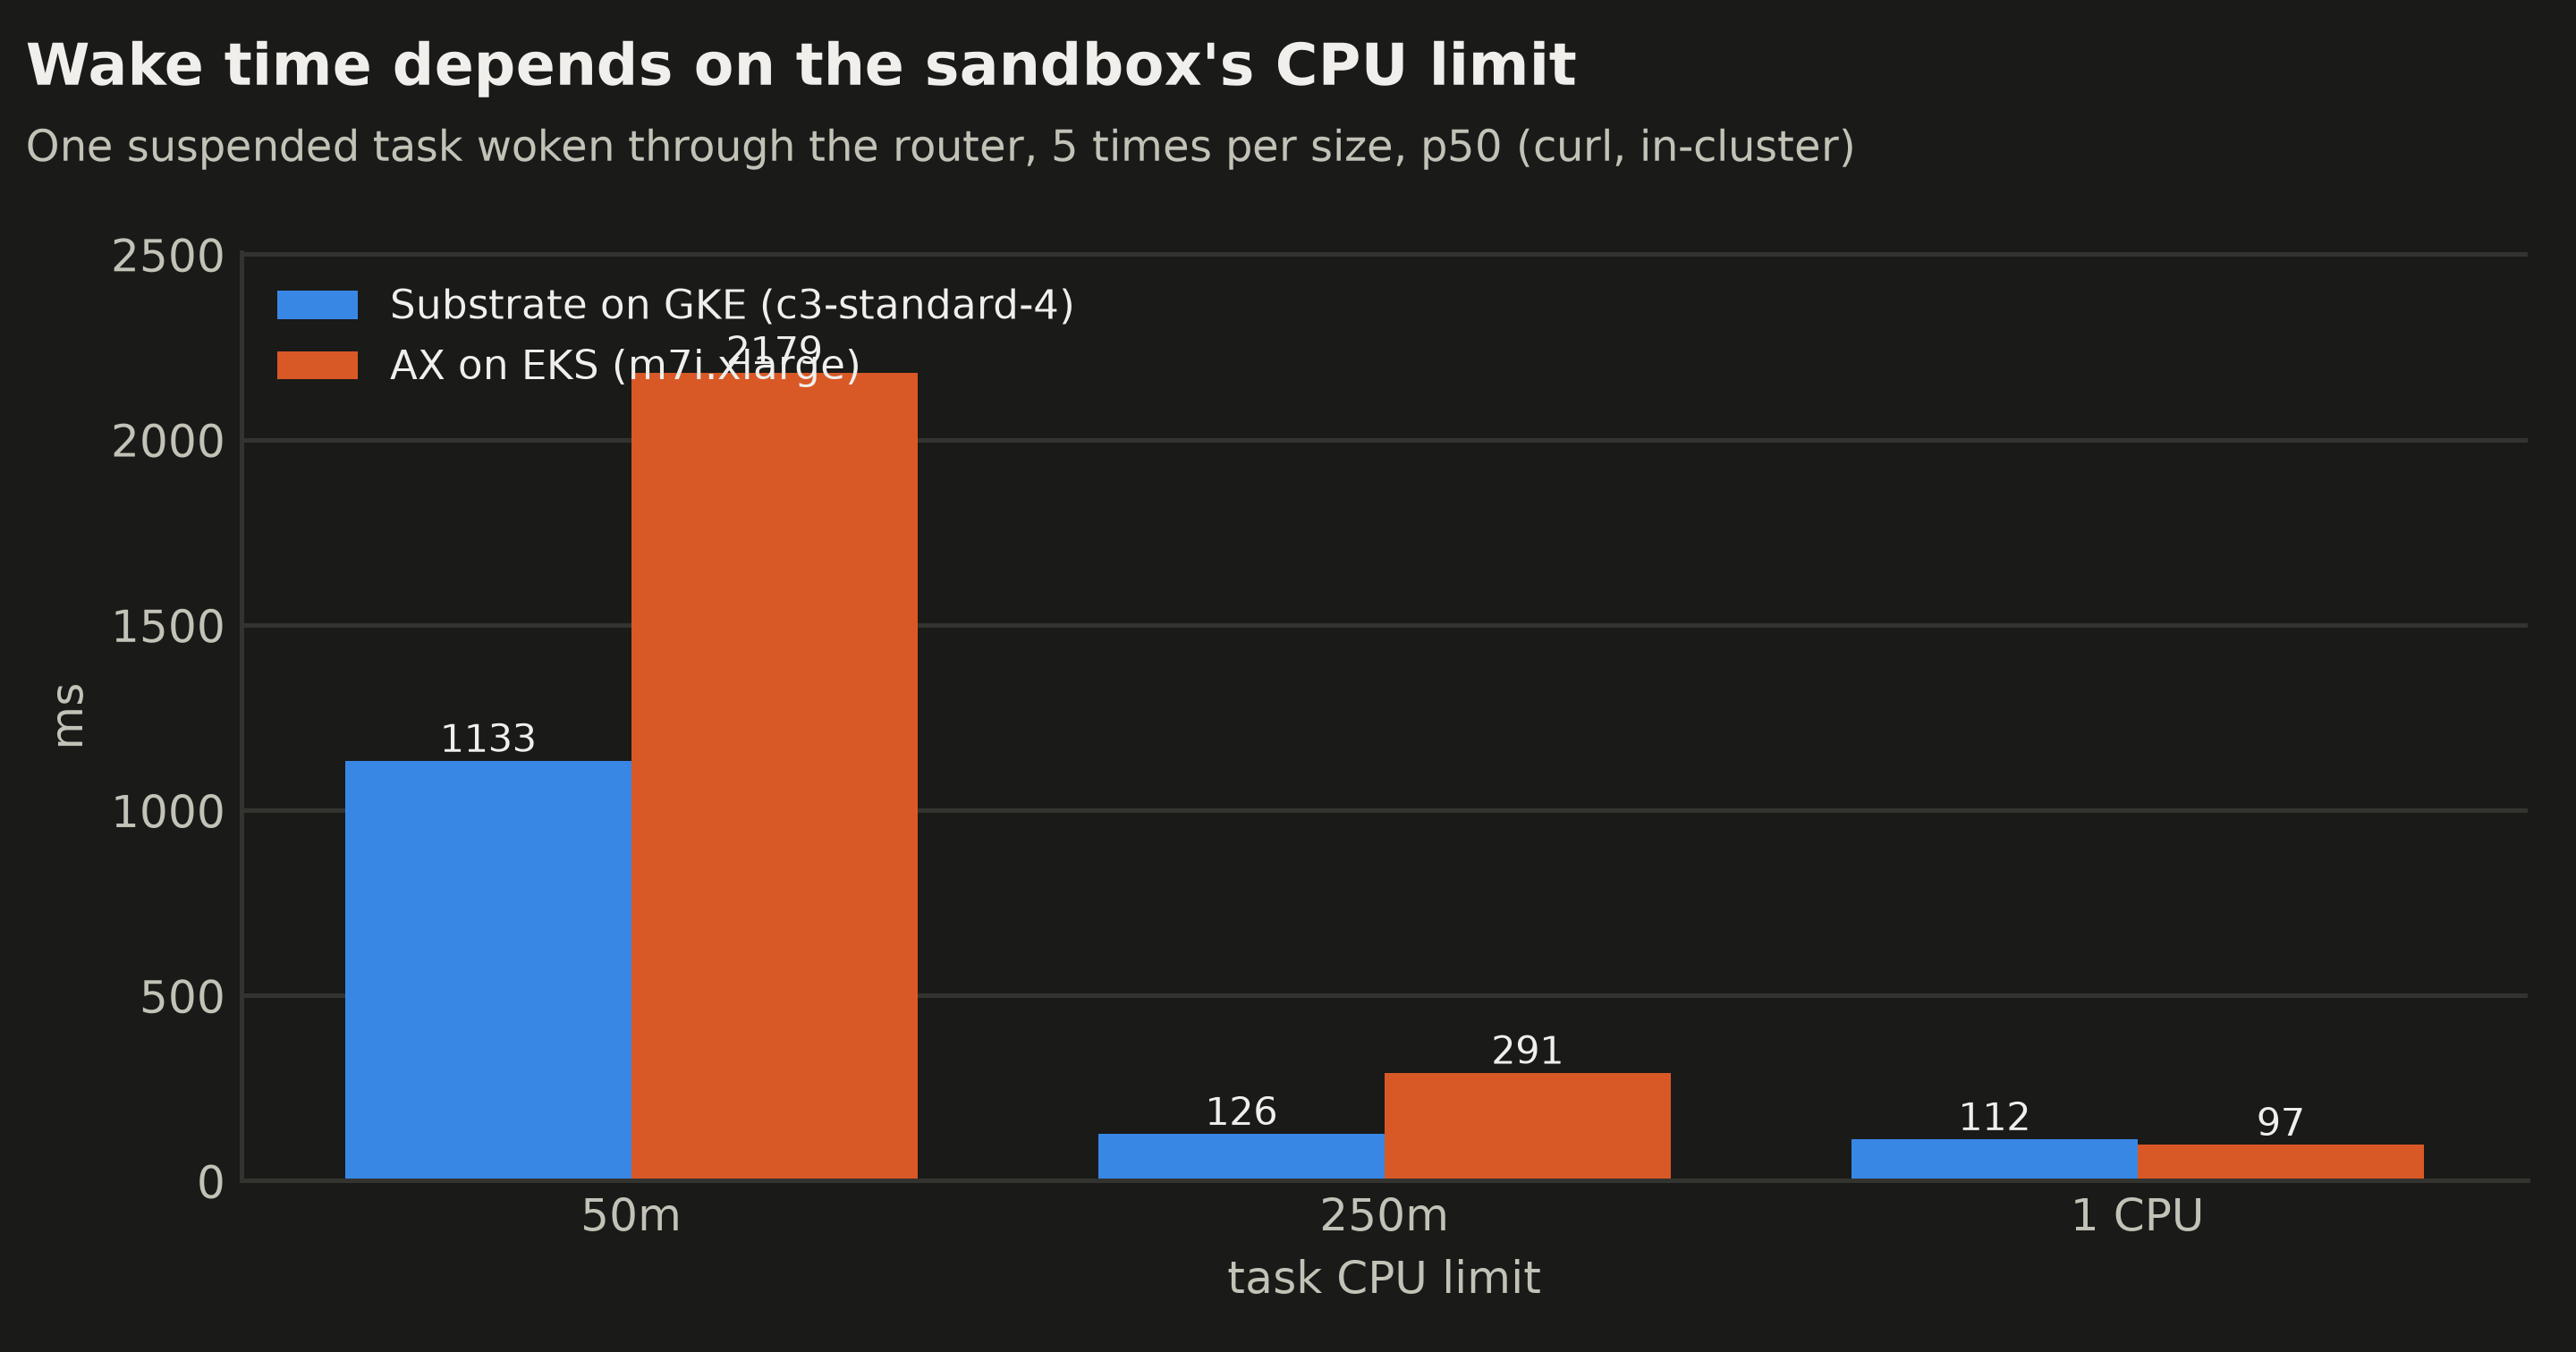
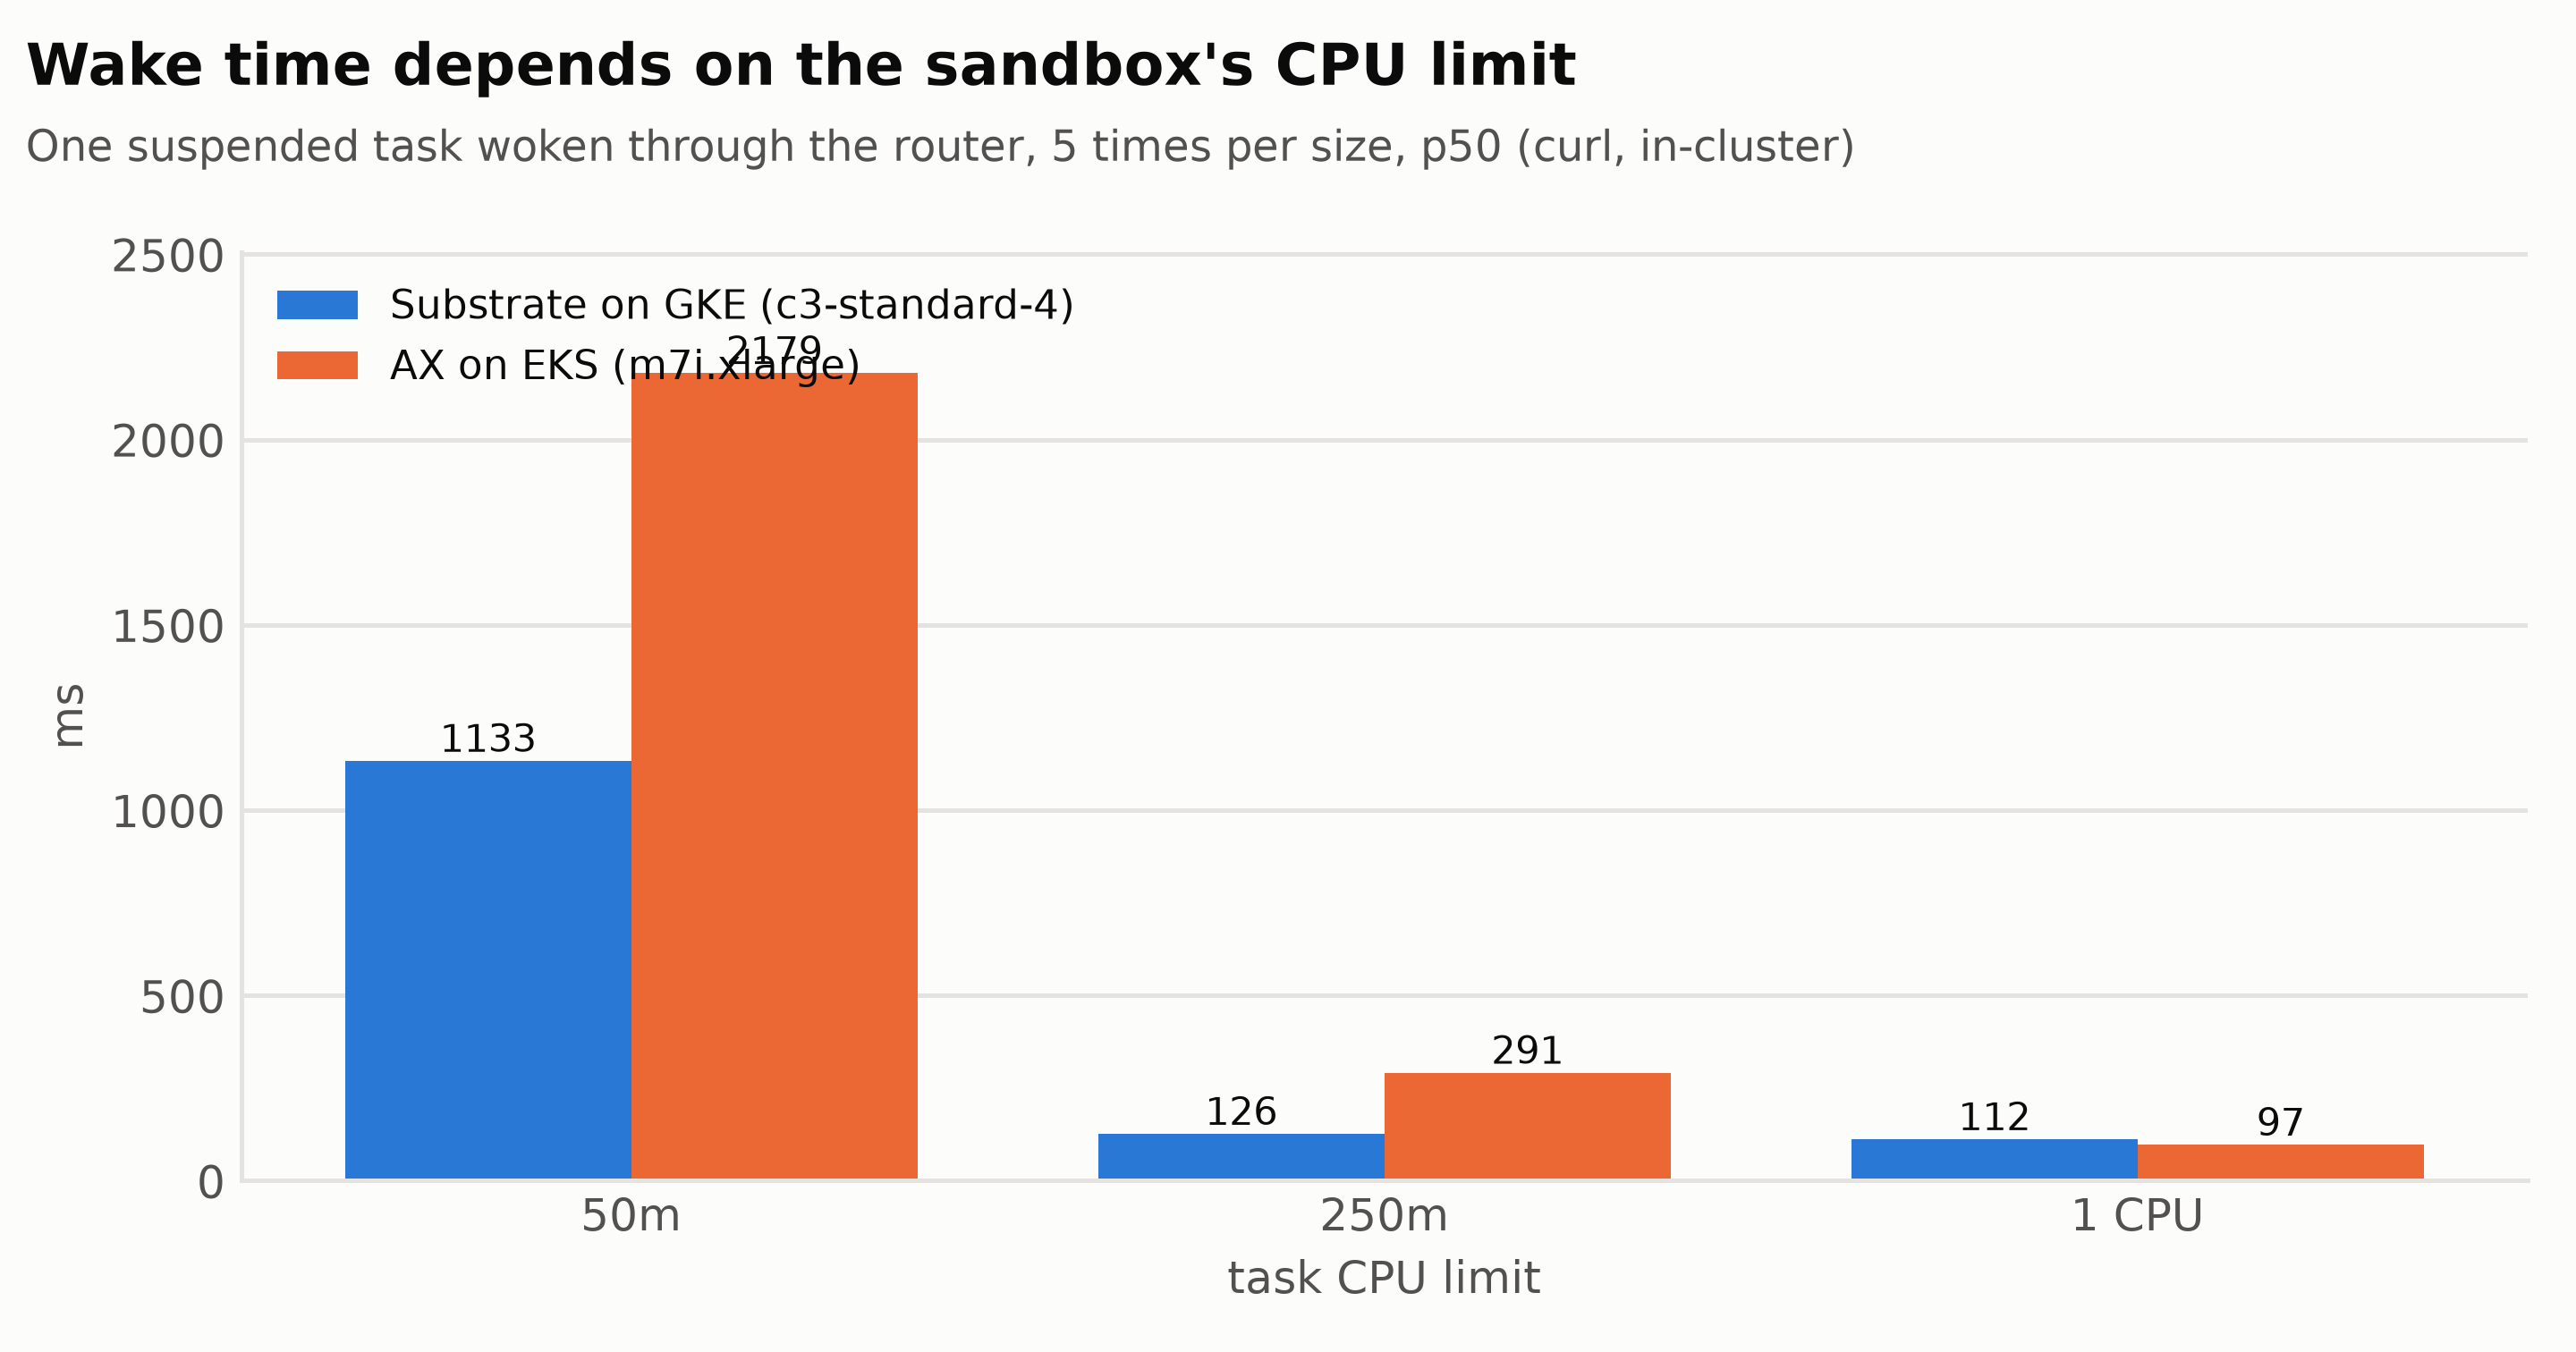
Uma task suspensa por tamanho, acordada cinco vezes pelo router, dentro do cluster, e depois bursts de 1, 10 e 30 tasks a 250m acordadas de uma vez:
| p50 GKE | p50 EKS | |
|---|---|---|
| 50m | 1,133 ms (p95 1,396) | 2,179 ms |
| 250m | 126 ms (p95 184) | 291 ms |
| 1 CPU | 112 ms (p95 118) | 97 ms |
| Burst de 1 | 188 ms | 316 ms |
| Burst de 10 | 413 ms (p95 559) | 434 ms |
| Burst de 30 | 1,245 ms (p95 1,461, p99 1,512) | 903 ms |
Todos 200. O resultado principal se reproduz: o tempo de wake é uma escolha de limite de CPU, porque o runner inicia sob o limite. Uma sandbox dimensionada em 250m ou 1 CPU acorda em cerca de um décimo de segundo, e uma dimensionada em 50m leva um segundo inteiro. O “sub-500ms” do Google vale a partir de 250m para um wake, e com 10 wakes simultâneos na mediana.
Teste 9: Noisy neighbors
Seis tasks vítimas a 250m / 256Mi rodaram um benchmark de CPU e uma escrita de 64 MB com fsync, sozinhas e depois ao lado de quatro tasks hog de um mesmo tipo. Medianas, com o p95 da escrita:
| Vizinhos | Benchmark de CPU | p95 da escrita | p95 do suspend |
|---|---|---|---|
| Nenhum | 518 ms | 620 ms | 727 ms |
| 4 hogs de CPU | 642 ms (+24%) | 194 ms | 900 ms |
| 4 hogs de disco | 592 ms | 199 ms | 1,551 ms |
| 4 hogs de memória | 594 ms | 196 ms | 712 ms |
No EKS os hogs de CPU atrasaram o benchmark em 74% e os hogs de disco levaram o p95 da escrita de 192 ms para 1.097 ms. Nenhum dos efeitos apareceu aqui: os hogs de CPU custaram 24%, e o p95 da escrita ficou perto de 200 ms (os 620 ms do baseline foram uma amostra de seis). Os hogs de disco apareceram uma vez, como um p95 de suspend de 1,55 s. Os hogs de memória terminaram Failed no limite deles, onde no EKS ficaram Running, e seus vizinhos não foram afetados em nenhum dos casos. Uma execução cada significa que eu não me apoiaria em +24% contra +74%, mas a ausência do efeito de disco merece uma segunda execução, e pode vir do disco do node (um boot disk hyperdisk-balanced contra EBS gp3) tanto quanto do software.
Teste 10: Tempestade de snapshots, o caminho de rede e modos de falha
Vinte tasks escreveram 100 MB cada e foram suspensas de uma vez. O suspend levou 1.951 ms na mediana e 2.890 ms no p95 (EKS 1.124 e 1.879); uma execução anterior do mesmo teste deu 1.866 e 3.235. Nenhum snapshot estava no Cloud Storage nos primeiros 5 minutos, e todos os 20 estavam duráveis em +324 segundos, o mesmo que o EKS em +325. O bucket guardava 1,95 GiB para eles.
A pergunta que a execução no EKS levantou foi o caminho de rede: a VPC dela não tinha endpoint S3, então 2,1 GB passaram pelo NAT gateway e foram cobrados como dados de NAT. No GKE eu puxei o sent_bytes_count do Cloud NAT e o received_bytes_count do Cloud Storage pelo Cloud Monitoring para a mesma janela. O Cloud Storage recebeu 2.090 MB no minuto da primeira tempestade e 2.097 MB na segunda. O Cloud NAT enviou 0 bytes. Como verificação de que a métrica do NAT funciona, ao longo das seis horas inteiras ela mostrou 749 MB recebidos, durante a instalação (imagens do ghcr.io), e 3,3 MB enviados (t10d_nat_sanity.py). A VPC do EKS não tinha endpoint S3; presumo que seja o Private Google Access na subnet que manteve esses uploads dentro da rede do Google, mas não testei a subnet com ele desligado.
Os modos de falha, em ordem:
- Um comando que termina. A task continua
Running, com o runner como PID 1 e sem exit code, como no EKS. - Um worker pod deletado sob uma task em execução e uma suspensa: a em execução virou
Failed; a suspensa não foi afetada e retomou em 614 ms com seu arquivo. Retomar a task que falhou levou 634 ms e começou do zero (up 0 min, seu arquivo não salvo sumiu). - Uma mudança no WorkerPool (declarando capacidade) levou 14,2 s para ser aplicada, contra 3,0 s no EKS, e toda task em execução virou
Failed. Rode por último. - Recursos ao longo de toda a janela. As médias de 1 minuto do Cloud Monitoring tiveram pico de 9% da CPU allocatable e 17,5% da memória nos dois nodes, minhas amostras de 3 segundos do kubelet chegaram a 63% da CPU de um node no teste mais pesado, e houve 0 restarts de container.
Resumo dos resultados
| Afirmação ou pergunta | Resultado |
|---|---|
| GA no GKE, allowlist | Nenhuma mensagem de allowlist ou elegibilidade na instalação |
| Esforço de instalação | Cerca de 20 min a partir de um projeto vazio; o bootstrap é 10 deles |
| O que um suspend preserva | AX: só /workspace. Nativo, memory fidelity: processo, /tmp, uptime. Nenhum: uma conexão aberta |
| Resume “sub-500ms” | p50 de 112 a 126 ms pelo router a 250m e 1 CPU; 107 a 314 ms para actors nativos; 1,1 s a 50m |
| Snapshot para object storage | 324 s depois de um suspend, desanexado do node em 1.807 s, 104,9 MB para 200 MB de arquivos, resume a partir do GCS em 1,7 a 2,3 s |
| Uploads e o NAT gateway | 2,1 GB para o Cloud Storage, 0 bytes pelo Cloud NAT |
| Densidade | 156 sandboxes ociosas em 2 x 4 vCPU (EKS 151), 12,6 MiB cada |
| Carga no control plane | 0,6 core no pico; as sandboxes são o limite |
| Noisy neighbors | CPU +24%, hogs de disco não atrasaram as escritas dos vizinhos |
Monitoramento
As métricas de sistema do GKE no Cloud Monitoring vêm ligadas por padrão e são gratuitas: CPU e memória dos nodes (kubernetes.io/node/cpu/allocatable_utilization), restarts de container e números por pod, que é de onde vêm os picos acima junto com o meu sampler do kubelet. O bootstrap também cria três dashboards, “Substrate gRPC Server: latency / QPS / errors”, “Substrate Routing & E2E Latency” e “Substrate Snapshot Size & QPS”. O Cloud NAT e o Cloud Storage publicam contagens de bytes, que é como respondi à pergunta de rede; a do Cloud Storage atrasou alguns minutos. O console mostra os workloads em ate-system e os objetos de snapshot no bucket, mas não há uma visão de actors, então para esses você usa kubectl ate get actor.
Preços
O Substrate não adiciona nenhuma taxa: você paga pelo GKE, pelo Compute Engine e pelo Cloud Storage. Ocioso, meu cluster custou cerca de $0.61 por hora (cerca de $14.60 por dia): dois c3-standard-4 a $0.2016 por hora cada, a taxa de gerenciamento do cluster (um crédito do free tier cobre um cluster zonal, o que leva a cerca de $0.51), um volume pd-balanced de 500 GiB para o PostgreSQL do Substrate (cerca de $0.07 por hora), o volume de 10 GiB do AX, dois boot disks de 100 GB e o Cloud NAT. O EKS custou cerca de $0.63 por hora. A exploração inteira e a execução registrada levaram algumas horas, então alguns dólares. Esse volume de 500 GiB é o que você deve lembrar: ele é criado por um PersistentVolumeClaim, então deletar o cluster o deixa para trás, cobrando, até você deletar o disco. Os snapshots em si são objetos do Cloud Storage: 105 MB por workspace de 200 MB aqui, e um bucket ao qual você deve dar uma lifecycle rule se suspender muitos actors.
Limpeza, em ordem: delete as tasks e os actors, os WorkerPools e o pod router-probe; delete o cluster; depois delete os discos pvc-* órfãos no Compute Engine; o bucket de snapshots e o -assets; o repositório do Artifact Registry; as service accounts ate-snapshot-transfer e dos nodes e seus IAM bindings; o Cloud NAT e o router. No dia seguinte, confira se o Billing não mostra crescimento em GKE, Compute Engine, Cloud Storage, Artifact Registry ou NAT. O teardown.sh do repositório faz isso e verifica.
Veredito
O que funciona
A afirmação de resume abaixo de 500 ms se sustentou, em um cluster modesto. Um actor suspenso acordou pelo router em cerca de 120 ms com CPU sobrando, 156 sandboxes ociosas couberam em dois nodes de 4 vCPU, e um snapshot de 100 MB chegou ao Cloud Storage em 5 minutos sem passar pelo Cloud NAT, uma diferença real em relação à minha execução no EKS que atribuo à configuração de rede e não à sorte. Um actor nativo com memory fidelity continuou exatamente de onde parou, o que é mais do que o AX pede. A instalação não teve allowlist, levou cerca de 20 minutos, e a maioria dos meus números do EKS se reproduziu dentro de uma margem que eu chamaria de ruído.
O que ainda não funciona
As arestas estão nos defaults. A allowlist do router decide quem pode acordar um actor, o README do instalador diz que o kubectl ate não precisa de entrada e o proxy precisa, e o AX agenda alegremente em qualquer WorkerPool do cluster, o que mudou meus números de densidade até eu perceber. A cota de disco de um projeto novo é menor que o volume que o Substrate pede, e um cluster criado pelo console não avisa. Um wake com limite de CPU de 50m levou mais de um segundo, resumes com 40 chamadas concorrentes levaram 3 segundos na mediana, e uma conexão aberta na hora do suspend não volta. Uma mudança no WorkerPool levou 14 segundos para ser aplicada e fez falhar toda task em execução. Não testado: um WorkerPool de microVM, injeção de credenciais com uma API key, GPUs, e qualquer coisa acima de dois nodes ou de uma execução cada. As versões diferem das execuções no EKS, então algumas das diferenças podem ser da v1.0.0 e não do GKE.
Quem deve usar
Use o Substrate no GKE quando você tem muitos agentes quase sempre ociosos e quer que cada um mantenha seu estado sem pagar por uma máquina acordada, e não se importa em rodar um cluster. Defina o tamanho da sandbox de propósito (o tempo de wake segue o limite de CPU), escolha a snapshot fidelity de que você precisa, adicione seus clientes à allowlist do router, e lembre do volume de 500 GiB na hora do teardown. Se você prefere não rodar um cluster, as partes anteriores cobrem as opções gerenciadas, e a parte 1 coloca todas elas em um mapa só.