E2B Sandboxes: Mão na Massa com o Ciclo de Vida Completo do Sandbox
Por Fabio Douek
Ir para seção
- Visão Geral
- Arquitetura
- Setup
- Passo 1: Conta e API key
- Passo 2: Instalar o SDK e o código de apoio
- Passo 3: Marcar tudo com tags
- Testes
- Teste 1: Criar um sandbox e inspecionar os padrões
- Teste 2: Comandos, arquivos e o timeout de comando
- Teste 3: Timeouts, set_timeout vs connect
- Teste 4: Pause e resume, três ciclos
- Teste 5: Auto-pause no timeout e auto-resume com atividade
- Teste 6: List, filtro e connect a partir de outro processo
- Teste 7: Fork e snapshot
- Teste 8: Um template customizado vs instalar em runtime
- Resumo dos resultados
- Preços
- Limpeza
Explica (TLDR) como se eu fosse...
Imagine uma caixa de brinquedos mágica que você pode emprestar para o seu robô. O robô pode construir qualquer coisa dentro dela, fazer bagunça, até quebrar coisas, e nada disso encosta no seu quarto de verdade. Quando a brincadeira acaba, a caixa pode sumir, ou pode congelar exatamente como está até você voltar.
A parte do congelamento é o truque esperto. Você pode parar a caixa no meio de um jogo, sair por dias, e quando abrir de novo os blocos ainda estão no meio da torre. Você pode até fazer cópias da caixa para que três robôs testem três ideias diferentes ao mesmo tempo.
A E2B é um ambiente de execução hospedado: o código que sua aplicação ou o AI agent dela gera roda em uma máquina virtual isolada na infraestrutura da E2B, cobrada por segundo, com o runtime open source do fornecedor disponível caso a organização prefira hospedar por conta própria.
Os pontos de diligência são ciclo de vida e retenção. Por padrão, um sandbox é destruído cinco minutos após a criação, mas sandboxes pausados são retidos indefinidamente, sem expiração automática, então os dados persistem até alguém apagá-los. Defina quem é responsável pela limpeza, configure um teto de gastos no console e trate o estado pausado como dado armazenado sob a sua política de retenção.
A condição que isso trata é a execução insegura de código escrito por máquina em infraestrutura com a qual você se importa. A intervenção é uma máquina virtual Firecracker descartável por tarefa, e nos meus testes ela iniciou em cerca de um terço de segundo e voltou da pausa em menos de um.
A evidência é boa para o mecanismo central: memória, arquivos e processos em execução sobreviveram intactos a três ciclos de pausa. Efeitos colaterais conhecidos ficam na mesma área, com bug reports em aberto e incidentes recentes do serviço envolvendo pause e resume. Bons candidatos são produtos de agents que precisam de estado por usuário; maus candidatos são workloads de GPU, que ela não suporta.
Repare em quanta preocupação silenciosa desaparece quando o código que um agent escreve só consegue quebrar uma caixa que foi feita para ser quebrada. Os engenheiros param de vigiar cada comando gerado, e a conversa muda de "deixamos o agent agir?" para "o que ele deve fazer em seguida?".
A nova tensão é sobre esquecimento. Pausar é tão barato e tão permanente que os sandboxes se acumulam sem ninguém ver, e os padrões destroem o trabalho silenciosamente após cinco minutos, a menos que alguém tenha escolhido outra coisa. O hábito saudável é nomear quem arruma a casa, e transformar isso num acordo compartilhado e explícito em vez de uma reflexão tardia.
Pense na E2B como um pedal de looper para o trabalho do seu agent. Você aperta gravar, o sandbox toca, e em qualquer compasso você pode congelar o loop exatamente onde está, sair, e voltar depois no mesmo tempo.
O fork é o overdub: um take vira três takes paralelos, cada um livre para improvisar a partir da mesma frase inicial. O andamento é rápido, com starts e resumes abaixo de um segundo nas minhas sessões, mas os padrões importam. Deixe o timeout como está e o loop simplesmente para depois de cinco minutos e desaparece.
O posicionamento é "um computador para o seu agent, com um botão de pausa." O time to value é de minutos: uma instalação, uma API key, e o primeiro sandbox inicia em bem menos de um segundo. O crédito único de $100 do plano gratuito cobriu todo este passo a passo por cerca de um centavo.
A história diferenciada é o estado. Os concorrentes também iniciam rápido, mas poucos mantêm memória e processos em execução durante uma pausa indefinidamente, ou clonam um sandbox ativo em cópias. Esse é o gancho para produtos que precisam de workspaces por usuário aos quais seus agents possam voltar dias depois.
 Veja o código-fonte aqui: e2b-sandbox-lifecycle
Visão Geral
A E2B roda código gerado por IA em sandboxes na nuvem. Cada sandbox é uma microVM Firecracker com seu próprio kernel, filesystem e rede, que você cria, controla e destrói a partir de um SDK Python ou JavaScript. Para muitos times, ela é a resposta padrão para “onde o meu agent roda o código que ele escreve”, e o runtime é open source sob Apache-2.0 caso você prefira hospedá-lo por conta própria.
Um sandbox da E2B pode ser pausado com sua memória, arquivos e processos em execução intactos, mantido pausado indefinidamente sem custo de computação, acordado automaticamente pela próxima chamada de API ou requisição HTTP, e “forkado” em cópias que herdam o estado ativo.
Este post, parte 1 de 2, acompanha um sandbox por toda a sua vida, de Sandbox.create() até a limpeza, com um script executável por etapa. Rodei tudo contra o SDK 2.59.0 (lançado em 2026-10-22) no plano gratuito Hobby em us-west-1, usando Python, e todos os tempos abaixo vêm das minhas execuções. Escrevi este post originalmente sobre a 2.52.1; os scripts rodaram sem alterações na 2.59.0, e os números se mantiveram, exceto no teste de template (veja o Teste 8). A coisa mais importante a saber antes de começar: o timeout padrão é de 5 minutos e a ação padrão no timeout é kill. Se você não optar pela pausa, seu sandbox e tudo o que há nele some cinco minutos após a criação. A Parte 2 trata de credenciais: como dar API keys a um agent no sandbox sem colocar as chaves dentro dele.
Arquitetura
Existem dois planos. A E2B API cuida das operações de ciclo de vida (create, connect, list, pause, fork, snapshot, kill). Dentro de cada VM, um pequeno daemon chamado envd atende comandos, o filesystem e os streams de processos, e um proxy expõe qualquer porta como https://<port>-<sandbox-id>.e2b.app.
Três coisas nessa imagem importam para o resto do post:
| Estado | Cobrado? | Conta para a concorrência? | Expira? |
|---|---|---|---|
| Running | Sim, por segundo (vCPU + RAM) | Sim | No seu timeout (kill ou pause) e no limite de runtime do plano (1 h no Hobby, 24 h no Pro) |
| Paused | Não | Não | Nunca. A E2B não apaga sandboxes pausados por conta própria |
| Killed | Não | Não | Some para sempre |
Não existe uma chamada resume() separada no SDK: você retoma chamando connect(). E pausar zera o relógio de runtime contínuo, então um sandbox que pausa e retoma pode ultrapassar o limite de 1 h / 24 h indefinidamente.
Setup
Passo 1: Conta e API key
Cadastre-se em e2b.dev e crie uma chave em API Keys no console. O plano Hobby é gratuito e vem com $100 de crédito de uso único, o que equivale a aproximadamente 900 horas de um sandbox padrão. Todo este passo a passo me custou cerca de um centavo (mais sobre isso em Preços).
Passo 2: Instalar o SDK e o código de apoio
git clone https://github.com/fabiodouek/my2centsai-blog-samples.git
cd my2centsai-blog-samples/e2b-sandbox-lifecycle
cp .env.example .env            # paste E2B_API_KEY=e2b_...
uv venv && uv pip install -e .  # installs e2b==2.59.0 + python-dotenv
source .venv/bin/activate
O SDK Python exige Python 3.11+ (a 2.56.0 removeu o suporte ao 3.10). Fixei e2b==2.59.0 de propósito: a E2B lança releases do SDK a cada poucos dias (cerca de 40 releases do SDK JS entre meados de junho e o início de outubro de 2026), e versões minor já mudaram padrões. Por exemplo, a 2.51.0 moveu create e connect para novos endpoints v2 e deixou de definir padrões no lado do cliente para timeout e recursos. Atualize a versão fixada de forma deliberada.
A CLI é opcional, mas útil para inspeção e limpeza: npx @e2b/cli sandbox list (ou npm i -g @e2b/cli / brew install e2b).
Passo 3: Marcar tudo com tags
Todo script marca seus sandboxes com metadata, para que a limpeza no final só toque no que a demo criou:
# common.py
DEMO_TAG = {"demo": "my2cents-lifecycle"}

def tagged(**extra: str) -> dict:
    return {**DEMO_TAG, **extra}
Recomendo o mesmo hábito em produção: marque por usuário, ambiente e job, porque a metadata é como você encontra os sandboxes de novo depois.
Testes
Teste 1: Criar um sandbox e inspecionar os padrões
python 01_create.py # optional arg: number of timed creates (default 5)from e2b import Sandbox
sbx = Sandbox.create(metadata=tagged(test="01"))
info = sbx.get_info()
print(info.cpu_count, info.memory_mb, info.end_at - info.started_at, info.lifecycle)[ 0.85s] Sandbox.create()
template : base (rki5dems9wqfm4r03t7g)
state : running
cpu / mem : 2 vCPU / 512 MiB
lifetime : 300s
lifecycle : {'on_timeout': <SandboxOnTimeout.KILL: 'kill'>, 'auto_resume': False}
envd : 0.10.0
=== 5 sequential creates ===
[ 0.79s] create #1
[ 0.83s] create #2
[ 0.33s] create #3
[ 0.23s] create #4
[ 0.33s] create #5
median 0.33s | min 0.23s | max 0.83sIsso confirma os padrões documentados: 2 vCPU, 512 MiB, timeout de 300 segundos e kill no timeout. Cinco creates sequenciais tiveram mediana de 0.33 s, medidos a partir do meu laptop, de ponta a ponta, incluindo o round trip do SDK.
Duas outras observações. free -m dentro da VM reporta 473 MiB no total, um pouco abaixo dos 512 nominais. E o filesystem raiz mostrou 22 GB (22.8 GB no console), embora a documentação de cobrança liste 10 GiB de disco para o Hobby. Não sei dizer se isso é uma franquia temporária ou uma defasagem da documentação, então não planeje em cima disso.
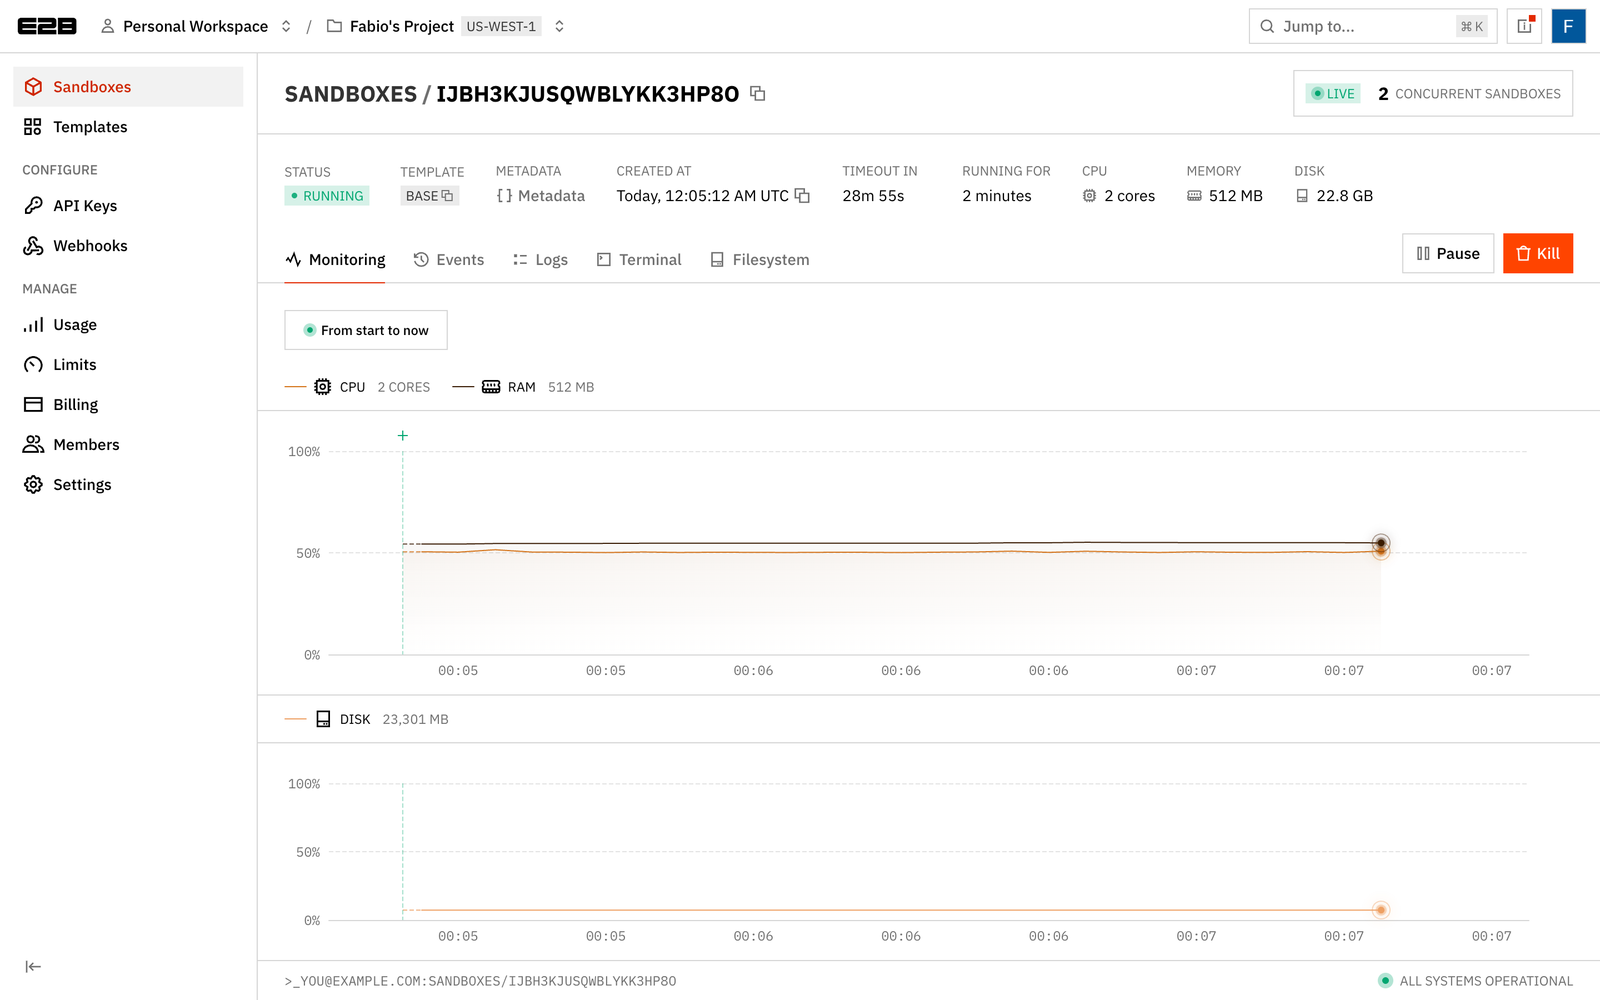
O console mostra cada sandbox ao vivo, com gráficos de CPU, RAM e disco, o timeout restante e os botões Pause e Kill:
Teste 2: Comandos, arquivos e o timeout de comando
python 02_commands_files.pyPor padrão, os comandos são bloqueantes; eles podem fazer stream de stdout e stderr através de callbacks, ou rodar em background e te devolver um handle:
sbx.commands.run(
    "for i in 1 2 3; do echo tick $i; sleep 1; done",
    on_stdout=lambda line: print(f"  stream> {line.strip()}"),
)

sbx.files.write("/home/user/notes/hello.txt", "hello from my laptop\n")
sbx.files.write_files([
    {"path": "/home/user/notes/a.txt", "data": "a"},
    {"path": "/home/user/notes/b.txt", "data": "b"},
])

server = sbx.commands.run(
    "cd /home/user/notes && python3 -m http.server 3000",
    background=True,
    timeout=0,  # without this the default 60s command timeout kills it
)
print(f"https://{sbx.get_host(3000)}/hello.txt")
exit=0
Python 3.11.6
user
/home/user
stream> tick 1
stream> tick 2
stream> tick 3
hello from my laptop
file a.txt
file b.txt
file hello.txt
server pid: 1529
running: pid=1529 cmd=/bin/bash -l -c cd /home/user/notes && python3 -m http.server 3000
preview URL: https://3000-iwmtv6w8e12wb0ceo7b5i.e2b.app/hello.txt
[ 3.00s] sleep 10 with timeout=3
TimeoutException: Request timed out: ...A pegadinha está nessa última linha. Os comandos têm seu próprio timeout, de 60 segundos por padrão, e ele mata o processo mesmo quando background=True. Um dev server ou um processo de agent de longa duração precisa de timeout=0. Duas notas menores sobre a API: o Python usa write_files() para múltiplos arquivos, enquanto o JavaScript sobrecarrega write(), e o código roda como user em /home/user por padrão. Um relato de produção da Codecloud acrescenta outra pegadinha: um commands.run() bloqueante também espera pelos processos filhos, então qualquer coisa que vire daemon deve ser iniciada com background=True.
O console tem um terminal no navegador para cada sandbox em execução, que é a forma mais rápida de fuçar durante o debug. Não espere encontrar o sandbox do script ali: 02_commands_files.py o mata na última linha. Para este screenshot, iniciei manualmente um sandbox separado com um processo queimando CPU e o mantive vivo (ele não faz parte do código de apoio):
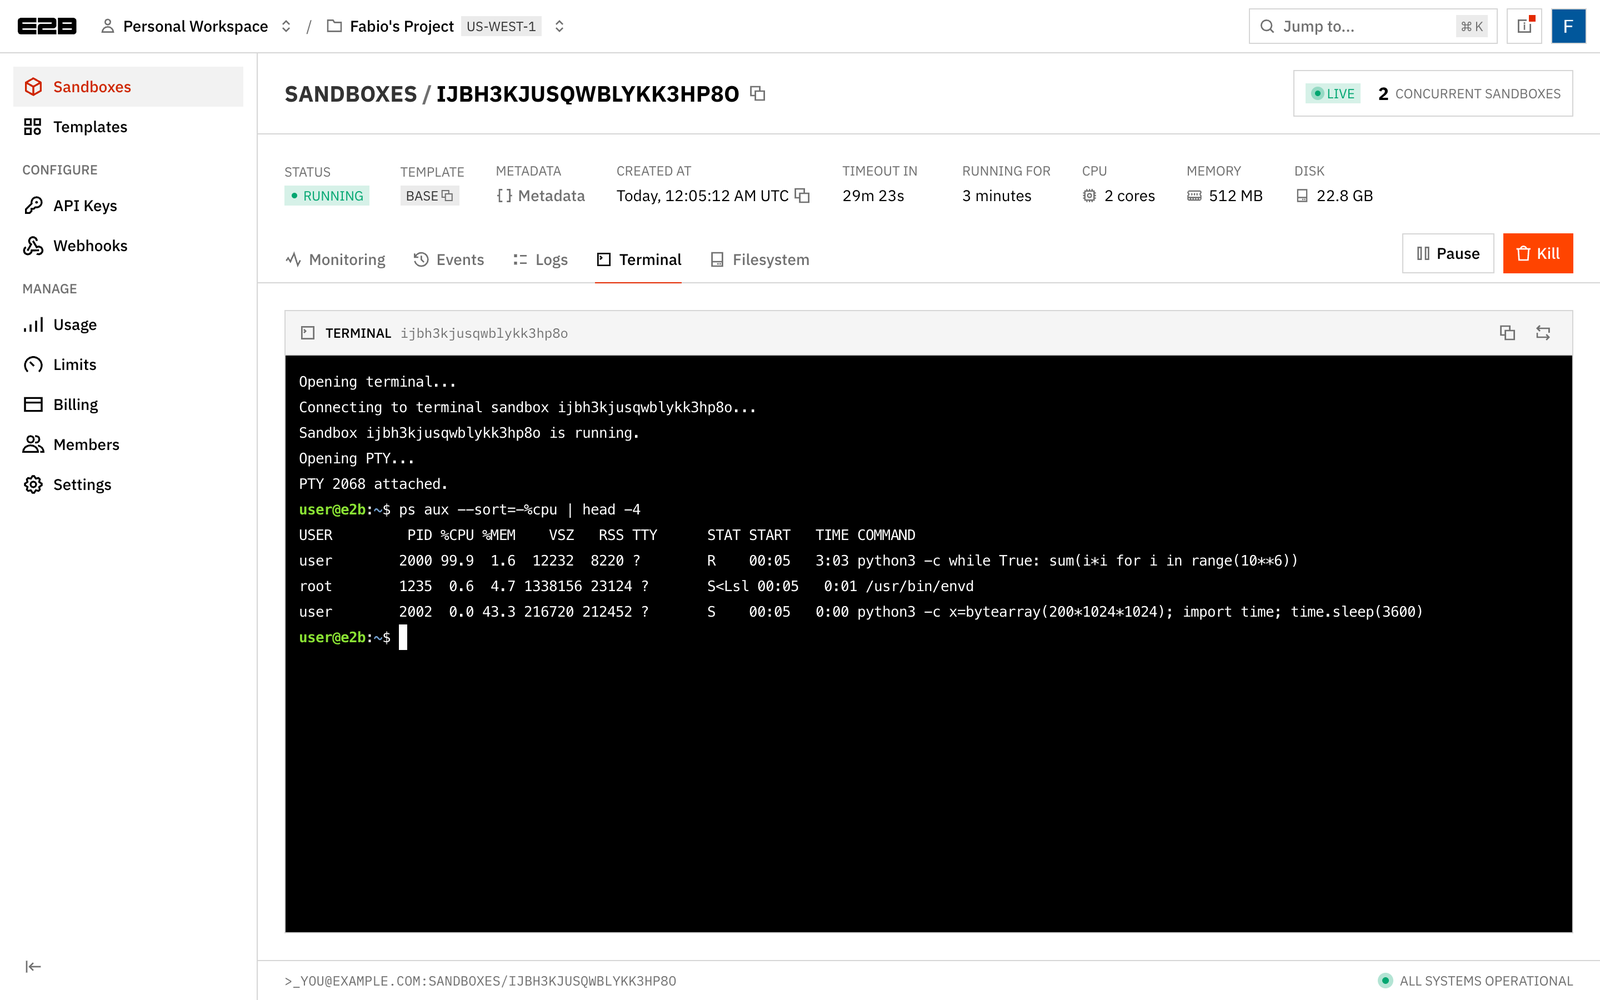
Repare no processo /usr/bin/envd rodando como root: é o daemon dentro da VM do diagrama de arquitetura. Um efeito colateral que notei: abrir a aba Terminal empurrou o timeout restante daquele sandbox de cerca de 24 minutos para cerca de 30. A conexão de terminal do console parece estender o timeout da mesma forma que um connect() do SDK faria, então um sandbox que você está observando no navegador pode viver mais do que o seu código pediu.
Teste 3: Timeouts, set_timeout vs connect
python 03_timeouts.pysbx = Sandbox.create(timeout=120, metadata=tagged(test="03"))
sbx.set_timeout(20) # exact: 20 s from now, can shorten
sbx.connect(timeout=5) # only extends, never shortens
time.sleep(remaining(sbx) + 10)
Sandbox.get_info(sandbox_id)remaining: 119s (asked for 120)
set_timeout(20): exact, can shorten -> remaining: 19s
connect(timeout=5): only extends, never shortens -> remaining: 19s
gone: SandboxNotFoundException: Sandbox ikxrlwxsu5gsoiu2ba98y not found
listed: FalseEsse é o comportamento que pega as pessoas desprevenidas. set_timeout() define a expiração para exatamente agora + N. connect(timeout=N) a define como max(expiração atual, agora + N), então um timeout curto no connect é ignorado silenciosamente. E quando o timer acaba com o ciclo de vida padrão, o sandbox não pausa: ele é apagado, com arquivos e tudo.
Atenção também às unidades. O Python recebe segundos (timeout=60), o JavaScript recebe milissegundos (timeoutMs: 60_000). Portar um snippet de um para o outro sem converter te dá um sandbox que morre depois de cerca de um segundo (o SDK JS arredonda para cima, para segundos inteiros), ou um que pede 16 horas e roda até o limite de 1 h ou 24 h do seu plano.
on_timeout="Pause" não era rejeitado, então o sandbox caía no padrão e era morto no timeout em vez de pausado.
Teste 4: Pause e resume, três ciclos
python 04_pause_resume.py 3 # number of pause/resume cyclesEssa é a feature que diferencia a E2B, então testei com mais rigor. O script inicia um processo Python cujo contador vive apenas na memória do processo (espelhado em um arquivo para que eu possa lê-lo), escreve um arquivo a cada ciclo, depois pausa, espera 10 segundos e retoma, três vezes. No final, ele se reconecta ao stream de stdout do processo.
counter = sbx.commands.run(
    "python3 -u -c \"import time\n"
    "i = 0\n"
    "while True:\n"
    "    i += 1\n"
    "    print(i)\n"
    "    open('/tmp/counter', 'w').write(str(i))\n"
    "    time.sleep(1)\"",
    background=True,
    timeout=0,
)

for cycle in range(1, 4):
    before = sbx.files.read("/tmp/counter")
    sbx.pause()
    time.sleep(10)       # wall clock moves, the sandbox doesn't
    sbx.connect()        # this is "resume"
    after = sbx.files.read("/tmp/counter")
=== Cycle 1 ===
[ 0.73s] pause()
state: paused
[ 0.24s] connect() / resume
counter before=5 after=6 (continues, not reset => memory restored)
pid 1520: alive
files: ['cycle-1.txt', 'state.txt']
=== Cycle 2 ===
[ 0.69s] pause()
[ 0.23s] connect() / resume
counter before=6 after=7
pid 1520: alive
files: ['cycle-1.txt', 'cycle-2.txt', 'state.txt']
=== Cycle 3 ===
[ 0.70s] pause()
[ 0.25s] connect() / resume
counter before=8 after=9
pid 1520: alive
files: ['cycle-1.txt', 'cycle-2.txt', 'cycle-3.txt', 'state.txt']
=== Reattach to the counter's stdout after resume ===
lines received in 6s: 6 ['13', '14', '15']
stream OKOs três ciclos passaram:
- A memória sobrevive. O contador foi de 5 para 6 em uma pausa de 10 segundos, não de 5 para 15 e nem de volta para 1. O processo foi congelado, não reiniciado.
- Os processos sobrevivem. Mesmo PID do início ao fim.
- Os arquivos sobrevivem. Todos os arquivos de ciclo estavam presentes após cada resume.
- O pause levou 0.69–0.73 s, o resume 0.23–0.25 s. A documentação cita cerca de 4 segundos por GiB de RAM para o pause e cerca de 1 s para o resume. Meus sandboxes usavam só algumas dezenas de MiB, o que provavelmente explica por que fiquei bem abaixo disso. Conte com o número documentado se seus sandboxes guardam memória de verdade: um sandbox de 8 GiB pode levar cerca de 32 segundos para pausar.
- A reconexão ao stdout funcionou. Testei isso especificamente porque há reports em aberto de alta prioridade sobre streams de stdout travando quando você se reconecta após um resume (E2B#1587, entre outros). Nas minhas execuções na 2.52.1, e de novo na 2.59.0, o stream entregou todas as linhas. São duas execuções, não uma prova de que o bug foi corrigido.
Pause e resume é a área com mais issues em aberto e mais incidentes recentes do serviço (a pesquisa que fiz na comunidade contou cinco incidentes de pause, resume ou connect no histórico da status page entre julho e o início de outubro de 2026, o mais recente em 2026-10-02). Um bug de persistência do filesystem em resumes repetidos (E2B#884) foi fechado como corrigido e depois reportado de novo por um usuário. Nada disso apareceu nos meus testes, mas se o estado pausado é o seu produto, inclua verificação: checksums ou um arquivo canário que você confere após cada resume.
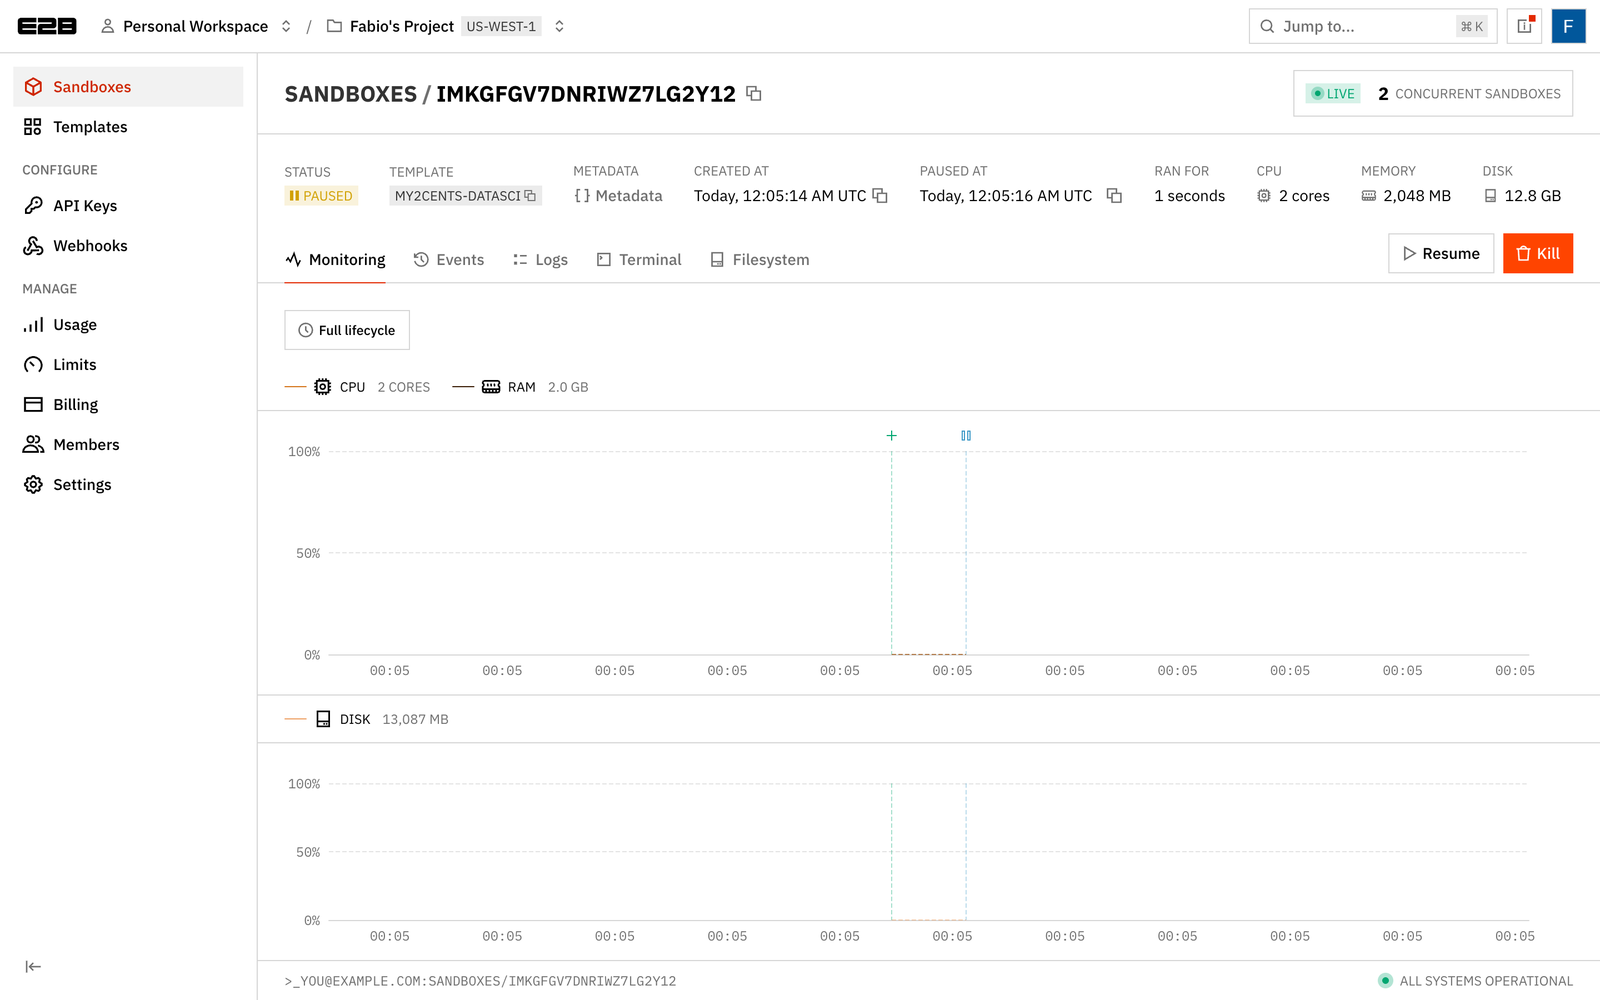
No console, um sandbox pausado mostra Resume em vez de Pause, além de quando ele foi pausado e por quanto tempo rodou:
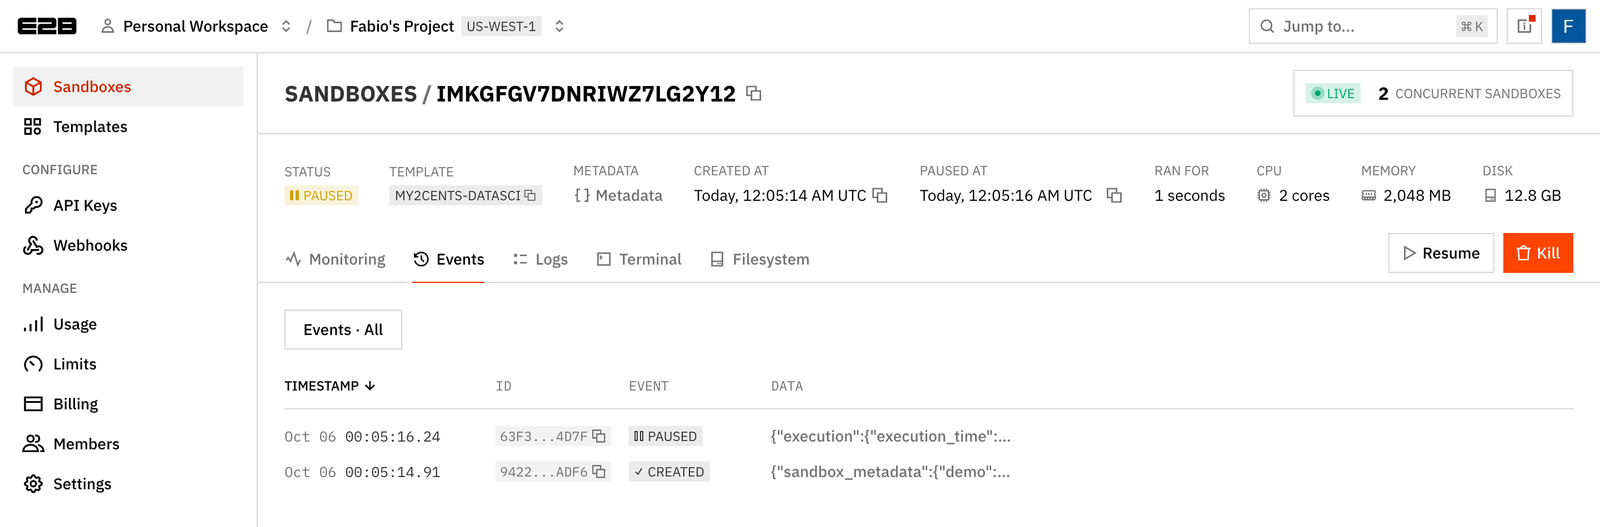
A aba Events registra cada transição de ciclo de vida. São os mesmos eventos que você pode assinar com lifecycle webhooks, que trazem tempo de execução e recursos caso você queira fazer sua própria contabilidade de custos:
Se você não precisa da memória restaurada, sbx.pause(mode="filesystem") tira um snapshot só do filesystem (ele substituiu keep_memory=False no SDK 2.55.0): os arquivos sobrevivem, os processos não, e o próximo resume é um reboot (docs).
Teste 5: Auto-pause no timeout e auto-resume com atividade
python 05_auto_resume.pyPause manual serve para scripts. Para um produto, você quer que o sandbox se pause sozinho quando ocioso e acorde quando algo encostar nele. São duas flags de ciclo de vida:
sbx = Sandbox.create(
    timeout=20,
    metadata=tagged(test="05"),
    lifecycle={"on_timeout": "pause", "auto_resume": True},
)
sbx.files.write("/home/user/hello.txt", "hello from a paused sandbox\n")
sbx.commands.run("cd /home/user && python3 -m http.server 3000", background=True, timeout=0)

# ...poll Sandbox.get_info(id).state until "paused"...
content = sbx.files.read("/home/user/hello.txt")   # wakes it
lifecycle: {'on_timeout': <SandboxOnTimeout.PAUSE: 'pause'>, 'auto_resume': True}
preview URL: https://3000-in85jhl0d77kt9gq2bwtk.e2b.app/hello.txt
=== Wait for timeout -> auto-pause ===
paused after ~21s of polling
=== Wake with files.read() ===
[ 0.25s] files.read on paused sandbox
hello from a paused sandbox
state after read: running, new end_at: 2026-10-25 09:12:35+00:00
=== Pause again, wake with HTTP ===
state: paused
HTTP 200: hello from a paused sandbox
[ 0.33s] GET preview URL on paused sandbox
state after HTTP: runningOs dois caminhos de despertar funcionaram. Um files.read() contra o sandbox pausado retornou o conteúdo em 0.25 s sem nenhuma chamada explícita de resume. Um HTTP GET na preview URL pública acordou o sandbox, restaurou o http.server que ainda estava rodando e retornou HTTP 200 em 0.33 s. Esse segundo caminho é o interessante: um ambiente de preview ou o web app de um agent pode dormir com custo zero de computação e acordar na primeira requisição.
Dois detalhes da execução. Fazer polling de Sandbox.get_info() a cada 5 segundos não o acordou, então checagens de status são seguras. Depois de acordar, o sandbox ganha pelo menos 5 minutos de runtime (ou seu timeout original, se for maior) antes de se auto-pausar de novo, e a configuração de ciclo de vida persiste entre os ciclos. auto_resume exige o pause que preserva memória; não dá para combiná-lo com mode="filesystem".
Teste 6: List, filtro e connect a partir de outro processo
python 06_list_connect.pyEm um sistema real, o processo que cria um sandbox raramente é o mesmo que o usa depois. Metadata mais Sandbox.list() é como você o encontra, e Sandbox.connect(id) é como você o retoma:
from e2b import Sandbox, SandboxQuery, SandboxState

paginator = Sandbox.list(
    query=SandboxQuery(metadata={"userId": "alice"},
                       state=[SandboxState.RUNNING, SandboxState.PAUSED]),
    limit=100,
)
items = paginator.next_items()
while paginator.has_next:
    items.extend(paginator.next_items())

# ...in a different Python process, with only the ID:
sbx = Sandbox.connect(sandbox_id)
Create three tagged sandboxes
i9vnw3wxcwi7wg2plqbd6 userId=alice
ib9sorwzv31movgjuqfhv userId=alice
iv0ti2xxvalw7yiw4u2s1 userId=bob
paused ib9sorwzv31movgjuqfhv
default (no query): 3
state=running: 2
state=paused: 1
userId=alice, any state: 2
ib9sorwzv31movgjuqfhv paused userId=alice
i9vnw3wxcwi7wg2plqbd6 running userId=alice
Connect from another process (resumes the paused one)
[ 0.76s] Sandbox.connect(id) from second process
[worker] read: owned by alice
back in parent, worker file: the worker was here
state now: runningFiltrar por metadata e estado funciona como documentado, e o paginator limita as páginas a 100. Um segundo processo, sem relação com o primeiro, se conectou ao sandbox pausado pelo ID em 0.76 s, o que o retomou, e escreveu um arquivo que o processo pai depois leu. Dois padrões diferem entre as ferramentas: Sandbox.list() no SDK retorna sandboxes em execução e pausados, enquanto e2b sandbox list na CLI mostra apenas os em execução, a menos que você passe --state running,paused. É um jeito fácil de se convencer de que não tem sandboxes sobrando quando tem.
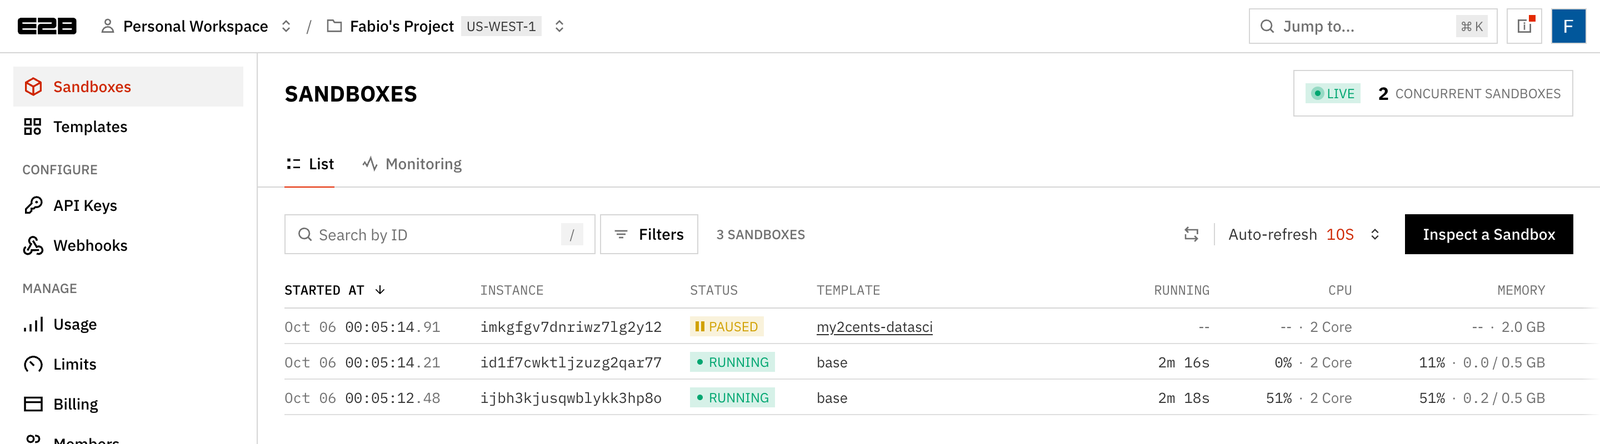
A lista de sandboxes do console mostra o mesmo quadro. Repare no contador no canto superior direito: três sandboxes estão listados, mas só dois contam como concorrentes, porque sandboxes pausados não contam para o limite de concorrência do plano (20 no Hobby):
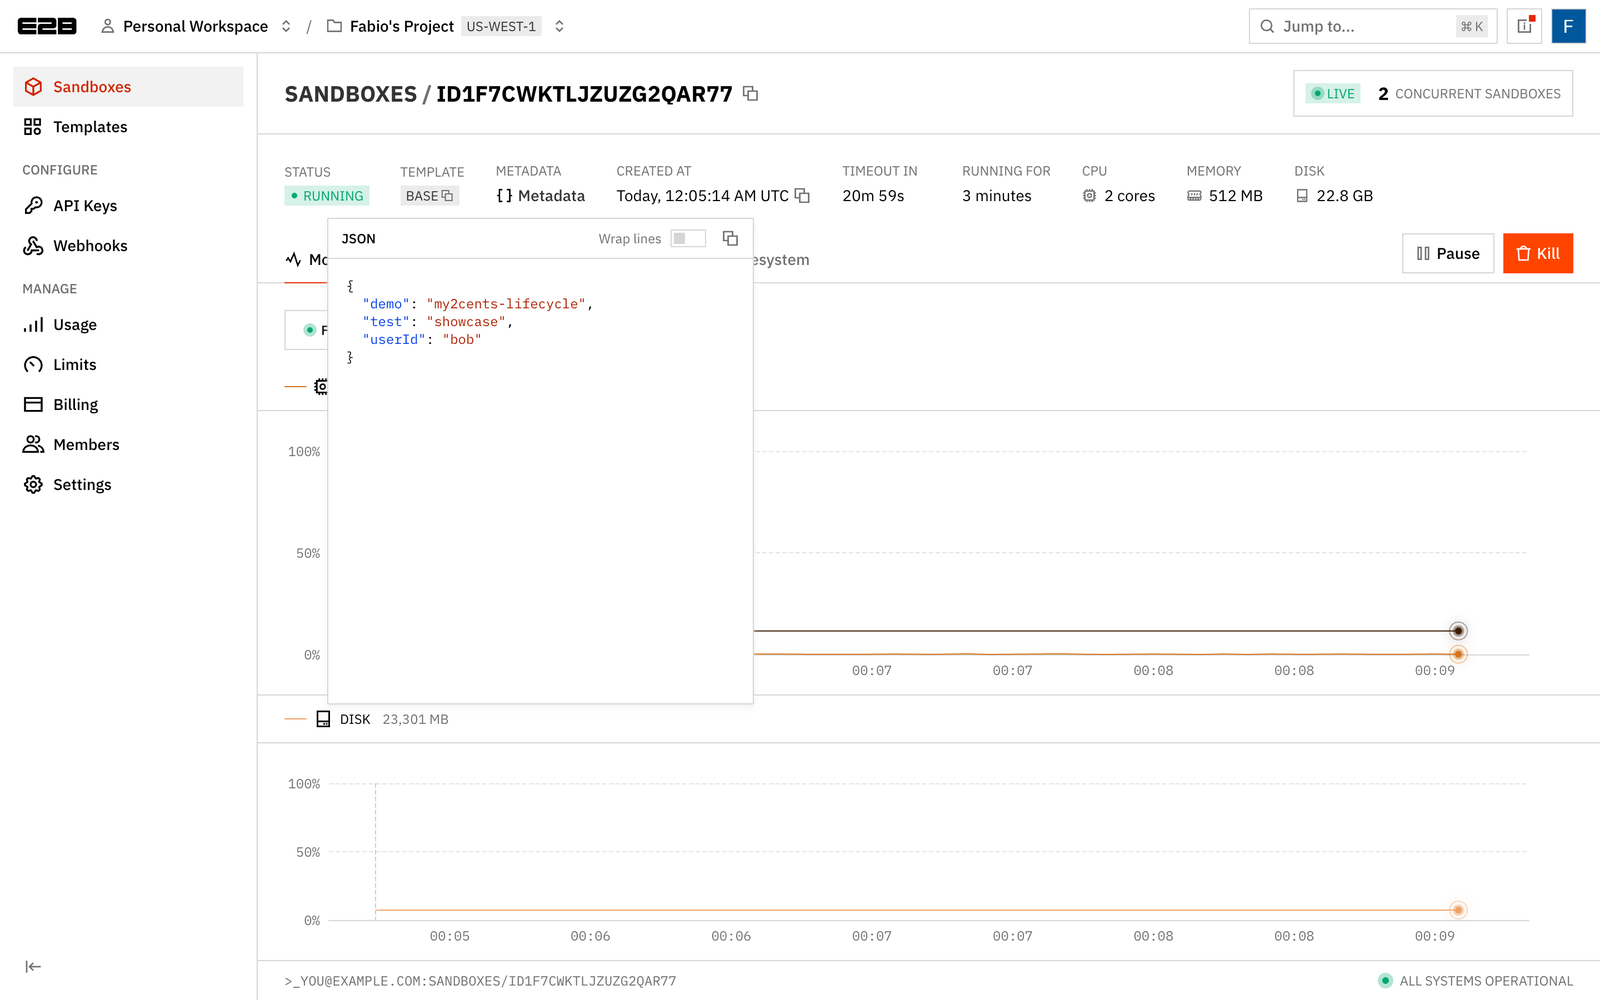
A metadata fica visível por sandbox, o que ajuda quando você está rastreando o sandbox de um usuário a partir de um ticket de suporte:
Teste 7: Fork e snapshot
python 07_fork_snapshot.pyO fork foi lançado em julho de 2026 (SDK 2.34.0 para Python), com um comando na CLI vindo em setembro. Um fork é um novo sandbox que parte dos arquivos, processos e memória do original. Snapshots são a versão persistente: capture uma vez, crie vários sandboxes a partir dele depois.
results = sbx.fork(count=3, timeout=120)  # always pass timeout: the SDK default is 15s
forks = [r for r in results if isinstance(r, Sandbox)]
errors = [r for r in results if not isinstance(r, Sandbox)]

snap = sbx.create_snapshot(name="my2cents-lifecycle-demo")
restored = Sandbox.create(snap.snapshot_id, timeout=120)
=== Fork x3 ===
[ 0.57s] fork(count=3, timeout=120)
forks: 3, errors: 0 []
fork 1 i85nwpvq3ryakayuvdh54: state.txt='shared state' counter=6 pid 1520 alive
fork 2 iajm0ldx33wti61hts3qr: state.txt='shared state' counter=7 pid 1520 alive
fork 3 it8v5xxsvk7nfgsynbfjp: state.txt='shared state' counter=8 pid 1520 alive
original sees fork writes? no (forks diverge)
original counter still running: 8
=== Snapshot -> new sandbox ===
[ 0.44s] create_snapshot()
snapshot: <project>/my2cents-lifecycle-demo:default
[ 0.38s] Sandbox.create(snapshot_id)
restored ih2d669g297p9phu40tjb: 'shared state'
deleted snapshot: TrueTrês forks em 0.57 s, cada um com o arquivo do pai e o processo contador do pai ainda rodando com o mesmo PID. As escritas nos forks não vazaram de volta para o original. Um snapshot levou 0.44 s e um novo sandbox a partir dele, 0.38 s. Essa é a primitiva para “testar três abordagens em paralelo a partir do mesmo estado” em workflows de agents, ou para fazer checkpoint antes de um passo arriscado.
O que saber antes de depender disso:
fork()retorna uma lista que mistura objetosSandboxe exceções em falhas parciais em vez de lançar erro, então filtre os resultados como acima.- O SDK limita uma chamada de fork a 20 cópias (a API permite até 100), e a quantidade precisa caber no seu limite de concorrência.
- Forks têm timeout padrão de 15 segundos no SDK e na API, enquanto a documentação da CLI fala em 5 minutos. Passe
timeoutexplicitamente, ou seus forks desaparecem no meio da demo. - O fork pausa brevemente o original para tirar o snapshot, então os streams abertos dele caem. Planeje reconectar.
- Fazer fork de um sandbox pausado atualmente retorna HTTP 409; o suporte a isso ainda é uma proposta em aberto no repositório do runtime. Retome antes.
A documentação de snapshots da E2B faz uma distinção útil: para um setup que você repete (os mesmos packages, os mesmos arquivos toda vez), um template é mais rápido que um snapshot, porque templates são capturados após um boot limpo com memória compacta. Snapshots e forks servem para capturar um estado ativo que você não consegue recriar facilmente.
Teste 8: Um template customizado vs instalar em runtime
python template/build.py   # one-off build, about a minute
python 08_template.py
Templates são o equivalente da E2B a uma imagem Docker, construídos com um builder code-first (Dockerfiles também funcionam). Aqui está um pequeno template de data science:
# template/template.py
from e2b import Template

template = (
    Template()
    .from_base_image()
    .pip_install(["pandas", "numpy", "matplotlib"])
    .set_envs({"MPLBACKEND": "Agg"})
)

# template/build.py
Template.build(template, "my2cents-datasci", cpu_count=2, memory_mb=2048,
               on_build_logs=default_build_logger())
O build levou 53 segundos. CPU e RAM são definidos em tempo de build, por template; não dá para redimensionar um sandbox em Sandbox.create(). Depois comparei o tempo até o primeiro import pandas no template base (instalando em runtime) contra o template customizado:
=== Base template + pip install at runtime ===
[  0.42s] create
[ 11.86s] pip install pandas numpy matplotlib
[  1.29s] first import
  time to first import: 13.58s

=== my2cents-datasci (run 1) ===
[  0.79s] create
[  7.15s] first import
[  1.06s] second import
  time to first import: 7.94s

=== my2cents-datasci (run 2) ===
[  0.56s] create
[  8.50s] first import
[  0.57s] second import
  time to first import: 9.06s

speedup vs base: run 1 1.7x, run 2 1.5x
Só cerca de 1.6x de ganho, e tudo vem de pular os 11.9 s do pip install. O primeiro import no template comeu a maior parte do ganho: 7–8.5 s, contra 0.6–1.1 s de um segundo import no mesmo sandbox, e 1.3 s logo após uma instalação nova no template base. Meu palpite é que o filesystem do template é carregado sob demanda, então a primeira leitura dos arquivos do pandas paga para buscá-los, e a execução no template base não pagou porque o pip tinha acabado de escrever esses arquivos localmente. Trate isso como hipótese. Se a latência do caminho a frio importa para você, um set_start_cmd que pré-importa suas libraries pesadas durante o build deve mover esse custo para dentro do snapshot. O time do lakeFS relatou que o tempo até o sandbox ficar pronto caiu de cerca de 19 s para cerca de 1 s depois de embutir as dependências em um template, que é a mesma ideia em escala maior.
Esse custo do primeiro import também não é estável. Quando rodei este teste pela primeira vez, três semanas antes, no SDK 2.52.1, o primeiro import no template levou só 3–4 s, um ganho de 3.7x. Na 2.59.0, com um template recém-reconstruído, levou 6.4–8.5 s em quatro execuções (1.5–2.0x), enquanto o caminho de instalação em runtime mal se mexeu. Não sei dizer se o responsável é o SDK, o rebuild ou a plataforma da E2B, o que é mais um motivo para pré-importar durante o build.
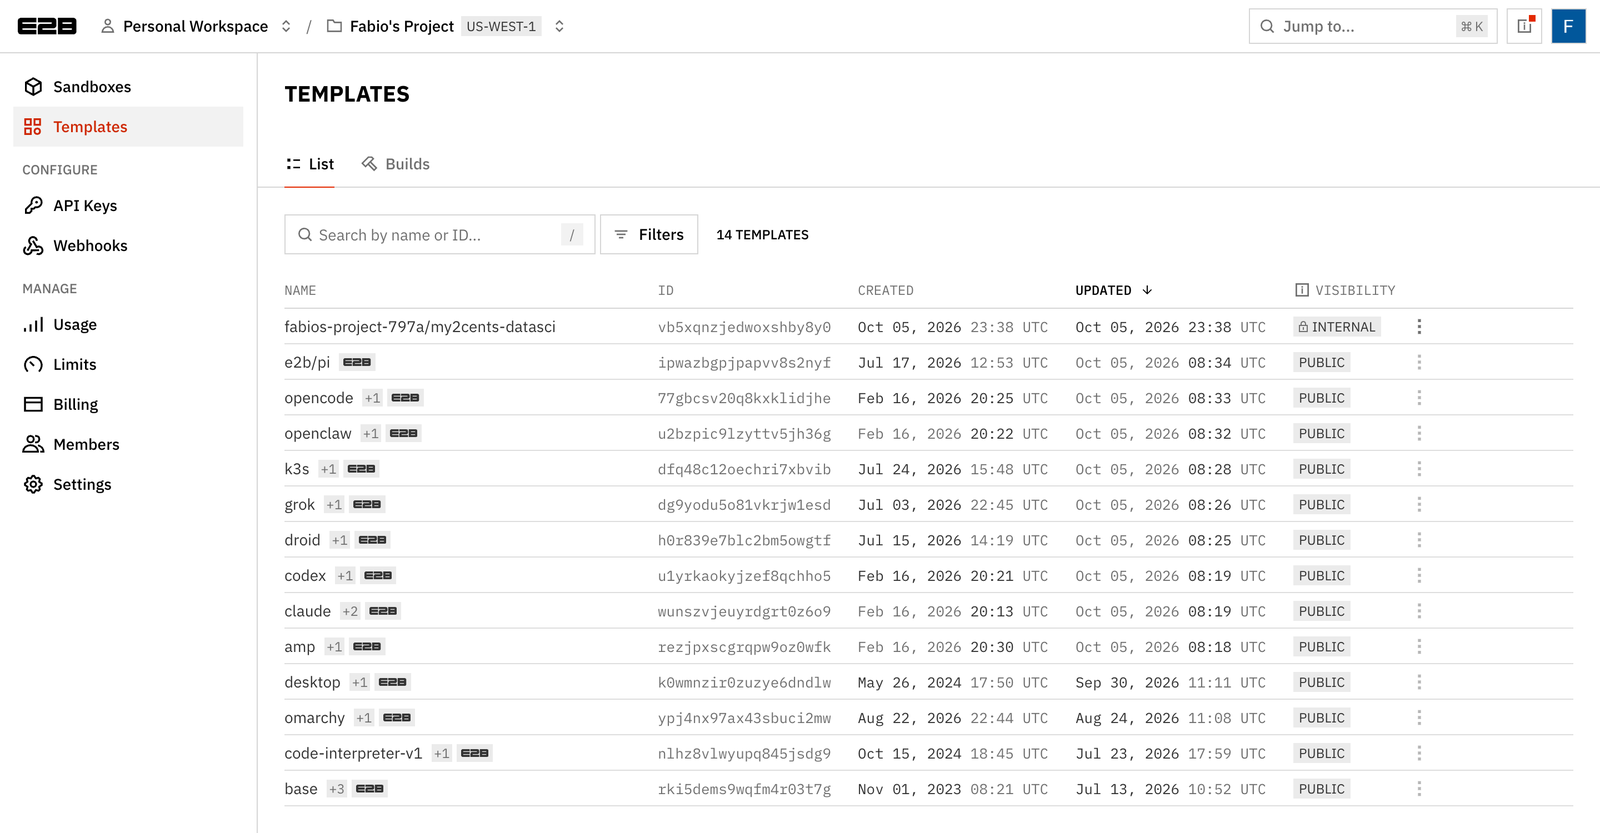
A página Templates do console lista seus templates privados ao lado dos públicos da E2B, que agora incluem imagens prontas para coding agents (claude, codex, opencode, amp e outros):
Resumo dos resultados
| Operação | Medido (SDK 2.59.0, Hobby, us-west-1, a partir do meu laptop) |
|---|---|
Sandbox.create() (base, sequencial) | mediana 0.33 s (0.23–0.83 s, n=5) |
pause() (sandbox com pouca memória) | 0.69–0.73 s |
Resume com connect() | 0.23–0.25 s |
Auto-resume via files.read() | 0.25 s |
| Auto-resume via HTTP na preview URL | 0.33 s |
Sandbox.connect(id) a partir de um segundo processo (paused → running) | 0.76 s |
fork(count=3) | 0.57 s |
create_snapshot() / create a partir do snapshot | 0.44 s / 0.38 s |
| Build do template (pandas, numpy, matplotlib) | 53 s |
Tempo até o primeiro import pandas: instalação em runtime vs template | 13.58 s vs 7.94–9.06 s |
São medições em uma única região, a partir de um laptop numa conexão residencial, com sandboxes que usavam muito pouca memória. Use-as como noção de escala, não como benchmark.
Preços
A E2B cobra por segundo enquanto um sandbox está em execução, pela vCPU e RAM alocadas, não pelo que ele usa (documentação de cobrança):
| Recurso | Tarifa | Por hora |
|---|---|---|
| vCPU | $0.000014 / vCPU-segundo | $0.0504 |
| RAM | $0.0000045 / GiB-segundo | $0.0162 |
| Sandbox padrão (2 vCPU, 512 MiB) | ≈ $0.109 | |
| Sandbox pausado ou morto | grátis | $0 |
| Plano | Mensal | Incluso | Runtime contínuo máximo | Sandboxes concorrentes |
|---|---|---|---|---|
| Hobby | $0 | $100 de crédito único | 1 hora | 20 |
| Pro | $150 + uso | Sem crédito extra | 24 horas | 100 (600 por +$500/mês, 1,100 por +$1,000/mês) |
| Enterprise | a partir de $3,000 | Personalizado | Personalizado | Personalizado |
A taxa do Pro compra limites, não computação: sessões mais longas, mais concorrência, tetos maiores de CPU e RAM por template (o Hobby já permite até 8 vCPU e 8 GiB) e mais chamadas de create por segundo (5/s vs 1/s no Hobby). O armazenamento de templates e snapshots é gratuito hoje, embora a documentação diga que a cobrança pelo armazenamento de templates “pode ser introduzida no futuro”.
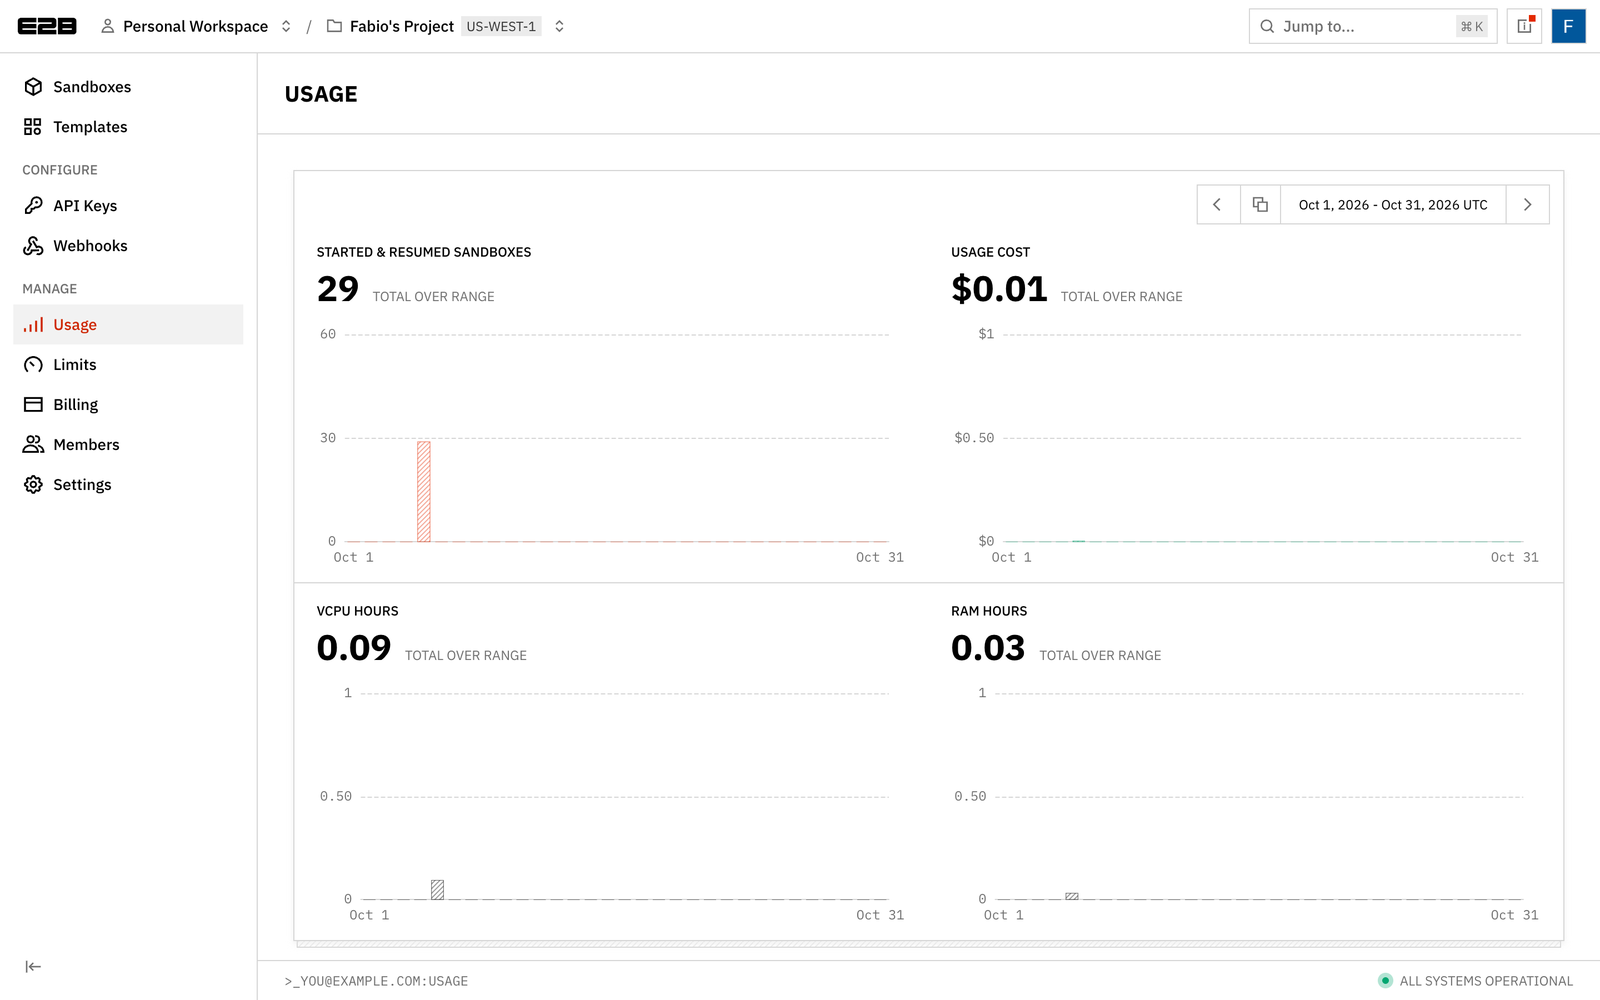
Para dar uma escala: minha execução de testes original no SDK 2.52.1 (29 sandboxes iniciados ou retomados, um build de template) saiu por $0.01, segundo a página Usage do console:
Limpeza
Sandboxes pausados nunca expiram, não são cobrados e não contam para a concorrência, o que os torna fáceis de esquecer. O cookbook da E2B chegou a adicionar um script de limpeza em 2026-09-30 que o suporte, segundo relatos, entrega aos clientes que pedem um TTL para sandboxes pausados. O último script do repositório de apoio mata tudo o que carrega a tag da demo:
from e2b import Sandbox, SandboxQuery, SandboxState

paginator = Sandbox.list(
    query=SandboxQuery(metadata={"demo": "my2cents-lifecycle"},
                       state=[SandboxState.RUNNING, SandboxState.PAUSED]),
    limit=100,
)
while True:
    for info in paginator.next_items():
        Sandbox.kill(info.sandbox_id)
    if not paginator.has_next:
        break

for s in Sandbox.list_snapshots(name="my2cents-lifecycle-demo").next_items():
    Sandbox.delete_snapshot(s.snapshot_id)
=== Sandboxes tagged {'demo': 'my2cents-lifecycle'} ===
kill imkgfgv7dnriwz7lg2y12 (paused): True
kill id1f7cwktljzuzg2qar77 (running): True
kill ijbh3kjusqwblykk3hp8o (running): True
killed 3
=== Snapshots named my2cents-* ===
deleted 0Um Sandbox.list() posterior abrangendo os estados running e paused retornou zero sandboxes, e Sandbox.list_snapshots() retornou zero snapshots (o snapshot da demo do Teste 7 já tinha sido apagado lá).
O equivalente na CLI, que também precisa do filtro de estado explícito:
npx @e2b/cli sandbox kill --all --state=running,paused --metadata=demo=my2cents-lifecyclePor fim, defina um teto. A página Limits do console tem um limite rígido de uso, que bloqueia todas as requisições de API quando você o atinge em um período de cobrança, além de um alerta de uso mais brando. E-mails automáticos são enviados em 50%, 80%, 90% e 100%:
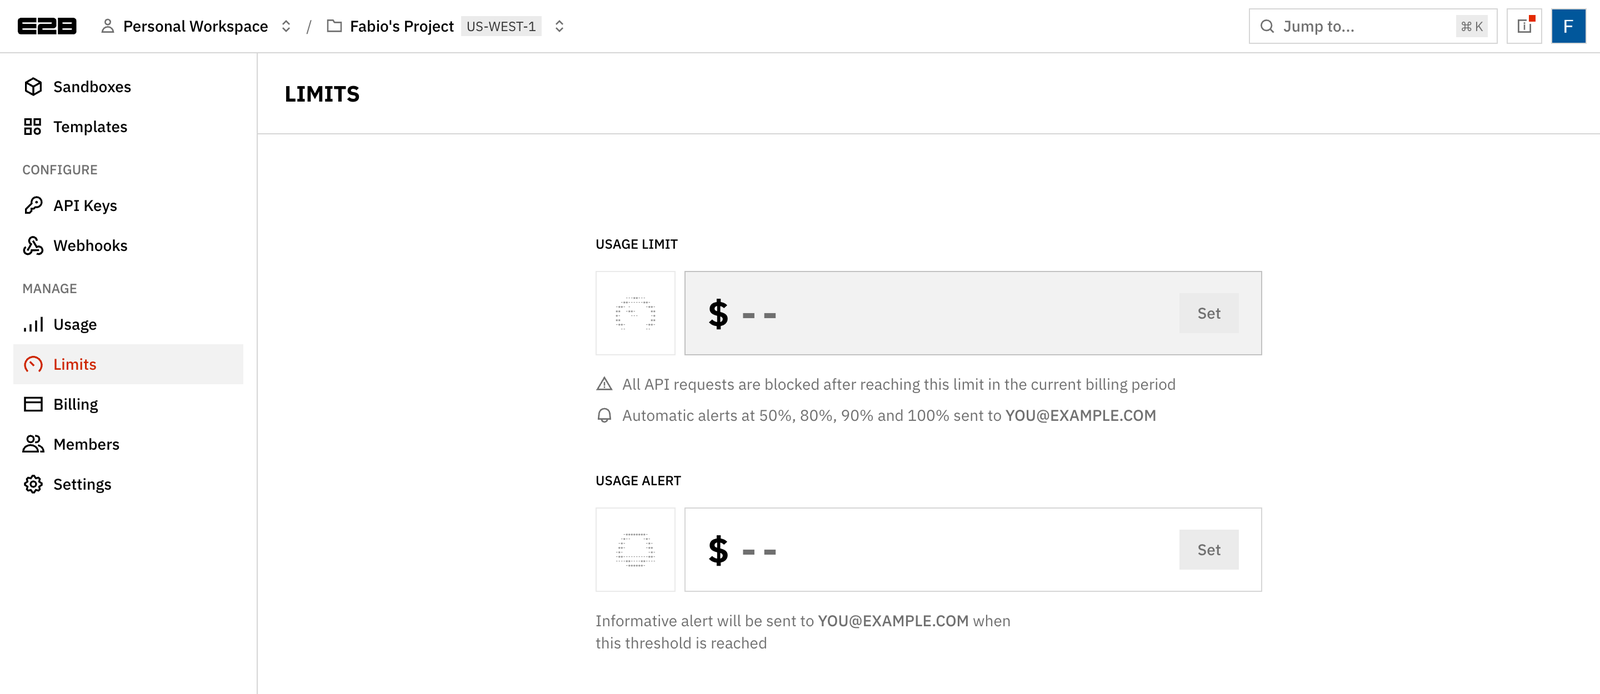
No Hobby, ficar sem créditos bloqueia a conta, então um limite de uso importa mais no Pro. Eu definiria um no primeiro dia mesmo assim.